Przykład: marka plecaków i jedno wideo twórcy
Fikcyjna marka sprzętu turystycznego sprzedaje plecaki we własnym sklepie internetowym. 19 maja 2026 roku twórca internetowy publikuje opłacone wideo z wyprawy z kodem rabatowym ważnym 14 dni. Dział marketingu pyta: ile plecaków sprzedała ta współpraca i czy się opłaciła?
Grupy kontrolnej nie ma: wideo obejrzał, kto chciał, więc to nie jest test A/B. Zostaje pytanie kontrfaktyczne: ile plecaków sprzedalibyśmy w tych samych dniach bez współpracy (model potencjalnych wyników)? Odpowiedź daje prognoza z modelu uczonego przed kampanią – kontrfaktyczny przebieg sprzedaży. Efekt = obserwowana − prognoza.
Mamy dzienną sprzedaż z 730 dni (16 czerwca 2024 – 15 czerwca 2026): plecaki, trzy kategorie nieobjęte kampanią (namioty, śpiwory, buty trekkingowe) i zamówienia z kodem twórcy. Przed publikacją jest 702 dni, po niej analizujemy 28: 14 dni z kodem i 14 po jego wygaśnięciu. Dane pobierzesz jako tworca-sprzedaz-plecakow-dzienna.csv.
Dane są fikcyjne i znamy prawdę. Ręcznie ustaliliśmy poziomy sprzedaży (plecaki 85, namioty 40, śpiwory 35, buty 70 sztuk dziennie), sezon ze szczytem w lipcu, rytm tygodnia, wzrost (plecaki 12% rocznie) i wspólne wahania kategorii (pogoda, wypłaty). Efekt współpracy dotyczy tylko plecaków: wygasający skok, mały dodatek, póki działa kod, i dołek po nim (część osób kupiła wcześniej). Prawdziwy efekt to 989 plecaków w 14 dniach z kodem, −67 w kolejnych 14 dniach i 922 łącznie. W dniach 3–12 dodaliśmy falę ciepłych dni: +20% we wszystkich kategoriach. Po pierwszym uruchomieniu zwiększyliśmy poziomy sprzedaży (z 42, 18, 15 i 30 sztuk), SD wspólnych wahań (z 0.06 na 0.10) i parametr rozproszenia rozkładu ujemnego dwumianowego (z 30 na 100), żeby kategorie kontrolne niosły czytelny sygnał. Ziarna 741 nie zmienialiśmy.
Porównanie przed–po myli. Przed publikacją (28 dni) sklep sprzedawał średnio 125 plecaków dziennie, z kodem 219. Różnica razy 14 dni to 1316 plecaków – o jedną trzecią za dużo. Maj to wzrost sezonowy, a do tego ciepłe dni.
Rysunek 1: oś czasu współpracy i pasmo kontrfaktyczne
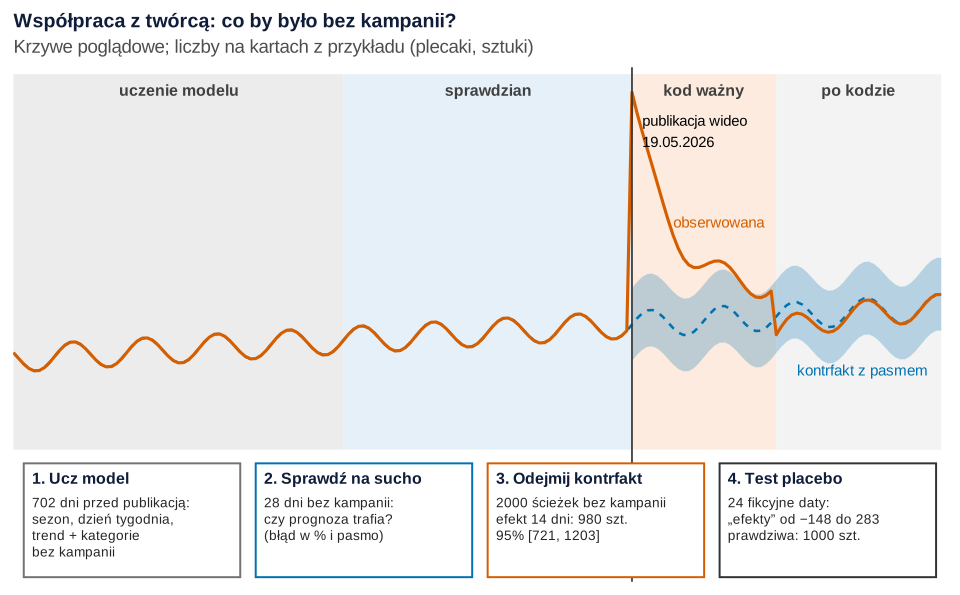
set.seed(741)).Co widać. Model uczy się przed publikacją (szary pas), sprawdzamy go na 28 dniach bez kampanii (niebieski), potem prognozuje dni po publikacji. Efekt to pole między krzywą obserwowaną a kontrfaktem.
Jak może zmylić. Założenie „bez kampanii byłoby jak w prognozie” jest nie do sprawdzenia po publikacji. Wspierają je pośrednio sprawdzian na sucho i placebo.
Podpis do pracy:
Rysunek 2: dwa lata sprzedaży i kategorie bez kampanii
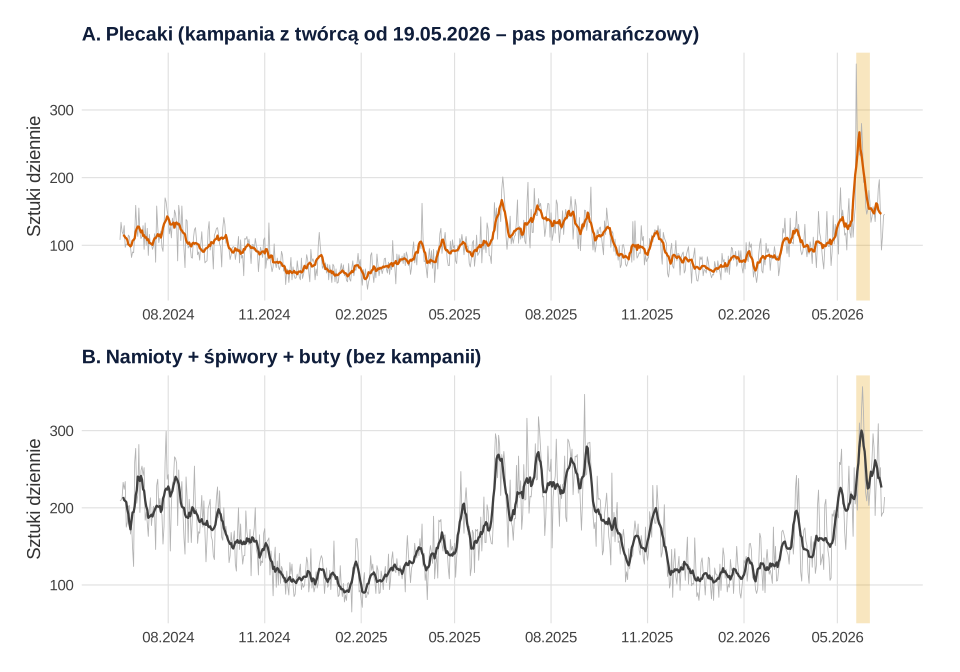
set.seed(741)).Co widać. Silna sezonowość: zimą dołek, latem szczyt. Plecaki rosną: 90.1 sztuki dziennie w pierwszym roku, 104.2 w drugim (do publikacji). Kategorie bez kampanii idą razem z plecakami, bo działają na nie te same czynniki.
Jak może zmylić. Panel B też rośnie w okresie kampanii – to fala ciepła, nie wideo. Patrząc tylko na plecaki, przypisalibyśmy ją twórcy; to klasyczna zmienna zakłócająca.
Podpis do pracy:
Model kontrfaktu: regresja z błędami ARIMA
Model opisuje logarytm dziennej sprzedaży plecaków. Regresory to sezon roczny (dwie pary sinusów i cosinusów), dzień tygodnia i trend, a zależność sąsiednich dni bierze składnik ARIMA błędów. Rzędy dobrała funkcja auto.arima() z pakietu forecast (Hyndman i Khandakar, 2008); w obu modelach wyszło ARIMA(1,0,1). Modele ARIMA pozwalają ocenić interwencję z uwzględnieniem trendu, autokorelacji i sezonowości (Schaffer i in., 2021). Krok po kroku prowadzą wpisy szeregi czasowe i ARIMA w praktyce oraz prognoza sprzedaży.
Porównujemy dwa modele. Model A zna tylko kalendarz. Model B dostaje dodatkowo logarytm łącznej sprzedaży namiotów, śpiworów i butów. To uproszczona syntetyczna kontrola: przebieg bez kampanii odtwarzamy z serii, których kampania nie dotknęła (pełna metoda z wagami: kampania w jednym regionie; warunki jej wiarygodności omawia Abadie, 2021). Seria kontrolna pomaga wykluczyć zdarzenia równoczesne z interwencją, ale ma też słabe strony i trzeba ją wybrać przed analizą (Lopez Bernal i in., 2018).
W modelu B współczynnik kategorii kontrolnych to 0.583 (SE = 0.041): +10% w kategoriach to około +5.7% plecaków. Odchylenie reszt spada z 0.187 do 0.167, AICc z −341.8 do −504.7. Test Ljunga–Boxa (21 opóźnień): Q(19) = 31.41, p = .036 – w resztach zostaje słaba zależność, więc pasma mogą być odrobinę za wąskie.
Sprawdzian na sucho. Modele uczone do 29. dnia przed publikacją prognozują 28 dni bez kampanii. MAPE (miary błędu prognozy) wynosi 15.2% (A) i 14.7% (B), w 95% paśmie leży 96.4% dni. Oba modele zaniżyły jednak sprzedaż: łącznie o 309 (A) i 229 sztuk (B). Model, który zaniża przed kampanią, może zawyżać efekt po niej.
Rysunek 3: sprzedaż obserwowana i kontrfaktyczna
Z modelu B losujemy 2000 możliwych przebiegów sprzedaży bez kampanii na 28 dni (simulate()). Mediana ścieżek w danym dniu to kontrfakt, 2.5. i 97.5. centyl – pasmo. To pasmo predykcji, nie ufności: obejmuje też dzienny szum.
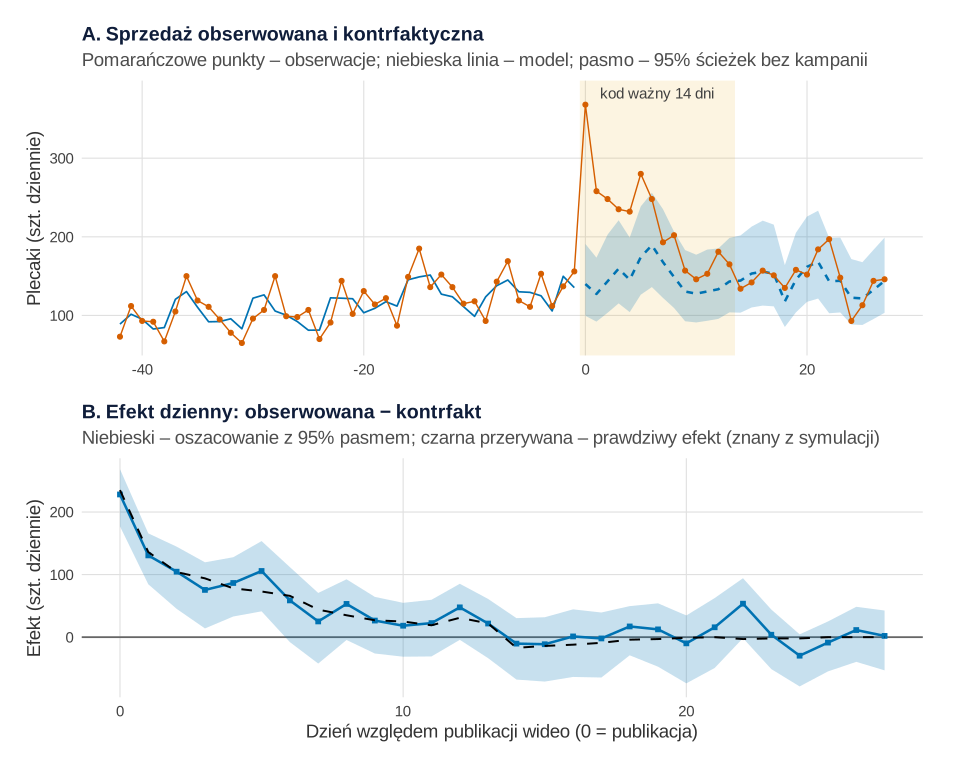
set.seed(741)).Co widać. W 14 dniach z kodem sklep sprzedawał średnio 219 plecaków dziennie, a kontrfakt wynosi 147.2. W dniu publikacji efekt to 228 sztuk, 95% [177, 269] (prawda: 235). Potem szybko maleje; nad pasmem jest tylko 6 z 14 dni z kodem, a w dniach 14–27 żaden dzień nie wychodzi z pasma. Kontrfakt w dniach 3–12 rośnie razem z kategoriami kontrolnymi – model B „widzi” falę ciepła.
Jak może zmylić. Dzień w paśmie nie znaczy „brak efektu”: pasmo ma szerokość 91–96 sztuk, a efekt po tygodniu – kilkadziesiąt. O całości mówi suma dni (rysunek 4). Pasmo pomija niepewność współczynników, więc jest raczej za wąskie.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: efekt skumulowany z niepewnością
Dla każdej z 2000 ścieżek liczymy sumę (obserwowana − ścieżka) od dnia publikacji, potem medianę i centyle sum. Dni w ścieżce są powiązane, więc przedział uwzględnia autokorelację.
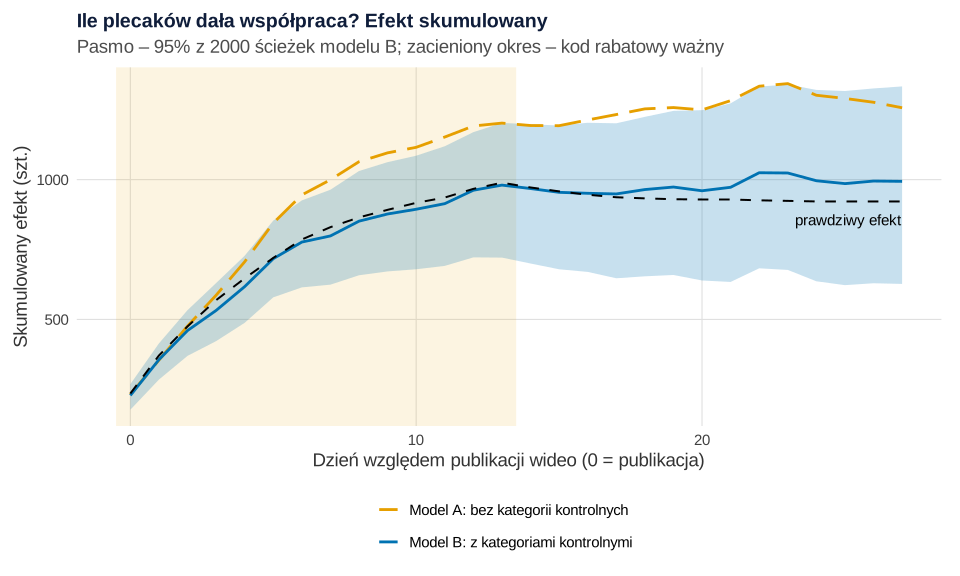
set.seed(741)).Co widać. Model B: 980 plecaków w 14 dniach z kodem, 95% przedział [721, 1203], przy prawdzie 989. To 47% ponad kontrfakt. Po 28 dniach: 994 [627, 1333], przy prawdzie 922. Model A daje 1202 [855, 1480]: przedział obejmuje prawdę, ale środek jest przesunięty o ponad 200 sztuk przez falę ciepła. Suma dziennych granic pasm dałaby absurdalne [−530, 2187], bo skrajne dni nie zdarzają się naraz.
Jak może zmylić. Dołek po wygaśnięciu kodu istnieje (prawda: −67 sztuk), ale model go nie widzi: w dniach 14–27 szacuje +18 [−222, 243]. Ujemną sumę dało 43.4% ścieżek. Dołki po promocji rzadko widać w danych sprzedaży, choć dane gospodarstw domowych pokazują, że klienci kupują wcześniej (van Heerde i in., 2000); ich siła zależy od cech produktu i kategorii (Macé i Neslin, 2004). Zob. też przyrost czy przesunięcie zakupów.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: test placebo na fikcyjnych datach
Udajemy, że wideo ukazało się w innym dniu: 24 fikcyjne daty co dwa tygodnie, od 3 czerwca 2025 do 21 kwietnia 2026 roku. Dla każdej model B uczy się tylko na wcześniejszych dniach, a my sumujemy (obserwowana − prognoza) w 14 dniach. Kampanii wtedy nie było, więc „efekty” pokazują zwykły rozrzut modelu. To logika testu permutacyjnego przeniesiona z regionów na czas.
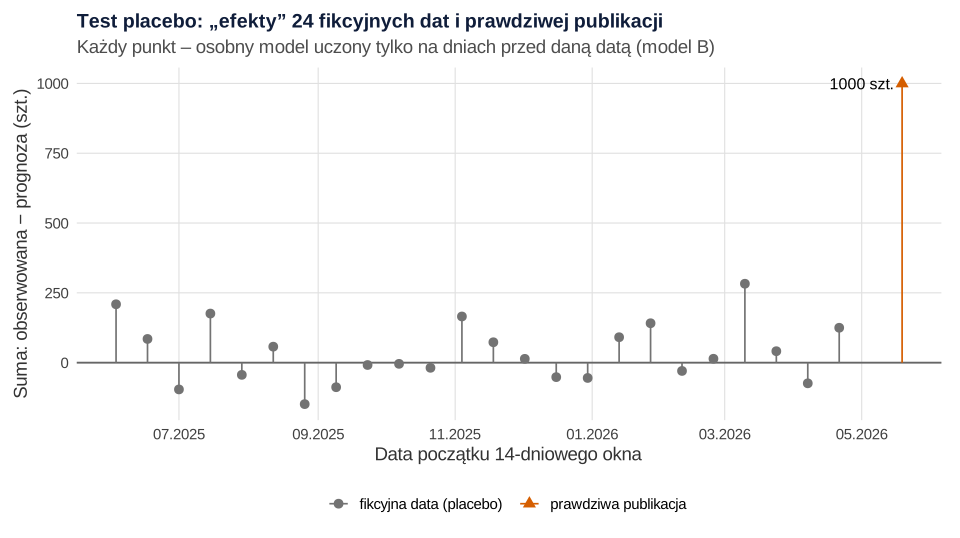
set.seed(741)).Co widać. „Efekty” placebo mają medianę 14 sztuk i wahają się od −148 do 283 (SD = 108). Prawdziwa data daje 1000 sztuk, ponad trzy razy więcej niż największe placebo. Żadne placebo nie dorównuje jej co do wartości bezwzględnej, więc p = 1/25 = .04, najmniej, ile się da przy 24 datach. (1000, a nie 980, bo tu odejmujemy prognozę punktową, a nie medianę ścieżek.)
Jak może zmylić. Placebo chroni przed zbyt wąskim pasmem, ale nie przed zdarzeniem dokładnie w dniu kampanii (wyprzedaż konkurencji, upał). To zadanie serii kontrolnej.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: kody rabatowe to nie efekt
Najprostsza miara to zamówienia z kodem twórcy: 699 w 14 dniach. Wiemy, skąd się wzięły: 602 od osób, które kupiły dzięki wideo, 97 od tych, którzy kupiliby i tak. Ustawiliśmy też, że 40% kupujących dzięki wideo w ogóle nie wpisuje kodu.
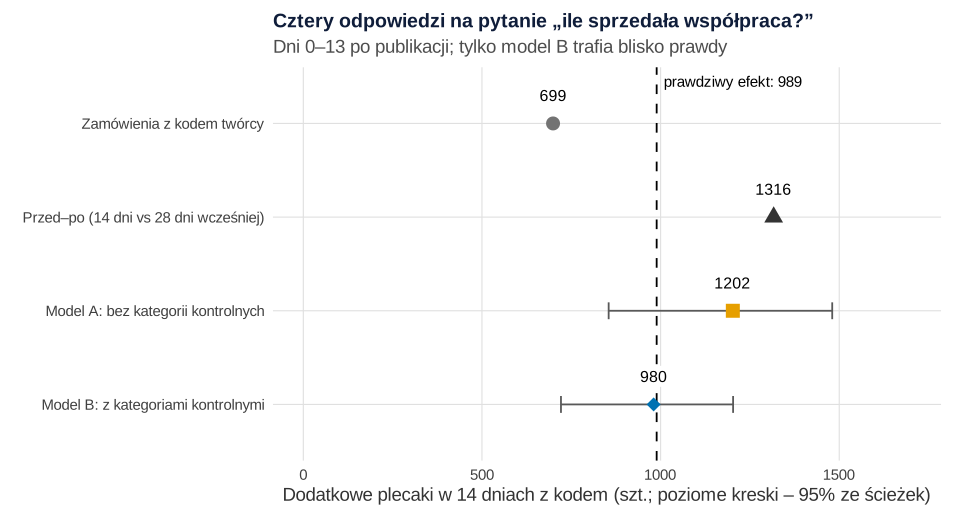
set.seed(741)).Co widać. Kody (699) zaniżają efekt, przed–po (1316) i model A (1202) go zawyżają. Blisko prawdy (989) jest tylko model B (980). Liczba kodów to 71.3% efektu z modelu B. Kod mierzy, kto użył rabatu, a nie, kto kupił dzięki kampanii.
Jak może zmylić. Kody mogą też zawyżać: gdy kod krąży po serwisach z rabatami, używają go osoby, które i tak by kupiły. Proporcji 60% do 4% w prawdziwej firmie nie znasz, więc efekt szacuj z całej sprzedaży.
Podpis do pracy:
Co z tym zrobić w marketingu
- Policz pieniądze z przedziałem. Ręcznie przyjęliśmy cenę 329 zł, rabat 15%, marżę 110 zł na plecaku i honorarium 25 000 zł. Rabaty kosztowały 34 496 zł, bo dostali je wszyscy z kodem, także ci, którzy kupiliby i tak. Wynik współpracy w 28 dniach: 49 828 zł, 95% [9 475, 87 183]; dodatni w 99% ścieżek. Gdyby efekt liczyć kodami, wyszłoby tylko 17 394 zł, a decyzja o kolejnej współpracy mogłaby być inna.
- Wybierz serię kontrolną przed kampanią. Kategorie, których twórca nie pokaże, i które przed kampanią szły razem z produktem. Zapisz wybór w planie.
- Nie zmieniaj niczego innego w tym czasie. Promocja, nowa reklama czy zmiana cen w tych dniach miesza się z efektem twórcy.
- Mierz dłużej niż kod. Dodaj co najmniej dwa tygodnie po wygaśnięciu kodu, żeby zobaczyć ewentualny dołek albo efekt, który trwa.
- Gdy możesz – losuj. Przy wielu twórcach lub regionach wylosuj kolejność kampanii. Metody obserwacyjne często nie odtwarzają wyników eksperymentów reklamowych (Gordon i in., 2019), a nawet eksperymenty z milionami osób dają szerokie przedziały dla zwrotu z reklamy (Lewis i Rao, 2015).
Podobne pytanie dla zliczeń reakcji na postach zadaje wpis co zwiększa zasięg posta, a zmianę ruchu po przebudowie sklepu – ruch z wyszukiwarki po zmianie strony. Inne tematy prac zbiera statystyka w pracy z marketingu.
Jak opisać w pracy
W Metodzie opisz okres uczenia, regresory, serię kontrolną i przedziały; w Wynikach – sprawdzian, efekt z przedziałami i placebo; w Dyskusji – zagrożenia trafności wewnętrznej: zdarzenia równoczesne i przenikanie kampanii do kategorii kontrolnych.
Kod R: kontrfakt, ścieżki prognozy, placebo i kody
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, przepis 2 – modele, przepis 3 – ścieżki prognozy używane w przepisach 4, 6 i 8. Przepisy kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują tylko przepisy 1 i 3; każdy zaczyna od własnego set.seed(741). Ziarno 741 ustalono raz i nie zmieniano go. Ręcznie ustalono: poziomy, sezon, rytm tygodnia, wzrost i wspólne wahania kategorii, rozproszenie sprzedaży, kształt efektu współpracy, falę ciepła oraz odsetki użycia kodu (przepis 1); 2000 ścieżek (przepis 3); 24 daty placebo co 14 dni (przepis 5); cenę, rabat, marżę i honorarium (przepis 6); 8 tygodni historii i 15% przecieku do namiotów (przepis 7). Po pierwszym uruchomieniu zmieniono poziomy sprzedaży, SD wspólnych wahań i rozproszenie (opis w sekcji z przykładem). Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w około 10 sekund.
1. Dane: 730 dni sprzedaży, prawdziwy efekt i kody: Rysunek 2
R
# Przepis 1. Fikcyjna marka sprzętu turystycznego: dzienna sprzedaż plecaków i trzech kategorii bez kampanii
library(ggplot2); library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(obserwowana = "#D55E00", kontrfakt = "#0072B2", bez_kontroli = "#E69F00", prawda = "#000000")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Kalendarz: 2 lata dziennych danych; wideo twórcy z kodem rabatowym (ważnym 14 dni) ukazuje się 19 maja 2026
dzien <- seq(as.Date("2024-06-16"), as.Date("2026-06-15"), by = "day")
n <- length(dzien); t <- seq_len(n)
start <- which(dzien == as.Date("2026-05-19"))
d <- t - start                                           # dzień względem publikacji (0 = dzień publikacji)
przed <- d < 0; po <- d >= 0 & d <= 27                    # 702 dni przed i 28 dni po publikacji

# Parametry ustalone ręcznie (skala logarytmiczna): poziom, sezon roczny (szczyt w lipcu), rytm tygodnia, trend
poziom <- c(plecaki = 85, namioty = 40, spiwory = 35, buty = 70)
amplituda <- c(plecaki = 0.35, namioty = 0.55, spiwory = 0.45, buty = 0.30)
wzrost <- c(plecaki = 0.12, namioty = 0.08, spiwory = 0.05, buty = 0.10)            # wzrost na rok
tydzien <- c(0.10, 0.05, 0, -0.02, -0.08, -0.15, 0.05)                              # pon.–niedz.
dt <- as.integer(format(dzien, "%u"))                                               # 1 = poniedziałek
sezon <- sin(2 * pi * (as.integer(format(dzien, "%j")) - 110) / 365.25)

# Prawdziwy efekt współpracy (tylko plecaki): skok po publikacji, wygasanie, stały dodatek, póki kod działa,
# a po wygaśnięciu kodu – dołek (część osób kupiła wcześniej, niż kupiłaby bez kampanii)
efekt_log <- ifelse(d >= 0 & d <= 13, 0.85 * exp(-d / 3.5) + 0.12,
             ifelse(d >= 14 & d <= 27, -0.10 * exp(-(d - 14) / 4), 0))
fala_ciepla <- ifelse(d >= 3 & d <= 12, 0.20, 0)        # równoczesne zdarzenie: ciepłe dni, wszystkie kategorie

set.seed(741)                                            # ziarno ustalone raz, bez dobierania pod wynik
pogoda <- as.numeric(arima.sim(list(ar = 0.7), n = n, sd = 0.10))   # wspólne wahania (pogoda, wypłaty)
mu <- sapply(names(poziom), function(k)
  poziom[k] * exp(amplituda[k] * sezon + tydzien[dt] + wzrost[k] * t / 365 + pogoda + fala_ciepla))
sprzedaz0 <- apply(mu, 2, function(m) rnbinom(n, mu = m, size = 100))      # sprzedaż bez współpracy z twórcą
dodatkowe <- rpois(n, mu[, "plecaki"] * pmax(exp(efekt_log) - 1, 0))     # zakupy wywołane współpracą
utracone <- rbinom(n, sprzedaz0[, "plecaki"], 1 - pmin(exp(efekt_log), 1)) # zakupy przesunięte wcześniej
plecaki <- sprzedaz0[, "plecaki"] + dodatkowe - utracone

# Kody rabatowe twórcy: używa ich 60% dodatkowych kupujących i 4% tych, którzy kupiliby i tak
okres_kodu <- d >= 0 & d <= 13
kody_dod <- ifelse(okres_kodu, rbinom(n, dodatkowe, 0.60), 0)                # kupujący dzięki współpracy
kody_baza <- ifelse(okres_kodu, rbinom(n, sprzedaz0[, "plecaki"], 0.04), 0)  # kupiliby i tak
kody <- kody_dod + kody_baza

dane <- data.frame(data = dzien, dzien_kampanii = d, plecaki = plecaki, namioty = sprzedaz0[, "namioty"],
                   spiwory = sprzedaz0[, "spiwory"], buty = sprzedaz0[, "buty"], kody_tworcy = kody)
write.csv(dane, "tworca-sprzedaz-plecakow-dzienna.csv", row.names = FALSE)

prawdziwy <- plecaki - sprzedaz0[, "plecaki"]            # prawdziwy efekt w sztukach (znany, bo dane są fikcyjne)
cat("Dni:", n, "| przed publikacją:", sum(przed), "| okno po publikacji:", sum(po), "\n")
cat("Średnia sprzedaż plecaków dziennie: rok 1", round(mean(plecaki[1:365]), 1),
    "| rok 2 przed publikacją", round(mean(plecaki[366:(start - 1)]), 1), "\n")
cat("28 dni przed publikacją:", round(mean(plecaki[d >= -28 & d < 0]), 1), "szt. dziennie;",
    "14 dni z kodem:", round(mean(plecaki[d >= 0 & d <= 13]), 1), "szt. dziennie\n")
cat("Prawdziwy efekt: dni 0–13", sum(prawdziwy[d >= 0 & d <= 13]), "szt.; dni 14–27", sum(prawdziwy[d >= 14 & d <= 27]),
    "szt.; razem 28 dni", sum(prawdziwy[po]), "szt.\n")
cat("Zamówienia z kodem twórcy w dniach 0–13:", sum(kody), "| w tym kupujący dzięki współpracy:", sum(kody_dod),
    "| kupujący, którzy kupiliby i tak:", sum(kody_baza), "\n")

# Rysunek 2: dwa lata sprzedaży – plecaki i suma trzech kategorii bez kampanii (średnia 7-dniowa jako linia)
sr7 <- function(v) as.numeric(stats::filter(v, rep(1 / 7, 7), sides = 2))
rys <- data.frame(data = dzien, plecaki = plecaki, kontrola = rowSums(sprzedaz0[, c("namioty", "spiwory", "buty")]))
panel <- function(kolumna, kolor, tytul) {
  ggplot(rys, aes(data, .data[[kolumna]])) +
    annotate("rect", xmin = as.Date("2026-05-19"), xmax = as.Date("2026-06-01"), ymin = -Inf, ymax = Inf,
             fill = "#E69F00", alpha = 0.25) +
    geom_line(colour = "grey70", linewidth = 0.3) +
    geom_line(aes(y = sr7(.data[[kolumna]])), colour = kolor, linewidth = 0.8, na.rm = TRUE) +
    scale_x_date(date_labels = "%m.%Y", date_breaks = "3 months") +
    labs(x = NULL, y = "Sztuki dziennie", title = tytul) + motyw
}
p2 <- panel("plecaki", kol[["obserwowana"]], "A. Plecaki (kampania z twórcą od 19.05.2026 – pas pomarańczowy)") /
  panel("kontrola", "grey25", "B. Namioty + śpiwory + buty (bez kampanii)")
p2   # zapis: ggsave("tworca-sprzedaz-dwa-lata.svg", p2, width = 10, height = 7)
Wynik w R
Dni: 730 | przed publikacją: 702 | okno po publikacji: 28
Średnia sprzedaż plecaków dziennie: rok 1 90.1 | rok 2 przed publikacją 104.2
28 dni przed publikacją: 125 szt. dziennie; 14 dni z kodem: 219 szt. dziennie
Prawdziwy efekt: dni 0–13 989 szt.; dni 14–27 -67 szt.; razem 28 dni 922 szt.
Zamówienia z kodem twórcy w dniach 0–13: 699 | w tym kupujący dzięki współpracy: 602 | kupujący, którzy kupiliby i tak: 97
2. Model A i B, diagnostyka i sprawdzian na sucho
R
# Przepis 2. Model sprzedaży plecaków na okresie przed publikacją: regresja z błędami ARIMA (pakiet forecast)
# (korzysta z dane, dzien, t, d, przed, po z przepisu 1)
library(forecast)

# Regresory znane także po publikacji: sezon roczny (wyrazy Fouriera), dzień tygodnia, trend
# oraz – w modelu B – sprzedaż trzech kategorii, których kampania nie dotyczyła (namioty, śpiwory, buty)
regresory <- function(z_kontrola) {
  X <- cbind(sin1 = sin(2 * pi * t / 365.25), cos1 = cos(2 * pi * t / 365.25),
             sin2 = sin(4 * pi * t / 365.25), cos2 = cos(4 * pi * t / 365.25),
             model.matrix(~ factor(format(dzien, "%u")))[, -1], trend = t / 365)
  colnames(X)[5:10] <- c("wt", "sr", "czw", "pt", "sob", "nd")
  if (z_kontrola) X <- cbind(X, kontrola = log(dane$namioty + dane$spiwory + dane$buty))
  X
}
XA <- regresory(FALSE); XB <- regresory(TRUE)
y <- log(dane$plecaki)                                   # model na logarytmie: efekty jako zmiany procentowe

fitA <- auto.arima(y[przed], xreg = XA[przed, ], seasonal = FALSE)   # model A: bez kategorii kontrolnych
fitB <- auto.arima(y[przed], xreg = XB[przed, ], seasonal = FALSE)   # model B: z kategoriami kontrolnymi
cat("Model A:", as.character(fitA), "| sigma =", round(sqrt(fitA$sigma2), 3), "| AICc =", round(fitA$aicc, 1), "\n")
cat("Model B:", as.character(fitB), "| sigma =", round(sqrt(fitB$sigma2), 3), "| AICc =", round(fitB$aicc, 1), "\n")
cat("Model B – współczynnik przy log(sprzedaży kategorii kontrolnych):",
    round(coef(fitB)["kontrola"], 3), "SE", round(sqrt(diag(fitB$var.coef))["kontrola"], 3), "\n")
lbB <- Box.test(residuals(fitB), lag = 21, type = "Ljung-Box", fitdf = sum(fitB$arma[1:2]))
cat("Model B – test Ljunga–Boxa reszt (21 opóźnień): Q =", round(lbB$statistic, 2), "df =", lbB$parameter,
    "p =", sub("^0", "", sprintf("%.3f", lbB$p.value)), "\n")

# Sprawdzian „na sucho”: model uczony do 29. dnia przed publikacją prognozuje 28 dni bez kampanii
uczenie <- d < -28; test <- d >= -28 & d < 0
sprawdzian <- function(X, fit) {
  f <- Arima(y[uczenie], xreg = X[uczenie, ], order = arimaorder(fit))
  fc <- forecast(f, xreg = X[test, ], level = 95)
  c(MAPE = mean(abs(dane$plecaki[test] - exp(fc$mean)) / dane$plecaki[test]) * 100,
    pokrycie = mean(y[test] >= fc$lower & y[test] <= fc$upper) * 100,
    suma_luk = sum(dane$plecaki[test] - exp(fc$mean)))
}
cat("\nSprawdzian na 28 dniach bez kampanii (MAPE %, % dni w 95% paśmie, suma różnic w szt.):\n")
print(round(rbind(model_A = sprawdzian(XA, fitA), model_B = sprawdzian(XB, fitB)), 1))
Wynik w R
Model A: Regression with ARIMA(1,0,1) errors | sigma = 0.187 | AICc = -341.8
Model B: Regression with ARIMA(1,0,1) errors | sigma = 0.167 | AICc = -504.7
Model B – współczynnik przy log(sprzedaży kategorii kontrolnych): 0.583 SE 0.041
Model B – test Ljunga–Boxa reszt (21 opóźnień): Q = 31.41 df = 19 p = .036

Sprawdzian na 28 dniach bez kampanii (MAPE %, % dni w 95% paśmie, suma różnic w szt.):
        MAPE pokrycie suma_luk
model_A 15.2     96.4    308.9
model_B 14.7     96.4    229.3
3. 2000 ścieżek kontrfaktu i efekt dzienny: Rysunek 3
R
# Przepis 3. Kontrfaktyczny przebieg sprzedaży: 2000 symulowanych ścieżek prognozy i efekt dzienny – Rysunek 3
# (korzysta z dane, d, po, y, XA, XB, fitA, fitB, prawdziwy, kol i motyw z przepisów 1–2)
library(forecast); library(ggplot2); library(patchwork)

# Każda ścieżka to jeden możliwy przebieg sprzedaży bez współpracy (z błędami ARIMA modelu); 2000 ścieżek
sciezki <- function(fit, X, R = 2000) {
  set.seed(741)                                          # to samo ziarno co w przepisie 1
  sapply(1:R, function(r) exp(simulate(fit, nsim = sum(po), xreg = X[po, ], future = TRUE)))
}
SA <- sciezki(fitA, XA); SB <- sciezki(fitB, XB)         # macierze 28 dni × 2000 ścieżek
obs <- dane$plecaki[po]

kf <- data.frame(dzien = 0:27, obs = obs, prawda = prawdziwy[po],
                 med = apply(SB, 1, median), lo = apply(SB, 1, quantile, 0.025), hi = apply(SB, 1, quantile, 0.975))
kf$efekt <- kf$obs - kf$med; kf$ef_lo <- kf$obs - kf$hi; kf$ef_hi <- kf$obs - kf$lo
cat("Model B, dni 0–13: obserwowana średnia", round(mean(obs[1:14]), 1), "szt., kontrfakt (mediana ścieżek)",
    round(mean(kf$med[1:14]), 1), "szt. dziennie\n")
cat("Efekt w dniu publikacji:", round(kf$efekt[1]), "szt. [", round(kf$ef_lo[1]), ",", round(kf$ef_hi[1]), "]",
    "| prawdziwy:", kf$prawda[1], "\n")
cat("Dni, w których obserwacja leży nad 95% pasmem: dni 0–13:", sum(kf$obs[1:14] > kf$hi[1:14]),
    "z 14 | dni 14–27:", sum(kf$obs[15:28] > kf$hi[15:28]), "z 14; pod pasmem w dniach 14–27:",
    sum(kf$obs[15:28] < kf$lo[15:28]), "\n")
cat("Szerokość pasma 95% (szt.): dzień 0", round(kf$hi[1] - kf$lo[1]), "| dzień 27", round(kf$hi[28] - kf$lo[28]), "\n")

okno <- d >= -42 & d <= 27
hist_df <- data.frame(dzien = d[okno], obs = dane$plecaki[okno],
                      dopas = c(exp(fitted(fitB))[d[d < 0] >= -42], rep(NA, sum(po))))
pA <- ggplot() +
  annotate("rect", xmin = -0.5, xmax = 13.5, ymin = -Inf, ymax = Inf, fill = "#E69F00", alpha = 0.12) +
  geom_ribbon(data = kf, aes(dzien, ymin = lo, ymax = hi), fill = kol[["kontrfakt"]], alpha = 0.22) +
  geom_line(data = hist_df, aes(dzien, dopas), colour = kol[["kontrfakt"]], linewidth = 0.6, na.rm = TRUE) +
  geom_line(data = kf, aes(dzien, med), colour = kol[["kontrfakt"]], linewidth = 0.9, linetype = "22") +
  geom_line(data = hist_df, aes(dzien, obs), colour = kol[["obserwowana"]], linewidth = 0.5) +
  geom_point(data = hist_df, aes(dzien, obs), colour = kol[["obserwowana"]], size = 1.3) +
  annotate("text", x = 6.5, y = max(obs) * 1.04, label = "kod ważny 14 dni", size = 4, colour = "grey25") +
  labs(x = NULL, y = "Plecaki (szt. dziennie)", title = "A. Sprzedaż obserwowana i kontrfaktyczna",
       subtitle = "Pomarańczowe punkty – obserwacje; niebieska linia – model; pasmo – 95% ścieżek bez kampanii") + motyw
pB <- ggplot(kf, aes(dzien)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_ribbon(aes(ymin = ef_lo, ymax = ef_hi), fill = kol[["kontrfakt"]], alpha = 0.22) +
  geom_line(aes(y = efekt), colour = kol[["kontrfakt"]], linewidth = 0.9) +
  geom_point(aes(y = efekt), colour = kol[["kontrfakt"]], size = 1.6, shape = 15) +
  geom_line(aes(y = prawda), colour = kol[["prawda"]], linewidth = 0.7, linetype = "dashed") +
  labs(x = "Dzień względem publikacji wideo (0 = publikacja)", y = "Efekt (szt. dziennie)",
       title = "B. Efekt dzienny: obserwowana − kontrfakt",
       subtitle = "Niebieski – oszacowanie z 95% pasmem; czarna przerywana – prawdziwy efekt (znany z symulacji)") + motyw
p3 <- pA / pB + plot_layout(heights = c(1.15, 1))
p3   # zapis: ggsave("tworca-sprzedaz-kontrfakt.svg", p3, width = 10, height = 8)
Wynik w R
Model B, dni 0–13: obserwowana średnia 219 szt., kontrfakt (mediana ścieżek) 147.2 szt. dziennie
Efekt w dniu publikacji: 228 szt. [ 177 , 269 ] | prawdziwy: 235
Dni, w których obserwacja leży nad 95% pasmem: dni 0–13: 6 z 14 | dni 14–27: 0 z 14; pod pasmem w dniach 14–27: 0
Szerokość pasma 95% (szt.): dzień 0 91 | dzień 27 96
4. Efekt skumulowany: Rysunek 4
R
# Przepis 4. Skumulowany efekt z niepewnością: suma po ścieżkach, a nie suma granic pasm – Rysunek 4
# (korzysta z SA, SB, obs, kf, prawdziwy, po, kol i motyw z przepisów 1–3)
library(ggplot2)

kumuluj <- function(S) apply(obs - S, 2, cumsum)         # 28 dni × 2000 ścieżek skumulowanego efektu
KA <- kumuluj(SA); KB <- kumuluj(SB)
opis <- function(K, dzien) { k <- K[dzien + 1, ]
  sprintf("%5.0f [%5.0f, %5.0f]", median(k), quantile(k, 0.025), quantile(k, 0.975)) }
prawda_kum <- cumsum(prawdziwy[po])
cat("Skumulowany efekt w sztukach: mediana [95% przedział z 2000 ścieżek]\n")
cat("                      dni 0–13            dni 0–27\n")
cat("Model A (bez kontroli):", opis(KA, 13), "  ", opis(KA, 27), "\n")
cat("Model B (z kontrolą):  ", opis(KB, 13), "  ", opis(KB, 27), "\n")
cat("Prawdziwy efekt:       ", prawda_kum[14], "                ", prawda_kum[28], "\n")
cat("Model B: efekt dni 14–27 (dołek po kodzie):", opis(KB[15:28, , drop = FALSE] - rep(KB[14, ], each = 14), 13),
    "| prawdziwy:", prawda_kum[28] - prawda_kum[14], "\n")
cat("Model B: odsetek ścieżek z efektem dni 14–27 < 0:", round(100 * mean(KB[28, ] < KB[14, ]), 1), "%\n")
cat("Model B: efekt względny dni 0–13:", round(100 * median(KB[14, ] / colSums(SB[1:14, ])), 1), "%\n")

# Błąd częsty: zsumować dzienne granice pasm – przedział wychodzi za szeroki (granice nie zdarzają się razem)
cat("\nSuma dziennych granic pasm (dni 0–27, model B): [", round(sum(kf$ef_lo)), ",", round(sum(kf$ef_hi)), "]",
    "wobec przedziału ze ścieżek [", round(quantile(KB[28, ], 0.025)), ",", round(quantile(KB[28, ], 0.975)), "]\n")

kum <- rbind(data.frame(dzien = 0:27, model = "Model B: z kategoriami kontrolnymi", med = apply(KB, 1, median),
                        lo = apply(KB, 1, quantile, 0.025), hi = apply(KB, 1, quantile, 0.975)),
             data.frame(dzien = 0:27, model = "Model A: bez kategorii kontrolnych", med = apply(KA, 1, median),
                        lo = NA, hi = NA))
p4 <- ggplot(kum, aes(dzien, med)) +
  annotate("rect", xmin = -0.5, xmax = 13.5, ymin = -Inf, ymax = Inf, fill = "#E69F00", alpha = 0.12) +
  geom_ribbon(data = subset(kum, !is.na(lo)), aes(ymin = lo, ymax = hi), fill = kol[["kontrfakt"]], alpha = 0.22) +
  geom_line(aes(colour = model, linetype = model), linewidth = 1) +
  geom_line(data = data.frame(dzien = 0:27, med = prawda_kum), colour = kol[["prawda"]], linewidth = 0.7,
            linetype = "dashed") +
  annotate("text", x = 27, y = prawda_kum[28], label = "prawdziwy efekt", hjust = 1, vjust = 2.2, size = 4) +
  scale_colour_manual(values = c(kol[["bez_kontroli"]], kol[["kontrfakt"]]), name = NULL) +
  scale_linetype_manual(values = c("longdash", "solid"), name = NULL) +
  labs(x = "Dzień względem publikacji wideo (0 = publikacja)", y = "Skumulowany efekt (szt.)",
       title = "Ile plecaków dała współpraca? Efekt skumulowany",
       subtitle = "Pasmo – 95% z 2000 ścieżek modelu B; zacieniony okres – kod rabatowy ważny") +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) + motyw
p4   # zapis: ggsave("tworca-sprzedaz-efekt-skumulowany.svg", p4, width = 10, height = 6)
Wynik w R
Skumulowany efekt w sztukach: mediana [95% przedział z 2000 ścieżek]
                      dni 0–13            dni 0–27
Model A (bez kontroli):  1202 [  855,  1480]     1257 [  728,  1712]
Model B (z kontrolą):     980 [  721,  1203]      994 [  627,  1333]
Prawdziwy efekt:        989                  922
Model B: efekt dni 14–27 (dołek po kodzie):    18 [ -222,   243] | prawdziwy: -67
Model B: odsetek ścieżek z efektem dni 14–27 < 0: 43.4 %
Model B: efekt względny dni 0–13: 47 %

Suma dziennych granic pasm (dni 0–27, model B): [ -530 , 2187 ] wobec przedziału ze ścieżek [ 627 , 1333 ]
5. Test placebo na 24 fikcyjnych datach: Rysunek 5
R
# Przepis 5. Test placebo w czasie: fikcyjne daty „publikacji” przed prawdziwą kampanią – Rysunek 5
# (korzysta z dane, d, y, XB, fitB, kol i motyw z przepisów 1–2; nic nie losuje)
library(forecast); library(ggplot2)

# Dla każdej daty: model uczony tylko na dniach przed nią (ten sam rząd ARIMA), prognoza 14 dni,
# „efekt” = suma (obserwowana − prognoza). Bez kampanii takie „efekty” pokazują zwykły rozrzut modelu.
efekt_14 <- function(dzien0) {
  ucz <- d < dzien0; okno <- d >= dzien0 & d <= dzien0 + 13
  f <- Arima(y[ucz], xreg = XB[ucz, ], order = arimaorder(fitB))
  sum(dane$plecaki[okno] - exp(forecast(f, xreg = XB[okno, ])$mean))
}
daty0 <- seq(-350, -28, by = 14)                          # 24 fikcyjne daty, co 2 tygodnie
plac <- data.frame(dzien0 = daty0, data = dane$data[match(daty0, d)], efekt = sapply(daty0, efekt_14))
prawdziwa <- efekt_14(0)
cat("Fikcyjnych dat:", nrow(plac), "| od", format(min(plac$data)), "do", format(max(plac$data)), "\n")
cat("„Efekty” placebo (szt. w 14 dni): mediana", round(median(plac$efekt)), "| zakres", round(min(plac$efekt)), "do",
    round(max(plac$efekt)), "| SD", round(sd(plac$efekt)), "\n")
cat("Prawdziwa data publikacji:", round(prawdziwa), "szt.\n")
cat("Placebo z |efektem| ≥ prawdziwego:", sum(abs(plac$efekt) >= abs(prawdziwa)),
    "→ p =", sub("^0", "", sprintf("%.3f", (1 + sum(abs(plac$efekt) >= abs(prawdziwa))) / (1 + nrow(plac)))), "\n")
cat("Placebo z efektem > 300 szt.:", sum(plac$efekt > 300), "| < −300 szt.:", sum(plac$efekt < -300), "\n")

wsz <- rbind(transform(plac, typ = "fikcyjna data (placebo)"),
             data.frame(dzien0 = 0, data = as.Date("2026-05-19"), efekt = prawdziwa, typ = "prawdziwa publikacja"))
p5 <- ggplot(wsz, aes(data, efekt, colour = typ, shape = typ)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_segment(aes(xend = data, y = 0, yend = efekt), linewidth = 0.6) +
  geom_point(size = 3) +
  annotate("text", x = as.Date("2026-05-19"), y = prawdziwa, label = paste0(round(prawdziwa), " szt."),
           hjust = 1.15, size = 4.2) +
  scale_colour_manual(values = c("grey45", kol[["obserwowana"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_x_date(date_labels = "%m.%Y", date_breaks = "2 months") +
  labs(x = "Data początku 14-dniowego okna", y = "Suma: obserwowana − prognoza (szt.)",
       title = "Test placebo: „efekty” 24 fikcyjnych dat i prawdziwej publikacji",
       subtitle = "Każdy punkt – osobny model uczony tylko na dniach przed daną datą (model B)") + motyw
p5   # zapis: ggsave("tworca-sprzedaz-placebo.svg", p5, width = 10, height = 5.6)
Wynik w R
Fikcyjnych dat: 24 | od 2025-06-03 do 2026-04-21
„Efekty” placebo (szt. w 14 dni): mediana 14 | zakres -148 do 283 | SD 108
Prawdziwa data publikacji: 1000 szt.
Placebo z |efektem| ≥ prawdziwego: 0 → p = .040
Placebo z efektem > 300 szt.: 0 | < −300 szt.: 0
6. Kody rabatowe, cztery sposoby liczenia i rachunek: Rysunek 6
R
# Przepis 6. Kody rabatowe a efekt z modelu i rachunek współpracy – Rysunek 6
# (korzysta z dane, d, KA, KB, prawdziwy, po, kol i motyw z przepisów 1–4; nic nie losuje)
library(ggplot2)

kody14 <- sum(dane$kody_tworcy)
przed_po <- (mean(dane$plecaki[d >= 0 & d <= 13]) - mean(dane$plecaki[d >= -28 & d < 0])) * 14
q <- function(k) c(quantile(k, 0.025), median(k), quantile(k, 0.975))
spos <- data.frame(
  sposob = c("Zamówienia z kodem twórcy", "Przed–po (14 dni vs 28 dni wcześniej)",
             "Model A: bez kategorii kontrolnych", "Model B: z kategoriami kontrolnymi"),
  rbind(rep(kody14, 3), rep(przed_po, 3), q(KA[14, ]), q(KB[14, ])))
names(spos)[2:4] <- c("lo", "med", "hi")
spos$sposob <- factor(spos$sposob, rev(spos$sposob))
prawda14 <- sum(prawdziwy[d >= 0 & d <= 13])
print(transform(spos, lo = round(lo), med = round(med), hi = round(hi)), row.names = FALSE)
cat("Prawdziwy efekt w dniach 0–13:", prawda14, "szt. | kody jako odsetek efektu z modelu B:",
    round(100 * kody14 / median(KB[14, ]), 1), "%\n")

# Rachunek (parametry ustalone ręcznie): cena 329 zł, rabat z kodem 15%, marża 110 zł na plecaku przed rabatem,
# honorarium twórcy 25 000 zł. Rabat dostają wszyscy z kodem – także ci, którzy kupiliby i tak.
cena <- 329; rabat <- 0.15; marza <- 110; honorarium <- 25000
zysk <- KB[28, ] * marza - kody14 * cena * rabat - honorarium       # 2000 ścieżek, okno 28 dni
cat("\nKoszt rabatów:", round(kody14 * cena * rabat), "zł | wynik współpracy (28 dni, model B):", round(median(zysk)),
    "zł [", round(quantile(zysk, 0.025)), ",", round(quantile(zysk, 0.975)), "]\n")
cat("Odsetek ścieżek z wynikiem > 0:", round(100 * mean(zysk > 0), 1), "%\n")
cat("Ten sam rachunek, gdyby efekt = liczba kodów:", round(kody14 * marza - kody14 * cena * rabat - honorarium), "zł\n")

p6 <- ggplot(spos, aes(med, sposob)) +
  geom_errorbar(data = subset(spos, hi > lo), aes(xmin = lo, xmax = hi), width = 0.18, orientation = "y",
                colour = "grey35") +
  geom_vline(xintercept = prawda14, linetype = "dashed", colour = kol[["prawda"]]) +
  annotate("text", x = prawda14, y = 4.45, label = paste("prawdziwy efekt:", prawda14), hjust = -0.05, size = 4) +
  geom_point(aes(shape = sposob, colour = sposob), size = 4.5) +
  geom_label(aes(label = round(med)), nudge_y = 0.3, size = 4.2, fill = "white", border.colour = NA) +
  scale_colour_manual(values = c("Zamówienia z kodem twórcy" = "grey45",
                                 "Przed–po (14 dni vs 28 dni wcześniej)" = "grey20",
                                 "Model A: bez kategorii kontrolnych" = kol[["bez_kontroli"]],
                                 "Model B: z kategoriami kontrolnymi" = kol[["kontrfakt"]]), guide = "none") +
  scale_shape_manual(values = c(18, 15, 17, 16), guide = "none") +
  scale_x_continuous(limits = c(0, 1700)) +
  labs(x = "Dodatkowe plecaki w 14 dniach z kodem (szt.; poziome kreski – 95% ze ścieżek)", y = NULL,
       title = "Cztery odpowiedzi na pytanie „ile sprzedała współpraca?”",
       subtitle = "Dni 0–13 po publikacji; tylko model B trafia blisko prawdy") + motyw
p6   # zapis: ggsave("tworca-sprzedaz-kody-a-efekt.svg", p6, width = 10, height = 5.4)
Wynik w R
                                sposob   lo  med   hi
             Zamówienia z kodem twórcy  699  699  699
 Przed–po (14 dni vs 28 dni wcześniej) 1316 1316 1316
    Model A: bez kategorii kontrolnych  855 1202 1480
    Model B: z kategoriami kontrolnymi  721  980 1203
Prawdziwy efekt w dniach 0–13: 989 szt. | kody jako odsetek efektu z modelu B: 71.3 %

Koszt rabatów: 34496 zł | wynik współpracy (28 dni, model B): 49828 zł [ 9475 , 87183 ]
Odsetek ścieżek z wynikiem > 0: 99 %
Ten sam rachunek, gdyby efekt = liczba kodów: 17394 zł
7. Pułapki: krótka historia i skażona kontrola
R
# Przepis 7. Pułapki: krótki okres przed kampanią i kampania „przeciekająca” do kategorii kontrolnych
# (korzysta z dane, d, y, XB, fitB, daty0, plac, prawdziwy z przepisów 1–5; nic nie losuje)
library(forecast)
suma_14 <- function(fit, X, dzien0) {                    # suma (obserwowana − prognoza) w 14 dniach od dzien0
  okno <- d >= dzien0 & d <= dzien0 + 13
  sum(dane$plecaki[okno] - exp(forecast(fit, xreg = X[okno, , drop = FALSE])$mean))
}

# (a) Tylko 8 tygodni historii: sezonu rocznego nie da się oszacować – zostaje dzień tygodnia i trend
Xk <- XB[, c("wt", "sr", "czw", "pt", "sob", "nd", "trend")]
krotki_14 <- function(dzien0) {
  ucz <- d >= dzien0 - 56 & d < dzien0
  suma_14(auto.arima(y[ucz], xreg = Xk[ucz, ], seasonal = FALSE), Xk, dzien0)
}
plac_k <- sapply(daty0, krotki_14)
cat("(a) Placebo przy 8 tygodniach historii: SD", round(sd(plac_k)), "| zakres", round(min(plac_k)), "do",
    round(max(plac_k)), "| pełna historia (model B): SD", round(sd(plac$efekt)), "\n")
cat("    Prawdziwa publikacja, 8 tygodni historii:", round(krotki_14(0)), "szt.\n")

# (b) Kampania podnosi też sprzedaż namiotów o 15% (twórca pokazał namiot) – kontrola przestaje być „czysta”
okno <- d >= 0 & d <= 13
Xc <- XB; nam <- dane$namioty; nam[okno] <- round(nam[okno] * 1.15)
Xc[, "kontrola"] <- log(nam + dane$spiwory + dane$buty)
cat("\n(b) Efekt dni 0–13 przy kontroli „skażonej” kampanią:", round(suma_14(fitB, Xc, 0)),
    "szt. wobec", round(suma_14(fitB, XB, 0)), "szt.; prawdziwy:", sum(prawdziwy[okno]), "\n")
Wynik w R
(a) Placebo przy 8 tygodniach historii: SD 273 | zakres -733 do 466 | pełna historia (model B): SD 108
    Prawdziwa publikacja, 8 tygodni historii: 1080 szt.

(b) Efekt dni 0–13 przy kontroli „skażonej” kampanią: 950 szt. wobec 1000 szt.; prawdziwy: 989
8. Grafika: oś czasu z pasmem kontrfaktycznym: Rysunek 1
R
# Przepis 8. Grafika: oś czasu współpracy z pasmem kontrfaktycznym – Rysunek 1
# (korzysta z KB, plac i prawdziwa z przepisów 4–5 – liczby na kartach; krzywe są poglądowe, nic nie losuje)
library(ggplot2)

x <- seq(-60, 30, by = 0.5)
kontrfakt <- 100 + 0.25 * (x + 60) + 6 * sin(2 * pi * x / 7)            # poglądowa sprzedaż bez kampanii
efekt <- ifelse(x >= 0 & x < 14, 90 * exp(-x / 3.5) + 12, ifelse(x >= 14, -8 * exp(-(x - 14) / 4), 0))
schemat <- data.frame(x, kontrfakt, obserwowana = kontrfakt + efekt)
med <- function(k) round(median(k)); g <- function(k, p) round(quantile(k, p))
fazy <- data.frame(x0 = c(-60, -28, 0, 14), x1 = c(-28, 0, 14, 30),
                   nazwa = c("uczenie modelu", "sprawdzian", "kod ważny", "po kodzie"),
                   kolor = c("grey90", "#DCEAF5", "#FBE3D0", "#EFEFEF"))
karty <- data.frame(
  x0 = c(-59, -36.5, -14, 8.5), y = 30,
  tytul = c("1. Ucz model", "2. Sprawdź na sucho", "3. Odejmij kontrfakt", "4. Test placebo"),
  tekst = c("702 dni przed publikacją:\nsezon, dzień tygodnia,\ntrend + kategorie\nbez kampanii",
            "28 dni bez kampanii:\nczy prognoza trafia?\n(błąd w % i pasmo)",
            paste0("2000 ścieżek bez kampanii\nefekt 14 dni: ", med(KB[14, ]), " szt.\n95% [",
                   g(KB[14, ], 0.025), ", ", g(KB[14, ], 0.975), "]"),
            paste0("24 fikcyjne daty:\n„efekty” od ", sub("-", "\u2212", round(min(plac$efekt))), " do ", round(max(plac$efekt)),
                   "\nprawdziwa: ", round(prawdziwa), " szt.")))
p1 <- ggplot() +
  geom_rect(data = fazy, aes(xmin = x0, xmax = x1, ymin = 60, ymax = 225, fill = kolor), alpha = 0.7) +
  geom_text(data = fazy, aes(x = (x0 + x1) / 2, y = 218, label = nazwa), size = 4.2, fontface = "bold",
            colour = "grey25") +
  scale_fill_identity() +
  geom_ribbon(data = subset(schemat, x >= 0), aes(x, ymin = kontrfakt - 16, ymax = kontrfakt + 16),
              fill = "#0072B2", alpha = 0.25) +
  geom_line(data = schemat, aes(x, kontrfakt), colour = "#0072B2", linewidth = 0.9, linetype = "22") +
  geom_line(data = schemat, aes(x, obserwowana), colour = "#D55E00", linewidth = 1.1) +
  geom_vline(xintercept = 0, colour = "grey20", linewidth = 0.6) +
  annotate("text", x = 1, y = 200, label = "publikacja wideo\n19.05.2026", hjust = 0, size = 3.9) +
  annotate("text", x = 4, y = 160, label = "obserwowana", colour = "#D55E00", hjust = 0, size = 4) +
  annotate("text", x = 16, y = 95, label = "kontrfakt z pasmem", colour = "#0072B2", hjust = 0, size = 4) +
  geom_rect(data = karty, aes(xmin = x0, xmax = x0 + 21, ymin = y - 26, ymax = y + 24),
            fill = "white", colour = c("grey45", "#0072B2", "#D55E00", "grey20"), linewidth = 0.7) +
  geom_text(data = karty, aes(x0 + 0.8, y + 20, label = tytul), hjust = 0, vjust = 1, fontface = "bold",
            size = 4.2, colour = "#0f1d3a") +
  geom_text(data = karty, aes(x0 + 0.8, y + 9, label = tekst), hjust = 0, vjust = 1, size = 3.6,
            lineheight = 1.0, colour = "grey15") +
  coord_cartesian(xlim = c(-60, 30), ylim = c(2, 228), expand = FALSE) +
  labs(title = "Współpraca z twórcą: co by było bez kampanii?",
       subtitle = "Krzywe poglądowe; liczby na kartach z przykładu (plecaki, sztuki)", x = NULL, y = NULL) +
  motyw + theme(axis.text = element_blank(), panel.grid.major = element_blank())
p1   # zapis: ggsave("tworca-sprzedaz-os-czasu.svg", p1, width = 10, height = 6.2)
9. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 9. Kontrola palety: symulacja zaburzeń widzenia barw
library(colorspace)
pary <- list("obserwowana – kontrfakt" = c("#D55E00", "#0072B2"), "model A – model B" = c("#E69F00", "#0072B2"),
             "obserwowana – model A" = c("#D55E00", "#E69F00"), "placebo – prawdziwa data" = c("grey45", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
col2hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(col2hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(col2hex(k))),
                                   protanopia = roznica(protan(col2hex(k)))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
obserwowana – kontrfakt                    114.6        108.3       91.9
model A – model B                          120.2        121.5      109.3
obserwowana – model A                       33.4         18.4       24.9
placebo – prawdziwa data                    76.9         63.4       53.8
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, test Ljunga–Boxa (Box.test) i średnie ruchome – pakiet stats. Regresję z błędami ARIMA (auto.arima, Arima), prognozy i symulowane ścieżki (forecast, simulate) policzono w pakiecie forecast. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- forecast (wersja 9.0.2): Hyndman, R., Athanasopoulos, G., Bergmeir, C., Caceres, G., Chhay, L., O’Hara-Wild, M., Petropoulos, F., Razbash, S., Wang, E., & Yasmeen, F. (2026). forecast: Forecasting functions for time series and linear models (R package version 9.0.2) [Computer software]. https://doi.org/10.32614/CRAN.package.forecast
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Krótki okres przed kampanią. Z 8 tygodni historii nie da się oszacować sezonu rocznego. Taki model w teście placebo dawał „efekty” od −733 do 466 sztuk (SD = 273 wobec 108 przy pełnej historii). Przy krótkiej historii nawet prawdziwy efekt ginie w szumie albo powstaje z niczego.
- Kampania przecieka do kontroli. Jeśli twórca pokaże też namiot i jego sprzedaż wzrośnie o 15%, model B oszacuje 950 zamiast 1000 sztuk. Seria kontrolna „skażona” kampanią zaniża efekt; wybieraj kategorie, których kampania na pewno nie dotyczy.
- Zdarzenia równoczesne. Fala ciepła zawyżyła model A o ponad 200 sztuk. Przerwany szereg czasowy bez serii kontrolnej nie odróżni kampanii od pogody czy świąt.
Najczęstsze pytania
Jak zmierzyć efekt współpracy z influencerem bez grupy kontrolnej?
Zbuduj model sprzedaży na okresie przed kampanią (sezon, dzień tygodnia, trend, najlepiej też sprzedaż kategorii nieobjętych kampanią) i użyj jego prognozy jako kontrfaktu. Efekt to obserwowana sprzedaż minus prognoza. Model sprawdź najpierw na kilku tygodniach bez kampanii, a wynik porównaj z testem placebo na fikcyjnych datach.
Czy liczba użyć kodu rabatowego to efekt kampanii?
Nie. Kod mierzy, kto skorzystał z rabatu, a nie, kto kupił dzięki kampanii. Część widzów kupuje bez kodu, a część użytkowników kodu kupiłaby i tak. W przykładzie było 699 zamówień z kodem przy efekcie 980 plecaków z modelu (prawda: 989).
Jak policzyć przedział ufności dla skumulowanego efektu kampanii?
Wylosuj z modelu wiele ścieżek sprzedaży bez kampanii (w R: simulate() z pakietu forecast), dla każdej zsumuj różnice obserwowana − ścieżka i weź 2.5. i 97.5. centyl sum. Nie sumuj dziennych granic pasm: w przykładzie dało to [−530, 2187] zamiast [627, 1333].
Po co test placebo w ocenie kampanii?
Pokazuje, jak duże „efekty” model daje w dniach, w których kampanii nie było. Jeśli prawdziwa data wyraźnie odstaje od fikcyjnych, wynik nie jest artefaktem modelu. W przykładzie 24 daty placebo dały od −148 do 283 sztuk, a prawdziwa 1000 sztuk (p = .04).
Ile danych przed kampanią potrzeba do kontrfaktu?
Tyle, żeby model nauczył się sezonu – przy sezonie rocznym najlepiej ponad rok danych dziennych. Model uczony na 8 tygodniach dawał w teście placebo rozrzut SD = 273 sztuki wobec 108 przy pełnej historii.
Powiązane hasła
Przeczytaj też
Kampania w jednym regionie – syntetyczna kontrola
16 regionów i kampania tylko w jednym: wagi bliźniaka, luka, testy placebo i porównanie z DiD – pięć rysunków z kodem R.
Czytaj →PoradnikSzeregi czasowe i ARIMA w praktyce
Trend, sezonowość, ACF i test Ljunga–Boxa, wybór modelu ARIMA w stats::arima, prognoza kontrfaktyczna i regresja segmentowa z kodem R.
Czytaj →PoradnikPrognoza sprzedaży: sezonowość, święta i promocje
Sklep z zabawkami, trzy lata dziennych zamówień: STL, ETS i ARIMA z regresorami, MAE i MAPE na teście, przeciek danych i prognoza z przedziałami w R.
Czytaj →Oceniasz kampanię bez grupy kontrolnej?
Pomożemy zbudować model kontrfaktu, dobrać serię kontrolną, policzyć efekt z przedziałem i test placebo, a potem opisać wszystko tak, żebyś umiał(a) to obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Abadie, A. (2021). Using synthetic controls: Feasibility, data requirements, and methodological aspects. Journal of Economic Literature, 59(2), 391–425. https://doi.org/10.1257/jel.20191450 ● Otwarty dostęp: pełny tekst
- Gordon, B. R., Zettelmeyer, F., Bhargava, N., & Chapsky, D. (2019). A comparison of approaches to advertising measurement: Evidence from big field experiments at Facebook. Marketing Science, 38(2), 193–225. https://doi.org/10.1287/mksc.2018.1135
- Hyndman, R. J., & Khandakar, Y. (2008). Automatic time series forecasting: The forecast package for R. Journal of Statistical Software, 27(3), 1–22. https://doi.org/10.18637/jss.v027.i03 ● Otwarty dostęp
- Lewis, R. A., & Rao, J. M. (2015). The unfavorable economics of measuring the returns to advertising. The Quarterly Journal of Economics, 130(4), 1941–1973. https://doi.org/10.1093/qje/qjv023
- Lopez Bernal, J., Cummins, S., & Gasparrini, A. (2018). The use of controls in interrupted time series studies of public health interventions. International Journal of Epidemiology, 47(6), 2082–2093. https://doi.org/10.1093/ije/dyy135
- Macé, S., & Neslin, S. A. (2004). The determinants of pre- and postpromotion dips in sales of frequently purchased goods. Journal of Marketing Research, 41(3), 339–350. https://doi.org/10.1509/jmkr.41.3.339.35992
- Schaffer, A. L., Dobbins, T. A., & Pearson, S.-A. (2021). Interrupted time series analysis using autoregressive integrated moving average (ARIMA) models: A guide for evaluating large-scale health interventions. BMC Medical Research Methodology, 21(1), Article 58. https://doi.org/10.1186/s12874-021-01235-8 ● Otwarty dostęp
- van Heerde, H. J., Leeflang, P. S. H., & Wittink, D. R. (2000). The estimation of pre- and postpromotion dips with store-level scanner data. Journal of Marketing Research, 37(3), 383–395. https://doi.org/10.1509/jmkr.37.3.383.18782 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{abadie2021using, author={Abadie, Alberto}, title={{Using synthetic controls: Feasibility, data requirements, and methodological aspects}}, journal={Journal of Economic Literature}, year={2021}, volume={59}, number={2}, pages={391--425}, doi={10.1257/jel.20191450}}@article{gordon2019comparison, author={Gordon, Brett R. and Zettelmeyer, Florian and Bhargava, Neha and Chapsky, Dan}, title={{A comparison of approaches to advertising measurement: Evidence from big field experiments at Facebook}}, journal={Marketing Science}, year={2019}, volume={38}, number={2}, pages={193--225}, doi={10.1287/mksc.2018.1135}}@article{hyndman2008automatic, author={Hyndman, Rob J. and Khandakar, Yeasmin}, title={{Automatic time series forecasting: The forecast package for R}}, journal={Journal of Statistical Software}, year={2008}, volume={27}, number={3}, pages={1--22}, doi={10.18637/jss.v027.i03}}@article{lewis2015unfavorable, author={Lewis, Randall A. and Rao, Justin M.}, title={{The unfavorable economics of measuring the returns to advertising}}, journal={The Quarterly Journal of Economics}, year={2015}, volume={130}, number={4}, pages={1941--1973}, doi={10.1093/qje/qjv023}}@article{lopezbernal2018use, author={Lopez Bernal, James and Cummins, Steven and Gasparrini, Antonio}, title={{The use of controls in interrupted time series studies of public health interventions}}, journal={International Journal of Epidemiology}, year={2018}, volume={47}, number={6}, pages={2082--2093}, doi={10.1093/ije/dyy135}}@article{mace2004determinants, author={Mac{\'e}, Sandrine and Neslin, Scott A.}, title={{The determinants of pre- and postpromotion dips in sales of frequently purchased goods}}, journal={Journal of Marketing Research}, year={2004}, volume={41}, number={3}, pages={339--350}, doi={10.1509/jmkr.41.3.339.35992}}@article{schaffer2021interrupted, author={Schaffer, Andrea L. and Dobbins, Timothy A. and Pearson, Sallie-Anne}, title={{Interrupted time series analysis using autoregressive integrated moving average (ARIMA) models: A guide for evaluating large-scale health interventions}}, journal={BMC Medical Research Methodology}, year={2021}, volume={21}, number={1}, eid={58}, doi={10.1186/s12874-021-01235-8}}@article{vanheerde2000estimation, author={van Heerde, Harald J. and Leeflang, Peter S. H. and Wittink, Dick R.}, title={{The estimation of pre- and postpromotion dips with store-level scanner data}}, journal={Journal of Marketing Research}, year={2000}, volume={37}, number={3}, pages={383--395}, doi={10.1509/jmkr.37.3.383.18782}}