Przykład: sklep z ceramiką po przebudowie strony
Fikcyjny sklep internetowy z ceramiką i naczyniami 3 lutego 2025 uruchomił nową wersję strony (nowe adresy kart produktów i menu). Ruch z wyszukiwarki internetowej najpierw spadł, potem wrócił. Właścicielka pyta: czy przebudowa w sumie pomogła, czy zaszkodziła – i o ile?
Losowania tu nie ma: stronę zmieniono dla wszystkich naraz. Pozostaje schemat quasi-eksperymentalny, a przy danych dziennych z wielu miesięcy najsilniejszy z nich to przerwany szereg czasowy. Ogólny model i autokorelację na danych miesięcznych opisuje wpis o regresji segmentowej. Tu dokładamy dni tygodnia, święta, okres przejściowy i szereg porównawczy. Inne tematy prac z tej dziedziny zebraliśmy we wpisie statystyka w pracy z marketingu.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Mamy 547 dni (od 1 stycznia 2024 do 30 czerwca 2025): 399 przed przebudową i 148 po niej. Dla każdego dnia znamy wizyty z wyszukiwarki w sklepie i na podstronach bloga z poradami, których przebudowa nie objęła. Prawdziwy efekt przebudowy ustaliliśmy ręcznie na skali logarytmu: trwała zmiana poziomu +0.04, zmiana nachylenia +0.0005 dziennie i przejściowy spadek −0.35, który wygasa wykładniczo (stała czasowa 12 dni). Po 147 dniach daje to +12.0% wizyt. Ziarna 742 ani parametrów danych nie zmienialiśmy po pierwszym uruchomieniu (pełna lista przy kodzie).
Średnio sklep miał 977.7 wizyt dziennie przed przebudową, 992.3 w ośmiu tygodniach po niej i 1038.4 później. Naiwne porównanie wszystkich dni „po” i „przed” daje +4.4% – ta liczba miesza efekt z trendem, sezonem i świętami. Dane pobierzesz jako ruch-wyszukiwarka-ceramika-dzienne.csv (kolumny: data, dzień tygodnia, święto, okres przed Gwiazdką, tydzień Dnia Matki, po, dni od przebudowy, wizyty sklepu i bloga).
Rysunek 1: dzienne wizyty z wyszukiwarki
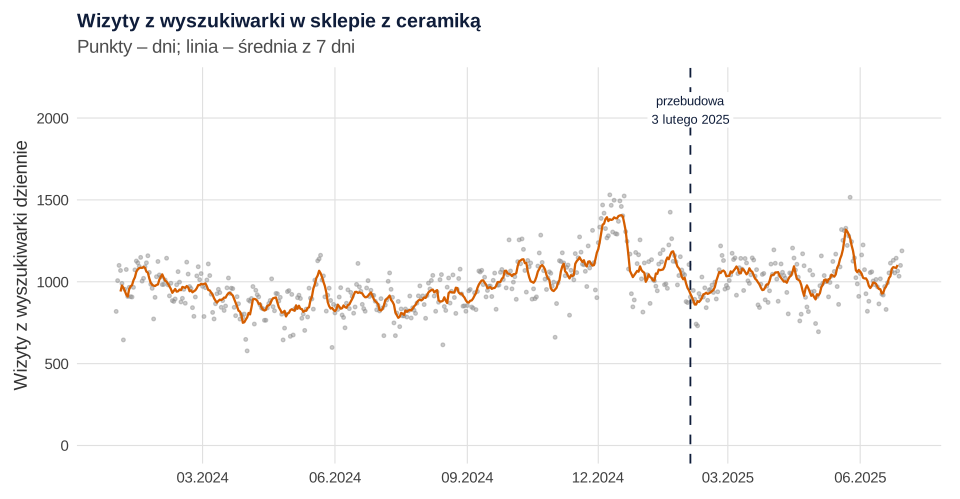
set.seed(742)).Co widać. Ruch ma wyraźny rytm: mniej wizyt w soboty, więcej w poniedziałki, szczyt w grudniu (prezenty) i przed Dniem Matki, dołki w dni wolne. Po przebudowie średnia 7-dniowa spada, a po kilku tygodniach wraca i rośnie. To sezonowość i kalendarz, które model musi opisać najpierw.
Jak może zmylić. Przebudowa w lutym trafiła na sezonowy spadek po grudniowym szczycie – część „spadku” to kalendarz. Porównywanie miesięcy rok do roku omawia osobny wpis o efektach kalendarza.
Podpis do pracy:
Rysunek 2: przed – przejście – po
Wyszukiwarka musi odkryć nowe adresy i przenieść na nie pozycje starych, więc po przebudowie najpierw przychodzi spadek, potem odbicie, a dopiero później ewentualny trwały zysk. Dlatego oś czasu dzielimy na trzy okresy. Lopez Bernal i in. (2016) zalecają, by przewidywany kształt wpływu interwencji określić przed analizą.
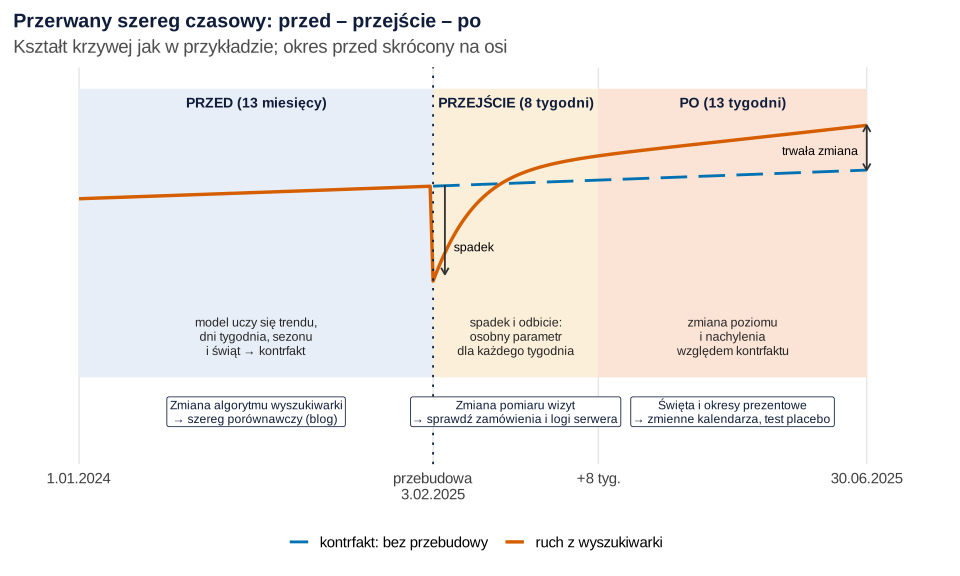
Co widać. Okres „przed” służy do zbudowania kontrfaktu – przebiegu, jaki ruch miałby bez przebudowy (to pojęcie z modelu potencjalnych wyników). W „przejściu” każdy z 8 tygodni dostaje własny parametr, więc spadek i odbicie nie wpływają na oszacowanie trwałej zmiany.
Jak może zmylić. Kontrfakt to założenie, nie obserwacja. Długość przejścia (8 tygodni) trzeba ustalić przed obejrzeniem wyników; dobieranie jej pod ładny wynik to p-hacking. Zagrożenia z dolnej części schematu omawiamy przy rysunkach 4–6.
Rysunek 3: model segmentowy z okresem przejściowym
Modelujemy logarytm dziennych wizyt, bo dni tygodnia i święta działają procentowo. Po prawej stronie: czas (trend), dzień tygodnia, para sinus–cosinus o okresie roku, święta, okres przed Gwiazdką i tydzień Dnia Matki. Podobnie Bell i Hillmer (1983) łączą część regresyjną (skład dni, święta) z modelem ARIMA dla autokorelacji. Do tego dochodzą zmienne przerwania: po (zmiana poziomu L), dni_po (zmiana nachylenia S) i osiem zmiennych tygodni przejścia. Efekt po k dniach (poza przejściem) to:
Reszty kolejnych dni są skorelowane (r = .37 przy opóźnieniu 1). To autokorelacja reszt, przez którą zwykłe błędy standardowe są za małe. Turner i in. (2021) pokazali w symulacji, że metody analizy ITS zwykle zaniżają autokorelację, więc przedziały bywają za wąskie. Mamy dwie poprawki: błędy HAC Neweya–Westa, odporne na autokorelację i niejednorodną wariancję (Newey i West, 1987; opóźnienie 14 dni), albo regresję z błędem ARMA – tu wybrany został AR(2). Model ARIMA pozwala też elastycznie modelować kształt wpływu (Schaffer i in., 2021).
| Model | Zmiana poziomu L (%) | Zmiana nachylenia S (% na 30 dni) | Efekt po 147 dniach (%) |
|---|---|---|---|
| MNK bez okresu przejściowego | −8.1 [−11.8, −4.4] | 5.0 [3.9, 6.2] | 16.9 [11.3, 22.8] |
| MNK, zwykłe błędy | 2.8 [−4.4, 10.6] | 2.2 [0.4, 4.1] | 14.5 [9.0, 20.2] |
| MNK, błędy HAC | 2.8 [−5.3, 11.6] | 2.2 [−0.2, 4.7] | 14.5 [6.7, 22.7] |
| Regresja z błędem AR(2) | 2.3 [−8.4, 14.3] | 2.3 [−0.5, 5.3] | 14.6 [6.2, 23.7] |
| Prawda (symulacja) | 4.1 | 1.5 | 12.0 |
Model bez okresu przejściowego „widzi” głęboki spadek poziomu (−8.1%) i stromy wzrost (+5.0% na 30 dni), bo odbicie udaje trend. Po dodaniu tygodni przejścia oszacowania zbliżają się do prawdy. Hausman i Rapson (2018) ostrzegają właśnie przed tym: gdy efekty krótko- i długookresowe się różnią, oszacowanie z jednego skoku może być obciążone. Z HAC zmiana nachylenia przestaje być istotna (p = .074), ale efekt po 147 dniach – nie.
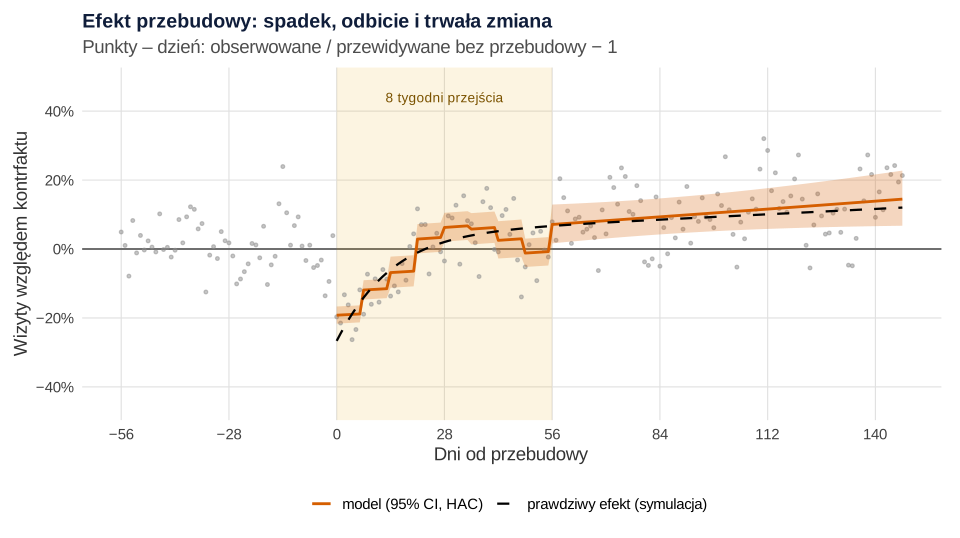
Co widać. W 1. tygodniu ruch był o 19.0% niższy niż kontrfakt, 95% CI [−21.5, −16.5] (prawda: −20.6%), w 2. tygodniu o 11.7%, w 3. o 6.6%. Od 4. tygodnia jest powyżej zera. W ośmiu tygodniach przejścia sklep miał 55 568 wizyt, a według modelu bez przebudowy miałby 57 001 – bilans to 1433 wizyty mniej. Przed przebudową punkty krążą wokół zera bez wyraźnego wzoru – kalendarz dobrze opisuje dni sprzed zmiany.
Jak może zmylić. Pasmo nie obejmuje niepewności samego kontrfaktu przy wyborze innego modelu kalendarza. Bez zmiennych świąt efekt po 147 dniach wynosi 11.6%, ale z przedziałem [−2.0, 27.1] – dwa razy szerszym. Pojedyncze tygodnie są głośne: w 8. tygodniu model daje −1.0%, a prawda to +6.3%.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: szereg porównawczy – blog bez zmian
Przerwany szereg ma jedną dużą słabość: nie odróżnia przebudowy od innego zdarzenia z tego samego czasu. Lopez Bernal i in. (2018) piszą, że szereg kontrolny daje porównanie przed–po i interwencja–kontrola, ale trzeba go dobrać z góry, myśląc o możliwych zakłóceniach. Naszą grupą porównawczą są wizyty z wyszukiwarki na podstronach bloga, których przebudowa nie dotknęła. Modelujemy różnicę log(sklep) − log(blog) tym samym modelem – to różnica w różnicach w wersji dla szeregów.
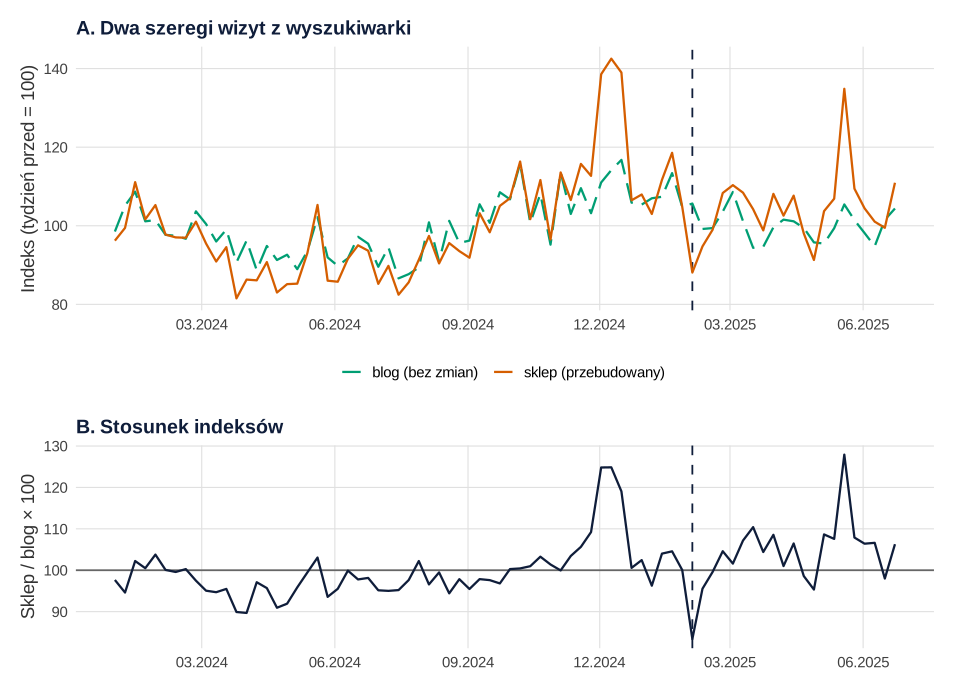
Co widać. Przed przebudową dzienne wahania obu szeregów są skorelowane (r = .53 dla reszt modeli kalendarza) – oba reagują na to, co dzieje się w wyszukiwarce. Model różnicy daje efekt po 147 dniach 8.7%, 95% CI [3.8, 13.8], węższy niż dla samego sklepu [6.7, 22.7]. Prawdziwe 12.0% mieści się w obu przedziałach. Sam blog, potraktowany jak wynik placebo, nie ma istotnej zmiany: 5.3%, 95% CI [−1.1, 12.1], p = .107.
Jak może zmylić. Blog nie jest idealną kontrolą: ma inny rytm tygodnia i mniej prezentowych szczytów, a nowe menu może przenosić ruch między blogiem a sklepem. Gdy masz kilka szeregów bez zmian, rozważ syntetyczną kontrolę.
Zdanie do Wyników:
Rysunek 5: test placebo w czasie
Czy spadek po 3 lutego jest nietypowy, czy podobne „efekty” zdarzają się w zwykłych tygodniach? Każdy poniedziałek sprzed przebudowy traktujemy jak fikcyjną datę zmiany i liczymy średnią zmianę wizyt w 4 tygodniach od niej, z tym samym kalendarzem. Takich dat jest 50.
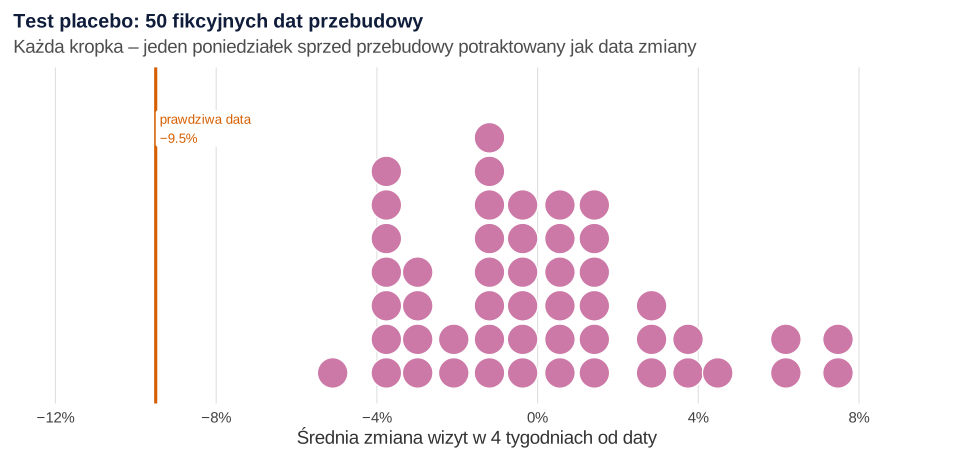
Co widać. Fikcyjne daty dają „efekty” od −5.1% do 7.7% (SD = 3.0 punktu procentowego). Prawdziwa data daje −9.5% – mniej niż każda z 50 dat placebo. Spadek w pierwszym miesiącu nie jest więc zwykłym wahaniem ruchu.
Jak może zmylić. Test placebo sprawdza tylko, czy zmiana jest nietypowa w tym szeregu. Nie wykluczy zdarzenia, które zbiegło się z przebudową. Przy 50 datach najmniejsze możliwe „p” to 1/51.
Zdanie do Wyników:
Rysunek 6: zakłócenia, których nie widać w danych
Dwa zdarzenia mogą zbiec się z przebudową i nie zostawić śladu w samym szeregu sklepu: zmiana algorytmu wyszukiwarki (ruch spada wszystkim stronom) i zmiana pomiaru (np. nowy kod statystyk na stronach sklepu rejestruje mniej wizyt). To klasyczne zagrożenie „historii” dla trafności wewnętrznej. Symulujemy po 1000 sklepów w trzech scenariuszach: (A) bez zakłóceń, (B) algorytm 10 dni po przebudowie obniża o 8% ruch z wyszukiwarki w sklepie i na blogu, (C) od dnia przebudowy pomiar w sklepie gubi 10% wizyt.
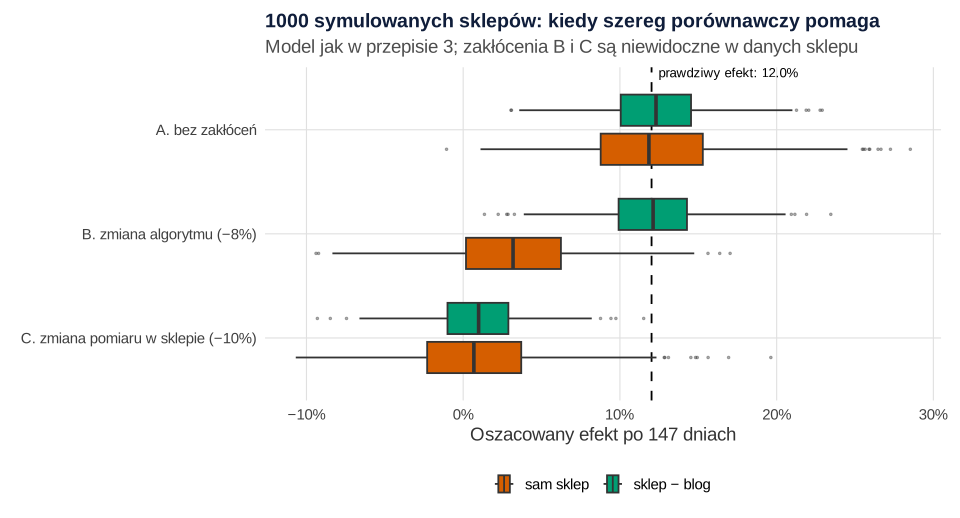
set.seed(7421)).Co widać. Bez zakłóceń obie metody trafiają w 12.0% (średnio 12.2% i 12.3%), a różnica sklep − blog ma mniejszy rozrzut (SD 3.2 wobec 4.9 punktu procentowego). Zmiana algorytmu zaniża samą analizę sklepu do 3.3% (obciążenie −8.7 punktu), a szereg porównawczy ją usuwa (12.1%). Zmiana pomiaru w sklepie psuje obie metody (0.9%), bo blogu nie dotyczy.
Jak może zmylić. W danych sklepu scenariusze B i C wyglądają identycznie jak słabsza przebudowa. Kontrola chroni tylko przed tym, co działa także na nią. Zmianę pomiaru wykryjesz, porównując wizyty z niezależnym źródłem: liczbą zamówień, logami serwera albo raportem wyszukiwarki o kliknięciach.
Zdanie do Dyskusji:
Co z tym zrobić w marketingu
- Zaplanuj analizę przed przebudową. Zapisz datę, długość przejścia, wskaźnik i szereg porównawczy; zbieraj dane dzienne co najmniej rok wstecz.
- Raportuj trzy liczby, nie jedną. Głębokość spadku (tu −19.0% w 1. tygodniu), bilans przejścia (1433 wizyty mniej w 8 tygodniach) i efekt po zakończeniu przejścia z przedziałem (14.5% [6.7, 22.7] po 147 dniach).
- Zostaw część witryny bez zmian. Blog, kategoria albo wersja językowa bez przebudowy to tania kontrola.
- Sprawdzaj pomiar. Przy każdej przebudowie porównaj wizyty z zamówieniami i z kliknięciami z raportu wyszukiwarki.
- Nie oceniaj po tygodniu. Po 4 tygodniach model widział jeszcze tylko przejście; o trwałym efekcie mówi dopiero okres po nim. Podobny problem – brak grupy kontrolnej i przebieg „co by było” – rozwiązujemy przy ocenie współpracy z twórcą.
Jak opisać w pracy
Opisz szereg, datę i kształt efektu ustalony z góry, zmienne kalendarza, sposób liczenia błędów standardowych, szereg porównawczy i test placebo. Okres przejściowy z osobnymi tygodniami to w istocie badanie zdarzeń połączone z regresją segmentową.
Kod R: dane dzienne, regresja segmentowa z przejściem, HAC, szereg porównawczy i placebo
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, kalendarz, paletę i motyw oraz funkcję symuluj(), przepis 3 – model m i funkcję tab(), z których korzystają następne. Przepisy kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne. Model z błędem ARMA liczy funkcja auto.arima() z pakietu forecast, błędy HAC – funkcja NeweyWest() z pakietu sandwich.
Losują przepisy 1 (set.seed(742)) i 6 (set.seed(7421)); ziarna ustalono raz i nie zmieniano. Ręcznie ustalono (skala logarytmu wizyt): poziom sklepu log(900) i bloga log(350); trend 0.0003 i 0.0002 dziennie; efekty dni tygodnia sklepu (względem czwartku) pon 0.06, wt 0.05, śr 0.03, pt −0.05, sob −0.12, nd −0.02 i bloga sob 0.05, nd 0.08; sezon roczny ze szczytem w połowie grudnia (amplituda 0.10 i 0.06); dni wolne −0.30 i −0.15; okres 1–21 grudnia +0.25 i +0.05; tydzień Dnia Matki (18–25 maja) +0.20 i +0.05; wspólne wahania wyszukiwarki AR(1) z φ = .6 i SD = 0.05 oraz własne wahania każdego szeregu AR(1) z φ = .3 i SD = 0.03; liczby wizyt z rozkładu Poissona; efekt przebudowy L = 0.04, S = 0.0005 dziennie, spadek T = −0.35 i stała czasowa τ = 12 dni. Ręcznie ustalono też decyzje analityczne: 8 tygodni przejścia, opóźnienie 14 dni w błędach HAC, okno 4 tygodni w teście placebo, zakłócenia w symulacji (−8% i −10%) i 1000 powtórzeń. Po pierwszym uruchomieniu nie zmieniano parametrów danych ani ziaren; poprawiono tylko wygląd rysunków 2, 3 i 5 (opisy i zakres osi, strzałka „trwała zmiana”) i wydruk tabeli w przepisie 4. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się ok. 5 sekund.
1. Dane: 547 dni wizyt w sklepie i na blogu, Rysunek 1
R
# Przepis 1. Fikcyjny sklep internetowy z ceramiką i naczyniami: dzienne wizyty z wyszukiwarki
# od 1 stycznia 2024 do 30 czerwca 2025 (18 miesięcy). Sklep przebudowano 3 lutego 2025.
# Drugi szereg: wizyty z wyszukiwarki na podstronach bloga z poradami, których przebudowa nie objęła.
library(ggplot2)
options(width = 120)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c(obserwowane = "grey55", model = "#D55E00", kontrfakt = "#0072B2", prawda = "#000000",
         blog = "#009E73", przejscie = "#E69F00", placebo = "#CC79A7")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)                  # znak minus (−) w etykietach rysunków

# Kalendarz: dni, dzień tygodnia, sezon roczny (para sinus–cosinus), święta i okresy prezentowe
data <- seq(as.Date("2024-01-01"), as.Date("2025-06-30"), by = "day")
przebudowa <- as.Date("2025-02-03")                      # poniedziałek – nowa wersja sklepu
dni_wolne <- as.Date(c("2024-01-01", "2024-01-06", "2024-03-31", "2024-04-01", "2024-05-01", "2024-05-03",
                       "2024-05-30", "2024-08-15", "2024-11-01", "2024-11-11", "2024-12-24", "2024-12-25",
                       "2024-12-26", "2025-01-01", "2025-01-06", "2025-04-20", "2025-04-21", "2025-05-01",
                       "2025-05-03", "2025-06-19"))
kal <- data.frame(data = data, czas = seq_along(data),
                  dzien_tyg = factor(format(data, "%u"), levels = c(4, 1:3, 5:7),
                                     labels = c("czw", "pon", "wt", "śr", "pt", "sob", "nd")))
doy <- as.numeric(format(data, "%j"))
kal$sin_rok <- sin(2 * pi * doy / 365.25); kal$cos_rok <- cos(2 * pi * doy / 365.25)
kal$swieto <- as.integer(data %in% dni_wolne)
kal$przed_gwiazdka <- as.integer(format(data, "%m") == "12" & as.numeric(format(data, "%d")) <= 21)
kal$dzien_matki <- as.integer(format(data, "%m") == "05" & as.numeric(format(data, "%d")) %in% 18:25)
# Zmienne przerwanego szeregu: po (0/1), dni_po (0 w dniu przebudowy), tydzień przejścia 1–8
kal$po <- as.integer(data >= przebudowa)
kal$dni_po <- pmax(0, as.numeric(data - przebudowa))
kal$tydz_po <- ifelse(kal$po == 1, kal$dni_po %/% 7 + 1, 0)
kal$przejscie <- factor(ifelse(kal$po == 1 & kal$tydz_po <= 8, paste0("t", kal$tydz_po), "poza"),
                        levels = c("poza", paste0("t", 1:8)))

# Parametry ustalone ręcznie (skala logarytmu wizyt)
param <- list(poziom_sklep = log(900), trend_sklep = 0.0003,              # +0.03% dziennie (ok. 11.6% rocznie)
              tydz_sklep = c(czw = 0, pon = 0.06, wt = 0.05, `śr` = 0.03, pt = -0.05, sob = -0.12, nd = -0.02),
              sezon_sklep = 0.10, swieto_sklep = -0.30, gwiazdka_sklep = 0.25, matki_sklep = 0.20,
              poziom_blog = log(350), trend_blog = 0.0002,
              tydz_blog = c(czw = 0, pon = 0, wt = 0, `śr` = 0, pt = 0, sob = 0.05, nd = 0.08),
              sezon_blog = 0.06, swieto_blog = -0.15, gwiazdka_blog = 0.05, matki_blog = 0.05,
              wspolny_ar = 0.6, wspolny_sd = 0.05, wlasny_ar = 0.3, wlasny_sd = 0.03,
              L = 0.04, S = 0.0005, T = -0.35, tau = 12)           # prawdziwy efekt przebudowy (tylko sklep)
# Prawdziwy efekt przebudowy po k dniach: L + S·k + T·exp(−k/τ) – spadek, odbicie i trwała zmiana
efekt_prawdziwy <- function(k, p = param) p$L + p$S * k + p$T * exp(-k / p$tau)

symuluj <- function(p = param, kal_ = kal, algorytm = 0, pomiar = 0) {
  n <- nrow(kal_)
  wspolny <- as.numeric(arima.sim(list(ar = p$wspolny_ar), n, sd = p$wspolny_sd))   # wahania całej wyszukiwarki
  e_s <- as.numeric(arima.sim(list(ar = p$wlasny_ar), n, sd = p$wlasny_sd))
  e_b <- as.numeric(arima.sim(list(ar = p$wlasny_ar), n, sd = p$wlasny_sd))
  sezon <- cos(2 * pi * (as.numeric(format(kal_$data, "%j")) - 345) / 365.25)        # szczyt w połowie grudnia
  # Zakłócenia do pułapek (domyślnie wyłączone): zmiana algorytmu wyszukiwarki 10 dni po przebudowie
  # (działa na sklep i blog) i zmiana pomiaru wizyt tylko na stronach sklepu od dnia przebudowy
  alg <- algorytm * as.integer(kal_$dni_po >= 10 & kal_$po == 1)
  mu_s <- p$poziom_sklep + p$trend_sklep * kal_$czas + p$tydz_sklep[as.character(kal_$dzien_tyg)] +
    p$sezon_sklep * sezon + p$swieto_sklep * kal_$swieto + p$gwiazdka_sklep * kal_$przed_gwiazdka +
    p$matki_sklep * kal_$dzien_matki + kal_$po * efekt_prawdziwy(kal_$dni_po, p) + wspolny + e_s + alg + pomiar * kal_$po
  mu_b <- p$poziom_blog + p$trend_blog * kal_$czas + p$tydz_blog[as.character(kal_$dzien_tyg)] +
    p$sezon_blog * sezon + p$swieto_blog * kal_$swieto + p$gwiazdka_blog * kal_$przed_gwiazdka +
    p$matki_blog * kal_$dzien_matki + wspolny + e_b + alg
  data.frame(sklep = rpois(n, exp(mu_s)), blog = rpois(n, exp(mu_b)))
}

set.seed(742)
dane <- cbind(kal, symuluj())
write.csv(dane[, c("data", "dzien_tyg", "swieto", "przed_gwiazdka", "dzien_matki", "po", "dni_po", "sklep", "blog")],
          "ruch-wyszukiwarka-ceramika-dzienne.csv", row.names = FALSE, fileEncoding = "UTF-8")

c(dni = nrow(dane), dni_przed = sum(dane$po == 0), dni_po = sum(dane$po == 1))
okres <- factor(ifelse(dane$po == 0, "przed", ifelse(dane$tydz_po <= 8, "przejście (8 tyg.)", "po przejściu")),
                levels = c("przed", "przejście (8 tyg.)", "po przejściu"))
round(cbind(sklep = tapply(dane$sklep, okres, mean), blog = tapply(dane$blog, okres, mean)), 1)
# Naiwne porównanie średnich dziennych: wszystkie dni po przebudowie vs wszystkie przed (%)
round(100 * (mean(dane$sklep[dane$po == 1]) / mean(dane$sklep[dane$po == 0]) - 1), 1)
head(dane[dane$data >= przebudowa - 2, c("data", "dzien_tyg", "po", "dni_po", "przejscie", "sklep", "blog")], 5)

# Rysunek 1: dzienne wizyty z wyszukiwarki i średnia 7-dniowa
dane$sr7 <- as.numeric(stats::filter(dane$sklep, rep(1 / 7, 7), sides = 2))
p1 <- ggplot(dane, aes(data)) +
  geom_point(aes(y = sklep), colour = kol["obserwowane"], alpha = 0.45, size = 0.9) +
  geom_line(aes(y = sr7), colour = kol["model"], linewidth = 0.8, na.rm = TRUE) +
  geom_vline(xintercept = przebudowa, linetype = "dashed", colour = "#0f1d3a") +
  annotate("label", x = przebudowa, y = 2050, label = "przebudowa\n3 lutego 2025", size = 3.4, hjust = 0.5,
           linewidth = 0, fill = "white", colour = "#0f1d3a") +
  scale_x_date(date_breaks = "3 months", date_labels = "%m.%Y") +
  scale_y_continuous(limits = c(0, 2200), breaks = seq(0, 2000, 500)) +
  labs(x = NULL, y = "Wizyty z wyszukiwarki dziennie", title = "Wizyty z wyszukiwarki w sklepie z ceramiką",
       subtitle = "Punkty – dni; linia – średnia z 7 dni") +
  motyw
p1   # zapis: ggsave("ruch-wyszukiwarka-dane-dzienne.svg", p1, width = 10, height = 5.2)
Wynik w R
      dni dni_przed    dni_po
      547       399       148
                    sklep  blog
przed               977.7 372.9
przejście (8 tyg.)  992.3 376.0
po przejściu       1038.4 372.7
[1] 4.4
          data dzien_tyg po dni_po przejscie sklep blog
398 2025-02-01       sob  0      0      poza   873  383
399 2025-02-02        nd  0      0      poza  1105  430
400 2025-02-03       pon  1      0        t1   907  406
401 2025-02-04        wt  1      1        t1   881  414
402 2025-02-05        śr  1      2        t1   947  387
2. Grafika: schemat przed – przejście – po, Rysunek 2
R
# Przepis 2. Grafika: schemat „przed – przejście – po” z kontrfaktem i listą zagrożeń. Rysunek 2.
# Korzysta z obiektów przepisu 1: efekt_prawdziwy, kol, motyw. Niczego nie losuje.
os <- data.frame(k = -120:147)
os$kontrfakt <- 100 * exp(0.0003 * (os$k + 120))                       # trend bez przebudowy
os$obserwowane <- os$kontrfakt * exp(ifelse(os$k >= 0, efekt_prawdziwy(pmax(os$k, 0)), 0))
fazy <- data.frame(x0 = c(-120, 0, 56), x1 = c(0, 56, 147),
                   nazwa = c("PRZED (13 miesięcy)", "PRZEJŚCIE (8 tygodni)", "PO (13 tygodni)"),
                   opis = c("model uczy się trendu,\ndni tygodnia, sezonu\ni świąt → kontrfakt",
                            "spadek i odbicie:\nosobny parametr\ndla każdego tygodnia",
                            "zmiana poziomu\ni nachylenia\nwzględem kontrfaktu"),
                   kolor = c("#E8EEF7", "#FBEFD9", "#FBE3D6"))
zagrozenia <- data.frame(x = c(-60, 28, 101.5), y = 38,
                         tekst = c("Zmiana algorytmu wyszukiwarki\n→ szereg porównawczy (blog)",
                                   "Zmiana pomiaru wizyt\n→ sprawdź zamówienia i logi serwera",
                                   "Święta i okresy prezentowe\n→ zmienne kalendarza, test placebo"))
p2 <- ggplot() +
  geom_rect(data = fazy, aes(xmin = x0, xmax = x1, ymin = 48, ymax = 132), fill = fazy$kolor, colour = NA) +
  geom_text(data = fazy, aes(x = (x0 + x1) / 2, y = 128, label = nazwa), fontface = "bold", size = 3.7, colour = "#0f1d3a") +
  geom_text(data = fazy, aes(x = (x0 + x1) / 2, y = 60, label = opis), size = 3.3, lineheight = 0.95, colour = "grey15") +
  geom_line(data = os[os$k >= 0, ], aes(k, kontrfakt, linetype = "kontrfakt: bez przebudowy"), colour = kol["kontrfakt"], linewidth = 1) +
  geom_line(data = os, aes(k, obserwowane, linetype = "ruch z wyszukiwarki"), colour = kol["model"], linewidth = 1.2) +
  geom_vline(xintercept = 0, colour = "#0f1d3a", linetype = "dotted") +
  annotate("segment", x = 4, xend = 4, y = 104, yend = 78, arrow = arrow(length = unit(2, "mm")), colour = "grey20") +
  annotate("text", x = 7, y = 86, label = "spadek", hjust = 0, size = 3.3) +
  annotate("segment", x = 147, xend = 147, y = 100 * exp(0.0003 * 267), yend = max(os$obserwowane),
           arrow = arrow(length = unit(2, "mm"), ends = "both"), colour = "grey20") +
  annotate("text", x = 144, y = 114, label = "trwała zmiana", hjust = 1, size = 3.3) +
  geom_label(data = zagrozenia, aes(x, y, label = tekst), size = 3.2, lineheight = 0.95, fill = "white",
             colour = "#0f1d3a", linewidth = 0.3) +
  scale_linetype_manual(values = c("kontrfakt: bez przebudowy" = "longdash", "ruch z wyszukiwarki" = "solid"), name = NULL) +
  scale_x_continuous(limits = c(-128, 158), breaks = c(-120, 0, 56, 147),
                     labels = c("1.01.2024", "przebudowa\n3.02.2025", "+8 tyg.", "30.06.2025")) +
  scale_y_continuous(limits = c(28, 133), breaks = NULL) +
  labs(x = NULL, y = NULL, title = "Przerwany szereg czasowy: przed – przejście – po",
       subtitle = "Kształt krzywej jak w przykładzie; okres przed skrócony na osi") +
  motyw + theme(panel.grid = element_blank())
p2   # zapis: ggsave("ruch-wyszukiwarka-schemat.svg", p2, width = 10, height = 6)
3. Regresja segmentowa, błędy HAC i błąd ARMA, Rysunek 3
R
# Przepis 3. Regresja segmentowa na logarytmie dziennych wizyt: zmiana poziomu i nachylenia,
# 8 tygodni przejścia, błędy HAC (Newey–West) i model z błędem ARMA. Rysunek 3.
# Korzysta z obiektów przepisu 1: dane, param, przebudowa, efekt_prawdziwy, kol, motyw, minus. Niczego nie losuje.
library(sandwich)
library(forecast)

kalendarz <- "dzien_tyg + sin_rok + cos_rok + swieto + przed_gwiazdka + dzien_matki"
f_bez_przejscia <- as.formula(paste("log(sklep) ~ czas +", kalendarz, "+ po + dni_po"))
f_pelny <- as.formula(paste("log(sklep) ~ czas +", kalendarz, "+ po + dni_po + przejscie"))
m_bez <- lm(f_bez_przejscia, data = dane)
m <- lm(f_pelny, data = dane)

# Błędy standardowe: zwykłe (MNK) i odporne na autokorelację (HAC, Newey–West, opóźnienie 14 dni)
V_hac <- NeweyWest(m, lag = 14, prewhite = FALSE)
c(autokorelacja_reszt_lag1 = round(acf(resid(m), plot = FALSE)$acf[2], 2))
k_kon <- max(dane$dni_po)                                 # ostatni dzień danych: 147 dni po przebudowie
kombinacje <- rbind("zmiana poziomu (L)" = c(po = 1, dni_po = 0),
                    "zmiana nachylenia (S, na 30 dni)" = c(po = 0, dni_po = 30),
                    "efekt po 147 dniach (L + 147·S)" = c(po = 1, dni_po = k_kon))
liniowa <- function(model, V, w) {                        # oszacowanie i SE kombinacji współczynników
  b <- coef(model)[colnames(w)]; Vs <- V[colnames(w), colnames(w)]
  cbind(b = drop(w %*% b), se = sqrt(diag(w %*% Vs %*% t(w))))
}
proc <- function(x) 100 * (exp(x) - 1)                    # skala logarytmu -> zmiana w %
tab <- function(model, V) {
  r <- liniowa(model, V, kombinacje)
  data.frame(proc = proc(r[, "b"]), dolna = proc(r[, "b"] - 1.96 * r[, "se"]), gorna = proc(r[, "b"] + 1.96 * r[, "se"]),
             p = 2 * pnorm(-abs(r[, "b"] / r[, "se"])), row.names = rownames(kombinacje))
}
# Model z błędem ARMA (rząd wybrany przez auto.arima, bez różnicowania) i tymi samymi zmiennymi
X <- model.matrix(m)[, -1]
m_arma <- auto.arima(log(dane$sklep), xreg = X, d = 0, seasonal = FALSE)
arimaorder(m_arma)
V_arma <- vcov(m_arma)
wyniki <- list("MNK, bez przejścia" = tab(m_bez, vcov(m_bez)), "MNK" = tab(m, vcov(m)),
               "MNK + HAC" = tab(m, V_hac),
               "błąd ARMA" = {
                 b <- coef(m_arma)[colnames(kombinacje)]; Vs <- V_arma[colnames(kombinacje), colnames(kombinacje)]
                 bb <- drop(kombinacje %*% b); se <- sqrt(diag(kombinacje %*% Vs %*% t(kombinacje)))
                 data.frame(proc = proc(bb), dolna = proc(bb - 1.96 * se), gorna = proc(bb + 1.96 * se),
                            p = 2 * pnorm(-abs(bb / se)), row.names = rownames(kombinacje)) })
for (nazwa in names(wyniki)) { cat("\n==", nazwa, "\n"); print(round(wyniki[[nazwa]], 3)) }
# Prawdziwe wartości (znane tylko w symulacji), w %
round(c(L = proc(param$L), S_30_dni = proc(30 * param$S), efekt_147 = proc(param$L + k_kon * param$S)), 2)

# Efekt w tygodniach przejścia: L + S·k + t_w (środek tygodnia), z 95% CI z macierzy HAC
tyg <- t(sapply(1:8, function(w) {
  nazwy <- c("po", "dni_po", paste0("przejsciet", w)); wv <- matrix(c(1, 7 * (w - 1) + 3, 1), 1, dimnames = list(NULL, nazwy))
  r <- liniowa(m, V_hac, wv); c(tydzien = w, proc = proc(r[1]), dolna = proc(r[1] - 1.96 * r[2]),
                                 gorna = proc(r[1] + 1.96 * r[2]), prawda = proc(efekt_prawdziwy(7 * (w - 1) + 3)))
}))
round(tyg, 1)
# Bilans przejścia: ile wizyt mniej niż bez przebudowy w 8 tygodniach (oszacowanie z modelu)
kontrfakt <- exp(predict(m, newdata = transform(dane, po = 0, dni_po = 0, przejscie = factor("poza", levels(dane$przejscie)))))
okno <- dane$po == 1 & dane$tydz_po <= 8
round(c(wizyty_8_tyg = sum(dane$sklep[okno]), kontrfakt_8_tyg = sum(kontrfakt[okno]),
        roznica = sum(dane$sklep[okno] - kontrfakt[okno])))
# Wrażliwość: ten sam model bez zmiennych świąt i okresów prezentowych
m_bez_kal <- lm(update(f_pelny, . ~ . - swieto - przed_gwiazdka - dzien_matki), data = dane)
round(rbind(z_kalendarzem = tab(m, V_hac)[3, ], bez_kalendarza = tab(m_bez_kal, NeweyWest(m_bez_kal, lag = 14, prewhite = FALSE))[3, ]), 3)

# Rysunek 3: dzienna różnica obserwowane/kontrfakt (%) i krzywa efektu z modelu
dzien <- data.frame(k = as.numeric(dane$data - przebudowa), roznica = 100 * (dane$sklep / kontrfakt - 1))
dzien <- dzien[dzien$k >= -56, ]
krzywa <- do.call(rbind, lapply(0:k_kon, function(k) {
  w <- if (k < 56) k %/% 7 + 1 else NA
  nazwy <- c("po", "dni_po", if (!is.na(w)) paste0("przejsciet", w))
  wv <- matrix(c(1, k, if (!is.na(w)) 1), 1, dimnames = list(NULL, nazwy))
  r <- liniowa(m, V_hac, wv)
  data.frame(k = k, proc = proc(r[1]), dolna = proc(r[1] - 1.96 * r[2]), gorna = proc(r[1] + 1.96 * r[2]),
             prawda = proc(efekt_prawdziwy(k)))
}))
p3 <- ggplot() +
  geom_hline(yintercept = 0, colour = "grey40") +
  annotate("rect", xmin = 0, xmax = 56, ymin = -Inf, ymax = Inf, fill = kol["przejscie"], alpha = 0.12) +
  annotate("text", x = 28, y = 44, label = "8 tygodni przejścia", size = 3.6, colour = "#7a5200") +
  geom_point(data = dzien, aes(k, roznica), colour = kol["obserwowane"], alpha = 0.5, size = 0.9) +
  geom_ribbon(data = krzywa, aes(k, ymin = dolna, ymax = gorna), fill = kol["model"], alpha = 0.25) +
  geom_line(data = krzywa, aes(k, proc, linetype = "model (95% CI, HAC)"), colour = kol["model"], linewidth = 1) +
  geom_line(data = krzywa, aes(k, prawda, linetype = "prawdziwy efekt (symulacja)"), colour = kol["prawda"], linewidth = 0.8) +
  scale_linetype_manual(values = c("model (95% CI, HAC)" = "solid", "prawdziwy efekt (symulacja)" = "dashed"), name = NULL) +
  scale_x_continuous(breaks = seq(-56, 147, 28), labels = minus) +
  scale_y_continuous(limits = c(-45, 48), breaks = seq(-40, 40, 20), labels = function(x) minus(paste0(x, "%"))) +
  labs(x = "Dni od przebudowy", y = "Wizyty względem kontrfaktu",
       title = "Efekt przebudowy: spadek, odbicie i trwała zmiana",
       subtitle = "Punkty – dzień: obserwowane / przewidywane bez przebudowy − 1") +
  motyw
p3   # zapis: ggsave("ruch-wyszukiwarka-krzywa-efektu.svg", p3, width = 10, height = 5.6)
Wynik w R
autokorelacja_reszt_lag1
                    0.37
p d q
2 0 0

== MNK, bez przejścia
                                   proc   dolna  gorna p
zmiana poziomu (L)               -8.134 -11.752 -4.368 0
zmiana nachylenia (S, na 30 dni)  5.038   3.931  6.158 0
efekt po 147 dniach (L + 147·S)  16.885  11.255 22.801 0

== MNK
                                   proc  dolna  gorna     p
zmiana poziomu (L)                2.837 -4.394 10.616 0.452
zmiana nachylenia (S, na 30 dni)  2.210  0.354  4.101 0.019
efekt po 147 dniach (L + 147·S)  14.466  9.007 20.199 0.000

== MNK + HAC
                                   proc  dolna  gorna     p
zmiana poziomu (L)                2.837 -5.251 11.616 0.503
zmiana nachylenia (S, na 30 dni)  2.210 -0.210  4.689 0.074
efekt po 147 dniach (L + 147·S)  14.466  6.749 22.741 0.000

== błąd ARMA
                                   proc  dolna  gorna     p
zmiana poziomu (L)                2.319 -8.434 14.335 0.686
zmiana nachylenia (S, na 30 dni)  2.344 -0.485  5.254 0.105
efekt po 147 dniach (L + 147·S)  14.622  6.173 23.744 0.000
        L  S_30_dni efekt_147
     4.08      1.51     12.02
     tydzien  proc dolna gorna prawda
[1,]       1 -19.0 -21.5 -16.5  -20.6
[2,]       2 -11.7 -14.5  -8.9  -10.2
[3,]       3  -6.6 -11.0  -2.0   -3.6
[4,]       4   3.1  -1.0   7.4    0.5
[5,]       5   6.5   2.4  10.7    2.9
[6,]       6   6.0   1.6  10.6    4.5
[7,]       7   2.7  -2.5   8.3    5.6
[8,]       8  -1.0  -5.0   3.2    6.3
   wizyty_8_tyg kontrfakt_8_tyg         roznica
          55568           57001           -1433
                 proc  dolna  gorna     p
z_kalendarzem  14.466  6.749 22.741 0.000
bez_kalendarza 11.575 -2.022 27.058 0.099
4. Szereg porównawczy i różnica w różnicach, Rysunek 4
R
# Przepis 4. Szereg porównawczy: podstrony bloga, których przebudowa nie objęła.
# Różnica w różnicach w wersji szeregów: model na log(sklep) − log(blog). Rysunek 4.
# Korzysta z obiektów przepisów 1 i 3: dane, przebudowa, kalendarz, kombinacje, tab, m, kol, motyw. Niczego nie losuje.
library(patchwork)

f_rr <- as.formula(paste("I(log(sklep) - log(blog)) ~ czas +", kalendarz, "+ po + dni_po + przejscie"))
f_blog <- as.formula(paste("log(blog) ~ czas +", kalendarz, "+ po + dni_po + przejscie"))
m_rr <- lm(f_rr, data = dane)
m_blog <- lm(f_blog, data = dane)
hac <- function(model) NeweyWest(model, lag = 14, prewhite = FALSE)
porownanie <- rbind(cbind(model = "sam sklep", wielkosc = rownames(kombinacje), tab(m, hac(m))),
                    cbind(model = "sklep − blog", wielkosc = rownames(kombinacje), tab(m_rr, hac(m_rr))),
                    cbind(model = "sam blog (placebo)", wielkosc = rownames(kombinacje), tab(m_blog, hac(m_blog))))
porownanie[, 3:6] <- round(porownanie[, 3:6], 3)
print(porownanie, row.names = FALSE)
# Odchylenie standardowe reszt: sklep vs różnica logarytmów (mniejsze = mniej szumu)
round(c(sd_reszt_sklep = sd(resid(m)), sd_reszt_roznica = sd(resid(m_rr))), 4)
# Korelacja dziennych wahań obu szeregów przed przebudową (reszty modeli bez efektu)
przed <- dane$po == 0
round(cor(resid(lm(log(sklep) ~ czas + dzien_tyg + sin_rok + cos_rok + swieto + przed_gwiazdka + dzien_matki, dane[przed, ])),
          resid(lm(log(blog) ~ czas + dzien_tyg + sin_rok + cos_rok + swieto + przed_gwiazdka + dzien_matki, dane[przed, ]))), 2)

# Rysunek 4: tygodniowe indeksy (średni tydzień przed przebudową = 100) i ich stosunek
dane$tydzien <- (dane$czas - 1) %/% 7 + 1
tygodnie <- aggregate(cbind(sklep, blog, dni = 1) ~ tydzien, data = dane, FUN = sum)
tygodnie <- tygodnie[tygodnie$dni == 7, ]
tygodnie$start <- min(dane$data) + 7 * (tygodnie$tydzien - 1)
tp <- tygodnie$start < przebudowa
tygodnie$i_sklep <- 100 * tygodnie$sklep / mean(tygodnie$sklep[tp])
tygodnie$i_blog <- 100 * tygodnie$blog / mean(tygodnie$blog[tp])
tygodnie$stosunek <- 100 * tygodnie$i_sklep / tygodnie$i_blog
dl <- rbind(data.frame(start = tygodnie$start, indeks = tygodnie$i_sklep, szereg = "sklep (przebudowany)"),
            data.frame(start = tygodnie$start, indeks = tygodnie$i_blog, szereg = "blog (bez zmian)"))
pa <- ggplot(dl, aes(start, indeks, colour = szereg, linetype = szereg)) +
  geom_vline(xintercept = przebudowa, linetype = "dashed", colour = "#0f1d3a") +
  geom_line(linewidth = 0.8) +
  scale_colour_manual(values = c("sklep (przebudowany)" = unname(kol["model"]), "blog (bez zmian)" = unname(kol["blog"])), name = NULL) +
  scale_linetype_manual(values = c("sklep (przebudowany)" = "solid", "blog (bez zmian)" = "longdash"), name = NULL) +
  scale_x_date(date_breaks = "3 months", date_labels = "%m.%Y") +
  labs(x = NULL, y = "Indeks (tydzień przed = 100)", title = "A. Dwa szeregi wizyt z wyszukiwarki") + motyw
pb <- ggplot(tygodnie, aes(start, stosunek)) +
  geom_hline(yintercept = 100, colour = "grey40") +
  geom_vline(xintercept = przebudowa, linetype = "dashed", colour = "#0f1d3a") +
  geom_line(colour = "#0f1d3a", linewidth = 0.8) +
  scale_x_date(date_breaks = "3 months", date_labels = "%m.%Y") +
  labs(x = NULL, y = "Sklep / blog × 100", title = "B. Stosunek indeksów") + motyw
p4 <- pa / pb + plot_layout(heights = c(1.3, 1))
p4   # zapis: ggsave("ruch-wyszukiwarka-szereg-porownawczy.svg", p4, width = 10, height = 7.2)
Wynik w R
              model                         wielkosc   proc  dolna  gorna     p
          sam sklep               zmiana poziomu (L)  2.837 -5.251 11.616 0.503
          sam sklep zmiana nachylenia (S, na 30 dni)  2.210 -0.210  4.689 0.074
          sam sklep  efekt po 147 dniach (L + 147·S) 14.466  6.749 22.741 0.000
       sklep − blog               zmiana poziomu (L)  4.797 -1.904 11.954 0.165
       sklep − blog zmiana nachylenia (S, na 30 dni)  0.750 -0.900  2.428 0.375
       sklep − blog  efekt po 147 dniach (L + 147·S)  8.704  3.834 13.804 0.000
 sam blog (placebo)               zmiana poziomu (L) -1.870 -9.397  6.283 0.643
 sam blog (placebo) zmiana nachylenia (S, na 30 dni)  1.450 -1.058  4.021 0.260
 sam blog (placebo)  efekt po 147 dniach (L + 147·S)  5.300 -1.113 12.129 0.107
  sd_reszt_sklep sd_reszt_roznica
          0.0747           0.0744
[1] 0.53
5. Test placebo z fikcyjnymi datami, Rysunek 5
R
# Przepis 5. Test placebo w czasie: fikcyjne daty przebudowy w okresie przed prawdziwą zmianą.
# Dla każdej daty: średnia zmiana wizyt w 4 tygodniach od niej, z modelu na dniach sprzed przebudowy. Rysunek 5.
# Korzysta z obiektów przepisów 1 i 3: dane, kalendarz, przebudowa, proc, kol, motyw, minus. Niczego nie losuje.
okno4 <- function(start, d) {                             # 4-tygodniowe okno od daty start
  d$okno <- as.integer(d$data >= start & d$data < start + 28)
  b <- coef(lm(as.formula(paste("log(sklep) ~ czas +", kalendarz, "+ okno")), data = d))[["okno"]]
  proc(b)
}
przed_dane <- dane[dane$data < przebudowa, ]
# Prawdziwa data: dni sprzed przebudowy + pierwsze 4 tygodnie po niej
prawdziwa <- okno4(przebudowa, dane[dane$data < przebudowa + 28, ])
# Fikcyjne daty: wszystkie poniedziałki, dla których całe okno mieści się przed przebudową (od 4. tygodnia danych)
daty_placebo <- seq(as.Date("2024-01-29"), przebudowa - 28, by = "week")
placebo <- sapply(daty_placebo, okno4, d = przed_dane)
c(liczba_dat_placebo = length(placebo))
round(c(prawdziwa_proc = prawdziwa, placebo_min = min(placebo), placebo_max = max(placebo),
        placebo_sd = sd(placebo)), 2)
# Odsetek dat placebo z efektem co najmniej tak dużym (co do wartości bezwzględnej) jak prawdziwy
c(odsetek_placebo_ponad_prawdziwy = mean(abs(placebo) >= abs(prawdziwa)))
round(sort(placebo)[c(1:3, length(placebo) - 2:0)], 2)

pl <- data.frame(data = daty_placebo, efekt = placebo)
p5 <- ggplot(pl, aes(efekt)) +
  geom_dotplot(binwidth = 0.8, fill = kol["placebo"], colour = "white", stackratio = 1.1, dotsize = 0.95) +
  geom_vline(xintercept = prawdziwa, colour = kol["model"], linewidth = 1.1) +
  annotate("label", x = prawdziwa, y = 0.85, hjust = 0, size = 3.5, linewidth = 0, fill = "white", colour = kol["model"],
           label = minus(sprintf(" prawdziwa data\n %.1f%%", prawdziwa))) +
  scale_x_continuous(limits = c(-12, 9), breaks = seq(-12, 8, 4), labels = function(x) minus(paste0(x, "%"))) +
  scale_y_continuous(NULL, breaks = NULL) +
  labs(x = "Średnia zmiana wizyt w 4 tygodniach od daty", title = sprintf("Test placebo: %d fikcyjnych dat przebudowy", length(placebo)),
       subtitle = "Każda kropka – jeden poniedziałek sprzed przebudowy potraktowany jak data zmiany") +
  motyw
p5   # zapis: ggsave("ruch-wyszukiwarka-placebo.svg", p5, width = 10, height = 4.8)
Wynik w R
liczba_dat_placebo
                50
prawdziwa_proc    placebo_min    placebo_max     placebo_sd
         -9.50          -5.10           7.71           3.03
odsetek_placebo_ponad_prawdziwy
                              0
[1] -5.10 -4.16 -3.73  6.36  7.24  7.71
6. Symulacja: zmiana algorytmu i zmiana pomiaru, Rysunek 6
R
# Przepis 6. Pułapki, których nie widać w jednym szeregu: 1000 symulowanych sklepów w trzech scenariuszach.
# (A) bez zakłóceń; (B) zmiana algorytmu wyszukiwarki 10 dni po przebudowie: −8% wizyt z wyszukiwarki
# w sklepie i na blogu; (C) zmiana pomiaru tylko na stronach sklepu: od przebudowy rejestruje 10% wizyt mniej.
# Korzysta z obiektów przepisów 1 i 3: kal, param, symuluj, efekt_prawdziwy, f_pelny, k_kon, proc, kol, motyw, minus.
set.seed(7421)
R <- 1000
X <- model.matrix(update(f_pelny, NULL ~ .), data = kal)    # te same zmienne co w modelu z przepisu 3
Q <- qr(X)
w_efekt <- setNames(numeric(ncol(X)), colnames(X)); w_efekt[c("po", "dni_po")] <- c(1, k_kon)
scenariusze <- list("A. bez zakłóceń" = c(algorytm = 0, pomiar = 0),
                    "B. zmiana algorytmu (−8%)" = c(algorytm = log(0.92), pomiar = 0),
                    "C. zmiana pomiaru w sklepie (−10%)" = c(algorytm = 0, pomiar = log(0.90)))
sym <- do.call(rbind, lapply(names(scenariusze), function(s) {
  z <- scenariusze[[s]]
  est <- t(replicate(R, {
    d <- symuluj(algorytm = z[["algorytm"]], pomiar = z[["pomiar"]])
    c(sam_sklep = sum(w_efekt * qr.coef(Q, log(d$sklep))),
      sklep_minus_blog = sum(w_efekt * qr.coef(Q, log(d$sklep) - log(d$blog))))
  }))
  data.frame(scenariusz = s, metoda = rep(c("sam sklep", "sklep − blog"), each = R), efekt = proc(c(est)))
}))
prawda <- proc(efekt_prawdziwy(k_kon))
c(prawdziwy_efekt_147_proc = round(prawda, 2))
podsum <- aggregate(efekt ~ metoda + scenariusz, data = sym,
                    FUN = function(x) round(c(srednia = mean(x), sd = sd(x), obciazenie = mean(x) - prawda), 2))
podsum

sym$scenariusz <- factor(sym$scenariusz, levels = rev(names(scenariusze)))
p6 <- ggplot(sym, aes(efekt, scenariusz, fill = metoda)) +
  geom_vline(xintercept = prawda, linetype = "dashed", colour = kol["prawda"]) +
  geom_boxplot(position = position_dodge(width = 0.75), width = 0.6, outlier.size = 0.6, outlier.alpha = 0.4) +
  annotate("text", x = prawda, y = 3.55, label = sprintf("prawdziwy efekt: %.1f%%", prawda), hjust = -0.05, size = 3.5) +
  scale_fill_manual(values = c("sam sklep" = unname(kol["model"]), "sklep − blog" = unname(kol["blog"])), name = NULL) +
  scale_x_continuous(labels = function(x) minus(paste0(x, "%"))) +
  labs(x = "Oszacowany efekt po 147 dniach", y = NULL,
       title = "1000 symulowanych sklepów: kiedy szereg porównawczy pomaga",
       subtitle = "Model jak w przepisie 3; zakłócenia B i C są niewidoczne w danych sklepu") +
  motyw
p6   # zapis: ggsave("ruch-wyszukiwarka-pulapki-symulacja.svg", p6, width = 10, height = 5.4)
Wynik w R
prawdziwy_efekt_147_proc
                   12.02
        metoda                         scenariusz efekt.srednia efekt.sd efekt.obciazenie
1    sam sklep                    A. bez zakłóceń         12.22     4.85             0.20
2 sklep − blog                    A. bez zakłóceń         12.33     3.24             0.31
3    sam sklep          B. zmiana algorytmu (−8%)          3.28     4.41            -8.74
4 sklep − blog          B. zmiana algorytmu (−8%)         12.11     3.24             0.09
5    sam sklep C. zmiana pomiaru w sklepie (−10%)          0.91     4.56           -11.11
6 sklep − blog C. zmiana pomiaru w sklepie (−10%)          0.92     2.95           -11.10
7. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 7. Kontrola palety: symulacja zaburzeń widzenia barw (odległość barw ΔE w CIELAB)
library(colorspace)
pary <- list("model – kontrfakt" = c("#D55E00", "#0072B2"),
             "sklep – blog" = c("#D55E00", "#009E73"),
             "model – przejście (tło)" = c("#D55E00", "#E69F00"),
             "placebo – prawdziwa data" = c("#CC79A7", "#D55E00"),
             "kontrfakt – blog" = c("#0072B2", "#009E73"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) { lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2)) }
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
model – kontrfakt                          114.6        108.3       91.9
sklep – blog                               102.4         53.5       37.3
model – przejście (tło)                     33.4         18.4       24.9
placebo – prawdziwa data                    74.3         70.2       71.9
kontrfakt – blog                            70.1         55.4       58.0
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Regresję (lm), symulację szeregów (arima.sim) i autokorelację reszt (acf) liczą funkcje podstawowej instalacji R (pakiet stats). Błędy HAC policzono pakietem sandwich, model z błędem ARMA – pakietem forecast. Rysunki wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- sandwich (wersja 3.1.1): Zeileis, A. (2004). Econometric computing with HC and HAC covariance matrix estimators. Journal of Statistical Software, 11(10), 1–17. https://doi.org/10.18637/jss.v011.i10
- forecast (wersja 9.0.2): Hyndman, R., Athanasopoulos, G., Bergmeir, C., Caceres, G., Chhay, L., O’Hara-Wild, M., Petropoulos, F., Razbash, S., Wang, E., & Yasmeen, F. (2026). forecast: Forecasting functions for time series and linear models (R package version 9.0.2) [Computer software]. https://doi.org/10.32614/CRAN.package.forecast
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Pominięty okres przejściowy. Model z jednym skokiem dał zmianę poziomu −8.1% i nachylenie +5.0% na 30 dni, choć prawda to +4.1% i +1.5%. Odbicie po spadku udaje trend.
- Data szukana w danych. Datę przebudowy znasz – użyj jej. Gdy punkt zmiany wybierasz z wykresu, zwykłe p jest zbyt optymistyczne (zob. punkt załamania w regresji segmentowej).
- Za krótki okres przed. Z kilku tygodni nie odróżnisz trendu od sezonu. Bez zmiennych kalendarza przedział efektu był tu dwa razy szerszy.
- Wszystkie wizyty zamiast wizyt z wyszukiwarki. Kampania e-mailowa w tym samym miesiącu zmieni ruch ogółem – analizuj źródło, którego dotyczy pytanie.
- Zwykłe błędy standardowe. Przy autokorelacji reszt zmiana nachylenia wyglądała na istotną (p = .019), a z HAC już nie (p = .074). Więcej o modelach z autokorelowanym błędem – we wpisie szeregi czasowe i ARIMA w praktyce.
- Kontrola, na którą działa przebudowa. Jeśli nowe menu kieruje ruch z bloga do sklepu (lub odwrotnie), różnica w różnicach zawyży albo zaniży efekt.
- Brak eksperymentu tam, gdzie był możliwy. Zmianę szablonu kart produktów można czasem wprowadzić na losowo wybranych grupach podstron i porównać jak w teście A/B. Przerwany szereg to plan B, gdy losowanie jest niemożliwe.
Najczęstsze pytania
Jak sprawdzić, czy przebudowa strony zmniejszyła ruch z wyszukiwarki?
Zbierz dzienne wizyty z wyszukiwarki z co najmniej roku przed zmianą i z kilku miesięcy po niej. Dopasuj regresję segmentową z trendem, dniami tygodnia, sezonem i świętami oraz zmiennymi zmiany poziomu i nachylenia, a pierwsze tygodnie po zmianie opisz osobnymi zmiennymi. Efekt to różnica między ruchem a przebiegiem przewidywanym bez zmiany (kontrfaktem), podana z przedziałem ufności.
Dlaczego po przebudowie strony ruch najpierw spada?
Wyszukiwarka musi odnaleźć nowe adresy i przenieść na nie pozycje starych, więc przez kilka tygodni ruch zwykle jest niższy. W przykładzie spadek wynosił 19.0% w 1. tygodniu i znikał po trzech tygodniach. Jeśli takiego okresu przejściowego nie wydzielisz w modelu, odbicie po spadku udaje trend i zniekształca ocenę trwałego efektu.
Czym są błędy standardowe HAC (Neweya–Westa)?
To błędy standardowe odporne na heteroskedastyczność i autokorelację reszt (Newey i West, 1987). Przy danych dziennych kolejne dni są do siebie podobne, więc zwykłe błędy z MNK są za małe. W przykładzie zmiana nachylenia była istotna przy zwykłych błędach (p = .019), a z HAC już nie (p = .074).
Po co szereg porównawczy w przerwanym szeregu czasowym?
Sam szereg nie odróżni przebudowy od zdarzenia z tego samego czasu, np. zmiany algorytmu wyszukiwarki. Szereg porównawczy (tu podstrony bloga bez zmian) reaguje na takie zdarzenie, ale nie na przebudowę. W symulacji zmiana algorytmu obniżyła oszacowanie z samego sklepu z 12.0% do 3.3%, a model różnicy sklep − blog dawał 12.1%.
Na czym polega test placebo w przerwanym szeregu czasowym?
Liczysz ten sam „efekt” dla fikcyjnych dat zmiany z okresu, w którym niczego nie zmieniano, i sprawdzasz, czy prawdziwa data wypada nietypowo. W przykładzie 50 fikcyjnych dat dało zmiany od −5.1% do 7.7%, a prawdziwa data −9.5%. Test placebo nie wyklucza jednak zdarzenia, które zbiegło się z prawdziwą datą.
Powiązane hasła
Przeczytaj też
Regresja segmentowa i przerwany szereg czasowy
Zmiana poziomu i nachylenia, gls z AR(1), sezonowość, szereg kontrolny, nieznany punkt załamania z bootstrapem, przykład w R i wzór opisu.
Czytaj →PoradnikWspółpraca z twórcą a sprzedaż
Kontrfakt z modelu ARIMA, efekt skumulowany ze ścieżek prognozy, placebo i kody rabatowe – na fikcyjnej marce plecaków, z kodem R.
Czytaj →PoradnikQuasi-eksperyment i różnica w różnicach (DiD)
Ocena programu bez losowania: równoległe trendy, regresja z interakcją, błędy klastrowane, model zdarzeń, test placebo, zagrożenia trafności i kod R.
Czytaj →Oceniasz zmianę strony albo kampanię na danych dziennych?
Pomożemy przygotować szereg czasowy, dobrać model z kalendarzem i okresem przejściowym, policzyć błędy HAC, test placebo i szereg porównawczy oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bell, W. R., & Hillmer, S. C. (1983). Modeling time series with calendar variation. Journal of the American Statistical Association, 78(383), 526–534. https://doi.org/10.1080/01621459.1983.10478005
- Hausman, C., & Rapson, D. S. (2018). Regression discontinuity in time: Considerations for empirical applications. Annual Review of Resource Economics, 10(1), 533–552. https://doi.org/10.1146/annurev-resource-121517-033306
- Lopez Bernal, J., Cummins, S., & Gasparrini, A. (2016). Interrupted time series regression for the evaluation of public health interventions: A tutorial. International Journal of Epidemiology, 46(1), 348–355. https://doi.org/10.1093/ije/dyw098 ● Otwarty dostęp
- Lopez Bernal, J., Cummins, S., & Gasparrini, A. (2018). The use of controls in interrupted time series studies of public health interventions. International Journal of Epidemiology, 47(6), 2082–2093. https://doi.org/10.1093/ije/dyy135
- Newey, W. K., & West, K. D. (1987). A simple, positive semi-definite, heteroskedasticity and autocorrelation consistent covariance matrix. Econometrica, 55(3), 703–708. https://doi.org/10.2307/1913610
- Schaffer, A. L., Dobbins, T. A., & Pearson, S.-A. (2021). Interrupted time series analysis using autoregressive integrated moving average (ARIMA) models: A guide for evaluating large-scale health interventions. BMC Medical Research Methodology, 21(1), Article 58. https://doi.org/10.1186/s12874-021-01235-8 ● Otwarty dostęp
- Turner, S. L., Forbes, A. B., Karahalios, A., Taljaard, M., & McKenzie, J. E. (2021). Evaluation of statistical methods used in the analysis of interrupted time series studies: A simulation study. BMC Medical Research Methodology, 21(1), Article 181. https://doi.org/10.1186/s12874-021-01364-0 ● Otwarty dostęp
Cytowania BibTeX
@article{bell1983modeling, author={Bell, William R. and Hillmer, Steven C.}, title={{Modeling time series with calendar variation}}, journal={Journal of the American Statistical Association}, year={1983}, volume={78}, number={383}, pages={526--534}, doi={10.1080/01621459.1983.10478005}}@article{hausman2018regression, author={Hausman, Catherine and Rapson, David S.}, title={{Regression discontinuity in time: Considerations for empirical applications}}, journal={Annual Review of Resource Economics}, year={2018}, volume={10}, number={1}, pages={533--552}, doi={10.1146/annurev-resource-121517-033306}}@article{lopezbernal2016interrupted, author={Lopez Bernal, James and Cummins, Steven and Gasparrini, Antonio}, title={{Interrupted time series regression for the evaluation of public health interventions: A tutorial}}, journal={International Journal of Epidemiology}, year={2016}, volume={46}, number={1}, pages={348--355}, doi={10.1093/ije/dyw098}}@article{lopezbernal2018use, author={Lopez Bernal, James and Cummins, Steven and Gasparrini, Antonio}, title={{The use of controls in interrupted time series studies of public health interventions}}, journal={International Journal of Epidemiology}, year={2018}, volume={47}, number={6}, pages={2082--2093}, doi={10.1093/ije/dyy135}}@article{newey1987simple, author={Newey, Whitney K. and West, Kenneth D.}, title={{A simple, positive semi-definite, heteroskedasticity and autocorrelation consistent covariance matrix}}, journal={Econometrica}, year={1987}, volume={55}, number={3}, pages={703--708}, doi={10.2307/1913610}}@article{schaffer2021interrupted, author={Schaffer, Andrea L. and Dobbins, Timothy A. and Pearson, Sallie-Anne}, title={{Interrupted time series analysis using autoregressive integrated moving average (ARIMA) models: A guide for evaluating large-scale health interventions}}, journal={BMC Medical Research Methodology}, year={2021}, volume={21}, number={1}, eid={58}, doi={10.1186/s12874-021-01235-8}}@article{turner2021evaluation, author={Turner, Simon L. and Forbes, Andrew B. and Karahalios, Amalia and Taljaard, Monica and McKenzie, Joanne E.}, title={{Evaluation of statistical methods used in the analysis of interrupted time series studies: A simulation study}}, journal={BMC Medical Research Methodology}, year={2021}, volume={21}, number={1}, eid={181}, doi={10.1186/s12874-021-01364-0}}