Przykład: 2647 opinii o salonach fryzjerskich i pytanie „czy nowy system rezerwacji pomógł?”
Fikcyjna aplikacja do rezerwacji wizyt u fryzjera zbiera po każdej wizycie ocenę od 1 do 5 gwiazdek i krótką opinię. W listopadzie 2025 roku aplikacja wprowadziła nowy system rezerwacji: potwierdzenia SMS i automatyczne przesuwanie kolejnych klientów, gdy ktoś się spóźnia. Dział obsługi klienta pyta: czy po zmianie opinie stały się cieplejsze i czy klienci rzadziej piszą o czekaniu? Gwiazdki mówią „jak bardzo”, tekst – „o czym”. Zamienia go w liczbę analiza sentymentu (wydźwięku).
Dane są fikcyjne, więc znamy prawdę o każdej opinii. Opinie złożył R z ręcznie napisanych szablonów zdań o pięciu aspektach wizyty (obsługa, efekt, termin, cena, salon), zdań opisowych bez oceny („Farbowanie na ciemny brąz.”) i krótkich opinii („Polecam.”, „Bez zastrzeżeń.”). Część negatywnych zdań jest ironiczna („No super, czekałam tylko godzinę.”). Gwiazdki wynikają z wydźwięku zdań, nastroju klienta i szumu; przed zmianą systemu zdania o terminie są częściej negatywne. Parametry podajemy przy kodzie. Opinie pobierzesz jako sentyment-opinie-salony.csv (kolumny ironia i skarga_termin są znane tylko w symulacji).
Zebrano 2647 opinii z 24 miesięcy (od 2024-11 do 2026-10, od 92 do 127 miesięcznie): 1338 przed zmianą i 1309 po niej. Piątki to 33.7% ocen, jedynki 17.2%. Prawda z symulacji: skarga na termin pojawiała się w 20.9% opinii przed zmianą i w 10.4% po niej, a 4.7% opinii zawiera zdanie ironiczne. Liczymy słowa według stałej reguły, bez ręcznego kodowania treści. Częstości słów, bigramy i modele tematów opisuje wpis analiza tekstu odpowiedzi otwartych w R, a samo porządkowanie gwiazdek – oceny gwiazdkowe i ranking produktów.
Słownik wydźwięku, tokeny i negacja
Metoda słownikowa ma trzy kroki. Tokenizacja dzieli opinię na zdania, a zdania na słowa (małe litery, bez interpunkcji); w R robi to funkcja unnest_tokens() z pakietu tidytext, w formacie „jeden token w wierszu” (Silge i Robinson, 2016). Słownik przypisuje części słów wagi: „polecam” +2, „miła” +1, „drogo” −1, „porażka” −2. Wynik opinii to suma wag znalezionych słów. Taboada i in. (2011) pokazali, że słownik z wagami siły i z regułami negacji daje podobne wyniki w różnych dziedzinach – pod warunkiem, że słownik jest starannie przygotowany.
Nasz słownik ma 72 formy wyrazów: 16 z wagą +2, 25 z wagą +1, 21 z wagą −1 i 10 z wagą −2. Polszczyzna odmienia wyrazy, a sprowadzania słów do formy podstawowej w R brakuje, więc wpisaliśmy formy występujące w opiniach („czekałam”, „czekałem”, „czekania”). Słownik pobierzesz jako sentyment-slownik-wydzwieku.csv. Negacja: jeśli jedno z dwóch słów przed słowem ze słownika to „nie”, „bez” albo „niezbyt”, waga zmienia znak – „nie polecam” daje −2, „bez czekania” +1. Polskie gotowe zasoby istnieją: korpus PolEmo 2.0 zawiera 8216 opinii konsumenckich z czterech dziedzin ręcznie oznaczonych pod względem wydźwięku (Kocoń i in., 2019), ale fryzjerów wśród nich nie ma.
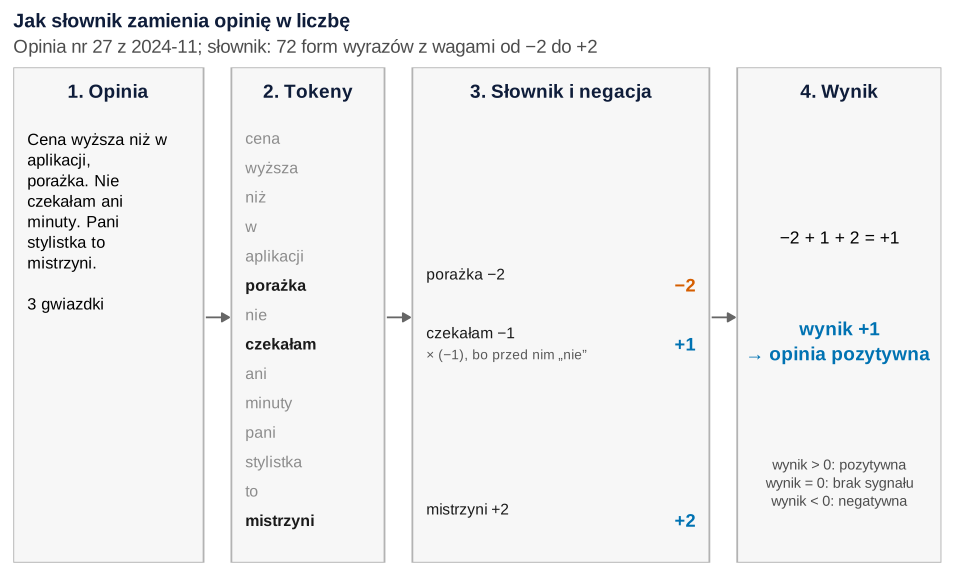
Co widać. Z 14 słów opinii nr 27 trzy są w słowniku. „Porażka” daje −2, „mistrzyni” +2, a „czekałam” zmienia znak, bo stoi po „nie”. Suma +1 oznacza opinię pozytywną. Klient dał 3 gwiazdki: chwali fryzjerkę, ale krytykuje cenę.
Jak może zmylić. Słowo „wyższa” (cena wyższa niż w aplikacji) jest krytyką, ale słownik go nie zna, więc nie liczy. Suma nie wie też, czego dotyczy pochwała – wynik +1 łączy zachwyt fryzjerką z niezadowoleniem z ceny.
Podpis do pracy:
Rysunek 2: czy wynik słownika zgadza się z gwiazdkami?
W całym zbiorze powstały 22 344 tokeny (183 różne słowa). Słownik trafił 5648 razy, w tym 870 razy po negacji. 328 opinii nie zawiera żadnego słowa ze słownika – mają wynik 0. Zanim wyciągniesz wnioski, sprawdź trafność kryterialną wyniku – tu kryterium są gwiazdki. Grimmer i Stewart (2013) przypominają, że każdą automatyczną analizę tekstu trzeba walidować na danych, do których jej używasz.
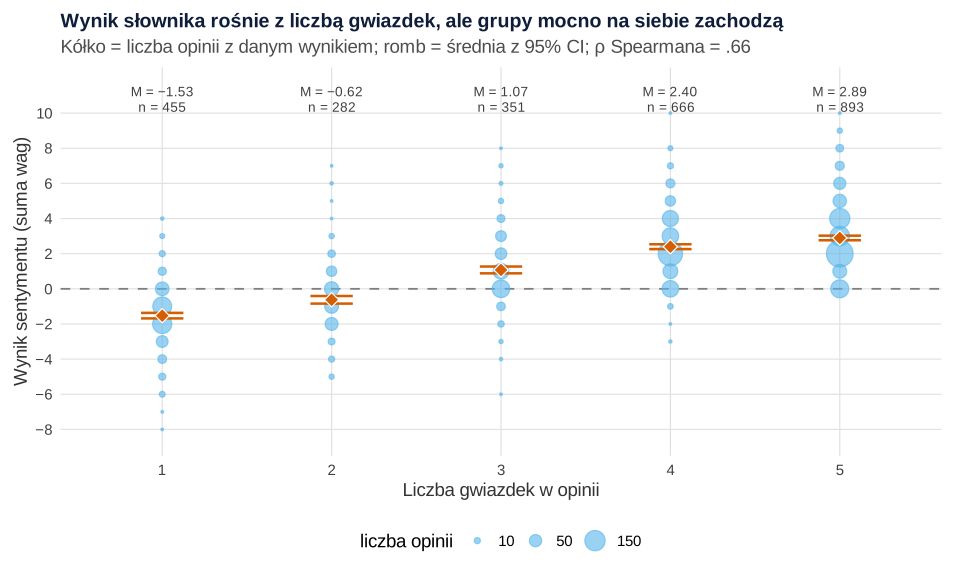
set.seed(661)).Co widać. Średni wynik rośnie z liczbą gwiazdek: od −1.53 przy jednej do 2.89 przy pięciu. Korelacja Spearmana wyniku z gwiazdkami wynosi ρ = .661, 95% CI [.637, .684] (bootstrap, 2000 prób).
Jak może zmylić. Średnie są bardzo pewne, ale pojedyncze opinie nie: przy 5 gwiazdkach zdarzają się wyniki 0, a przy jednej gwiazdce wyniki dodatnie. Gwiazdki to skala porządkowa, a suma wag zależy od długości opinii, dlatego używamy korelacji rang, a nie Pearsona.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: macierz pomyłek – słownik a gwiazdki
Wynik dodatni oznaczamy jako opinię pozytywną, ujemny jako negatywną, zero jako „brak sygnału”. Gwiazdki dzielimy na 1–2, 3 i 4–5. Zestawienie obu podziałów to macierz pomyłek.
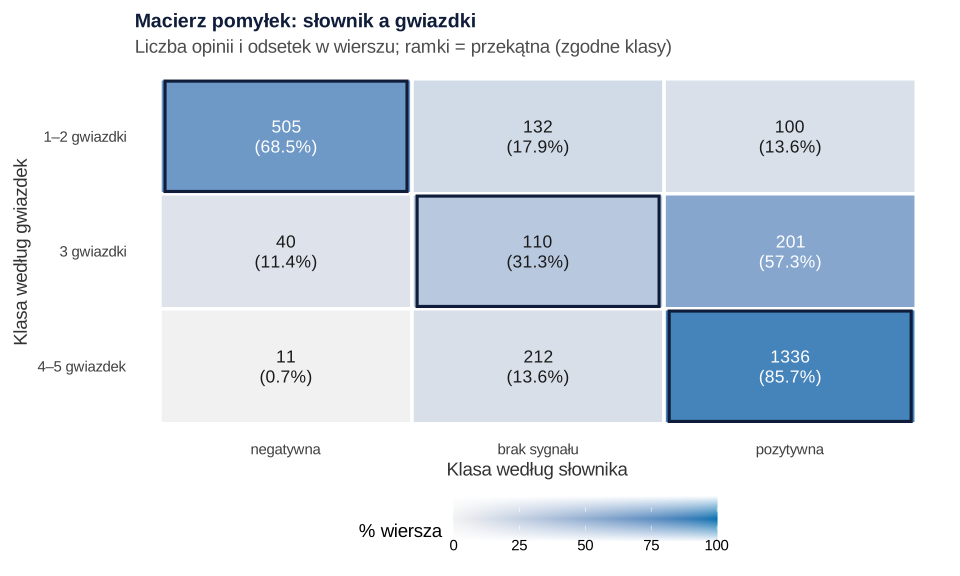
Co widać. Słownik rozpoznaje 85.7% opinii z 4–5 gwiazdkami jako pozytywne i 68.5% opinii z 1–2 gwiazdkami jako negatywne. Wśród 2296 opinii jednoznacznych (bez trójek) trafność wynosi 80.2%; 85.0% z nich ma wynik różny od zera, a wśród nich trafność rośnie do 94.3%. Opinie z trzema gwiazdkami słownik zwykle uznaje za pozytywne (57.3%). Kappa Cohena dla całej tabeli: κ = .526 (zgodność obserwowana .737, losowa .445).
Jak może zmylić. Błędy są asymetryczne: negatywną opinię słownik bierze za pozytywną 100 razy, a pozytywną za negatywną tylko 11 razy. To ironia i krótkie opinie bez słów ze słownika (rysunek 6). Ogólne „80% trafności” ukrywa, że słownik gorzej słyszy niezadowolonych; dla każdej klasy policz odsetki osobno, jak czułość i swoistość.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: które słowa niosą wynik
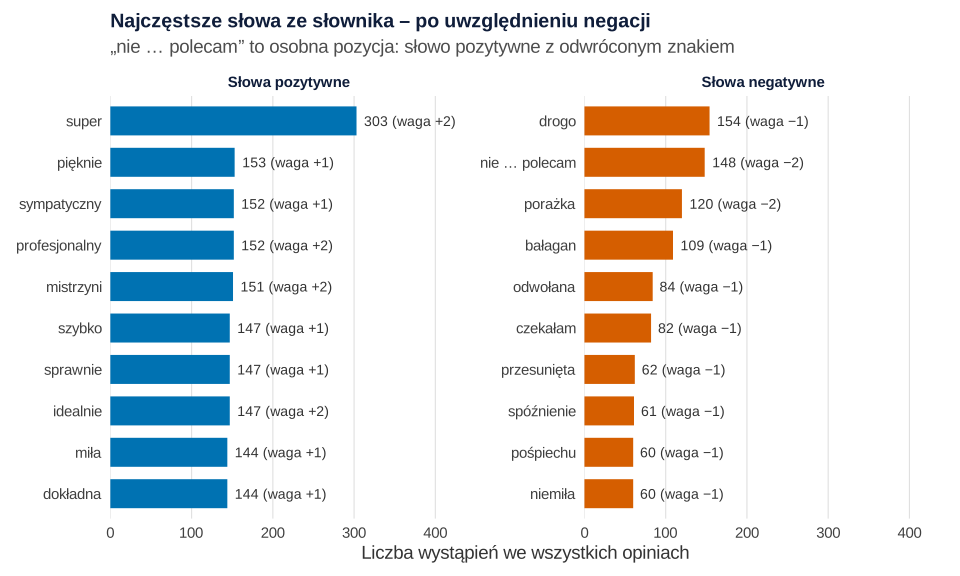
Co widać. Najczęstsze słowo pozytywne to „super” (303 wystąpienia), negatywne – „drogo” (154) i „nie … polecam” (148, czyli 9.9% wszystkich negatywnych trafień). Cztery z dziesięciu słów negatywnych dotyczą terminów: „bałagan”, „odwołana”, „czekałam”, „przesunięta”.
Jak może zmylić. 76 z 303 wystąpień „super” pochodzi z opinii zawierających zdanie ironiczne. Zanim przypiszesz słowu wagę, przeczytaj kilkanaście opinii, w których występuje.
Podpis do pracy:
Rysunek 5: trend miesięczny i zmiana systemu rezerwacji
Średni wynik w każdym miesiącu liczymy z 95% przedziałem ufności. Do oceny zmiany używamy przerwanego szeregu czasowego: regresja wyniku opinii na numer miesiąca, wskaźnik „po zmianie” (skok poziomu) i liczbę miesięcy od zmiany (zmiana nachylenia). Opinie z jednego miesiąca dzielą wspólne warunki, więc stosujemy błędy standardowe odporne na klastrowanie po miesiącach. Procedurę krok po kroku opisuje wpis regresja segmentowa i przerwany szereg czasowy.
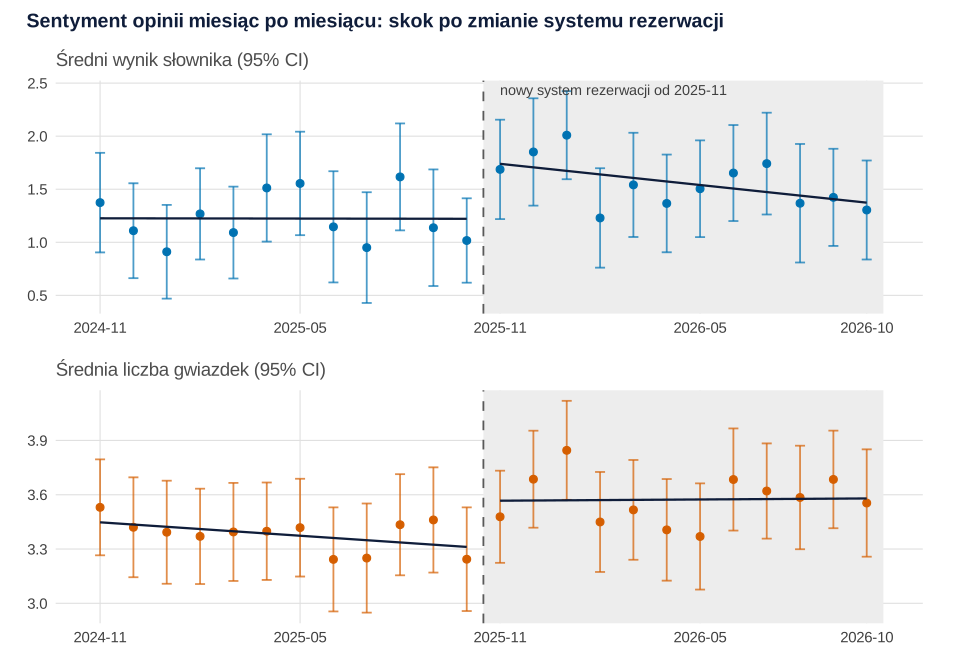
Co widać. Przed zmianą wynik nie miał trendu (nachylenie −0.001 na miesiąc, 95% CI [−0.035, 0.032]). W listopadzie 2025 poziom podskoczył o 0.557 punktu, 95% CI [0.206, 0.908], p = .002. Zmiana nachylenia po wdrożeniu nie była istotna (−0.032, 95% CI [−0.075, 0.011], p = .147). Średnia gwiazdek też wzrosła skokowo (o 0.260, 95% CI [0.057, 0.462]). Słowa o terminach bez negacji („czekałam”, „odwołana”, „przesunięta”, „spóźnienie”, „bałagan”) występowały w 22.1% opinii przed zmianą i w 11.3% po niej – blisko prawdy z symulacji (20.9% i 10.4%).
Jak może zmylić. Przedziały miesięczne są szerokie (około ±0.5), a spadek linii po zmianie to szum, nie „wygasanie efektu”. Przerwany szereg nie zastąpi grupy porównawczej: jeśli w tym samym miesiącu zmienił się cennik albo sezon, skok przypiszesz nie temu, co trzeba (korelacja a przyczynowość). Prosta różnica średnich (1.56 wobec 1.22, różnica 0.34, 95% CI [0.15, 0.53]) jest mniejsza niż skok z modelu, bo obejmuje też późniejsze miesiące z niższym wynikiem.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: negacja, słownik z innej dziedziny i krótkie opinie
Porównujemy trzy wersje słownika na tych samych opiniach. Druga to nasz słownik bez reguły negacji. Trzecia udaje słownik przeniesiony z innej dziedziny: brak w nim słów typowych dla wizyt („czekałam”, „odwołana”, „punktualnie”, „mistrzyni”), a słowa neutralne w opisie fryzury – „krótko”, „ciemny”, „ostro”, „zimny”, „cienkie” – są w nim negatywne, jak w opiniach o elektronice czy jedzeniu.
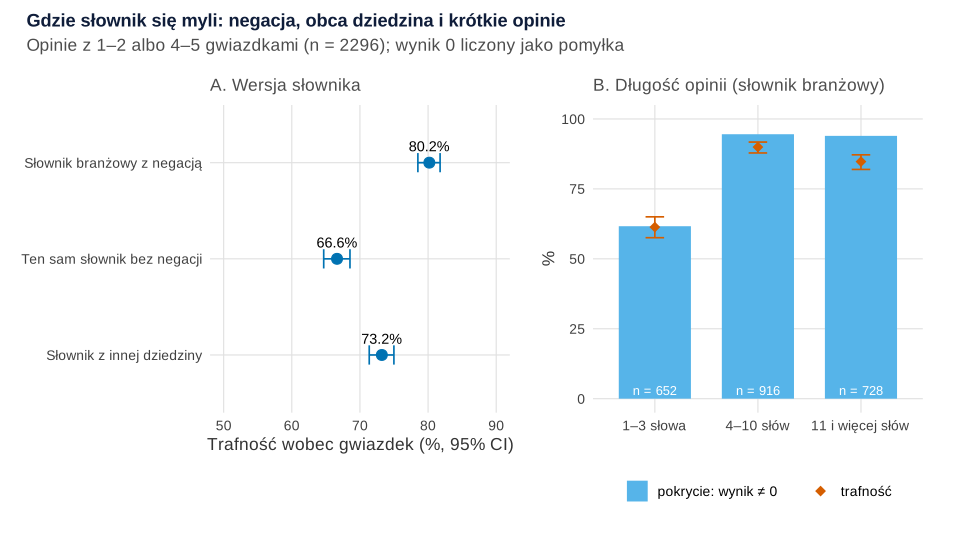
Co widać. Bez negacji trafność spada z 80.2% do 66.6% (95% CI [64.7, 68.5]), a korelacja z gwiazdkami z .661 do .466: „nie polecam” liczy się wtedy jako pochwała. Słownik z innej dziedziny daje 73.2%, 95% CI [71.4, 75.0]. Loughran i McDonald (2011) opisali to samo w finansach: prawie trzy czwarte słów, które ogólny słownik uznawał za negatywne, w raportach spółek negatywne nie było. W opiniach z 1–3 słowami tylko 61.7% ma jakikolwiek wynik, a trafność wynosi 61.3%; najczęstsze krótkie opinie z wynikiem 0 to „Bez zastrzeżeń.” (68), „10/10” (63) i „Jest ok.” (57). Ironia: z 88 opinii ironicznych z 1–2 gwiazdkami 63.6% dostało wynik dodatni; trafność w tej grupie wynosi 25.0% wobec 82.3% w pozostałych.
Jak może zmylić. W prawdziwych danych nie wiesz, które opinie są ironiczne – tu to wiemy, bo sami je napisaliśmy. Ranking metod zależy od zbioru: w porównaniu 24 metod na 18 zbiorach trafność tych samych narzędzi wyraźnie różniła się między zbiorami (Ribeiro i in., 2016), a gotowe narzędzia słabo radziły sobie z tekstami specyficznymi dla dziedziny (González-Bailón i Paltoglou, 2015).
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w firmie
- Monitoruj trend, nie pojedyncze opinie. Słownik myli się w co piątej jednoznacznej opinii, ale średnia z setek opinii jest stabilna. Pokazuj ją z przedziałem, jak w badaniu trackingowym marki.
- Licz osobno słowa o aspektach. Odsetek opinii ze słowami o czekaniu i odwołaniach spadł z 22.1% do 11.3% – to konkretniejsza informacja dla działu operacji niż ogólny wynik.
- Ocen negatywnych szukaj także poza wynikiem. Opinie z 1–2 gwiazdkami i wynikiem dodatnim (100 w przykładzie) to kandydaci na ironię – przeczytaj je, zanim odpowiesz klientowi.
- Zmianę systemu sprawdź eksperymentem, jeśli możesz. Wdrożenie najpierw w części salonów daje grupę porównawczą (test A/B).
- Uważaj na zaproszenia do opinii. Jeśli nowy system sam prosi o opinię po wizycie, zmienia się to, kto pisze (błąd selekcji), a ten efekt łatwo pomylić z poprawą obsługi – zob. samoselekcję opinii opisaną przez Hu i in. (2017).
Jak opisać w pracy
W Metodzie opisz źródło opinii, okres i liczebność, sposób tokenizacji, słownik (liczba słów, skala wag, kto i jak go przygotował; słownik dołącz do aneksu) oraz regułę negacji. Podaj, jak sprawdzono trafność wyniku (gwiazdki albo próbka opinii oznaczona ręcznie przez dwie osoby niezależnie od siebie). Przed analizą usuń z opinii imiona i nazwy salonów (anonimizacja i pseudonimizacja). Szerzej o układzie pracy: statystyka w pracy z zarządzania i ekonomii.
W ograniczeniach napisz wprost, że metoda słownikowa nie rozpoznaje ironii i nie ocenia opinii bez słów ze słownika. Zob. też jak napisać pracę z zarządzania i ekonomii i NPS z przedziałem ufności.
Kod R: słownik, trafność i trend
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, szablony zdań i opinie, przepis 2 – słownik, tokeny, funkcję policz() i wynik każdej opinii, z których korzystają kolejne. Przepisy 2–6 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne. Przepisy 1 i 2 zapisują w katalogu roboczym pliki CSV z opiniami i słownikiem.
Losują przepisy 1 (opinie) i 3 (bootstrap korelacji); oba zaczynają się od własnego set.seed(661). Ziarno 661 ustalono raz i nie zmieniano go. Ręcznie ustalono: szablony zdań i słownik (72 formy, wagi −2…+2), negacje „nie”, „bez”, „niezbyt” w oknie dwóch słów; liczbę opinii w miesiącu (Poisson, średnio 110); nastrój klienta (normalny, średnia 0.7, SD 1.1); udział krótkich opinii (22%); liczbę zdań 1–4 (prawdopodobieństwa .25, .40, .25, .10); udział aspektów (obsługa .22, efekt .22, termin .24, cena .10, salon .10, opis .12); szansę zdania pozytywnego plogis(1.6 × nastrój + przesunięcie), gdzie przesunięcie wynosi −1.5 dla terminu przed zmianą, +0.5 po zmianie, −0.6 dla ceny i +0.3 dla pozostałych aspektów; ironię w 15% negatywnych zdań o obsłudze, efekcie i terminie; gwiazdki = zaokrąglone 3 + 1.5 × średni wydźwięk zdań + 0.35 × (nastrój − 0.7) + szum (SD 0.55), w granicach 1–5. Po pierwszym uruchomieniu zwiększono udział zdań o terminie (z .18 do .24) i różnicę przed–po (z −1.0/+0.4 na −1.5/+0.5), bo zmiana po wdrożeniu ginęła w szumie; ziarna nie zmieniano. Cały kod liczy się w kilka sekund.
1. Opinie z szablonów zdań: 24 miesiące, 2647 opinii
R
# Przepis 1. Fikcyjna aplikacja do rezerwacji wizyt u fryzjera: 24 miesiące opinii z gwiazdkami 1–5
# Opinie składamy z szablonów zdań (napisanych ręcznie) – dzięki temu znamy prawdę o każdej opinii.
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         blekit = "#56B4E9", fiolet = "#CC79A7", szary = "grey60")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4), legend.position = "bottom",
        strip.text = element_text(face = "bold", colour = "#0f1d3a"),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Szablony zdań: aspekt wizyty × wydźwięk (+1 pozytywny, -1 negatywny); „ironia” – negatywne zdania
# zbudowane z pozytywnych słów; „opis” – zdania bez oceny, ale ze słowami branżowymi (krótko, ciemny…)
szablony <- list(
  obsluga = list(
    poz = c("Fryzjerka bardzo miła i dokładna.", "Pan fryzjer sympatyczny i profesjonalny.",
            "Profesjonalna obsługa od wejścia.", "Nie było problemu z dogadaniem się.",
            "Pani stylistka to mistrzyni."),
    neg = c("Fryzjerka niemiła i w pośpiechu.", "Obsługa niezbyt miła.", "Pani przy recepcji nieuprzejma.",
            "Nie polecam tej fryzjerki."),
    ironia = c("Super obsługa, nikt się nawet nie przywitał.")),
  efekt = list(
    poz = c("Kolor wyszedł idealnie.", "Strzyżenie dokładne, fryzura ładnie się układa.",
            "Efekt rewelacyjny, jestem zachwycona.", "Pasemka wyszły pięknie.", "Nie jestem rozczarowana, wręcz przeciwnie."),
    neg = c("Grzywka krzywo ścięta.", "Kolor wyszedł fatalnie.", "Włosy zniszczone po rozjaśnianiu.",
            "Nie jestem zadowolona z koloru.", "Efekt to porażka, nie polecam."),
    ironia = c("Pięknie, kolor zszedł po dwóch myciach.")),
  termin = list(
    poz = c("Wszystko punktualnie, bez czekania.", "Rezerwacja w aplikacji szybko i sprawnie.",
            "Nie czekałam ani minuty.", "Termin od ręki, super."),
    neg = c("Czekałam pół godziny mimo rezerwacji.", "Czekałem pół godziny mimo rezerwacji.",
            "Wizyta odwołana w ostatniej chwili.", "Wizyta przesunięta bez uprzedzenia.",
            "Spóźnienie fryzjera o 40 minut.", "Bałagan z rezerwacjami, nikt nie wiedział o mojej wizycie."),
    ironia = c("No super, czekałam tylko godzinę.", "Świetna organizacja, wizyta odwołana pięć minut przed czasem.")),
  cena = list(
    poz = c("Cena rozsądna, dobrze wydane pieniądze.", "Nie jest drogo jak na taki efekt.", "Ceny przyjemne."),
    neg = c("Drogo jak na taki efekt.", "Za drogo jak na pięć minut strzyżenia.", "Cena wyższa niż w aplikacji, porażka."),
    ironia = character(0)),
  miejsce = list(
    poz = c("W salonie czysto i przyjemnie.", "Fajnie urządzony salon.", "Wygodnie i miło, do tego dobra kawa."),
    neg = c("W salonie brudno i głośno.", "Bałagan na stanowisku.", "Hałas z ulicy, trudno się zrelaksować."),
    ironia = character(0)),
  opis = c("Strzyżenie krótko na boki.", "Farbowanie na ciemny brąz.", "Cięcie na ostro do linii brody.",
           "Zimny blond z tonerem.", "Mam cienkie włosy, więc wybrałam cieniowanie.",
           "Byłam na strzyżeniu i modelowaniu.", "Umówiłam wizytę przez aplikację.", "Pierwsza wizyta w tym salonie."),
  krotkie = list(poz = c("Polecam.", "Super!", "Rewelacja.", "Polecam serdecznie.", "Bez zastrzeżeń.", "Jest ok.", "10/10"),
                 neg = c("Nie polecam.", "Tragedia.", "Szkoda pieniędzy.", "Nigdy więcej.", "Słabo.")))

# Generator jednej opinii. Parametry ustalono ręcznie: nastrój klienta u ~ N(0.7, 1.1); 22% opinii to
# jedno krótkie zdanie; pozostałe mają 1–4 zdania o różnych aspektach. Przed zmianą systemu rezerwacji
# zdania o terminie są częściej negatywne (przesunięcie -1.5), po zmianie – częściej pozytywne (+0.5).
aspekty <- c("obsluga", "efekt", "termin", "cena", "miejsce", "opis")
p_aspekt <- c(.22, .22, .24, .10, .10, .12)
generuj_opinie <- function(po_zmianie) {
  u <- rnorm(1, 0.7, 1.1)
  if (runif(1) < .22) {                                      # krótka opinia
    w <- if (runif(1) < plogis(1.6 * u)) 1 else -1
    zd <- sample(szablony$krotkie[[if (w > 0) "poz" else "neg"]], 1)
    return(data.frame(tekst = zd, v = w, ironia = FALSE, skarga_termin = FALSE, u = u))
  }
  k <- sample(1:4, 1, prob = c(.25, .40, .25, .10))
  as <- sample(aspekty, k, prob = p_aspekt)
  zd <- character(k); w <- numeric(k); iron <- logical(k)
  for (j in seq_len(k)) {
    if (as[j] == "opis") { zd[j] <- sample(szablony$opis, 1); w[j] <- 0; next }
    przes <- switch(as[j], termin = if (po_zmianie) 0.5 else -1.5, cena = -0.6, 0.3)
    w[j] <- if (runif(1) < plogis(1.6 * u + przes)) 1 else -1
    s <- szablony[[as[j]]]
    if (w[j] < 0 && length(s$ironia) && runif(1) < .15) { zd[j] <- sample(s$ironia, 1); iron[j] <- TRUE
    } else zd[j] <- sample(s[[if (w[j] > 0) "poz" else "neg"]], 1)
  }
  data.frame(tekst = paste(zd, collapse = " "), v = if (any(w != 0)) mean(w[w != 0]) else 0,
             ironia = any(iron), skarga_termin = any(as == "termin" & w < 0), u = u)
}

set.seed(661)                                    # ziarno ustalone raz, bez dobierania pod wynik
miesiace <- format(seq(as.Date("2024-11-01"), by = "month", length.out = 24), "%Y-%m")
n_mies <- rpois(24, 110)                         # liczba opinii w miesiącu
opinie <- do.call(rbind, lapply(1:24, function(m)
  cbind(miesiac_nr = m, do.call(rbind, replicate(n_mies[m], generuj_opinie(m >= 13), simplify = FALSE)))))
# Gwiazdki: wynikają z treści (średni wydźwięk zdań v) i nastroju klienta, plus szum
opinie$gwiazdki <- pmin(5, pmax(1, round(3 + 1.5 * opinie$v + 0.35 * (opinie$u - 0.7) + rnorm(nrow(opinie), 0, 0.55))))
opinie$id <- seq_len(nrow(opinie))
opinie$miesiac <- miesiace[opinie$miesiac_nr]
opinie$po_zmianie <- as.integer(opinie$miesiac_nr >= 13)   # nowy system rezerwacji od listopada 2025
opinie <- opinie[, c("id", "miesiac", "miesiac_nr", "po_zmianie", "gwiazdki", "tekst", "ironia", "skarga_termin")]
write.csv(opinie, "sentyment-opinie-salony.csv", row.names = FALSE)

c(opinie = nrow(opinie), min_w_miesiacu = min(n_mies), max_w_miesiacu = max(n_mies),
  przed_zmiana = sum(opinie$po_zmianie == 0), po_zmianie = sum(opinie$po_zmianie == 1))
round(100 * prop.table(table(opinie$gwiazdki)), 1)          # rozkład gwiazdek (%)
# Prawda znana tylko w symulacji: odsetek opinii ze skargą na termin i opinii ironicznych
round(100 * c(skarga_termin_przed = mean(opinie$skarga_termin[opinie$po_zmianie == 0]),
              skarga_termin_po = mean(opinie$skarga_termin[opinie$po_zmianie == 1]),
              ironia = mean(opinie$ironia)), 1)
c(srednia_gwiazdek_przed = round(mean(opinie$gwiazdki[opinie$po_zmianie == 0]), 2),
  srednia_gwiazdek_po = round(mean(opinie$gwiazdki[opinie$po_zmianie == 1]), 2))
head(opinie[, c("miesiac", "gwiazdki", "tekst")], 5)
Wynik w R
        opinie min_w_miesiacu max_w_miesiacu   przed_zmiana     po_zmianie
          2647             92            127           1338           1309

   1    2    3    4    5
17.2 10.7 13.3 25.2 33.7
skarga_termin_przed    skarga_termin_po              ironia
               20.9                10.4                 4.7
srednia_gwiazdek_przed    srednia_gwiazdek_po
                  3.38                   3.57
  miesiac gwiazdki
1 2024-11        5
2 2024-11        4
3 2024-11        5
4 2024-11        2
5 2024-11        4
                                                                       tekst
1                                                                      10/10
2 Farbowanie na ciemny brąz. Strzyżenie dokładne, fryzura ładnie się układa.
3                Kolor wyszedł idealnie. Wszystko punktualnie, bez czekania.
4               Włosy zniszczone po rozjaśnianiu. W salonie brudno i głośno.
5                                                                   Jest ok.
2. Słownik, tokenizacja, negacja i wynik opinii: Rysunek 1
R
# Przepis 2. Słownik wydźwięku przygotowany ręcznie, tokenizacja (tidytext), negacja i wynik opinii: Rysunek 1
# Korzysta z obiektów przepisu 1: opinie, kol, motyw. Niczego nie losuje.
library(ggplot2)
library(dplyr, warn.conflicts = FALSE)
library(tidytext)

# Słownik: formy wyrazów (bez lematyzacji – wpisujemy formy, które występują w opiniach) z wagami -2…+2
slownik <- rbind(
  data.frame(slowo = c("polecam", "super", "rewelacja", "rewelacyjny", "rewelacyjnie", "idealnie", "świetnie",
                       "świetna", "świetny", "profesjonalna", "profesjonalny", "profesjonalnie", "mistrzyni",
                       "zachwycona", "zachwycony", "perfekcyjnie"), waga = 2),
  data.frame(slowo = c("miła", "miły", "miło", "sympatyczna", "sympatyczny", "dokładna", "dokładny", "dokładne",
                       "dokładnie", "zadowolona", "zadowolony", "ładnie", "pięknie", "punktualnie", "sprawnie",
                       "szybko", "czysto", "przyjemnie", "przyjemne", "fajnie", "dobrze", "rozsądna", "uprzejma",
                       "wygodnie", "serdecznie"), waga = 1),
  data.frame(slowo = c("drogo", "drogi", "czekałam", "czekałem", "czekania", "spóźnienie", "krzywo", "nierówno",
                       "niemiła", "niemiły", "nieuprzejma", "głośno", "hałas", "problem", "problemu", "pośpiechu",
                       "odwołana", "przesunięta", "bałagan", "brudno", "słabo"), waga = -1),
  data.frame(slowo = c("tragedia", "tragicznie", "fatalnie", "fatalny", "porażka", "beznadziejnie", "zniszczone",
                       "koszmar", "rozczarowana", "rozczarowany"), waga = -2))
negacje <- c("nie", "bez", "niezbyt")            # odwracają znak słowa, jeśli stoją 1–2 słowa przed nim w zdaniu
write.csv(slownik, "sentyment-slownik-wydzwieku.csv", row.names = FALSE)
table(slownik$waga)

# Tokenizacja: opinia → zdania → słowa (małe litery, bez interpunkcji); numer słowa w zdaniu
tokeny <- opinie |>
  select(id, tekst) |>
  unnest_tokens(zdanie, tekst, token = "sentences") |>
  mutate(nr_zdania = row_number(), .by = id) |>
  unnest_tokens(slowo, zdanie) |>
  mutate(poprz1 = lag(slowo, 1), poprz2 = lag(slowo, 2), .by = c(id, nr_zdania)) |>
  mutate(zanegowane = poprz1 %in% negacje | poprz2 %in% negacje)

# Wynik sentymentu = suma wag dopasowanych słów; słowo po negacji liczy się ze znakiem odwrotnym
policz <- function(tok, slow, z_negacja = TRUE) {
  traf <- inner_join(tok, slow, by = "slowo") |>
    mutate(wklad = if (z_negacja) ifelse(zanegowane, -waga, waga) else waga)
  w <- summarise(traf, wynik = sum(wklad), n_traf = n(), .by = id)
  out <- left_join(select(opinie, id), w, by = "id")
  out$wynik[is.na(out$wynik)] <- 0; out$n_traf[is.na(out$n_traf)] <- 0
  out
}
w <- policz(tokeny, slownik)
opinie$wynik <- w$wynik
opinie$n_traf <- w$n_traf
opinie$n_slow <- count(tokeny, id)$n
opinie$klasa_slownik <- cut(opinie$wynik, c(-Inf, -0.5, 0.5, Inf), labels = c("negatywna", "brak sygnału", "pozytywna"))
c(tokenow = nrow(tokeny), roznych_slow = n_distinct(tokeny$slowo), slow_w_slowniku = nrow(slownik),
  trafien = sum(tokeny$slowo %in% slownik$slowo), zanegowanych_trafien = sum(tokeny$zanegowane & tokeny$slowo %in% slownik$slowo),
  opinie_bez_trafienia = sum(opinie$n_traf == 0))
summary(opinie$wynik)

# --- Rysunek 1: grafika „opinia → tokeny → słownik → wynik” dla jednej opinii z danych ---
# wybór przykładu: pierwsza krótka opinia z co najmniej 3 trafieniami, negacją i słowami o obu znakach
wk <- inner_join(tokeny, slownik, by = "slowo") |>
  summarise(neg = any(zanegowane), plus = any(ifelse(zanegowane, -waga, waga) > 0),
            minus = any(ifelse(zanegowane, -waga, waga) < 0), .by = id)
kand <- opinie$id[opinie$n_traf >= 3 & nchar(opinie$tekst) < 95 & opinie$id %in% wk$id[wk$neg & wk$plus & wk$minus]]
przyklad <- opinie[opinie$id == kand[1], ]
tp <- left_join(filter(tokeny, id == przyklad$id), slownik, by = "slowo") |>
  mutate(wklad = ifelse(is.na(waga), NA, ifelse(zanegowane, -waga, waga)), poz = row_number())
print(przyklad[, c("id", "miesiac", "gwiazdki", "tekst", "wynik")], row.names = FALSE)
print(as.data.frame(tp[, c("nr_zdania", "slowo", "zanegowane", "waga", "wklad")]), row.names = FALSE)

zn <- function(x) sub("^-", "−", sprintf("%+d", x))               # liczba ze znakiem (minus U+2212)
gw <- function(n) paste(n, ifelse(n == 1, "gwiazdka", ifelse(n <= 4, "gwiazdki", "gwiazdek")))
nt <- nrow(tp); yk <- seq(9.3, 1.2, length.out = nt)          # pionowe położenie tokenów
traf <- tp[!is.na(tp$waga), ]; yt <- yk[traf$poz]
traf$opis <- ifelse(traf$zanegowane, sprintf("× (−1), bo przed nim „%s”",
                                              ifelse(traf$poprz1 %in% negacje, traf$poprz1, traf$poprz2)), "")
suma <- paste(sub("^\\+", "", paste0(ifelse(traf$wklad < 0, " − ", " + "), abs(traf$wklad))) |> paste(collapse = "") |>
                sub(pattern = "^ \\+ ", replacement = "") |> sub(pattern = "^ − ", replacement = "−"),
              "=", zn(przyklad$wynik))
kolumny <- data.frame(x0 = c(0, 4.7, 8.6, 15.6), x1 = c(4.1, 8.0, 15.0, 20),
                      tytul = c("1. Opinia", "2. Tokeny", "3. Słownik i negacja", "4. Wynik"))
p1 <- ggplot() +
  geom_rect(data = kolumny, aes(xmin = x0, xmax = x1, ymin = 0.3, ymax = 10.8), fill = "grey97", colour = "grey70") +
  geom_text(data = kolumny, aes(x = (x0 + x1) / 2, y = 10.3, label = tytul), fontface = "bold", size = 5, colour = "#0f1d3a") +
  annotate("segment", x = c(4.15, 8.05, 15.05), xend = c(4.65, 8.55, 15.55), y = 5.5, yend = 5.5,
           arrow = arrow(length = unit(0.22, "cm"), type = "closed"), colour = "grey40") +
  annotate("text", x = 0.3, y = 9.4, hjust = 0, vjust = 1, size = 4.3, lineheight = 1.05,
           label = paste0(paste(strwrap(przyklad$tekst, 19), collapse = "\n"), "\n\n", gw(przyklad$gwiazdki))) +
  geom_text(aes(x = 5.0, y = yk, label = tp$slowo, fontface = ifelse(is.na(tp$waga), "plain", "bold"),
                colour = ifelse(is.na(tp$waga), "poza słownikiem", "w słowniku")), hjust = 0, size = 4.2) +
  geom_text(aes(x = 8.9, y = yt + 0.12, label = sprintf("%s  %s", traf$slowo, zn(traf$waga))),
            hjust = 0, vjust = 0, size = 4.1, colour = "grey10") +
  geom_text(aes(x = 8.9, y = yt - 0.12, label = traf$opis), hjust = 0, vjust = 1, size = 3.6, colour = "grey35") +
  geom_text(aes(x = 14.7, y = yt, label = zn(traf$wklad), colour = ifelse(traf$wklad > 0, "pozytywne", "negatywne")),
            hjust = 1, size = 4.8, fontface = "bold") +
  annotate("text", x = 17.8, y = 7.2, label = suma, size = 4.6) +
  annotate("text", x = 17.8, y = 5.0, label = sprintf("wynik %s\n→ opinia %s", zn(przyklad$wynik), przyklad$klasa_slownik),
           size = 5, fontface = "bold", colour = if (przyklad$wynik < 0) kol[["cynober"]] else kol[["niebieski"]], lineheight = 1.1) +
  annotate("text", x = 17.8, y = 2.0, label = "wynik > 0: pozytywna\nwynik = 0: brak sygnału\nwynik < 0: negatywna",
           size = 3.8, colour = "grey30", lineheight = 1.05) +
  scale_colour_manual(values = c("poza słownikiem" = "grey55", "w słowniku" = "grey10",
                                 "pozytywne" = kol[["niebieski"]], "negatywne" = kol[["cynober"]]), guide = "none") +
  coord_cartesian(xlim = c(0, 20), ylim = c(0.3, 10.8), expand = FALSE) +
  labs(title = "Jak słownik zamienia opinię w liczbę",
       subtitle = sprintf("Opinia nr %d z %s; słownik: %d form wyrazów z wagami od −2 do +2", przyklad$id,
                          przyklad$miesiac, nrow(slownik))) +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major = element_blank())
p1   # zapis: ggsave("sentyment-schemat-slownika.svg", p1, width = 10, height = 6)
Wynik w R
-2 -1  1  2
10 21 25 16
             tokenow         roznych_slow      slow_w_slowniku
               22344                  183                   72
             trafien zanegowanych_trafien opinie_bez_trafienia
                5648                  870                  328
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
 -8.000   0.000   2.000   1.393   3.000  10.000
 id miesiac gwiazdki
 27 2024-11        3
                                                                                       tekst
 Cena wyższa niż w aplikacji, porażka. Nie czekałam ani minuty. Pani stylistka to mistrzyni.
 wynik
     1
 nr_zdania     slowo zanegowane waga wklad
         1      cena      FALSE   NA    NA
         1    wyższa      FALSE   NA    NA
         1       niż      FALSE   NA    NA
         1         w      FALSE   NA    NA
         1 aplikacji      FALSE   NA    NA
         1   porażka      FALSE   -2    -2
         2       nie      FALSE   NA    NA
         2  czekałam       TRUE   -1     1
         2       ani       TRUE   NA    NA
         2    minuty      FALSE   NA    NA
         3      pani      FALSE   NA    NA
         3 stylistka      FALSE   NA    NA
         3        to      FALSE   NA    NA
         3 mistrzyni      FALSE    2     2
3. Trafność wobec gwiazdek: Rysunki 2 i 3
R
# Przepis 3. Trafność wyniku słownikowego wobec gwiazdek: Rysunki 2 i 3
# Korzysta z obiektów przepisów 1–2: opinie (z kolumnami wynik i klasa_slownik), kol, motyw.
library(ggplot2)

# Gwiazdki jako „wzorzec”: 1–2 = negatywna, 3 = mieszana, 4–5 = pozytywna
opinie$klasa_gwiazdki <- cut(opinie$gwiazdki, c(0, 2, 3, 5), labels = c("1–2 gwiazdki", "3 gwiazdki", "4–5 gwiazdek"))
mp <- table(gwiazdki = opinie$klasa_gwiazdki, slownik = opinie$klasa_slownik)   # macierz pomyłek 3 × 3
mp
round(100 * prop.table(mp, 1), 1)                                # odsetki w wierszach

# Trafność dla opinii jednoznacznych (bez 3 gwiazdek): wynik 0 liczymy jako pomyłkę
biegun <- opinie$gwiazdki != 3
zgodne <- (opinie$gwiazdki >= 4 & opinie$wynik > 0) | (opinie$gwiazdki <= 2 & opinie$wynik < 0)
c(opinie_1_2_lub_4_5 = sum(biegun), trafnosc_proc = round(100 * mean(zgodne[biegun]), 1),
  pokrycie_proc = round(100 * mean(opinie$wynik[biegun] != 0), 1),
  trafnosc_gdy_wynik_niezerowy = round(100 * mean(zgodne[biegun & opinie$wynik != 0]), 1))

# Kappa Cohena dla tabeli 3 × 3 (zgodność ponad przypadek)
po <- sum(diag(mp)) / sum(mp); pe <- sum(rowSums(mp) * colSums(mp)) / sum(mp)^2
round(c(zgodnosc_obserwowana = po, zgodnosc_losowa = pe, kappa = (po - pe) / (1 - pe)), 3)

# Korelacja Spearmana wyniku z gwiazdkami i 95% przedział bootstrapowy (2000 prób)
rho <- cor(opinie$wynik, opinie$gwiazdki, method = "spearman")
set.seed(661)
rho_b <- replicate(2000, { i <- sample(nrow(opinie), replace = TRUE)
  cor(opinie$wynik[i], opinie$gwiazdki[i], method = "spearman") })
round(c(rho = rho, dolna = quantile(rho_b, .025, names = FALSE), gorna = quantile(rho_b, .975, names = FALSE)), 3)

# Średni wynik w każdej grupie gwiazdek z 95% CI (t)
sr <- do.call(rbind, lapply(1:5, function(g) { x <- opinie$wynik[opinie$gwiazdki == g]
  data.frame(gwiazdki = g, n = length(x), srednia = mean(x),
             dolna = mean(x) - qt(.975, length(x) - 1) * sd(x) / sqrt(length(x)),
             gorna = mean(x) + qt(.975, length(x) - 1) * sd(x) / sqrt(length(x))) }))
print(sr, digits = 3, row.names = FALSE)

# --- Rysunek 2: wynik słownikowy a liczba gwiazdek ---
p2 <- ggplot(opinie, aes(factor(gwiazdki), wynik)) +
  geom_hline(yintercept = 0, colour = "grey50", linetype = "dashed") +
  geom_count(colour = kol[["blekit"]], alpha = 0.6) +
  geom_errorbar(data = sr, aes(x = factor(gwiazdki), ymin = dolna, ymax = gorna), inherit.aes = FALSE,
                width = 0.25, linewidth = 0.9, colour = kol[["cynober"]]) +
  geom_point(data = sr, aes(x = factor(gwiazdki), y = srednia), inherit.aes = FALSE, shape = 23, size = 3.6,
             fill = kol[["cynober"]], colour = "white") +
  geom_text(data = sr, aes(x = factor(gwiazdki), y = 10.8, label = sprintf("M = %s\nn = %d", sub("^-", "−", sprintf("%.2f", srednia)), n)),
            inherit.aes = FALSE, size = 3.6, lineheight = 0.95, colour = "grey25") +
  scale_size_area(max_size = 9, name = "liczba opinii", breaks = c(10, 50, 150)) +
  scale_y_continuous(breaks = seq(-8, 10, 2), limits = c(-8.5, 11.6), labels = function(x) sub("^-", "−", x)) +
  labs(x = "Liczba gwiazdek w opinii", y = "Wynik sentymentu (suma wag)",
       title = "Wynik słownika rośnie z liczbą gwiazdek, ale grupy mocno na siebie zachodzą",
       subtitle = sprintf("Kółko = liczba opinii z danym wynikiem; romb = średnia z 95%% CI; ρ Spearmana = %.2f",
                          rho) |> sub(pattern = "0\\.", replacement = ".")) +
  motyw
p2   # zapis: ggsave("sentyment-wynik-a-gwiazdki.svg", p2, width = 10, height = 6)

# --- Rysunek 3: macierz pomyłek (wiersze = gwiazdki, kolumny = słownik) ---
md <- as.data.frame(mp)
md$proc <- as.vector(100 * prop.table(mp, 1))
md$zgodna <- as.integer(md$gwiazdki) == as.integer(md$slownik)
p3 <- ggplot(md, aes(slownik, gwiazdki)) +
  geom_tile(aes(fill = proc), colour = "white", linewidth = 1.2) +
  geom_tile(data = md[md$zgodna, ], fill = NA, colour = "#0f1d3a", linewidth = 1.1, width = 0.96, height = 0.96) +
  geom_text(aes(label = sprintf("%d\n(%.1f%%)", Freq, proc), colour = proc > 45), size = 4.6, lineheight = 0.95) +
  scale_fill_gradient(low = "#F2F2F2", high = kol[["niebieski"]], limits = c(0, 100), name = "% wiersza") +
  scale_colour_manual(values = c("FALSE" = "grey10", "TRUE" = "white"), guide = "none") +
  scale_y_discrete(limits = rev) +
  labs(x = "Klasa według słownika", y = "Klasa według gwiazdek",
       title = "Macierz pomyłek: słownik a gwiazdki",
       subtitle = "Liczba opinii i odsetek w wierszu; ramki = przekątna (zgodne klasy)") +
  motyw + theme(panel.grid.major = element_blank(), legend.key.width = unit(1.4, "cm"))
p3   # zapis: ggsave("sentyment-macierz-pomylek.svg", p3, width = 10, height = 6)
Wynik w R
              slownik
gwiazdki       negatywna brak sygnału pozytywna
  1–2 gwiazdki       505          132       100
  3 gwiazdki          40          110       201
  4–5 gwiazdek        11          212      1336
              slownik
gwiazdki       negatywna brak sygnału pozytywna
  1–2 gwiazdki      68.5         17.9      13.6
  3 gwiazdki        11.4         31.3      57.3
  4–5 gwiazdek       0.7         13.6      85.7
          opinie_1_2_lub_4_5                trafnosc_proc
                      2296.0                         80.2
               pokrycie_proc trafnosc_gdy_wynik_niezerowy
                        85.0                         94.3
zgodnosc_obserwowana      zgodnosc_losowa                kappa
               0.737                0.445                0.526
  rho dolna gorna
0.661 0.637 0.684
 gwiazdki   n srednia dolna  gorna
        1 455  -1.527 -1.68 -1.371
        2 282  -0.624 -0.84 -0.408
        3 351   1.074  0.88  1.268
        4 666   2.398  2.26  2.535
        5 893   2.894  2.76  3.024
4. Najczęstsze słowa pozytywne i negatywne: Rysunek 4
R
# Przepis 4. Najczęstsze słowa pozytywne i negatywne (po uwzględnieniu negacji): Rysunek 4
# Korzysta z obiektów przepisów 1–2: tokeny, slownik, negacje, kol, motyw. Niczego nie losuje.
library(ggplot2)
library(dplyr, warn.conflicts = FALSE)

trafienia <- inner_join(tokeny, slownik, by = "slowo") |>
  mutate(negator = ifelse(poprz1 %in% negacje, poprz1, ifelse(poprz2 %in% negacje, poprz2, NA)),
         etykieta = ifelse(zanegowane, paste(negator, "…", slowo), slowo),   # np. „nie … polecam”
         wklad = ifelse(zanegowane, -waga, waga))
top <- trafienia |>
  summarise(wystapienia = n(), opinie = n_distinct(id), wklad = first(wklad), .by = etykieta) |>
  mutate(strona = ifelse(wklad > 0, "Słowa pozytywne", "Słowa negatywne"), suma_wag = wystapienia * wklad) |>
  arrange(desc(wystapienia)) |>
  slice_head(n = 10, by = strona)
print(as.data.frame(top), row.names = FALSE)
# Ile trafień to słowa po negacji i jaki ich udział w sumie wag
c(trafien = nrow(trafienia), po_negacji = sum(trafienia$zanegowane),
  udzial_nie_polecam_wsrod_negatywnych = round(100 * sum(trafienia$etykieta == "nie … polecam") /
                                                 sum(trafienia$wklad < 0), 1),
  super_w_opiniach_ironicznych = sum(trafienia$slowo == "super" & trafienia$id %in% opinie$id[opinie$ironia]))

p4 <- ggplot(top, aes(wystapienia, reorder(etykieta, wystapienia), fill = strona)) +
  geom_col(width = 0.7) +
  geom_text(aes(label = sprintf("%d  (waga %s)", wystapienia, sub("^-", "−", sprintf("%+d", wklad)))),
            hjust = -0.08, size = 3.7, colour = "grey20") +
  facet_wrap(~ factor(strona, levels = c("Słowa pozytywne", "Słowa negatywne")), scales = "free_y") +
  scale_fill_manual(values = c("Słowa pozytywne" = kol[["niebieski"]], "Słowa negatywne" = kol[["cynober"]]),
                    guide = "none") +
  scale_x_continuous(expand = expansion(mult = c(0, 0.45))) +
  labs(x = "Liczba wystąpień we wszystkich opiniach", y = NULL,
       title = "Najczęstsze słowa ze słownika – po uwzględnieniu negacji",
       subtitle = "„nie … polecam” to osobna pozycja: słowo pozytywne z odwróconym znakiem") +
  motyw + theme(panel.grid.major.y = element_blank())
p4   # zapis: ggsave("sentyment-najczestsze-slowa.svg", p4, width = 10, height = 6)
Wynik w R
      etykieta wystapienia opinie wklad          strona suma_wag
         super         303    297     2 Słowa pozytywne      606
       pięknie         153    153     1 Słowa pozytywne      153
   sympatyczny         152    152     1 Słowa pozytywne      152
 profesjonalny         152    152     2 Słowa pozytywne      304
     mistrzyni         151    151     2 Słowa pozytywne      302
      idealnie         147    147     2 Słowa pozytywne      294
        szybko         147    147     1 Słowa pozytywne      147
      sprawnie         147    147     1 Słowa pozytywne      147
          miła         144    144     1 Słowa pozytywne      144
      dokładna         144    144     1 Słowa pozytywne      144
         drogo         154    154    -1 Słowa negatywne     -154
 nie … polecam         148    146    -2 Słowa negatywne     -296
       porażka         120    117    -2 Słowa negatywne     -240
       bałagan         109    108    -1 Słowa negatywne     -109
      odwołana          84     84    -1 Słowa negatywne      -84
      czekałam          82     82    -1 Słowa negatywne      -82
   przesunięta          62     62    -1 Słowa negatywne      -62
    spóźnienie          61     61    -1 Słowa negatywne      -61
       niemiła          60     60    -1 Słowa negatywne      -60
     pośpiechu          60     60    -1 Słowa negatywne      -60
                             trafien                           po_negacji
                              5648.0                                870.0
udzial_nie_polecam_wsrod_negatywnych         super_w_opiniach_ironicznych
                                 9.9                                 76.0
5. Trend miesięczny i przerwany szereg czasowy: Rysunek 5
R
# Przepis 5. Trend miesięczny sentymentu z 95% CI i zmiana po nowym systemie rezerwacji: Rysunek 5
# Korzysta z obiektów przepisów 1–2: opinie (z kolumną wynik), tokeny, kol, motyw. Niczego nie losuje.
library(ggplot2)
library(patchwork)
library(sandwich)
library(lmtest)

# Średnia miesięczna z 95% przedziałem ufności (t) – osobno wynik słownika i gwiazdki
srednia_ci <- function(x) { m <- mean(x); h <- qt(.975, length(x) - 1) * sd(x) / sqrt(length(x))
  c(n = length(x), srednia = m, dolna = m - h, gorna = m + h) }
mies <- do.call(rbind, lapply(split(opinie, opinie$miesiac_nr), function(d)
  data.frame(miesiac_nr = d$miesiac_nr[1], miesiac = d$miesiac[1],
             miara = c("Wynik słownika (suma wag)", "Liczba gwiazdek"),
             rbind(srednia_ci(d$wynik), srednia_ci(d$gwiazdki)))))
print(mies[mies$miara == "Wynik słownika (suma wag)", -3], digits = 3, row.names = FALSE)

# Regresja segmentowa (przerwany szereg czasowy) na poziomie opinii:
# poziom i nachylenie przed zmianą, skok poziomu (po) i zmiana nachylenia (czas_po) od listopada 2025;
# błędy standardowe odporne na skupienie opinii w miesiącach (sandwich::vcovCL)
opinie$czas_po <- pmax(0, opinie$miesiac_nr - 12)
its <- function(y) {
  m <- lm(y ~ miesiac_nr + po_zmianie + czas_po, data = opinie)
  ct <- coeftest(m, vcov = vcovCL(m, cluster = ~ miesiac_nr))
  ci <- coefci(m, vcov = vcovCL(m, cluster = ~ miesiac_nr))
  round(cbind(b = ct[, 1], se = ct[, 2], dolna = ci[, 1], gorna = ci[, 2], p = ct[, 4]), 3)
}
its(opinie$wynik)
its(opinie$gwiazdki)

# Prosta różnica średnich: 12 miesięcy po – 12 miesięcy przed (Welch)
tt <- t.test(wynik ~ factor(po_zmianie, levels = c(1, 0)), data = opinie)
round(c(przed = mean(opinie$wynik[opinie$po_zmianie == 0]), po = mean(opinie$wynik[opinie$po_zmianie == 1]),
        roznica = unname(diff(rev(tt$estimate))), dolna = tt$conf.int[1], gorna = tt$conf.int[2]), 2)

# Słowa „terminowe” (czekanie, odwołanie, przesunięcie, spóźnienie, bałagan) bez negacji – odsetek opinii
terminowe <- c("czekałam", "czekałem", "czekania", "odwołana", "przesunięta", "spóźnienie", "bałagan")
z_terminem <- unique(tokeny$id[tokeny$slowo %in% terminowe & !tokeny$zanegowane])
opinie$slowo_terminowe <- opinie$id %in% z_terminem
round(100 * tapply(opinie$slowo_terminowe, opinie$po_zmianie, mean), 1)   # 0 = przed, 1 = po

# --- Rysunek 5: dwa panele – wynik słownika i gwiazdki, miesiąc po miesiącu ---
rysuj <- function(d, kolor, tytul) {
  ggplot(d, aes(miesiac_nr, srednia)) +
    annotate("rect", xmin = 12.5, xmax = 24.5, ymin = -Inf, ymax = Inf, fill = "grey93") +
    geom_vline(xintercept = 12.5, linetype = "dashed", colour = "grey35") +
    geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0.3, colour = kolor, alpha = 0.7) +
    geom_point(colour = kolor, size = 2.3) +
    geom_smooth(aes(group = miesiac_nr > 12.5), method = "lm", formula = y ~ x, se = FALSE,
                colour = "#0f1d3a", linewidth = 0.8) +
    scale_x_continuous(breaks = c(1, 7, 13, 19, 24), labels = d$miesiac[match(c(1, 7, 13, 19, 24), d$miesiac_nr)]) +
    labs(x = NULL, y = NULL, subtitle = tytul) + motyw
}
p5 <- rysuj(mies[mies$miara == "Wynik słownika (suma wag)", ], kol[["niebieski"]], "Średni wynik słownika (95% CI)") +
  annotate("text", x = 13, y = Inf, vjust = 1.4, hjust = 0, size = 3.8, colour = "grey25",
           label = "nowy system rezerwacji od 2025-11") +
  rysuj(mies[mies$miara == "Liczba gwiazdek", ], kol[["cynober"]], "Średnia liczba gwiazdek (95% CI)") +
  plot_layout(ncol = 1) +
  plot_annotation(title = "Sentyment opinii miesiąc po miesiącu: skok po zmianie systemu rezerwacji",
                  theme = theme(plot.title = element_text(face = "bold", colour = "#0f1d3a")))
p5   # zapis: ggsave("sentyment-trend-miesieczny.svg", p5, width = 10, height = 7)
Wynik w R
 miesiac_nr miesiac   n srednia dolna gorna
          1 2024-11 115   1.374 0.905  1.84
          2 2024-12 119   1.109 0.662  1.56
          3 2025-01 112   0.911 0.469  1.35
          4 2025-02 127   1.268 0.838  1.70
          5 2025-03 109   1.092 0.659  1.52
          6 2025-04 123   1.512 1.007  2.02
          7 2025-05 110   1.555 1.067  2.04
          8 2025-06 103   1.146 0.622  1.67
          9 2025-07 100   0.950 0.428  1.47
         10 2025-08  99   1.616 1.112  2.12
         11 2025-09 102   1.137 0.588  1.69
         12 2025-10 119   1.017 0.619  1.41
         13 2025-11 115   1.687 1.219  2.16
         14 2025-12 121   1.851 1.346  2.36
         15 2026-01 110   2.009 1.594  2.42
         16 2026-02 109   1.229 0.761  1.70
         17 2026-03 122   1.541 1.050  2.03
         18 2026-04 101   1.366 0.906  1.83
         19 2026-05 111   1.505 1.049  1.96
         20 2026-06  95   1.653 1.200  2.10
         21 2026-07 116   1.741 1.262  2.22
         22 2026-08 106   1.368 0.810  1.93
         23 2026-09 111   1.423 0.966  1.88
         24 2026-10  92   1.304 0.838  1.77
                 b    se  dolna gorna     p
(Intercept)  1.234 0.116  1.006 1.461 0.000
miesiac_nr  -0.001 0.017 -0.035 0.032 0.935
po_zmianie   0.557 0.179  0.206 0.908 0.002
czas_po     -0.032 0.022 -0.075 0.011 0.147
                 b    se  dolna gorna     p
(Intercept)  3.462 0.037  3.390 3.535 0.000
miesiac_nr  -0.013 0.007 -0.026 0.000 0.059
po_zmianie   0.260 0.103  0.057 0.462 0.012
czas_po      0.014 0.012 -0.010 0.037 0.245
  przed      po roznica   dolna   gorna
   1.22    1.56    0.34    0.15    0.53
   0    1
22.1 11.3
6. Negacja, słownik z innej dziedziny, ironia i długość opinii: Rysunek 6
R
# Przepis 6. Pułapki: brak negacji, słownik z innej dziedziny, ironia i krótkie opinie: Rysunek 6
# Korzysta z obiektów przepisów 1–3: opinie, tokeny, slownik, policz(), kol, motyw. Niczego nie losuje.
library(ggplot2)
library(patchwork)

biegun <- opinie$gwiazdki != 3                   # opinie jednoznaczne: 1–2 albo 4–5 gwiazdek
trafnosc <- function(wynik, ktore = biegun) {    # odsetek zgodnych z gwiazdkami + 95% CI Wilsona
  ok <- ((opinie$gwiazdki >= 4 & wynik > 0) | (opinie$gwiazdki <= 2 & wynik < 0))[ktore]
  ci <- prop.test(sum(ok), length(ok), correct = FALSE)$conf.int
  c(n = length(ok), trafnosc = 100 * mean(ok), dolna = 100 * ci[1], gorna = 100 * ci[2],
    pokrycie = 100 * mean(wynik[ktore] != 0))
}

# Wariant „słownik z innej dziedziny”: brak słów typowych dla wizyt (czekanie, odwołanie, punktualność…)
# i słowa, które w opisie fryzury są neutralne, a w ogólnym słowniku – negatywne (krótko, ciemny, ostro…)
bez_branzowych <- c("punktualnie", "czekałam", "czekałem", "czekania", "odwołana", "przesunięta",
                    "spóźnienie", "krzywo", "mistrzyni")
obcy <- rbind(slownik[!slownik$slowo %in% bez_branzowych, ],
              data.frame(slowo = c("krótko", "ciemny", "ostro", "zimny", "cienkie"), waga = -1))
warianty <- list(
  "Słownik branżowy z negacją" = opinie$wynik,
  "Ten sam słownik bez negacji" = policz(tokeny, slownik, z_negacja = FALSE)$wynik,
  "Słownik z innej dziedziny" = policz(tokeny, obcy)$wynik)
tab_w <- t(sapply(warianty, trafnosc))
cbind(round(tab_w, 1), rho = round(sapply(warianty, cor, y = opinie$gwiazdki, method = "spearman"), 3))

# Ironia (znana tylko w symulacji): jak często słownik daje wynik dodatni opinii ironicznej z 1–2 gwiazdkami?
ir <- opinie$ironia & opinie$gwiazdki <= 2
c(ironiczne_1_2 = sum(ir), z_wynikiem_dodatnim_proc = round(100 * mean(opinie$wynik[ir] > 0), 1),
  trafnosc_ironiczne = round(trafnosc(opinie$wynik, ir & biegun)[["trafnosc"]], 1),
  trafnosc_pozostale = round(trafnosc(opinie$wynik, !opinie$ironia & biegun)[["trafnosc"]], 1))

# Długość opinii: trafność i pokrycie (odsetek opinii z wynikiem różnym od 0)
opinie$dlugosc <- cut(opinie$n_slow, c(0, 3, 10, Inf), labels = c("1–3 słowa", "4–10 słów", "11 i więcej słów"))
tab_d <- t(sapply(levels(opinie$dlugosc), function(l) trafnosc(opinie$wynik, biegun & opinie$dlugosc == l)))
round(tab_d, 1)
# Krótkie opinie bez żadnego słowa ze słownika – które teksty?
sort(table(opinie$tekst[opinie$n_slow <= 3 & opinie$wynik == 0]), decreasing = TRUE)

# --- Rysunek 6: dwa panele ---
dw <- data.frame(wariant = factor(rownames(tab_w), levels = rev(rownames(tab_w))), tab_w)
dd <- data.frame(dlugosc = factor(rownames(tab_d), levels = rownames(tab_d)), tab_d)
pa <- ggplot(dw, aes(trafnosc, wariant)) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), orientation = "y", width = 0.2, colour = kol[["niebieski"]]) +
  geom_point(size = 3.4, colour = kol[["niebieski"]]) +
  geom_text(aes(label = sprintf("%.1f%%", trafnosc)), vjust = -1.1, size = 3.8) +
  scale_x_continuous(limits = c(50, 90)) +
  labs(x = "Trafność wobec gwiazdek (%, 95% CI)", y = NULL, subtitle = "A. Wersja słownika") + motyw
pb <- ggplot(dd, aes(dlugosc)) +
  geom_col(aes(y = pokrycie, fill = "pokrycie: wynik ≠ 0"), width = 0.7) +
  geom_point(aes(y = trafnosc, shape = "trafność"), size = 3.4, colour = kol[["cynober"]]) +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0.18, colour = kol[["cynober"]]) +
  geom_text(aes(y = 3, label = sprintf("n = %d", n)), size = 3.4, colour = "white") +
  scale_fill_manual(values = kol[["blekit"]], name = NULL) + scale_shape_manual(values = 18, name = NULL) +
  scale_y_continuous(limits = c(0, 100)) +
  labs(x = NULL, y = "%", subtitle = "B. Długość opinii (słownik branżowy)") + motyw
p6 <- pa + pb + plot_layout(widths = c(1, 1.1)) +
  plot_annotation(title = "Gdzie słownik się myli: negacja, obca dziedzina i krótkie opinie",
                  subtitle = sprintf("Opinie z 1–2 albo 4–5 gwiazdkami (n = %d); wynik 0 liczony jako pomyłka", sum(biegun)),
                  theme = theme(plot.title = element_text(face = "bold", colour = "#0f1d3a")))
p6   # zapis: ggsave("sentyment-pulapki.svg", p6, width = 10, height = 5.6)
Wynik w R
                               n trafnosc dolna gorna pokrycie   rho
Słownik branżowy z negacją  2296     80.2  78.5  81.8     85.0 0.661
Ten sam słownik bez negacji 2296     66.6  64.7  68.5     81.0 0.466
Słownik z innej dziedziny   2296     73.2  71.4  75.0     79.7 0.586
           ironiczne_1_2 z_wynikiem_dodatnim_proc       trafnosc_ironiczne
                    88.0                     63.6                     25.0
      trafnosc_pozostale
                    82.3
                   n trafnosc dolna gorna pokrycie
1–3 słowa        652     61.3  57.6  65.0     61.7
4–10 słów        916     90.0  87.8  91.7     94.5
11 i więcej słów 728     84.8  82.0  87.2     94.0

  Bez zastrzeżeń.             10/10          Jest ok. Szkoda pieniędzy.
               68                63                57                42
    Nigdy więcej.
               27
7. Sprawdzenie palety (deuteranopia i protanopia)
R
# Przepis 7. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (pozytywne / negatywne; wynik / gwiazdki)" = c("#0072B2", "#D55E00"),
             "błękit – cynober (pokrycie / trafność; kółka / średnie)" = c("#56B4E9", "#D55E00"),
             "jasnoszary – niebieski (skala macierzy pomyłek)" = c("#F2F2F2", "#0072B2"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  k <- rgb(t(col2rgb(k)), maxColorValue = 255)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(hex(k))),
                                   protanopia = roznica(protan(hex(k)))))), 1)
Wynik w R
                                                              widzenie_typowe
niebieski – cynober (pozytywne / negatywne; wynik / gwiazdki)           114.6
błękit – cynober (pokrycie / trafność; kółka / średnie)                 113.6
jasnoszary – niebieski (skala macierzy pomyłek)                          64.6
czerwony – zielony (do unikania)                                        121.7
                                                              deuteranopia
niebieski – cynober (pozytywne / negatywne; wynik / gwiazdki)        108.3
błękit – cynober (pokrycie / trafność; kółka / średnie)              101.1
jasnoszary – niebieski (skala macierzy pomyłek)                       68.4
czerwony – zielony (do unikania)                                      21.1
                                                              protanopia
niebieski – cynober (pozytywne / negatywne; wynik / gwiazdki)       91.9
błękit – cynober (pokrycie / trafność; kółka / średnie)             89.0
jasnoszary – niebieski (skala macierzy pomyłek)                     59.9
czerwony – zielony (do unikania)                                    31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, regresja lm(), korelacja Spearmana i przedziały Wilsona – pakiety base i stats). Tokenizację wykonano pakietem tidytext, operacje na tabelach – dplyr, błędy standardowe odporne na klastrowanie – sandwich i lmtest. Rysunki wykonano w ggplot2 (panele – patchwork); pliki SVG zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- tidytext (wersja 0.4.3): Silge, J., & Robinson, D. (2016). tidytext: Text mining and analysis using tidy data principles in R. Journal of Open Source Software, 1(3), 37. https://doi.org/10.21105/joss.00037
- dplyr (wersja 1.2.0): Wickham, H., François, R., Henry, L., Müller, K., & Vaughan, D. (2026). dplyr: A grammar of data manipulation [R package]. https://doi.org/10.32614/CRAN.package.dplyr
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Ironia. „No super, czekałam tylko godzinę” zawiera słowo pozytywne i daje wynik dodatni. Słownik ironii nie rozpozna (63.6% ironicznych opinii z 1–2 gwiazdkami dostało wynik dodatni).
- Słowa branżowe. „Krótko”, „ciemny” i „ostro” u fryzjera opisują fryzurę, a nie wadę. Słownik z innej dziedziny obniżył trafność z 80.2% do 73.2%. Przejrzyj listę najczęstszych słów, zanim przyjmiesz cudzy słownik.
- Krótkie opinie. „Bez zastrzeżeń”, „10/10”, „Nigdy więcej” nie mają słów ze słownika. Wynik 0 to brak informacji, a nie opinia neutralna – raportuj odsetek takich opinii osobno.
- Suma rośnie z długością. Długa opinia zbiera więcej słów, więc ma wynik bardziej skrajny. Porównując grupy o różnej długości opinii, użyj klasy (pozytywna/negatywna) albo wyniku podzielonego przez liczbę słów.
- Słownik dobierany pod wynik. Dopisywanie słów po obejrzeniu trendu to ukryta elastyczność analizy. Słownik ustal przed analizą okresu, który porównujesz, a zmiany opisz w pracy.
Pomoc w takiej analizie: analizy statystyczne dla studentów.
Najczęstsze pytania
Jak zrobić analizę sentymentu opinii klientów w R?
Podziel opinie na słowa (np. unnest_tokens() z pakietu tidytext), połącz je ze słownikiem wydźwięku, w którym każde słowo ma wagę, i zsumuj wagi w każdej opinii. Słowa po „nie” licz ze znakiem odwrotnym. Potem sprawdź trafność wyniku wobec gwiazdek albo ręcznie oznaczonej próbki – w przykładzie korelacja Spearmana wyniosła .661.
Skąd wziąć polski słownik wydźwięku do opinii klientów?
Gotowe zasoby angielskie nie pasują do polskich tekstów, a ogólne słowniki często źle oceniają słowa branżowe. Najprościej przygotować własny słownik: przejrzeć listę najczęstszych słów w opiniach, nadać wagi (np. od −2 do +2) i opisać to w pracy. Polskie opinie konsumenckie oznaczone pod względem wydźwięku zawiera korpus PolEmo 2.0 (Kocoń i in., 2019).
Dlaczego negacja jest ważna w analizie sentymentu?
Bez niej „nie polecam” liczy się jak „polecam”, a „bez czekania” jak skarga. W przykładzie usunięcie reguły negacji obniżyło trafność klasyfikacji z 80.2% do 66.6%, a korelację wyniku z gwiazdkami z .661 do .466. Najprostsza reguła odwraca znak słowa, jeśli jedno z dwóch poprzednich słów w zdaniu to „nie”, „bez” albo „niezbyt”.
Jak sprawdzić trafność analizy sentymentu?
Porównaj wynik z niezależnym kryterium: gwiazdkami albo próbką opinii oznaczonych ręcznie. Policz korelację Spearmana, macierz pomyłek z odsetkami w wierszach i kappę Cohena. Patrz osobno na opinie negatywne – w przykładzie słownik rozpoznał 85.7% opinii z 4–5 gwiazdkami, ale tylko 68.5% opinii z 1–2 gwiazdkami.
Jak pokazać zmianę sentymentu opinii w czasie?
Policz średni wynik w każdym miesiącu z 95% przedziałem ufności, a zmianę po wdrożeniu oceń regresją segmentową (przerwany szereg czasowy) z błędami odpornymi na klastrowanie w miesiącach. W przykładzie skok po nowym systemie rezerwacji wyniósł 0.557 punktu, 95% CI [0.206, 0.908]. Bez grupy porównawczej wynik nie dowodzi, że to zmiana systemu poprawiła opinie.
Powiązane hasła
Przeczytaj też
Analiza tekstu odpowiedzi otwartych w R
Polskie stopwords, tokenizacja, częstości, bigramy i model tematów stm na fikcyjnych odpowiedziach – z walidacją przez lekturę i wzorem opisu.
Czytaj →PoradnikOceny gwiazdkowe i ranking produktów
Sklep z artykułami kuchennymi: rozkład J, wykres lejkowy, przedział Wilsona, średnia wygładzona i symulacja 1000 sklepów z kodem R.
Czytaj →PoradnikRegresja segmentowa i przerwany szereg czasowy
Zmiana poziomu i nachylenia, gls z AR(1), sezonowość, szereg kontrolny, nieznany punkt załamania z bootstrapem, przykład w R i wzór opisu.
Czytaj →PoradnikWykrywanie fałszywych opinii
Portal z opiniami o warsztatach: skupiska ocen, profil konta, las losowy, 5 kontroli dziennie, krzywa PR i ranking po moderacji – z kodem R.
Czytaj →Masz w pracy opinie klientów do przeanalizowania?
Pomożemy przygotować słownik wydźwięku, policzyć wynik sentymentu, sprawdzić jego trafność i opisać trend w czasie tak, żebyś umiał(a) obronić wyniki.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- González-Bailón, S., & Paltoglou, G. (2015). Signals of public opinion in online communication: A comparison of methods and data sources. The ANNALS of the American Academy of Political and Social Science, 659(1), 95–107. https://doi.org/10.1177/0002716215569192
- Grimmer, J., & Stewart, B. M. (2013). Text as data: The promise and pitfalls of automatic content analysis methods for political texts. Political Analysis, 21(3), 267–297. https://doi.org/10.1093/pan/mps028 ● Otwarty dostęp
- Hu, N., Pavlou, P. A., & Zhang, J. (2017). On self-selection biases in online product reviews. MIS Quarterly, 41(2), 449–471. https://doi.org/10.25300/misq/2017/41.2.06
- Kocoń, J., Miłkowski, P., & Zaśko-Zielińska, M. (2019). Multi-level sentiment analysis of PolEmo 2.0: Extended corpus of multi-domain consumer reviews. In Proceedings of the 23rd Conference on Computational Natural Language Learning (CoNLL) (pp. 980–991). Association for Computational Linguistics. https://doi.org/10.18653/v1/k19-1092 ● Otwarty dostęp
- Loughran, T., & McDonald, B. (2011). When is a liability not a liability? Textual analysis, dictionaries, and 10-Ks. The Journal of Finance, 66(1), 35–65. https://doi.org/10.1111/j.1540-6261.2010.01625.x ● Otwarty dostęp: pełny tekst
- Ribeiro, F. N., Araújo, M., Gonçalves, P., André Gonçalves, M., & Benevenuto, F. (2016). SentiBench – a benchmark comparison of state-of-the-practice sentiment analysis methods. EPJ Data Science, 5(1), Article 23. https://doi.org/10.1140/epjds/s13688-016-0085-1 ● Otwarty dostęp
- Silge, J., & Robinson, D. (2016). tidytext: Text mining and analysis using tidy data principles in R. Journal of Open Source Software, 1(3), Article 37. https://doi.org/10.21105/joss.00037 ● Otwarty dostęp
- Taboada, M., Brooke, J., Tofiloski, M., Voll, K., & Stede, M. (2011). Lexicon-based methods for sentiment analysis. Computational Linguistics, 37(2), 267–307. https://doi.org/10.1162/coli_a_00049 ● Otwarty dostęp
Cytowania BibTeX
@article{gonzalezbailon2015signals, author={González-Bailón, Sandra and Paltoglou, Georgios}, title={{Signals of public opinion in online communication: A comparison of methods and data sources}}, journal={The ANNALS of the American Academy of Political and Social Science}, year={2015}, volume={659}, number={1}, pages={95--107}, doi={10.1177/0002716215569192}}@article{grimmer2013text, author={Grimmer, Justin and Stewart, Brandon M.}, title={{Text as data: The promise and pitfalls of automatic content analysis methods for political texts}}, journal={Political Analysis}, year={2013}, volume={21}, number={3}, pages={267--297}, doi={10.1093/pan/mps028}}@article{hu2017self, author={Hu, Nan and Pavlou, Paul A. and Zhang, Jie}, title={{On self-selection biases in online product reviews}}, journal={MIS Quarterly}, year={2017}, volume={41}, number={2}, pages={449--471}, doi={10.25300/misq/2017/41.2.06}}@inproceedings{kocon2019multilevel, author={Kocoń, Jan and Miłkowski, Piotr and Zaśko-Zielińska, Monika}, title={{Multi-level sentiment analysis of PolEmo 2.0: Extended corpus of multi-domain consumer reviews}}, booktitle={Proceedings of the 23rd Conference on Computational Natural Language Learning (CoNLL)}, year={2019}, pages={980--991}, publisher={Association for Computational Linguistics}, doi={10.18653/v1/k19-1092}}@article{loughran2011when, author={Loughran, Tim and McDonald, Bill}, title={{When is a liability not a liability? Textual analysis, dictionaries, and 10-Ks}}, journal={The Journal of Finance}, year={2011}, volume={66}, number={1}, pages={35--65}, doi={10.1111/j.1540-6261.2010.01625.x}}@article{ribeiro2016sentibench, author={Ribeiro, Filipe N. and Araújo, Matheus and Gonçalves, Pollyanna and André Gonçalves, Marcos and Benevenuto, Fabrício}, title={{SentiBench – a benchmark comparison of state-of-the-practice sentiment analysis methods}}, journal={EPJ Data Science}, year={2016}, volume={5}, number={1}, eid={23}, doi={10.1140/epjds/s13688-016-0085-1}}@article{silge2016tidytext, author={Silge, Julia and Robinson, David}, title={{tidytext: Text mining and analysis using tidy data principles in R}}, journal={Journal of Open Source Software}, year={2016}, volume={1}, number={3}, eid={37}, doi={10.21105/joss.00037}}@article{taboada2011lexicon, author={Taboada, Maite and Brooke, Julian and Tofiloski, Milan and Voll, Kimberly and Stede, Manfred}, title={{Lexicon-based methods for sentiment analysis}}, journal={Computational Linguistics}, year={2011}, volume={37}, number={2}, pages={267--307}, doi={10.1162/coli_a_00049}}