Co to jest metoda k najbliższych sąsiadów?
Metoda k najbliższych sąsiadów (ang. k-nearest neighbors, kNN) klasyfikuje nową obserwację na podstawie k najbliższych jej przypadków z próby uczącej: przypisuje klasę, która przeważa wśród tych sąsiadów. W wersji regresyjnej przewidywaniem jest średnia wyniku sąsiadów. Metoda nie szacuje współczynników – „modelem” są zapamiętane dane i miara odległości (zwykle euklidesowa). Cover i Hart (1967) wykazali, że przy bardzo dużej próbie błąd reguły jednego najbliższego sąsiada jest co najwyżej dwukrotnie większy od błędu najlepszej możliwej reguły klasyfikacyjnej. Altman (1992) przedstawia kNN jako nieparametryczną regresję – lokalną wersję średniej.
Jak dobrać k i odległość
Małe k daje poszarpaną granicę między klasami i sprzyja przeuczeniu; bardzo duże – przypisuje wszystkim klasę dominującą. Liczbę sąsiadów wybiera się walidacją krzyżową, przy dwóch klasach spośród wartości nieparzystych (bez remisów). Przed liczeniem odległości predyktory trzeba standaryzować – inaczej zmienna o największym zakresie, np. dochód w złotych, sama decyduje, kto jest „blisko”. Dla zmiennych mieszanych (ilościowych i jakościowych) stosuje się np. odległość Gowera.
Przykład
W symulowanych danych 300 osób klasa zależy nieliniowo od dwóch wyników testów (układ „szachownicy”), a trzecia zmienna – dochód – jest szumem o dużej skali. Na surowych danych trafność w próbie testowej (100 osób) wyniosła .50–.54, czyli poziom zgadywania. Po standaryzacji wzrosła do .77 (k = 1) i .81 (k = 5 i 15), a przy k = 51 spadła do .66. Walidacja typu leave-one-out wskazała k = 15; w próbie testowej kNN poprawnie sklasyfikował 81 osób na 100 (macierz pomyłek: 43 i 38 trafień, 12 i 7 błędów). Regresja logistyczna z samymi efektami głównymi osiągnęła .49, bo nie uwzględniała interakcji.
Na rysunku
Rysunek używa danych z przykładu (ziarno 684), ale tylko dwóch standaryzowanych testów – granicę da się narysować w dwóch wymiarach, a dochód i tak był szumem. Dlatego trafności różnią się nieco od tych z przykładu. Remisy odległości w knn() rozstrzyga losowanie z ziarnami 6841 i 6842; ziaren nie dobierano.
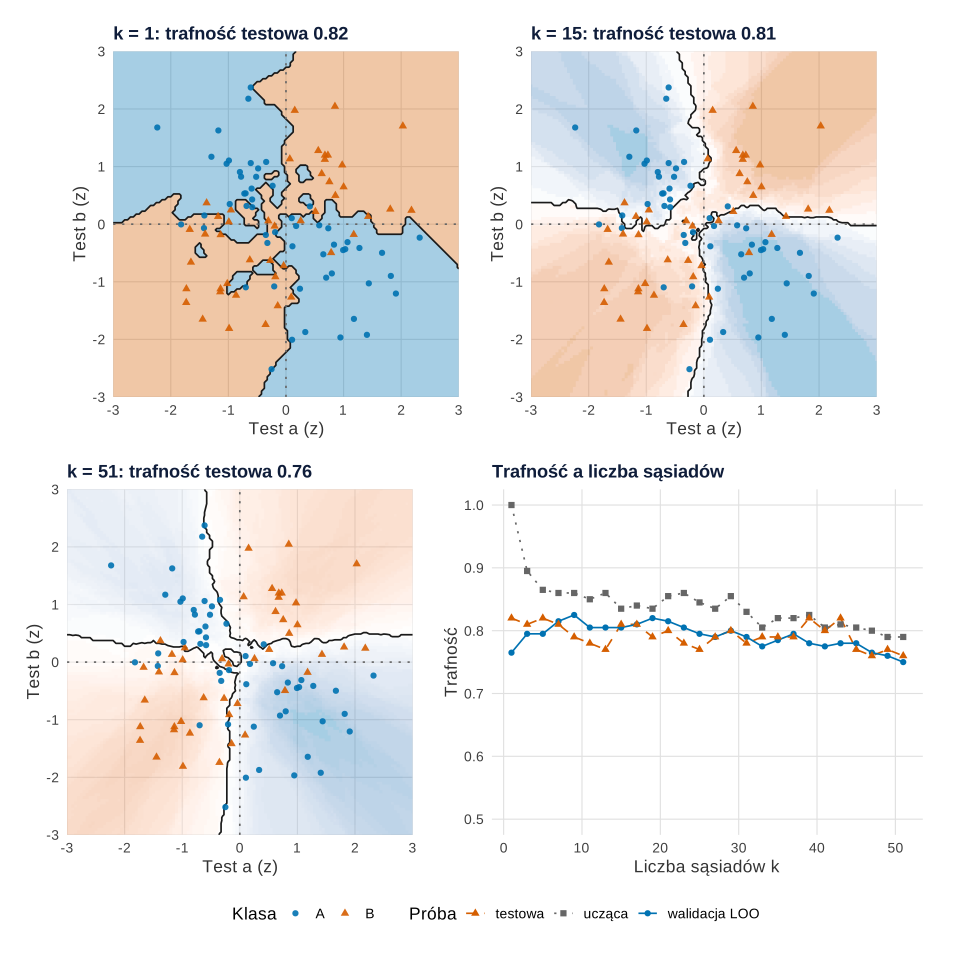
Co widać. Tło pokazuje, jaką klasę kNN przypisałby osobie w danym miejscu, a czarna linia – granicę decyzyjną. Przy k = 1 granica oplata pojedyncze osoby z próby uczącej i tworzy „wyspy”. W próbie uczącej trafność wynosi wtedy 1.00, bo każda osoba jest swoim własnym sąsiadem, a w próbie testowej 0.82. Przy k = 15 granica jest gładka i biegnie blisko prawdziwego podziału (kropkowane osie). Przy k = 51 uśrednianie zaciera narożniki i trafność testowa spada do 0.76. Na ostatnim panelu walidacja leave-one-out najwyżej ocenia k = 9 (0.825), a dla k = 15 daje 0.805.
Na co uważać. Krzywe trafności dla 200 i 100 osób są poszarpane: różnica 0.01 to jedna osoba testowa. Szczyt walidacji wskazuje więc raczej zakres rozsądnych k niż jedną najlepszą wartość. Rysunek w dwóch wymiarach nie pokazuje, jak granicę psują zbędne predyktory i różne skale zmiennych. Ten problem pokazuje przykład z dochodem. Jasność tła oddaje tylko odsetek głosów sąsiadów, nie skalibrowane prawdopodobieństwo.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby; paletę Okabe–Ito i motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (inny krój czcionki i siatka).
Kod R rysunku 1
# Rysunek 1. Granice decyzyjne kNN dla k = 1, 15 i 51 oraz trafność w funkcji k
library(ggplot2)
library(patchwork)
library(class)

kol <- c(A = "#0072B2", B = "#D55E00")                 # Okabe–Ito; klasy różni też kształt punktu
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))

# Dane z przykładu w haśle (to samo ziarno i te same losowania); rysunek używa tylko dwóch testów,
# bo granicę da się narysować w dwóch wymiarach (dochód był szumem)
set.seed(684)
n <- 300
a <- rnorm(n); b <- rnorm(n)
dochod <- rnorm(n, mean = 5000, sd = 1500)
klasa <- factor(ifelse(a * b + rnorm(n, sd = 0.5) > 0, "B", "A"))
ucz <- sample(n, 200)
X <- data.frame(a, b)
Xs <- scale(X, center = colMeans(X[ucz, ]), scale = apply(X[ucz, ], 2, sd))   # standaryzacja z próby uczącej

# Trafność w próbie uczącej, w walidacji leave-one-out i w próbie testowej dla nieparzystych k
set.seed(6841)                                         # knn() losuje przy remisach odległości
k_cv <- seq(1, 51, by = 2)
traf <- data.frame(
  k = rep(k_cv, 3),
  proba = rep(c("ucząca", "walidacja LOO", "testowa"), each = length(k_cv)),
  trafnosc = c(sapply(k_cv, function(k) mean(knn(Xs[ucz, ], Xs[ucz, ], klasa[ucz], k = k) == klasa[ucz])),
               sapply(k_cv, function(k) mean(knn.cv(Xs[ucz, ], klasa[ucz], k = k) == klasa[ucz])),
               sapply(k_cv, function(k) mean(knn(Xs[ucz, ], Xs[-ucz, ], klasa[ucz], k = k) == klasa[-ucz]))))
print(reshape(traf, idvar = "k", timevar = "proba", direction = "wide")[c(1, 3, 8, 26), ], digits = 3,
      row.names = FALSE)
loo <- traf$trafnosc[traf$proba == "walidacja LOO"]
cat("k z najlepszą trafnością LOO:", k_cv[which.max(loo)], " trafność:", max(loo), "\n")
round(sapply(split(traf$trafnosc, traf$proba), range), 3)   # zakres trafności dla k od 1 do 51

# Siatka punktów: dla każdego k odsetek sąsiadów z klasy B wśród 200 osób uczących (tło i granica)
siatka <- expand.grid(a = seq(-3, 3, length.out = 121), b = seq(-3, 3, length.out = 121))
test_df <- data.frame(Xs[-ucz, ], klasa = klasa[-ucz])   # punkty na rysunku: 100 osób testowych
granica <- function(k) {
  set.seed(6842)
  p <- knn(Xs[ucz, ], siatka, klasa[ucz], k = k, prob = TRUE)
  pB <- ifelse(p == "B", attr(p, "prob"), 1 - attr(p, "prob"))
  tr <- traf$trafnosc[traf$k == k & traf$proba == "testowa"]
  ggplot(cbind(siatka, pB = pB), aes(a, b)) +
    geom_raster(aes(fill = pB), alpha = 0.35, show.legend = FALSE) +
    geom_contour(aes(z = pB), breaks = 0.5, colour = "grey10", linewidth = 0.6) +
    geom_hline(yintercept = 0, linetype = "dotted", colour = "grey40") +
    geom_vline(xintercept = 0, linetype = "dotted", colour = "grey40") +
    geom_point(data = test_df, aes(colour = klasa, shape = klasa), size = 1.8, alpha = 0.9) +
    scale_fill_gradient2(low = kol[["A"]], mid = "white", high = kol[["B"]], midpoint = 0.5) +
    scale_colour_manual("Klasa", values = kol) + scale_shape_manual("Klasa", values = c(A = 16, B = 17)) +
    coord_equal(xlim = c(-3, 3), ylim = c(-3, 3), expand = FALSE) +
    labs(x = "Test a (z)", y = "Test b (z)",
         title = sprintf("k = %d: trafność testowa %.2f", k, tr)) + motyw
}
pD <- ggplot(traf, aes(k, trafnosc, colour = proba, linetype = proba, shape = proba)) +
  geom_line() + geom_point(size = 1.8) +
  scale_colour_manual("Próba", values = c("ucząca" = "grey40", "walidacja LOO" = "#0072B2", "testowa" = "#D55E00")) +
  scale_linetype_manual("Próba", values = c("ucząca" = "dotted", "walidacja LOO" = "solid", "testowa" = "dashed")) +
  scale_shape_manual("Próba", values = c("ucząca" = 15, "walidacja LOO" = 16, "testowa" = 17)) +
  scale_y_continuous("Trafność", limits = c(0.5, 1)) +
  labs(x = "Liczba sąsiadów k", title = "Trafność a liczba sąsiadów") + motyw +
  guides(colour = guide_legend(nrow = 1), linetype = guide_legend(nrow = 1), shape = guide_legend(nrow = 1))
p1 <- (granica(1) + granica(15)) / (granica(51) + pD) +
  plot_layout(guides = "collect") & theme(legend.position = "bottom", legend.box = "vertical")
p1
Wynik w R
  k trafnosc.ucząca trafnosc.walidacja LOO trafnosc.testowa
  1           1.000                  0.765             0.82
  5           0.865                  0.795             0.82
 15           0.835                  0.805             0.81
 51           0.790                  0.750             0.76
k z najlepszą trafnością LOO: 9  trafność: 0.825
     testowa ucząca walidacja LOO
[1,]    0.76   0.79         0.750
[2,]    0.82   1.00         0.825
Jak opisać w pracy
Na co uważać
- Standaryzacja tylko z próby uczącej. Średnie i odchylenia licz na danych uczących; inaczej informacja z testu przecieka do modelu.
- Wiele nieistotnych predyktorów. Każda zbędna zmienna dokłada szum do odległości, więc dobór zmiennych bywa ważniejszy niż dobór k.
- Brak współczynników. kNN nie mówi, które zmienne są ważne. Do porównania z innymi klasyfikatorami, np. SVM, używaj tych samych podziałów danych (zob. walidacja i kalibracja modeli predykcyjnych).
Metoda kNN w R
Kod standaryzuje predyktory parametrami z próby uczącej, porównuje trafność class::knn() dla danych surowych i standaryzowanych, wybiera k funkcją knn.cv() (leave-one-out) i porównuje wynik z regresją logistyczną. Liczby w tekście pochodzą z tego kodu.
Klasyfikacja kNN z wyborem k i porównaniem z regresją logistyczną
R
set.seed(684)                                   # dane symulowane: 300 osób, 2 klasy
n <- 300
a <- rnorm(n); b <- rnorm(n)                    # dwie skale testowe (SD = 1)
dochod <- rnorm(n, mean = 5000, sd = 1500)      # zmienna bez związku z klasą, duża skala
klasa <- factor(ifelse(a * b + rnorm(n, sd = 0.5) > 0, "B", "A"))   # granica nieliniowa (układ „szachownicy”)
X <- data.frame(a, b, dochod)
ucz <- sample(n, 200)                           # 200 uczących, 100 testowych
sr <- colMeans(X[ucz, ]); s <- apply(X[ucz, ], 2, sd)   # parametry standaryzacji z próby uczącej
Xs <- scale(X, center = sr, scale = s)
library(class)
trafnosc <- function(Xu, Xt, k) mean(knn(Xu, Xt, klasa[ucz], k = k) == klasa[-ucz])
k_siatka <- c(1, 5, 15, 51)
tab <- data.frame(k = k_siatka,
                  surowe = sapply(k_siatka, function(k) trafnosc(X[ucz, ], X[-ucz, ], k)),
                  standaryzowane = sapply(k_siatka, function(k) trafnosc(Xs[ucz, ], Xs[-ucz, ], k)))
print(tab)
# wybór k walidacją krzyżową leave-one-out na próbie uczącej
k_cv <- seq(1, 51, by = 2)                      # nieparzyste k: brak remisów w głosowaniu
loo <- sapply(k_cv, function(k) mean(knn.cv(Xs[ucz, ], klasa[ucz], k = k) == klasa[ucz]))
k_best <- k_cv[which.max(loo)]
cat("najlepsze k (LOO):", k_best, " trafnosc LOO:", round(max(loo), 3), "\n")
pred <- knn(Xs[ucz, ], Xs[-ucz, ], klasa[ucz], k = k_best)
print(table(przewidywana = pred, prawdziwa = klasa[-ucz]))
cat("trafnosc testowa kNN:", mean(pred == klasa[-ucz]), "\n")
logit <- glm(klasa ~ a + b + dochod, family = binomial, subset = ucz)
p_log <- predict(logit, X[-ucz, ], type = "response") > 0.5
cat("trafnosc testowa regresji logistycznej:", mean(p_log == (klasa[-ucz] == "B")), "\n")
Wynik w R
   k surowe standaryzowane
1  1   0.54           0.77
2  5   0.52           0.81
3 15   0.50           0.81
4 51   0.54           0.66
najlepsze k (LOO): 15  trafnosc LOO: 0.815
            prawdziwa
przewidywana  A  B
           A 43  7
           B 12 38
trafnosc testowa kNN: 0.81
trafnosc testowa regresji logistycznej: 0.49
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet class 7.3-23). Rysunek 1 wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- class (wersja 7.3-23): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy metodą kNN można przewidywać wynik ciągły?
Tak. W regresji kNN przewidywana wartość to średnia (czasem mediana) wyniku k najbliższych sąsiadów. Altman (1992) opisuje ją jako nieparametryczną regresję, która nie zakłada kształtu zależności.
Jak wybrać liczbę sąsiadów k?
Sprawdź siatkę wartości walidacją krzyżową na próbie uczącej i wybierz k z najlepszym wynikiem, przy dwóch klasach spośród liczb nieparzystych. Ocenę końcową podaj na osobnej próbie testowej.
Czym kNN różni się od analizy skupień k-średnich?
kNN to metoda nadzorowana: zna klasy w próbie uczącej i przewiduje je dla nowych osób. Metoda k-średnich nie zna żadnych klas – sama dzieli obserwacje na k grup. Obie łączy tylko użycie odległości.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Altman, N. S. (1992). An introduction to kernel and nearest-neighbor nonparametric regression. The American Statistician, 46(3), 175–185. https://doi.org/10.1080/00031305.1992.10475879
- Cover, T., & Hart, P. (1967). Nearest neighbor pattern classification. IEEE Transactions on Information Theory, 13(1), 21–27. https://doi.org/10.1109/tit.1967.1053964
Cytowania BibTeX
@article{altman1992introduction, author={Altman, Naomi S.}, title={{An introduction to kernel and nearest-neighbor nonparametric regression}}, journal={The American Statistician}, year={1992}, volume={46}, number={3}, pages={175--185}, doi={10.1080/00031305.1992.10475879}}@article{cover1967nearest, author={Cover, Thomas and Hart, Peter}, title={{Nearest neighbor pattern classification}}, journal={IEEE Transactions on Information Theory}, year={1967}, volume={13}, number={1}, pages={21--27}, doi={10.1109/tit.1967.1053964}}