Co to jest maszyna wektorów nośnych?
Maszyna wektorów nośnych (ang. support vector machine, SVM) to klasyfikator, który szuka granicy między klasami o możliwie największym marginesie, czyli odległości od najbliższych obserwacji obu klas. Boser, Guyon i Vapnik (1992) przedstawili algorytm maksymalizujący ten margines, w którym rozwiązanie jest kombinacją liniową tylko części przypadków uczących – tych leżących najbliżej granicy. To właśnie wektory nośne; pozostałe obserwacje nie wpływają na granicę. Nazwa „sieci wektorów nośnych” pochodzi z pracy Cortes i Vapnika (1995). Przystępne wprowadzenie daje Noble (2006).
Jądro i parametry C oraz γ
Gdy klas nie da się oddzielić prostą (hiperpłaszczyzną), SVM używa jądra, które pozwala wyznaczyć granicę nieliniową bez jawnego tworzenia nowych zmiennych. Najczęściej stosuje się jądro radialne exp(−γ‖x − x′‖²). Parametr C (cost) określa karę za obserwacje po złej stronie marginesu: duże C to wąski margines i ryzyko przeuczenia, małe – granica gładsza. γ decyduje, jak lokalny jest wpływ pojedynczej obserwacji. Oba parametry dobiera się walidacją krzyżową, a predyktory się standaryzuje (funkcja svm() z pakietu e1071 robi to domyślnie).
Przykład
W symulowanych danych 400 punktów klasa „tak” leżała wewnątrz koła. Na 250 punktach uczących siatka 4 × 3 wartości C i γ z 10-krotną walidacją wskazała C = 1 i γ = 0.1 (błąd walidacji .052); model miał 143 wektory nośne. Na 150 punktach testowych SVM z jądrem radialnym sklasyfikował poprawnie 94.7% przypadków (8 błędów). SVM liniowy i regresja logistyczna osiągnęły po 60.0% – tyle, ile daje przypisanie wszystkim klasy częstszej – bo żadna prosta nie oddziela wnętrza koła od otoczenia.
Na rysunku
Rysunek 1 używa osobnych danych: dwie zachodzące na siebie chmury po 30 punktów (ziarno 6861; średnie ±1 i SD = 0.8 ustawiono ręcznie, tak by część punktów leżała po złej stronie). Rysunek 2 używa danych z przykładu (ziarno 686) i parametrów C = 1, γ = 0.1 wybranych tam walidacją krzyżową. Ziaren nie dobierano.
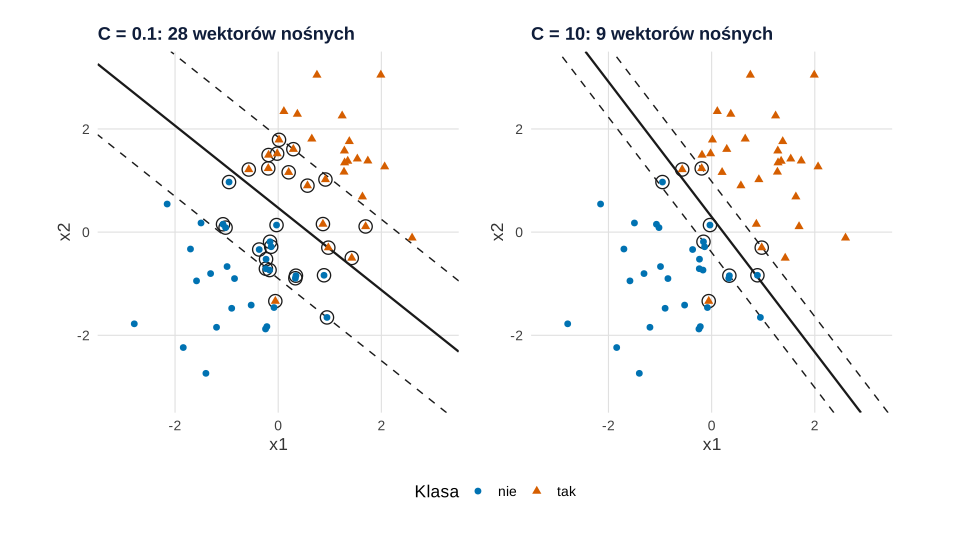
Co widać. Ciągła prosta to granica, a linie przerywane – brzegi marginesu. Obwiedzione punkty to wektory nośne: leżą na brzegu marginesu, w jego środku albo po złej stronie granicy. Tylko one wyznaczają granicę. Przy małej karze (C = 0.1) margines jest szeroki i wspiera go 28 z 60 punktów. Przy C = 10 margines zwęża się do 9 wektorów nośnych, a granica obraca się w stronę kilku punktów ze środka.
Na co uważać. Węższy margines nie znaczy lepszy model. W próbie uczącej trafność wyniosła 0.983 przy C = 0.1 i 0.967 przy C = 10, a o wyborze C rozstrzyga i tak dopiero walidacja krzyżowa. Szerokość marginesu liczy się w skali standaryzowanych zmiennych, bo svm() domyślnie je standaryzuje.
Podpis do pracy:
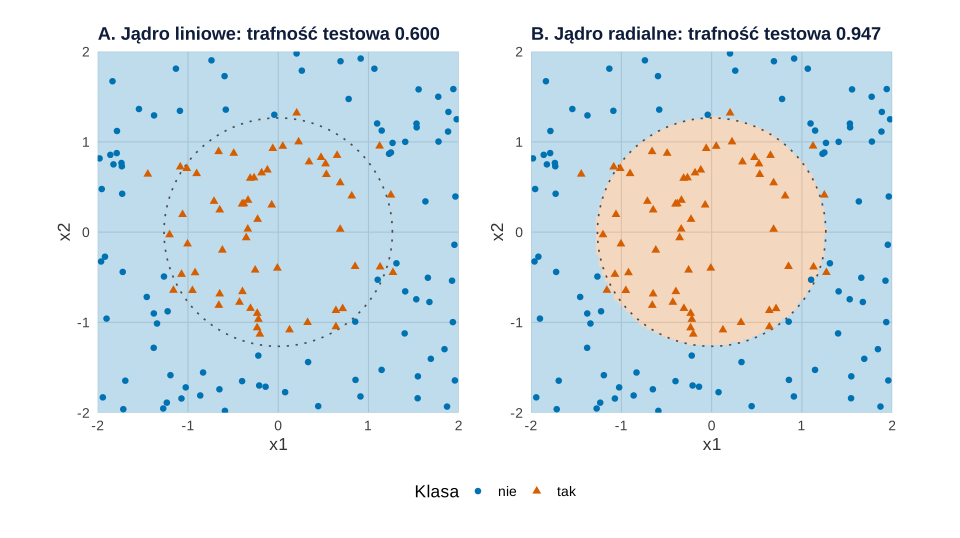
Co widać. Prosta nie oddzieli wnętrza koła, więc SVM liniowy przypisuje wszystkim 150 osobom testowym klasę „nie” i trafia w 60.0% przypadków. Jądro radialne wyznacza obszar niemal pokrywający się z prawdziwą granicą (kropkowany okrąg) i trafia w 94.7%.
Na co uważać. W dwóch wymiarach granicę widać od razu, ale przy wielu predyktorach takiego obrazu już nie ma. Nieliniowość trzeba wtedy wykryć porównaniem modeli w walidacji. Tło pokazuje tylko przypisaną klasę, nie pewność modelu.
Podpis do pracy:
Kod poniżej odtwarza oba rysunki i liczby; paletę Okabe–Ito i motyw definiuje sam. Rysunki na stronie powstały z tych samych obiektów p1 i p2 z motywem serwisu (inny krój czcionki i siatka).
Kod R rysunków 1–2
# Rysunki 1–2. Margines i wektory nośne SVM przy małym i dużym C; jądro liniowe a radialne
library(ggplot2)
library(patchwork)
library(e1071)

kol <- c(nie = "#0072B2", tak = "#D55E00")             # Okabe–Ito; klasy różni też kształt punktu
ksz <- c(nie = 16, tak = 17)
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))

# Wartość funkcji decyzyjnej SVM na siatce punktów (0 = granica, ±1 = brzegi marginesu)
f_decyzja <- function(m, siatka) {
  f <- attr(predict(m, siatka, decision.values = TRUE), "decision.values")[, 1]
  if (colnames(attr(predict(m, siatka[1, ], decision.values = TRUE), "decision.values")) == "nie/tak") -f else f
}   # znak ustawiony tak, by f > 0 oznaczało klasę „tak”

# Rysunek 1: dwie zachodzące na siebie chmury, SVM liniowy przy C = 0.1 i C = 10
set.seed(6861)
d1 <- data.frame(x1 = c(rnorm(30, -1, 0.8), rnorm(30, 1, 0.8)),
                 x2 = c(rnorm(30, -1, 0.8), rnorm(30, 1, 0.8)),
                 klasa = factor(rep(c("nie", "tak"), each = 30)))
s1 <- expand.grid(x1 = seq(-3.5, 3.5, length.out = 141), x2 = seq(-3.5, 3.5, length.out = 141))
margines <- function(C) {
  m <- svm(klasa ~ x1 + x2, data = d1, kernel = "linear", cost = C)
  cat(sprintf("C = %-4s wektory nośne: %2d z %d, trafność w próbie uczącej: %.3f\n",
              C, m$tot.nSV, nrow(d1), mean(predict(m, d1) == d1$klasa)))
  ggplot(d1, aes(x1, x2)) +
    geom_contour(data = cbind(s1, f = f_decyzja(m, s1)), aes(z = f), breaks = 0,
                 colour = "grey10", linewidth = 0.8) +
    geom_contour(data = cbind(s1, f = f_decyzja(m, s1)), aes(z = f), breaks = c(-1, 1),
                 colour = "grey10", linewidth = 0.5, linetype = "dashed") +
    geom_point(data = d1[m$index, ], shape = 21, size = 4.2, colour = "grey10", stroke = 0.7) +
    geom_point(aes(colour = klasa, shape = klasa), size = 2) +
    scale_colour_manual("Klasa", values = kol) + scale_shape_manual("Klasa", values = ksz) +
    coord_equal(xlim = c(-3.5, 3.5), ylim = c(-3.5, 3.5), expand = FALSE) +
    labs(x = "x1", y = "x2", title = sprintf("C = %s: %d wektorów nośnych", C, m$tot.nSV)) + motyw
}
p1 <- (margines(0.1) + margines(10)) + plot_layout(guides = "collect") & theme(legend.position = "bottom")

# Rysunek 2: dane z przykładu w haśle (klasa „tak” wewnątrz koła); parametry jądra radialnego
# z przykładu (C = 1, γ = 0.1, wybrane tam walidacją krzyżową)
set.seed(686)
n <- 400
x1 <- runif(n, -2, 2); x2 <- runif(n, -2, 2)
klasa <- factor(ifelse(x1^2 + x2^2 + rnorm(n, sd = 0.4) < 1.6, "tak", "nie"))
d <- data.frame(x1, x2, klasa)
ucz <- sample(n, 250); du <- d[ucz, ]; dt <- d[-ucz, ]
m_lin <- svm(klasa ~ x1 + x2, data = du, kernel = "linear", cost = 1)
m_rbf <- svm(klasa ~ x1 + x2, data = du, kernel = "radial", cost = 1, gamma = 0.1)
traf <- c(liniowe = mean(predict(m_lin, dt) == dt$klasa), radialne = mean(predict(m_rbf, dt) == dt$klasa))
round(traf, 3)
table(predict(m_lin, dt))                              # SVM liniowy: komu przypisuje którą klasę
s2 <- expand.grid(x1 = seq(-2, 2, length.out = 121), x2 = seq(-2, 2, length.out = 121))
okrag <- data.frame(t = seq(0, 2 * pi, length.out = 200))
granica <- function(m, nazwa, tr) {
  ggplot(dt, aes(x1, x2)) +
    geom_raster(data = cbind(s2, kl = predict(m, s2)), aes(fill = kl), alpha = 0.25, show.legend = FALSE) +
    geom_path(data = okrag, aes(sqrt(1.6) * cos(t), sqrt(1.6) * sin(t)), linetype = "dotted", colour = "grey30") +
    geom_point(aes(colour = klasa, shape = klasa), size = 1.9) +
    scale_fill_manual(values = kol) +
    scale_colour_manual("Klasa", values = kol) + scale_shape_manual("Klasa", values = ksz) +
    coord_equal(xlim = c(-2, 2), ylim = c(-2, 2), expand = FALSE) +
    labs(x = "x1", y = "x2", title = sprintf("%s: trafność testowa %.3f", nazwa, tr)) + motyw
}
p2 <- (granica(m_lin, "A. Jądro liniowe", traf[["liniowe"]]) +
       granica(m_rbf, "B. Jądro radialne", traf[["radialne"]])) +
  plot_layout(guides = "collect") & theme(legend.position = "bottom")
p1
p2
Wynik w R
C = 0.1  wektory nośne: 28 z 60, trafność w próbie uczącej: 0.983
C = 10   wektory nośne:  9 z 60, trafność w próbie uczącej: 0.967
 liniowe radialne
   0.600    0.947

nie tak
150   0
Jak opisać w pracy
Na co uważać
- Wynik SVM to nie prawdopodobieństwo. Odległość od granicy trzeba przeliczyć na prawdopodobieństwa i sprawdzić ich kalibrację; do oceny rozróżniania użyj krzywej ROC.
- Strojenie na danych testowych. Siatkę parametrów oceniaj tylko na próbie uczącej; próba testowa służy do jednej, końcowej oceny.
- Interpretacja. Model z jądrem radialnym nie daje współczynników; przy kilku predyktorach i liniowej granicy regresja logistyczna jest zwykle równie trafna i łatwiejsza do opisu. Inne elastyczne metody to kNN i lasy losowe.
SVM w R
Kod stroi e1071::svm() z jądrem radialnym funkcją tune() (10-krotna walidacja krzyżowa), liczy wektory nośne i macierz pomyłek w próbie testowej, a następnie porównuje trafność z SVM liniowym i regresją logistyczną. Liczby w tekście pochodzą z tego kodu.
SVM z jądrem radialnym: strojenie C i γ oraz porównanie z modelami liniowymi
R
set.seed(686)                                   # dane symulowane: klasa zależy od odległości od środka
n <- 400
x1 <- runif(n, -2, 2); x2 <- runif(n, -2, 2)
klasa <- factor(ifelse(x1^2 + x2^2 + rnorm(n, sd = 0.4) < 1.6, "tak", "nie"))
d <- data.frame(x1, x2, klasa)
ucz <- sample(n, 250); du <- d[ucz, ]; dt <- d[-ucz, ]
library(e1071)
# strojenie C (cost) i gamma 10-krotną walidacją krzyżową na próbie uczącej
str <- tune(svm, klasa ~ x1 + x2, data = du, kernel = "radial",
            ranges = list(cost = c(0.1, 1, 10, 100), gamma = c(0.1, 0.5, 2)))
print(str$best.parameters)
cat("blad CV:", round(str$best.performance, 3), "\n")
m <- str$best.model
cat("liczba wektorow nosnych:", m$tot.nSV, "z", nrow(du), "\n")
pred <- predict(m, dt)
print(table(przewidywana = pred, prawdziwa = dt$klasa))
lin <- svm(klasa ~ x1 + x2, data = du, kernel = "linear", cost = 1)
logit <- glm(klasa ~ x1 + x2, data = du, family = binomial)
p_log <- ifelse(predict(logit, dt, type = "response") > 0.5, levels(d$klasa)[2], levels(d$klasa)[1])
round(c(SVM_radialny = mean(pred == dt$klasa),
        SVM_liniowy = mean(predict(lin, dt) == dt$klasa),
        logistyczna = mean(p_log == dt$klasa)), 3)
Wynik w R
  cost gamma
2    1   0.1
blad CV: 0.052
liczba wektorow nosnych: 143 z 250
            prawdziwa
przewidywana nie tak
         nie  89   7
         tak   1  53
SVM_radialny  SVM_liniowy  logistyczna
       0.947        0.600        0.600
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet e1071 1.7-17). Rysunki 1–2 wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- e1071 (wersja 1.7-17): Meyer, D., Dimitriadou, E., Hornik, K., Weingessel, A., & Leisch, F. (2025). e1071: Misc functions of the Department of Statistics, Probability Theory Group (formerly: E1071), TU Wien (R package version 1.7-17) [Computer software]. https://doi.org/10.32614/CRAN.package.e1071
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy SVM podaje prawdopodobieństwo przynależności do klasy?
Nie wprost – zwraca klasę i odległość od granicy. W e1071 opcja probability = TRUE dopasowuje dodatkowy model, który przelicza te wartości na prawdopodobieństwa. Ich kalibrację trzeba sprawdzić na nowych danych.
Jak dobrać parametry C i gamma w SVM?
Ustal siatkę wartości w skali logarytmicznej, np. C = 0.1, 1, 10, 100 i gamma = 0.1, 0.5, 2, i oceń każdą parę walidacją krzyżową na próbie uczącej, np. funkcją tune() z pakietu e1071. Wynik końcowy podaj na próbie testowej.
Czy SVM sprawdza się przy małej próbie w pracy dyplomowej?
Może, ale przy kilku predyktorach i około stu osobach regresja logistyczna jest zwykle równie trafna i daje interpretowalne współczynniki. SVM warto użyć, gdy granica jest nieliniowa, a celem jest przewidywanie, nie wyjaśnianie.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Boser, B. E., Guyon, I. M., & Vapnik, V. N. (1992). A training algorithm for optimal margin classifiers. In Proceedings of the Fifth Annual Workshop on Computational Learning Theory (pp. 144–152). ACM. https://doi.org/10.1145/130385.130401
- Cortes, C., & Vapnik, V. (1995). Support-vector networks. Machine Learning, 20(3), 273–297. https://doi.org/10.1007/bf00994018 ● Otwarty dostęp
- Noble, W. S. (2006). What is a support vector machine? Nature Biotechnology, 24(12), 1565–1567. https://doi.org/10.1038/nbt1206-1565
Cytowania BibTeX
@inproceedings{boser1992training, author={Boser, Bernhard E. and Guyon, Isabelle M. and Vapnik, Vladimir N.}, title={{A training algorithm for optimal margin classifiers}}, booktitle={Proceedings of the Fifth Annual Workshop on Computational Learning Theory}, year={1992}, pages={144--152}, publisher={ACM}, doi={10.1145/130385.130401}}@article{cortes1995support, author={Cortes, Corinna and Vapnik, Vladimir}, title={{Support-vector networks}}, journal={Machine Learning}, year={1995}, volume={20}, number={3}, pages={273--297}, doi={10.1007/bf00994018}}@article{noble2006support, author={Noble, William S.}, title={{What is a support vector machine?}}, journal={Nature Biotechnology}, year={2006}, volume={24}, number={12}, pages={1565--1567}, doi={10.1038/nbt1206-1565}}