Przykład: 36 aptek, 6 regionów i sezon przeziębień
Fikcyjna sieć 36 aptek w sześciu regionach co tydzień zamawia preparaty na przeziębienie: syropy, pastylki, krople do nosa. Apteka chce wiedzieć, ile opakowań sprzeda, region – ile dowieźć do magazynu, a zarząd – ile kupić u producenta na półrocze. To prognoza hierarchiczna: prognozy z trzech poziomów powinny się sumować.
Pytanie zarządu pod koniec grudnia 2024 roku: ile opakowań sprzedamy od stycznia do czerwca 2025 roku w każdej aptece, każdym regionie i całej sieci – i jak sprawić, by te liczby do siebie pasowały? Jak prognozować jeden szereg czasowy, pokazuje wpis o prognozie sprzedaży z sezonowością i promocjami. Tu szeregów jest 43 i trzeba je ze sobą pogodzić.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Ręcznie ustawiliśmy m.in.: ok. 22 opakowania tygodniowo latem w typowej aptece i ok. 1 w sześciu punktach aptecznych, szczyt sezonu ok. 3.2 razy wyższy niż lato (w regionach od 2. do 10. tygodnia roku), wzrost Centrum o 12% rocznie, konkurencję, remonty i apteki nad morzem. Pełną listę, ziarno 714 i zmiany po pierwszym uruchomieniu podajemy przy kodzie. Dane pobierzesz jako prognoza-hierarchiczna-apteki-tygodnie.csv (wiersz = apteka w tygodniu).
Rysunek 1: cztery sezony sprzedaży
Mamy 208 tygodni: od 5 lipca 2021 roku do 29 czerwca 2025 roku. Modele uczą się na 182 tygodniach (do 29 grudnia 2024 roku), a ostatnie 26 tygodni to okres testowy, którego modele nie widzą.
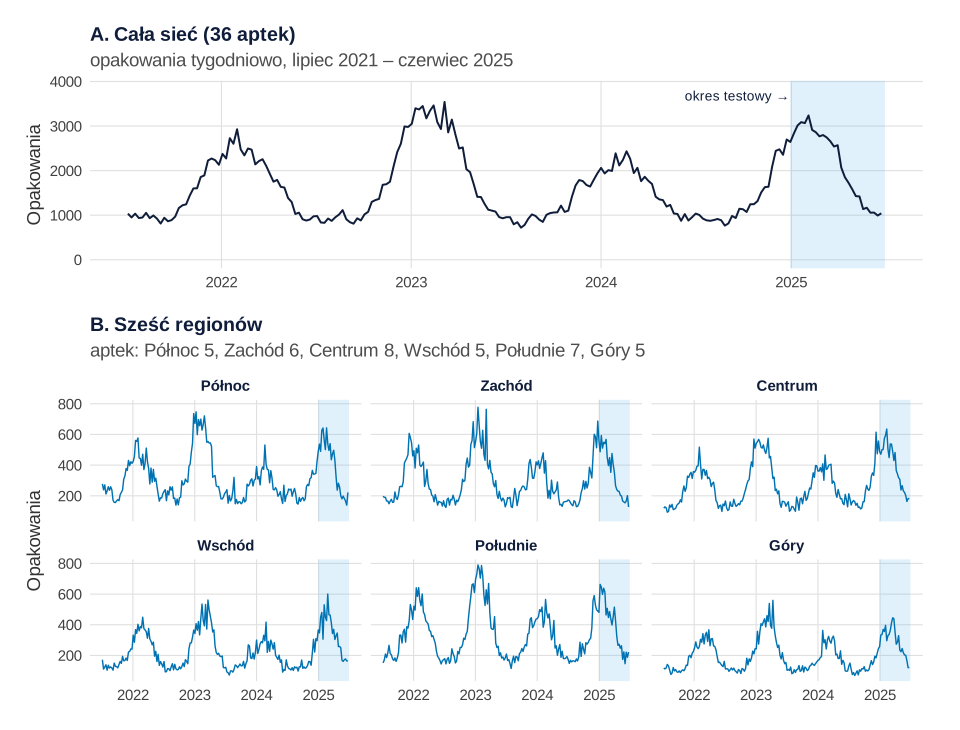
set.seed(714)).Co widać. Latem sieć sprzedaje ok. 929 opakowań tygodniowo (mediana lipca i sierpnia), zimą trzy razy więcej; najwyższy tydzień (od 6 marca 2023 roku) to 3541 opakowań. Sezony (lipiec–czerwiec) różnią się siłą: od 73 878 do 97 825 opakowań. Udział Centrum wzrósł z 14.9% w sezonie 2021/22 do 18.2% w 2024/25, a Północy spadł z 20.0% do 18.3% – to ważne dla metody od góry. Powtarzalna fala to sezonowość roczna.
Jak może zmylić. Suma 36 aptek uśrednia przypadkowe wahania. Pojedyncza apteka jest bardziej poszarpana, a w sześciu punktach aptecznych 17.7% tygodni ma zerową sprzedaż (w pozostałych 0.1%).
Podpis do pracy:
Rysunek 2: drzewo hierarchii i macierz sumowania
Hierarchia ma trzy poziomy: sieć (1 szereg), regiony (6) i apteki (36) – razem 43 szeregi. Wszystkie da się zbudować z 36 szeregów aptek, bo region to suma jego aptek, a sieć to suma wszystkich. Zapisuje to macierz sumowania S (43 × 36): w polu jest 1, gdy apteka wchodzi do sumy w danym wierszu.
Słowami: 43 sprzedaże z danego tygodnia to S pomnożona przez sprzedaże 36 aptek. Pierwszy wiersz S to same jedynki (sieć), sześć kolejnych – jedynki przy aptekach regionu, ostatnie 36 – każda apteka sama dla siebie.
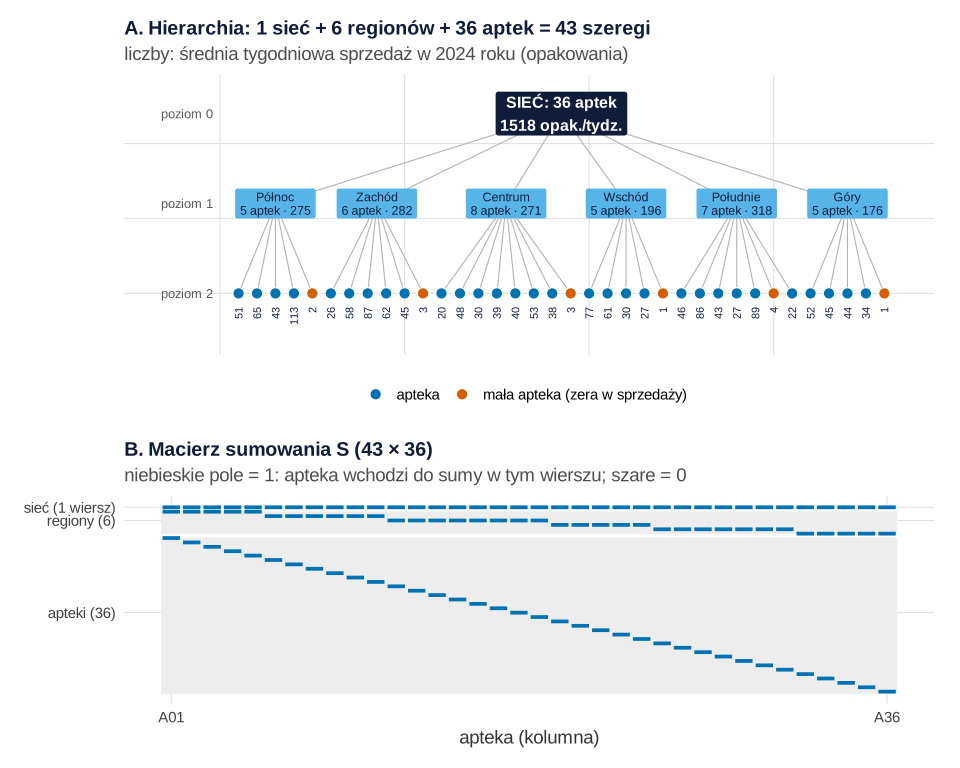
Co widać. W 2024 roku sieć sprzedawała średnio 1518 opakowań tygodniowo, regiony od 176 (Góry) do 318 (Południe), apteki od 1 do 113. Największa apteka sprzedaje ponad sto razy więcej niż najmniejsza.
Jak może zmylić. Drzewo to jedna z możliwych hierarchii. Apteki można też grupować według typu (osiedlowa, przy przychodni) – S ma wtedy więcej wierszy, ale zasada zostaje. Samo sumowanie szeregów opisuje hasło agregacja danych.
Podpis do pracy:
Rysunek 3: prognozy bazowe nie sumują się
Najpierw prognozujemy każdy z 43 szeregów osobno – to prognozy bazowe. Używamy funkcji stlf() z pakietu forecast (Hyndman i Khandakar, 2008): rozkład STL zdejmuje sezon roczny (52 tygodnie), a resztę szeregu prognozuje model wygładzania wykładniczego ETS dobierany automatycznie. Szeregi bez zer liczymy na logarytmie (transformacja logarytmiczna), a osiem aptek z zerami (sześć małych i dwie po remoncie) – bez transformacji. Większość szeregów dostała model bez trendu (ETS(A,N,N) lub ETS(M,N,N)).
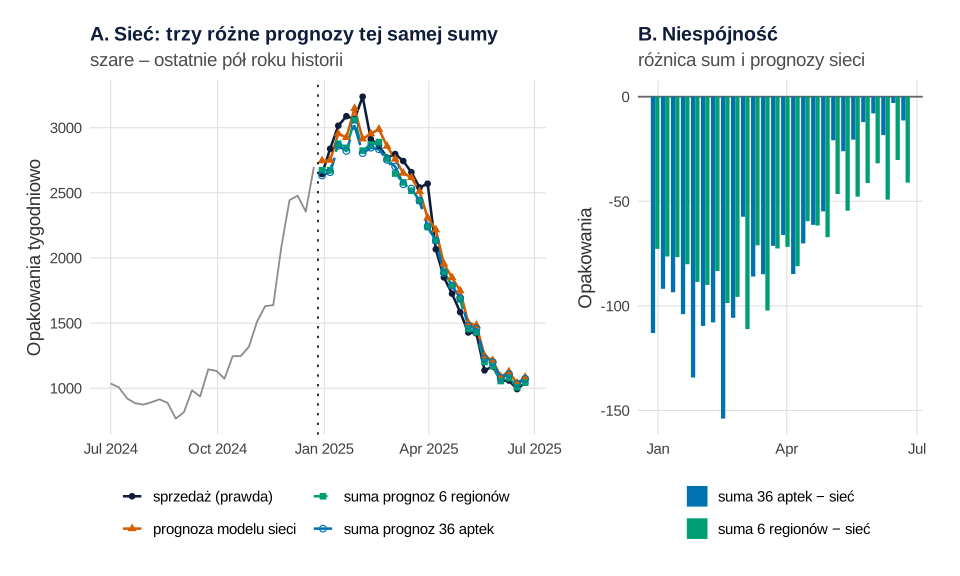
Co widać. Model sieci prognozuje na 26 tygodni 56 638 opakowań, suma prognoz regionów – 54 835, a suma prognoz aptek – 54 868. Prawdziwa sprzedaż to 56 277. Co tydzień suma aptek jest niższa od prognozy sieci o 3–154 opakowania (0.3–5.1%). Prognozy są niespójne: zarząd zamówi więcej, niż chcą apteki. W Zachodzie suma aptek różni się od prognozy regionu o −15 do +54 opakowań tygodniowo.
Jak może zmylić. Nie wiadomo, która liczba jest lepsza: model sieci widzi wyraźny sezon, a modele aptek – lokalne zmiany, np. odpływ klientów do konkurencji.
Zdanie do Metody:
Rysunek 4: trzy sposoby uzgadniania
Uzgadnianie zamienia 43 prognozy bazowe na spójne. Każda metoda to macierz G, która robi z 43 prognoz bazowych 36 prognoz aptek; S sumuje je w górę:
- Od dołu (bottom-up): tylko prognozy aptek, wyżej ich sumy.
- Od góry (top-down): prognoza sieci dzielona według średnich udziałów aptek w historii (od 0.07% do 7.5%) – jeden ze sposobów dezagregacji, które porównywali Gross i Sohl (1990).
- MinT (minimum trace, najmniejszy łączny błąd): G = (S′W−1S)−1S′W−1. Słowami: szukamy prognoz spójnych najbliższych wszystkim 43 prognozom, przy czym prognozy niepewne wolno przesunąć bardziej niż pewne. To uogólnione najmniejsze kwadraty z macierzą W – kowariancją błędów prognoz bazowych.
Łączenie prognoz ze wszystkich poziomów regresją zaproponowali Hyndman i in. (2011), a Wickramasuriya i in. (2019) – MinT z pełną kowariancją błędów, minimalizujący błąd średniokwadratowy spójnych prognoz w całej hierarchii. W szacujemy z reszt jednokrokowych modeli bazowych: 946 wariancji i kowariancji ze 182 tygodni to niestabilna macierz, więc ją kurczymy w stronę macierzy diagonalnej:
gdzie W1 to kowariancja reszt, a λ – intensywność kurczenia liczona z danych (im mniej pewne korelacje, tym większe λ). Taki estymator jest dodatnio określony i dobrze uwarunkowany nawet przy małej próbie (Schäfer i Strimmer, 2005) – podobnie jak w regresji grzbietowej. U nas λ = 0.284. Gotowe uzgadnianie mają pakiety hts i fable; tu liczymy je ręcznie kilkoma mnożeniami macierzy.
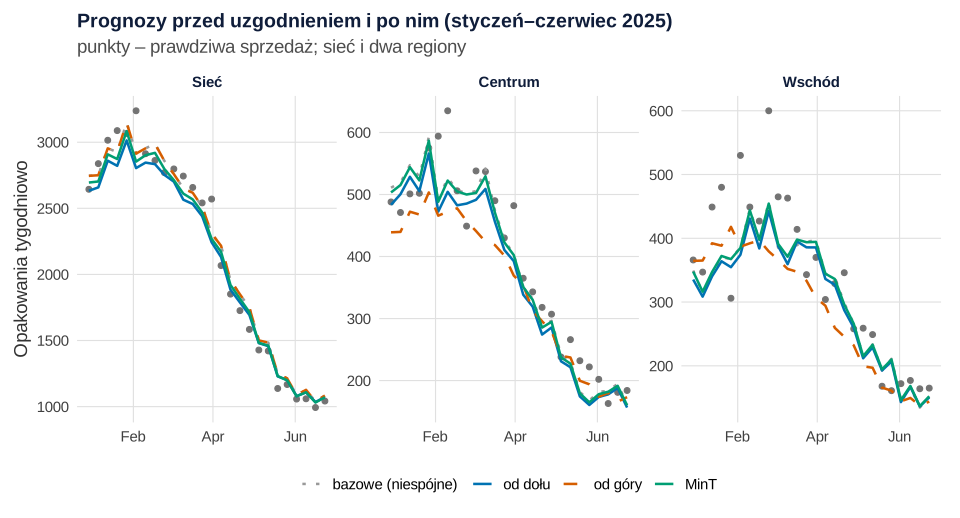
Co widać. Po uzgodnieniu różnica między prognozą sieci a sumą aptek spada ze 154 opakowań do zera. Na 26 tygodni sieci: od dołu 54 868, od góry 56 638, MinT 55 648 (prawda 56 277). Metoda od góry myli się w regionach: Centrum dostaje 9055 opakowań zamiast 10 219, bo średni udział nie widzi wzrostu, a Wschód – 7520 zamiast 8761, bo ma szczyt później niż sieć. MinT daje im 9797 i 8079.
Jak może zmylić. MinT nie jest „średnią z metod”: prognoza apteki zależy od wszystkich 43 prognoz bazowych. Dla apteki A04 waga jej własnej prognozy bazowej to 0.779, a prognozy sieci – 0.0245.
Podpis do pracy:
Rysunek 5: która metoda trafia najlepiej i na którym poziomie
Trafność oceniamy osobno na każdym poziomie. Średni błąd bezwzględny (MAE) jest w opakowaniach, więc nie porówna apteki z siecią. Dlatego główną miarą jest MASE – MAE podzielone przez średni błąd prognozy „jak przed rokiem” w okresie uczenia; Hyndman i Koehler (2006) proponują ją jako standard porównań między szeregami (zob. miary błędu prognozy).
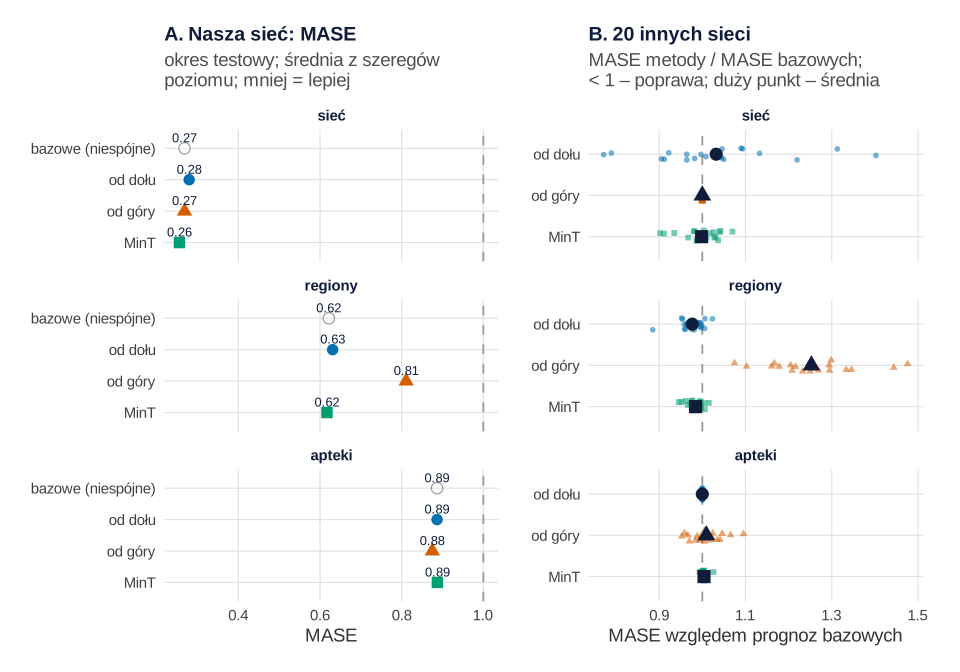
set.seed(714) i set.seed(7145)).| Metoda | MAE sieci | MAE regionów | MAE aptek | MASE sieci | MASE regionów | MASE aptek |
|---|---|---|---|---|---|---|
| bazowe (niespójne) | 98.3 | 43.7 | 13.88 | 0.268 | 0.622 | 0.887 |
| od dołu | 102.5 | 44.2 | 13.88 | 0.280 | 0.631 | 0.887 |
| od góry | 98.3 | 56.2 | 13.97 | 0.268 | 0.811 | 0.875 |
| MinT | 93.8 | 43.3 | 13.87 | 0.256 | 0.617 | 0.887 |
Co widać. W naszej sieci MinT ma najmniejszy błąd dla sieci (MASE 0.256) i regionów (0.617). Metoda od góry jest najgorsza w regionach (0.811); w Zachodzie jej MASE to 0.83 wobec 0.48 prognozy bazowej. Na poziomie aptek metody są prawie równe (0.875–0.887). W 20 innych sieciach (panel B) MinT poprawia regiony średnio o 1.6% (błąd Monte Carlo 0.4%), metoda od dołu o 2.3% – obie w 17 z 20 sieci; metoda od góry pogarsza je o 25.3% i nie wygrała ani razu. Dla sieci MinT jest średnio równy prognozie bazowej (0.998, zakres 0.902–1.070), a metoda od dołu waha się od 0.771 do 1.402.
Jak może zmylić. Jeden okres testowy to jedna próba – stąd panel B i okno kroczące (zob. walidacja w czasie). Uzgadnianie nie naprawi złego modelu: wszystkie metody zaniżyły styczeń i luty 2025 roku, bo sezon był silniejszy od przeciętnej. W hierarchii turystyki najlepiej wypadły metoda od góry z udziałami prognozowanymi i optymalne łączenie prognoz (Athanasopoulos i in., 2009).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: małe apteki z zerami i nowa apteka bez historii
Pierwszy kłopot: punkty apteczne z kilkoma opakowaniami tygodniowo. Model bez logarytmu może dać prognozę ujemną, a uzgadnianie dokłada korektę. Dla porównania liczymy też uzgadnianie bez wag (OLS), które dzieli niespójność po równo. Drugi: apteka A37 otwarta 7 października 2024 roku w Centrum ma tylko 12 tygodni historii, a klientów przybywa stopniowo (ręcznie: start od 50% docelowej sprzedaży).
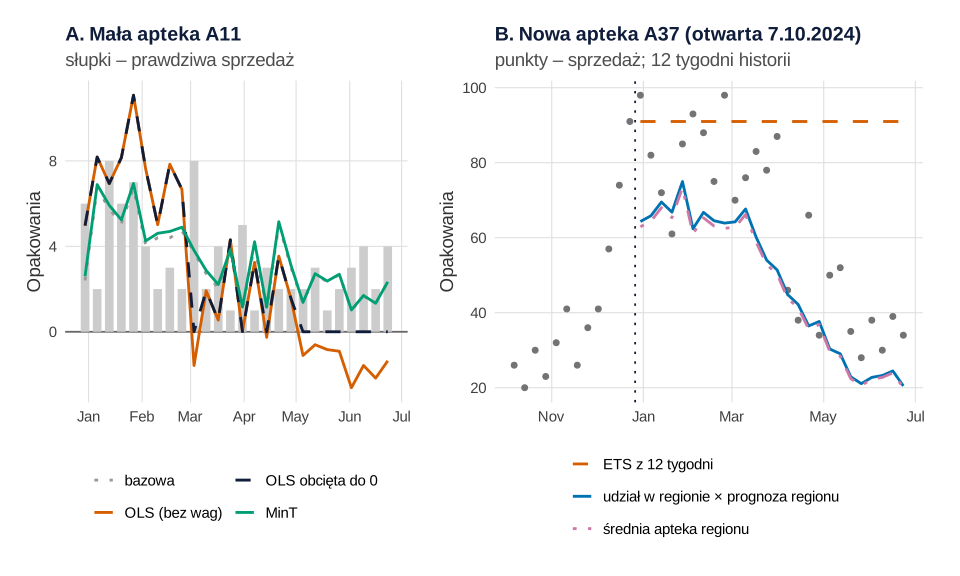
set.seed(7146) dla nowej apteki).Co widać. Panel A: bazowe i MinT dały po jednej ujemnej prognozie (najniższa −0.19 opakowania), OLS – 11 (najniższa −2.62). MinT przesuwa małe apteki najmniej, bo ich błędy mają małą wariancję. Obcięcie do zera i ponowne zsumowanie podnosi prognozę sieci o 13.1 opakowania przy OLS i o 0.19 przy MinT. MAE małych aptek: 1.76 przy MinT, 2.84 przy OLS. Panel B: ETS z 12 tygodni przenosi grudniowy szczyt na półrocze – 2366 opakowań zamiast 1636 (MAE 29.3). Udział A37 w Centrum (12.8%) razy prognoza regionu daje 1252 (MAE 15.8), a „średnia apteka regionu” – 1225 (MAE 16.6).
Jak może zmylić. Obcięcie do zera to łatka; przy wielu zerach lepszy jest model popytu sporadycznego (zob. analiza ABC/XYZ asortymentu). Prognoza z udziału zaniża sprzedaż nowej apteki, bo klientów wciąż przybywa; punkt bez historii prognozuje się z analogii, a „rozkręcanie się” sprzedaży opisuje model dyfuzji Bassa.
Zdanie do Metody:
Co z tym zrobić w firmie
- Jedna liczba na każdym poziomie. Zamówienie zarządu, dostawy do regionów i zamówienia aptek wynikają z tej samej uzgodnionej prognozy. Bez uzgodnienia sieć zamówiłaby o 1770 opakowań (ok. 3%) więcej, niż chciały apteki.
- Nie dziel prognozy stałymi udziałami, gdy regiony rosną w różnym tempie albo mają szczyt w innych tygodniach – Centrum zaniżone o 11%.
- MinT jako ustawienie domyślne, od dołu jako punkt odniesienia. Oba poprawiały regiony w 17 z 20 sieci; MinT był stabilniejszy dla całej sieci.
- Oceniaj każdy poziom osobno – liczy się poziom, na którym zapada decyzja.
- Małe i nowe apteki osobno. Prognozę małego punktu obcinaj do zera, a zapas licz z kwantyla (zob. zapas bezpieczeństwa). Nowej aptece dawaj udział w regionie i aktualizuj go co miesiąc.
- Dodaj szybsze sygnały. Wczesny sygnał popytu z wyszukiwań opisuje nowcasting sprzedaży, a różny efekt promocji w punktach – model mieszany dla sieci sklepów.
Jak opisać w pracy
Opisz hierarchię (poziomy, liczbę szeregów, macierz S), model prognoz bazowych, okres uczenia i testowy, metody uzgadniania (w MinT – szacowanie W i λ), miarę trafności dla każdego poziomu i postępowanie z prognozami ujemnymi. Zob. też statystyka w pracy z zarządzania i ekonomii; ryzyko w finansach opisuje wpis o VaR i expected shortfall.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, parametry i dane, przepisy 2–4 – macierz S, prognozy bazowe i funkcje uzgadniania używane dalej. Przepisy 1–6 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy blok, który losuje, zaczyna od własnego set.seed(): 714 w przepisie 1 (sieć z przykładu), 7145 w przepisie 5 (20 innych sieci), 7146 w przepisie 6 (nowa apteka); przepisy 2, 3, 4 i 7 nie losują. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono (przepis 1): liczbę aptek w regionach (5, 6, 8, 5, 7, 5), tydzień szczytu w regionach (6, 2, 5, 8, 4, 10), trendy roczne (Centrum 12%, pozostałe 0–3%), amplitudę sezonu 2.2, siłę sezonów (1.00, 1.30, 0.85, 1.15), sprzedaż latem (średnio ok. 22 opakowania, rozrzut 0.45 na skali logarytmu; punkty apteczne 0.6–1.8), wahania pogody i fal zachorowań (AR(1) z φ = 0.6, odchylenie 0.04 i 0.06), akcje w 4% tygodni (×1.8), apteki nad morzem (×2 w tygodniach 26–34), konkurencję (−35% od 2.10.2023), remonty (4–24 marca 2024), parametr rozproszenia rozkładu ujemnego dwumianowego (40) oraz podział 182 tygodnie uczenia i 26 testu; w przepisie 5 – 20 powtórzeń; w przepisie 6 – sprzedaż nowej apteki (18 opakowań latem, start od 50%, stała narastania 8.7 tygodnia) i 4 ostatnie tygodnie do udziału.
Zmiany po pierwszym uruchomieniu. W pierwszej wersji sprzedaż aptek była bardziej poszarpana (parametr rozproszenia 15), punkty apteczne sprzedawały latem 1.5–3.5 opakowania (zer było tylko 5.8% tygodni), szczyty regionów przypadały na tygodnie 3–8, apteki różniły się tylko wielkością i szumem, a wszystkie szeregi modelowano bez logarytmu – prognozy bazowe sumowały się wtedy prawie dokładnie. Zmieniliśmy więc: parametr rozproszenia na 40, sprzedaż punktów aptecznych na 0.6–1.8, szczyty na tygodnie 2–10, dodaliśmy akcje, apteki nad morzem, konkurencję i remonty oraz logarytm dla szeregów bez zer. Wersje pośrednie sprawdzaliśmy też na 12 innych ziarnach (ziarna 714 nie zmienialiśmy); metoda od dołu często wygrywała w nich na poziomie sieci i regionów, a metoda od góry – na poziomie aptek. Dlatego pokazujemy powtórzenie na 20 sieciach (rysunek 5B) zamiast opierać wnioski na jednym okresie testowym. Zmieniono też prezentację: w rysunku 6A dodano dla porównania uzgadnianie OLS (sam MinT dawał jedną ujemną prognozę), w przepisie 5 zamiast „ile razy metoda była najlepsza” (remisy z definicji) liczymy „w ilu sieciach poprawiła prognozy bazowe”, a macierz S rysujemy tylko z jedynek (mniejszy plik). Przepis 5 liczy się ok. 12 s, pozostałe – około sekundy lub krócej.
1. Dane sieci aptek: Rysunek 1
R
# Rysunek 1. Fikcyjna sieć 36 aptek w 6 regionach: tygodniowa sprzedaż preparatów na przeziębienie
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", rozowy = "#CC79A7", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustawione ręcznie (w prawdziwych danych ich nie znamy):
regiony <- data.frame(
  region  = c("Północ", "Zachód", "Centrum", "Wschód", "Południe", "Góry"),
  n_aptek = c(5, 6, 8, 5, 7, 5),
  szczyt  = c(6, 2, 5, 8, 4, 10),            # tydzień roku ze szczytem zachorowań w regionie
  wzrost  = c(0.02, 0.02, 0.12, 0.00, 0.03, 0.01))   # roczny trend sprzedaży (Centrum: nowe osiedla)
amplituda <- 2.2                     # w szczycie sezonu sprzedaż ok. 3.2 razy większa niż latem
sila_sezonu <- c(1.00, 1.30, 0.85, 1.15)  # sezony 2021/22, 2022/23, 2023/24, 2024/25
tygodnie <- 208                      # tygodnie od 5 lipca 2021 do 29 czerwca 2025
uczenie <- 182                       # prognoza z końca grudnia 2024 na 26 tygodni (30.12.2024–29.06.2025)
male <- c("A05", "A11", "A19", "A24", "A30", "A36")   # punkty apteczne: ok. 1 opakowanie tygodniowo latem
nad_morzem <- c("A01", "A02")        # latem (tygodnie 26–34) dwa razy więcej klientów
konkurencja <- c("A03", "A14", "A27") # od 2.10.2023 obok nowa apteka konkurencji: −35%
remont <- c("A08", "A21")            # zamknięte 4–24 marca 2024

# Generator danych: jedna fikcyjna sieć (funkcję wywołuje też przepis 5, żeby powtórzyć test na innych sieciach)
symuluj_siec <- function() {
  apteki <- data.frame(apteka = sprintf("A%02d", 1:36), region = rep(regiony$region, regiony$n_aptek))
  apteki$baza <- round(exp(rnorm(36, log(22), 0.45)), 1)        # sprzedaż latem, opakowań tygodniowo
  apteki$baza[match(male, apteki$apteka)] <- c(1.0, 1.5, 1.2, 0.6, 1.8, 0.8)
  szok_sieci <- as.numeric(arima.sim(list(ar = 0.6), tygodnie, sd = 0.04))   # pogoda wspólna dla sieci
  profil_reg <- matrix(NA, tygodnie, nrow(regiony), dimnames = list(NULL, regiony$region))
  dane <- NULL
  for (r in seq_len(nrow(regiony))) {
    szok_reg <- as.numeric(arima.sim(list(ar = 0.6), tygodnie, sd = 0.06))  # lokalna fala zachorowań
    f <- (0.5 * (1 + cos(2 * pi * (tydz_roku - regiony$szczyt[r]) / 52)))^2
    profil_reg[, r] <- (1 + amplituda * sila_sezonu[sezon] * f) * exp(regiony$wzrost[r] * lata + szok_sieci + szok_reg)
    for (a in apteki$apteka[apteki$region == regiony$region[r]]) {
      mu <- apteki$baza[apteki$apteka == a] * profil_reg[, r] * ifelse(runif(tygodnie) < 0.04, 1.8, 1)  # akcje (4% tygodni)
      if (a %in% nad_morzem) mu <- mu * ifelse(tydz_roku >= 26 & tydz_roku <= 34, 2.0, 1)
      if (a %in% konkurencja) mu <- mu * ifelse(daty >= as.Date("2023-10-02"), 0.65, 1)
      if (a %in% remont) mu[daty >= as.Date("2024-03-04") & daty < as.Date("2024-03-25")] <- 0
      dane <- rbind(dane, data.frame(tydzien = daty, apteka = a, region = regiony$region[r],
                                     sprzedaz = rnbinom(tygodnie, mu = mu, size = 40)))
    }
  }
  list(dane = dane, apteki = apteki, profil_reg = profil_reg)
}
daty <- as.Date("2021-07-05") + 7 * (0:(tygodnie - 1))
tydz_roku <- as.integer(format(daty, "%V"))
sezon <- findInterval(daty, as.Date(c("2021-07-01", "2022-07-01", "2023-07-01", "2024-07-01")))
lata <- as.numeric(daty - daty[1]) / 365.25

set.seed(714)
siec <- symuluj_siec()
dane <- siec$dane
apteki <- siec$apteki
dane$okres <- ifelse(dane$tydzien < daty[uczenie + 1], "uczenie", "test")
write.csv(dane, "prognoza-hierarchiczna-apteki-tygodnie.csv", row.names = FALSE)

# Szeregi na trzech poziomach: sieć (1), regiony (6), apteki (36)
Yb <- sapply(apteki$apteka, function(a) dane$sprzedaz[dane$apteka == a])          # 208 × 36
Yr <- sapply(regiony$region, function(r) rowSums(Yb[, apteki$region == r, drop = FALSE]))
Ys <- rowSums(Yb)
cat("Tygodni:", tygodnie, "| uczenie:", uczenie, "| test:", tygodnie - uczenie,
    "| ostatni tydzień uczenia od", format(daty[uczenie]), "| test:", format(daty[uczenie + 1]), "–", format(daty[tygodnie] + 6), "\n")
cat("Sprzedaż sieci (opak./tydz.): mediana lipiec–sierpień", median(Ys[format(daty, "%m") %in% c("07", "08")]),
    "| najwyższy tydzień:", max(Ys), "(", format(daty[which.max(Ys)]), ")\n")
cat("Sprzedaż sieci w sezonach lipiec–czerwiec:", tapply(Ys, sezon, sum), "\n")
cat("Małe apteki:", male, "| odsetek tygodni z zerową sprzedażą:", round(100 * mean(Yb[, male] == 0), 1),
    "% | pozostałe apteki:", round(100 * mean(Yb[, !colnames(Yb) %in% male] == 0), 1), "%\n")
udz <- rbind(`udział 2021/22 (%)` = colSums(Yr[sezon == 1, ]) / sum(Ys[sezon == 1]),
             `udział 2024/25 (%)` = colSums(Yr[sezon == 4, ]) / sum(Ys[sezon == 4]))
print(round(100 * udz, 1))

dl <- data.frame(tydzien = rep(daty, 6), region = rep(regiony$region, each = tygodnie), sprzedaz = as.vector(Yr))
dl$region <- factor(dl$region, levels = regiony$region)
test_od <- daty[uczenie + 1]
pA <- ggplot(data.frame(tydzien = daty, sprzedaz = Ys), aes(tydzien, sprzedaz)) +
  annotate("rect", xmin = test_od, xmax = max(daty) + 7, ymin = -Inf, ymax = Inf, fill = kol[["blekit"]], alpha = 0.18) +
  annotate("text", x = test_od - 7, y = max(Ys) * 1.04, label = "okres testowy →", hjust = 1, size = 3.6, colour = "#0f1d3a") +
  geom_line(colour = kol[["granat"]], linewidth = 0.7) +
  scale_y_continuous(limits = c(0, max(Ys) * 1.08)) +
  labs(title = "A. Cała sieć (36 aptek)", subtitle = "opakowania tygodniowo, lipiec 2021 – czerwiec 2025",
       x = NULL, y = "Opakowania") + motyw
pB <- ggplot(dl, aes(tydzien, sprzedaz)) +
  annotate("rect", xmin = test_od, xmax = max(daty) + 7, ymin = -Inf, ymax = Inf, fill = kol[["blekit"]], alpha = 0.18) +
  geom_line(colour = kol[["niebieski"]], linewidth = 0.5) +
  facet_wrap(~ region, nrow = 2) + scale_x_date(date_labels = "%Y", date_breaks = "1 year") +
  labs(title = "B. Sześć regionów", subtitle = "aptek: Północ 5, Zachód 6, Centrum 8, Wschód 5, Południe 7, Góry 5",
       x = NULL, y = "Opakowania") + motyw
p1 <- pA / pB + plot_layout(heights = c(1, 1.5))
p1                       # do pliku: ggsave("prognoza-hierarchiczna-sprzedaz.svg", p1, width = 10, height = 7.6)
Wynik w R
Tygodni: 208 | uczenie: 182 | test: 26 | ostatni tydzień uczenia od 2024-12-23 | test: 2024-12-30 – 2025-06-29
Sprzedaż sieci (opak./tydz.): mediana lipiec–sierpień 929 | najwyższy tydzień: 3541 ( 2023-03-06 )
Sprzedaż sieci w sezonach lipiec–czerwiec: 82743 97825 73878 91203
Małe apteki: A05 A11 A19 A24 A30 A36 | odsetek tygodni z zerową sprzedażą: 17.7 % | pozostałe apteki: 0.1 %
                   Północ Zachód Centrum Wschód Południe Góry
udział 2021/22 (%)   20.0   18.3    14.9   14.1     20.9 11.9
udział 2024/25 (%)   18.3   18.0    18.2   14.0     19.4 12.0
2. Hierarchia i macierz sumowania S: Rysunek 2
R
# Rysunek 2. Hierarchia apteka → region → sieć i macierz sumowania S
# (korzysta z kol, motyw, regiony, apteki, Yb, Yr, Ys, daty i uczenie z przepisu 1 – bez nowego losowania)
library(ggplot2)
library(patchwork)

# Macierz sumowania S: wiersz = szereg (sieć, 6 regionów, 36 aptek), kolumna = apteka.
# Każdy szereg to suma aptek, które mają w jego wierszu 1: y_wszystkie = S × y_apteki.
S <- rbind(Sieć = rep(1, 36),
           t(sapply(regiony$region, function(r) as.numeric(apteki$region == r))),
           diag(36))
rownames(S)[8:43] <- apteki$apteka
colnames(S) <- apteki$apteka
Y <- cbind(Sieć = Ys, Yr, Yb)                      # 208 tygodni × 43 szeregi
cat("Wymiary S:", dim(S), "| liczba szeregów:", ncol(Y), "| dane spełniają y = S × y_apteki:",
    all(t(S %*% t(Yb)) == Y), "\n")
print(S[1:7, 1:12])                                # pierwsze 12 kolumn (apteki Północy i Zachodu)

# Średnia tygodniowa sprzedaż w 2024 roku (ostatni pełny rok przed prognozą) – liczby na drzewie
rok24 <- format(daty, "%Y") == "2024"
sr24 <- round(colMeans(Y[rok24, ]))
print(sr24[1:7])
cat("Apteki: od", min(sr24[8:43]), "do", max(sr24[8:43]), "opak./tydz.; najmniejsze:",
    paste(names(sort(sr24[8:43]))[1:6], sort(sr24[8:43])[1:6], collapse = ", "), "\n")

# Drzewo: współrzędne węzłów
wezly_a <- data.frame(id = apteki$apteka, region = apteki$region, x = 1:36, y = 1, sprzedaz = sr24[8:43])
wezly_r <- data.frame(id = regiony$region, x = tapply(wezly_a$x, wezly_a$region, mean)[regiony$region], y = 2.2,
                      sprzedaz = sr24[regiony$region], n = regiony$n_aptek)
wezly_s <- data.frame(id = "Sieć", x = 18.5, y = 3.4, sprzedaz = sr24[["Sieć"]])
krawedzie <- rbind(data.frame(x = wezly_s$x, y = wezly_s$y, xend = wezly_r$x, yend = wezly_r$y),
                   data.frame(x = wezly_r$x[match(wezly_a$region, wezly_r$id)], y = wezly_r$y,
                              xend = wezly_a$x, yend = wezly_a$y))
wezly_a$mala <- ifelse(wezly_a$sprzedaz < 5, "mała apteka (zera w sprzedaży)", "apteka")
pA <- ggplot() +
  geom_segment(data = krawedzie, aes(x, y, xend = xend, yend = yend), colour = "grey70", linewidth = 0.4) +
  geom_label(data = wezly_s, aes(x, y, label = paste0("SIEĆ: 36 aptek\n", sprzedaz, " opak./tydz.")),
             fill = kol[["granat"]], colour = "white", size = 4.2, fontface = "bold", linewidth = 0) +
  geom_label(data = wezly_r, aes(x, y, label = paste0(id, "\n", n, " aptek · ", sprzedaz)),
             fill = kol[["blekit"]], colour = "#0f1d3a", size = 3.3, linewidth = 0, lineheight = 0.9) +
  geom_point(data = wezly_a, aes(x, y, fill = mala), shape = 21, size = 3.6, colour = "white") +
  geom_text(data = wezly_a, aes(x, y - 0.18, label = sprzedaz), angle = 90, hjust = 1, size = 2.9, colour = "#0f1d3a") +
  annotate("text", x = -3.2, y = c(3.4, 2.2, 1), hjust = 0, size = 3.4, colour = "grey35",
           label = c("poziom 0", "poziom 1", "poziom 2")) +
  scale_fill_manual(values = c(kol[["niebieski"]], kol[["pomaranczowy"]]), name = NULL) +
  scale_x_continuous(limits = c(-3.2, 36.7)) + scale_y_continuous(limits = c(0.35, 3.75)) +
  labs(title = "A. Hierarchia: 1 sieć + 6 regionów + 36 aptek = 43 szeregi",
       subtitle = "liczby: średnia tygodniowa sprzedaż w 2024 roku (opakowania)", x = NULL, y = NULL) +
  motyw + theme(axis.text = element_blank(), panel.grid = element_blank())

# Macierz S jako kafelki: 43 wiersze × 36 kolumn (rysujemy tylko jedynki na szarym tle – mniejszy plik)
dS <- which(S == 1, arr.ind = TRUE)
dS <- data.frame(wiersz = dS[, 1], kolumna = dS[, 2])
pB <- ggplot(dS, aes(kolumna, wiersz)) +
  annotate("rect", xmin = 0.5, xmax = 36.5, ymin = 0.5, ymax = 43.5, fill = "grey93") +
  geom_hline(yintercept = c(1.5, 7.5), colour = "white", linewidth = 1.2) +
  geom_tile(fill = kol[["niebieski"]], width = 0.85, height = 0.85) +
  scale_y_reverse(breaks = c(1, 4, 25), labels = c("sieć (1 wiersz)", "regiony (6)", "apteki (36)")) +
  scale_x_continuous(breaks = c(1, 36), labels = c("A01", "A36")) +
  labs(title = "B. Macierz sumowania S (43 × 36)", subtitle = "niebieskie pole = 1: apteka wchodzi do sumy w tym wierszu; szare = 0",
       x = "apteka (kolumna)", y = NULL) +
  motyw + theme(panel.grid = element_blank())
p2 <- pA / pB + plot_layout(heights = c(1.35, 1))
p2                       # do pliku: ggsave("prognoza-hierarchiczna-drzewo.svg", p2, width = 10, height = 8)
Wynik w R
Wymiary S: 43 36 | liczba szeregów: 43 | dane spełniają y = S × y_apteki: TRUE
         A01 A02 A03 A04 A05 A06 A07 A08 A09 A10 A11 A12
Sieć       1   1   1   1   1   1   1   1   1   1   1   1
Północ     1   1   1   1   1   0   0   0   0   0   0   0
Zachód     0   0   0   0   0   1   1   1   1   1   1   0
Centrum    0   0   0   0   0   0   0   0   0   0   0   1
Wschód     0   0   0   0   0   0   0   0   0   0   0   0
Południe   0   0   0   0   0   0   0   0   0   0   0   0
Góry       0   0   0   0   0   0   0   0   0   0   0   0
    Sieć   Północ   Zachód  Centrum   Wschód Południe     Góry
    1518      275      282      271      196      318      176
Apteki: od 1 do 113 opak./tydz.; najmniejsze: A24 1, A36 1, A05 2, A11 3, A19 3, A30 4
3. Prognozy bazowe i niespójność: Rysunek 3
R
# Rysunek 3. Prognozy bazowe na każdym poziomie osobno – i dlaczego się nie sumują
# (korzysta z kol, motyw, daty, uczenie, tygodnie z przepisu 1 oraz Y, S z przepisu 2 – bez losowania)
library(ggplot2)
library(patchwork)
library(forecast)

# Prognoza bazowa każdego z 43 szeregów: STL (sezon tygodniowy w roku, 52 tygodnie) + ETS dla reszty szeregu.
# Szeregi bez zer modelujemy na logarytmie (sezon multiplikatywny), szeregi z zerami – bez transformacji.
prognozy_bazowe <- function(Y, n_ucz, h) {
  fc <- matrix(NA, h, ncol(Y), dimnames = list(NULL, colnames(Y)))
  res <- matrix(NA, n_ucz, ncol(Y), dimnames = list(NULL, colnames(Y)))
  model <- character(ncol(Y))
  for (i in seq_len(ncol(Y))) {
    y <- ts(Y[1:n_ucz, i], frequency = 52)
    log_ok <- all(y > 0)
    f <- stlf(y, h = h, method = "ets", s.window = "periodic", lambda = if (log_ok) 0 else NULL, biasadj = log_ok)
    fc[, i] <- f$mean
    res[, i] <- y - fitted(f)                        # reszty jednokrokowe w opakowaniach (do MinT)
    model[i] <- paste(if (log_ok) "log" else "bez log.", f$model$method)
  }
  list(fc = fc, res = res, model = model)
}
h <- tygodnie - uczenie
baz <- prognozy_bazowe(Y, uczenie, h)
yt <- Y[(uczenie + 1):tygodnie, ]                    # prawdziwa sprzedaż w okresie testowym
poziom <- rep(c("sieć", "regiony", "apteki"), c(1, 6, 36))
print(table(poziom = factor(poziom, unique(poziom)), model = baz$model))

# Niespójność: suma prognoz niższego poziomu ≠ prognoza wyższego
roz_apteki <- rowSums(baz$fc[, 8:43]) - baz$fc[, 1]
roz_regiony <- rowSums(baz$fc[, 2:7]) - baz$fc[, 1]
cat("Prognoza sieci na 26 tygodni:", round(sum(baz$fc[, 1])), "| suma prognoz regionów:", round(sum(baz$fc[, 2:7])),
    "| suma prognoz aptek:", round(sum(baz$fc[, 8:43])), "| prawda:", sum(yt[, 1]), "\n")
cat("Suma aptek − sieć, tygodniowo: od", round(min(roz_apteki)), "do", round(max(roz_apteki)), "opak.; od",
    round(100 * min(roz_apteki / baz$fc[, 1]), 1), "do", round(100 * max(roz_apteki / baz$fc[, 1]), 1), "%\n")
cat("Suma regionów − sieć, tygodniowo: od", round(min(roz_regiony)), "do", round(max(roz_regiony)), "opak.\n")
for (r in colnames(Y)[2:7]) {
  d <- rowSums(baz$fc[, colnames(S)[S[r, ] == 1], drop = FALSE]) - baz$fc[, r]
  cat(sprintf("  %-9s suma aptek − region: od %4.0f do %4.0f opak. tygodniowo\n", r, min(d), max(d)))
}
cat("Ujemnych prognoz bazowych (tydzień × szereg):", sum(baz$fc < 0), "w szeregach:",
    paste(unique(colnames(baz$fc)[col(baz$fc)[baz$fc < 0]]), collapse = ", "), "\n")

dl <- rbind(data.frame(tydzien = daty[(uczenie + 1):tygodnie], opak = yt[, 1], co = "sprzedaż (prawda)"),
            data.frame(tydzien = daty[(uczenie + 1):tygodnie], opak = baz$fc[, 1], co = "prognoza modelu sieci"),
            data.frame(tydzien = daty[(uczenie + 1):tygodnie], opak = rowSums(baz$fc[, 2:7]), co = "suma prognoz 6 regionów"),
            data.frame(tydzien = daty[(uczenie + 1):tygodnie], opak = rowSums(baz$fc[, 8:43]), co = "suma prognoz 36 aptek"))
dl$co <- factor(dl$co, levels = unique(dl$co))
hist_dl <- data.frame(tydzien = daty[(uczenie - 25):uczenie], opak = Y[(uczenie - 25):uczenie, 1])
pA <- ggplot(dl, aes(tydzien, opak, colour = co, linetype = co, shape = co)) +
  geom_line(data = hist_dl, aes(tydzien, opak), inherit.aes = FALSE, colour = "grey55") +
  geom_line(linewidth = 0.9) + geom_point(size = 1.9) +
  geom_vline(xintercept = daty[uczenie + 1] - 3.5, linetype = "dotted", colour = "#0f1d3a") +
  scale_colour_manual(values = c("#0f1d3a", kol[["pomaranczowy"]], kol[["zielony"]], kol[["niebieski"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "solid", "dashed", "longdash"), name = NULL) +
  scale_shape_manual(values = c(16, 17, 15, 1), name = NULL) +
  labs(title = "A. Sieć: trzy różne prognozy tej samej sumy", subtitle = "szare – ostatnie pół roku historii",
       x = NULL, y = "Opakowania tygodniowo") +
  motyw + guides(colour = guide_legend(nrow = 2))
dr <- rbind(data.frame(tydzien = daty[(uczenie + 1):tygodnie], roz = roz_apteki, co = "suma 36 aptek − sieć"),
            data.frame(tydzien = daty[(uczenie + 1):tygodnie], roz = roz_regiony, co = "suma 6 regionów − sieć"))
pB <- ggplot(dr, aes(tydzien, roz, fill = co)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_col(position = position_dodge(width = 6), width = 6) +
  scale_fill_manual(values = c(kol[["niebieski"]], kol[["zielony"]]), name = NULL) +
  labs(title = "B. Niespójność", subtitle = "różnica sum i prognozy sieci", x = NULL, y = "Opakowania") +
  motyw + guides(fill = guide_legend(ncol = 1))
p3 <- pA + pB + plot_layout(widths = c(1.6, 1))
p3                       # do pliku: ggsave("prognoza-hierarchiczna-niespojnosc.svg", p3, width = 10, height = 6)
Wynik w R
         model
poziom    bez log. ETS(A,A,N) bez log. ETS(A,N,N) log ETS(A,Ad,N)
  sieć                      0                   0               0
  regiony                   0                   0               0
  apteki                    1                   7               2
         model
poziom    log ETS(A,N,N) log ETS(M,N,N)
  sieć                 0              1
  regiony              6              0
  apteki              16             10
Prognoza sieci na 26 tygodni: 56638 | suma prognoz regionów: 54835 | suma prognoz aptek: 54868 | prawda: 56277
Suma aptek − sieć, tygodniowo: od -154 do -3 opak.; od -5.1 do -0.3 %
Suma regionów − sieć, tygodniowo: od -111 do -30 opak.
  Północ  suma aptek − region: od   -1 do   22 opak. tygodniowo
  Zachód   suma aptek − region: od  -15 do   54 opak. tygodniowo
  Centrum   suma aptek − region: od  -33 do   -5 opak. tygodniowo
  Wschód   suma aptek − region: od  -15 do    5 opak. tygodniowo
  Południe suma aptek − region: od  -19 do    1 opak. tygodniowo
  Góry     suma aptek − region: od  -11 do   13 opak. tygodniowo
Ujemnych prognoz bazowych (tydzień × szereg): 1 w szeregach: A24
4. Uzgadnianie od dołu, od góry i MinT: Rysunek 4
R
# Rysunek 4. Uzgadnianie prognoz: od dołu, od góry (udziały historyczne) i MinT liczone ręcznie
# (korzysta z kol, motyw, daty, uczenie, tygodnie z przepisu 1, Y, S z przepisu 2 i baz, yt, h z przepisu 3)
library(ggplot2)

# Każda metoda to macierz G (36 × 43), która z 43 prognoz bazowych robi prognozy 36 aptek;
# spójne prognozy wszystkich szeregów to S × G × prognozy bazowe.
uzgodnij <- function(fc, S, G) t(S %*% G %*% t(fc))

# 1) Od dołu (bottom-up): bierzemy tylko prognozy aptek i sumujemy
G_bu <- cbind(matrix(0, 36, 7), diag(36))
# 2) Od góry (top-down): prognozę sieci dzielimy według średnich udziałów aptek w historii (Gross i Sohl, 1990)
udzialy_hist <- function(Y, n_ucz) colMeans(Y[1:n_ucz, 8:43] / Y[1:n_ucz, 1])
G_td <- function(p) cbind(p, matrix(0, 36, 42))
# 3) MinT: G = (S' W⁻¹ S)⁻¹ S' W⁻¹, gdzie W – kowariancja błędów prognoz bazowych (Wickramasuriya i in., 2019).
#    W szacujemy z reszt jednokrokowych i kurczymy do macierzy diagonalnej (Schäfer i Strimmer, 2005):
#    W = λ·diag(W₁) + (1 − λ)·W₁, gdzie λ wynika z tego, jak niepewne są korelacje z próby.
kowariancja_kurczona <- function(res) {
  n <- nrow(res)
  W1 <- crossprod(res) / n                          # kowariancja reszt (średnia reszt ≈ 0)
  x <- sweep(res, 2, sqrt(diag(W1)), "/")           # reszty standaryzowane
  R <- crossprod(x) / n                             # korelacje z próby
  v <- (crossprod(x^2) - crossprod(x)^2 / n) / (n * (n - 1))   # wariancje oszacowań korelacji
  diag(v) <- 0
  diag(R) <- 0
  lambda <- max(0, min(1, sum(v) / sum(R^2)))
  list(W = lambda * diag(diag(W1)) + (1 - lambda) * W1, lambda = lambda, W1 = W1)
}
G_mint <- function(S, W) {
  Wi <- solve(W)
  solve(t(S) %*% Wi %*% S, t(S) %*% Wi)
}

p_hist <- udzialy_hist(Y, uczenie)
kw <- kowariancja_kurczona(baz$res)
cat("Udziały historyczne aptek: od", round(100 * min(p_hist), 2), "do", round(100 * max(p_hist), 2), "% | suma:",
    round(sum(p_hist), 4), "\n")
cat("Intensywność kurczenia λ =", round(kw$lambda, 3), "| wskaźnik uwarunkowania W₁:", signif(kappa(kw$W1), 2),
    "→ po kurczeniu:", signif(kappa(kw$W), 2), "\n")
r_sr <- cov2cor(kw$W1)[2:7, 2:7]
cat("Średnia korelacja reszt między regionami:", round(mean(r_sr[upper.tri(r_sr)]), 2), "\n")

prog <- list(`bazowe (niespójne)` = baz$fc,
             `od dołu` = uzgodnij(baz$fc, S, G_bu),
             `od góry` = uzgodnij(baz$fc, S, G_td(p_hist)),
             MinT = uzgodnij(baz$fc, S, G_mint(S, kw$W)))
for (m in names(prog)) colnames(prog[[m]]) <- colnames(Y)
spojnosc <- sapply(prog, function(F) max(abs(F[, 1] - rowSums(F[, 8:43]))))
print(round(spojnosc, 3))                       # 0 = prognoza sieci równa sumie aptek
sumy <- sapply(prog, function(F) round(colSums(F[, 1:7])))
print(cbind(sumy, prawda = colSums(yt[, 1:7])))  # suma 26 tygodni: sieć i regiony
Gm <- G_mint(S, kw$W)
cat("MinT: waga prognozy bazowej sieci w prognozie apteki A04:", round(Gm["A04", "Sieć"], 4),
    "| waga własnej prognozy bazowej A04:", round(Gm["A04", "A04"], 3), "\n")

pokaz <- c("Sieć", "Centrum", "Wschód")
dl <- do.call(rbind, lapply(names(prog), function(m) do.call(rbind, lapply(pokaz, function(s)
  data.frame(tydzien = daty[(uczenie + 1):tygodnie], szereg = s, opak = prog[[m]][, s], metoda = m)))))
dl$metoda <- factor(dl$metoda, levels = names(prog))
dl$szereg <- factor(dl$szereg, levels = pokaz)
dp <- do.call(rbind, lapply(pokaz, function(s) data.frame(tydzien = daty[(uczenie + 1):tygodnie], szereg = s, opak = yt[, s])))
dp$szereg <- factor(dp$szereg, levels = pokaz)
p4 <- ggplot(dl, aes(tydzien, opak)) +
  geom_point(data = dp, colour = "grey45", size = 1.6) +
  geom_line(aes(colour = metoda, linetype = metoda), linewidth = 0.9) +
  facet_wrap(~ szereg, scales = "free_y", nrow = 1) +
  scale_colour_manual(values = c(kol[["szary"]], kol[["niebieski"]], kol[["pomaranczowy"]], kol[["zielony"]]), name = NULL) +
  scale_linetype_manual(values = c("dotted", "solid", "dashed", "solid"), name = NULL) +
  scale_x_date(date_labels = "%b", date_breaks = "2 months") +
  labs(title = "Prognozy przed uzgodnieniem i po nim (styczeń–czerwiec 2025)",
       subtitle = "punkty – prawdziwa sprzedaż; sieć i dwa regiony",
       x = NULL, y = "Opakowania tygodniowo") + motyw
p4                       # do pliku: ggsave("prognoza-hierarchiczna-uzgadnianie.svg", p4, width = 10, height = 5.4)
Wynik w R
Udziały historyczne aptek: od 0.07 do 7.5 % | suma: 1
Intensywność kurczenia λ = 0.284 | wskaźnik uwarunkowania W₁: 20000 → po kurczeniu: 11000
Średnia korelacja reszt między regionami: 0.17
bazowe (niespójne)            od dołu            od góry               MinT
           153.878              0.000              0.000              0.000
         bazowe (niespójne) od dołu od góry  MinT prawda
Sieć                  56638   54868   56638 55648  56277
Północ                 9294    9574   11117  9583  10294
Zachód                 9344    9757   10535  9807   9035
Centrum                9888    9489    9055  9797  10219
Wschód                 8068    7896    7520  8079   8761
Południe              10712   10521   11726 10729  10323
Góry                   7528    7630    6685  7654   7645
MinT: waga prognozy bazowej sieci w prognozie apteki A04: 0.0245 | waga własnej prognozy bazowej A04: 0.779
5. Ocena na każdym poziomie i 20 innych sieci: Rysunek 5
R
# Rysunek 5. Ocena na okresie testowym na każdym poziomie (MASE i MAE) i powtórzenie na 20 innych sieciach
# (korzysta z przepisów 1–4: symuluj_siec(), prognozy_bazowe(), uzgodnij(), G_bu, G_td(), udzialy_hist(),
#  kowariancja_kurczona(), G_mint(), S, Y, prog, yt, uczenie, tygodnie, h)
library(ggplot2)
library(patchwork)
library(forecast)

# MASE: średni błąd bezwzględny prognozy podzielony przez średni błąd prognozy sezonowej naiwnej
# („jak przed rokiem”) w okresie uczenia (Hyndman i Koehler, 2006). MASE < 1: lepiej niż „jak przed rokiem” w historii.
ocen <- function(prog, Y, yt, n_ucz) {
  skala <- apply(Y[1:n_ucz, ], 2, function(y) mean(abs(diff(y, lag = 52))))
  poziom <- factor(rep(c("sieć", "regiony", "apteki"), c(1, 6, 36)), levels = c("sieć", "regiony", "apteki"))
  do.call(rbind, lapply(names(prog), function(m) {
    mae <- colMeans(abs(prog[[m]] - yt))
    data.frame(metoda = m, poziom = levels(poziom), MAE = as.numeric(tapply(mae, poziom, mean)),
               MASE = as.numeric(tapply(mae / skala, poziom, mean)))
  }))
}
oc <- ocen(prog, Y, yt, uczenie)
oc$metoda <- factor(oc$metoda, levels = names(prog))
oc$poziom <- factor(oc$poziom, levels = c("sieć", "regiony", "apteki"))
print(reshape(oc[c("metoda", "poziom", "MASE")], idvar = "metoda", timevar = "poziom", direction = "wide"), digits = 3,
      row.names = FALSE)
print(reshape(oc[c("metoda", "poziom", "MAE")], idvar = "metoda", timevar = "poziom", direction = "wide"), digits = 4,
      row.names = FALSE)
skala_reg <- apply(Y[1:uczenie, 2:7], 2, function(y) mean(abs(diff(y, lag = 52))))
print(round(sapply(prog, function(F) colMeans(abs(F[, 2:7] - yt[, 2:7])) / skala_reg), 2))   # MASE regionów

# Jeden okres testowy to jedna próba. Powtarzamy całość na 20 nowych sieciach o tych samych parametrach.
# (Od góry na poziomie sieci i od dołu na poziomie aptek to z definicji prognozy bazowe – stosunek = 1.)
set.seed(7145)
powt <- 20
wyniki <- do.call(rbind, lapply(seq_len(powt), function(b) {
  s <- symuluj_siec()
  Yb_b <- sapply(s$apteki$apteka, function(a) s$dane$sprzedaz[s$dane$apteka == a])
  Y_b <- cbind(Sieć = rowSums(Yb_b), sapply(regiony$region, function(r) rowSums(Yb_b[, s$apteki$region == r])), Yb_b)
  bz <- prognozy_bazowe(Y_b, uczenie, h)
  pr <- list(`bazowe (niespójne)` = bz$fc, `od dołu` = uzgodnij(bz$fc, S, G_bu),
             `od góry` = uzgodnij(bz$fc, S, G_td(udzialy_hist(Y_b, uczenie))),
             MinT = uzgodnij(bz$fc, S, G_mint(S, kowariancja_kurczona(bz$res)$W)))
  o <- ocen(pr, Y_b, Y_b[(uczenie + 1):tygodnie, ], uczenie)
  o$wzgl <- o$MASE / rep(o$MASE[o$metoda == "bazowe (niespójne)"], length(pr))   # MASE metody / MASE bazowych
  o$siec <- b
  o
}))
wyniki$metoda <- factor(wyniki$metoda, levels = names(prog))
wyniki$poziom <- factor(wyniki$poziom, levels = c("sieć", "regiony", "apteki"))
podsum <- aggregate(cbind(MASE, wzgl) ~ metoda + poziom, data = wyniki, FUN = mean)
podsum$bladMC_wzgl <- aggregate(wzgl ~ metoda + poziom, data = wyniki, FUN = function(x) sd(x) / sqrt(length(x)))$wzgl
podsum$lepsza_niz_bazowe <- aggregate(wzgl ~ metoda + poziom, data = wyniki, FUN = function(x) sum(x < 1 - 1e-9))$wzgl
print(podsum, digits = 3, row.names = FALSE)
zakres <- aggregate(wzgl ~ metoda + poziom, data = wyniki, FUN = function(x) round(range(x), 3))
print(subset(zakres, metoda != "bazowe (niespójne)"), row.names = FALSE)   # najmniejszy i największy stosunek

kolory <- c(kol[["szary"]], kol[["niebieski"]], kol[["pomaranczowy"]], kol[["zielony"]])
ksztalty <- c(1, 16, 17, 15)
pA <- ggplot(oc, aes(MASE, metoda, colour = metoda, shape = metoda)) +
  geom_vline(xintercept = 1, colour = "grey60", linetype = "dashed") +
  geom_point(size = 3.6) +
  geom_text(aes(label = sprintf("%.2f", MASE)), nudge_y = 0.34, size = 3.4, colour = "#0f1d3a") +
  facet_wrap(~ poziom, ncol = 1) +
  scale_colour_manual(values = kolory, guide = "none") + scale_shape_manual(values = ksztalty, guide = "none") +
  scale_y_discrete(limits = rev(names(prog))) +
  labs(title = "A. Nasza sieć: MASE", subtitle = "okres testowy; średnia z szeregów\npoziomu; mniej = lepiej",
       x = "MASE", y = NULL) + motyw
pB <- ggplot(subset(wyniki, metoda != "bazowe (niespójne)"), aes(wzgl, metoda, colour = metoda, shape = metoda)) +
  geom_vline(xintercept = 1, colour = "grey60", linetype = "dashed") +
  geom_jitter(height = 0.15, width = 0, size = 1.6, alpha = 0.55) +
  geom_point(data = subset(podsum, metoda != "bazowe (niespójne)"), size = 4.2, colour = "#0f1d3a") +
  facet_wrap(~ poziom, ncol = 1) +
  scale_colour_manual(values = kolory[-1], guide = "none") + scale_shape_manual(values = ksztalty[-1], guide = "none") +
  scale_y_discrete(limits = rev(names(prog)[-1])) +
  labs(title = "B. 20 innych sieci",
       subtitle = "MASE metody / MASE bazowych;\n< 1 – poprawa; duży punkt – średnia", x = "MASE względem prognoz bazowych", y = NULL) +
  motyw
p5 <- pA + pB + plot_layout(widths = c(1, 1))
p5                       # do pliku: ggsave("prognoza-hierarchiczna-ocena.svg", p5, width = 10, height = 7)
Wynik w R
             metoda MASE.sieć MASE.regiony MASE.apteki
 bazowe (niespójne)     0.268        0.622       0.887
            od dołu     0.280        0.631       0.887
            od góry     0.268        0.811       0.875
               MinT     0.256        0.617       0.887
             metoda MAE.sieć MAE.regiony MAE.apteki
 bazowe (niespójne)    98.33       43.68      13.88
            od dołu   102.54       44.17      13.88
            od góry    98.33       56.20      13.97
               MinT    93.76       43.26      13.87
         bazowe (niespójne) od dołu od góry MinT
Północ                 0.64    0.57    0.51 0.56
Zachód                 0.48    0.56    0.83 0.55
Centrum                0.49    0.56    0.70 0.49
Wschód                 0.80    0.83    0.97 0.78
Południe               0.61    0.60    0.89 0.62
Góry                   0.71    0.68    0.96 0.69
             metoda  poziom  MASE  wzgl bladMC_wzgl lepsza_niz_bazowe
 bazowe (niespójne)    sieć 0.576 1.000    0.00e+00                 0
            od dołu    sieć 0.589 1.032    3.45e-02                 9
            od góry    sieć 0.576 1.000    2.15e-16                 0
               MinT    sieć 0.574 0.998    9.73e-03                 8
 bazowe (niespójne) regiony 0.863 1.000    0.00e+00                 0
            od dołu regiony 0.842 0.977    6.63e-03                17
            od góry regiony 1.077 1.253    2.23e-02                 0
               MinT regiony 0.848 0.984    4.03e-03                17
 bazowe (niespójne)  apteki 0.984 1.000    0.00e+00                 0
            od dołu  apteki 0.984 1.000    0.00e+00                 0
            od góry  apteki 0.993 1.009    8.07e-03                 8
               MinT  apteki 0.988 1.004    1.52e-03                 4
  metoda  poziom wzgl.1 wzgl.2
 od dołu    sieć  0.771  1.402
 od góry    sieć  1.000  1.000
    MinT    sieć  0.902  1.070
 od dołu regiony  0.885  1.023
 od góry regiony  1.075  1.476
    MinT regiony  0.946  1.015
 od dołu  apteki  1.000  1.000
 od góry  apteki  0.952  1.096
    MinT  apteki  0.994  1.026
6. Małe apteki i nowa apteka: Rysunek 6
R
# Rysunek 6. Pułapki: ujemne prognozy małych aptek i nowa apteka bez historii
# (korzysta z kol, motyw, daty, uczenie, tygodnie, siec, male z przepisu 1, Y, S z przepisu 2,
#  baz, yt, h z przepisu 3 oraz uzgodnij() i prog z przepisu 4)
library(ggplot2)
library(patchwork)
library(forecast)

# A. Ujemne prognozy małych aptek. Model bez logarytmu (szereg z zerami) może zejść poniżej zera, a uzgadnianie
#    dokłada do tego korektę. MinT dzieli niespójność według wariancji błędów (małe apteki dostają małe korekty);
#    dla porównania uzgadnianie bez wag (OLS: G = (S'S)⁻¹S') dzieli ją po równo między apteki.
G_ols <- solve(t(S) %*% S, t(S))
F_ols <- uzgodnij(baz$fc, S, G_ols)
colnames(F_ols) <- colnames(Y)
F_mint <- prog[["MinT"]]
ile_uj <- function(F) sum(F[, 8:43] < 0)
cat("Ujemnych prognoz aptek (tydzień × apteka): bazowe", ile_uj(baz$fc), "| MinT", ile_uj(F_mint), "| OLS", ile_uj(F_ols), "\n")
cat("Najniższa prognoza: bazowe", round(min(baz$fc[, 8:43]), 2), "| MinT", round(min(F_mint[, 8:43]), 2),
    "| OLS", round(min(F_ols[, 8:43]), 2), "\n")
uj <- F_ols[, 8:43] < 0
cat("OLS – ujemne w aptekach:", paste(names(which(colSums(uj) > 0)), colSums(uj)[colSums(uj) > 0], collapse = ", "), "\n")
# Obcinamy do zera na poziomie aptek i sumujemy od nowa, żeby zachować spójność
obetnij <- function(F) { G <- t(S %*% t(pmax(F[, 8:43], 0))); colnames(G) <- colnames(F); G }
F_ols_obc <- obetnij(F_ols)
F_mint_obc <- obetnij(F_mint)
cat("Obcięcie podniosło prognozę sieci na 26 tygodni: OLS o", round(sum(F_ols_obc[, 1]) - sum(F_ols[, 1]), 1),
    "opak., MinT o", round(sum(F_mint_obc[, 1]) - sum(F_mint[, 1]), 2), "opak.\n")
mae_male <- sapply(list(`bazowe obcięte` = pmax(baz$fc, 0), OLS = F_ols, `OLS obcięte` = F_ols_obc, MinT = F_mint,
                        `MinT obcięte` = F_mint_obc), function(F) mean(abs(F[, male] - yt[, male])))
print(round(mae_male, 3))                              # MAE 6 małych aptek
cat("Średnia sprzedaż małych aptek w teście:", round(mean(yt[, male]), 2), "opak. | tygodni z zerem:",
    round(100 * mean(yt[, male] == 0), 1), "% | w lipcu–wrześniu (historia):",
    round(100 * mean(Y[format(daty, "%m") %in% c("07", "08", "09"), male] == 0), 1), "%\n")
a_pok <- names(which.max(colSums(uj)))
dA <- rbind(data.frame(tydzien = daty[(uczenie + 1):tygodnie], opak = baz$fc[, a_pok], co = "bazowa"),
            data.frame(tydzien = daty[(uczenie + 1):tygodnie], opak = F_ols[, a_pok], co = "OLS (bez wag)"),
            data.frame(tydzien = daty[(uczenie + 1):tygodnie], opak = F_ols_obc[, a_pok], co = "OLS obcięta do 0"),
            data.frame(tydzien = daty[(uczenie + 1):tygodnie], opak = F_mint[, a_pok], co = "MinT"))
dA$co <- factor(dA$co, levels = unique(dA$co))
pA <- ggplot(dA, aes(tydzien, opak)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_col(data = data.frame(tydzien = daty[(uczenie + 1):tygodnie], opak = yt[, a_pok]), fill = "grey80", width = 5) +
  geom_line(aes(colour = co, linetype = co), linewidth = 1) +
  scale_colour_manual(values = c(kol[["szary"]], kol[["pomaranczowy"]], kol[["granat"]], kol[["zielony"]]), name = NULL) +
  scale_linetype_manual(values = c("dotted", "solid", "dashed", "solid"), name = NULL) +
  scale_x_date(date_labels = "%b", date_breaks = "1 month") +
  labs(title = paste("A. Mała apteka", a_pok), subtitle = "słupki – prawdziwa sprzedaż",
       x = NULL, y = "Opakowania") + motyw + guides(colour = guide_legend(ncol = 2))

# B. Nowa apteka A37 w regionie Centrum: otwarta 7.10.2024, przed prognozą ma 12 tygodni historii.
#    Parametry ustawione ręcznie: sprzedaż jak średnia apteka (latem 18 opak.), klienci przychodzą stopniowo
#    (na starcie 50% docelowej sprzedaży, połowa luki znika w ok. 6 tygodni).
set.seed(7146)
otwarcie <- as.Date("2024-10-07")
tyg_od <- as.numeric(daty - otwarcie) / 7
mu37 <- ifelse(tyg_od >= 0, 18 * siec$profil_reg[, "Centrum"] * (1 - 0.5 * exp(-tyg_od / 8.7)), 0)
y37 <- rnbinom(tygodnie, mu = mu37, size = 40)
hist37 <- which(tyg_od >= 0 & seq_len(tygodnie) <= uczenie)
cat("Nowa apteka: tygodni historii przed prognozą:", length(hist37), "| sprzedaż w tych tygodniach:", y37[hist37], "\n")
# (1) ETS tylko z 12 tygodni – nie zna sezonu, prognoza płaska
f_ets <- forecast(ets(ts(y37[hist37]), model = "ANN"), h = h)$mean
# (2) analogia: udział A37 w sprzedaży regionu w ostatnich 4 tygodniach × prognoza MinT regionu
ost4 <- tail(hist37, 4)
udz37 <- sum(y37[ost4]) / sum(Y[ost4, "Centrum"])
f_udz <- udz37 * prog[["MinT"]][, "Centrum"]
# (3) „średnia apteka regionu”: prognoza MinT regionu / 8 aptek
f_sred <- prog[["MinT"]][, "Centrum"] / 8
y37_test <- y37[(uczenie + 1):tygodnie]
mae37 <- c(`ETS z 12 tygodni` = mean(abs(f_ets - y37_test)), `udział w regionie × prognoza regionu` = mean(abs(f_udz - y37_test)),
           `średnia apteka regionu` = mean(abs(f_sred - y37_test)))
cat("Udział A37 w Centrum (ostatnie 4 tygodnie):", round(100 * udz37, 1), "%\n")
print(round(mae37, 2))
cat("Suma 26 tygodni: prawda", sum(y37_test), "| ETS", round(sum(f_ets)), "| udział", round(sum(f_udz)),
    "| średnia apteka", round(sum(f_sred)), "\n")
okno <- which(daty >= otwarcie)
dB <- rbind(data.frame(tydzien = daty[(uczenie + 1):tygodnie], opak = as.numeric(f_ets), co = names(mae37)[1]),
            data.frame(tydzien = daty[(uczenie + 1):tygodnie], opak = f_udz, co = names(mae37)[2]),
            data.frame(tydzien = daty[(uczenie + 1):tygodnie], opak = f_sred, co = names(mae37)[3]))
dB$co <- factor(dB$co, levels = names(mae37))
pB <- ggplot(dB, aes(tydzien, opak)) +
  geom_point(data = data.frame(tydzien = daty[okno], opak = y37[okno]), colour = "grey45", size = 1.6) +
  geom_vline(xintercept = daty[uczenie + 1] - 3.5, linetype = "dotted", colour = "#0f1d3a") +
  geom_line(aes(colour = co, linetype = co), linewidth = 1) +
  scale_colour_manual(values = c(kol[["pomaranczowy"]], kol[["niebieski"]], kol[["rozowy"]]), name = NULL) +
  scale_linetype_manual(values = c("dashed", "solid", "dotdash"), name = NULL) +
  scale_x_date(date_labels = "%b", date_breaks = "2 months") +
  labs(title = "B. Nowa apteka A37 (otwarta 7.10.2024)", subtitle = "punkty – sprzedaż; 12 tygodni historii",
       x = NULL, y = "Opakowania") + motyw + guides(colour = guide_legend(ncol = 1))
p6 <- pA + pB + plot_layout(widths = c(1, 1.25))
p6                       # do pliku: ggsave("prognoza-hierarchiczna-pulapki.svg", p6, width = 10, height = 6)
Wynik w R
Ujemnych prognoz aptek (tydzień × apteka): bazowe 1 | MinT 1 | OLS 11
Najniższa prognoza: bazowe -0.18 | MinT -0.19 | OLS -2.62
OLS – ujemne w aptekach: A05 1, A11 10
Obcięcie podniosło prognozę sieci na 26 tygodni: OLS o 13.1 opak., MinT o 0.19 opak.
bazowe obcięte            OLS    OLS obcięte           MinT   MinT obcięte
         1.741          2.840          2.756          1.759          1.758
Średnia sprzedaż małych aptek w teście: 3.08 opak. | tygodni z zerem: 8.3 % | w lipcu–wrześniu (historia): 32.4 %
Nowa apteka: tygodni historii przed prognozą: 12 | sprzedaż w tych tygodniach: 26 20 30 23 32 41 26 36 41 57 74 91
Udział A37 w Centrum (ostatnie 4 tygodnie): 12.8 %
                    ETS z 12 tygodni udział w regionie × prognoza regionu
                               29.31                                15.82
              średnia apteka regionu
                               16.62
Suma 26 tygodni: prawda 1636 | ETS 2366 | udział 1252 | średnia apteka 1225
7. Paleta a zaburzenia widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy" = c("#0072B2", "#D55E00"), "błękit – pomarańczowy" = c("#56B4E9", "#D55E00"),
             "niebieski – zielony" = c("#0072B2", "#009E73"), "pomarańczowy – zielony" = c("#D55E00", "#009E73"),
             "żółty – zielony" = c("#E69F00", "#009E73"), "pomarańczowy – żółty" = c("#D55E00", "#E69F00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
niebieski – pomarańczowy                   114.6        108.3       91.9
błękit – pomarańczowy                      113.6        101.1       89.0
niebieski – zielony                         70.1         55.4       58.0
pomarańczowy – zielony                     102.4         53.5       37.3
żółty – zielony                             88.7         66.3       51.5
pomarańczowy – żółty                        33.4         18.4       24.9
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie, mnożenie i odwracanie macierzy wykonano pakietami base i stats (z podstawowej instalacji R), rozkład STL, modele ETS i prognozy – pakietem forecast. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- forecast (wersja 9.0.2): Hyndman, R., Athanasopoulos, G., Bergmeir, C., Caceres, G., Chhay, L., O’Hara-Wild, M., Petropoulos, F., Razbash, S., Wang, E., & Yasmeen, F. (2026). forecast: Forecasting functions for time series and linear models (R package version 9.0.2) [Computer software]. https://doi.org/10.32614/CRAN.package.forecast
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Niespójne prognozy – każdy dział planuje z innej liczby (rysunek 3).
- Stałe udziały historyczne przy rosnącym regionie i przesuniętym szczycie (rysunki 4 i 5).
- Ocena tylko dla całej sieci (rysunek 5).
- Ujemne prognozy małych aptek – zwłaszcza przy uzgadnianiu bez wag (rysunek 6A).
- Nowa apteka bez historii (rysunek 6B).
- Jeden okres testowy – różnice rzędu 1–2% bywają przypadkiem. Ogólniej o szeregach czasowych w praktyce.
Najczęstsze pytania
Co to jest prognoza hierarchiczna?
To prognozowanie wielu szeregów, które sumują się w hierarchii, np. sprzedaży aptek, regionów i całej sieci. Prognozy powinny być spójne: suma prognoz aptek ma się równać prognozie regionu, a suma regionów – prognozie sieci. Strukturę zapisuje macierz sumowania S.
Czym różni się metoda od dołu od metody od góry?
Metoda od dołu prognozuje najniższy poziom (apteki) i sumuje prognozy w górę – zachowuje lokalne różnice, ale dziedziczy szum małych szeregów. Metoda od góry prognozuje całość i dzieli ją według udziałów – jest gładka, ale nie widzi regionów, które rosną szybciej albo mają szczyt sezonu w innym tygodniu. W przykładzie stałe udziały zaniżyły rosnący region o 11%.
Jak działa uzgadnianie MinT?
MinT bierze prognozy ze wszystkich poziomów i szuka prognoz spójnych, które są do nich najbliżej, pozwalając bardziej przesuwać prognozy o dużym błędzie. Wzór to G = (S′W−1S)−1S′W−1, gdzie W to kowariancja błędów prognoz bazowych; przy wielu szeregach szacuje się ją z kurczeniem do macierzy diagonalnej. Metodę zaproponowali Wickramasuriya, Athanasopoulos i Hyndman (2019).
Jak ocenić trafność prognoz hierarchicznych?
Osobno na każdym poziomie, na okresie testowym, którego modele nie widziały. Błędy w opakowaniach (MAE) różnią się skalą między apteką a siecią, więc do porównań lepszy jest MASE – MAE podzielony przez błąd prognozy „jak przed rokiem”. Jeden okres testowy to jedna próba, dlatego warto powtórzyć ocenę z kilku punktów startowych.
Co zrobić z ujemnymi prognozami małych sklepów po uzgodnieniu?
Zastąpić je zerami i zsumować hierarchię od nowa – spójność zostaje. W przykładzie MinT dał jedną ujemną prognozę (−0.19 opakowania), a uzgadnianie bez wag (OLS), które dzieli niespójność po równo, aż 11. Przy wielu zerach lepiej sięgnąć po model dla zliczeń albo popytu sporadycznego.
Powiązane hasła
Przeczytaj też
Prognoza sprzedaży: sezonowość, święta i promocje
Sklep z zabawkami, trzy lata dziennych zamówień: STL, ETS i ARIMA z regresorami, MAE i MAPE na teście, przeciek danych i prognoza z przedziałami w R.
Czytaj →PoradnikNowcasting sprzedaży z wyszukiwań
Dealer kamperów zna sprzedaż po 6 tygodniach: ARIMA z indeksem i zapytaniami, ocena w kroczącym oknie, rewizje i zależność pozorna – z kodem R.
Czytaj →PoradnikModel gazeciarza i zapas bezpieczeństwa
Sieć piekarni: kwantyl krytyczny, sprzedaż ≠ popyt w dniach wyprzedanych, zapas mąki z błędów prognozy, poziom obsługi α i β – rysunki i kod R.
Czytaj →Prognozujesz sprzedaż wielu sklepów albo piszesz o tym pracę?
Pomożemy zbudować hierarchię szeregów, policzyć i uzgodnić prognozy na każdym poziomie oraz opisać ocenę trafności tak, żebyś umiał(a) ją obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Athanasopoulos, G., Ahmed, R. A., & Hyndman, R. J. (2009). Hierarchical forecasts for Australian domestic tourism. International Journal of Forecasting, 25(1), 146–166. https://doi.org/10.1016/j.ijforecast.2008.07.004 ● Otwarty dostęp: pełny tekst
- Gross, C. W., & Sohl, J. E. (1990). Disaggregation methods to expedite product line forecasting. Journal of Forecasting, 9(3), 233–254. https://doi.org/10.1002/for.3980090304
- Hyndman, R. J., & Khandakar, Y. (2008). Automatic time series forecasting: The forecast package for R. Journal of Statistical Software, 27(3). https://doi.org/10.18637/jss.v027.i03 ● Otwarty dostęp
- Hyndman, R. J., & Koehler, A. B. (2006). Another look at measures of forecast accuracy. International Journal of Forecasting, 22(4), 679–688. https://doi.org/10.1016/j.ijforecast.2006.03.001 ● Otwarty dostęp: pełny tekst
- Hyndman, R. J., Ahmed, R. A., Athanasopoulos, G., & Shang, H. L. (2011). Optimal combination forecasts for hierarchical time series. Computational Statistics & Data Analysis, 55(9), 2579–2589. https://doi.org/10.1016/j.csda.2011.03.006 ● Otwarty dostęp: pełny tekst
- Schäfer, J., & Strimmer, K. (2005). A shrinkage approach to large-scale covariance matrix estimation and implications for functional genomics. Statistical Applications in Genetics and Molecular Biology, 4(1). https://doi.org/10.2202/1544-6115.1175
- Wickramasuriya, S. L., Athanasopoulos, G., & Hyndman, R. J. (2019). Optimal forecast reconciliation for hierarchical and grouped time series through trace minimization. Journal of the American Statistical Association, 114(526), 804–819. https://doi.org/10.1080/01621459.2018.1448825 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{athanasopoulos2009hierarchical, author={Athanasopoulos, George and Ahmed, Roman A. and Hyndman, Rob J.}, title={{Hierarchical forecasts for Australian domestic tourism}}, journal={International Journal of Forecasting}, year={2009}, volume={25}, number={1}, pages={146--166}, doi={10.1016/j.ijforecast.2008.07.004}}@article{gross1990disaggregation, author={Gross, Charles W. and Sohl, Jeffrey E.}, title={{Disaggregation methods to expedite product line forecasting}}, journal={Journal of Forecasting}, year={1990}, volume={9}, number={3}, pages={233--254}, doi={10.1002/for.3980090304}}@article{hyndman2008automatic, author={Hyndman, Rob J. and Khandakar, Yeasmin}, title={{Automatic time series forecasting: The forecast package for R}}, journal={Journal of Statistical Software}, year={2008}, volume={27}, number={3}, doi={10.18637/jss.v027.i03}}@article{hyndman2006another, author={Hyndman, Rob J. and Koehler, Anne B.}, title={{Another look at measures of forecast accuracy}}, journal={International Journal of Forecasting}, year={2006}, volume={22}, number={4}, pages={679--688}, doi={10.1016/j.ijforecast.2006.03.001}}@article{hyndman2011optimal, author={Hyndman, Rob J. and Ahmed, Roman A. and Athanasopoulos, George and Shang, Han Lin}, title={{Optimal combination forecasts for hierarchical time series}}, journal={Computational Statistics \& Data Analysis}, year={2011}, volume={55}, number={9}, pages={2579--2589}, doi={10.1016/j.csda.2011.03.006}}@article{schafer2005shrinkage, author={Schäfer, Juliane and Strimmer, Korbinian}, title={{A shrinkage approach to large-scale covariance matrix estimation and implications for functional genomics}}, journal={Statistical Applications in Genetics and Molecular Biology}, year={2005}, volume={4}, number={1}, doi={10.2202/1544-6115.1175}}@article{wickramasuriya2019optimal, author={Wickramasuriya, Shanika L. and Athanasopoulos, George and Hyndman, Rob J.}, title={{Optimal forecast reconciliation for hierarchical and grouped time series through trace minimization}}, journal={Journal of the American Statistical Association}, year={2019}, volume={114}, number={526}, pages={804--819}, doi={10.1080/01621459.2018.1448825}}