Pytania ze statystyki na obronę pracy magisterskiej – znajdź swoją analizę
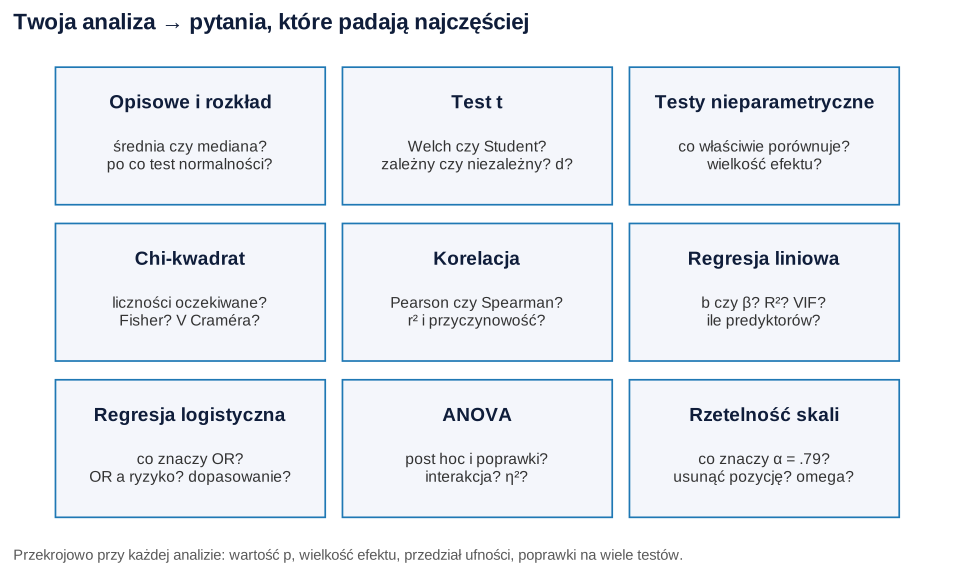
Ta lista zbiera pytania ze statystyki na obronę pracy magisterskiej ułożone według analizy, której użyłeś(-aś) w pracy. Znajdź w tabeli swój test, przejdź do sekcji i przećwicz odpowiedzi na pytania, które promotor albo recenzent zadaje właśnie przy nim. Pytania ogólne o metodologię (hipotezy, schemat, próba, etyka) i przykładową obronę krok po kroku znajdziesz w tekście pytania na obronie z metodologii i statystyki – tutaj ich nie powtarzamy.
| Użyłem(-am) w pracy… | Przejdź do sekcji |
|---|---|
| średnich, median, testu normalności | 1. Statystyki opisowe i rozkład |
| testu t (niezależnego, zależnego, Welcha) | 2. Test t |
| testu Manna–Whitneya, Wilcoxona, Kruskala–Wallisa | 3. Testy nieparametryczne |
| tabeli krzyżowej i testu χ² | 4. Chi-kwadrat |
| korelacji Pearsona lub Spearmana | 5. Korelacja |
| regresji liniowej (wielorakiej) | 6. Regresja liniowa |
| regresji logistycznej | 7. Regresja logistyczna |
| analizy wariancji (jedno- lub dwuczynnikowej) | 8. ANOVA |
| alfy Cronbacha, omegi | 9. Rzetelność skali |
| moderacji (interakcji w regresji) | 10. Moderacja |
| czegokolwiek z powyższych | 11. Pytania przekrojowe: p, efekt, moc, poprawki |
Odpowiedzi opierają się na jednym przykładowym badaniu w stylu pracy magisterskiej z psychologii: 120 osób studiujących (73 kobiety, 47 mężczyzn), praca zarobkowa (nie pracuje – 51, dorywczo – 51, na etat – 18), stres mierzony skalą 6 pozycji (1–5, pozycja 5 odwrócona) w semestrze i w sesji, wsparcie społeczne (1–7), satysfakcja z życia (5–35), czas w mediach społecznościowych i korzystanie z pomocy psychologicznej. Dane są symulowane, a każda liczba pochodzi z kodu R na końcu wpisu. Dane możesz pobrać w pliku pytania-ze-statystyki-obrona-dane.csv i przećwiczyć analizy w swoim programie.
Odpowiedzi są krótkie (2–5 zdań), bo tyle zwykle wystarcza; jeśli komisja chce więcej, dopyta. Podstaw własne liczby i mów własnymi słowami. Przy części pytań dodaliśmy pułapkę – zdanie, które brzmi naturalnie, ale jest błędne. Jeśli nie pamiętasz, dlaczego wybrałeś(-aś) dany test, zacznij od zestawienia jaki test statystyczny do jakiej hipotezy, a rachunki przećwicz na zadaniach ze statystyki z rozwiązaniami.
1. Statystyki opisowe i rozkład – pytania na obronę
Dlaczego przy stresie podajesz średnią, a przy czasie w mediach społecznościowych medianę?
„Rozkład stresu jest prawie symetryczny: średnia 2.92 i mediana 2.83 są bliskie, a skośność wynosi 0.11. Czas w mediach społecznościowych jest wyraźnie prawoskośny (skośność 1.17, kilka osób podało ponad 10 godzin dziennie), więc średnia 3.63 godziny jest zawyżona przez nieliczne wysokie wyniki, a mediana 2.90 lepiej opisuje typową osobę. Dlatego przy tej zmiennej podaję medianę i rozstęp międzykwartylowy.”
Po co był test Shapiro–Wilka i co znaczy jego wynik?
„Sprawdzałem(-am), czy rozkład odbiega od normalnego. Dla stresu wynik był nieistotny, W = 0.984, p = .157, dla czasu w mediach – istotny, W = 0.902, p < .001. Nieistotny wynik nie dowodzi normalności, tylko nie daje podstaw, by ją odrzucić, dlatego oglądałem(-am) też histogramy i wykresy Q-Q.” Więcej o samym teście – w haśle test Shapiro–Wilka.
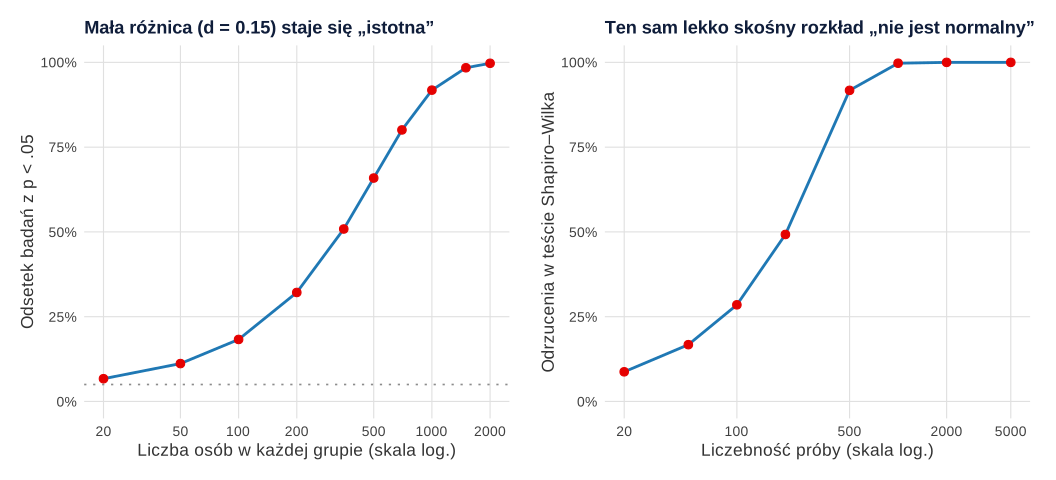
Przy dużej próbie test normalności zawsze wychodzi istotny. Po co go więc robić?
„Test Shapiro–Wilka ma moc rosnącą z liczebnością próby. Ten sam lekko skośny rozkład (skośność około 0.4) w symulacji był odrzucany w 13% prób po 30 osób, w 34% prób po 120 osób i w 100% prób po 1000 i 5000 osób. Przy dużej próbie test wykrywa więc odchylenia bez praktycznego znaczenia, a jednocześnie test t i regresja są wtedy trafne nawet przy wyraźnie nienormalnych danych (Lumley i in., 2002). Dlatego o metodzie decydowałem(-am) na podstawie wykresu i pytania badawczego, a nie samego p.”
Normalność czego sprawdzałeś(-aś) – zmiennych czy reszt?
„W regresji i ANOVA założenie dotyczy reszt modelu, a nie surowych zmiennych. Reszty regresji satysfakcji z życia nie odbiegały istotnie od normalnego, W = 0.991, p = .635.” Szerzej – we wpisie normalność reszt czy zmiennych.
Pułapka: „Rozkład nie był normalny, więc musiałem(-am) użyć testu nieparametrycznego”. To skrót myślowy, który recenzent łatwo podważy: wybór testu zależy od tego, co chcesz porównać (średnie czy rozkłady), od liczebności i od kształtu rozkładu, a nie tylko od wyniku testu normalności.
2. Test t: niezależny, zależny i Welcha
Dlaczego użyłeś(-aś) testu Welcha, a nie klasycznego testu t Studenta?
„Grupy były nierówne (47 mężczyzn i 73 kobiety) i miały różne odchylenia standardowe (0.54 i 0.73). Test Welcha nie zakłada równych wariancji, lepiej kontroluje błąd I rodzaju, gdy są różne, i niewiele traci, gdy są równe, dlatego zaleca się go jako domyślny (Delacre i in., 2017). Wynik: t(115.97) = 3.27, p = .001; klasyczny test dałby t(118) = 3.06, p = .003, czyli ten sam wniosek.” Ułamkowe stopnie swobody to cecha testu Welcha, a nie błąd w obliczeniach.
O ile różnią się grupy i jak policzono d Cohena?
„Kobiety miały stres wyższy średnio o 0.38 punktu na skali 1–5, 95% CI [0.15, 0.61]. d Cohena to ta różnica podzielona przez łączne odchylenie standardowe obu grup, ważone ich liczebnością: d = 0.57. Przy nierównych grupach wzór na łączne SD to uwzględnia, więc liczebność większej grupy nie jest pomijana (Lakens, 2013).”
Dlaczego stres w semestrze i w sesji porównano testem zależnym?
„Te same 120 osób wypełniło skalę dwa razy, a wyniki były silnie skorelowane, r = .88. Test zależny analizuje różnice u każdej osoby: stres wzrósł z 2.92 do 3.08, t(119) = 4.74, p < .001, dz = 0.43. Test niezależny na tych samych danych dałby t = 1.67 i p = .096, bo potraktowałby stałe różnice między osobami jako szum.”
Pułapka: „Założeniem testu t jest normalność zmiennej w całej próbie”. Założenie dotyczy rozkładu w każdej grupie (w teście zależnym – różnic), a przy kilkudziesięciu osobach w grupie test jest na nie dość odporny.
3. Testy nieparametryczne: Mann–Whitney, Wilcoxon, Kruskal–Wallis
Dlaczego czas w mediach porównałeś(-aś) testem Manna–Whitneya, a nie testem t?
„Rozkład był silnie prawoskośny z kilkoma bardzo wysokimi wynikami (maksimum 12.6 godziny), a w pracy opisuję typową osobę medianą. Test Manna–Whitneya opiera się na rangach, więc pojedyncze skrajne wyniki nie decydują o wyniku. Przy 47 i 73 osobach test t też byłby dopuszczalny, ale odpowiadałby na pytanie o średnie, które tu słabo opisują dane.”
Co właściwie porównuje test Manna–Whitneya – mediany?
„Nie tylko. Test sprawdza, czy wyniki jednej grupy mają tendencję do bycia wyższymi niż drugiej; różnice w kształcie i rozproszeniu też wpływają na wynik, więc to nie jest test median (Hart, 2001). U mnie U = 1236.5, p = .010: losowo wybrana kobieta spędza w mediach więcej czasu niż losowo wybrany mężczyzna z prawdopodobieństwem .64 (remisy liczone po połowie). Korelacja rangowo-dwuseryjna wynosi .28. Opisowo podaję mediany: 3.50 godziny u kobiet i 2.20 u mężczyzn.” Zob. test U Manna–Whitneya.
Test Kruskala–Wallisa wyszedł nieistotny. Czy robiłeś(-aś) porównania parami?
„Nie. Czas w mediach nie różnił się istotnie między grupami pracy zarobkowej, H(2) = 3.04, p = .218, ε² = .026, więc porównania parami testem Dunna nie były uzasadnione. Mediany (3.3, 2.9 i 2.2 godziny) opisuję tylko jako tendencję, której to badanie nie potwierdziło.” Więcej o teście w haśle test Kruskala–Wallisa.
Po co dodatkowo test Wilcoxona dla stresu w sesji?
„Jako analizę wrażliwości: test Wilcoxona dla par, V = 5311.5, p < .001, prowadzi do tego samego wniosku co test t dla prób zależnych. Gdy oba testy się zgadzają, wynik nie zależy od założeń o rozkładzie.”
Pułapka: „Testy nieparametryczne nie mają założeń”. Mają: niezależność obserwacji, a przy interpretacji jako przesunięcia – podobny kształt rozkładów w grupach.
4. Chi-kwadrat: tabela krzyżowa, Fisher i V Craméra
Co sprawdzał test χ² w Twojej tabeli?
„Czy korzystanie z pomocy psychologicznej jest niezależne od płci. Korzystało 24 z 73 kobiet (32.88%) i 5 z 47 mężczyzn (10.64%); χ²(1, N = 120) = 7.72, p = .005. Test mówi o związku dwóch zmiennych w tej próbie, a nie o tym, dlaczego kobiety częściej szukają pomocy.” Zob. chi-kwadrat – test niezależności.
Czy liczności w tabeli były wystarczające?
„Warunek dotyczy liczności oczekiwanych, a nie obserwowanych. Najmniejsza oczekiwana wynosiła 11.36, choć w jednej komórce było tylko 5 mężczyzn. Przyjmuje się, że najwyżej 20% komórek może mieć liczność oczekiwaną poniżej 5 i żadna poniżej 1 (Kim, 2017). W tabeli praca × pomoc taka komórka była jedna na sześć (najmniejsza oczekiwana 4.35), więc warunek był spełniony, a test dokładny Fishera dał ten sam wniosek: χ²(2) = 0.10, p = .953, test Fishera p = 1.000.” Kiedy wybrać ten drugi test, wyjaśnia hasło test dokładny Fishera.
Jak silny jest ten związek?
„V Craméra wynosi .25, co przy tabeli 2 × 2 (df = 1) mieści się między progami małego (.10) i średniego (.30) efektu (Kim, 2017). Bardziej obrazowo: odsetek korzystających z pomocy był u kobiet 3.09 raza wyższy niż u mężczyzn.”
Liczyłeś(-aś) z poprawką Yatesa czy bez?
„Bez poprawki, bo liczności oczekiwane były duże; z poprawką Yatesa p = .010, więc wniosek się nie zmienia. W pracy podałem(-am), której wersji użyłem(-am).”
5. Korelacja: Pearson, Spearman i przyczynowość
Dlaczego Pearson, a nie Spearman?
„Obie zmienne są ilościowe, a wykres rozrzutu nie pokazywał nieliniowości ani skrajnych punktów. Wynik Pearsona, r(118) = −.43, 95% CI [−.56, −.27], p < .001, był prawie taki sam jak korelacja Spearmana, ρ = −.44. Gdyby wyniki się rozjeżdżały, sprawdziłbym(-abym), czy nie decyduje o nich kilka osób.”
Co by się stało, gdyby w danych była jedna nietypowa osoba?
„Po dopisaniu jednej osoby z bardzo niskim wsparciem i bardzo niskim stresem korelacja Pearsona spada z −.43 do −.33, a Spearmana tylko do −.40. Pearson jest wrażliwy na pojedyncze skrajne punkty, dlatego zawsze oglądam wykres rozrzutu.”
Co znaczy r = −.43 i ile to jest r²?
„Osoby z większym wsparciem miały przeciętnie niższy stres. r² = .18, czyli wsparcie i stres mają wspólne około 18% zmienności; pozostałe 82% wynika z innych czynników.”
Czy to znaczy, że wsparcie obniża stres?
„Nie. To badanie korelacyjne z jednym pomiarem: równie dobrze zestresowane osoby mogą słabiej dostrzegać wsparcie albo oba wyniki mogą zależeć od trzeciej zmiennej, np. sytuacji materialnej. Piszę o związku, nie o wpływie.” Zob. korelacja a przyczynowość.
Pułapka: „Korelacja jest istotna, więc jest silna”. Przy n = 120 korelacja .10 jest nieistotna (p = .277), a przy n = 1500 – istotna (p < .001), choć siła związku jest identyczna.
6. Regresja liniowa: współczynniki, R² i współliniowość
Co znaczy współczynnik b = −2.86 przy stresie?
„Przy tym samym wsparciu i tej samej płci osoby, których stres jest wyższy o 1 punkt, mają przeciętnie o 2.86 punktu niższą satysfakcję z życia (SE = 0.67, p < .001). To współczynnik cząstkowy, więc różni się od zależności, którą widać na prostym wykresie stresu i satysfakcji.”
Który predyktor jest ważniejszy – stres czy wsparcie?
„Współczynniki niestandaryzowane są w różnych jednostkach (skala 1–5 i 1–7), dlatego do porównania używam standaryzowanych: β = −.38 dla stresu i β = .31 dla wsparcia. Stres ma nieco silniejszy związek w tej próbie, ale różnica jest niewielka i nie testowałem(-am) jej formalnie, więc nie piszę, że stres jest „ważniejszy”.” Kiedy podawać które współczynniki, wyjaśnia wpis współczynniki standaryzowane czy niestandaryzowane.
Co mówi R² = .35?
„Trzy predyktory razem wyjaśniają 35% zmienności satysfakcji w tej próbie, F(3, 116) = 20.39, p < .001. Skorygowane R² = .33 uwzględnia liczbę predyktorów i jest lepszym oszacowaniem dla populacji.”
Czy sprawdzałeś(-aś) współliniowość?
„Tak, współczynniki VIF wyniosły 1.39 dla stresu, 1.30 dla wsparcia i 1.15 dla płci, czyli predyktory nie dublują się na tyle, by zawyżać błędy standardowe.” Co oznaczają wyższe wartości, opisuje hasło VIF.
Ile predyktorów możesz wstawić przy 120 osobach?
„W modelu są trzy predyktory, czyli 40 osób na predyktor. Popularne reguły kciuka (10–20 osób na predyktor) są tylko orientacyjne – właściwą liczebność wyznacza analiza mocy dla efektu, który chcę wykryć. Nie dodawałem(-am) predyktorów po obejrzeniu wyników, bo przy małej próbie łatwo dopasować model do przypadkowych zależności.”
Pułapka: „Płeć nie ma znaczenia dla satysfakcji”. Nieistotny współczynnik (b = −0.21, p = .806) znaczy tylko, że po uwzględnieniu stresu i wsparcia ta próba nie pokazała różnicy, a nie że jej nie ma.
7. Regresja logistyczna: iloraz szans i dopasowanie modelu
Co znaczy iloraz szans 3.26 dla płci?
„Przy tym samym poziomie stresu szansa skorzystania z pomocy psychologicznej (stosunek prawdopodobieństwa skorzystania do nieskorzystania) była u kobiet 3.26 raza większa niż u mężczyzn, 95% CI [1.17, 10.64], p = .032. Przedział jest bardzo szeroki, bo pomoc wybrało tylko 5 mężczyzn, więc prawdziwy efekt może być zarówno mały, jak i bardzo duży.” Zob. iloraz szans.
Czy to znaczy, że kobiety ponad trzy razy częściej korzystają z pomocy?
„Nie do końca. Iloraz szans to nie iloraz prawdopodobieństw: gdy zdarzenie nie jest rzadkie, OR zawyża wielkość efektu odczytaną jako ryzyko względne (Davies i in., 1998). W surowej tabeli iloraz odsetków wynosi 3.09, a iloraz szans – 4.11. Dlatego podaję też przewidywane prawdopodobieństwa: dla kobiety o stresie 2, 3 i 4 wynoszą .19, .31 i .46.”
Iloraz szans dla stresu wynosi 1.88, ale p = .062. Jak to rozumieć?
„Każdy punkt stresu wiązał się z prawie dwukrotnie większą szansą skorzystania z pomocy, ale 95% CI [0.99, 3.77] obejmuje 1, czyli brak związku. Wynik jest nierozstrzygnięty: dane są zgodne zarówno z brakiem efektu, jak i z efektem dużym. Nie piszę, że stres nie ma związku z szukaniem pomocy.”
Jak dobrze model pasuje do danych?
„Model jest lepszy od modelu bez predyktorów, test ilorazu wiarygodności χ²(2) = 12.09, p = .002, ale wyjaśnia niewiele: R² McFaddena = .09, R² Nagelkerkego = .14, a pole pod krzywą ROC wynosi .71. Trafnie klasyfikuje 75.00% osób, czyli nie więcej niż reguła „nikt nie korzysta” (75.83%), bo z pomocy korzystało tylko 29 osób na 120. Model służył mi do opisu związków, a nie do przewidywania.”
Pułapka: „Model trafnie klasyfikuje 75% osób, więc dobrze działa”. Odsetek trafień zawsze porównaj z odsetkiem najliczniejszej kategorii.
8. ANOVA: post hoc, poprawki, η² i interakcja
Pytania „dlaczego ANOVA, a nie kilka testów t” i „jak sprawdzono założenia ANOVA” omawia tekst o pytaniach z metodologii, do którego linkujemy na początku wpisu. Tutaj – pytania, które padają, gdy wynik nie jest taki, jak w podręczniku.
Efekt pracy zarobkowej był nieistotny. Czy mimo to robiłeś(-aś) testy post hoc?
„Średni stres w trzech grupach był podobny (2.85, 2.97 i 3.01), F(2, 117) = 0.59, p = .555, η² = .01. Testy post hoc pokazałem(-am) tylko w aneksie: żadna para się nie różniła (test Tukeya, p od .620 do .982). Szukanie różnic między parami po nieistotnym teście ogólnym to zwykle szukanie przypadku.”
Dlaczego test Tukeya, a nie poprawka Bonferroniego?
„Przy porównaniu wszystkich par test Tukeya kontroluje błąd dla całej rodziny porównań i jest mniej konserwatywny niż Bonferroni, który mnoży każde p przez liczbę porównań. U mnie po poprawce Bonferroniego wszystkie trzy wartości p wynoszą 1.000. Wybór testu post hoc zapisałem(-am) w planie analiz.” Porównanie procedur – we wpisie testy post hoc – który wybrać.
Skąd ujemna omega kwadrat (ω² = −.01)?
„η² z próby jest obciążone w górę, a ω² koryguje to obciążenie (Lakens, 2013). Gdy efekt jest bliski zera, korekta daje wartość ujemną; interpretuję ją jako zero, czyli brak wyjaśnionej zmienności.”
Efekt główny pracy był nieistotny, a interakcja z płcią istotna. Jak to możliwe?
„Interakcja praca × płeć była istotna, F(2, 114) = 3.53, p = .033, cząstkowe η² = .06. U kobiet stres był wyższy przy pracy dorywczej (3.18) i na etat (3.42) niż bez pracy (2.86), u mężczyzn – nie (2.83, 2.52 i 2.68). Przeciwne kierunki częściowo się znoszą, więc w średnich dla całej próby różnicy nie widać. Ostrożnie: na etat pracowało tylko 8 kobiet i 10 mężczyzn, a przedziały ufności w tych komórkach są szerokie.” Jak opisywać taki wynik, pokazuje wpis interakcja w ANOVA – jak ją opisać.
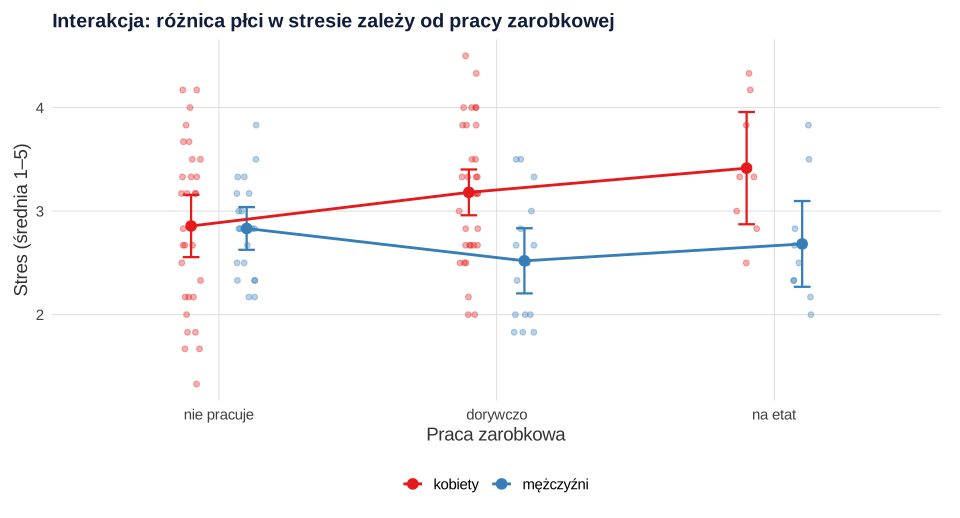
Pułapka: „Praca zarobkowa nie wpływa na stres”. Nieistotny efekt główny przy istotnej interakcji nie oznacza braku związku – oznacza, że związek jest inny w różnych grupach.
9. Rzetelność skali: alfa Cronbacha i omega
Co znaczy α = .79?
„Alfa Cronbacha mówi, w jakim stopniu pozycje skali zmieniają się razem; przy założeniach modelu można ją czytać jako szacowany udział wariancji wyniku prawdziwego w wyniku skali. Dla sześciu pozycji stresu α = .79, a średnia korelacja między pozycjami wynosi .37. To zadowalająca spójność do porównań grupowych, ale nie dowód, że skala mierzy właśnie stres.” Szerzej – w poradniku alfa Cronbacha – rzetelność skali.
Po usunięciu pozycji 5 alfa wzrosłaby do .81. Dlaczego jej nie usunąłeś(-aś)?
„Pozycja 5 ma najniższą korelację z resztą skali (.23 wobec .56–.63 dla pozostałych), więc o niej wspominam. Usunąłbym(-abym) ją jednak tylko z powodów merytorycznych: to pozycja z opublikowanej skali, jej usunięcie zmieniłoby treść narzędzia i porównywalność z innymi badaniami, a zysk w alfie jest niewielki (z .79 do .81). Decyzji o usuwaniu pozycji nie podejmuje się po to, by poprawić wynik.”
Czy pozycję odwróconą przekodowano przed obliczeniem alfy?
„Tak. Bez przekodowania pozycji 5 alfa spadłaby do .70, a wynik skali byłby zaniżony u osób z wysokim stresem.” Recenzenci pytają o to często, bo brak przekodowania to jeden z najczęstszych błędów w pracach.
Dlaczego podajesz też omegę McDonalda?
„Alfa zakłada, że wszystkie pozycje mierzą konstrukt z podobną siłą, a omega tego nie wymaga, dlatego proponuje się ją jako praktyczną alternatywę (Dunn i in., 2014). W mojej skali obie wynoszą .79, więc wybór współczynnika nie zmienia wniosku.”
Pułapka: „Krótsza skala ma gorszą alfę, więc jest gorsza”. Alfa zależy od liczby pozycji: trzy pierwsze pozycje mają α = .75, choć mierzą to samo.
10. Moderacja: pytania o interakcję w regresji
Pytania o centrowanie i bootstrap w mediacji omawia wpis statystyka do pracy magisterskiej. Tutaj – sytuacja, którą komisja lubi: interakcja wyszła nieistotna.
Interakcja stresu i wsparcia była nieistotna. Czy wsparcie osłabia związek stresu z satysfakcją?
„Tego badanie nie wykazało. Współczynnik interakcji wyniósł b = 0.75, SE = 0.59, p = .202, a przyrost R² po jej dodaniu – .009. Kierunek był zgodny z hipotezą, ale wynik jest nierozstrzygnięty, a do wykrycia małej interakcji potrzeba zwykle dużo większej próby niż 120 osób.”
Przy niskim wsparciu nachylenie wynosi −3.78, a przy wysokim −2.25. Czy to nie dowód moderacji?
„Nie. Oba nachylenia są istotne (p < .001 i p = .006), ale o moderacji świadczy test różnicy między nimi, czyli test interakcji, a ten był nieistotny. Analizę nachyleń prostych pokazuję opisowo, nie jako potwierdzenie hipotezy.”
Czym moderator różni się od mediatora w Twoim modelu?
„Moderator zmienia siłę lub kierunek związku – tu: czy przy wysokim wsparciu stres mniej obniża satysfakcję. Mediator byłby ogniwem pośrednim – stres obniża coś, co z kolei obniża satysfakcję. Hipoteza dotyczyła warunku, a nie mechanizmu, dlatego testowałem(-am) interakcję.” Definicję i przykłady znajdziesz w haśle moderacja.
11. Pytania przekrojowe: p, wielkość efektu, przedział ufności, moc i poprawki
Te pytania padają przy każdej analizie. Pełniejsze odpowiedzi z przykładami – w pytaniach o interpretację wyników; tu tylko wersja skrócona.
Co znaczy p = .010 w Twoim teście?
„Że tak duża lub większa różnica byłaby mało prawdopodobna, gdyby w populacji grupy się nie różniły, a założenia testu były spełnione. To nie jest prawdopodobieństwo, że hipoteza zerowa jest prawdziwa.” Zob. wartość p.
Po co wielkość efektu, skoro wynik jest istotny?
„Bo p zależy od liczebności, a wielkość efektu – nie. Różnica płci w stresie to d = 0.57, a związek płci z korzystaniem z pomocy – V = .25; to informacja, której p nie daje.” Progi i ich ograniczenia omawia wpis wielkość efektu – interpretacja.
Ile wynosiła moc Twojego badania?
„Moc jest cechą planu, nie wyniku, więc nie liczę jej z uzyskanego efektu. Mogę powiedzieć, jaki efekt badanie mogło wykryć: przy 60 osobach w grupie (średnio tyle liczą porównywane grupy płci) moc dla bardzo małej różnicy (d = 0.15) wynosi tylko .13, a do mocy .80 potrzeba by 699 osób w grupie.” Zob. moc testu.
Czy stosowałeś(-aś) poprawkę na wielokrotne porównania?
„Tak, wewnątrz rodzin porównań – testem Tukeya po ANOVA. Każdą hipotezę główną testowałem(-am) jedną zaplanowaną analizą, a analizy dodatkowe opisałem(-am) jako eksploracyjne.” Kiedy poprawka jest potrzebna, a kiedy nie, wyjaśnia wpis poprawki na wielokrotne porównania.
Przed obroną przejdź przez sekcje swoich analiz i dla każdego pytania powiedz odpowiedź na głos z własnymi liczbami. Jeśli na obronie pokazujesz wyniki na slajdach, przygotuj je tak, by liczby z odpowiedzi były na nich widoczne – podpowiada to wpis prezentacja wyników na obronie.
Kod R: skąd pochodzą liczby w odpowiedziach
Dwa przepisy liczą wszystkie liczby użyte w odpowiedziach. Pierwszy losuje dane przykładowe (set.seed(376)), zapisuje je do pliku CSV i liczy statystyki opisowe, testy t, testy nieparametryczne, χ² i korelacje. Drugi wczytuje ten plik i liczy regresję liniową i logistyczną, ANOVA, rzetelność skali i moderację. Rysunki przygotowano w osobnym skrypcie.
Część 1: dane, statystyki opisowe, testy t, testy nieparametryczne, χ² i korelacja
R
# B376 – przykładowa „praca magisterska”: dane symulowane, statystyki opisowe, testy t, nieparametryczne, chi-kwadrat, korelacja
# 120 osób studiujących: płeć, praca zarobkowa, stres (skala 6 pozycji 1–5, pozycja s5 odwrócona), stres w sesji,
# wsparcie społeczne (1–7), satysfakcja z życia (5–35), czas w mediach społecznościowych, korzystanie z pomocy psychologicznej.
# Uruchom z folderu kod/. Zapisuje plik CSV z danymi, który wczytuje drugi przepis.
set.seed(376)
n <- 120
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)
pp <- function(p) if (p < .001) "p < .001" else paste("p =", sub("^0\\.", ".", z3(p)))
bz <- function(x) sub("^(-?)0\\.", "\\1.", z2(x))           # bez zera przed kropką (r, V, r²)

plec  <- factor(sample(c("K", "M"), n, replace = TRUE, prob = c(.6, .4)), levels = c("M", "K"))
praca <- factor(sample(c("nie", "dorywczo", "etat"), n, replace = TRUE, prob = c(.45, .35, .20)),
                levels = c("nie", "dorywczo", "etat"))
wsparcie <- round(pmin(7, pmax(1, rnorm(n, 5.2, 1.0))), 2)
# stres latentny: wyższy u kobiet i przy pracy na etat (u kobiet silniej), niższy przy większym wsparciu
eta <- 0.35 * (plec == "K") + 0.15 * (praca == "dorywczo") + 0.25 * (praca == "etat") +
       0.55 * (praca == "etat") * (plec == "K") - 0.35 * (wsparcie - 5.2) + rnorm(n, 0, 0.6)
lad <- c(0.9, 0.8, 0.85, 0.75, 0.25, 0.8)                     # s5 – słaba pozycja odwrócona
pozycje <- sapply(1:6, function(j) round(pmin(5, pmax(1, 2.6 + lad[j] * eta + rnorm(n, 0, 0.75)))))
pozycje[, 5] <- 6 - pozycje[, 5]                               # odpowiedzi na pozycję odwróconą
colnames(pozycje) <- paste0("s", 1:6)
s5_odkod <- 6 - pozycje[, "s5"]
stres <- round(rowMeans(cbind(pozycje[, -5], s5_odkod)), 2)
stres_sesja <- round(pmin(5, pmax(1, stres + 0.20 + rnorm(n, 0, 0.35))), 2)
media <- round(exp(rnorm(n, log(2.2) + 0.40 * (plec == "K") + 0.15 * (praca == "nie"), 0.6)), 1)
satysfakcja <- round(pmin(35, pmax(5, 22 - 3.2 * (stres - 2.9) + 1.6 * (wsparcie - 5.2) +
                     1.4 * (stres - 2.9) * (wsparcie - 5.2) + rnorm(n, 0, 4.2))))
pomoc <- rbinom(n, 1, plogis(-1.6 + 1.1 * (stres - 2.9) + 0.3 * (plec == "K")))
d <- data.frame(id = 1:n, plec, praca, pozycje, stres, stres_sesja, wsparcie, satysfakcja, media, pomoc)
write.csv(d, "../pytania-ze-statystyki-obrona-dane.csv", row.names = FALSE)

cat("1. Statystyki opisowe i rozkład\n")
cat("N =", n, "; kobiety:", sum(plec == "K"), "; praca nie/dorywczo/etat:", table(praca), "\n")
opis <- function(x) c(M = mean(x), SD = sd(x), Me = median(x), min = min(x), max = max(x))
print(round(rbind(stres = opis(stres), wsparcie = opis(wsparcie), satysfakcja = opis(satysfakcja),
                  media = opis(media)), 2))
skos <- function(x) mean((x - mean(x))^3) / sd(x)^3
cat("Skośność: stres =", z2(skos(stres)), "; media =", z2(skos(media)), "\n")
sw1 <- shapiro.test(stres); sw2 <- shapiro.test(media)
cat("Shapiro–Wilk stres: W =", z3(sw1$statistic), ",", pp(sw1$p.value),
    "| media: W =", z3(sw2$statistic), ",", pp(sw2$p.value), "\n")
# ten sam lekko skośny rozkład w małej i dużej próbie (rozkład gamma, skośność ok. 0.4)
p_sw <- sapply(c(30, 120, 1000, 5000), function(m) mean(replicate(500, shapiro.test(rgamma(m, 25))$p.value < .05)))
cat("Odsetek odrzuceń H0 w teście Shapiro–Wilka (skośność ok. 0.4), n = 30/120/1000/5000:", z2(p_sw), "\n\n")

cat("2. Test t: stres kobiet i mężczyzn (Welch) oraz stres w semestrze i w sesji (zależny)\n")
print(round(sapply(split(stres, plec), function(x) c(n = length(x), M = mean(x), SD = sd(x))), 2))
tw <- t.test(stres ~ plec, var.equal = FALSE)
ts <- t.test(stres ~ plec, var.equal = TRUE)
sp <- sqrt(((sum(plec == "M") - 1) * var(stres[plec == "M"]) + (sum(plec == "K") - 1) * var(stres[plec == "K"])) / (n - 2))
dc <- (mean(stres[plec == "K"]) - mean(stres[plec == "M"])) / sp
cat("Welch: t(", z2(tw$parameter), ") =", z2(-tw$statistic), ",", pp(tw$p.value),
    "; różnica K − M =", z2(diff(tw$estimate)), ", 95% CI [", z2(-tw$conf.int[2]), ",", z2(-tw$conf.int[1]), "]\n")
cat("Student: t(", ts$parameter, ") =", z2(-ts$statistic), ",", pp(ts$p.value), "; d Cohena =", z2(dc), "\n")
tz <- t.test(stres_sesja, stres, paired = TRUE)
roz <- stres_sesja - stres
cat("Zależny: M semestr =", z2(mean(stres)), ", M sesja =", z2(mean(stres_sesja)), "; t(", tz$parameter, ") =",
    z2(tz$statistic), ",", pp(tz$p.value), "; d_z =", z2(mean(roz) / sd(roz)),
    "; r(semestr, sesja) =", bz(cor(stres, stres_sesja)), "\n")
cat("Błąd: test niezależny na tych samych danych: t =", z2(t.test(stres_sesja, stres)$statistic),
    ",", pp(t.test(stres_sesja, stres)$p.value), "\n\n")

cat("3. Testy nieparametryczne: czas w mediach społecznościowych (godz./dzień)\n")
print(round(sapply(split(media, plec), function(x) c(Me = median(x), Q1 = unname(quantile(x, .25)), Q3 = unname(quantile(x, .75)))), 2))
mw <- wilcox.test(media ~ plec, exact = FALSE)
n1 <- sum(plec == "M"); n2 <- sum(plec == "K")
U_K <- n1 * n2 - mw$statistic                                  # U dla kobiet
cat("Mann–Whitney: U =", mw$statistic, ",", pp(mw$p.value), "; korelacja rangowo-dwuseryjna (K > M) =",
    bz(2 * U_K / (n1 * n2) - 1), "; P(K > M) =", bz(U_K / (n1 * n2)), "\n")
wx <- wilcox.test(stres_sesja, stres, paired = TRUE, exact = FALSE)
cat("Wilcoxon (sesja vs semestr): V =", wx$statistic, ",", pp(wx$p.value), "\n")
kw <- kruskal.test(media ~ praca)
cat("Kruskal–Wallis (praca): H(", kw$parameter, ") =", z2(kw$statistic), ",", pp(kw$p.value),
    "; epsilon² =", sub("^0", "", z3(kw$statistic / (n - 1))), "; mediany:", tapply(media, praca, median), "\n\n")

cat("4. Chi-kwadrat: płeć a korzystanie z pomocy psychologicznej\n")
tab <- table(plec, pomoc = factor(pomoc, 0:1, c("nie", "tak")))
print(tab)
ch <- chisq.test(tab, correct = FALSE)
cat("Odsetek korzystających: M =", z2(100 * prop.table(tab, 1)["M", "tak"]), "%, K =",
    z2(100 * prop.table(tab, 1)["K", "tak"]), "%\n")
cat("Liczności oczekiwane: min =", z2(min(ch$expected)), "\n")
pk <- prop.table(tab, 1)[, "tak"]
cat("Iloraz odsetków K / M =", z2(pk["K"] / pk["M"]), "; iloraz szans K / M =",
    z2((tab["K", "tak"] / tab["K", "nie"]) / (tab["M", "tak"] / tab["M", "nie"])), "\n")
cat("chi2(", ch$parameter, ", N =", n, ") =", z2(ch$statistic), ",", pp(ch$p.value),
    "; V Craméra =", bz(sqrt(ch$statistic / n)), "; z poprawką Yatesa:", pp(chisq.test(tab)$p.value), "\n")
tab3 <- table(praca, pomoc = factor(pomoc, 0:1, c("nie", "tak")))
ch3 <- suppressWarnings(chisq.test(tab3))
cat("Praca × pomoc: komórki z E < 5:", sum(ch3$expected < 5), "z", length(ch3$expected),
    "; min E =", z2(min(ch3$expected)), "; chi2(2) =", z2(ch3$statistic), ",", pp(ch3$p.value),
    "; Fisher:", pp(fisher.test(tab3)$p.value), "\n\n")

cat("5. Korelacja: wsparcie a stres\n")
cp <- cor.test(wsparcie, stres); cs <- cor.test(wsparcie, stres, method = "spearman", exact = FALSE)
cat("Pearson: r(", cp$parameter, ") =", bz(cp$estimate), ", 95% CI [", bz(cp$conf.int[1]), ",", bz(cp$conf.int[2]),
    "],", pp(cp$p.value), "; r² =", bz(cp$estimate^2), "\n")
cat("Spearman: rho =", bz(cs$estimate), ",", pp(cs$p.value), "\n")
w_o <- c(wsparcie, 1.2); s_o <- c(stres, 1.3)                  # jedna dopisana osoba nietypowa
cat("Z jedną osobą nietypową: Pearson r =", bz(cor(w_o, s_o)), "; Spearman rho =", bz(cor(w_o, s_o, method = "spearman")), "\n")
r_male <- .10
cat("r = .10: przy n = 120", pp(2 * pt(-abs(r_male * sqrt(118 / (1 - r_male^2))), 118)),
    "; przy n = 1500", pp(2 * pt(-abs(r_male * sqrt(1498 / (1 - r_male^2))), 1498)), "\n")
cat("Moc testu t dla d = 0.15: przy 60 osobach w grupie =", z2(power.t.test(n = 60, delta = 0.15)$power),
    "; osób w grupie dla mocy .80 =", ceiling(power.t.test(delta = 0.15, power = .80)$n), "\n")
Wynik w R
1. Statystyki opisowe i rozkład
N = 120 ; kobiety: 73 ; praca nie/dorywczo/etat: 51 51 18
                M   SD    Me  min  max
stres        2.92 0.69  2.83 1.33  4.5
wsparcie     5.00 1.02  4.92 2.75  7.0
satysfakcja 21.42 5.18 22.00 5.00 34.0
media        3.63 2.24  2.90 0.50 12.6
Skośność: stres = 0.11 ; media = 1.17
Shapiro–Wilk stres: W = 0.984 , p = .157 | media: W = 0.902 , p < .001
Odsetek odrzuceń H0 w teście Shapiro–Wilka (skośność ok. 0.4), n = 30/120/1000/5000: 0.13 0.34 1.00 1.00

2. Test t: stres kobiet i mężczyzn (Welch) oraz stres w semestrze i w sesji (zależny)
       M     K
n  47.00 73.00
M   2.69  3.07
SD  0.54  0.73
Welch: t( 115.97 ) = 3.27 , p = .001 ; różnica K − M = 0.38 , 95% CI [ 0.15 , 0.61 ]
Student: t( 118 ) = 3.06 , p = .003 ; d Cohena = 0.57
Zależny: M semestr = 2.92 , M sesja = 3.08 ; t( 119 ) = 4.74 , p < .001 ; d_z = 0.43 ; r(semestr, sesja) = .88
Błąd: test niezależny na tych samych danych: t = 1.67 , p = .096

3. Testy nieparametryczne: czas w mediach społecznościowych (godz./dzień)
      M   K
Me 2.20 3.5
Q1 1.80 2.2
Q3 3.95 5.4
Mann–Whitney: U = 1236.5 , p = .010 ; korelacja rangowo-dwuseryjna (K > M) = .28 ; P(K > M) = .64
Wilcoxon (sesja vs semestr): V = 5311.5 , p < .001
Kruskal–Wallis (praca): H( 2 ) = 3.04 , p = .218 ; epsilon² = .026 ; mediany: 3.3 2.9 2.2

4. Chi-kwadrat: płeć a korzystanie z pomocy psychologicznej
    pomoc
plec nie tak
   M  42   5
   K  49  24
Odsetek korzystających: M = 10.64 %, K = 32.88 %
Liczności oczekiwane: min = 11.36
Iloraz odsetków K / M = 3.09 ; iloraz szans K / M = 4.11
chi2( 1 , N = 120 ) = 7.72 , p = .005 ; V Craméra = .25 ; z poprawką Yatesa: p = .010
Praca × pomoc: komórki z E < 5: 1 z 6 ; min E = 4.35 ; chi2(2) = 0.10 , p = .953 ; Fisher: p = 1.000

5. Korelacja: wsparcie a stres
Pearson: r( 118 ) = -.43 , 95% CI [ -.56 , -.27 ], p < .001 ; r² = .18
Spearman: rho = -.44 , p < .001
Z jedną osobą nietypową: Pearson r = -.33 ; Spearman rho = -.40
r = .10: przy n = 120 p = .277 ; przy n = 1500 p < .001
Moc testu t dla d = 0.15: przy 60 osobach w grupie = 0.13 ; osób w grupie dla mocy .80 = 699
Część 2: regresja liniowa i logistyczna, ANOVA, rzetelność i moderacja
R
# B376 – przykładowa „praca magisterska”, część 2: regresja liniowa, regresja logistyczna, ANOVA, rzetelność, moderacja
# Wczytuje dane zapisane przez pierwszy przepis (ten sam plik CSV, który możesz pobrać ze strony).
suppressPackageStartupMessages(library(psych))
d <- read.csv("../pytania-ze-statystyki-obrona-dane.csv")
d$plec  <- factor(d$plec, levels = c("M", "K"))
d$praca <- factor(d$praca, levels = c("nie", "dorywczo", "etat"))
n <- nrow(d)
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)
pp <- function(p) if (p < .001) "p < .001" else paste("p =", sub("^0\\.", ".", z3(p)))
bz <- function(x, k = 2) sub("^(-?)0\\.", "\\1.", formatC(x, format = "f", digits = k))

cat("6. Regresja liniowa: satysfakcja z życia ~ stres + wsparcie + płeć\n")
m <- lm(satysfakcja ~ stres + wsparcie + plec, data = d)
s <- summary(m)
std <- function(x) (x - mean(x)) / sd(x)
ms <- lm(std(satysfakcja) ~ std(stres) + std(wsparcie) + plec, data = d)   # beta dla predyktorów ilościowych
tab <- cbind(b = coef(m), SE = s$coefficients[, 2], t = s$coefficients[, 3], p = s$coefficients[, 4],
             beta = c(NA, coef(ms)[2:3], NA))
print(round(tab, 3))
cat("R² =", bz(s$r.squared), "; skorygowane R² =", bz(s$adj.r.squared), "; F(", s$fstatistic[2], ",",
    s$fstatistic[3], ") =", z2(s$fstatistic[1]), ",",
    pp(pf(s$fstatistic[1], s$fstatistic[2], s$fstatistic[3], lower.tail = FALSE)), "\n")
X <- model.matrix(m)[, -1]
vif <- sapply(colnames(X), function(j) 1 / (1 - summary(lm(X[, j] ~ X[, -which(colnames(X) == j)]))$r.squared))
cat("VIF:", paste(names(vif), z2(vif), collapse = "; "), "\n")
cat("Shapiro–Wilk dla reszt: W =", z3(shapiro.test(resid(m))$statistic), ",", pp(shapiro.test(resid(m))$p.value), "\n")
cat("Osób na predyktor:", round(n / 3), "\n\n")

cat("7. Regresja logistyczna: korzystanie z pomocy psychologicznej ~ stres + płeć\n")
cat("Korzysta:", sum(d$pomoc), "z", n, "\n")
g <- glm(pomoc ~ stres + plec, data = d, family = binomial)
ci <- suppressMessages(confint(g))
print(round(cbind(b = coef(g), OR = exp(coef(g)), OR_dol = exp(ci[, 1]), OR_gora = exp(ci[, 2]),
                  p = summary(g)$coefficients[, 4]), 3))
g0 <- glm(pomoc ~ 1, data = d, family = binomial)
lr <- g0$deviance - g$deviance
cat("Test ilorazu wiarygodności: chi2(2) =", z2(lr), ",", pp(pchisq(lr, 2, lower.tail = FALSE)), "\n")
ll1 <- as.numeric(logLik(g)); ll0 <- as.numeric(logLik(g0))
r2cs <- 1 - exp(2 * (ll0 - ll1) / n)
cat("R² McFaddena =", bz(1 - ll1 / ll0), "; R² Nagelkerkego =", bz(r2cs / (1 - exp(2 * ll0 / n))), "\n")
pr <- fitted(g)
cat("Trafne klasyfikacje (próg .5):", z2(100 * mean((pr > .5) == d$pomoc)), "%; bez modelu (wszyscy „nie”):",
    z2(100 * mean(d$pomoc == 0)), "%\n")
r_ <- rank(pr); auc <- (sum(r_[d$pomoc == 1]) - sum(d$pomoc) * (sum(d$pomoc) + 1) / 2) / (sum(d$pomoc) * sum(d$pomoc == 0))
cat("AUC =", bz(auc), "\n")
cat("Przewidywane prawdopodobieństwo (kobieta): stres 2 =", bz(predict(g, data.frame(stres = 2, plec = "K"), type = "response")),
    "; stres 3 =", bz(predict(g, data.frame(stres = 3, plec = "K"), type = "response")),
    "; stres 4 =", bz(predict(g, data.frame(stres = 4, plec = "K"), type = "response")), "\n\n")

cat("8. ANOVA: stres a praca zarobkowa; ANOVA dwuczynnikowa praca × płeć\n")
print(round(sapply(split(d$stres, d$praca), function(x) c(n = length(x), M = mean(x), SD = sd(x))), 2))
a1 <- aov(stres ~ praca, data = d); t1 <- summary(a1)[[1]]
cat("F(", t1$Df[1], ",", t1$Df[2], ") =", z2(t1$`F value`[1]), ",", pp(t1$`Pr(>F)`[1]),
    "; eta² =", bz(t1$`Sum Sq`[1] / sum(t1$`Sum Sq`)), "; omega² =",
    bz((t1$`Sum Sq`[1] - t1$Df[1] * t1$`Mean Sq`[2]) / (sum(t1$`Sum Sq`) + t1$`Mean Sq`[2])), "\n")
odch <- abs(d$stres - ave(d$stres, d$praca, FUN = median))
lv <- summary(aov(odch ~ d$praca))[[1]]
cat("Levene (wokół mediany): F(", lv$Df[1], ",", lv$Df[2], ") =", z2(lv$`F value`[1]), ",", pp(lv$`Pr(>F)`[1]), "\n")
ow <- oneway.test(stres ~ praca, data = d)
cat("ANOVA Welcha: F(", ow$parameter[1], ",", z2(ow$parameter[2]), ") =", z2(ow$statistic), ",", pp(ow$p.value), "\n")
tk <- TukeyHSD(a1)$praca
print(round(tk, 3))
ph <- pairwise.t.test(d$stres, d$praca, p.adjust.method = "bonferroni")$p.value
cat("Bonferroni (p):", paste(z3(ph[!is.na(ph)]), collapse = " "), "\n")
a2 <- aov(stres ~ praca * plec, data = d); t2 <- summary(a2)[[1]]
cat("Interakcja praca × płeć: F(", t2$Df[3], ",", t2$Df[4], ") =", z2(t2$`F value`[3]), ",", pp(t2$`Pr(>F)`[3]),
    "; częściowe eta² =", bz(t2$`Sum Sq`[3] / (t2$`Sum Sq`[3] + t2$`Sum Sq`[4])), "\n")
print(round(tapply(d$stres, list(d$praca, d$plec), mean), 2))
print(table(d$praca, d$plec))
cat("\n")

cat("9. Rzetelność skali stresu (6 pozycji, s5 odwrócona)\n")
poz <- d[, paste0("s", 1:6)]
al <- psych::alpha(poz, keys = c("s5"), warnings = FALSE)
cat("alfa Cronbacha =", bz(al$total$raw_alpha), "; średnia korelacja między pozycjami =", bz(al$total$average_r), "\n")
print(round(data.frame(r_skor = al$item.stats$r.drop, alfa_bez = al$alpha.drop$raw_alpha,
                       row.names = rownames(al$item.stats)), 2))
poz_o <- poz; poz_o$s5 <- 6 - poz_o$s5
om <- suppressWarnings(suppressMessages(psych::omega(poz_o, nfactors = 1, plot = FALSE)))
cat("omega całkowita =", bz(om$omega.tot), "\n")
cat("Błąd – s5 bez odwrócenia: alfa =", bz(psych::alpha(poz, check.keys = FALSE, warnings = FALSE)$total$raw_alpha), "\n")
cat("Alfa dla 3 pozycji (s1–s3) =", bz(psych::alpha(poz[, 1:3], warnings = FALSE)$total$raw_alpha), "\n\n")

cat("10. Moderacja: czy wsparcie osłabia związek stresu z satysfakcją?\n")
d$stres_c <- d$stres - mean(d$stres); d$wsparcie_c <- d$wsparcie - mean(d$wsparcie)
mm <- lm(satysfakcja ~ stres_c * wsparcie_c, data = d); sm <- summary(mm)$coefficients
print(round(sm, 3))
cat("Przyrost R² po dodaniu interakcji =", bz(summary(mm)$r.squared - summary(lm(satysfakcja ~ stres_c + wsparcie_c, d))$r.squared, 3), "\n")
for (w in c(-1, 1)) {
  d$w_tmp <- d$wsparcie_c - w * sd(d$wsparcie)
  e <- summary(lm(satysfakcja ~ stres_c * w_tmp, data = d))$coefficients["stres_c", ]
  cat("Nachylenie stresu przy wsparciu", ifelse(w < 0, "−1 SD", "+1 SD"), ": b =", z2(e[1]), ", SE =", z2(e[2]), ",", pp(e[4]), "\n")
}
Wynik w R
6. Regresja liniowa: satysfakcja z życia ~ stres + wsparcie + płeć
                 b    SE      t     p   beta
(Intercept) 21.973 3.428  6.409 0.000     NA
stres       -2.858 0.668 -4.276 0.000 -0.379
wsparcie     1.587 0.435  3.647 0.000  0.312
plecK       -0.209 0.849 -0.246 0.806     NA
R² = .35 ; skorygowane R² = .33 ; F( 3 , 116 ) = 20.39 , p < .001
VIF: stres 1.39; wsparcie 1.30; plecK 1.15
Shapiro–Wilk dla reszt: W = 0.991 , p = .635
Osób na predyktor: 40

7. Regresja logistyczna: korzystanie z pomocy psychologicznej ~ stres + płeć
Korzysta: 29 z 120
                 b    OR OR_dol OR_gora     p
(Intercept) -3.880 0.021  0.002   0.152 0.000
stres        0.634 1.884  0.987   3.774 0.062
plecK        1.183 3.264  1.171  10.643 0.032
Test ilorazu wiarygodności: chi2(2) = 12.09 , p = .002
R² McFaddena = .09 ; R² Nagelkerkego = .14
Trafne klasyfikacje (próg .5): 75.00 %; bez modelu (wszyscy „nie”): 75.83 %
AUC = .71
Przewidywane prawdopodobieństwo (kobieta): stres 2 = .19 ; stres 3 = .31 ; stres 4 = .46

8. ANOVA: stres a praca zarobkowa; ANOVA dwuczynnikowa praca × płeć
     nie dorywczo  etat
n  51.00    51.00 18.00
M   2.85     2.97  3.01
SD  0.68     0.69  0.70
F( 2 , 117 ) = 0.59 , p = .555 ; eta² = .01 ; omega² = -.01
Levene (wokół mediany): F( 2 , 117 ) = 0.06 , p = .946
ANOVA Welcha: F( 2 , 47.50 ) = 0.59 , p = .560
               diff    lwr   upr p adj
dorywczo-nie  0.127 -0.196 0.451 0.620
etat-nie      0.162 -0.286 0.610 0.668
etat-dorywczo 0.035 -0.413 0.482 0.982
Bonferroni (p): 1.000 1.000 1.000
Interakcja praca × płeć: F( 2 , 114 ) = 3.53 , p = .033 ; częściowe eta² = .06
            M    K
nie      2.83 2.86
dorywczo 2.52 3.18
etat     2.68 3.42

            M  K
  nie      21 30
  dorywczo 16 35
  etat     10  8

9. Rzetelność skali stresu (6 pozycji, s5 odwrócona)
alfa Cronbacha = .79 ; średnia korelacja między pozycjami = .37
    r_skor alfa_bez
s1    0.62     0.73
s2    0.63     0.73
s3    0.58     0.74
s4    0.59     0.74
s5-   0.23     0.81
s6    0.56     0.75
omega całkowita = .79
Błąd – s5 bez odwrócenia: alfa = .70
Alfa dla 3 pozycji (s1–s3) = .75

10. Moderacja: czy wsparcie osłabia związek stresu z satysfakcją?
                   Estimate Std. Error t value Pr(>|t|)
(Intercept)          21.648      0.422  51.309    0.000
stres_c              -3.016      0.628  -4.804    0.000
wsparcie_c            1.573      0.420   3.750    0.000
stres_c:wsparcie_c    0.753      0.587   1.284    0.202
Przyrost R² po dodaniu interakcji = .009
Nachylenie stresu przy wsparciu −1 SD : b = -3.78 , SE = 0.92 , p < .001
Nachylenie stresu przy wsparciu +1 SD : b = -2.25 , SE = 0.81 , p = .006
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats oraz pakietu psych, który do obliczenia omegi korzysta z GPArotation); rysunki przygotowano w pakietach ggplot2, patchwork, svglite i magick. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- GPArotation (wersja 2025.3.1): Bernaards, C. A., & Jennrich, R. I. (2005). Gradient projection algorithms and software for arbitrary rotation criteria in factor analysis. Educational and Psychological Measurement, 65(5), 676–696. https://doi.org/10.1177/0013164404272507
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
- magick (wersja 2.9.1): Ooms, J. (2026). magick: Advanced graphics and image-processing in R [R package]. https://doi.org/10.32614/CRAN.package.magick
Najczęstsze pytania
Jakie pytania ze statystyki zadaje recenzent na obronie pracy magisterskiej?
Najczęściej o analizy opisane w pracy: dlaczego wybrano dany test (np. Welcha zamiast Studenta, Manna–Whitneya zamiast testu t), co znaczą podane liczby (b, β, R², iloraz szans, η², alfa) i czego wynik nie dowodzi. Dobrym źródłem pytań jest recenzja – przygotuj odpowiedź na każdą uwagę dotyczącą analizy.
Co powiedzieć komisji, gdy test Shapiro–Wilka w mojej pracy wyszedł istotny?
Że test normalności przy większej próbie wykrywa nawet drobne odchylenia, dlatego oceniałeś(-aś) też histogram i wykres Q-Q, a w regresji i ANOVA – rozkład reszt. Dodaj, jak wpłynęło to na wybór analizy, np. mediana i test Manna–Whitneya przy silnie skośnej zmiennej albo test t przy dużych grupach i niewielkim odchyleniu.
Jak w jednym zdaniu wyjaśnić na obronie iloraz szans?
Na przykład: „przy tym samym poziomie stresu szansa skorzystania z pomocy była u kobiet 3.26 raza większa niż u mężczyzn”. Pamiętaj, że szansa to stosunek prawdopodobieństwa zdarzenia do jego braku, więc OR nie oznacza „3 razy częściej”, gdy zdarzenie nie jest rzadkie – wtedy podaj też przewidywane prawdopodobieństwa.
Czy komisja może zapytać o test, którego nie użyłem w pracy?
Tak, zwykle w formie „dlaczego nie…?”: dlaczego nie test nieparametryczny, nie korelacja Spearmana, nie test Fishera. Przygotuj dla każdej analizy jedną alternatywę i jedno zdanie, dlaczego jej nie wybrałeś(-aś) albo że dała ten sam wniosek, jeśli sprawdzałeś(-aś) ją jako analizę wrażliwości.
Co odpowiedzieć na obronie, gdy wynik jest istotny, ale efekt mały?
Że istotność i wielkość efektu to różne informacje: p zależy od liczebności próby, a wielkość efektu (d, r, V, η²) mówi, jak duża jest różnica lub związek. Podaj efekt z przedziałem ufności i powiedz, co oznacza w jednostkach skali – to pokazuje, że rozumiesz praktyczne znaczenie wyniku.
Powiązane hasła
Przeczytaj też
Pytania na obronie z metodologii i statystyki
38 pytań komisji o hipotezy, schemat, próbę, narzędzia, analizy i wyniki – z przykładowymi odpowiedziami, ściągą na jedną stronę i planem przygotowania.
Czytaj →PoradnikPrezentacja wyników na obronie
Ile slajdów i liczb, wykres zamiast tabeli z SPSS, wynik nieistotny jako efekt z przedziałem ufności – z dwiema parami slajdów „źle / dobrze” zrobionych w R.
Czytaj →PoradnikZadania ze statystyki na psychologii
Dziesięć zadań jak na kolokwium: opisowe, steny i centyle, przedział ufności, testy t, korelacja, χ², ANOVA i regresja – z rozwiązaniami krok po kroku.
Czytaj →PoradnikPytania z metodologii na obronę
Pytania promotora, recenzenta i komisji ułożone według typu badania – od eksperymentu i sondażu po przegląd systematyczny – oraz pojęcia, o które pytają „z definicji”.
Czytaj →PoradnikPytania na egzamin ze statystyki
66 krótkich pytań z odpowiedziami w 9 działach – od skal pomiarowych i SD po wartość p, moc, wybór testu, regresję i pytania „wyjaśnij różnicę”.
Czytaj →Nie umiesz wyjaśnić, dlaczego w Twojej pracy jest właśnie ten test?
Przejdziemy z Tobą przez analizy i wydruki z Twojej pracy, sprawdzimy obliczenia w R lub SPSS i omówimy wyniki tak, żebyś umiał(a) samodzielnie odpowiedzieć na pytania promotora i recenzenta.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Davies, H. T. O., Crombie, I. K., & Tavakoli, M. (1998). When can odds ratios mislead? BMJ, 316(7136), 989–991. https://doi.org/10.1136/bmj.316.7136.989 ● Otwarty dostęp: pełny tekst
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Dunn, T. J., Baguley, T., & Brunsden, V. (2014). From alpha to omega: A practical solution to the pervasive problem of internal consistency estimation. British Journal of Psychology, 105(3), 399–412. https://doi.org/10.1111/bjop.12046 ● Otwarty dostęp: pełny tekst
- Hart, A. (2001). Mann-Whitney test is not just a test of medians: Differences in spread can be important. BMJ, 323(7309), 391–393. https://doi.org/10.1136/bmj.323.7309.391 ● Otwarty dostęp
- Kim, H.-Y. (2017). Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test. Restorative Dentistry & Endodontics, 42(2), 152–155. https://doi.org/10.5395/rde.2017.42.2.152 ● Otwarty dostęp
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Lumley, T., Diehr, P., Emerson, S., & Chen, L. (2002). The importance of the normality assumption in large public health data sets. Annual Review of Public Health, 23(1), 151–169. https://doi.org/10.1146/annurev.publhealth.23.100901.140546
Cytowania BibTeX
@article{davies1998when, author={Davies, Huw T. O. and Crombie, Iain K. and Tavakoli, Manouchehr}, title={{When can odds ratios mislead?}}, journal={BMJ}, year={1998}, volume={316}, number={7136}, pages={989--991}, doi={10.1136/bmj.316.7136.989}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{dunn2014alpha, author={Dunn, Thomas J. and Baguley, Thom and Brunsden, Vivienne}, title={{From alpha to omega: A practical solution to the pervasive problem of internal consistency estimation}}, journal={British Journal of Psychology}, year={2014}, volume={105}, number={3}, pages={399--412}, doi={10.1111/bjop.12046}}@article{hart2001mann, author={Hart, Anna}, title={{Mann-Whitney test is not just a test of medians: Differences in spread can be important}}, journal={BMJ}, year={2001}, volume={323}, number={7309}, pages={391--393}, doi={10.1136/bmj.323.7309.391}}@article{kim2017chi, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test}}, journal={Restorative Dentistry \& Endodontics}, year={2017}, volume={42}, number={2}, pages={152--155}, doi={10.5395/rde.2017.42.2.152}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{lumley2002importance, author={Lumley, Thomas and Diehr, Paula and Emerson, Scott and Chen, Lu}, title={{The importance of the normality assumption in large public health data sets}}, journal={Annual Review of Public Health}, year={2002}, volume={23}, number={1}, pages={151--169}, doi={10.1146/annurev.publhealth.23.100901.140546}}