Czego dotyczą pytania z metodologii i statystyki na obronie
Złożenie egzaminu dyplomowego jest jednym z warunków ukończenia studiów (art. 76 ust. 1 pkt 2 ustawy – Prawo o szkolnictwie wyższym i nauce, t.j. Dz.U. 2024 poz. 1571 z późn. zm.). Jego przebieg – liczbę pytań, ich zakres i to, czy padną pytania spoza pracy – określają regulamin studiów i zasady Twojego wydziału, dlatego sprawdź je najpierw. Pytania o część empiryczną sprawdzają zwykle jedno: czy rozumiesz decyzje opisane w pracy i umiesz je uzasadnić. Nie chodzi o recytowanie wzorów, tylko o odpowiedź na pytanie „dlaczego tak, a nie inaczej?”.
Najlepszym źródłem pytań jest Twoja praca i recenzje. Recenzje pracy dyplomowej są jawne (art. 76 ust. 5 tej ustawy), więc przeczytaj je przed obroną i do każdej uwagi przygotuj krótką odpowiedź. Zaznacz też w pracy miejsca, w których podjąłeś decyzję: wybór narzędzia, liczebność próby, test, wykluczenia osób, analizy dodatkowe.
Poniżej znajdziesz 38 pytań w dziewięciu grupach – od hipotez po pytania podchwytliwe – z przykładowymi odpowiedziami. Odpowiedzi opierają się na badaniu, które opisujemy w całej serii: 180 osób studiujących losowo przydzielono do grupy kontrolnej, czterotygodniowego treningu relaksacji albo treningu uważności, a stres mierzono przed treningiem i po nim (dane symulowane, obliczenia w R). Metodę tego badania pokazuje poradnik o rozdziale metodologicznym, wyniki – poradniki jak opisać wyniki w stylu APA i przykładowy rozdział wyników, a interpretację – poradnik o dyskusji wyników. Odpowiedzi to wzory, a nie teksty do wykucia: podstaw własne liczby i mów własnymi słowami.
Jak budować odpowiedź: decyzja, uzasadnienie, konsekwencja
Dobra odpowiedź na pytanie metodologiczne ma zwykle trzy części:
- Decyzja – co dokładnie zrobiono: nazwa testu, liczba, narzędzie.
- Uzasadnienie – dlaczego: pytanie badawcze, schemat, poziom pomiaru, literatura.
- Konsekwencja – co z tego wynika dla wniosków albo jakie ograniczenie się z tym wiąże.
Zacznij od bezpośredniej odpowiedzi, a uzasadnienie dodaj w jednym–dwóch zdaniach. Odpowiedź, która trwa 30–60 sekund, zwykle wystarcza; jeśli komisja chce więcej, dopyta. Tak może brzmieć odpowiedź na pytanie o wybór analizy:
Uzasadnienie: Zmienna zależna jest ilościowa (średnia z sześciu pozycji), grupy są niezależne, a analiza wariancji z testem post hoc chroni przed kumulowaniem się błędu I rodzaju przy trzech porównaniach.
Konsekwencja: Założenia sprawdzono (test Levene’a, rozkład reszt), a wnioski dotyczą średnich w grupach, a nie każdej osoby z osobna.
Pytania o problem badawczy i hipotezy
1. Jaki problem rozwiązuje ta praca i dlaczego warto go badać?
„Sprawdzam, czy czterotygodniowy trening uważności obniża stres akademicki osób studiujących w porównaniu z brakiem zajęć i z treningiem relaksacji. Nowym elementem jest porównanie z aktywną grupą kontrolną.” Znaczenie problemu uzasadniasz w części teoretycznej – na obronie wystarczy jedno zdanie z najważniejszym argumentem i źródłem, z którego pochodzi.
2. Skąd wzięły się hipotezy i dlaczego są kierunkowe?
„Hipotezy wyprowadzono z teorii i wcześniejszych badań opisanych w rozdziale [numer]: przewidywano niższy stres po treningu uważności niż bez treningu (H1) i niż po treningu relaksacji (H2). Kierunek ustalono przed zebraniem danych i zapisano w planie badania.” Dodaj, z jakiego mechanizmu teoretycznego wynika kierunek – to odróżnia hipotezę badawczą od zgadywania.
3. Jak brzmi hipoteza zerowa dla H1 i co znaczy jej odrzucenie?
„Według hipotezy zerowej średni stres po treningu jest w populacji taki sam w grupie uważności i w grupie kontrolnej. Odrzucenie jej przy α = .05 oznacza, że tak duża różnica byłaby mało prawdopodobna, gdyby hipoteza zerowa i założenia testu były prawdziwe.” Nie mów, że H1 jest prawdziwa „na 95%” – test tego nie mierzy.
4. Czy wszystkie hipotezy sformułowano przed zebraniem danych?
„Tak, H1–H3 zapisano w planie badania przed rekrutacją. Analizę warunku i płci dodano później, dlatego w wynikach opisano ją jako eksploracyjną.” Przedstawianie hipotezy wymyślonej po poznaniu wyników tak, jakby powstała wcześniej, to HARKing (Kerr, 1998), a standardy APA każą odróżniać analizy pierwszorzędowe, drugorzędowe i eksploracyjne (Appelbaum i in., 2018).
Pytania o schemat badania
5. Jaki schemat badania zastosowano i dlaczego?
„Schemat eksperymentalny z trzema grupami i dwoma pomiarami: osoby losowo przydzielono do kontroli, relaksacji albo uważności, a stres mierzono przed treningiem i po czterech tygodniach. Dzięki losowemu przydziałowi grupy różnią się na starcie tylko przypadkowo, więc różnicę po treningu można przypisać warunkowi – w granicach tego badania.”
6. Po co w badaniu dwie grupy porównawcze?
„Grupa bez zajęć pokazuje, co dzieje się ze stresem bez interwencji. Grupa relaksacji to aktywna grupa kontrolna: jej uczestnicy też chodzą na zajęcia i oczekują poprawy, więc pozwala oddzielić efekt uważności od efektu udziału w jakimkolwiek treningu.” Warto dodać liczby: przewaga uważności nad relaksacją była mniejsza niż nad brakiem zajęć (d = 0.47 wobec d = 0.79).
7. Dlaczego nie wystarczyło porównać stresu przed i po treningu w grupie uważności?
„W tej grupie stres spadł średnio o 0.75 punktu, t(59) = 11.80, p < .001, ale spadek mógł wynikać też z upływu czasu, ponownego wypełniania kwestionariusza albo regresji do średniej. W grupie kontrolnej stres również się obniżył, choć tylko o 0.17 punktu. Dlatego wnioski o skuteczności opieram na porównaniu z grupami kontrolnymi, a nie na samej zmianie przed–po.”
8. Czy na podstawie tego badania można napisać, że trening „obniża” stres?
„W części eksperymentalnej – tak, ostrożnie: losowy przydział pozwala na wniosek przyczynowy dla tej próby, tych warunków i stresu deklarowanego w kwestionariuszu. Związek wsparcia społecznego ze stresem (H3) badano jednak w schemacie korelacyjnym, na danych z jednego pomiaru, więc tam piszę o związku, a nie o wpływie.”
Pytania o próbę i dobór osób badanych
9. Na jakiej podstawie ustalono liczebność próby?
„Analizą mocy a priori dla jednoczynnikowej ANOVA z trzema grupami: dla efektu f = 0.25, α = .05 i mocy .80 potrzeba 53 osób w grupie, czyli 159 łącznie. Z zapasem na 10% rezygnacji zaplanowano po 60 osób (N = 180).” Analiza mocy to jeden z kilku uznanych sposobów uzasadniania liczebności (Lakens, 2022); przygotuj też jedno zdanie o tym, skąd wzięła się zakładana wielkość efektu.
10. Na kogo można uogólnić wyniki?
„Próba nie jest reprezentatywna – to dobór wygodny: zgłaszały się osoby studiujące jednej uczelni, zainteresowane treningiem. Wyniki z takiej próby można odnosić tylko do (sub)populacji, z której pochodzi (Andrade, 2021), czyli do osób studiujących, które same zgłaszają się na podobne zajęcia. W całej populacji osób studiujących efekt może być mniejszy.” Więcej o tym, kiedy wymaga się reprezentatywności próby, piszemy w słowniku.
11. Czy przewaga kobiet w próbie wpływa na wyniki?
„Kobiety stanowiły 61.7% próby, a w grupie uważności było tylko 21 mężczyzn, co ogranicza uogólnianie na mężczyzn. Proporcje płci w grupach były jednak podobne (37, 35 i 39 kobiet), więc płeć nie zakłóca porównania warunków. Wynik dotyczący płci traktuję jako eksploracyjny.”
12. Kogo wykluczono z badania i dlaczego?
„Kryteria ustalono przed badaniem: włączano osoby studiujące stacjonarnie, a wykluczano te, które w ostatnim roku uczestniczyły w treningu uważności lub relaksacji. Z analiz wykluczano też osoby, które błędnie odpowiedziały na pytania kontrolne. Reguły zapisano wcześniej, żeby decyzja o usunięciu osoby nie zależała od wyniku.”
Pytania o narzędzia i rzetelność
13. Skąd wiadomo, że skala stresu jest rzetelna?
„Rzetelność oszacowano w mojej próbie, a nie tylko przepisano z podręcznika: α = .85 i ω = .86 w pomiarze przed treningiem. Podaję także omegę McDonalda, bo alfa Cronbacha opiera się na założeniach, które rzadko są spełnione, i zwykle zaniża rzetelność (McNeish, 2018).”
14. Skąd wiadomo, że skala mierzy właśnie stres, a nie coś innego?
„To pytanie o trafność, a nie o rzetelność: wysoka alfa mówi tylko, że pozycje są ze sobą spójne. Dowody trafności pochodzą z badań nad polską adaptacją skali [autorzy, rok]. W mojej próbie stres był ujemnie skorelowany ze wsparciem społecznym, r(178) = −.38, co jest zgodne z teorią, ale samo w sobie trafności nie dowodzi.”
15. Dlaczego jakość snu mierzono jednym pytaniem i co z tego wynika?
„Jedno pytanie skraca ankietę, ale jego rzetelności nie da się oszacować, a skala od 1 do 5 słabo różnicuje osoby. Odpowiedzi potraktowano jako porządkowe i porównano testem Kruskala–Wallisa, H(2) = 11.14, p = .004. Wynik dotyczący snu jest przez to mniej pewny niż wynik dotyczący stresu.”
16. Dlaczego wynik skali stresu potraktowano jako zmienną ilościową?
„Pojedyncza odpowiedź na skali Likerta jest porządkowa, ale wynik skali to średnia z sześciu pozycji o dobrej spójności wewnętrznej, która przyjmuje wiele wartości. Metody parametryczne, takie jak ANOVA i regresja, są przy takich danych odporne na naruszenia założeń (Norman, 2010).”
Pytania o wybór analiz statystycznych
17. Dlaczego ANOVA, a nie trzy testy t?
„Trzy osobne testy t, każdy przy α = .05, zwiększają ryzyko, że któryś wynik okaże się fałszywie istotny. Analiza wariancji sprawdza najpierw, czy grupy w ogóle się różnią, F(2, 177) = 10.09, p < .001, a test post hoc Tukeya porównuje pary grup z kontrolą błędu dla całej rodziny porównań.”
18. Jak sprawdzono założenia analizy wariancji?
„Jednorodność wariancji oceniono testem Levene’a i nie było podstaw, by ją odrzucić, F(2, 177) = 0.64, p = .527. Rozkład reszt nie odbiegał istotnie od normalnego, W = 0.99, p = .148, a grupy były równoliczne. Gdyby wariancje wyraźnie się różniły, plan przewidywał wersję Welcha.” Delacre i in. (2017) zalecają test Welcha jako domyślny przy porównaniu dwóch grup – warto to wiedzieć, gdy padnie pytanie o test t.
19. Dlaczego w analizie nie uwzględniono pomiaru wyjściowego?
„Przy losowym przydziale porównanie wyników po treningu jest poprawne, dlatego plan zakładał ANOVA. Analiza kowariancji z pomiarem wyjściowym daje jednak bardziej precyzyjne oszacowania, zwłaszcza gdy grupy różnią się na starcie (Egbewale i in., 2014) – a u mnie średnie przed treningiem wynosiły od 3.04 do 3.25. Jako analiza wrażliwości pokazuje ten sam obraz, F(2, 176) = 32.98, p < .001: uważność różni się od obu grup, relaksacja od kontroli – nie.” Takie pytanie warto przewidzieć i mieć analizę policzoną zawczasu.
20. Dlaczego efekt pośredni sprawdzono bootstrapem?
„Efekt pośredni to iloczyn dwóch współczynników (a × b), którego rozkład zwykle nie jest normalny, więc przedział ufności oszacowano bootstrapem z 5000 prób. Efekt pośredni wyniósł ab = −0.151, 95% CI [−0.218, −0.093], a przedział nie obejmuje zera. Test Sobela zakłada normalność tego iloczynu, dlatego go nie stosowano.”
21. Dlaczego testy dwustronne, skoro hipotezy są kierunkowe?
„Test jednostronny jest uprawniony, gdy kierunek ustalono przed zebraniem danych, a wynik w przeciwną stronę nie miałby znaczenia. W planie przyjęto testy dwustronne, bo wynik przeciwny – wyższy stres po treningu – też byłby ważną informacją. Takiej decyzji nie zmienia się po poznaniu wyników.”
Pytania o interpretację wyników
22. Co oznacza p < .001 w analizie wariancji?
„Że tak duże różnice między średnimi (albo większe) byłyby bardzo mało prawdopodobne, gdyby w populacji średnie były równe, a założenia modelu – spełnione.” Dodaj, czego wartość p nie mówi: nie jest prawdopodobieństwem, że hipoteza zerowa jest prawdziwa (Greenland i in., 2016), i nie informuje, jak duży jest efekt.
23. Co mówi η² = .10 o sile efektu treningu?
„Warunek wyjaśnia około 10% zmienności stresu po treningu w tej próbie; pozostała zmienność to różnice indywidualne i inne czynniki. η² z próby nieco przeszacowuje efekt w populacji, dlatego część autorów podaje też ω².”
24. Co mówi przedział ufności dla różnicy między uważnością a kontrolą?
„Różnica średnich wyniosła −0.72 punktu, 95% CI [−1.10, −0.34]: dane są zgodne z różnicą od około jednej trzeciej punktu do ponad jednego punktu na skali 1–5, a przedział nie obejmuje zera.” Jeśli komisja dopyta o „95%”: dotyczy ono procedury, a nie tego konkretnego przedziału – tak liczone przedziały obejmowałyby prawdziwą wartość w 95% powtórzeń badania, o ile spełnione są założenia modelu (Greenland i in., 2016). Więcej w haśle przedział ufności.
25. Relaksacja nie różniła się istotnie od kontroli – czy to znaczy, że nie działa?
„Nie. Różnica wyniosła −0.32 punktu, 95% CI [−0.70, 0.05], p = .109: przedział obejmuje zarówno brak różnicy, jak i różnicę podobną do przewagi uważności nad relaksacją. Brak efektu można by wykazać testem równoważności z ustaloną z góry najmniejszą interesującą wielkością efektu (Lakens i in., 2018).” Jak opisywać takie wyniki, pokazujemy w poradniku hipoteza się nie potwierdziła.
26. Czy d = 0.79 to dużo?
„To efekt bliski umownego progu dużego efektu (0.8), ale ważniejsze jest znaczenie praktyczne: różnica 0.72 punktu na skali 1–5. Przedział ufności dla d jest szeroki – od 0.42 do 1.16 – więc prawdziwy efekt może być zarówno umiarkowany, jak i bardzo duży.” Progi Cohena omawiamy w haśle d Cohena – interpretacja.
Pytania o ograniczenia i uogólnianie
27. Jakie jest najważniejsze ograniczenie badania?
„Stres mierzono wyłącznie samoopisem, a uczestnicy wiedzieli, w jakim treningu biorą udział, więc część różnicy mogła wynikać z ich oczekiwań. Problem zmniejsza aktywna grupa kontrolna, ale go nie usuwa; kolejne badanie powinno dodać wskaźnik niezależny od samoopisu.” Wybierz jedno ograniczenie, które naprawdę zmienia interpretację, i powiedz, w którą stronę mogło przesunąć wynik.
28. Czy wynik dotyczący płci można uznać za odkrycie?
„Nie. Interakcja warunku i płci była istotna, F(2, 174) = 3.66, p = .028, η²p = .04, ale tej analizy nie planowano, a w grupie uważności było tylko 21 mężczyzn. To hipoteza do sprawdzenia w badaniu zaplanowanym z myślą o porównaniu płci, a nie wniosek.”
29. Czy efekt treningu się utrzyma?
„Tego badanie nie rozstrzyga: stres zmierzono tylko bezpośrednio po czterech tygodniach zajęć. Wnioski dotyczą efektu krótkoterminowego, a trwałość wymaga pomiaru odroczonego, na przykład po kilku miesiącach albo w czasie sesji.”
30. Co należałoby zmienić, gdyby badanie można było powtórzyć?
„Dodać pomiar odroczony, wskaźnik stresu niezależny od samoopisu i więcej mężczyzn, a plan analiz zarejestrować publicznie przed zebraniem danych (prerejestracja).” Taka odpowiedź pokazuje, że rozumiesz ograniczenia, i nie przekreśla badania – mów o ulepszeniach, a nie o porażce.
Pytania o etykę badania
31. Jak chroniono dane uczestników, skoro dwa pomiary trzeba było połączyć?
„Badanie było poufne, a nie anonimowe: każda osoba podawała kod, który pozwalał połączyć pomiar przed i po treningu. Lista kodów była przechowywana oddzielnie od odpowiedzi i została usunięta po zakończeniu zbierania danych, a uczestnicy wiedzieli, jak dane będą przetwarzane.” Podstawy opisujemy w haśle świadoma zgoda i RODO w badaniach.
32. Czy grupa kontrolna nie została pokrzywdzona brakiem treningu?
„Uczestnicy przed wyrażeniem zgody wiedzieli, że mogą trafić do grupy bez zajęć, i mogli się w każdej chwili wycofać. Badanie trwało cztery tygodnie, a brak treningu oznaczał po prostu zwykły tok studiów.” Częstym rozwiązaniem jest lista oczekujących: grupa kontrolna dostaje trening po zakończeniu pomiarów – jeśli tak było w Twoim badaniu, powiedz to wprost.
33. Czy analizy wykonano samodzielnie?
„Analizy wykonano w R według planu uzgodnionego z promotorem; z konsultacji statystycznej skorzystano przy [zakres], co opisano w podziękowaniach i w rozdziale metodologicznym. Mogę przejść przez każdy krok i odtworzyć główny wynik.” Odpowiadaj zgodnie z prawdą i tak, jak opisano to w pracy. Gdzie kończy się dopuszczalna pomoc i jak ją ujawnić, wyjaśniamy we wpisie czy można zlecić analizę statystyczną, a wzory deklaracji użycia AI – w poradniku jak opisać użycie AI w pracy dyplomowej.
Pytania podchwytliwe
34. Czy p = .039 to mocny dowód przewagi uważności nad relaksacją?
„Niezbyt mocny. To wynik z jednego badania, blisko progu istotności, a przedział ufności dla różnicy, [−0.77, −0.02], sięga niemal zera. Traktuję go jako argument za H2, który warto powtórzyć, a nie jako rozstrzygnięcie – dlatego podaję też wielkość efektu, d = 0.47.”
35. Przy dwóch tysiącach osób każda różnica byłaby istotna – po co więc wartość p?
„W dużej próbie nawet bardzo mały efekt może dać wynik istotny statystycznie (Greenland i in., 2016). Dlatego wartość p traktuję tylko jako informację o zgodności danych z brakiem różnicy, a o znaczeniu wyniku wnioskuję z wielkości efektu i przedziału ufności – w moim badaniu z różnicy 0.72 punktu na skali 1–5.”
36. Ile wynosiła moc testu w tym badaniu?
„Moc to cecha planu badania, a nie wyniku: moc policzona z uzyskanego efektu jest tylko przekształceniem wartości p (Greenland i in., 2016). Mogę podać analizę wrażliwości: przy 60 osobach w grupie porównanie dwóch grup miało 80% mocy dla d = 0.52, a ANOVA – dla f = 0.23 (α = .05).”
37. Czy samoskuteczność jest mechanizmem, przez który wsparcie obniża stres?
„Wyniki są zgodne z takim modelem, ale go nie dowodzą: efekt pośredni (ab = −0.151) policzono na danych z jednego pomiaru, w którym wszystkie zmienne mierzono jednocześnie. Standardowe analizy mediacji prowadzą do trafnych wniosków przyczynowych tylko w ograniczonych warunkach (Rohrer i in., 2022), a dane pasują też do innych układów zależności.”
38. Dlaczego nie usunięto osób z nietypowymi wynikami, żeby różnice były wyraźniejsze?
„Bo decyzja o usunięciu obserwacji nie może zależeć od tego, czy wynik się poprawi. Reguły wykluczeń zapisano przed analizą, a elastyczność w doborze osób i analiz po fakcie zwiększa liczbę wyników fałszywie pozytywnych (Simmons i in., 2011).” Jeśli komisja pyta o wpływ wartości odstających, najlepszą odpowiedzią jest analiza wrażliwości: wynik z nimi i bez nich. Dobieranie analiz pod oczekiwany wynik to p-hacking.
Ściąga na jedną stronę: liczby i decyzje Twojego badania
Pod presją najłatwiej pomylić liczby i nazwy analiz. Zbierz na jednej stronie wszystko, o co komisja może zapytać: pytanie i hipotezy, schemat, próbę, narzędzia, analizy, najważniejsze wyniki i ograniczenia. Sprawdź w zasadach wydziału, czy na egzaminie wolno korzystać z notatek – nawet jeśli nie, samo przygotowanie ściągi porządkuje wiedzę, a jej powtarzanie z pamięci jest dobrym ćwiczeniem. Wzór do uzupełnienia:
SCHEMAT: [typ schematu, grupy lub zmienne, liczba pomiarów, sposób przydziału]
PRÓBA: N = […] ([struktura płci]), wiek […]; dobór […]; uzasadnienie liczebności: […]
NARZĘDZIA: [skala] – [liczba pozycji, zakres, pozycje odwrócone]; α = […], ω = […]
ANALIZY: H1: […]; H2: […]; H3: […]; założenia: […]; program i wersja: […]
WYNIKI: H1: [statystyka, p, wielkość efektu, 95% CI]; H2: […]; H3: […]; analizy eksploracyjne: […]
CZUŁOŚĆ BADANIA: 80% mocy dla efektu […]
OGRANICZENIA (trzy najważniejsze): […]
CO DALEJ: [jedno konkretne badanie]
Tak wygląda ściąga wypełniona liczbami z przykładowego badania (wszystkie wartości pochodzą z tych samych obliczeń w R co w pozostałych wpisach serii):
SCHEMAT: eksperyment, 3 grupy × 2 pomiary (przed i po 4 tygodniach), losowy przydział.
PRÓBA: N = 180 (po 60 w grupie); 111 kobiet (61.7%), 69 mężczyzn; wiek 19–26 lat (M = 21.49, SD = 1.60); dobór wygodny; analiza mocy: f = 0.25, α = .05, moc .80 → 159 osób + 10% zapasu.
NARZĘDZIA: skala stresu, 6 pozycji (1–5), pozycje 4 i 5 odwrócone; α = .85, ω = .86; jakość snu – jedno pytanie (1–5).
ANALIZY: H1–H2: ANOVA + test Tukeya (Levene: p = .527); H3: mediacja, bootstrap 5000 prób; sen: test Kruskala–Wallisa; R 4.5.3.
WYNIKI: ANOVA F(2, 177) = 10.09, p < .001, η² = .10; uważność a kontrola: −0.72, 95% CI [−1.10, −0.34], d = 0.79; uważność a relaksacja: −0.39, 95% CI [−0.77, −0.02], p = .039, d = 0.47; relaksacja a kontrola: p = .109 (wynik nierozstrzygnięty); H3: ab = −0.151, 95% CI [−0.218, −0.093]; eksploracyjnie: warunek × płeć, p = .028.
CZUŁOŚĆ BADANIA: 80% mocy dla d = 0.52 (dwie grupy po 60 osób).
OGRANICZENIA: samoopis i uczestnicy znający swój warunek; dobór wygodny; brak pomiaru odroczonego.
CO DALEJ: pomiar po kilku miesiącach, wskaźnik niezależny od samoopisu, badanie zaplanowane pod kątem płci.
Jak ćwiczyć odpowiedzi przed obroną
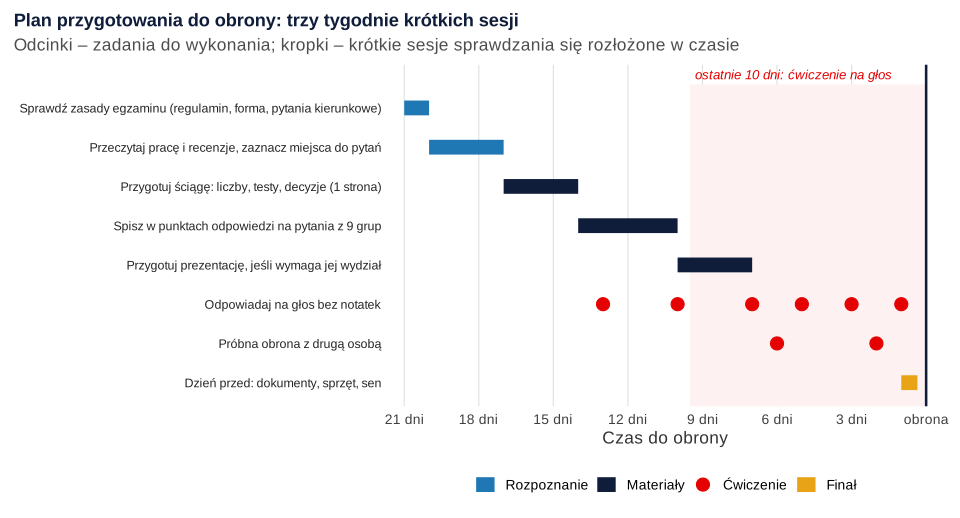
Ponowne czytanie pracy wydaje się najprostszym sposobem przygotowania, ale słabo uczy odpowiadania. W przeglądzie dziesięciu technik uczenia się najwyżej oceniono testowanie się i rozkładanie nauki w czasie, a ponowne czytanie i podkreślanie – nisko (Dunlosky i in., 2013). W praktyce oznacza to krótkie sesje, w których odpowiadasz z pamięci, a dopiero potem sprawdzasz w pracy, co pominąłeś:
- Wybierz pytania. Z każdej grupy weź dwa–trzy pytania najbliższe Twojej pracy i dopisz pytania wynikające z recenzji.
- Odpowiadaj na głos, bez notatek. Mierz czas: 30–60 sekund na odpowiedź według schematu decyzja – uzasadnienie – konsekwencja.
- Sprawdź i popraw. Porównaj odpowiedź z pracą i ściągą; zapisz, czego zabrakło.
- Wracaj co dwa–trzy dni do pytań, które sprawiły kłopot, zamiast powtarzać wszystkie naraz.
- Zrób próbną obronę. Poproś drugą osobę, żeby zadawała pytania w losowej kolejności i dopytywała; nagraj się i odsłuchaj, gdzie odpowiedź się rozmywa.
Rysunek 1 rozkłada to przygotowanie na trzy tygodnie.
Jeśli po próbnej obronie nadal nie potrafisz wyjaśnić, skąd wziął się któryś wynik, wróć do analizy, zanim usiądziesz przed komisją. Przy liczbach z wydruku pomoże poradnik jak czytać wyniki z SPSS, a jeśli wolisz omówić analizy i wyniki z kimś, kto zada Ci pytania jak komisja, zobacz konsultacje dla studentów – ich celem jest to, żebyś rozumiał własne wyniki.
Co robić, gdy nie znasz odpowiedzi
Każdemu zdarza się pytanie, na które nie ma gotowej odpowiedzi. Komisja ocenia wtedy przede wszystkim sposób myślenia, dlatego:
- Poproś o doprecyzowanie. „Czy chodzi o…?” daje chwilę do namysłu i często zawęża pytanie.
- Zacznij od tego, co wiesz na pewno, i połącz to z pytaniem: jaki test wykonano, na jakich danych i dlaczego.
- Nie zgaduj liczb i nie opisuj analiz, których nie było. Jeśli możesz, wskaż tabelę w pracy.
- Odróżnij „nie wiem” od „tego nie sprawdzano”. W drugim przypadku powiedz, jak można by to sprawdzić i czego się spodziewasz – zaznaczając, że to przypuszczenie.
- Przyjmij trafną uwagę rzeczowo. Zgódź się z nią i powiedz, co z niej wynika dla wniosków; nie broń za wszelką cenę każdego zdania pracy.
Tego w badaniu nie sprawdzano. Można by to zrobić za pomocą [analiza lub projekt badania]; można przypuszczać, że [kierunek], ale to hipoteza, a nie wynik.
Dokładnej wartości nie pamiętam – jest w Tabeli [numer]. Z pamięci: efekt był [kierunek i przybliżona wielkość].
To trafna uwaga. Oznacza, że wynik [który] należy interpretować ostrożniej, ponieważ […].
Wybrano [metoda], ponieważ [powód]. Alternatywą była [metoda], która [zaleta], ale [dlaczego jej nie wybrano].
Lista kontrolna przed obroną
- Znasz zasady egzaminu: liczbę i zakres pytań, formę (stacjonarnie czy zdalnie) i to, czy potrzebna jest prezentacja.
- Przeczytałeś recenzje i do każdej uwagi masz jedno–dwa zdania odpowiedzi.
- Umiesz w trzech zdaniach powiedzieć, czego dotyczy badanie i co wyszło.
- Dla każdej hipotezy znasz test, statystykę, wartość p, wielkość efektu i przedział ufności.
- Umiesz uzasadnić liczebność próby i powiedzieć, jaki efekt badanie mogło wykryć.
- Znasz rzetelność narzędzi w swojej próbie i wiesz, skąd są dowody ich trafności.
- Rozróżniasz analizy zaplanowane i eksploracyjne oraz wiesz, które wnioski są przyczynowe, a które nie.
- Masz przygotowane trzy najważniejsze ograniczenia i jedno konkretne badanie na przyszłość.
- Wiesz, jak w pracy opisano pomoc przy analizie, jeśli z niej korzystałeś.
- Masz jednostronicową ściągę i co najmniej jedną próbną obronę za sobą.
Jeśli do obrony zostało jeszcze trochę czasu, przejrzyj całą serię jeszcze raz: plan analizy danych, wyniki i dyskusję. Sprawdź zwłaszcza, czy hipotezy, analizy i wnioski są w nich opisane spójnie – niespójność między rozdziałami łatwo zauważyć i łatwo o nią zapytać.
Najczęstsze pytania
O co z metodologii i statystyki pytają na obronie pracy dyplomowej?
Pytania o część empiryczną dotyczą zwykle decyzji opisanych w pracy: skąd wzięły się hipotezy, jaki był schemat badania, dlaczego zbadano tyle osób, czy narzędzia były rzetelne, dlaczego wybrano dane testy i co znaczą wyniki – wartość p, wielkość efektu i przedział ufności. Często padają też pytania o ograniczenia badania i o to, co można by zrobić inaczej. Liczbę i zakres pytań określa regulamin studiów i zasady wydziału.
Co powiedzieć na obronie, gdy nie znam odpowiedzi na pytanie?
Nie zgaduj i nie wymyślaj liczb. Poproś o doprecyzowanie pytania, powiedz, co wiesz na pewno (np. jaki test wykonano i dlaczego), a jeśli czegoś nie sprawdzano – jak można by to sprawdzić. Rzeczowe „tego nie analizowano, ale…” jest lepsze niż pewna siebie, błędna odpowiedź.
Czy recenzja pracy dyplomowej jest jawna przed obroną?
Tak. Ustawa – Prawo o szkolnictwie wyższym i nauce stanowi, że recenzje pracy dyplomowej są jawne (art. 76 ust. 5), z wyjątkiem prac, których przedmiot jest objęty tajemnicą prawnie chronioną. Kiedy i jak możesz je przeczytać, określają zasady uczelni. Przeczytaj recenzje przed obroną i do każdej uwagi przygotuj krótką odpowiedź.
Czy obrona pracy magisterskiej może odbyć się zdalnie?
Ustawa dopuszcza przeprowadzenie egzaminu dyplomowego poza siedzibą uczelni przy użyciu środków komunikacji elektronicznej, które zapewniają transmisję i wielostronną komunikację w czasie rzeczywistym (art. 76a ust. 2 ustawy – Prawo o szkolnictwie wyższym i nauce). Zasady takiego egzaminu uczelnia udostępnia w Biuletynie Informacji Publicznej (art. 76a ust. 3), a to, czy z tej możliwości korzysta, zależy od niej.
Ile czasu potrzeba na przygotowanie się do obrony pracy?
Zaplanuj około trzech tygodni krótkich sesji zamiast jednej długiej nocy. Najlepiej działa sprawdzanie się i rozkładanie nauki w czasie (Dunlosky i in., 2013): odpowiadaj na głos na pytania z każdej grupy, wracaj do trudnych co dwa–trzy dni i zrób co najmniej jedną próbną obronę z drugą osobą.
Czy na obronie trzeba znać wzory statystyczne?
Zwykle nie trzeba ich wyprowadzać, ale trzeba rozumieć statystyki, które podajesz w pracy: co oznacza wartość p, przedział ufności i wielkość efektu, jakie założenia ma zastosowany test i co by się zmieniło, gdyby nie były spełnione. Jeśli promotor zapowiada inne wymagania, przygotuj się według nich.
Powiązane hasła
Przeczytaj też
Wyniki badań własnych – przykładowy rozdział
Cały rozdział wyników jednego badania – od przygotowania danych po tabelę hipotez – z komentarzem, tabelami APA, rysunkami i wzorem w Wordzie.
Czytaj →PoradnikJak napisać dyskusję wyników – wzory zdań
Osiem elementów dyskusji z gotowymi zdaniami: interpretacja, wyniki nieistotne, konkretne ograniczenia, granice uogólniania, implikacje i wnioski.
Czytaj →PoradnikCzy można zlecić analizę statystyczną do pracy dyplomowej?
Przepisy o samodzielności pracy, granice pomocy statystyka, wzory ujawnienia w pracy, rozmowa z promotorem i czerwone flagi nieuczciwych ofert.
Czytaj →Obrona za pasem, a wyniki wciąż budzą wątpliwości?
Omówimy z Tobą analizy i wyniki Twojej pracy tak, aby każda decyzja była dla Ciebie jasna i łatwa do wyjaśnienia komisji.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Andrade, C. (2021). The inconvenient truth about convenience and purposive samples. Indian Journal of Psychological Medicine, 43(1), 86–88. https://doi.org/10.1177/0253717620977000 ● Otwarty dostęp
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191 ● Otwarty dostęp
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Dunlosky, J., Rawson, K. A., Marsh, E. J., Nathan, M. J., & Willingham, D. T. (2013). Improving students’ learning with effective learning techniques: Promising directions from cognitive and educational psychology. Psychological Science in the Public Interest, 14(1), 4–58. https://doi.org/10.1177/1529100612453266
- Egbewale, B. E., Lewis, M., & Sim, J. (2014). Bias, precision and statistical power of analysis of covariance in the analysis of randomized trials with baseline imbalance: A simulation study. BMC Medical Research Methodology, 14(1), Article 49. https://doi.org/10.1186/1471-2288-14-49 ● Otwarty dostęp
- Greenland, S., Senn, S. J., Rothman, K. J., Carlin, J. B., Poole, C., Goodman, S. N., & Altman, D. G. (2016). Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations. European Journal of Epidemiology, 31(4), 337–350. https://doi.org/10.1007/s10654-016-0149-3 ● Otwarty dostęp
- Kerr, N. L. (1998). HARKing: Hypothesizing after the results are known. Personality and Social Psychology Review, 2(3), 196–217. https://doi.org/10.1207/s15327957pspr0203_4
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- Lakens, D., Scheel, A. M., & Isager, P. M. (2018). Equivalence testing for psychological research: A tutorial. Advances in Methods and Practices in Psychological Science, 1(2), 259–269. https://doi.org/10.1177/2515245918770963 ● Otwarty dostęp
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
- Norman, G. (2010). Likert scales, levels of measurement and the “laws” of statistics. Advances in Health Sciences Education, 15(5), 625–632. https://doi.org/10.1007/s10459-010-9222-y
- Rohrer, J. M., Hünermund, P., Arslan, R. C., & Elson, M. (2022). That’s a lot to process! Pitfalls of popular path models. Advances in Methods and Practices in Psychological Science, 5(2), Article 25152459221095827. https://doi.org/10.1177/25152459221095827 ● Otwarty dostęp
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- Ustawa z dnia 20 lipca 2018 r. – Prawo o szkolnictwie wyższym i nauce. (2018). Tekst jednolity (Dz.U. 2024 poz. 1571 z późn. zm.). Internetowy System Aktów Prawnych. https://isap.sejm.gov.pl/isap.nsf/DocDetails.xsp?id=WDU20180001668 ● Otwarty dostęp
Cytowania BibTeX
@article{andrade2021inconvenient, author={Andrade, Chittaranjan}, title={{The inconvenient truth about convenience and purposive samples}}, journal={Indian Journal of Psychological Medicine}, year={2021}, volume={43}, number={1}, pages={86--88}, doi={10.1177/0253717620977000}}@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={{Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{dunlosky2013improving, author={Dunlosky, John and Rawson, Katherine A. and Marsh, Elizabeth J. and Nathan, Mitchell J. and Willingham, Daniel T.}, title={{Improving students’ learning with effective learning techniques: Promising directions from cognitive and educational psychology}}, journal={Psychological Science in the Public Interest}, year={2013}, volume={14}, number={1}, pages={4--58}, doi={10.1177/1529100612453266}}@article{egbewale2014bias, author={Egbewale, Bolaji E. and Lewis, Martyn and Sim, Julius}, title={{Bias, precision and statistical power of analysis of covariance in the analysis of randomized trials with baseline imbalance: A simulation study}}, journal={BMC Medical Research Methodology}, year={2014}, volume={14}, number={1}, eid={49}, doi={10.1186/1471-2288-14-49}}@article{greenland2016statistical, author={Greenland, Sander and Senn, Stephen J. and Rothman, Kenneth J. and Carlin, John B. and Poole, Charles and Goodman, Steven N. and Altman, Douglas G.}, title={{Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations}}, journal={European Journal of Epidemiology}, year={2016}, volume={31}, number={4}, pages={337--350}, doi={10.1007/s10654-016-0149-3}}@article{kerr1998harking, author={Kerr, Norbert L.}, title={{HARKing: Hypothesizing after the results are known}}, journal={Personality and Social Psychology Review}, year={1998}, volume={2}, number={3}, pages={196--217}, doi={10.1207/s15327957pspr0203_4}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@article{lakens2018equivalence, author={Lakens, Daniël and Scheel, Anne M. and Isager, Peder M.}, title={{Equivalence testing for psychological research: A tutorial}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={2}, pages={259--269}, doi={10.1177/2515245918770963}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}@article{norman2010likert, author={Norman, Geoff}, title={{Likert scales, levels of measurement and the “laws” of statistics}}, journal={Advances in Health Sciences Education}, year={2010}, volume={15}, number={5}, pages={625--632}, doi={10.1007/s10459-010-9222-y}}@article{rohrer2022process, author={Rohrer, Julia M. and Hünermund, Paul and Arslan, Ruben C. and Elson, Malte}, title={{That’s a lot to process! Pitfalls of popular path models}}, journal={Advances in Methods and Practices in Psychological Science}, year={2022}, volume={5}, number={2}, eid={25152459221095827}, doi={10.1177/25152459221095827}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}@misc{pswn2018ustawa, author={{Ustawa z dnia 20 lipca 2018 r. – Prawo o szkolnictwie wyższym i nauce}}, title={{Tekst jednolity (Dz.U. 2024 poz. 1571 z późn. zm.)}}, howpublished={Internetowy System Aktów Prawnych}, year={2018}, publisher={Kancelaria Sejmu RP}, url={https://isap.sejm.gov.pl/isap.nsf/DocDetails.xsp?id=WDU20180001668}}