Pytania z metodologii badań naukowych na obronę – znajdź typ swojego badania
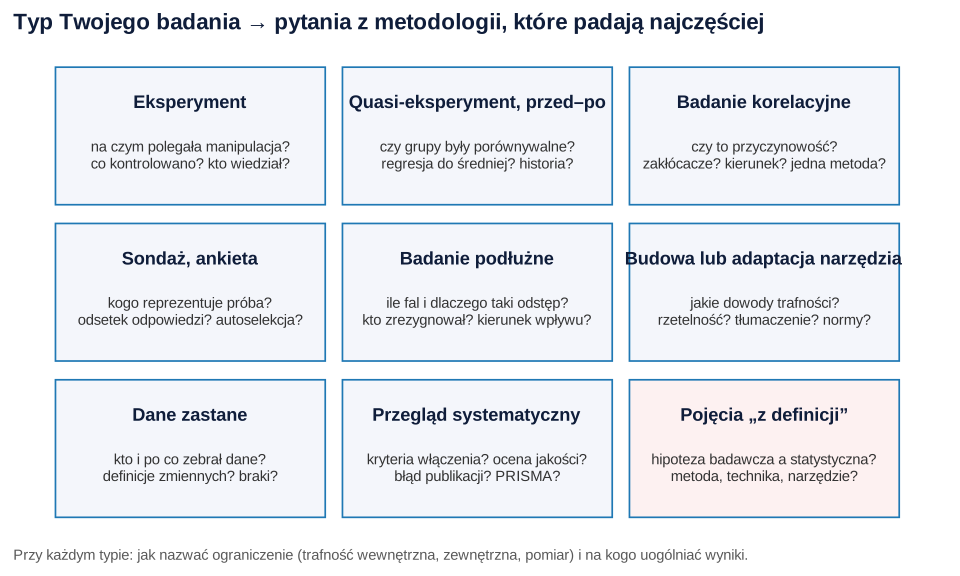
Ta lista zbiera pytania z metodologii badań naukowych na obronę ułożone według typu badania, które przeprowadziłeś(-aś): eksperymentu, badania przed–po, badania korelacyjnego, sondażu, badania podłużnego, budowy narzędzia, analizy danych zastanych albo przeglądu systematycznego. Na końcu są pojęcia, o które komisja pyta „z definicji”. Pytania ogólne o hipotezy, próbę i etykę oraz przykładową obronę krok po kroku znajdziesz w tekście pytania na obronie z metodologii i statystyki, a pytania o konkretne analizy (test t, chi-kwadrat, regresja, alfa Cronbacha) – w zestawieniu pytania ze statystyki na obronę pracy magisterskiej. Tutaj ich nie powtarzamy.
| Moja praca to… | Przejdź do sekcji |
|---|---|
| eksperyment, badanie interwencyjne z losowym przydziałem | 1. Eksperyment |
| porównanie grup bez losowania, pomiar przed i po programie | 2. Quasi-eksperyment i przed–po |
| związki między zmiennymi z jednego pomiaru | 3. Badanie korelacyjne |
| ankieta w internecie lub w instytucji | 4. Badanie sondażowe |
| kilka pomiarów tych samych osób w czasie | 5. Badanie podłużne |
| nowa skala albo polska wersja kwestionariusza | 6. Budowa lub adaptacja narzędzia |
| dokumentacja medyczna, dane GUS, ESS, rejestry | 7. Dane zastane |
| praca przeglądowa | 8. Przegląd systematyczny |
| każdy typ – pytania „z definicji” i o ograniczenia | 9. Pojęcia i 10. Ograniczenia |
Każde pytanie ma wzorcową odpowiedź na 2–5 zdań, osadzoną w krótkim przykładzie pracy z psychologii, pielęgniarstwa, pedagogiki, zarządzania albo fizjoterapii. Podstaw własne decyzje i mów własnymi słowami. Przy części sekcji jest pułapka – zdanie, które brzmi naturalnie, ale recenzent łatwo je podważy. Liczby w odpowiedziach pochodzą z symulacji w R pokazanych na końcu wpisu: dane są wymyślone, ale dzięki temu wiemy, jaka jest prawda, i widać, jak bardzo plan badania może ją przesłonić.
1. Eksperyment i badanie interwencyjne – pytania z metodologii na obronę
Pytania o wybór schematu eksperymentalnego, o aktywną grupę kontrolną i o to, czy wolno napisać „obniża”, omawia sekcja o schemacie badania w tekście ogólnym. Tutaj – pytania o to, jak eksperyment przeprowadzono.
Na czym dokładnie polegała manipulacja i skąd wiesz, że się udała?
„W pracy z psychologii jedna grupa oglądała smutny fragment filmu, a druga – neutralny, i to był poziom zmiennej niezależnej. Zaraz po filmie osoby oceniały swój nastrój na krótkiej skali; to sprawdzenie manipulacji pokazało, że grupa ze smutnym filmem oceniała nastrój niżej. Bez takiego sprawdzenia brak różnic w zmiennej zależnej mógłby oznaczać zarówno brak efektu, jak i nieudaną manipulację.” Zob. manipulacja eksperymentalna.
Jak losowano przydział do grup i kto mógł na niego wpłynąć?
„W badaniu z fizjoterapii listę przydziału wygenerował komputer przed rekrutacją, a osoba kwalifikująca pacjentów nie znała kolejnej pozycji na liście. Przydzielanie naprzemienne albo według dnia wizyty nie jest losowe: terapeuta mógłby, nawet nieświadomie, kierować do nowej metody pacjentów rokujących lepiej.”
Kto wiedział, do której grupy trafił uczestnik?
„Pacjenci wiedzieli, jaką terapię dostają, bo tego nie da się ukryć. Zaślepiona była natomiast osoba mierząca zakres ruchu: nie wiedziała, z której grupy jest pacjent, więc jej oczekiwania nie mogły wpłynąć na pomiar.”
Jak kontrolowałeś(-aś) zmienne uboczne?
„W eksperymencie pedagogicznym obie metody nauczania prowadziła ta sama nauczycielka, w tej samej sali i według tego samego scenariusza, a test wiedzy był identyczny – tak wyeliminowałem(-am) zmienne, które mogłem(-am) utrzymać stałe. Cechy uczniów, których nie dało się kontrolować, rozkładał losowy przydział.”
Pułapka: „Dzięki randomizacji grupy były identyczne”. Losowanie sprawia, że grupy różnią się tylko przypadkowo, a nie że nie różnią się wcale – przy małych grupach te przypadkowe różnice bywają spore.
2. Quasi-eksperyment i badanie przed–po bez randomizacji
Dlaczego osoby nie zostały przydzielone losowo i co z tego wynika?
„Program profilaktyczny realizowały całe klasy, a szkoła nie zgodziła się na losowanie uczniów, więc porównuję klasę z programem z równoległą klasą bez programu. To grupy nierównoważne: mogą różnić się wyjściowo, dlatego porównuję też wyniki sprzed programu i analizuję zmianę, a nie tylko wynik końcowy.” Analizę takiego planu pokazuje wpis quasi-eksperyment i różnica w różnicach.
Czy spadek bólu po terapii nie jest regresją do średniej?
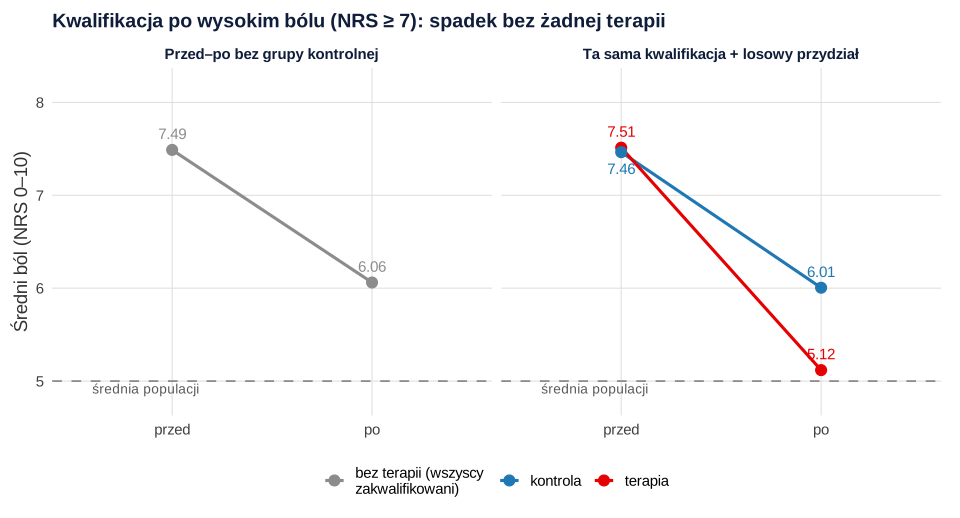
„To realne ryzyko, bo do badania kwalifikowałem(-am) osoby z silnym bólem. W symulacji wybrano z 2000 osób te, które w pierwszym pomiarze miały ból co najmniej 7 w skali NRS (391 osób), i zmierzono je ponownie bez żadnej terapii. Średni ból spadł z 7.49 do 6.06, t(390) = −17.79, p < .001, dz = −0.90, a u 48.85% osób poprawa wyniosła co najmniej 2 punkty. Tak wygląda sama regresja do średniej. Jest tym silniejsza, im większy błąd pomiaru – tu dwa pomiary tych samych osób korelowały tylko na poziomie .45 – i gdy do badania kwalifikuje się po wyniku wyjściowym (Barnett i in., 2005).”
Jak można by oddzielić efekt terapii od regresji do średniej?
„Grupą kontrolną zakwalifikowaną tak samo. W tej samej symulacji osoby z bólem co najmniej 7 przydzielono losowo do terapii (prawdziwy efekt: 1 punkt) albo do kontroli: ból spadł o 2.39 punktu w terapii i o 1.46 w kontroli, a analiza kowariancji dała efekt −0.90 (SE = 0.15). Sama zmiana przed–po w grupie terapii pokazałaby więc ponad dwa razy większy efekt niż prawdziwy.” Więcej sposobów – we wpisie regresja do średniej w badaniu przed–po.
Co poza terapią mogło się zmienić między pomiarami?
„W badaniu szkolenia z komunikacji w firmie między pomiarami trwała reorganizacja działu – to historia, czyli zdarzenie zewnętrzne, które działa na wszystkich badanych. U uczniów lub pacjentów dochodzi dojrzewanie i naturalny przebieg choroby, a przy dwukrotnym wypełnianiu tego samego testu – efekt testowania. Te zagrożenia trafności wewnętrznej opisują Shadish i in. (2002); w pracy wymieniam te, które w moim badaniu były realne.”
Pułapka: „Wynik po programie był istotnie lepszy niż przed, więc program działa”. Test dla prób zależnych mówi tylko, że zmiana nastąpiła, a nie dlaczego.
3. Badanie korelacyjne i przekrojowe
Czy z Twoich wyników wynika, że media społecznościowe pogarszają nastrój?
„Nie, bo to badanie korelacyjne z jednym pomiarem. W symulacji czas w mediach i objawy depresyjne korelują, r(298) = .25, 95% CI [.14, .35], p < .001, choć z założenia czas w mediach na objawy nie wpływa – obie zmienne zależą od neurotyczności. Po jej uwzględnieniu w regresji współczynnik spada do b = −0.03, 95% CI [−0.13, 0.08], p = .638. Korelacja jest prawdziwa, ale jej źródłem jest zmienna zakłócająca.” Zob. korelacja a przyczynowość i zmienna zakłócająca.
Skąd wiesz, które zmienne kontrolować?
„Z teorii, a nie z tego, co jest w bazie. Kontroluję zmienne, które mogą wpływać i na predyktor, i na wynik. Nie kontroluję mediatorów ani wspólnych skutków obu zmiennych, bo to oddala oszacowanie od efektu, który chcę opisać (Rohrer, 2018). Założenia narysowałem(-am) w postaci grafu.” Jak to zrobić, pokazuje wpis grafy przyczynowe (DAG).
A może zależność działa w drugą stronę?
„Może. W pracy z zarządzania zaangażowanie pracowników wiązało się z lepszą oceną przełożonego, ale z jednego pomiaru nie wiem, czy dobry przełożony zwiększa zaangażowanie, czy zaangażowani pracownicy oceniają go łagodniej. Dlatego piszę o związku, a o kierunku tylko w dyskusji, jako o hipotezie.”
Wszystko mierzyłeś(-aś) jednym kwestionariuszem tego samego dnia. Czy to nie zawyża związków?
„Może je zawyżać: gdy te same osoby tą samą metodą opisują predyktor i wynik, część wspólnej zmienności pochodzi z samej metody, np. ze stylu odpowiadania. Podsakoff i in. (2003) opisują sposoby proceduralne i statystyczne, które to ograniczają; u mnie skale były w różnych częściach ankiety i miały różne formaty odpowiedzi. Problemu to nie usuwa, więc wymieniam go w ograniczeniach.” Zob. wspólna wariancja metody.
Pułapka: „Kontrolowałem(-am) wiek i płeć, więc wynik jest przyczynowy”. Kontrola zmiennych zmierzonych nie usuwa wpływu tych, których nie zmierzono.
4. Badanie sondażowe i ankietowe
Rodzaje sondaży i źródła ich błędów szerzej opisują wpisy rodzaje badań ankietowych i całkowity błąd badania sondażowego. Na obronie zwykle padają te pytania.
Czy Twoja próba jest reprezentatywna?
„Nie – to dobór wygodny: link do ankiety udostępniłem(-am) w grupach studenckich. Reprezentatywność wynika ze sposobu doboru, a nie z liczebności ani z tego, że struktura płci przypomina populację. Wnioski odnoszę do osób podobnych do tych, które odpowiedziały.” Zob. dobór próby w pracy dyplomowej.
Ile osób dostało zaproszenie, a ile odpowiedziało?
„W badaniu pielęgniarek z trzech szpitali znam liczbę rozdanych i zwróconych ankiet, więc podaję odsetek odpowiedzi. Niski odsetek nie musi oznaczać obciążenia, ale często mu towarzyszy – o tym, czy wynik jest obciążony, decyduje to, czy osoby odpowiadające różnią się od pozostałych (Groves, 2006). Porównałem(-am) więc strukturę stażu i oddziałów z danymi szpitali.”
Kto mógł sam zgłosić się do badania i co z tego wynika?
„W ankiecie o satysfakcji z pracy, rozesłanej w grupie zawodowej, odpowiadali chętniej ludzie zaangażowani albo bardzo niezadowoleni. To autoselekcja: ten sam mechanizm, który decyduje o udziale, może być związany z mierzoną cechą. Dlatego nie podaję odsetków jako oszacowań dla wszystkich pracowników branży, a związki między zmiennymi interpretuję ostrożnie.”
Skąd wzięły się pytania w autorskiej ankiecie?
„Każde pytanie przypisałem(-am) do zmiennej i wskaźnika z rozdziału metodologicznego, część pozycji przejąłem(-ęłam) z wcześniejszych badań, a całość sprawdziłem(-am) w pilotażu. Po pilotażu przeformułowałem(-am) pytania, które osoby badane rozumiały różnie.”
Pułapka: „Zbadałem(-am) bardzo dużo osób, więc wyniki są reprezentatywne”. Duża próba z doboru wygodnego daje precyzyjne oszacowanie dla niewłaściwej populacji.
5. Badanie podłużne
Dlaczego zaplanowałeś(-aś) tyle fal i taki odstęp między nimi?
„Odstęp dobrałem(-am) do tempa zmiany, którą badam: wypalenie zmienia się powoli, więc pomiary co kilka dni mierzyłyby głównie wahania nastroju. Zbyt długi odstęp zwiększa natomiast ubytek uczestników. Liczba fal wynikała z pytania o kształt zmiany i z tego, ile pomiarów pielęgniarki mogły wypełnić bez nadmiernego obciążenia.” Praktykę planowania fal opisuje wpis ankieta w kilku falach.
Kto zrezygnował i czy to zmienia wyniki?
„Porównałem(-am) osoby, które zostały, z tymi, które odpadły. W symulacji do ostatniej fali zostało 403 z 500 pielęgniarek (80.60%), a rezygnujące miały na starcie wyższe wypalenie: 55.56 wobec 48.70 punktu, t(152.35) = −6.24, p < .001, d = −0.69. Średnia w ostatniej fali policzona tylko dla pozostających wynosi 49.20, a dla wszystkich byłaby 50.12 – ubytek zaniża więc poziom wypalenia.” Zob. utrata uczestników.
Czy dane podłużne pozwalają powiedzieć, co jest przyczyną, a co skutkiem?
„Pomagają, bo znam kolejność pomiarów i mogę sprawdzić, czy wcześniejszy poziom jednej zmiennej przewiduje późniejszą zmianę drugiej przy kontroli jej wcześniejszego poziomu. Nie usuwają jednak wpływu zmiennych niezmierzonych, więc piszę o związkach w czasie, a nie o dowodzie przyczynowym.”
Pułapka: „Analizowałem(-am) tylko osoby z kompletem pomiarów, więc dane były pełne”. Dane były pełne dla wybranej grupy – i właśnie ten wybór może obciążać wynik.
6. Budowa lub adaptacja narzędzia
Jakie masz dowody, że Twoja skala mierzy to, co miała mierzyć?
„Trafności nie da się wykazać jedną liczbą, więc zebrałem(-am) kilka rodzajów dowodów: ocenę treści pozycji przez ekspertów, strukturę czynnikową zgodną z założeniami i korelacje z innymi skalami – wyższe z miarami tego samego konstruktu, niższe z miarami innych.” Etapy takiej pracy pokazuje wpis jak zbudować i zwalidować skalę.
Jak tłumaczono kwestionariusz i kto sprawdzał polską wersję?
„Dwie osoby niezależnie przetłumaczyły skalę na polski, z tych wersji powstała wspólna, którą inna osoba przetłumaczyła z powrotem na angielski. Rozbieżności omówił zespół z udziałem eksperta dziedziny, a wersję wstępną sprawdziłem(-am) w pilotażu. Chodziło o równoważność znaczenia, a nie o dosłowność.” Zob. adaptacja kulturowa kwestionariusza.
Czy możesz porównywać wyniki swoich badanych z normami z podręcznika?
„Tylko jeśli moi badani należą do populacji, na której ustalono normy. Normy dla dorosłych z populacji ogólnej nie pasują do studentów fizjoterapii ani do pacjentów, więc w takiej sytuacji opisuję wyniki surowe i porównuję grupy w mojej próbie.”
Dlaczego sprawdzałeś(-aś) rzetelność test–retest, a nie tylko spójność?
„Bo skala ma mierzyć cechę względnie stałą, więc wyniki tych samych osób powinny być podobne w dwóch pomiarach. Spójność wewnętrzna mówi o zgodności pozycji w jednym pomiarze, a stabilność – o powtarzalności w czasie; to różne pytania.”
Pułapka: „Skala jest trafna, bo używano jej w wielu badaniach”. Popularność narzędzia nie jest dowodem trafności w Twojej populacji.
7. Analiza danych zastanych i wtórnych
Kto, kiedy i po co zebrał te dane?
„Dane pochodzą z dokumentacji medycznej oddziału, prowadzonej do celów leczenia, a nie badania. Znaczy to, że nie miałem(-am) wpływu na to, co i jak zapisywano, a zapisy mogą być dokładniejsze u pacjentów, którym poświęcano więcej uwagi.” Ogólne zasady pracy na cudzych danych omawia wpis reanaliza i wtórna analiza danych.
Jak zdefiniowano zmienne i czy definicje się nie zmieniały?
„Zmienne odtworzyłem(-am) z dokumentacji zbioru: dla każdej podaję brzmienie pytania albo regułę kodowania. W danych z kilku edycji sondażu sprawdzałem(-am), czy pytanie nie zmieniło brzmienia lub skali odpowiedzi – zmiana definicji mogłaby wyglądać jak zmiana w społeczeństwie.” Specyfikę dużych sondaży opisuje wpis analiza danych z ESS, PGSS i Diagnozy Społecznej.
Ile było braków i czy mogą być nielosowe?
„Braki opisałem(-am) dla każdej zmiennej i porównałem(-am) pacjentów z brakami i bez nich. W dokumentacji braki rzadko są przypadkowe: wynik badania bywa niezapisany u pacjentów w najcięższym albo najlżejszym stanie, dlatego nie usuwam ich bez zastanowienia.”
Skoro nie zbierałeś(-aś) danych, na czym polega Twój wkład?
„Na postawieniu pytania, na które oryginalni autorzy nie odpowiadali, na przygotowaniu zmiennych i na analizie. Rozdział metodologiczny opisuje, jak przekształciłem(-am) dane, tak by ktoś mógł to powtórzyć.”
8. Przegląd systematyczny i praca przeglądowa
Jak szukałeś(-aś) badań i czy ktoś inny powtórzy to wyszukiwanie?
„Przeszukałem(-am) kilka baz, a w aneksie podaję pełne zapytania, daty wyszukiwania i liczbę rekordów na każdym etapie w diagramie przepływu. Raport ułożyłem(-am) według listy kontrolnej PRISMA 2020 (Page i in., 2021), która ma właśnie pozwolić czytelnikowi zobaczyć, co i jak zrobiono.” Zob. przegląd systematyczny i PRISMA.
Według jakich kryteriów włączałeś(-aś) badania i kto je stosował?
„Kryteria – populacja, interwencja, porównanie, wynik i typ badania – ustaliłem(-am) przed wyszukiwaniem. Tytuły, streszczenia i pełne teksty oceniały niezależnie dwie osoby, a rozbieżności rozstrzygała rozmowa.”
Jak oceniałeś(-aś) jakość włączonych badań?
„Narzędziem dobranym do typu badania: dla badań randomizowanych – oceną ryzyka błędu, dla obserwacyjnych – osobnym narzędziem. Ocena wpływa na wnioski: osobno opisuję wyniki badań o niskim ryzyku błędu.”
Czy wnioski nie są zawyżone przez to, że nieistotne wyniki rzadziej się publikuje?
„Mogą być. Przeszukałem(-am) też rejestry badań, a przy wystarczającej liczbie badań oceniam asymetrię wykresu lejkowego; przy kilku badaniach mogę jedynie zaznaczyć to ryzyko w ograniczeniach.”
Pułapka: „To praca przeglądowa, więc nie ma w niej metodologii”. Metodologią przeglądu jest sposób szukania, wybierania i oceniania badań – i o nią komisja pyta.
9. Pojęcia, o które komisja pyta „z definicji”
Te pytania padają niezależnie od typu badania. Wystarczy odpowiedź w 1–3 zdaniach, najlepiej z przykładem z własnej pracy. Szersze ujęcie znajdziesz w podręcznikach metodologii, np. u Brzezińskiego (2019).
Czym różni się problem badawczy od pytania badawczego?
Problem to luka w wiedzy, którą praca podejmuje (np. nie wiadomo, od czego zależy wypalenie młodych pielęgniarek), a pytania badawcze to konkretne pytania, na które badanie odpowiada (czy staż pracy wiąże się z wypaleniem?). Zob. pytania badawcze i hipotezy.
Czym różni się hipoteza badawcza od statystycznej?
Hipoteza badawcza to przewidywanie wyrażone w języku teorii („wsparcie wiąże się z niższym stresem”), a statystyczna – twierdzenie o parametrze populacji, testowane jako para H0 i H1 („korelacja w populacji wynosi zero”). Zob. hipotezy H0 i H1.
Czym różni się zmienna od wskaźnika?
Zmienna to cecha, która przyjmuje różne wartości (stres), a wskaźnik – obserwowalna oznaka, po której poznajemy jej wartość (wynik w skali stresu, poziom kortyzolu). Jedna zmienna może mieć kilka wskaźników.
Co to jest operacjonalizacja?
Przełożenie pojęć z pytania badawczego na wskaźniki i procedury pomiaru: decyzja, że „zaangażowanie w pracę” mierzysz konkretną skalą i liczysz wynik jako średnią z pozycji. Zob. operacjonalizacja.
Czym różni się trafność wewnętrzna od zewnętrznej?
Trafność wewnętrzna dotyczy tego, czy wynik można przypisać badanej przyczynie, a nie innym czynnikom; zewnętrzna – czy wynik dotyczy też innych osób, sytuacji i czasu (Shadish i in., 2002). Zob. trafność wewnętrzna badania.
Czym różni się trafność od rzetelności narzędzia?
Rzetelność to dokładność i powtarzalność pomiaru, a trafność – to, czy narzędzie mierzy właściwą cechę. Narzędzie może być rzetelne i nietrafne, ale nierzetelne nie może być w pełni trafne.
Czym różni się populacja od próby?
Populacja to wszystkie osoby, których dotyczy pytanie (np. pielęgniarki pracujące w szpitalach w Polsce), a próba – osoby faktycznie zbadane. Wnioskowanie o populacji wymaga znanego sposobu doboru próby.
Czym różni się dobór losowy od przydziału losowego?
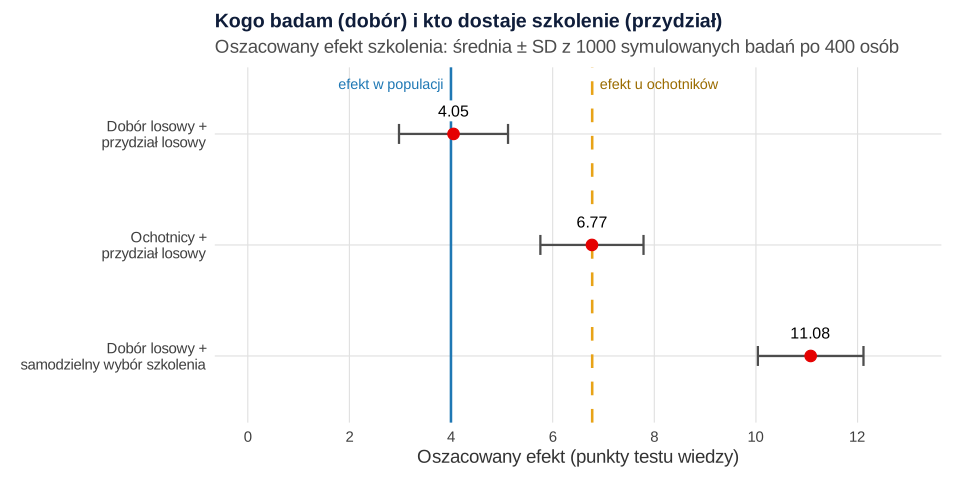
Dobór losowy decyduje, kogo badasz, i wspiera trafność zewnętrzną; przydział losowy decyduje, kto trafia do której grupy, i wspiera trafność wewnętrzną. W symulacji szkolenia pracowników prawdziwy efekt w populacji wynosi 4.00 punktu, a wśród ochotników – 6.78. Badanie z doborem losowym i przydziałem losowym dało średnio 4.05, badanie ochotników z przydziałem losowym – 6.77 (trafny efekt, ale dla ochotników), a dobór losowy z samodzielnym zapisem na szkolenie – 11.08, bo zapisywali się bardziej zmotywowani (Rysunek 3).
Czym różni się zmienna zakłócająca od moderatora?
Zakłócacz wpływa na obie badane zmienne i tworzy między nimi pozorny lub zniekształcony związek (neurotyczność w sekcji 3); moderator zmienia siłę lub kierunek związku (np. efekt szkolenia większy u osób zmotywowanych). Pierwszy trzeba kontrolować, drugi – testować interakcją.
Czym różni się metoda, technika i narzędzie badawcze?
W polskiej tradycji metodologicznej metoda to ogólny sposób postępowania (np. sondaż diagnostyczny), technika – sposób zbierania danych w jej ramach (ankieta), a narzędzie – przedmiot, którym się posługujesz (kwestionariusz ankiety). Komisja często sprawdza, czy nie mylisz tych poziomów.
Co to jest schemat badania?
Plan określający, kogo i ile razy mierzysz, jakie są grupy, jak do nich trafiają osoby i co jest porównywane – np. eksperyment z pomiarem przed i po, badanie przekrojowe albo podłużne. Od schematu zależy, jakie wnioski wolno wyciągnąć.
10. Ograniczenia i uogólnianie: jak nazwać ograniczenie językiem trafności
Jak wybrać i opisać ograniczenia w pracy, pokazuje wpis ograniczenia badania – jak je opisać. Na obronie pomaga jedno: gdy komisja wskazuje słabość, nazwij, której trafności dotyczy, i powiedz, który wniosek przez nią słabnie.
| Uwaga komisji | Której trafności dotyczy | Co słabnie w odpowiedzi |
|---|---|---|
| „Nie było grupy kontrolnej” | wewnętrzna | wniosek, że zmianę spowodował program |
| „Badał(a) Pan(i) samych ochotników” | zewnętrzna | przeniesienie wyniku na całą populację |
| „Wszystko opiera się na samoopisie” | trafność pomiaru (teoretyczna) | pewność, że zmierzono właściwą cechę |
| „Próba była mała” | trafność wniosków statystycznych | precyzja oszacowań i szansa wykrycia małego efektu |
Czy mała próba oznacza, że nie można uogólniać wyników?
„Mała próba to przede wszystkim problem precyzji: szerokie przedziały ufności i mała szansa wykrycia słabego efektu. To, na kogo można uogólniać, zależy od sposobu doboru – duża próba ochotników nie uogólnia się lepiej niż mała, co pokazuje symulacja z sekcji 9.”
Jak sformułować ograniczenie, żeby nie przekreślić całej pracy?
„Mówię, czego ograniczenie dotyczy i w którą stronę mogło przesunąć wynik: ubytek pielęgniarek z wyższym wypaleniem zaniża średni poziom wypalenia w ostatniej fali (49.20 zamiast 50.12 w symulacji z sekcji 5), więc podaję tę średnią jako raczej zaniżoną. Potem jednym zdaniem mówię, jak usunęłoby to ograniczenie kolejne badanie.”
Przed obroną przejdź przez sekcję swojego typu badania, sekcję z pojęciami i tabelę ograniczeń, a każdą odpowiedź powiedz na głos z danymi z własnej pracy. Jeśli pokazujesz wyniki na slajdach, przygotuj też slajdy zapasowe z planem badania – podpowiada to wpis prezentacja wyników na obronie.
Kod R: skąd pochodzą liczby w odpowiedziach
Dwa przepisy w bazowym R liczą wszystkie liczby użyte w odpowiedziach. Pierwszy pokazuje zmienną zakłócającą w badaniu korelacyjnym (sekcja 3) i regresję do średniej w badaniu przed–po (sekcja 2), drugi – różnicę między doborem losowym a przydziałem losowym (sekcja 9) oraz ubytek uczestników w badaniu podłużnym (sekcja 5). Dane są symulowane, więc znamy prawdziwe efekty i widać, jak plan badania zmienia ich oszacowania. Rysunki przygotowano w osobnym skrypcie na tych samych danych.
Część 1: zmienna zakłócająca i regresja do średniej
R
# B377 – dwie symulacje do odpowiedzi na obronie (dane symulowane, bazowy R)
# A. Badanie korelacyjne: zmienna zakłócająca daje korelację bez wpływu przyczynowego
# B. Badanie przed–po bez grupy kontrolnej: regresja do średniej przy kwalifikacji po wysokim wyniku
set.seed(377)
z2 <- function(x) formatC(x, format = "f", digits = 2)
pp <- function(p) if (p < .001) "p < .001" else paste("p =", sub("^0\\.", ".", formatC(p, format = "f", digits = 3)))
bz <- function(x) sub("^(-?)0\\.", "\\1.", z2(x))              # bez zera przed kropką (r, R²)

cat("A. Czas w mediach społecznościowych a objawy depresyjne – zakłócacz: neurotyczność\n")
n <- 300
neurot  <- rnorm(n)                                          # zmienna zakłócająca (z-score)
media   <- 0.55 * neurot + rnorm(n, 0, 0.85)                 # X zależy od neurotyczności
depres  <- 0.60 * neurot + rnorm(n, 0, 0.80)                 # Y zależy od neurotyczności, NIE od X
ct <- cor.test(media, depres)
cat("Korelacja X–Y: r(", ct$parameter, ") =", bz(ct$estimate), ", 95% CI [", bz(ct$conf.int[1]), ",",
    bz(ct$conf.int[2]), "],", pp(ct$p.value), "\n")
m1 <- lm(depres ~ media); m2 <- lm(depres ~ media + neurot)
e1 <- summary(m1)$coefficients["media", ]; e2 <- summary(m2)$coefficients["media", ]
cat("Regresja Y na X bez zakłócacza: b =", z2(e1[1]), ",", pp(e1[4]), "\n")
cat("Regresja Y na X z kontrolą neurotyczności: b =", z2(e2[1]), ", 95% CI [",
    z2(confint(m2)["media", 1]), ",", z2(confint(m2)["media", 2]), "],", pp(e2[4]), "\n")
r_cz <- cor(resid(lm(media ~ neurot)), resid(lm(depres ~ neurot)))
cat("Korelacja cząstkowa X–Y przy stałej neurotyczności: r =", bz(r_cz), "\n\n")

cat("B. Fizjoterapia: ból (NRS 0–10) u osób zakwalifikowanych po wyniku co najmniej 7, bez żadnej terapii\n")
N <- 2000
prawdziwy <- rnorm(N, 5, 1.2)                                # stały poziom bólu osoby
pomiar <- function() pmin(10, pmax(0, round(prawdziwy + rnorm(N, 0, 1.2))))
pre <- pomiar(); post <- pomiar()                             # dwa pomiary, w międzyczasie nic się nie dzieje
k <- pre >= 7
tt <- t.test(post[k], pre[k], paired = TRUE)
roz <- post[k] - pre[k]
cat("Zakwalifikowano", sum(k), "z", N, "osób; ból przed =", z2(mean(pre[k])), "; po =", z2(mean(post[k])),
    "; zmiana =", z2(mean(roz)), "\n")
cat("Test t dla prób zależnych: t(", tt$parameter, ") =", z2(tt$statistic), ",", pp(tt$p.value),
    "; d_z =", z2(mean(roz) / sd(roz)), "\n")
cat("Odsetek osób z poprawą o co najmniej 2 punkty:", z2(100 * mean(roz <= -2)), "%\n")
cat("Rzetelność pojedynczego pomiaru: r(pre, post) w całej próbie =", bz(cor(pre, post)), "\n")
# Ta sama kwalifikacja, losowy przydział: terapia (prawdziwy efekt −1 punkt) albo grupa kontrolna
idx <- which(k)
terapia <- sample(rep(0:1, length.out = length(idx)))
post2 <- post[idx] - 1 * terapia
zm <- post2 - pre[idx]
cat("Z grupą kontrolną: zmiana w terapii =", z2(mean(zm[terapia == 1])), "; w kontroli =",
    z2(mean(zm[terapia == 0])), "; różnica zmian =", z2(mean(zm[terapia == 1]) - mean(zm[terapia == 0])), "\n")
ac <- summary(lm(post2 ~ terapia + pre[idx]))$coefficients["terapia", ]
cat("ANCOVA (po ~ grupa + przed): efekt terapii =", z2(ac[1]), ", SE =", z2(ac[2]), ",", pp(ac[4]), "\n")
Wynik w R
A. Czas w mediach społecznościowych a objawy depresyjne – zakłócacz: neurotyczność
Korelacja X–Y: r( 298 ) = .25 , 95% CI [ .14 , .35 ], p < .001
Regresja Y na X bez zakłócacza: b = 0.25 , p < .001
Regresja Y na X z kontrolą neurotyczności: b = -0.03 , 95% CI [ -0.13 , 0.08 ], p = .638
Korelacja cząstkowa X–Y przy stałej neurotyczności: r = -.03

B. Fizjoterapia: ból (NRS 0–10) u osób zakwalifikowanych po wyniku co najmniej 7, bez żadnej terapii
Zakwalifikowano 391 z 2000 osób; ból przed = 7.49 ; po = 6.06 ; zmiana = -1.43
Test t dla prób zależnych: t( 390 ) = -17.79 , p < .001 ; d_z = -0.90
Odsetek osób z poprawą o co najmniej 2 punkty: 48.85 %
Rzetelność pojedynczego pomiaru: r(pre, post) w całej próbie = .45
Z grupą kontrolną: zmiana w terapii = -2.39 ; w kontroli = -1.46 ; różnica zmian = -0.94
ANCOVA (po ~ grupa + przed): efekt terapii = -0.90 , SE = 0.15 , p < .001
Część 2: dobór losowy, przydział losowy i ubytek uczestników
R
# B377 – dobór losowy a przydział losowy oraz ubytek w badaniu podłużnym (dane symulowane, bazowy R)
# C. Szkolenie pracowników: populacja 100 000 osób, efekt szkolenia większy u osób zmotywowanych
# D. Badanie podłużne pielęgniarek: rezygnują częściej osoby z wyższym wypaleniem
set.seed(3770)
z2 <- function(x) formatC(x, format = "f", digits = 2)

cat("C. Dobór losowy (kogo badam) a przydział losowy (kto dostaje szkolenie)\n")
Npop <- 100000
motyw <- rnorm(Npop)                                          # motywacja do rozwoju (z-score)
y0 <- 60 + 6 * motyw + rnorm(Npop, 0, 8)                       # wynik testu wiedzy bez szkolenia
efekt <- 4 + 3 * motyw                                         # efekt szkolenia rośnie z motywacją
ochotnik <- rbinom(Npop, 1, plogis(-2 + 1.5 * motyw))          # kto zgłasza się do badania sam
cat("Prawdziwy średni efekt w populacji =", z2(mean(efekt)), "; wśród ochotników =", z2(mean(efekt[ochotnik == 1])),
    "; odsetek ochotników =", z2(100 * mean(ochotnik)), "%\n")
cat("Średni wynik bez szkolenia: populacja =", z2(mean(y0)), "; ochotnicy =", z2(mean(y0[ochotnik == 1])), "\n")
jedno <- function(plan, n = 400) {
  pula <- if (plan == "wygodny") which(ochotnik == 1) else 1:Npop
  i <- sample(pula, n)
  if (plan == "bez_przydzialu") {
    sz <- rbinom(n, 1, plogis(1.2 * motyw[i]))                   # na szkolenie zapisują się chętniejsi
  } else {
    sz <- sample(rep(0:1, n / 2))                                 # przydział losowy
  }
  y <- y0[i] + efekt[i] * sz
  c(srednia_kontrola = mean(y[sz == 0]), efekt = mean(y[sz == 1]) - mean(y[sz == 0]))
}
plany <- c(losowy_dobor_losowy_przydzial = "losowy", ochotnicy_losowy_przydzial = "wygodny",
           losowy_dobor_bez_przydzialu = "bez_przydzialu")
wyn <- t(sapply(plany, function(p) {
  r <- replicate(1000, jedno(p))
  c(M_kontrola = mean(r["srednia_kontrola", ]), efekt_M = mean(r["efekt", ]), efekt_SD = sd(r["efekt", ]))
}))
print(round(wyn, 2))
cat("\n")

cat("D. Badanie wypalenia u pielęgniarek, fala 1 i fala 3: ubytek zależny od wyniku wyjściowego\n")
n <- 500
wyp1 <- rnorm(n, 50, 10)                                       # wypalenie w fali 1 (skala 0–100)
wyp3 <- 0.7 * wyp1 + 15 + rnorm(n, 0, 7)                       # wypalenie w fali 3
zostaje <- rbinom(n, 1, plogis(1.5 - 0.08 * (wyp1 - 50)))     # wyżej wypaleni częściej rezygnują
cat("Zostało do fali 3:", sum(zostaje), "z", n, "(", z2(100 * mean(zostaje)), "%)\n")
cat("Fala 1: wszyscy M =", z2(mean(wyp1)), "; pozostający M =", z2(mean(wyp1[zostaje == 1])),
    "; rezygnujący M =", z2(mean(wyp1[zostaje == 0])), "\n")
tt <- t.test(wyp1[zostaje == 1], wyp1[zostaje == 0])
sp <- sqrt((var(wyp1[zostaje == 1]) + var(wyp1[zostaje == 0])) / 2)
cat("Porównanie fali 1 (Welch): t(", z2(tt$parameter), ") =", z2(tt$statistic), ", p", ifelse(tt$p.value < .001, "< .001", paste("=", z2(tt$p.value))), "; d =",
    z2((mean(wyp1[zostaje == 1]) - mean(wyp1[zostaje == 0])) / sp), "\n")
cat("Fala 3: prawdziwa średnia (wszyscy) =", z2(mean(wyp3)), "; średnia tylko u pozostających =",
    z2(mean(wyp3[zostaje == 1])), "\n")
Wynik w R
C. Dobór losowy (kogo badam) a przydział losowy (kto dostaje szkolenie)
Prawdziwy średni efekt w populacji = 4.00 ; wśród ochotników = 6.78 ; odsetek ochotników = 18.99 %
Średni wynik bez szkolenia: populacja = 59.99 ; ochotnicy = 65.64
                              M_kontrola efekt_M efekt_SD
losowy_dobor_losowy_przydzial      59.97    4.05     1.07
ochotnicy_losowy_przydzial         65.64    6.77     1.01
losowy_dobor_bez_przydzialu        57.15   11.08     1.04

D. Badanie wypalenia u pielęgniarek, fala 1 i fala 3: ubytek zależny od wyniku wyjściowego
Zostało do fali 3: 403 z 500 ( 80.60 %)
Fala 1: wszyscy M = 50.03 ; pozostający M = 48.70 ; rezygnujący M = 55.56
Porównanie fali 1 (Welch): t( 152.35 ) = -6.24 , p < .001 ; d = -0.69
Fala 3: prawdziwa średnia (wszyscy) = 50.12 ; średnia tylko u pozostających = 49.20
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats); rysunki przygotowano w pakietach ggplot2, patchwork, svglite i magick. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
- magick (wersja 2.9.1): Ooms, J. (2026). magick: Advanced graphics and image-processing in R [R package]. https://doi.org/10.32614/CRAN.package.magick
Najczęstsze pytania
Jakie pytania z metodologii badań naukowych padają na obronie pracy magisterskiej?
Najczęściej pytania o plan badania właściwy dla jego typu: w eksperymencie – o manipulację, losowy przydział i zaślepienie, w badaniu korelacyjnym – o przyczynowość i zmienne zakłócające, w sondażu – o dobór próby i odsetek odpowiedzi, w badaniu podłużnym – o rezygnacje uczestników. Do tego dochodzą pytania o definicje (hipoteza badawcza a statystyczna, trafność a rzetelność) i o ograniczenia badania.
Czym różni się metoda, technika i narzędzie badawcze?
Metoda to ogólny sposób postępowania badawczego (np. sondaż diagnostyczny), technika – sposób zbierania danych w jej ramach (np. ankieta), a narzędzie – konkretny przedmiot, którym się posługujesz (np. kwestionariusz ankiety). W rozdziale metodologicznym i na obronie warto nazywać każdy z tych poziomów osobno.
Czy w pracy z badaniem ankietowym mogę pisać o wpływie jednej zmiennej na drugą?
Zwykle nie. Badanie ankietowe z jednym pomiarem pokazuje związki, a ich źródłem mogą być zmienne zakłócające albo odwrotny kierunek zależności. Pisz o związku lub współwystępowaniu, a hipotezy przyczynowe przedstaw w dyskusji jako wyjaśnienia do sprawdzenia w badaniu eksperymentalnym lub podłużnym.
Czy badanie przed i po bez grupy kontrolnej może potwierdzić skuteczność terapii?
Samo w sobie – nie. Zmiana między pomiarami może wynikać z regresji do średniej, naturalnego przebiegu choroby, zdarzeń między pomiarami albo z ponownego wypełniania testu. Takie badanie pokazuje, że zmiana nastąpiła; aby przypisać ją terapii, potrzebna jest porównywalna grupa kontrolna, najlepiej z losowym przydziałem.
O co pyta komisja na obronie pracy przeglądowej?
O metodologię przeglądu: w jakich bazach i jakim zapytaniem szukano badań, według jakich kryteriów je włączano i kto je oceniał, jak oceniano jakość włączonych badań i czy wnioski nie są zawyżone przez błąd publikacji. Dobrze, gdy raport jest zgodny z wytycznymi PRISMA 2020.
Powiązane hasła
Przeczytaj też
Metodologia badań – zadania z rozwiązaniami
Dziesięć zadań: zmienne i skale, schemat badania, zagrożenia trafności, regresja do średniej, hipotezy, operacjonalizacja, dobór próby, mediator i moderator.
Czytaj →PoradnikPytania na obronie z metodologii i statystyki
38 pytań komisji o hipotezy, schemat, próbę, narzędzia, analizy i wyniki – z przykładowymi odpowiedziami, ściągą na jedną stronę i planem przygotowania.
Czytaj →PoradnikPytania ze statystyki na obronę magisterską
Pytania promotora i recenzenta ułożone według analizy – od testu t i chi-kwadrat po regresję, ANOVA i alfę Cronbacha – z krótkimi odpowiedziami na liczbach.
Czytaj →PoradnikOgraniczenia badania – jak je opisać
Jak znaleźć ograniczenia, ocenić kierunek i wielkość błędu, wybrać najważniejsze i opisać je konkretnie. Przykład ankiety online z liczbami z R.
Czytaj →PoradnikPrezentacja wyników na obronie
Ile slajdów i liczb, wykres zamiast tabeli z SPSS, wynik nieistotny jako efekt z przedziałem ufności – z dwiema parami slajdów „źle / dobrze” zrobionych w R.
Czytaj →Nie wiesz, jak obronić plan swojego badania?
Przejdziemy z Tobą przez rozdział metodologiczny i analizy Twojej pracy, nazwiemy mocne strony i ograniczenia planu badania i przećwiczymy odpowiedzi tak, żebyś umiał(a) samodzielnie odpowiedzieć na pytania promotora i recenzenta.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215–220. https://doi.org/10.1093/ije/dyh299 ● Otwarty dostęp
- Brzeziński, J. (2019). Metodologia badań psychologicznych (Wyd. nowe). Wydawnictwo Naukowe PWN.
- Groves, R. M. (2006). Nonresponse rates and nonresponse bias in household surveys. Public Opinion Quarterly, 70(5), 646–675. https://doi.org/10.1093/poq/nfl033
- Page, M. J., McKenzie, J. E., Bossuyt, P. M., Boutron, I., Hoffmann, T. C., Mulrow, C. D., Shamseer, L., Tetzlaff, J. M., Akl, E. A., Brennan, S. E., Chou, R., Glanville, J., Grimshaw, J. M., Hróbjartsson, A., Lalu, M. M., Li, T., Loder, E. W., Mayo-Wilson, E., McDonald, S., . . . Moher, D. (2021). The PRISMA 2020 statement: An updated guideline for reporting systematic reviews. BMJ, 372, Article n71. https://doi.org/10.1136/bmj.n71 ● Otwarty dostęp
- Podsakoff, P. M., MacKenzie, S. B., Lee, J.-Y., & Podsakoff, N. P. (2003). Common method biases in behavioral research: A critical review of the literature and recommended remedies. Journal of Applied Psychology, 88(5), 879–903. https://doi.org/10.1037/0021-9010.88.5.879
- Rohrer, J. M. (2018). Thinking clearly about correlations and causation: Graphical causal models for observational data. Advances in Methods and Practices in Psychological Science, 1(1), 27–42. https://doi.org/10.1177/2515245917745629 ● Otwarty dostęp
- Shadish, W. R., Cook, T. D., & Campbell, D. T. (2002). Experimental and quasi-experimental designs for generalized causal inference. Houghton Mifflin.
Cytowania BibTeX
@article{barnett2005regression, author={Barnett, Adrian G. and van der Pols, Jolieke C. and Dobson, Annette J.}, title={{Regression to the mean: What it is and how to deal with it}}, journal={International Journal of Epidemiology}, year={2005}, volume={34}, number={1}, pages={215--220}, doi={10.1093/ije/dyh299}}@book{brzezinski2019metodologia, author={Brzeziński, Jerzy}, title={{Metodologia badań psychologicznych}}, year={2019}, edition={Wyd. nowe}, publisher={Wydawnictwo Naukowe PWN}}@article{groves2006nonresponse, author={Groves, Robert M.}, title={{Nonresponse rates and nonresponse bias in household surveys}}, journal={Public Opinion Quarterly}, year={2006}, volume={70}, number={5}, pages={646--675}, doi={10.1093/poq/nfl033}}@article{page2021prisma, author={Page, Matthew J and McKenzie, Joanne E and Bossuyt, Patrick M and Boutron, Isabelle and Hoffmann, Tammy C and Mulrow, Cynthia D and Shamseer, Larissa and Tetzlaff, Jennifer M and Akl, Elie A and Brennan, Sue E and Chou, Roger and Glanville, Julie and Grimshaw, Jeremy M and Hróbjartsson, Asbjørn and Lalu, Manoj M and Li, Tianjing and Loder, Elizabeth W and Mayo-Wilson, Evan and McDonald, Steve and McGuinness, Luke A and Stewart, Lesley A and Thomas, James and Tricco, Andrea C and Welch, Vivian A and Whiting, Penny and Moher, David}, title={{The PRISMA 2020 statement: An updated guideline for reporting systematic reviews}}, journal={BMJ}, year={2021}, volume={372}, eid={n71}, doi={10.1136/bmj.n71}}@article{podsakoff2003common, author={Podsakoff, Philip M. and MacKenzie, Scott B. and Lee, Jeong-Yeon and Podsakoff, Nathan P.}, title={{Common method biases in behavioral research: A critical review of the literature and recommended remedies}}, journal={Journal of Applied Psychology}, year={2003}, volume={88}, number={5}, pages={879--903}, doi={10.1037/0021-9010.88.5.879}}@article{rohrer2018thinking, author={Rohrer, Julia M.}, title={{Thinking clearly about correlations and causation: Graphical causal models for observational data}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={1}, pages={27--42}, doi={10.1177/2515245917745629}}@book{shadish2002experimental, author={Shadish, William R. and Cook, Thomas D. and Campbell, Donald T.}, title={{Experimental and quasi-experimental designs for generalized causal inference}}, year={2002}, publisher={Houghton Mifflin}}