Po co slajdy z wynikami na obronie
Na obronie komisja zwykle zna już pracę albo przynajmniej recenzje. Prezentacja nie ma więc powtarzać rozdziału wyników, tylko w kilka minut pokazać, na jakie pytania odpowiedziało badanie i jak pewne są te odpowiedzi. Rozdział czyta się we własnym tempie, a slajd ogląda kilkadziesiąt sekund, jednocześnie słuchając osoby, która mówi.
Mayer i Moreno (2003) opisują człowieka jako odbiorcę z dwoma kanałami, wzrokowym i słownym, z których każdy przetwarza naraz ograniczoną ilość materiału. Gdy prezentacja wymaga więcej przetwarzania, niż słuchacz ma do dyspozycji, dochodzi do przeciążenia i uczenie się słabnie. Slajd z tabelą pełną liczb, przy którym jednocześnie mówisz o czymś innym, to podręcznikowy przykład takiego przeciążenia. Kosslyn i in. (2012) pokazali też, że osiem zasad psychologicznych jest w prezentacjach łamanych często, a slajdy akademickie nie wypadały lepiej niż biznesowe. Oglądający nie zawsze potrafili przy tym wskazać, która zasada została złamana.
Ten wpis dotyczy tylko slajdów z wynikami: ile ich zrobić, co na nich umieścić, jaki wykres wybrać i jak pokazać wynik nieistotny. Pytania, które mogą paść po prezentacji, i wzory odpowiedzi zebraliśmy w osobnym tekście o pytaniach na obronie z metodologii i statystyki. Przebieg samej obrony, czas wystąpienia i wymagania co do prezentacji określają regulamin studiów i promotor, więc sprawdź je najpierw.
Przykład: trzy hipotezy, trzy slajdy
Wszystkie liczby pochodzą z jednego badania symulowanego. 120 osób studiujących przydzielono losowo, po 60, do krótkiego treningu relaksacji przed sesją albo do grupy kontrolnej. Zmierzono lęk przed egzaminem (średnia z pozycji na skali 1–5) i wynik egzaminu (0–40 punktów). Dane są w pliku CSV. Hipotezy były trzy:
- H1: po treningu lęk będzie niższy niż w grupie kontrolnej. Średnie wyniosły 2.82 i 3.27, różnica −0.46 punktu, 95% CI [−0.72, −0.20], t(117.69) = −3.46, p < .001, d = −0.63, 95% CI [−1.00, −0.26].
- H2: po treningu wynik egzaminu będzie wyższy. Średnie wyniosły 23.68 i 23.58 punktu, różnica 0.10 punktu, 95% CI [−1.95, 2.15], t(117.95) = 0.10, p = .923, d = 0.02, 95% CI [−0.34, 0.38].
- H3: wyższy lęk będzie się wiązał z niższym wynikiem egzaminu. Korelacja wyniosła r(118) = −.12, 95% CI [−.29, .06], p = .188.
W pracy te wyniki zajmują kilka stron z tabelami APA, opisem założeń i testem Welcha (jak go opisać, pokazuje wpis test t Studenta krok po kroku). Na obronie wystarczą trzy slajdy, po jednym na hipotezę, a jeśli czas jest krótki – dwa, jak na rysunku 2.
Ile slajdów z wynikami i ile liczb na slajdzie
Nie ma jednej normy, bo czas wystąpienia i liczba hipotez są różne. Dobrze działa prosta reguła: jeden slajd na jedną hipotezę albo pytanie badawcze. Do tego dochodzi jeden slajd o próbie i jeden podsumowujący. Jeśli hipotez jest dużo, pogrupuj je według pytań badawczych, a wyniki podobnego typu pokaż na jednym wykresie efektów, jak na rysunku 2. Zasady wyboru analiz i kolejności wyników w samej pracy omawia wpis ile analiz w pracy magisterskiej. Prezentacja zwykle obejmuje tylko analizy główne, a eksploracyjne trafiają na slajdy zapasowe.
| Slajd | Co na nim jest | Liczby |
|---|---|---|
| Próba i schemat | Kto, ile osób, jakie grupy i pomiary; prosty schemat badania albo model hipotez | N, liczebności grup, 1–2 cechy próby |
| Jedna hipoteza | Teza w tytule, jeden wykres, jedna linijka statystyk | 3–5: dwie średnie albo r, test z p, wielkość efektu z 95% CI |
| Podsumowanie | Hipotezy z odpowiedzią „wykazano / nie wykazano” i wielkością efektu | Po jednej wielkości efektu na hipotezę |
| Zapasowe (po prezentacji) | Założenia, analizy dodatkowe, pełne tabele z pracy | Tyle, ile trzeba – pokazujesz tylko na pytanie |
Trzy–pięć liczb na slajdzie to nie przepis z wytycznych, tylko praktyczny limit. Tyle słuchacz zdąży przeczytać, zanim przejdziesz dalej. Liczby zaokrąglaj do tego, co ma znaczenie. Cole (2015) pokazuje, że wyniki często podaje się ze zbyt dużą precyzją, i proponuje m.in., by średnią podawać z taką liczbą miejsc po przecinku, przy której SD ma dwie cyfry znaczące, a odsetki przy dużych różnicach – w liczbach całkowitych. Na slajdzie „117.689 stopni swobody” nic nie wnosi. Wystarczy t(117.7) albo nawet sam opis efektu w tytule, a pełny zapis zostaje w pracy.
Wykres zamiast tabeli: który do jakiego wyniku
Tabela służy do odczytu dokładnych wartości, wykres – do szybkiego porównania. Na obronie ważniejsze jest porównanie. Gelman i in. (2002) przejrzeli tabele w numerze czasopisma statystycznego i pokazali, że wykresy mogą je zastąpić, zajmując przy tym mniej miejsca. Cleveland i McGill (1984) uporządkowali zadania percepcyjne według dokładności odczytu. Porównanie położenia na wspólnej skali wypadło w nich najlepiej, dlatego punkty na osi czyta się dokładniej niż kąty czy powierzchnie. Ogólne zasady doboru wykresu w pracy dyplomowej omawia wpis wykresy w pracy dyplomowej. Tu skupiamy się na tym, co zmienia slajd.
| Wynik w pracy | Wykres na slajd | Co dopisać na slajdzie |
|---|---|---|
| Różnica dwóch lub kilku grup (test t, ANOVA) | Punkty osób i średnie z 95% CI; przy dużej próbie wykres pudełkowy | n w grupach, d Cohena albo η² z CI |
| Związek dwóch zmiennych ilościowych | Wykres rozrzutu z linią regresji | r z 95% CI i N |
| Interakcja dwóch czynników, moderacja | Wykres interakcji: linie średnich z CI | Efekty proste z CI |
| Tabela krzyżowa (chi-kwadrat) | Słupki odsetków w grupach na wspólnej osi 0–100% | Odsetki, n, V Craméra |
| Odpowiedzi na pozycje skali Likerta | Słupki rozbieżne – zob. odpowiedzi Likerta w raporcie | Odsetki zgody i niezgody |
| Kilka hipotez albo predyktorów naraz | Wykres efektów: punkty z CI wokół zera, jak wykres lasu | Wielkość efektu z CI dla każdej linii |
Unikaj na slajdzie słupków samych średnich, jeśli zmienna jest ilościowa. Weissgerber i in. (2015) przypominają, że wiele różnych rozkładów daje ten sam wykres słupkowy, a pełne dane mogą prowadzić do innych wniosków niż średnie. Newman i Scholl (2012) wykazali ponadto, że oglądający uznają wartości leżące „wewnątrz” słupka za bardziej prawdopodobne niż równie odległe wartości ponad nim. Słupek średniej sugeruje więc rozkład, którego nie ma. Słupki zostaw dla liczebności i odsetków.
Slajd z wynikiem istotnym: źle i dobrze
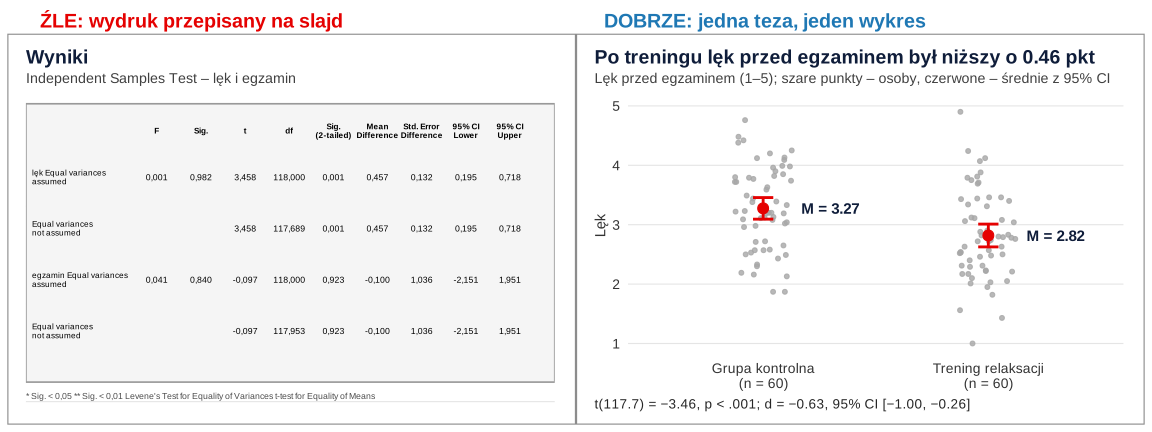
Rysunek 1 pokazuje ten sam wynik H1 na dwóch slajdach. Po lewej jest tabela przepisana z wydruku testu t: 32 liczby z trzema miejscami po przecinku, dwa warianty testu, test Levene'a, angielskie nagłówki i przecinki dziesiętne. Komisja nie ma czasu, by znaleźć w niej jedną potrzebną wartość. Różnica jest tu dodatnia, bo program odjął grupę treningu od kontrolnej, choć hipoteza mówiła o spadku lęku. Obie zmienne zależne trafiły do jednej tabeli, więc slajd odpowiada na dwa pytania naraz.
Slajd po prawej robi trzy rzeczy inaczej:
- Tytuł jest wnioskiem, a nie nazwą sekcji. „Po treningu lęk był niższy o 0.46 pkt” mówi to, co komisja ma zapamiętać. Tytuł „Wyniki” albo „Test t” każe tego szukać.
- Wykres pokazuje osoby i niepewność. Widać, że wyniki obu grup w dużej części się nakładają, mimo że różnica średnich jest wyraźna. W podtytule jest napisane, co oznaczają odcinki. Cumming i in. (2007) przypominają, że mogą to być przedziały ufności, błędy standardowe albo odchylenia standardowe, a każde z nich mówi co innego.
- Statystyki mieszczą się w jednej linijce u dołu: test, wartość p i wielkość efektu z przedziałem. Resztę mówisz, a pełny zapis jest w pracy.
Oś zaczyna się od 1, czyli od początku skali, a nie od wartości, przy której różnica wygląda najefektowniej. To samo dotyczy kolorów. Wystarczy jeden kolor akcentu dla tego, o czym mówisz, a reszta może być szara. Rougier i in. (2014) opisują wykres naukowy jako interfejs między ludźmi a danymi. Te same dane mogą być odebrane bardzo różnie w zależności od tego, kto patrzy.
Przy slajdzie powiedz wniosek, a potem liczbę, która go uzasadnia:
Wynik nieistotny i wielkość efektu na slajdzie
Wynik nieistotny to też wynik i należy mu się slajd. Najczęstszy błąd pokazuje lewa strona rysunku 2: słupki, napis „n.s.” i wniosek, że trening „nie wpływa” na wynik egzaminu. Tymczasem p = .923 mówi tylko, że dane nie pozwoliły odrzucić hipotezy zerowej. Co jest zgodne z danymi, pokazuje dopiero przedział ufności. Dlaczego „brak istotności” nie oznacza „braku efektu” i jak to zapisać w pracy, wyjaśnia wpis jak opisać wynik nieistotny. Tu pokazujemy, jak przenieść tę zasadę na slajd.
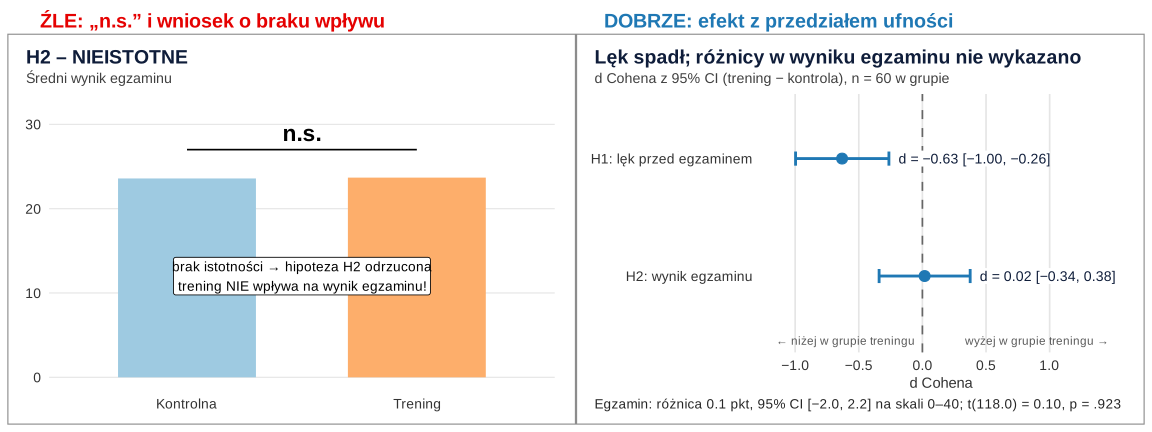
Na prawym slajdzie obie hipotezy są na jednej osi wielkości efektu. Przedział dla lęku leży w całości po lewej stronie zera. Przedział dla egzaminu przecina zero i sięga od −0.34 do 0.38. Dane są więc zgodne zarówno z małym spadkiem, jak i z małym wzrostem wyniku egzaminu. W punktach to od −2.0 do 2.2 na skali 0–40. Taki slajd jest uczciwszy niż „n.s.” i odpowiada na pytanie, które komisja i tak zada: „czy to znaczy, że trening nie działa?”. Cumming (2014) zaleca przejście od testowania istotności do szacowania efektów z przedziałami ufności. Na slajdzie widać to najlepiej, bo szerokość przedziału jest od razu widoczna.
Wielkość efektu pokazuj przy każdej hipotezie, także istotnej. Jak ją nazywać („mała”, „umiarkowana”) i dlaczego progi Cohena to tylko punkt wyjścia, omawia wpis wielkość efektu – interpretacja. Jeśli masz odwrotny problem, czyli istotny, ale bardzo mały efekt, przeczytaj wpis wynik istotny, ale efekt mały. Wynik bliski progu, np. p = .06, opisz jak każdy inny i nie nazywaj go „trendem” (zob. p = .06 – trend czy brak efektu).
Typowe błędy na slajdach z wynikami
- Zrzut ekranu z SPSS. Mała czcionka, angielskie etykiety, przecinki dziesiętne, „Sig. = ,000” i wiersze, o których nie mówisz. Z wydruku przepisz na slajd tylko 3–5 liczb, a jeśli nie wiesz, które to, sprawdź we wpisie jak czytać wyniki z SPSS. Zamiast „,000” napisz p < .001.
- Tabela 20 × 10. Macierz korelacji dziesięciu zmiennych to 45 współczynników, a pełna tabela regresji ma kilkadziesiąt komórek. W pracy tabele są na miejscu (zob. tabele APA – wzory), na slajdzie – nie. Wybierz wiersze, których dotyczą hipotezy, albo zrób z nich wykres efektów.
- Same gwiazdki i „n.s.” bez wielkości efektu i przedziału. Komisja nie wie, czy efekt jest duży, czy tylko istotny.
- Słupki średnich bez rozrzutu i bez opisu odcinków. Nie wiadomo, czy to SD, SE, czy 95% CI.
- Slajd pełen tekstu czytany na głos. Słuchacz czyta i słucha naraz, więc nie robi dobrze żadnej z tych rzeczy (Mayer i Moreno, 2003). Na slajdzie zostaw tezę i wykres, a zdania mów.
- Inne liczby na slajdzie i w pracy. Najczęściej po poprawkach promotora. Sprawdź każdą wartość z tabelą w pracy, bo recenzent porówna.
- Wykres kołowy metryczki, efekt 3D, przycięta oś. Te błędy omawia szczegółowo wpis o wykresach w pracy dyplomowej. Na slajdzie ważą tyle samo.
Pokaż gotowe slajdy osobie spoza tematu i poproś, by w jednym zdaniu powiedziała, co mówi każdy z nich. Badanie Kosslyna i in. (2012) sugeruje, że autorzy i odbiorcy nie zawsze rozpoznają złamane zasady. Szybki test na drugiej osobie wychwyci więcej niż samodzielne przeglądanie.
Slajdy zapasowe i pytania komisji
Po ostatnim slajdzie podsumowania dodaj kilka slajdów zapasowych, których nie pokazujesz w trakcie wystąpienia. Mogą to być: sprawdzenie założeń, analiza bez obserwacji odstających, pełna tabela z pracy, wynik analizy eksploracyjnej. Gdy ktoś zapyta „a czy sprawdzał Pan / sprawdzała Pani założenia?”, możesz od razu pokazać odpowiedź. Jakie pytania padają najczęściej i jak na nie odpowiadać, opisaliśmy we wpisie o pytaniach na obronie. Nie powtarzamy ich tutaj.
Liczby na slajdy najłatwiej przygotować, zapisując wcześniej każdy wynik w stylu APA. Pomaga w tym generator opisu wyników APA: wpisujesz statystyki z wydruku, a dostajesz gotowe zdanie z wielkością efektu. Z takiego zdania wybierasz 3–5 liczb na slajd. Cały rozdział wyników z takimi zdaniami pokazuje przykładowy rozdział wyników. Ogólny plan analiz w pracy dyplomowej, od hipotez do obrony, opisuje przewodnik po statystyce w pracy dyplomowej.
Slajdy z rysunków 1 i 2 w R
Przepis 1 tworzy dane, liczy wszystkie liczby z tekstu (test t Welcha, d Cohena z 95% CI z pakietu effectsize, korelację) i odtwarza układ tabeli z wydruku, który trafił na zły slajd. Przepis 2 rysuje oba porównania „źle / dobrze” w ggplot2 i łączy slajdy pakietem patchwork. Wykres zapisany jako SVG wkleisz do PowerPointa albo Impressa bez utraty ostrości.
1. Liczby do slajdów: test Welcha, d z 95% CI i korelacja
R
# B241 – liczby do slajdów z wynikami: test t Welcha, d Cohena z 95% CI, korelacja
# Dane symulowane, set.seed(2411): 120 osób studiujących przydzielonych losowo (po 60)
# do krótkiego treningu relaksacji przed sesją albo do grupy kontrolnej.
# Lęk przed egzaminem: średnia z pozycji na skali 1–5; wynik egzaminu: 0–40 punktów.
suppressPackageStartupMessages(library(effectsize))
set.seed(2411)
n <- 120
grupa <- factor(rep(c("Kontrolna", "Trening"), each = n / 2), levels = c("Kontrolna", "Trening"))
trening <- as.numeric(grupa == "Trening")
lek <- round(pmin(5, pmax(1, rnorm(n, 3.25 - 0.38 * trening, 0.68))), 2)
egzamin <- round(pmin(40, pmax(0, rnorm(n, 24 - 2.2 * (lek - 3.1), 5.6))))
dane <- data.frame(grupa, lek, egzamin)
write.csv(dane, "../obrona-dane-przyklad.csv", row.names = FALSE, fileEncoding = "UTF-8")

# Pomocnicza funkcja: wszystko, co trafia na slajd, dla jednej zmiennej zależnej
na_slajd <- function(y, g) {
  m <- tapply(y, g, mean); s <- tapply(y, g, sd); k <- tapply(y, g, length)
  tw <- t.test(y[g == "Trening"], y[g == "Kontrolna"])          # Welch: Trening − Kontrolna
  d <- cohens_d(y[g == "Trening"], y[g == "Kontrolna"], ci = 0.95)
  data.frame(M_kontr = m[[1]], SD_kontr = s[[1]], M_tren = m[[2]], SD_tren = s[[2]],
             roznica = unname(diff(m)), CI_dol = tw$conf.int[1], CI_gor = tw$conf.int[2],
             t = unname(tw$statistic), df = unname(tw$parameter), p = tw$p.value,
             d = d$Cohens_d, d_dol = d$CI_low, d_gor = d$CI_high)
}
wyniki <- rbind(lek = na_slajd(dane$lek, dane$grupa), egzamin = na_slajd(dane$egzamin, dane$grupa))
print(round(wyniki, 3))

# Korelacja lęku z wynikiem egzaminu (cała próba)
kor <- cor.test(dane$lek, dane$egzamin)
round(c(r = unname(kor$estimate), CI_dol = kor$conf.int[1], CI_gor = kor$conf.int[2],
        df = unname(kor$parameter), p = kor$p.value), 3)

# „Wydruk” w układzie tabeli Independent Samples Test (Levene liczony ze średniej, test t
# przy równych i nierównych wariancjach) – tak wygląda slajd zrobiony z wydruku programu
levene <- function(y, g) {
  z <- abs(y - ave(y, g))
  a <- anova(lm(z ~ g)); c(F = a$`F value`[1], p = a$`Pr(>F)`[1])
}
wydruk <- do.call(rbind, lapply(c("lek", "egzamin"), function(v) {
  y <- dane[[v]]; g <- dane$grupa; L <- levene(y, g)
  do.call(rbind, lapply(c(TRUE, FALSE), function(rowne) {
    tt <- t.test(y[g == "Kontrolna"], y[g == "Trening"], var.equal = rowne)
    data.frame(zmienna = v, wariant = if (rowne) "Equal variances assumed" else "Equal variances not assumed",
               F = if (rowne) L[["F"]] else NA, Sig = if (rowne) L[["p"]] else NA,
               t = unname(tt$statistic), df = unname(tt$parameter), p = tt$p.value,
               roznica = unname(tt$estimate[1] - tt$estimate[2]), SE = tt$stderr,
               dol = tt$conf.int[1], gor = tt$conf.int[2])
  }))
}))
print(wydruk, digits = 4)
cat("Liczb w tabeli wydruku:", sum(!is.na(as.matrix(wydruk[, c("F", "Sig", "t", "df", "p", "roznica", "SE", "dol", "gor")]))), "\n")
Wynik w R
        M_kontr SD_kontr M_tren SD_tren roznica CI_dol CI_gor      t      df     p      d  d_dol
lek       3.275    0.705  2.818   0.742  -0.457 -0.718 -0.195 -3.458 117.689 0.001 -0.631 -0.997
egzamin  23.583    5.729 23.683   5.616   0.100 -1.951  2.151  0.097 117.953 0.923  0.018 -0.340
         d_gor
lek     -0.263
egzamin  0.375
      r  CI_dol  CI_gor      df       p
 -0.121  -0.294   0.059 118.000   0.188
  zmienna                     wariant        F    Sig        t    df         p roznica     SE
1     lek     Equal variances assumed 0.000516 0.9819  3.45765 118.0 0.0007586  0.4568 0.1321
2     lek Equal variances not assumed       NA     NA  3.45765 117.7 0.0007592  0.4568 0.1321
3 egzamin     Equal variances assumed 0.040827 0.8402 -0.09655 118.0 0.9232481 -0.1000 1.0357
4 egzamin Equal variances not assumed       NA     NA -0.09655 118.0 0.9232482 -0.1000 1.0357
      dol    gor
1  0.1952 0.7185
2  0.1952 0.7185
3 -2.1510 1.9510
4 -2.1511 1.9511
Liczb w tabeli wydruku: 32
2. Rysunki: dwa slajdy „źle / dobrze”
R
# B241 – rysunki do wpisu /blog/prezentacja-wynikow-na-obronie/
# Dwa porównania „źle / dobrze”: slajd z wynikiem istotnym i slajd z wynikiem nieistotnym.
# Uruchomienie z folderu kod/: LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b241-rysunki.R > b241-rysunki-wynik.txt
suppressPackageStartupMessages({ library(ggplot2); library(patchwork); library(svglite) })
KOLORY <- c(akcent = "#e50101", drugi = "#1f78b4", granat = "#0f1d3a")
zapisz_svg <- function(wykres, plik, szer = 10, wys = 5.6) {
  svglite::svglite(plik, width = szer, height = wys, bg = "white"); print(wykres); invisible(grDevices::dev.off())
  cat(sprintf("Zapisano %s: width=\"%d\" height=\"%d\"\n", plik, round(szer * 100), round(wys * 100)))
}
# Wygląd slajdu 16:9: ramka, duży tytuł-teza, mało elementów
theme_slajd <- function(base_size = 13) {
  theme_minimal(base_size = base_size) +
    theme(plot.title = element_text(face = "bold", colour = KOLORY[["granat"]], size = rel(1.12), margin = margin(b = 4)),
          plot.subtitle = element_text(colour = "grey25", size = rel(0.82), margin = margin(b = 6)),
          plot.caption = element_text(colour = "grey15", size = rel(0.78), hjust = 0, margin = margin(t = 6)),
          plot.caption.position = "plot", plot.title.position = "plot",
          panel.grid.minor = element_blank(), panel.grid.major.x = element_blank(),
          panel.grid.major.y = element_line(colour = "grey90", linewidth = 0.4),
          axis.title = element_text(colour = "grey20", size = rel(0.85)), axis.text = element_text(colour = "grey20"),
          legend.position = "none",
          plot.background = element_rect(fill = "white", colour = "grey55", linewidth = 0.8),
          plot.margin = margin(12, 16, 10, 14))
}
# Pasek z oceną nad parą slajdów: „ŹLE” albo „DOBRZE”
etykieta <- function(tekst, kolor) {
  ggplot() + annotate("text", x = 0, y = 0.5, label = tekst, hjust = 0, fontface = "bold", colour = kolor, size = 5.2) +
    xlim(0, 1) + theme_void() + theme(plot.margin = margin(0, 0, 0, 4))
}
para <- function(zle, dobrze, opis_zle, opis_dobrze) {
  (etykieta(opis_zle, KOLORY[["akcent"]]) | etykieta(opis_dobrze, KOLORY[["drugi"]])) /
    (wrap_elements(full = zle) | wrap_elements(full = dobrze)) + plot_layout(heights = c(0.07, 1))
}
f2 <- function(x, k = 2) sub("^-", "\u2212", formatC(x, format = "f", digits = k))   # minus typograficzny
pdf(NULL)
invisible(capture.output(source("b241-1-wyniki.R")))
L <- wyniki["lek", ]; E <- wyniki["egzamin", ]

# ---------- Rysunek 1, ŹLE: tabela przepisana z wydruku (przecinki, trzy miejsca, angielskie nagłówki)
kolumny <- c("F", "Sig.", "t", "df", "Sig.\n(2-tailed)", "Mean\nDifference", "Std. Error\nDifference", "95% CI\nLower", "95% CI\nUpper")
liczby <- as.matrix(wydruk[, c("F", "Sig", "t", "df", "p", "roznica", "SE", "dol", "gor")])
tekst_kom <- ifelse(is.na(liczby), "", sub("\\.", ",", formatC(liczby, format = "f", digits = 3)))
siatka <- expand.grid(w = seq_len(nrow(liczby)), k = seq_len(ncol(liczby)))
siatka$lab <- tekst_kom[cbind(siatka$w, siatka$k)]
x_kol <- 2.55 + (seq_along(kolumny) - 1) * 0.86
wiersze <- paste(c("lęk", "", "egzamin", ""), c("Equal variances\nassumed", "Equal variances\nnot assumed"))
zle1 <- ggplot() +
  annotate("rect", xmin = 0, xmax = 10.3, ymin = 0.4, ymax = 6.1, fill = "grey96", colour = "grey60") +
  annotate("text", x = x_kol, y = 5.55, label = kolumny, size = 2.15, lineheight = 0.9, fontface = "bold") +
  annotate("text", x = 0.12, y = 4.6 - (0:3) * 1.05, label = wiersze, size = 2.15, hjust = 0, lineheight = 0.9) +
  geom_text(data = siatka, aes(x = x_kol[k], y = 4.6 - (w - 1) * 1.05, label = lab), size = 2.3) +
  annotate("text", x = 0, y = 0.12, hjust = 0, size = 2.3, colour = "grey30",
           label = "* Sig. < 0,05   ** Sig. < 0,01   Levene's Test for Equality of Variances   t-test for Equality of Means") +
  coord_cartesian(xlim = c(0, 10.3), ylim = c(-0.2, 6.3), expand = FALSE) +
  labs(title = "Wyniki", subtitle = "Independent Samples Test – lęk i egzamin") +
  theme_slajd() + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid = element_blank())

# ---------- Rysunek 1, DOBRZE: teza w tytule, dane osób, średnie z 95% CI, jedna linijka statystyk
sr <- do.call(rbind, lapply(split(dane$lek, dane$grupa), function(y) {
  ci <- t.test(y)$conf.int; data.frame(M = mean(y), dol = ci[1], gor = ci[2]) }))
sr$grupa <- factor(rownames(sr), levels = levels(dane$grupa))
set.seed(1)
dobrze1 <- ggplot(dane, aes(grupa, lek)) +
  geom_jitter(width = 0.13, height = 0, colour = "grey65", size = 1.3, alpha = 0.8) +
  geom_errorbar(data = sr, aes(y = M, ymin = dol, ymax = gor), width = 0.09, linewidth = 1, colour = KOLORY[["akcent"]]) +
  geom_point(data = sr, aes(y = M), size = 3.4, colour = KOLORY[["akcent"]]) +
  geom_text(data = sr, aes(y = M, label = paste0("M = ", f2(M))), nudge_x = 0.3, size = 4, colour = KOLORY[["granat"]], fontface = "bold") +
  scale_x_discrete(labels = c("Kontrolna" = "Grupa kontrolna\n(n = 60)", "Trening" = "Trening relaksacji\n(n = 60)")) +
  scale_y_continuous(limits = c(1, 5), breaks = 1:5) +
  labs(title = sprintf("Po treningu lęk przed egzaminem był niższy o %s pkt", f2(-L$roznica)),
       subtitle = "Lęk przed egzaminem (1–5); szare punkty – osoby, czerwone – średnie z 95% CI",
       caption = sprintf("t(%s) = %s, p < .001; d = %s, 95%% CI [%s, %s]",
                         f2(L$df, 1), f2(L$t), f2(L$d), f2(L$d_dol), f2(L$d_gor)),
       x = NULL, y = "Lęk") +
  theme_slajd()
r1 <- para(zle1, dobrze1, "ŹLE: wydruk przepisany na slajd", "DOBRZE: jedna teza, jeden wykres")
zapisz_svg(r1, "../obrona-slajd-wynik-istotny.svg", szer = 12, wys = 4.5)

# ---------- Rysunek 2, ŹLE: słupki średnich, „n.s.” i błędny wniosek
srE <- aggregate(egzamin ~ grupa, dane, mean)
zle2 <- ggplot(srE, aes(grupa, egzamin)) +
  geom_col(fill = c("#9ecae1", "#fdae6b"), width = 0.6) +
  annotate("segment", x = 1, xend = 2, y = 27, yend = 27) +
  annotate("text", x = 1.5, y = 29, label = "n.s.", size = 6, fontface = "bold") +
  annotate("label", x = 1.5, y = 12, size = 3.6, fill = "white",
           label = "brak istotności → hipoteza H2 odrzucona\ntrening NIE wpływa na wynik egzaminu!") +
  scale_y_continuous(limits = c(0, 32)) +
  labs(title = "H2 – NIEISTOTNE", subtitle = "Średni wynik egzaminu", x = NULL, y = NULL) +
  theme_slajd()

# ---------- Rysunek 2, DOBRZE: wielkość efektu z 95% CI dla obu wyników, linia zera
ef <- data.frame(wynik = factor(c("H1: lęk przed egzaminem", "H2: wynik egzaminu"),
                                levels = c("H2: wynik egzaminu", "H1: lęk przed egzaminem")),
                 d = c(L$d, E$d), dol = c(L$d_dol, E$d_dol), gor = c(L$d_gor, E$d_gor))
ef$lab <- sprintf("d = %s [%s, %s]", f2(ef$d), f2(ef$dol), f2(ef$gor))
dobrze2 <- ggplot(ef, aes(d, wynik)) +
  geom_vline(xintercept = 0, colour = "grey40", linetype = 2) +
  geom_errorbar(aes(xmin = dol, xmax = gor), width = 0.12, orientation = "y", linewidth = 1, colour = KOLORY[["drugi"]]) +
  geom_point(size = 3.4, colour = KOLORY[["drugi"]]) +
  geom_label(aes(x = gor + 0.06, label = lab), hjust = 0, size = 3.7, colour = KOLORY[["granat"]],
             fill = "white", linewidth = 0, label.padding = unit(0.12, "lines")) +
  annotate("text", x = c(-1.15, 1.45), y = 0.45, hjust = c(0, 1), size = 3.1, colour = "grey35",
           label = c("← niżej w grupie treningu", "wyżej w grupie treningu →")) +
  scale_x_continuous(limits = c(-1.15, 1.45), breaks = seq(-1, 1, 0.5), labels = f2(seq(-1, 1, 0.5), 1)) +
  scale_y_discrete(expand = expansion(add = c(0.65, 0.55))) +
  labs(title = "Lęk spadł; różnicy w wyniku egzaminu nie wykazano",
       subtitle = "d Cohena z 95% CI (trening − kontrola), n = 60 w grupie",
       caption = sprintf("Egzamin: różnica %s pkt, 95%% CI [%s, %s] na skali 0–40; t(%s) = %s, p = .%s",
                         f2(E$roznica, 1), f2(E$CI_dol, 1), f2(E$CI_gor, 1), f2(E$df, 1), f2(E$t),
                         sub("^0\\.", "", f2(E$p, 3))),
       x = "d Cohena", y = NULL) +
  theme_slajd() + theme(panel.grid.major.y = element_blank(), panel.grid.major.x = element_line(colour = "grey90"))
r2 <- para(zle2, dobrze2, "ŹLE: „n.s.” i wniosek o braku wpływu", "DOBRZE: efekt z przedziałem ufności")
zapisz_svg(r2, "../obrona-slajd-wynik-nieistotny.svg", szer = 12, wys = 4.5)
print(ef[, c("wynik", "lab")], row.names = FALSE)
Wynik w R
Zapisano ../obrona-slajd-wynik-istotny.svg: width="1200" height="450"
Zapisano ../obrona-slajd-wynik-nieistotny.svg: width="1200" height="450"
                   wynik                      lab
 H1: lęk przed egzaminem d = −0.63 [−1.00, −0.26]
      H2: wynik egzaminu   d = 0.02 [−0.34, 0.38]
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki powstały w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Ile slajdów z wynikami przygotować na obronę pracy dyplomowej?
Nie ma jednej normy, bo czas wystąpienia ustala regulamin lub promotor. Praktyczna reguła to jeden slajd na każdą hipotezę albo pytanie badawcze, do tego slajd o próbie i schemacie, slajd podsumowujący i kilka slajdów zapasowych z założeniami i pełnymi tabelami, które pokazujesz tylko na pytanie komisji. Przy wielu hipotezach podobnego typu pokaż ich wielkości efektu na jednym wykresie.
Czy na slajd z wynikami można wkleić tabelę z SPSS?
Lepiej nie. Wydruk testu t dla dwóch zmiennych to w naszym przykładzie 32 liczby z trzema miejscami po przecinku, angielskie nagłówki i dwa warianty testu, z których mówisz o jednym. Przepisz na slajd tylko 3–5 potrzebnych wartości w zapisie APA, a pełną tabelę zostaw w pracy albo na slajdzie zapasowym.
Jak pokazać na prezentacji hipotezę, która się nie potwierdziła?
Daj jej własny slajd i pokaż wielkość efektu z 95% przedziałem ufności, np. d = 0.02 [−0.34, 0.38]. Powiedz, że nie wykazano różnicy, i wyjaśnij, jakie efekty są zgodne z danymi. Nie pisz „n.s.” ani „trening nie działa”: wynik nieistotny nie dowodzi braku efektu, a szeroki przedział pokazuje, że przy tej liczebności nie da się go wykluczyć.
Jaki wykres wybrać na slajd z porównaniem dwóch grup?
Przy zmiennej ilościowej pokaż wyniki osób jako punkty, a na nich średnie z 95% CI, na osi obejmującej całą skalę. Taki wykres pokazuje różnicę i to, jak bardzo grupy się nakładają. Słupki samych średnich ukrywają rozkład, a oglądający uznają wartości wewnątrz słupka za bardziej prawdopodobne niż ponad nim (Newman i Scholl, 2012).
Czy na slajdach z wynikami trzeba podawać stopnie swobody i wartość p?
Wystarczy jedna linijka u dołu slajdu: statystyka testu ze stopniami swobody, p i wielkość efektu z przedziałem ufności, zaokrąglone do znaczących cyfr, np. t(117.7) = −3.46, p < .001, d = −0.63. Najważniejszy jest tytuł z wnioskiem i wykres. Pełny zapis APA jest w pracy, a na slajd trafia tylko to, o czym mówisz.
Powiązane hasła
Przeczytaj też
Pytania na obronie z metodologii i statystyki
38 pytań komisji o hipotezy, schemat, próbę, narzędzia, analizy i wyniki – z przykładowymi odpowiedziami, ściągą na jedną stronę i planem przygotowania.
Czytaj →PoradnikJak opisać wynik nieistotny
Co podać przy p > .05, jak odróżnić brak efektu od wyniku nierozstrzygającego, sformułowania źle i dobrze oraz gotowy wzór opisu w stylu APA.
Czytaj →PoradnikWykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →Przygotowujesz slajdy z wynikami na obronę?
Sprawdzimy, czy liczby na slajdach zgadzają się z pracą, dobierzemy wykresy do hipotez i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je przedstawić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Cole, T. J. (2015). Too many digits: The presentation of numerical data. Archives of Disease in Childhood, 100(7), 608–609. https://doi.org/10.1136/archdischild-2014-307149 ● Otwarty dostęp
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Cumming, G., Fidler, F., & Vaux, D. L. (2007). Error bars in experimental biology. Journal of Cell Biology, 177(1), 7–11. https://doi.org/10.1083/jcb.200611141 ● Otwarty dostęp
- Gelman, A., Pasarica, C., & Dodhia, R. (2002). Let's practice what we preach: Turning tables into graphs. The American Statistician, 56(2), 121–130. https://doi.org/10.1198/000313002317572790
- Kosslyn, S. M., Kievit, R. A., Russell, A. G., & Shephard, J. M. (2012). PowerPoint® presentation flaws and failures: A psychological analysis. Frontiers in Psychology, 3, Article 230. https://doi.org/10.3389/fpsyg.2012.00230 ● Otwarty dostęp
- Mayer, R. E., & Moreno, R. (2003). Nine ways to reduce cognitive load in multimedia learning. Educational Psychologist, 38(1), 43–52. https://doi.org/10.1207/s15326985ep3801_6
- Newman, G. E., & Scholl, B. J. (2012). Bar graphs depicting averages are perceptually misinterpreted: The within-the-bar bias. Psychonomic Bulletin & Review, 19(4), 601–607. https://doi.org/10.3758/s13423-012-0247-5 ● Otwarty dostęp
- Rougier, N. P., Droettboom, M., & Bourne, P. E. (2014). Ten simple rules for better figures. PLoS Computational Biology, 10(9), Article e1003833. https://doi.org/10.1371/journal.pcbi.1003833 ● Otwarty dostęp
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), Article e1002128. https://doi.org/10.1371/journal.pbio.1002128 ● Otwarty dostęp
Cytowania BibTeX
@article{cleveland1984graphical, author={Cleveland, William S. and McGill, Robert}, title={{Graphical perception: Theory, experimentation, and application to the development of graphical methods}}, journal={Journal of the American Statistical Association}, year={1984}, volume={79}, number={387}, pages={531--554}, doi={10.1080/01621459.1984.10478080}}@article{cole2015too, author={Cole, T. J.}, title={{Too many digits: The presentation of numerical data}}, journal={Archives of Disease in Childhood}, year={2015}, volume={100}, number={7}, pages={608--609}, doi={10.1136/archdischild-2014-307149}}@article{cumming2014new, author={Cumming, Geoff}, title={{The new statistics: Why and how}}, journal={Psychological Science}, year={2014}, volume={25}, number={1}, pages={7--29}, doi={10.1177/0956797613504966}}@article{cumming2007error, author={Cumming, Geoff and Fidler, Fiona and Vaux, David L.}, title={{Error bars in experimental biology}}, journal={Journal of Cell Biology}, year={2007}, volume={177}, number={1}, pages={7--11}, doi={10.1083/jcb.200611141}}@article{gelman2002lets, author={Gelman, Andrew and Pasarica, Cristian and Dodhia, Rahul}, title={{Let's practice what we preach: Turning tables into graphs}}, journal={The American Statistician}, year={2002}, volume={56}, number={2}, pages={121--130}, doi={10.1198/000313002317572790}}@article{kosslyn2012powerpoint, author={Kosslyn, Stephen M. and Kievit, Rogier A. and Russell, Alexandra G. and Shephard, Jennifer M.}, title={{PowerPoint® presentation flaws and failures: A psychological analysis}}, journal={Frontiers in Psychology}, year={2012}, volume={3}, eid={230}, doi={10.3389/fpsyg.2012.00230}}@article{mayer2003nine, author={Mayer, Richard E. and Moreno, Roxana}, title={{Nine ways to reduce cognitive load in multimedia learning}}, journal={Educational Psychologist}, year={2003}, volume={38}, number={1}, pages={43--52}, doi={10.1207/s15326985ep3801_6}}@article{newman2012bar, author={Newman, George E. and Scholl, Brian J.}, title={{Bar graphs depicting averages are perceptually misinterpreted: The within-the-bar bias}}, journal={Psychonomic Bulletin \& Review}, year={2012}, volume={19}, number={4}, pages={601--607}, doi={10.3758/s13423-012-0247-5}}@article{rougier2014ten, author={Rougier, Nicolas P. and Droettboom, Michael and Bourne, Philip E.}, title={{Ten simple rules for better figures}}, journal={PLoS Computational Biology}, year={2014}, volume={10}, number={9}, eid={e1003833}, doi={10.1371/journal.pcbi.1003833}}@article{weissgerber2015beyond, author={Weissgerber, Tracey L. and Milic, Natasa M. and Winham, Stacey J. and Garovic, Vesna D.}, title={{Beyond bar and line graphs: Time for a new data presentation paradigm}}, journal={PLOS Biology}, year={2015}, volume={13}, number={4}, eid={e1002128}, doi={10.1371/journal.pbio.1002128}}