Metodologia badań – zadania z rozwiązaniami: jak korzystać ze zbioru
Na zajęciach z metodologii badań rzadko się liczy, za to często trzeba coś rozpoznać, nazwać albo poprawić: zmienne, schemat, zagrożenie trafności, hipotezę. Te same umiejętności przydają się potem w pracy dyplomowej. Poniżej znajdziesz metodologię badań w zadaniach z rozwiązaniami: dziesięć krótkich opisów badań z psychologii, pielęgniarstwa, pedagogiki, zarządzania i fizjoterapii, każdy z poleceniem jak na kolokwium.
Każde zadanie ma ten sam układ: opis badania i polecenie, wzorcowe rozwiązanie, krótka interpretacja i jeden typowy błąd. Nieliczne rachunki (zadania 3, 4, 7 i 9) i symulację do zadania 8 sprawdziliśmy w R – kod jest na końcu wpisu. Najpierw odpowiedz sam(a). Pojęcia i schematy są standardowe; szerzej opisują je podręczniki metodologii (Brzeziński, 2019) i klasyczna praca o schematach eksperymentalnych i quasi-eksperymentalnych (Shadish i in., 2002).
| Zadanie | Dziedzina i historyjka | Co robisz |
|---|---|---|
| 1 | pielęgniarstwo: film edukacyjny przed operacją | nazywasz zmienne niezależne, zależne i kontrolne oraz skale pomiaru |
| 2 | sześć krótkich opisów z różnych dziedzin | rozpoznajesz schemat badania |
| 3 | pedagogika: program czytelniczy w jednej klasie | wskazujesz zagrożenia trafności wewnętrznej i poprawki |
| 4 | pedagogika: zajęcia wyrównawcze dla najsłabszych | liczysz oczekiwaną regresję do średniej |
| 5 | zarządzanie: cztery hipotezy z planu pracy | poprawiasz hipotezy i pytania badawcze |
| 6 | fizjoterapia: przestrzeganie zaleceń w ćwiczeniach domowych | operacjonalizujesz konstrukt |
| 7 | zarządzanie: ankieta w sieci sklepów | oceniasz dobór próby, zakres uogólnienia, dobór i przydział losowy |
| 8 | psychologia zdrowia: aktywność seniorów i objawy depresyjne | rozróżniasz zakłócacz, mediator i moderator |
| 9 | zarządzanie: szkolenia a zaangażowanie | oceniasz wniosek przyczynowy z badania korelacyjnego |
| 10 | pięć hipotez z różnych prac | dobierasz test statystyczny |
Dane z symulacji do zadania 8 możesz pobrać w pliku metodologia-badan-zadania-dane.csv (kolumny: struktura, id, X, Z, Y; 300 osób w każdej z trzech struktur). Sprawdzisz w nim, jak zmienia się współczynnik po dodaniu Z do regresji. Definicje pojęć, o które pytają na obronie, zebraliśmy we wpisie pytania z metodologii badań naukowych na obronę.
Zadanie 1. Zmienne i skale pomiaru w badaniu pielęgniarskim
Treść zadania
Studentka pielęgniarstwa bada 80 pacjentów przed planową operacją. Połowa oddziałów pokazuje pacjentom 10-minutowy film o przebiegu zabiegu i znieczulenia, druga połowa daje standardową rozmowę z pielęgniarką. Godzinę przed zabiegiem pacjent ocenia lęk na skali NRS 0–10, a po operacji zapisuje się liczbę dawek leku przeciwbólowego podanych w ciągu doby. W analizie uwzględniono wiek (w latach), płeć, rodzaj operacji (ortopedyczna, brzuszna, ginekologiczna) i wykształcenie (podstawowe, średnie, wyższe). Polecenie: (a) wskaż zmienną niezależną, zmienne zależne i kontrolne; (b) dla każdej zmiennej podaj skalę pomiaru.
Rozwiązanie
(a) Rola zmiennych. Zmienna niezależna to forma edukacji przedoperacyjnej (film albo rozmowa) – to ją badaczka uważa za przyczynę różnic. Zmienne zależne to lęk przed zabiegiem i liczba dawek leku przeciwbólowego, czyli skutki, które mierzy. Wiek, płeć, rodzaj operacji i wykształcenie to zmienne kontrolne: nie są przedmiotem hipotezy, ale mogą wpływać na lęk i ból, więc uwzględnia się je w analizie.
| Zmienna | Rola | Skala pomiaru |
|---|---|---|
| forma edukacji (film / rozmowa) | niezależna | nominalna (dwie kategorie) |
| lęk NRS 0–10 | zależna | porządkowa (w praktyce często traktowana jak ilościowa) |
| liczba dawek leku | zależna | ilorazowa (zliczenia z naturalnym zerem) |
| wiek w latach | kontrolna | ilorazowa |
| płeć | kontrolna | nominalna |
| rodzaj operacji | kontrolna | nominalna (trzy kategorie) |
| wykształcenie | kontrolna | porządkowa |
Interpretacja
Zmienna nie ma roli „na zawsze”: o tym, czy jest niezależna, zależna czy kontrolna, decyduje pytanie badawcze. Ta sama liczba dawek leku może być zmienną zależną tutaj, a zmienną kontrolną w badaniu o czasie pobytu w szpitalu. Skala pomiaru wynika natomiast z tego, jak zmienną zmierzono, i ogranicza wybór statystyk. Andrade (2021) na przykładach klinicznych pokazuje, że od klasyfikacji zmiennych i ich operacjonalizacji zaczyna się projektowanie całego badania.
Typowy błąd
Uznanie wieku, płci i rodzaju operacji za zmienne niezależne „bo też mogą wpływać na lęk”. Mogą, ale hipoteza ich nie dotyczy – gdybyś nazwał(a) je niezależnymi, praca miałaby nagle cztery dodatkowe hipotezy do sprawdzenia i opisania.
Zadanie 2. Rozpoznaj schemat badania
Treść zadania
Dla każdego opisu podaj schemat badania i jedno zdanie uzasadnienia.
- (a) Fizjoterapia: 60 pacjentów po endoprotezoplastyce stawu kolanowego losowo przydzielono do rehabilitacji z grą ruchową lub do rehabilitacji standardowej; po 4 tygodniach zmierzono zakres zgięcia kolana.
- (b) Pedagogika: w jednej szkole wprowadzono program przeciwdziałania przemocy rówieśniczej, w drugiej, podobnej szkole – nie; uczniowie obu szkół wypełnili ankietę we wrześniu i w czerwcu.
- (c) Psychologia: 400 studentów jeden raz wypełniło skale perfekcjonizmu i prokrastynacji.
- (d) Pielęgniarstwo: te same 150 pielęgniarek co 6 miesięcy przez 2 lata ocenia satysfakcję z pracy i zamiar odejścia z zawodu.
- (e) Zarządzanie: w jednym badaniu porównano zaangażowanie pracowników w wieku 20–29, 30–39 i 40–49 lat; autor wnioskuje, że „zaangażowanie spada z wiekiem”.
- (f) Pielęgniarstwo: pacjenci z cukrzycą wypełnili test wiedzy przed i po trzech spotkaniach edukacyjnych; grupy porównawczej nie było.
Rozwiązanie
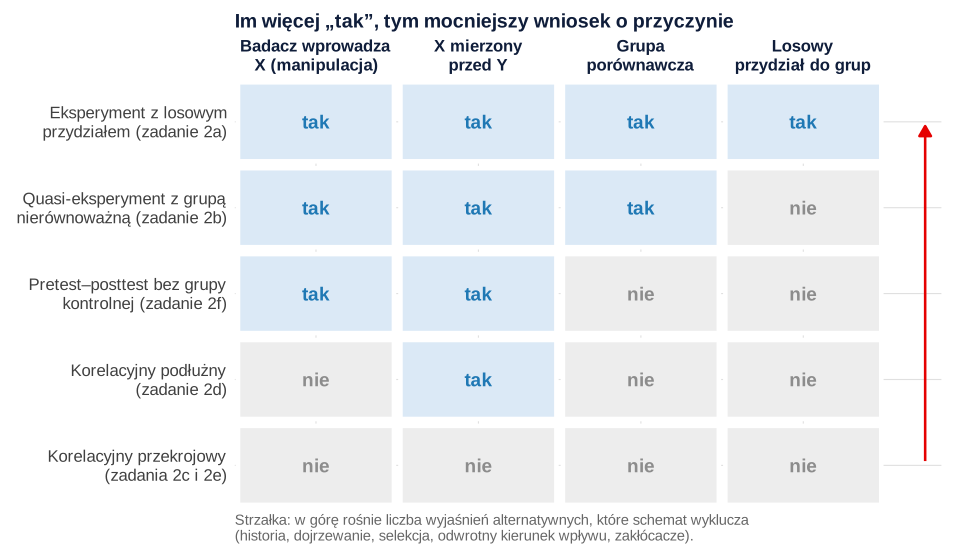
(a) Eksperyment (badanie z randomizacją, schemat międzyobiektowy): badacz wprowadza warunki i losowo decyduje, kto do którego trafia. (b) Quasi-eksperyment z nierównoważną grupą kontrolną i pomiarem przed i po: jest interwencja i grupa porównawcza, ale szkoły nie zostały wylosowane do warunków. (c) Schemat korelacyjny przekrojowy: brak manipulacji, jeden pomiar. (d) Schemat korelacyjny podłużny (panelowy): te same osoby w kilku pomiarach, bez manipulacji. (e) Schemat przekrojowy: grupy wiekowe porównane w jednym momencie; wniosek o „spadku z wiekiem” miesza efekt wieku z efektem pokolenia, bo nie śledzono tych samych osób w czasie. (f) Pretest–posttest bez grupy kontrolnej (schemat przedeksperymentalny): jest interwencja i dwa pomiary, ale nie ma z czym porównać zmiany.
Interpretacja
Rozpoznając schemat, pytasz: czy badacz wprowadził X, czy jest grupa porównawcza i kto decydował o przynależności do grup. Od tego zależy, jak mocno wolno pisać o przyczynie.
Typowy błąd
Nazwanie badania (b) eksperymentem, „bo jest grupa kontrolna”. Grupa kontrolna to za mało – bez losowego przydziału szkoły mogły różnić się już we wrześniu, np. klimatem albo liczbą konfliktów.
Zadanie 3. Zagrożenia trafności wewnętrznej w badaniu przed–po
Treść zadania
Nauczycielka prowadzi w swojej klasie trzeciej roczny program „Czytam z pasją”. We wrześniu i w czerwcu uczniowie piszą ten sam test rozumienia tekstu; średni wynik wzrósł z 18 do 24 punktów (na 40). W tym roku gmina otworzyła w szkole nową bibliotekę z kącikiem dla dzieci. Do czerwca troje uczniów z najsłabszymi wynikami zmieniło szkołę. Nauczycielka wnioskuje, że program poprawia rozumienie tekstu. Polecenie: wskaż co najmniej cztery zagrożenia trafności wewnętrznej i do każdego zaproponuj poprawkę planu badania.
Rozwiązanie
| Zagrożenie | Co w opisie na nie wskazuje | Poprawka |
|---|---|---|
| historia | nowa biblioteka w tym samym roku | klasa porównawcza z tej samej szkoły, bez programu |
| dojrzewanie | dzieci przez rok same uczą się czytać lepiej | grupa porównawcza w tym samym wieku albo wyniki odniesione do norm dla klasy i miesiąca badania |
| efekt testowania | ten sam test dwa razy – dzieci pamiętają teksty i pytania | dwie równoległe wersje testu, przydzielone losowo do pomiarów |
| ubytek (selektywny) | odeszło troje najsłabszych, więc średnia w czerwcu rośnie „sama” | analiza uczniów z oboma pomiarami i opis, kto odpadł |
| efekt oczekiwań | test ocenia nauczycielka, która prowadzi program | ocena testów przez osobę nieznającą klasy i terminu pomiaru |
Ubytek widać już w liczbach. Jeśli klasa liczyła 25 osób, a troje uczniów, którzy odeszli, miało we wrześniu po 8 punktów, to średnia wrześniowa 22 uczniów, którzy zostali, wynosiła 19.36, a nie 18. U tych samych dzieci wzrost to 4.64 punktu zamiast 6.00 – część „efektu” wynikała tylko ze zmiany składu klasy. Najmocniejszą poprawką jest grupa porównawcza: historia, dojrzewanie i testowanie działają wtedy w obu klasach i znoszą się przy porównaniu zmian.
Interpretacja
Wzrost o 6 punktów jest faktem, ale schemat nie pozwala przypisać go programowi. W pracy napiszesz uczciwie: „wyniki w teście rozumienia tekstu wzrosły w czasie trwania programu”, a w ograniczeniach wymienisz zagrożenia z tabeli. Klasyczne omówienie tych zagrożeń (historia, dojrzewanie, testowanie, instrumentacja, regresja do średniej, selekcja, ubytek) znajdziesz w podręczniku Shadisha i in. (2002).
Typowy błąd
Wypisanie samych nazw zagrożeń bez wskazania, co w opisie badania je uruchamia. Na kolokwium i w recenzji liczy się powiązanie: „historia – bo w tym samym roku otwarto bibliotekę”.
Zadanie 4. Regresja do średniej: ile poprawy to złudzenie
Treść zadania
Szkoła skierowała na semestralne zajęcia wyrównawcze z matematyki 18 uczniów z wynikiem T ≤ 37 w październikowym teście (normy dla klasy i miesiąca: M = 50, SD = 10; rzetelność test–retest po trzech miesiącach r = .70). Średnia grupy w październiku wynosiła 33.0, a w styczniu 41.0. Dyrekcja chce ogłosić, że zajęcia podniosły wyniki o 8 punktów. Polecenie: (a) oblicz, jakiej średniej w styczniu należałoby się spodziewać, gdyby zajęcia nic nie dały; (b) jaka część poprawy to regresja do średniej; (c) jak zaplanować ocenę zajęć w kolejnym roku?
Rozwiązanie
(a) Wzór. Gdy grupę wybrano po skrajnym wyniku pierwszego pomiaru, jej oczekiwana średnia w drugim pomiarze przesuwa się ku średniej populacji proporcjonalnie do 1 − r:
(b) Rozkład zmiany. Obserwowana zmiana: 41.0 − 33.0 = 8.0 punktu. Zmiana oczekiwana z samej regresji do średniej: 38.1 − 33.0 = 5.1 punktu, czyli 63.8% obserwowanej poprawy. Na ewentualny wpływ zajęć zostaje 2.9 punktu. Przy rzetelności .90 oczekiwana średnia wyniosłaby tylko 34.7.
Sprawdzenie symulacją. W R wygenerowaliśmy 100 000 uczniów bez żadnych zajęć, każdy ze stałym poziomem umiejętności i dwoma pomiarami z błędem (korelacja .70). Wybrano 9693 uczniów (9.7%) z wynikiem ≤ 37: ich średnia wynosiła 32.35, a w drugim pomiarze 37.72 – prawie dokładnie tyle, ile daje wzór (37.67). „Poprawiło się” 77.1% wybranych uczniów, choć nikt nie dostał żadnej pomocy.
(c) Plan na kolejny rok. Wśród uczniów zakwalifikowanych tym samym kryterium wylosuj połowę na zajęcia od razu, a połowę na zajęcia w drugim semestrze (grupa kontrolna z listy oczekujących). Regresja do średniej działa wtedy jednakowo w obu grupach i odpada przy porównaniu. Pomaga też kwalifikacja po średniej z dwóch testów.
Interpretacja
Co najmniej 5 z 8 punktów poprawy pojawiłoby się bez zajęć. Barnett i in. (2005) opisują to zjawisko jako naturalną zmienność powtarzanych pomiarów, która wygląda jak prawdziwa zmiana, zwłaszcza gdy analizuje się podgrupę wybraną po wyniku wyjściowym; ograniczać je trzeba planem badania.
Typowy błąd
Uznanie, że skoro wyniki odnosi się do norm (M = 50 w każdym miesiącu), to wzrost średniej musi być efektem zajęć. Normy usuwają dojrzewanie, ale nie regresję do średniej – ta wynika z błędu pomiaru i z tego, że uczniów wybrano po skrajnym wyniku.
Zadanie 5. Popraw hipotezy i pytania badawcze
Treść zadania
Student zarządzania planuje ankietę wśród 200 pracowników firm usługowych. W konspekcie zapisał: H1: „Styl przywództwa ma wpływ na pracowników”. H2: „Większość pracowników jest niezadowolona z wynagrodzenia”. H3: „Praca zdalna powoduje wzrost produktywności”. H4: „Nie ma różnicy w wypaleniu między kobietami a mężczyznami”. Polecenie: oceń każdą hipotezę i zapisz jej poprawioną wersję albo zamień ją na pytanie badawcze.
Rozwiązanie
| Hipoteza | Problem | Poprawiona wersja |
|---|---|---|
| H1 | nie wiadomo, jaki styl, na co i w którą stronę; „wpływ” w badaniu ankietowym | „Im wyżej pracownicy oceniają przywództwo transformacyjne przełożonego, tym wyższe jest ich zaangażowanie w pracę.” |
| H2 | to opis jednej zmiennej, a nie związek; brak progu „niezadowolenia” | pytanie badawcze: „Jaki odsetek pracowników ocenia wynagrodzenie jako niezadowalające (odpowiedzi 1–2 na skali 1–5)?” |
| H3 | słowo „powoduje” nie pasuje do jednorazowej ankiety; „produktywność” bez miary | „Pracownicy pracujący zdalnie co najmniej 3 dni w tygodniu oceniają swoją produktywność wyżej niż pracujący w biurze.” |
| H4 | brak różnicy to hipoteza zerowa; zwykły test nie potwierdzi jej, najwyżej jej nie odrzuci | kierunkowa hipoteza z uzasadnieniem z literatury albo pytanie: „Czy poziom wypalenia różni się między kobietami a mężczyznami?” |
Dobra hipoteza badawcza mówi o związku lub różnicy między mierzalnymi zmiennymi, podaje kierunek (gdy uzasadnia go literatura) i pasuje do schematu: „wpływa” tylko w eksperymencie, w badaniu korelacyjnym „wiąże się”.
Interpretacja
Po poprawkach każda hipoteza wskazuje od razu analizę: H1 – korelacja lub regresja, H3 – porównanie dwóch grup, H2 – odsetek z przedziałem ufności.
Typowy błąd
Sformułowanie hipotezy tak ogólnie, że każdy wynik ją „potwierdza” (H1). Druga częsta pomyłka to stawianie hipotezy o braku różnicy (H4) i ogłaszanie jej potwierdzenia, gdy wynik jest nieistotny – brak istotności to nie dowód braku efektu.
Zadanie 6. Operacjonalizacja konstruktu w fizjoterapii
Treść zadania
Fizjoterapeutka chce sprawdzić, czy przypomnienia SMS zwiększają przestrzeganie zaleceń ćwiczeń domowych u pacjentów z przewlekłym bólem krzyża (program: 5 ćwiczeń, 5 dni w tygodniu, przez 6 tygodni). Polecenie: zoperacjonalizuj „przestrzeganie zaleceń ćwiczeń domowych”: podaj definicję, 2–3 wskaźniki, narzędzie, skalę i sposób liczenia wyniku. Oceń zalety i wady każdego wskaźnika.
Rozwiązanie
Definicja teoretyczna: stopień, w jakim pacjent wykonuje zalecone ćwiczenia z zaleconą częstością i liczbą powtórzeń. Operacjonalizacja polega na przełożeniu tej definicji na obserwowalne wskaźniki i regułę liczenia wyniku.
| Wskaźnik | Narzędzie i wynik | Zaleta | Wada |
|---|---|---|---|
| odsetek wykonanych sesji | dzienniczek ćwiczeń: liczba dni z ćwiczeniami / 30 zaleconych × 100%; skala ilorazowa 0–100% | prosty, bezpośrednio z definicji | pacjent może dopisywać sesje (aprobata społeczna) |
| jakość wykonania | ocena fizjoterapeuty na wizycie kontrolnej (0–2 pkt za każde z 5 ćwiczeń, suma 0–10) | sprawdza, czy ćwiczenia są wykonywane poprawnie | jedna obserwacja, oceniający może znać grupę |
| samoocena przestrzegania | kwestionariusz o przestrzeganiu zaleceń z opublikowaną rzetelnością i trafnością | porównywalność z innymi badaniami | pamięć i chęć wypadnięcia dobrze |
Jeden wskaźnik (np. odsetek sesji) wybierz jako główny, a z góry ustal regułę na braki („dzień bez wpisu = brak ćwiczeń”) i ewentualny próg przestrzegania (np. co najmniej 80% sesji).
Interpretacja
Dobra operacjonalizacja pozwala innej osobie zmierzyć to samo tak samo. Rozbieżność między dzienniczkiem a oceną fizjoterapeuty jest cenną informacją o trafności pomiaru, a nie problemem do ukrycia.
Typowy błąd
Podanie jako operacjonalizacji samego narzędzia („mierzę ankietą”) bez wskaźnika i reguły liczenia wyniku. Drugi błąd to autorska ankieta bez sprawdzenia rzetelności, gdy istnieje opublikowane narzędzie.
Zadanie 7. Dobór próby, zakres uogólnienia oraz dobór i przydział losowy
Treść zadania
Studentka zarządzania bada satysfakcję z pracy w sieci 12 sklepów, która zatrudnia 900 osób (55.0% kobiet, 6.0% kierowników zmiany). Link do ankiety wysłała w grupie na komunikatorze, do której należą pracownicy 3 sklepów w Krakowie (260 osób). Odpowiedziało 120 osób, w tym 94 kobiety i 22 kierowników zmiany. We wnioskach napisała o „satysfakcji pracowników handlu w Polsce”. Polecenie: (a) nazwij sposób doboru i oblicz pokrycie oraz odsetek odpowiedzi; (b) oceń zakres uogólnienia; (c) zaproponuj lepszy dobór; (d) firma chce sprawdzić, czy nowy system grafików poprawia satysfakcję – czym różni się tu dobór losowy od przydziału losowego?
Rozwiązanie
(a) To dobór wygodny z autoselekcją: badaczka dotarła tylko do osób z jednej grupy na komunikatorze, a odpowiadali chętni. Link dotarł do 260 z 900 osób (pokrycie 28.9%). Odsetek odpowiedzi wśród osób z linkiem to 46.2%, a względem całej firmy 13.3%.
(b) Próba nie odpowiada strukturze firmy: kobiety to 78.3% respondentów wobec 55.0% zatrudnionych, a kierownicy zmiany 18.3% wobec 6.0%. Wyniki opisują 120 osób, które odpowiedziały w trzech sklepach. Uogólnienie na całą sieć jest ryzykowne, a na „pracowników handlu w Polsce” – nieuprawnione. To pytanie o trafność zewnętrzną.
(c) Z listy płac wszystkich 900 pracowników wylosuj próbę (dobór losowy prosty albo losowanie osobno w każdym sklepie), zaproś osobiście z przypomnieniem i raportuj odsetek odpowiedzi. Przy próbie wygodnej zawęź wnioski do badanej grupy.
(d) Dobór losowy odpowiada na pytanie „kogo badam” i pozwala uogólniać na populację. Przydział losowy odpowiada na pytanie „kto dostaje nowy grafik” i pozwala wnioskować o przyczynie. Oba mogą wystąpić razem albo osobno:
| Przydział losowy do grafiku | Bez przydziału losowego (sklepy same wybierają) | |
|---|---|---|
| Dobór losowy pracowników z całej sieci | wniosek o przyczynie i uogólnienie na sieć | opis sieci; różnica grafików może wynikać z różnic między sklepami |
| Dobór wygodny (trzy sklepy) | wniosek o przyczynie, ale tylko dla takich sklepów jak badane | najsłabsze: ani przyczyny, ani uogólnienia |
Interpretacja
Wadą tego badania nie jest liczebność, tylko to, kto mógł i chciał odpowiedzieć. Więcej odpowiedzi z tego samego kanału nie usunie obciążenia.
Typowy błąd
Nazwanie próby „losową”, bo „każdy w grupie mógł odpowiedzieć”. Losowość oznacza, że o udziale decyduje losowanie z listy całej populacji, a nie wola respondenta.
Zadanie 8. Zakłócacz, mediator czy moderator?
Treść zadania
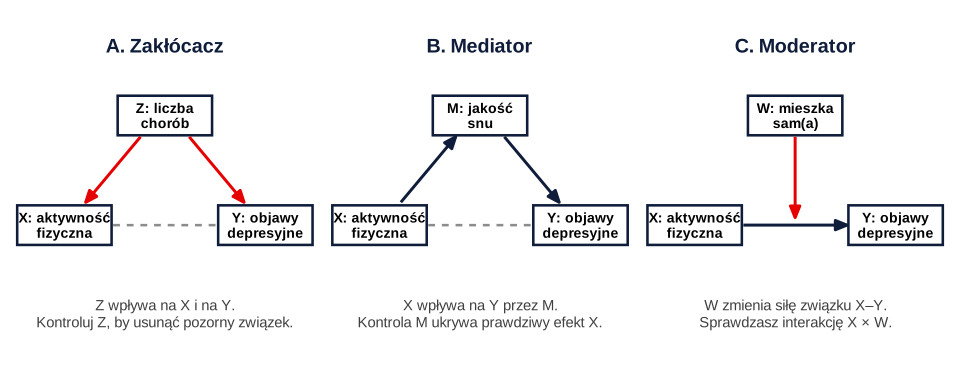
W badaniu 300 osób po 65. roku życia wyższa aktywność fizyczna (X) wiąże się z mniejszym nasileniem objawów depresyjnych (Y). Psycholożka rozważa trzy zmienne trzecie: (A) liczbę chorób przewlekłych, (B) jakość snu, (C) to, czy senior mieszka sam. Polecenie: dla każdej zmiennej opisz najbardziej prawdopodobną rolę (zmienna zakłócająca, mediator, moderator), narysuj schemat i powiedz, co się stanie ze współczynnikiem przy X po „kontrolowaniu” tej zmiennej w regresji.
Rozwiązanie
(A) Zakłócacz. Choroby przewlekłe ograniczają aktywność i same nasilają objawy depresyjne – są wspólną przyczyną X i Y. Kontrola tej zmiennej usuwa część związku, która nie wynika z wpływu aktywności. (B) Mediator. Aktywność poprawia sen, a lepszy sen zmniejsza objawy – jakość snu leży na drodze od X do Y. To mediacja; kontrola mediatora ukrywa właśnie tę część efektu, która przez niego przechodzi. (C) Moderator. Aktywność (np. zajęcia grupowe) może mieć znaczenie głównie dla osób mieszkających samotnie – to moderacja, którą sprawdza się interakcją X × W, a nie zwykłą kontrolą.
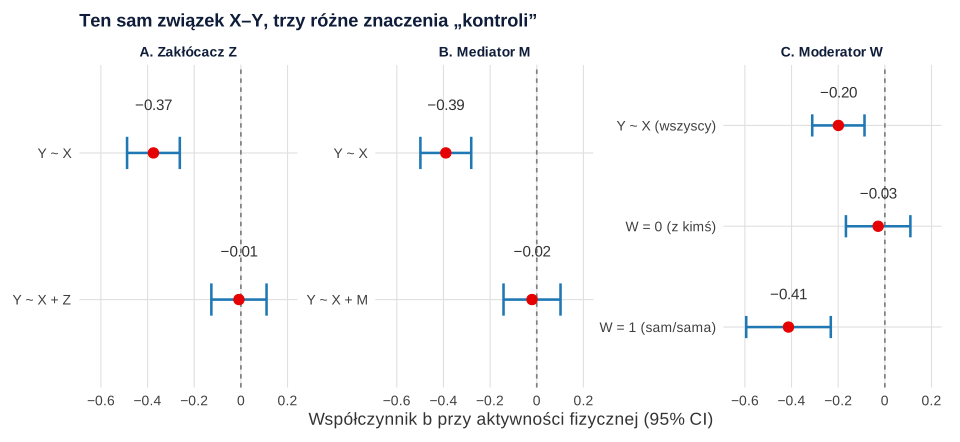
Sprawdzenie symulacją (trzy zbiory po 300 osób, wyniki standaryzowane). (A) Bez kontroli b = −0.37, 95% CI [−0.49, −0.26]; po dodaniu liczby chorób b = −0.01, 95% CI [−0.13, 0.11], p = .891. (B) Efekt całkowity b = −0.39, 95% CI [−0.50, −0.28]; po dodaniu jakości snu b = −0.02, p = .744, a efekt pośredni wynosi 0.67 × (−0.55) = −0.37. (C) W całej próbie b = −0.20, ale u mieszkających z kimś b = −0.03, 95% CI [−0.17, 0.11], a u mieszkających samotnie b = −0.41, 95% CI [−0.59, −0.23]; interakcja b = −0.38, p < .001. Dodanie W jako zmiennej kontrolnej nic nie zmienia (b = −0.20).
Interpretacja
Dane nie rozstrzygną, czy zmienna jest zakłócaczem, czy mediatorem. Decyduje teoria i kolejność czasowa: zakłócacz istnieje przed X, mediator jest skutkiem X. MacKinnon i in. (2007) definiują mediator jako zmienną przekazującą wpływ X na Y i odróżniają go od zakłócaczy i moderatorów, a Baron i Kenny (1986) przestrzegają przed zamiennym używaniem terminów „moderator” i „mediator”. Rohrer (2018) pokazuje, że kontrolowanie mediatora oddala oszacowanie od interesującego efektu przyczynowego.
Typowy błąd
„Kontrolowanie wszystkiego, co się zmierzyło”. Dodanie mediatora do zmiennych kontrolnych prowadzi do wniosku „aktywność nie ma znaczenia”, choć w strukturze B cały jej wpływ przechodzi przez sen.
Zadanie 9. Oceń wniosek przyczynowy z badania korelacyjnego
Treść zadania
W jednorazowej ankiecie wśród 240 pracowników firm informatycznych liczba szkoleń w ostatnim roku koreluje z zaangażowaniem w pracę, r = .41. W zakończeniu pracy student napisał: „Szkolenia zwiększają zaangażowanie pracowników, dlatego firmy powinny zwiększyć budżety szkoleniowe”. Polecenie: (a) oblicz r² i zinterpretuj; (b) podaj trzy alternatywne wyjaśnienia; (c) przepisz wniosek; (d) zaproponuj schemat, który pozwoliłby sprawdzić wpływ szkoleń.
Rozwiązanie
(a) r² = .41² = .17, czyli liczba szkoleń i zaangażowanie mają 17% wspólnej wariancji; 83.2% zróżnicowania zaangażowania nie wiąże się z liczbą szkoleń. Korelacja jest istotna, r(238) = .41, 95% CI [.30, .51], p < .001, ale istotność nie mówi nic o kierunku wpływu.
(b) (1) Odwrotny kierunek: zaangażowani pracownicy częściej sami zgłaszają się na szkolenia. (2) Zakłócacz: przełożony, który wspiera rozwój, wysyła na szkolenia i zarazem buduje zaangażowanie; podobnie stanowisko lub wielkość firmy. (3) Wspólna metoda: obie zmienne pochodzą z samoopisu w jednej ankiecie, a osoba w dobrym nastroju zawyża obie odpowiedzi.
(c) „Pracownicy, którzy w ostatnim roku uczestniczyli w większej liczbie szkoleń, deklarowali wyższe zaangażowanie w pracę (r = .41). Ze względu na przekrojowy schemat badania nie można rozstrzygnąć, czy szkolenia zwiększają zaangażowanie, czy bardziej zaangażowani pracownicy częściej z nich korzystają.”
(d) Najmocniej: eksperyment terenowy – losowo wybrani pracownicy dostają szkolenia od razu, pozostali później, a zaangażowanie mierzy się przed i po. Słabiej: badanie podłużne w kilku falach.
Interpretacja
Związek jest umiarkowany i realny w tej próbie, ale badanie korelacyjne nie odróżni wpływu szkoleń od wyjaśnień alternatywnych. Rohrer (2018) przypomina, że wnioski przyczynowe z danych obserwacyjnych zawsze zależą od założeń, które trzeba jawnie uzasadnić wiedzą dziedzinową.
Typowy błąd
Przekonanie, że wysoka korelacja albo bardzo małe p „wzmacnia” wniosek przyczynowy. Siła i istotność związku nie zmieniają schematu badania.
Zadanie 10. Wybierz test do hipotezy
Treść zadania
Dla każdej hipotezy podaj zmienne i ich skale, określ, czy grupy są niezależne czy zależne, i wybierz test (z alternatywą, gdy założenia nie są spełnione). (a) Pielęgniarki pracujące w systemie 12-godzinnym odczuwają większe zmęczenie (skala 0–100) niż pracujące 8-godzinnie. (b) Odsetek pacjentów z odleżynami różni się między trzema oddziałami. (c) Uczniowie uczeni trzema metodami (tradycyjną, projektową, odwróconą klasą) różnią się wynikiem testu z biologii. (d) Im dłuższy staż pracy, tym wyższe zaangażowanie (suma 9 pozycji Likerta). (e) Szansa zdania egzaminu na prawo jazdy za pierwszym razem rośnie z liczbą godzin jazd doszkalających.
Rozwiązanie
| Hipoteza | Zmienne i skale | Test (alternatywa) | Ćwiczenia |
|---|---|---|---|
| (a) | system pracy: nominalna, 2 grupy niezależne; zmęczenie: ilościowa | test t Welcha, jednostronny (Mann–Whitney) | zadania na psychologii |
| (b) | oddział: nominalna, 3 kategorie; odleżyna: tak / nie | χ² niezależności 3 × 2 (dokładny test przy małych licznościach) | chi-kwadrat – zadania |
| (c) | metoda: nominalna, 3 grupy niezależne; wynik testu: ilościowa | ANOVA jednoczynnikowa lub Welcha (Kruskal–Wallis) | ANOVA – zadania |
| (d) | staż: ilorazowa; zaangażowanie: suma pozycji, ilościowa | korelacja Pearsona, jednostronnie (Spearman) | korelacja i regresja – zadania |
| (e) | godziny: ilościowa; zdał za pierwszym razem: tak / nie | regresja logistyczna | regresja logistyczna – zadania |
Interpretacja
Test wybierasz z trzech informacji: skala zmiennej zależnej, liczba grup lub zmiennych oraz to, czy pomiary pochodzą od tych samych osób. Pełną ściągę znajdziesz we wpisie jaki test statystyczny do jakiej hipotezy.
Typowy błąd
Wybór testu po kształcie wyniku („nie wyszło w teście t, to sprawdzę Manna–Whitneya”). Druga pomyłka to test dla prób niezależnych przy pomiarach przed i po u tych samych osób.
Inne zbiory zadań
Metodologia daje plan, a statystyka – liczby. Wszystkie zbiory zebraliśmy na stronie zadania ze statystyki z rozwiązaniami. Najbliżej tego zbioru są:
- zadania ze statystyki na psychologii (testy t, χ², ANOVA, regresja);
- korelacja i regresja – zadania z rozwiązaniami, w tym pułapka przyczynowości;
- test chi-kwadrat i tabele krzyżowe – zadania z rozwiązaniami.
Plan własnego badania opisujesz w rozdziale metodologicznym. Jeśli chcesz go sprawdzić przed zbieraniem danych, skorzystaj z konsultacji dla studentów – wyjaśnimy decyzje tak, żebyś umiał(a) je samodzielnie uzasadnić.
Sprawdź wyniki w R: kod i wynik
Dwa przepisy liczą wszystkie liczby z rozwiązań. Pierwszy ma dane z treści zadań 3, 4, 7 i 9 wpisane w kod i symulację sprawdzającą wzór na regresję do średniej. Drugi generuje trzy zbiory danych do zadania 8 (zakłócacz, mediator, moderator) i porównuje modele regresji z kontrolą zmiennej trzeciej i bez niej. Rysunki i plik CSV powstały w osobnym skrypcie, który wczytuje dane z drugiego przepisu.
Zadania 3, 4, 7 i 9: ubytek, regresja do średniej, struktura próby i korelacja
R
# B393 – liczby do zadań 3, 4, 7 i 9 (metodologia badań – zadania z rozwiązaniami).
# Zadanie 3: jak ubytek najsłabszych uczniów zmienia średnią wyjściową klasy.
# Zadanie 4: oczekiwana regresja do średniej w grupie wybranej po niskim wyniku + symulacja sprawdzająca wzór.
# Zadanie 7: odsetek odpowiedzi i struktura próby wygodnej na tle całej firmy (dane z treści zadania).
# Zadanie 9: r, r² i 95% CI dla korelacji z badania przekrojowego (transformacja Fishera z).
# Tylko funkcje bazowego R.
z1 <- function(x) formatC(x, format = "f", digits = 1)
z2 <- function(x) formatC(x, format = "f", digits = 2)
bz <- function(x) sub("^(-?)0\\.", "\\1.", z2(x))              # bez zera przed kropką (r, R²)
pp <- function(p) if (p < .001) "p < .001" else paste("p =", sub("^0\\.", ".", formatC(p, format = "f", digits = 3)))

cat("Zadanie 3. Program czytelniczy: ubytek trojga najsłabszych uczniów\n")
n_klasa <- 25; M_wrzesien <- 18; M_czerwiec <- 24              # czerwiec: tylko 22 uczniów, którzy zostali
odeszli <- c(8, 8, 8)                                          # założone wyniki wrześniowe uczniów, którzy odeszli
M_wrz_zostali <- (n_klasa * M_wrzesien - sum(odeszli)) / (n_klasa - length(odeszli))
cat("Średnia wrześniowa 22 uczniów, którzy zostali =", z2(M_wrz_zostali), "\n")
cat("Wzrost liczony na wszystkich =", z2(M_czerwiec - M_wrzesien), "; wzrost u tych samych 22 uczniów =",
    z2(M_czerwiec - M_wrz_zostali), "\n\n")

cat("Zadanie 4. Zajęcia wyrównawcze z matematyki: uczniowie z wynikiem T <= 37\n")
mu <- 50; SD <- 10; r_tt <- 0.70                               # normy skali T i rzetelność test–retest (3 miesiące)
M_przed <- 33.0; M_po <- 41.0                                  # średnie grupy z treści zadania
M_po_oczek <- mu + r_tt * (M_przed - mu)                       # oczekiwana średnia po, gdyby zajęcia nic nie dały
cat("Oczekiwana średnia po bez żadnego wpływu = 50 + 0.70 × (33.0 − 50) =", z1(M_po_oczek), "\n")
cat("Zmiana obserwowana =", z1(M_po - M_przed), "; zmiana oczekiwana z samej regresji do średniej =",
    z1(M_po_oczek - M_przed), "; nadwyżka ponad regresję =", z1(M_po - M_po_oczek), "\n")
cat("Odsetek obserwowanej poprawy wyjaśniony regresją do średniej =",
    z1(100 * (M_po_oczek - M_przed) / (M_po - M_przed)), "%\n")
cat("Gdyby rzetelność wynosiła .90: oczekiwana średnia po =", z1(mu + 0.90 * (M_przed - mu)), "\n")

# Symulacja sprawdzająca wzór: wynik = poziom stały ucznia + błąd pomiaru, brak jakichkolwiek zajęć.
set.seed(393)
N <- 100000
poziom <- rnorm(N, mu, sqrt(r_tt) * SD)                        # wariancja prawdziwa 70
przed  <- poziom + rnorm(N, 0, sqrt(1 - r_tt) * SD)            # wariancja błędu 30, razem 100
po     <- poziom + rnorm(N, 0, sqrt(1 - r_tt) * SD)
wyb <- przed <= 37
cat("\nSymulacja (N = 100 000, bez zajęć): r(przed, po) =", bz(cor(przed, po)),
    "; wybrano", sum(wyb), "uczniów (", z1(100 * mean(wyb)), "%)\n")
cat("Wybrani: średnia przed =", z2(mean(przed[wyb])), "; średnia po =", z2(mean(po[wyb])),
    "; wzór 50 + r × (przed − 50) =", z2(mu + cor(przed, po) * (mean(przed[wyb]) - mu)), "\n")
cat("Odsetek wybranych, którzy „poprawili się” (po > przed) =", z1(100 * mean(po[wyb] > przed[wyb])), "%\n\n")

cat("Zadanie 7. Ankieta satysfakcji w sieci sklepów\n")
N_firma <- 900; N_dotarto <- 260; n_odp <- 120                 # zatrudnieni, pracownicy 3 sklepów z linkiem, odpowiedzi
cat("Pokrycie: link dotarł do", N_dotarto, "z", N_firma, "osób =", z1(100 * N_dotarto / N_firma), "%\n")
cat("Odsetek odpowiedzi wśród osób z linkiem =", z1(100 * n_odp / N_dotarto), "%; względem całej firmy =",
    z1(100 * n_odp / N_firma), "%\n")
struktura <- data.frame(
  cecha = c("kobiety", "kierownicy zmiany"),
  firma_n = c(495, 54), proba_n = c(94, 22))
struktura$firma_proc <- z1(100 * struktura$firma_n / N_firma)
struktura$proba_proc <- z1(100 * struktura$proba_n / n_odp)
print(struktura, row.names = FALSE)

cat("\nZadanie 9. Szkolenia a zaangażowanie: r = .41, n = 240 (jeden pomiar)\n")
r <- 0.41; n <- 240
t_r <- r * sqrt(n - 2) / sqrt(1 - r^2)
ci <- tanh(atanh(r) + c(-1, 1) * qnorm(0.975) / sqrt(n - 3))
cat("r² =", bz(r^2), "; t(", n - 2, ") =", z2(t_r), ",", pp(2 * pt(-abs(t_r), n - 2)),
    "; 95% CI dla r [", bz(ci[1]), ",", bz(ci[2]), "]\n")
cat("Wariancja zaangażowania niezwiązana z liczbą szkoleń = 1 − r² =", z1(100 * (1 - r^2)), "%\n")
Wynik w R
Zadanie 3. Program czytelniczy: ubytek trojga najsłabszych uczniów
Średnia wrześniowa 22 uczniów, którzy zostali = 19.36
Wzrost liczony na wszystkich = 6.00 ; wzrost u tych samych 22 uczniów = 4.64

Zadanie 4. Zajęcia wyrównawcze z matematyki: uczniowie z wynikiem T <= 37
Oczekiwana średnia po bez żadnego wpływu = 50 + 0.70 × (33.0 − 50) = 38.1
Zmiana obserwowana = 8.0 ; zmiana oczekiwana z samej regresji do średniej = 5.1 ; nadwyżka ponad regresję = 2.9
Odsetek obserwowanej poprawy wyjaśniony regresją do średniej = 63.8 %
Gdyby rzetelność wynosiła .90: oczekiwana średnia po = 34.7

Symulacja (N = 100 000, bez zajęć): r(przed, po) = .70 ; wybrano 9693 uczniów ( 9.7 %)
Wybrani: średnia przed = 32.35 ; średnia po = 37.72 ; wzór 50 + r × (przed − 50) = 37.67
Odsetek wybranych, którzy „poprawili się” (po > przed) = 77.1 %

Zadanie 7. Ankieta satysfakcji w sieci sklepów
Pokrycie: link dotarł do 260 z 900 osób = 28.9 %
Odsetek odpowiedzi wśród osób z linkiem = 46.2 %; względem całej firmy = 13.3 %
             cecha firma_n proba_n firma_proc proba_proc
           kobiety     495      94       55.0       78.3
 kierownicy zmiany      54      22        6.0       18.3

Zadanie 9. Szkolenia a zaangażowanie: r = .41, n = 240 (jeden pomiar)
r² = .17 ; t( 238 ) = 6.93 , p < .001 ; 95% CI dla r [ .30 , .51 ]
Wariancja zaangażowania niezwiązana z liczbą szkoleń = 1 − r² = 83.2 %
Zadanie 8: co daje kontrola zakłócacza, mediatora i moderatora
R
# B393 – zadanie 8: ta sama para zmiennych, trzy role zmiennej trzeciej (dane symulowane, bazowy R).
# X = aktywność fizyczna seniora, Y = objawy depresyjne (oba w jednostkach SD, czyli wyniki z).
# A. Zakłócacz Z (liczba chorób przewlekłych): Z -> X i Z -> Y, X nie wpływa na Y.
# B. Mediator M (jakość snu): X -> M -> Y, bez efektu bezpośredniego.
# C. Moderator W (mieszka sam: 0/1): X -> Y tylko u osób mieszkających samotnie.
set.seed(3930)
z2 <- function(x) formatC(x, format = "f", digits = 2)
pp <- function(p) if (p < .001) "p < .001" else paste("p =", sub("^0\\.", ".", formatC(p, format = "f", digits = 3)))
n <- 300
wspolcz <- function(model, nazwa = "X") {                      # b, 95% CI i p dla jednego współczynnika
  s <- summary(model)$coefficients[nazwa, ]; ci <- confint(model)[nazwa, ]
  paste0("b = ", z2(s[1]), ", 95% CI [", z2(ci[1]), ", ", z2(ci[2]), "], ", pp(s[4]))
}

# A. Zakłócacz
Z <- rnorm(n)
dane_A <- data.frame(X = -0.6 * Z + rnorm(n, 0, 0.8), Z = Z)
dane_A$Y <- 0.6 * dane_A$Z + rnorm(n, 0, 0.8)
dane_A <- round(dane_A, 2)                                     # te same liczby co w pliku CSV
cat("A. Zakłócacz (choroby przewlekłe)\n")
cat("Y ~ X     :", wspolcz(lm(Y ~ X, dane_A)), "\n")
cat("Y ~ X + Z :", wspolcz(lm(Y ~ X + Z, dane_A)), "\n\n")

# B. Mediator
dane_B <- data.frame(X = rnorm(n))
dane_B$Z <- 0.6 * dane_B$X + rnorm(n, 0, 0.8)                  # Z = mediator: jakość snu (wyżej = lepszy sen)
dane_B$Y <- -0.6 * dane_B$Z + rnorm(n, 0, 0.8)
dane_B <- round(dane_B, 2)
mB_a <- lm(Z ~ X, dane_B); mB_c <- lm(Y ~ X, dane_B); mB_b <- lm(Y ~ X + Z, dane_B)
cat("B. Mediator (jakość snu)\n")
cat("Y ~ X (efekt całkowity)       :", wspolcz(mB_c), "\n")
cat("Y ~ X + M (efekt bezpośredni) :", wspolcz(mB_b), "\n")
cat("Efekt pośredni a × b =", z2(coef(mB_a)["X"]), "×", z2(coef(mB_b)["Z"]), "=",
    z2(coef(mB_a)["X"] * coef(mB_b)["Z"]), "\n\n")

# C. Moderator
dane_C <- data.frame(X = rnorm(n), Z = rbinom(n, 1, 0.4))     # Z = mieszka sam (1) albo z kimś (0)
dane_C$Y <- -0.5 * dane_C$X * dane_C$Z + rnorm(n, 0, 0.9)
dane_C <- round(dane_C, 2)
mC <- lm(Y ~ X * Z, dane_C)
cat("C. Moderator (mieszka sam)\n")
cat("Odsetek mieszkających samotnie =", z2(100 * mean(dane_C$Z)), "%\n")
cat("Y ~ X (bez interakcji)        :", wspolcz(lm(Y ~ X, dane_C)), "\n")
cat("Y ~ X, tylko mieszkający z kimś (Z = 0):", wspolcz(lm(Y ~ X, subset(dane_C, Z == 0))), "\n")
cat("Y ~ X, tylko mieszkający sami (Z = 1)  :", wspolcz(lm(Y ~ X, subset(dane_C, Z == 1))), "\n")
cat("Interakcja X × Z w modelu Y ~ X * Z    :", wspolcz(mC, "X:Z"), "\n")
cat("Y ~ X + Z (Z tylko jako zmienna kontrolna):", wspolcz(lm(Y ~ X + Z, dane_C)), "\n")
Wynik w R
A. Zakłócacz (choroby przewlekłe)
Y ~ X     : b = -0.37, 95% CI [-0.49, -0.26], p < .001
Y ~ X + Z : b = -0.01, 95% CI [-0.13, 0.11], p = .891

B. Mediator (jakość snu)
Y ~ X (efekt całkowity)       : b = -0.39, 95% CI [-0.50, -0.28], p < .001
Y ~ X + M (efekt bezpośredni) : b = -0.02, 95% CI [-0.14, 0.10], p = .744
Efekt pośredni a × b = 0.67 × -0.55 = -0.37

C. Moderator (mieszka sam)
Odsetek mieszkających samotnie = 37.33 %
Y ~ X (bez interakcji)        : b = -0.20, 95% CI [-0.31, -0.09], p < .001
Y ~ X, tylko mieszkający z kimś (Z = 0): b = -0.03, 95% CI [-0.17, 0.11], p = .683
Y ~ X, tylko mieszkający sami (Z = 1)  : b = -0.41, 95% CI [-0.59, -0.23], p < .001
Interakcja X × Z w modelu Y ~ X * Z    : b = -0.38, 95% CI [-0.61, -0.16], p < .001
Y ~ X + Z (Z tylko jako zmienna kontrolna): b = -0.20, 95% CI [-0.31, -0.08], p < .001
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats); rysunki przygotowano w pakietach ggplot2, patchwork, svglite i magick. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
- magick (wersja 2.9.1): Ooms, J. (2026). magick: Advanced graphics and image-processing in R [R package]. https://doi.org/10.32614/CRAN.package.magick
Najczęstsze pytania
Jak rozpoznać w opisie badania zmienną niezależną, zależną i kontrolną?
Zapytaj, co badacz uważa za przyczynę lub czynnik różnicujący (zmienna niezależna), co mierzy jako skutek (zmienna zależna) i co tylko utrzymuje stałe albo uwzględnia w analizie, bo mogłoby zaburzyć wynik (zmienna kontrolna). Pomaga zdanie „Czy X wpływa na Y przy stałym Z?”. W zadaniu 1 X to forma edukacji przed zabiegiem, Y to lęk i liczba dawek leku, a Z to wiek, płeć i rodzaj operacji.
Czym różni się zakłócacz od mediatora, skoro po kontroli obu związek znika?
Różni je kierunek strzałek, a nie liczby. Zakłócacz jest wspólną przyczyną X i Y, więc kontrolujesz go, żeby usunąć pozorny związek; mediator leży na drodze od X do Y, więc jego kontrola ukrywa prawdziwy efekt. W symulacji z zadania 8 w obu przypadkach współczynnik spada prawie do zera (z −0.37 do −0.01 i z −0.39 do −0.02) – o roli zmiennej decydują teoria i kolejność czasowa pomiarów.
Jak obliczyć, jaka część poprawy w grupie wybranej po niskim wyniku to regresja do średniej?
Oczekiwana średnia drugiego pomiaru bez żadnego wpływu wynosi μ + r × (Mprzed − μ), gdzie μ to średnia populacji, a r – korelacja test–retest. W zadaniu 4: 50 + .70 × (33 − 50) = 38.1, więc z obserwowanej poprawy o 8 punktów aż 5.1 punktu (63.8%) wynika z samej regresji do średniej. Resztę może wyjaśnić interwencja, ale tylko grupa kontrolna to potwierdzi.
Jak poprawić źle sformułowaną hipotezę badawczą?
Sprawdź cztery rzeczy: czy hipoteza mówi o związku lub różnicy między nazwanymi zmiennymi, czy podaje kierunek, czy zmienne da się zmierzyć i czy słowa pasują do schematu badania („wpływa” tylko w eksperymencie). Przykład z zadania 5: zamiast „Styl przywództwa ma wpływ na pracowników” napisz „Im wyżej pracownicy oceniają przywództwo transformacyjne przełożonego, tym wyższe jest ich zaangażowanie w pracę”.
Po czym poznać, że badanie jest quasi-eksperymentem, a nie eksperymentem?
W obu badacz wprowadza interwencję i porównuje grupy, ale w quasi-eksperymencie osoby nie trafiają do grup losowo – grupy już istnieją (klasy, oddziały, szkoły) albo uczestnicy sami wybierają warunek. Jeśli w opisie brakuje słów „losowo przydzielono”, sprawdź, kto decydował o przynależności do grupy. Wtedy różnice wyjściowe między grupami (selekcja) są głównym zagrożeniem trafności wewnętrznej.
Powiązane hasła
Przeczytaj też
Pytania z metodologii na obronę
Pytania promotora, recenzenta i komisji ułożone według typu badania – od eksperymentu i sondażu po przegląd systematyczny – oraz pojęcia, o które pytają „z definicji”.
Czytaj →PoradnikRozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →PoradnikZadania ze statystyki z rozwiązaniami
Wszystkie zbiory zadań w jednym miejscu: tabela działów, poziomów i kierunków, dziewięć przykładowych zadań, ściąga wyboru testu i najczęstsze błędy.
Czytaj →Planujesz własne badanie do pracy i nie wiesz, czy schemat się obroni?
Pomożemy nazwać zmienne, dobrać schemat, hipotezy i analizy do pytań badawczych oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Andrade, C. (2021). A student’s guide to the classification and operationalization of variables in the conceptualization and design of a clinical study: Part 1. Indian Journal of Psychological Medicine, 43(2), 177–179. https://doi.org/10.1177/0253717621994334 ● Otwarty dostęp
- Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215–220. https://doi.org/10.1093/ije/dyh299 ● Otwarty dostęp
- Baron, R. M., & Kenny, D. A. (1986). The moderator–mediator variable distinction in social psychological research: Conceptual, strategic, and statistical considerations. Journal of Personality and Social Psychology, 51(6), 1173–1182. https://doi.org/10.1037/0022-3514.51.6.1173
- Brzeziński, J. (2019). Metodologia badań psychologicznych (Wyd. nowe). Wydawnictwo Naukowe PWN.
- MacKinnon, D. P., Fairchild, A. J., & Fritz, M. S. (2007). Mediation analysis. Annual Review of Psychology, 58(1), 593–614. https://doi.org/10.1146/annurev.psych.58.110405.085542 ● Otwarty dostęp: pełny tekst
- Rohrer, J. M. (2018). Thinking clearly about correlations and causation: Graphical causal models for observational data. Advances in Methods and Practices in Psychological Science, 1(1), 27–42. https://doi.org/10.1177/2515245917745629 ● Otwarty dostęp
- Shadish, W. R., Cook, T. D., & Campbell, D. T. (2002). Experimental and quasi-experimental designs for generalized causal inference. Houghton Mifflin.
Cytowania BibTeX
@article{andrade2021student, author={Andrade, Chittaranjan}, title={{A student’s guide to the classification and operationalization of variables in the conceptualization and design of a clinical study: Part 1}}, journal={Indian Journal of Psychological Medicine}, year={2021}, volume={43}, number={2}, pages={177--179}, doi={10.1177/0253717621994334}}@article{barnett2005regression, author={Barnett, Adrian G. and van der Pols, Jolieke C. and Dobson, Annette J.}, title={{Regression to the mean: What it is and how to deal with it}}, journal={International Journal of Epidemiology}, year={2005}, volume={34}, number={1}, pages={215--220}, doi={10.1093/ije/dyh299}}@article{baron1986moderator, author={Baron, Reuben M. and Kenny, David A.}, title={{The moderator–mediator variable distinction in social psychological research: Conceptual, strategic, and statistical considerations}}, journal={Journal of Personality and Social Psychology}, year={1986}, volume={51}, number={6}, pages={1173--1182}, doi={10.1037/0022-3514.51.6.1173}}@book{brzezinski2019metodologia, author={Brzeziński, Jerzy}, title={{Metodologia badań psychologicznych}}, year={2019}, edition={Wyd. nowe}, publisher={Wydawnictwo Naukowe PWN}}@article{mackinnon2007mediation, author={MacKinnon, David P. and Fairchild, Amanda J. and Fritz, Matthew S.}, title={{Mediation analysis}}, journal={Annual Review of Psychology}, year={2007}, volume={58}, number={1}, pages={593--614}, doi={10.1146/annurev.psych.58.110405.085542}}@article{rohrer2018thinking, author={Rohrer, Julia M.}, title={{Thinking clearly about correlations and causation: Graphical causal models for observational data}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={1}, pages={27--42}, doi={10.1177/2515245917745629}}@book{shadish2002experimental, author={Shadish, William R. and Cook, Thomas D. and Campbell, Donald T.}, title={{Experimental and quasi-experimental designs for generalized causal inference}}, year={2002}, publisher={Houghton Mifflin}}