summary(glm) z przedziałami Walda i profilowymi, interpretację „przy kontroli”, tabelę klasyfikacji przy dwóch progach, AUC, pseudo-R² i test ilorazu wiarygodności z EPV. Każde rozwiązanie ma wzór, podstawienie, wynik, interpretację i typowy błąd. Wszystkie liczby sprawdzono w R, a dane możesz pobrać w pliku CSV.Regresja logistyczna: zadania z rozwiązaniami – jak z nich korzystać
Ten wpis to regresja logistyczna – zadania z rozwiązaniami na kolokwium, egzamin albo przed analizą do pracy dyplomowej. Najwięcej kłopotu sprawiają przeliczenia: prawdopodobieństwo – szansa – logit oraz współczynnik b – iloraz szans. Dziesięć ćwiczeń przechodzi przez nie po kolei, a potem przez ocenę modelu: klasyfikację, AUC, pseudo-R² i test ilorazu wiarygodności.
Każde zadanie ma ten sam układ: treść z danymi, rozwiązanie krok po kroku, interpretację i typowy błąd. Zadania 1–4 policzysz kalkulatorem z funkcjami ex i ln; zadania 5–10 opierają się na jednym zbiorze 60 osób i na wydruku z R, bo modelu nikt nie dopasowuje na kartce. Każdą liczbę sprawdziliśmy w R (kod na końcu wpisu). Wzory są standardowe (np. Field, 2018).
Założenia i opis w pracy omawia poradnik regresja logistyczna krok po kroku, definicje – hasło regresja logistyczna.
| Zadanie | Historyjka | Co liczysz |
|---|---|---|
| 1 | rezygnacja z terapii | prawdopodobieństwo, szansa, logit |
| 2 | program mentorski a zaliczenie 1. roku | OR z tabeli 2 × 2 i z modelu: OR = exp(b) |
| 3 | wypalenie zawodowe pielęgniarek | logit i prawdopodobieństwo dla konkretnej osoby |
| 4 | stres a problemy ze snem | OR dla predyktora ciągłego na 1 i 10 punktów |
| 5 | kurs online: lekcje a certyfikat | wydruk summary(glm), przedział Walda i profilowy |
| 6 | kurs online: lekcje i praca na etat | OR bez kontroli i „przy kontroli” |
| 7 | kurs online: kto dostanie certyfikat | tabela klasyfikacji przy progu 0.5 i 0.7 |
| 8 | model ryzyka upadku i kurs online | AUC z par osób i z krzywej ROC |
| 9 | kurs online: dopasowanie modelu | pseudo-R² McFaddena, Coxa i Snella, Nagelkerkego |
| 10 | kurs online: czy etat coś wnosi | test ilorazu wiarygodności, EPV |
Dane do zadania 2, zadań 5–10 i części (a) zadania 8 możesz pobrać w jednym pliku: regresja-logistyczna-zadania-dane.csv (format długi; 1 = tak, 0 = nie; dane wymyślone).
Model ma postać logit(p) = b0 + b1X1 + …, gdzie p to prawdopodobieństwo wartości 1.
Zadanie 1. Szansa a prawdopodobieństwo
Treść zadania
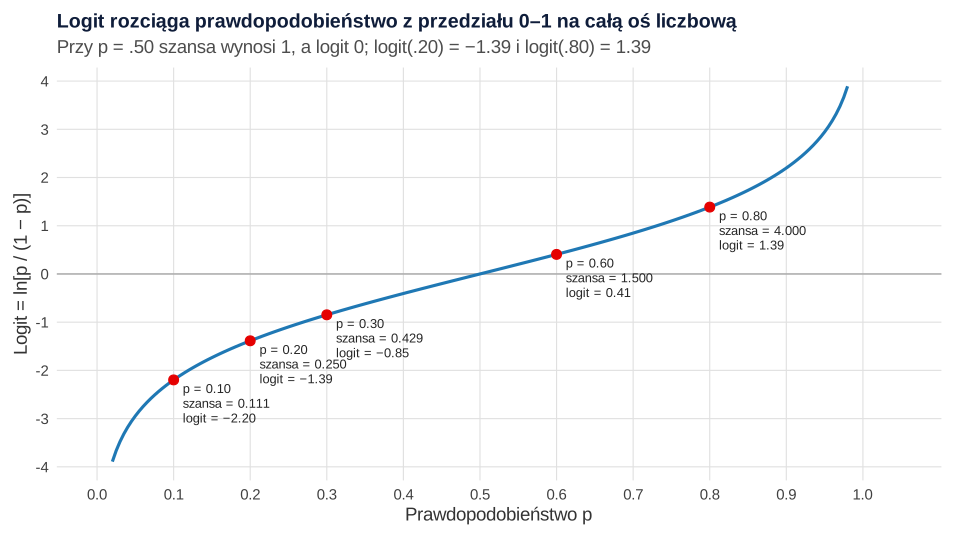
W poradni terapię przerwało 18 z 60 pacjentów. (a) Oblicz prawdopodobieństwo rezygnacji, szansę i logit. (b) Jakie prawdopodobieństwo odpowiada szansie 1.5, a jakie szansie 3 : 1? (c) W poradni A rezygnuje 10% pacjentów, w poradni B 20%. W poradni C – 60%, w poradni D – 80%. Dla obu par oblicz iloraz prawdopodobieństw i iloraz szans.
Rozwiązanie krok po kroku
Krok 1. p = 18 / 60 = 0.300. Szansa = 18 / 42 = 0.300 / 0.700 = 0.4286 (3 : 7). Logit = ln(0.4286) = −0.847.
Krok 2. Szansa 1.5 daje 1.5 / 2.5 = 0.600, a szansa 3 : 1 daje 3 / 4 = 0.750.
Krok 3. Porównanie poradni.
| Para poradni | p | Szanse | Iloraz prawdopodobieństw | Iloraz szans |
|---|---|---|---|---|
| A i B | 0.10 i 0.20 | 0.111 i 0.250 | 2.00 | 2.25 |
| C i D | 0.60 i 0.80 | 1.500 i 4.000 | 1.33 | 2.67 |
Interpretacja
Na 10 osób, które zostają w terapii, przypada ok. 4 rezygnujących. Przy rzadkim zdarzeniu (A–B) iloraz szans jest bliski ilorazowi prawdopodobieństw, przy częstym (C–D) – dużo od niego większy. Zob. iloraz szans.
Typowy błąd
Mówienie „szansa wynosi 30%”. Trzydzieści procent to prawdopodobieństwo; szansa to 0.43 (3 : 7) i może być większa od 1 – przy prawdopodobieństwie 80% wynosi 4.
Zadanie 2. Iloraz szans z tabeli 2 × 2 a współczynnik z modelu
Treść zadania
Na wydziale 60 studentów pierwszego roku wzięło udział w programie mentorskim, a 100 nie. Rok zaliczyło 45 osób z mentorem i 50 bez mentora. (a) Oblicz iloraz szans zaliczenia z 95% przedziałem ufności z tabeli. (b) Do danych dopasowano model logit(p) = b0 + b1 × mentor (mentor: 1 = tak, 0 = nie). Bez dopasowywania modelu podaj b0 i b1, a potem sprawdź je z wydrukiem.
Rozwiązanie krok po kroku
Krok 1. Tabela i szanse. Mentor: 45 zaliczyło, 15 nie – szansa 45 / 15 = 3.000. Bez mentora: 50 i 50 – szansa 1.000.
Krok 2. Przedział. ln(3) = 1.0986, więc 95% CI = exp(1.0986 ± 1.96 × 0.359) = [1.48, 6.06].
Krok 3. Współczynniki modelu. Bez mentora logit = b0 = ln(1.000) = 0. Z mentorem logit = b0 + b1 = ln(3), więc b1 = 1.0986 = ln(OR).
Krok 4. Kontrola w R: wyraz wolny 0.0000, mentor 1.0986 (SE = 0.359, z = 3.06, p = .002) – SE jest identyczny jak SE[ln(OR)] z tabeli.
Interpretacja
Model z jednym predyktorem 0/1 to ten sam iloraz szans co z tabeli, zapisany na skali logarytmu.
Typowy błąd
Interpretacja „z mentorem zalicza trzy razy więcej osób”. Odsetki to 75% i 50%, więc prawdopodobieństwo jest tylko 1.5 raza większe; trzykrotnie większa jest szansa.
Zadanie 3. Z równania na prawdopodobieństwo dla konkretnej osoby
Treść zadania
W badaniu pielęgniarek (dane wymyślone) wypalenie zawodowe (1 = tak) opisano modelem: logit(p) = −3.10 + 0.06 × nadgodziny + 0.90 × zmianowa − 0.45 × wsparcie, gdzie nadgodziny to liczba nadgodzin w miesiącu, zmianowa = 1 przy pracy zmianowej, a wsparcie to ocena wsparcia przełożonego (1–5). Oblicz prawdopodobieństwo wypalenia dla: A – 20 nadgodzin, praca zmianowa, wsparcie 2; B – 40 nadgodzin, praca zmianowa, wsparcie 1. O ile wzrośnie prawdopodobieństwo u A i u B po dodaniu 10 nadgodzin?
Rozwiązanie krok po kroku
Krok 1. Logit. A: −3.10 + 0.06 × 20 + 0.90 × 1 − 0.45 × 2 = −3.10 + 1.20 + 0.90 − 0.90 = −1.90. B: −3.10 + 2.40 + 0.90 − 0.45 = −0.25.
Krok 2. Szansa i prawdopodobieństwo. A: szansa = e−1.90 = 0.150, a prawdopodobieństwo = 0.150 / 1.150 = .130. B: szansa = e−0.25 = 0.779, p = .438.
Krok 3. Dziesięć nadgodzin więcej. OR = exp(10 × 0.06) = 1.822 dla każdego, ale prawdopodobieństwo rośnie różnie: A z .130 do .214 (o 8.4 punktu procentowego), B z .438 do .587 (o 14.9 punktu).
Interpretacja
Pielęgniarka A ma ok. 13% przewidywanego prawdopodobieństwa wypalenia, a pielęgniarka B ok. 44%. Ten sam iloraz szans przekłada się na większą zmianę prawdopodobieństwa, gdy wyjściowe p jest bliżej .50.
Typowy błąd
Wstawienie współczynników do wzoru na prawdopodobieństwo tak, jakby to była regresja liniowa („−3.10 + 1.20 + … = −1.90, więc prawdopodobieństwo jest ujemne”). Wynik równania to logit; prawdopodobieństwo dostajesz dopiero po przeliczeniu.
Zadanie 4. Iloraz szans dla predyktora ciągłego na 1 i na 10 jednostek
Treść zadania
W badaniu studentów (dane wymyślone) problemy ze snem (1 = tak) przewidywano wynikiem skali odczuwanego stresu PSS-10 (0–40 punktów). Z wydruku: b = 0.065, SE = 0.021. Oblicz OR z 95% CI dla wzrostu stresu o 1 punkt i o 10 punktów oraz test Walda.
Rozwiązanie krok po kroku
Krok 1. Jeden punkt. OR = e0.065 = 1.067; 95% CI = exp(0.065 ± 1.96 × 0.021) = [1.02, 1.11].
Krok 2. Dziesięć punktów. Mnożysz współczynnik, a nie iloraz szans:
Krok 3. Test Walda. z = b / SE = 0.065 / 0.021 = 3.10, p = .002. Ten sam test w SPSS ma postać Wald = z² (więcej: test Walda).
Interpretacja
OR na 1 punkt wygląda na mały, bo punkt skali 0–40 to niewiele; podaj OR na sensowną jednostkę (10 punktów, 1 SD).
Typowy błąd
Mnożenie procentu przez 10: „1 punkt to +6.7% szans, więc 10 punktów to +67%”. Ilorazy szans się mnożą, a nie dodają – poprawny wynik to +91.6% (OR = 1.916).
Zadanie 5. Odczyt wydruku summary(glm): b, SE, z, p i dwa przedziały dla OR
Treść zadania
W kursie online ze statystyki 60 uczestników; 33 uzyskało certyfikat (1 = tak). Predyktor to liczba lekcji ukończonych w pierwszym tygodniu (0–11). Liczba osób i certyfikatów:
| Lekcje | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| osoby | 4 | 4 | 2 | 5 | 5 | 4 | 12 | 8 | 7 | 2 | 2 | 5 |
| certyfikat | 0 | 1 | 0 | 2 | 2 | 2 | 7 | 5 | 5 | 2 | 2 | 5 |
Wydruk modelu glm(certyfikat ~ lekcje, family = binomial):
            Estimate Std. Error z value Pr(>|z|)
(Intercept)  -2.4060     0.7949  -3.027 0.002472 **
lekcje        0.4691     0.1321   3.551 0.000384 ***
    Null deviance: 82.577  on 59  degrees of freedom
Residual deviance: 63.275  on 58  degrees of freedom
AIC: 67.275
Zinterpretuj współczynnik dla lekcji, oblicz OR z 95% przedziałem Walda i porównaj go z przedziałem z profilu wiarygodności, który R podał jako [1.268, 2.147]. Oblicz prawdopodobieństwo certyfikatu przy 0, 5 i 10 lekcjach.
Rozwiązanie krok po kroku
Krok 1. Kolumny. Estimate to b (skala logitu), Std. Error to SE, z value = 0.469 / 0.132 = 3.55, Pr(>|z|) to p testu Walda (< .001).
Krok 2. OR i przedział Walda. OR = e0.4691 = 1.599. Przedział Walda liczysz jak w zadaniu 4: exp(0.4691 ± 1.96 × 0.1321) = [1.234, 2.071]. Tyle samo daje exp(confint.default(model)).
Krok 3. Przedział profilowy. Funkcja confint(model) liczy przedział z profilu wiarygodności i nie zakłada symetrii wokół b. Tu: [1.268, 2.147] – obie granice przesunięte w górę. Przy dużych próbach oba przedziały prawie się pokrywają, przy małych lepszy jest profilowy (więcej: przedział z profilu wiarygodności).
Krok 4. Prawdopodobieństwa. 0 lekcji: logit = −2.406, p = .083. 5 lekcji: −2.406 + 5 × 0.4691 = −0.061, p = .485. 10 lekcji: 2.285, p = .908.
Interpretacja
Wyraz wolny to logit dla osoby z zerem lekcji. Dewiancje z dołu wydruku przydadzą się w zadaniach 9 i 10.
Typowy błąd
Podanie w tabeli wartości z kolumny Estimate jako ilorazu szans („OR = 0.47”). Estimate to b; ilorazem szans jest eb = 1.60. Napisz też, którego przedziału używasz.
Zadanie 6. Dwa predyktory: iloraz szans „przy kontroli”
Treść zadania
W tych samych danych 23 uczestników pracowało na pełen etat. Certyfikat uzyskało 8 z 23 pracujących na etat i 25 z 37 pozostałych. Osoby pracujące ukończyły w pierwszym tygodniu średnio 3.65 lekcji, a pozostałe 6.92. Oblicz OR dla etatu z tabeli, a potem zinterpretuj model z dwoma predyktorami:
| Predyktor | b | SE | z | p | OR | 95% CI dla OR |
|---|---|---|---|---|---|---|
| wyraz wolny | −2.167 | 0.959 | −2.26 | .024 | 0.115 | [0.01, 0.67] |
| lekcje | 0.446 | 0.141 | 3.16 | .002 | 1.563 | [1.21, 2.13] |
| etat (1 = tak) | −0.299 | 0.677 | −0.44 | .659 | 0.742 | [0.20, 2.91] |
Rozwiązanie krok po kroku
Krok 1. OR bez kontroli. Etat: szansa 8 / 15 = 0.533. Bez etatu: 25 / 12 = 2.083. OR = 0.533 / 2.083 = (8 × 12) / (15 × 25) = 0.256. Model z samym etatem daje to samo: b = −1.363, SE = 0.561, p = .015, 95% CI dla OR [0.08, 0.75].
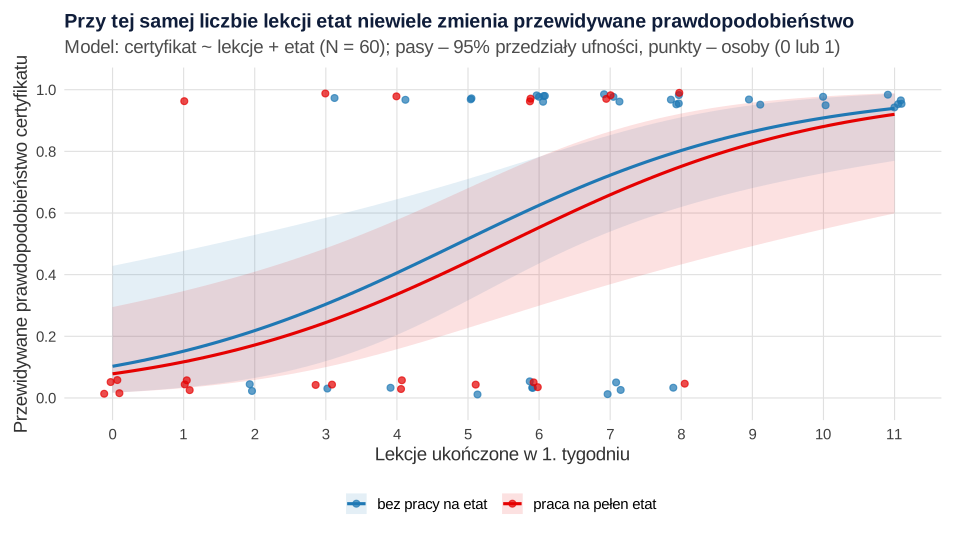
Krok 2. OR przy kontroli lekcji. W modelu z dwoma predyktorami OR dla etatu = e−0.299 = 0.742, p = .659, a przedział [0.20, 2.91] obejmuje 1. Porównujesz teraz osoby z tą samą liczbą lekcji, które różnią się tylko etatem.
Krok 3. Co się stało? Etat wiązał się z mniejszą liczbą lekcji, a lekcje – z certyfikatem, więc w modelu z samym etatem etat „przejmował” efekt lekcji. Czy lekcje są zmienną zakłócającą, czy ogniwem pośrednim, rozstrzyga teoria, nie dane.
Krok 4. Przy 6 lekcjach przewidywane prawdopodobieństwo certyfikatu to .625 bez etatu i .553 z etatem.
Interpretacja
„Przy kontroli” znaczy: przy ustalonej wartości pozostałych predyktorów. Szeroki przedział [0.20, 2.91] nie dowodzi braku efektu etatu.
Typowy błąd
Raportowanie tylko modelu z samym etatem jako „etat zmniejsza szansę certyfikatu o 74%”. To związek surowy, który miesza etat z mniejszą aktywnością na początku kursu.
Zadanie 7. Tabela klasyfikacji przy progu 0.5 i 0.7
Treść zadania
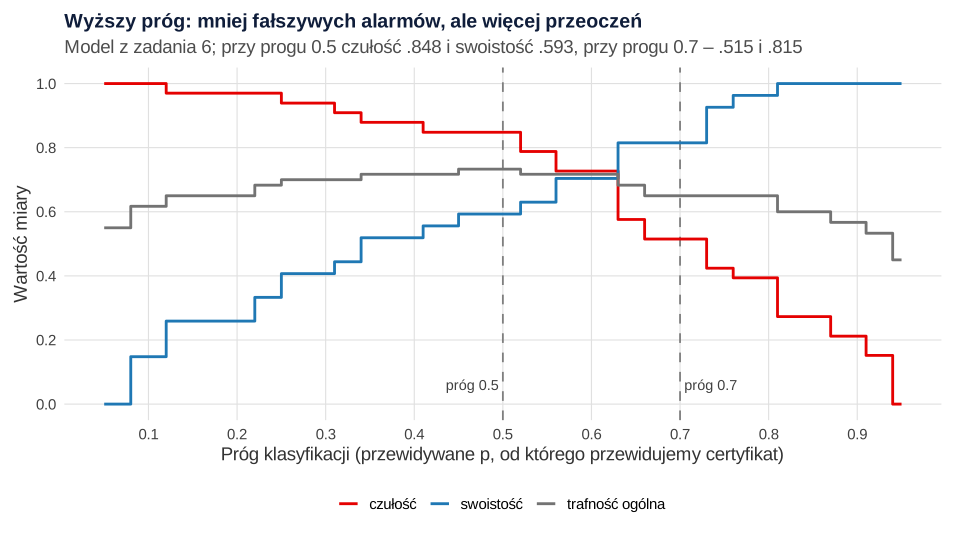
Model z zadania 6 przewiduje certyfikat („tak”), gdy przewidywane p ≥ progu. Przy progu 0.5: prawdziwie dodatnie TP = 28, fałszywie ujemne FN = 5, fałszywie dodatnie FP = 11, prawdziwie ujemne TN = 16. Przy progu 0.7: TP = 17, FN = 16, FP = 5, TN = 22. Oblicz czułość, swoistość i trafność ogólną przy obu progach i porównaj trafność z modelem, który każdemu przewiduje certyfikat.
Rozwiązanie krok po kroku
| Próg | Czułość | Swoistość | Trafność |
|---|---|---|---|
| 0.5 | 28 / 33 = .848 | 16 / 27 = .593 | 44 / 60 = .733 |
| 0.7 | 17 / 33 = .515 | 22 / 27 = .815 | 39 / 60 = .650 |
Model naiwny. Gdyby każdemu przewidzieć certyfikat, trafność wynosiłaby 33 / 60 = .550. Model przy progu 0.5 poprawia ją o 18 punktów procentowych, a przy progu 0.7 – tylko o 10.
Interpretacja
Przy progu 0.5 model rozpoznaje 85% osób, które dostaną certyfikat, ale błędnie wskazuje 11 z 27 pozostałych. Próg 0.7 daje tylko 5 fałszywych wskazań, za to przeocza prawie połowę absolwentów. Wybór progu zależy od kosztu każdej pomyłki. Więcej: czułość i swoistość, punkt odcięcia.
Typowy błąd
Chwalenie modelu za „73% poprawnych klasyfikacji” bez porównania z modelem naiwnym. Przy zdarzeniu występującym u 90% osób model „zawsze tak” ma 90% trafności.
Zadanie 8. AUC policzone z par osób i odczytane z krzywej ROC
Treść zadania
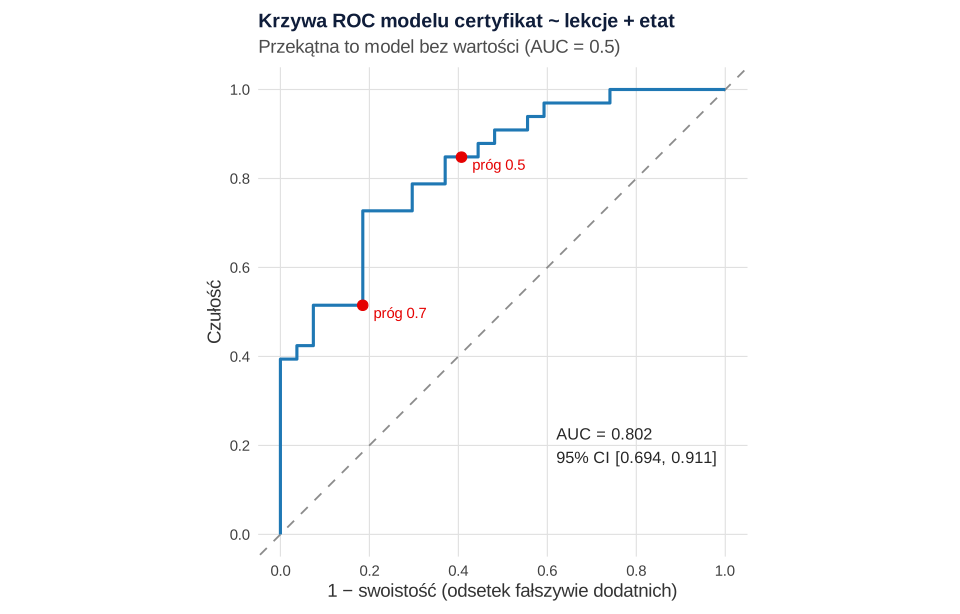
(a) Szpitalny model ryzyka upadku przypisał 4 pacjentom, którzy upadli, prawdopodobieństwa 0.82, 0.64, 0.55 i 0.30, a 5 pacjentom bez upadku – 0.61, 0.40, 0.30, 0.18 i 0.10. Oblicz AUC z par „pacjent z upadkiem – pacjent bez upadku”. (b) Dla modelu z zadania 6 R podał AUC = 0.802, 95% CI [0.694, 0.911]. Zinterpretuj.
Rozwiązanie krok po kroku
Krok 1. Par jest 4 × 5 = 20. Para zgodna (wyższe p u pacjenta z upadkiem) – 1 punkt, remis – 0.5, para niezgodna – 0.
Krok 2. Zliczanie. 0.82 i 0.64 są wyższe od wszystkich pięciu wartości: 5 + 5 = 10. 0.55 przegrywa tylko z 0.61: 4. 0.30 przegrywa z 0.61 i 0.40, remisuje z 0.30 i wygrywa z 0.18 i 0.10: 2 + 0.5 = 2.5. Razem: 16 par zgodnych, 1 remis, 3 pary niezgodne.
Funkcja auc() z pakietu pROC daje to samo.
Krok 3. AUC modelu z zadania 6. AUC = 0.802 oznacza, że w 80% par „osoba z certyfikatem – osoba bez” model przypisał wyższe p osobie z certyfikatem. Model z samymi lekcjami ma AUC = 0.800.
Interpretacja
Hanley i McNeil (1982) pokazali, że pole pod krzywą ROC to prawdopodobieństwo, że losowo wybrana osoba ze zdarzeniem dostanie wyższą ocenę niż losowo wybrana osoba bez zdarzenia – to właśnie policzyłeś w części (a). Zob. krzywa ROC i wybór punktu odcięcia krok po kroku.
Typowy błąd
Liczenie AUC na tych samych danych, na których dopasowano model, i podawanie go jako trafności dla nowych osób. Na nowych danych AUC jest zwykle niższe.
Zadanie 9. Pseudo-R² McFaddena, Coxa i Snella oraz Nagelkerkego
Treść zadania
Dla modelu z zadania 6 (N = 60) logarytm wiarygodności modelu pustego (tylko wyraz wolny) wynosi LL0 = −41.288, a modelu z lekcjami i etatem LL1 = −31.541. Oblicz trzy pseudo-R².
Rozwiązanie krok po kroku
Krok 1. McFadden. Porównuje logarytmy wiarygodności wprost:
Krok 2. Cox i Snell. R²CS = 1 − exp[2(LL0 − LL1) / N] = 1 − exp[2 × (−9.747) / 60] = 1 − exp(−0.325) = 0.277.
Krok 3. Nagelkerke. Cox i Snell nie może dojść do 1; jego maksimum to 1 − exp(2LL0 / N) = 1 − exp(−1.376) = 0.747. Nagelkerke dzieli przez to maksimum: 0.277 / 0.747 = 0.371.
Dewiancje to −2LL: D0 = 82.577 i D1 = 63.083.
Interpretacja
Trzy miary dają trzy różne liczby dla tego samego modelu: .24, .28 i .37. Żadna nie jest „odsetkiem wyjaśnionej wariancji” jak w regresji liniowej. Nagelkerke (1991) zaproponował swoją wersję po to, żeby uogólnione R² mogło sięgać 1 także w modelach dla zmiennych dyskretnych. Menard (2000) porównał analogi R² i stwierdził, że jeden z nich jest koncepcyjnie najbliższy R² z regresji liniowej i najmniej zależy od częstości wyniku, a wnioski z pseudo-R² nie muszą się zgadzać z ocenami trafności przewidywań. Podaj, którą miarę liczysz – zob. pseudo-R².
Typowy błąd
Ocena modelu według progów dla R² z regresji liniowej („0.24 to słabe dopasowanie”). Pseudo-R² mają inne skale i zwykle wychodzą niższe niż R² w regresji liniowej, a porównywać wolno tylko tę samą miarę między modelami na tych samych danych.
Zadanie 10. Test ilorazu wiarygodności i liczba zdarzeń na predyktor
Treść zadania
(a) Czy model z lekcjami i etatem (D1 = 63.083) jest lepszy od modelu pustego (D0 = 82.577)? (b) Czy dodanie etatu do modelu z samymi lekcjami (D = 63.275) poprawia dopasowanie? Porównaj wynik z testem Walda dla etatu (z = −0.44). (c) Ile wynosi EPV i ile predyktorów zmieści się w modelu według reguły 10 zdarzeń na predyktor?
Rozwiązanie krok po kroku
Krok 1. Statystyka to różnica dewiancji, df – różnica liczby parametrów:
Krok 2. Czy etat coś wnosi? Modele są zagnieżdżone (drugi to pierwszy plus etat): χ² = 63.275 − 63.083 = 0.193, df = 1, p = .661. Test Walda daje prawie to samo: z² = 0.194, p = .659. Kryterium AIC też przemawia za prostszym modelem: 67.28 wobec 69.08.
Krok 3. EPV. Certyfikat uzyskały 33 osoby, a nie uzyskało 27. Liczysz rzadszy wynik: EPV = 27 / 2 predyktory = 13.50. Reguła „co najmniej 10 zdarzeń na predyktor” pozwala tu na najwyżej 27 / 10 = 2 predyktory.
Interpretacja
Peduzzi i in. (1996) w symulacjach pokazali, że przy EPV poniżej 10 współczynniki bywają obciążone, a przedziały mają złe pokrycie; van Smeden i in. (2016) ocenili jednak dowody na rzecz sztywnej reguły 10 jako słabe – liczy się też całkowita liczebność i ryzyko separacji. Peng i in. (2002) zalecają opisać w raporcie stosunek liczby obserwacji do liczby predyktorów. Zob. test ilorazu wiarygodności, EPV.
Typowy błąd
Liczenie EPV z liczby wszystkich osób (60 / 2 = 30) albo z częstszego wyniku (33 / 2). EPV liczysz z rzadszej kategorii, a predyktor kategorialny o k poziomach zajmuje k − 1 miejsc.
Ściąga: co liczysz w zadaniu z regresji logistycznej
Najpierw ustal, na jakiej skali jest liczba z treści: prawdopodobieństwo, szansa, logit czy iloraz szans.
| Pytanie w zadaniu | Wzór | W R |
|---|---|---|
| Szansa i logit z prawdopodobieństwa | p / (1 − p); ln[p / (1 − p)] | qlogis(p) |
| Prawdopodobieństwo z równania | 1 / (1 + e−logit) | plogis(), predict(type = "response") |
| Iloraz szans z b | eb; na k jednostek ekb | exp(coef()) |
| Przedział dla OR | exp(b ± 1.96 × SE) (Wald) | confint.default(), confint() (profilowy) |
| Czy model jest lepszy od pustego / od mniejszego | χ² = różnica dewiancji, df = różnica parametrów | anova(m1, m2, test = "LRT") |
| Jak dobrze model rozróżnia | AUC = odsetek par zgodnych | pROC::auc() |
| Jak trafnie klasyfikuje przy danym progu | czułość, swoistość, trafność | table(p_hat >= prog, y) |
| „Ile wyjaśnia” model | pseudo-R² z LL0 i LL1 | logLik() |
Do oceny kalibracji modelu służy też test Hosmera–Lemeshowa, a gotową tabelę wyników przygotujesz według wzoru tabeli APA dla regresji logistycznej. Jeśli liczysz w SPSS, zobacz regresję logistyczną w SPSS.
Inne zbiory zadań
Wszystkie zbiory z rozwiązaniami zebraliśmy na stronie zadania ze statystyki z rozwiązaniami. Najbliższe tematycznie:
- korelacja i regresja – zadania z rozwiązaniami (regresja liniowa, wydruk
summary(lm)), - statystyka medyczna – zadania z rozwiązaniami (RR, OR, czułość, PPV),
- test chi-kwadrat i tabele krzyżowe – zadania z rozwiązaniami,
- estymacja i testowanie hipotez – zadania z rozwiązaniami.
Jeśli po zaliczeniu przychodzi czas na własny model do pracy dyplomowej, możesz skorzystać z konsultacji analizy statystycznej dla studentów.
Sprawdź wyniki w R: kod i wynik
Dwa przepisy liczą wszystkie liczby z rozwiązań na danych wpisanych w kod (bez losowania). Zadania 1–4 są policzone wzorem, tak jak na kartce, a zadanie 2 dodatkowo modelem glm jako kontrola. Zadania 5–10 korzystają z jednego zbioru 60 osób; wzory (OR, przedział Walda, czułość, AUC z par, pseudo-R², różnica dewiancji) są sprawdzone gotowymi funkcjami. Rysunki i plik CSV powstały w osobnym skrypcie, który wczytuje dane z tych przepisów.
Zadania 1–4: szansa, logit, iloraz szans z tabeli i z modelu, prawdopodobieństwo z równania
R
# B389 – zadania 1–4: szansa a prawdopodobieństwo, OR z tabeli 2 × 2 = exp(b), logit -> prawdopodobieństwo,
# OR dla predyktora ciągłego. Dane wpisane na sztywno – te same co w treści zadań. Tylko bazowy R (stats).
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)
z4 <- function(x) formatC(x, format = "f", digits = 4)
bz <- function(x, d = 3) sub("^(-?)0\\.", "\\1.", formatC(x, format = "f", digits = d))   # bez zera przed kropką
pz <- function(p) if (p < .001) "< .001" else paste("=", bz(p))                            # zapis p w APA
szansa <- function(p) p / (1 - p)
logit <- function(p) log(p / (1 - p))
odwr_logit <- function(l) 1 / (1 + exp(-l))
z <- qnorm(0.975)

# Zadanie 1. Rezygnacja z terapii: 18 z 60 pacjentów przerwało terapię
p1 <- 18 / 60
cat("Zadanie 1\n")
cat("prawd. =", z3(p1), "; szansa = p / (1 - p) =", z4(szansa(p1)), "(= 18 / 42); logit =", z3(logit(p1)), "\n")
cat("Szansa 1.5 -> prawd. = 1.5 / (1 + 1.5) =", z3(1.5 / (1 + 1.5)), "; szansa 3 (3 : 1) -> prawd. =", z3(3 / 4), "\n")
porownaj <- function(pa, pb) {
  cat("prawd.:", z2(pa), "vs", z2(pb), "; szanse:", z3(szansa(pa)), "vs", z3(szansa(pb)),
      "; iloraz prawdopodobieństw =", z2(pb / pa), "; iloraz szans =", z2(szansa(pb) / szansa(pa)), "\n")
}
porownaj(0.10, 0.20)
porownaj(0.60, 0.80)
cat("Symetria logitu: logit(.20) =", z3(logit(0.20)), "; logit(.80) =", z3(logit(0.80)), "\n\n")

# Zadanie 2. Program mentorski a zaliczenie 1. roku: tabela 2 × 2 i model z jednym predyktorem 0/1
a <- 45; b <- 15   # mentor: zaliczył / nie zaliczył (60 osób)
c <- 50; d <- 50   # bez mentora: zaliczył / nie zaliczył (100 osób)
OR <- (a * d) / (b * c)
se_lnOR <- sqrt(1 / a + 1 / b + 1 / c + 1 / d)
cat("Zadanie 2\n")
cat("Szansa zaliczenia: mentor =", z3(a / b), "; bez mentora =", z3(c / d), "\n")
cat("OR = (a × d) / (b × c) =", z3(OR), "; ln(OR) =", z4(log(OR)), "; SE ln(OR) =", z3(se_lnOR),
    "; 95% CI [", z2(exp(log(OR) - z * se_lnOR)), ",", z2(exp(log(OR) + z * se_lnOR)), "]\n")
mentor <- rep(c(1, 1, 0, 0), c(a, b, c, d))
zaliczyl <- rep(c(1, 0, 1, 0), c(a, b, c, d))
m2 <- glm(zaliczyl ~ mentor, family = binomial)
print(round(summary(m2)$coefficients, 4))
cat("exp(b0) = szansa w grupie odniesienia =", z3(exp(coef(m2)[1])), "; exp(b1) = OR =", z3(exp(coef(m2)[2])),
    "; z =", z2(summary(m2)$coefficients[2, 3]), "; p", pz(summary(m2)$coefficients[2, 4]), "\n")
cat("Odsetki zaliczeń: mentor =", z3(a / (a + b)), "; bez mentora =", z3(c / (c + d)),
    "; iloraz odsetków (RR) =", z2((a / (a + b)) / (c / (c + d))), "\n\n")

# Zadanie 3. Model wypalenia zawodowego pielęgniarek (współczynniki podane w treści zadania)
b0 <- -3.10; b_nadg <- 0.06; b_zmian <- 0.90; b_wsp <- -0.45
lp <- function(nadg, zmian, wsp) b0 + b_nadg * nadg + b_zmian * zmian + b_wsp * wsp
cat("Zadanie 3\n")
for (os in list(c(20, 1, 2), c(40, 1, 1), c(0, 0, 4))) {
  l <- lp(os[1], os[2], os[3])
  cat("nadgodziny =", os[1], "; zmianowa =", os[2], "; wsparcie =", os[3], "-> logit =", z2(l),
      "; szansa = exp(logit) =", z3(exp(l)), "; prawd. =", z3(odwr_logit(l)), "\n")
}
cat("+10 nadgodzin: OR =", z3(exp(10 * b_nadg)), "\n")
cat("Osoba A (20 -> 30 nadgodzin): prawd.", z3(odwr_logit(lp(20, 1, 2))), "->", z3(odwr_logit(lp(30, 1, 2))),
    "; osoba B (40 -> 50): prawd.", z3(odwr_logit(lp(40, 1, 1))), "->", z3(odwr_logit(lp(50, 1, 1))), "\n\n")

# Zadanie 4. Stres (PSS-10, 0–40) a problemy ze snem: b = 0.065, SE = 0.021 (z wydruku w treści)
b4 <- 0.065; se4 <- 0.021
cat("Zadanie 4\n")
for (k in c(1, 10)) {
  cat("Wzrost o", k, "pkt: OR = exp(", k, "× b) =", z3(exp(k * b4)), "; 95% CI [", z2(exp(k * (b4 - z * se4))), ",",
      z2(exp(k * (b4 + z * se4))), "]\n")
}
cat("OR na 10 pkt z mnożenia: 1.067^10 =", z3(exp(b4)^10), "; błędnie '10 × 6.7%' =", z2(10 * (exp(b4) - 1) * 100), "%\n")
cat("z = b / SE =", z2(b4 / se4), "; p", pz(2 * pnorm(-abs(b4 / se4))), "\n")
Wynik w R
Zadanie 1
prawd. = 0.300 ; szansa = p / (1 - p) = 0.4286 (= 18 / 42); logit = -0.847
Szansa 1.5 -> prawd. = 1.5 / (1 + 1.5) = 0.600 ; szansa 3 (3 : 1) -> prawd. = 0.750
prawd.: 0.10 vs 0.20 ; szanse: 0.111 vs 0.250 ; iloraz prawdopodobieństw = 2.00 ; iloraz szans = 2.25
prawd.: 0.60 vs 0.80 ; szanse: 1.500 vs 4.000 ; iloraz prawdopodobieństw = 1.33 ; iloraz szans = 2.67
Symetria logitu: logit(.20) = -1.386 ; logit(.80) = 1.386

Zadanie 2
Szansa zaliczenia: mentor = 3.000 ; bez mentora = 1.000
OR = (a × d) / (b × c) = 3.000 ; ln(OR) = 1.0986 ; SE ln(OR) = 0.359 ; 95% CI [ 1.48 , 6.06 ]
            Estimate Std. Error z value Pr(>|z|)
(Intercept)   0.0000      0.200  0.0000   1.0000
mentor        1.0986      0.359  3.0601   0.0022
exp(b0) = szansa w grupie odniesienia = 1.000 ; exp(b1) = OR = 3.000 ; z = 3.06 ; p = .002
Odsetki zaliczeń: mentor = 0.750 ; bez mentora = 0.500 ; iloraz odsetków (RR) = 1.50

Zadanie 3
nadgodziny = 20 ; zmianowa = 1 ; wsparcie = 2 -> logit = -1.90 ; szansa = exp(logit) = 0.150 ; prawd. = 0.130
nadgodziny = 40 ; zmianowa = 1 ; wsparcie = 1 -> logit = -0.25 ; szansa = exp(logit) = 0.779 ; prawd. = 0.438
nadgodziny = 0 ; zmianowa = 0 ; wsparcie = 4 -> logit = -4.90 ; szansa = exp(logit) = 0.007 ; prawd. = 0.007
+10 nadgodzin: OR = 1.822
Osoba A (20 -> 30 nadgodzin): prawd. 0.130 -> 0.214 ; osoba B (40 -> 50): prawd. 0.438 -> 0.587

Zadanie 4
Wzrost o 1 pkt: OR = exp( 1 × b) = 1.067 ; 95% CI [ 1.02 , 1.11 ]
Wzrost o 10 pkt: OR = exp( 10 × b) = 1.916 ; 95% CI [ 1.27 , 2.89 ]
OR na 10 pkt z mnożenia: 1.067^10 = 1.916 ; błędnie '10 × 6.7%' = 67.16 %
z = b / SE = 3.10 ; p = .002
Zadania 5–10: wydruk glm, dwa predyktory, klasyfikacja, AUC, pseudo-R² i test ilorazu wiarygodności
R
# B389 – zadania 5–10: wydruk summary(glm), dwa predyktory, tabela klasyfikacji, AUC, pseudo-R², test ilorazu
# wiarygodności i EPV. Dane wpisane na sztywno – te same co w treści zadań. Bazowy R (stats) i pakiet pROC.
suppressPackageStartupMessages(library(pROC))
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)
bz <- function(x, d = 3) sub("^(-?)0\\.", "\\1.", formatC(x, format = "f", digits = d))
pz <- function(p) if (p < .001) "< .001" else paste("=", bz(p))

# 60 uczestników kursu online: lekcje ukończone w 1. tygodniu (0–11), praca na pełen etat (1 = tak),
# certyfikat ukończenia kursu (1 = tak)
lekcje <- c(2, 2, 3, 3, 4, 4, 5, 5, 5, 6, 6, 6, 6, 6, 6, 6, 6, 7, 7, 7, 7, 7, 7, 8, 8, 8, 8, 8, 9, 9, 10, 10,
            11, 11, 11, 11, 11, 0, 0, 0, 0, 1, 1, 1, 1, 3, 3, 3, 4, 4, 4, 5, 6, 6, 6, 6, 7, 7, 8, 8)
etat <- rep(c(0, 1), c(37, 23))
certyfikat <- c(0, 0, 0, 1, 0, 1, 0, 1, 1, 0, 0, 0, 1, 1, 1, 1, 1, 0, 0, 0, 1, 1, 1, 0, 1, 1, 1, 1, 1, 1, 1, 1,
                1, 1, 1, 1, 1, 0, 0, 0, 0, 0, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 0, 1, 1, 1, 1, 0, 1)
cat("N =", length(certyfikat), "; certyfikat:", sum(certyfikat), "; bez certyfikatu:", sum(1 - certyfikat),
    "; etat:", sum(etat), "\n")
cat("Odsetek z certyfikatem: bez etatu =", z3(mean(certyfikat[etat == 0])), "; etat =", z3(mean(certyfikat[etat == 1])),
    "; średnia lekcji: bez etatu =", z2(mean(lekcje[etat == 0])), "; etat =", z2(mean(lekcje[etat == 1])), "\n\n")

# Zadanie 5. Jeden predyktor ciągły: odczyt wydruku i dwa rodzaje przedziałów ufności
m0 <- glm(certyfikat ~ 1, family = binomial)
m1 <- glm(certyfikat ~ lekcje, family = binomial)
cat("Zadanie 5\n")
print(summary(m1))
k1 <- summary(m1)$coefficients
cat("z = b / SE =", z3(k1[2, 1]), "/", z3(k1[2, 2]), "=", z2(k1[2, 1] / k1[2, 2]), "; p", pz(k1[2, 4]), "(dokładnie", format.pval(k1[2, 4], digits = 3), ")\n")
cat("OR = exp(b) =", z3(exp(k1[2, 1])), "\n")
cat("95% CI Walda dla OR (confint.default):", z3(exp(confint.default(m1)[2, ])), "\n")
cat("95% CI z profilu wiarygodności dla OR (confint):", z3(exp(suppressMessages(confint(m1))[2, ])), "\n")
cat("Wald ręcznie: exp(b ± 1.96 × SE) =", z3(exp(k1[2, 1] + c(-1, 1) * qnorm(0.975) * k1[2, 2])), "\n")
cat("prawd. dla 0 lekcji =", z3(plogis(coef(m1)[1])), "; dla 5 lekcji =", z3(plogis(sum(coef(m1) * c(1, 5)))),
    "; dla 10 lekcji =", z3(plogis(sum(coef(m1) * c(1, 10)))), "\n\n")

# Zadanie 6. Dwa predyktory: OR dla etatu bez kontroli i przy kontroli liczby lekcji
m_etat <- glm(certyfikat ~ etat, family = binomial)
m2 <- glm(certyfikat ~ lekcje + etat, family = binomial)
cat("Zadanie 6\n")
tab6 <- table(etat = etat, certyfikat = certyfikat); print(tab6)
cat("OR etatu z tabeli =", z3((tab6[2, 2] * tab6[1, 1]) / (tab6[2, 1] * tab6[1, 2])), "\n")
pokaz <- function(m) {
  k <- summary(m)$coefficients; ci <- exp(suppressMessages(confint(m)))
  print(data.frame(b = round(k[, 1], 3), SE = round(k[, 2], 3), z = round(k[, 3], 2), p = round(k[, 4], 3),
                   OR = round(exp(k[, 1]), 3), CI_dolna = round(ci[, 1], 2), CI_gorna = round(ci[, 2], 2)))
}
cat("Model tylko z etatem:\n"); pokaz(m_etat)
cat("Model z lekcjami i etatem:\n"); pokaz(m2)
cat("prawd. dla 6 lekcji: bez etatu =", z3(predict(m2, data.frame(lekcje = 6, etat = 0), type = "response")),
    "; etat =", z3(predict(m2, data.frame(lekcje = 6, etat = 1), type = "response")), "\n\n")

# Zadanie 7. Tabela klasyfikacji modelu z zadania 6 przy progu 0.5 i 0.7
p_hat <- fitted(m2)
klasyfikacja <- function(prog) {
  przew <- as.integer(p_hat >= prog)
  TP <- sum(przew == 1 & certyfikat == 1); FN <- sum(przew == 0 & certyfikat == 1)
  FP <- sum(przew == 1 & certyfikat == 0); TN <- sum(przew == 0 & certyfikat == 0)
  data.frame(prog, TP, FN, FP, TN, czulosc = round(TP / (TP + FN), 3), swoistosc = round(TN / (TN + FP), 3),
             trafnosc = round((TP + TN) / length(certyfikat), 3))
}
cat("Zadanie 7\n")
print(rbind(klasyfikacja(0.5), klasyfikacja(0.7)), row.names = FALSE)
cat("Model 'wszyscy dostaną certyfikat': trafność =", z3(mean(certyfikat)), "\n\n")

# Zadanie 8. AUC ręcznie (model ryzyka upadku, 4 pacjentów z upadkiem i 5 bez) i AUC modelu z zadania 6
p_upadek <- c(0.82, 0.64, 0.55, 0.30)
p_bez <- c(0.61, 0.40, 0.30, 0.18, 0.10)
pary <- outer(p_upadek, p_bez, function(x, y) ifelse(x > y, 1, ifelse(x == y, 0.5, 0)))
cat("Zadanie 8\n")
dimnames(pary) <- list(upadek = p_upadek, bez_upadku = p_bez); print(pary)
cat("Pary zgodne =", sum(pary == 1), "; remisy =", sum(pary == 0.5), "; niezgodne =", sum(pary == 0),
    "; AUC = (zgodne + 0.5 × remisy) / pary =", sum(pary), "/", length(pary), "=", z3(sum(pary) / length(pary)), "\n")
cat("Kontrola pROC: AUC =", z3(as.numeric(auc(c(rep(1, 4), rep(0, 5)), c(p_upadek, p_bez), quiet = TRUE))), "\n")
roc6 <- roc(certyfikat, p_hat, quiet = TRUE)
cat("AUC modelu z zadania 6 =", z3(as.numeric(auc(roc6))), "; 95% CI (DeLong) [", z3(ci.auc(roc6)[1]), ",", z3(ci.auc(roc6)[3]), "]\n")
cat("AUC modelu tylko z lekcjami =", z3(as.numeric(auc(roc(certyfikat, fitted(m1), quiet = TRUE)))), "\n\n")

# Zadanie 9. Pseudo-R² modelu z zadania 6 z logarytmów wiarygodności
n <- length(certyfikat)
LL0 <- as.numeric(logLik(m0)); LL2 <- as.numeric(logLik(m2))
mcf <- 1 - LL2 / LL0
cs <- 1 - exp(2 * (LL0 - LL2) / n)
nag <- cs / (1 - exp(2 * LL0 / n))
cat("Zadanie 9\n")
cat("LL0 =", z3(LL0), "; LL1 =", z3(LL2), "; dewiancje: D0 =", z3(-2 * LL0), "; D1 =", z3(-2 * LL2), "\n")
cat("McFadden = 1 - LL1 / LL0 =", z3(mcf), "\n")
cat("Cox i Snell = 1 - exp(2(LL0 - LL1) / n) =", z3(cs), "; maksimum Coxa i Snella =", z3(1 - exp(2 * LL0 / n)), "\n")
cat("Nagelkerke = Cox i Snell / maksimum =", z3(nag), "\n")
cat("Tjur (różnica średnich p_hat) =", z3(mean(p_hat[certyfikat == 1]) - mean(p_hat[certyfikat == 0])), "\n\n")

# Zadanie 10. Test ilorazu wiarygodności i liczba zdarzeń na predyktor (EPV)
cat("Zadanie 10\n")
LL1 <- as.numeric(logLik(m1))
G_01 <- -2 * (LL0 - LL2)
cat("Model 0 vs model z lekcjami i etatem: chi^2 = D0 - D1 =", z2(G_01), "; df = 2 ; p", pz(pchisq(G_01, 2, lower.tail = FALSE)), "\n")
G_12 <- -2 * (LL1 - LL2)
cat("Model z lekcjami vs + etat: D =", z3(-2 * LL1), "vs", z3(-2 * LL2), "; chi^2 =", z3(G_12), "; df = 1 ; p =",
    bz(pchisq(G_12, 1, lower.tail = FALSE)), "\n")
print(anova(m1, m2, test = "LRT"))
cat("Dla porównania test Walda dla etatu w modelu 2: z^2 =", z3(summary(m2)$coefficients[3, 3]^2), "; p =",
    bz(summary(m2)$coefficients[3, 4]), "\n")
cat("AIC: model z lekcjami =", z2(AIC(m1)), "; z lekcjami i etatem =", z2(AIC(m2)), "\n")
mniej <- min(sum(certyfikat), sum(1 - certyfikat))
cat("EPV = liczba rzadszego wyniku / liczba parametrów predyktorów =", mniej, "/ 2 =", z2(mniej / 2),
    "; przy regule 10 EPV maksymalnie", floor(mniej / 10), "predyktory\n")
Wynik w R
N = 60 ; certyfikat: 33 ; bez certyfikatu: 27 ; etat: 23
Odsetek z certyfikatem: bez etatu = 0.676 ; etat = 0.348 ; średnia lekcji: bez etatu = 6.92 ; etat = 3.65

Zadanie 5

Call:
glm(formula = certyfikat ~ lekcje, family = binomial)

Coefficients:
            Estimate Std. Error z value Pr(>|z|)
(Intercept)  -2.4060     0.7949  -3.027 0.002472 **
lekcje        0.4691     0.1321   3.551 0.000384 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

(Dispersion parameter for binomial family taken to be 1)

    Null deviance: 82.577  on 59  degrees of freedom
Residual deviance: 63.275  on 58  degrees of freedom
AIC: 67.275

Number of Fisher Scoring iterations: 4

z = b / SE = 0.469 / 0.132 = 3.55 ; p < .001 (dokładnie 0.000384 )
OR = exp(b) = 1.599
95% CI Walda dla OR (confint.default): 1.234 2.071
95% CI z profilu wiarygodności dla OR (confint): 1.268 2.147
Wald ręcznie: exp(b ± 1.96 × SE) = 1.234 2.071
prawd. dla 0 lekcji = 0.083 ; dla 5 lekcji = 0.485 ; dla 10 lekcji = 0.908

Zadanie 6
    certyfikat
etat  0  1
   0 12 25
   1 15  8
OR etatu z tabeli = 0.256
Model tylko z etatem:
                 b    SE     z     p    OR CI_dolna CI_gorna
(Intercept)  0.734 0.351  2.09 0.037 2.083     1.07     4.30
etat        -1.363 0.561 -2.43 0.015 0.256     0.08     0.75
Model z lekcjami i etatem:
                 b    SE     z     p    OR CI_dolna CI_gorna
(Intercept) -2.167 0.959 -2.26 0.024 0.115     0.01     0.67
lekcje       0.446 0.141  3.16 0.002 1.563     1.21     2.13
etat        -0.299 0.677 -0.44 0.659 0.742     0.20     2.91
prawd. dla 6 lekcji: bez etatu = 0.625 ; etat = 0.553

Zadanie 7
 prog TP FN FP TN czulosc swoistosc trafnosc
  0.5 28  5 11 16   0.848     0.593    0.733
  0.7 17 16  5 22   0.515     0.815    0.650
Model 'wszyscy dostaną certyfikat': trafność = 0.550

Zadanie 8
      bez_upadku
upadek 0.61 0.4 0.3 0.18 0.1
  0.82    1   1 1.0    1   1
  0.64    1   1 1.0    1   1
  0.55    0   1 1.0    1   1
  0.3     0   0 0.5    1   1
Pary zgodne = 16 ; remisy = 1 ; niezgodne = 3 ; AUC = (zgodne + 0.5 × remisy) / pary = 16.5 / 20 = 0.825
Kontrola pROC: AUC = 0.825
AUC modelu z zadania 6 = 0.802 ; 95% CI (DeLong) [ 0.694 , 0.911 ]
AUC modelu tylko z lekcjami = 0.800

Zadanie 9
LL0 = -41.288 ; LL1 = -31.541 ; dewiancje: D0 = 82.577 ; D1 = 63.083
McFadden = 1 - LL1 / LL0 = 0.236
Cox i Snell = 1 - exp(2(LL0 - LL1) / n) = 0.277 ; maksimum Coxa i Snella = 0.747
Nagelkerke = Cox i Snell / maksimum = 0.371
Tjur (różnica średnich p_hat) = 0.284

Zadanie 10
Model 0 vs model z lekcjami i etatem: chi^2 = D0 - D1 = 19.49 ; df = 2 ; p < .001
Model z lekcjami vs + etat: D = 63.275 vs 63.083 ; chi^2 = 0.193 ; df = 1 ; p = .661
Analysis of Deviance Table

Model 1: certyfikat ~ lekcje
Model 2: certyfikat ~ lekcje + etat
  Resid. Df Resid. Dev Df Deviance Pr(>Chi)
1        58     63.275
2        57     63.083  1  0.19268   0.6607
Dla porównania test Walda dla etatu w modelu 2: z^2 = 0.194 ; p = .659
AIC: model z lekcjami = 67.28 ; z lekcjami i etatem = 69.08
EPV = liczba rzadszego wyniku / liczba parametrów predyktorów = 27 / 2 = 13.50 ; przy regule 10 EPV maksymalnie 2 predyktory
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats oraz pakietu pROC); rysunki przygotowano w pakietach ggplot2, svglite i magick. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, 77. https://doi.org/10.1186/1471-2105-12-77
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
- magick (wersja 2.9.1): Ooms, J. (2026). magick: Advanced graphics and image-processing in R [R package]. https://doi.org/10.32614/CRAN.package.magick
Najczęstsze pytania
Jakie zadania z regresji logistycznej pojawiają się na kolokwium?
Najczęściej: przeliczenie prawdopodobieństwa na szansę i logit, iloraz szans z tabeli 2 × 2 i z współczynnika b (OR = exp(b)), obliczenie prawdopodobieństwa dla osoby o podanych cechach, odczyt tabeli współczynników (b, SE, z, p, przedział dla OR), interpretacja „przy kontroli” drugiej zmiennej, tabela klasyfikacji z czułością i swoistością, AUC, pseudo-R² i test ilorazu wiarygodności. Zakres zależy od przedmiotu, więc porównaj go z sylabusem.
Jak policzyć przewidywane prawdopodobieństwo, mając tylko współczynniki z tabeli regresji logistycznej?
Wstaw wartości predyktorów do równania, żeby dostać logit, a potem przelicz go wzorem p = 1 / (1 + e−logit). W zadaniu 3 pielęgniarka z 20 nadgodzinami, pracą zmianową i wsparciem 2 ma logit −3.10 + 0.06 × 20 + 0.90 − 0.45 × 2 = −1.90, czyli p = .130. Nie dodawaj ilorazów szans do prawdopodobieństwa – liczysz zawsze przez logit.
Dlaczego predyktor istotny w modelu z jedną zmienną przestaje być istotny po dodaniu drugiej?
Bo wcześniej przejmował efekt zmiennej, z którą jest powiązany. W zadaniu 6 osoby pracujące na etat ukończyły mniej lekcji (średnio 3.65 wobec 6.92), więc sam etat miał OR = 0.26, p = .015, a przy kontroli liczby lekcji OR = 0.74, p = .659. Dlatego w pracy podaj oba modele albo wyjaśnij, które zmienne kontrolowałeś i dlaczego.
Jaki próg klasyfikacji wybrać w regresji logistycznej, jeśli nie 0.5?
Próg 0.5 jest tylko domyślny. Wyższy próg zwiększa swoistość i zmniejsza czułość (w zadaniu 7: przy 0.5 czułość .848 i swoistość .593, przy 0.7 – .515 i .815). Próg wybierasz według kosztu pomyłek: gdy przeoczenie jest groźniejsze niż fałszywy alarm, wybierz niższy; punkt na krzywej ROC możesz też wskazać indeksem Youdena. Samą jakość modelu oceniaj AUC, które od progu nie zależy.
Jak przeliczyć iloraz szans z jednej jednostki na 10 jednostek predyktora?
Pomnóż współczynnik b przez 10 i dopiero wtedy policz exp, czyli OR10 = exp(10 × b) = OR10. Granice przedziału liczysz tak samo: exp(10 × (b ± 1.96 × SE)). W zadaniu 4 OR = 1.067 na 1 punkt skali stresu daje OR = 1.92, 95% CI [1.27, 2.89] na 10 punktów, a nie „67% większe szanse”.
Powiązane hasła
Przeczytaj też
Regresja logistyczna krok po kroku
Ilorazy szans i prawdopodobieństwa przewidywane, założenia, separacja, pseudo-R², AUC i kalibracja, tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikRegresja logistyczna w SPSS
Binary Logistic krok po kroku: kategoria odniesienia, Hosmer–Lemeshow, pseudo-R², tabela klasyfikacji, Exp(B) z przedziałami ufności i zapis APA.
Czytaj →PoradnikKrzywa ROC i punkt odcięcia krok po kroku
AUC z 95% CI, tabela progów, trzy reguły wyboru progu, czułość i swoistość z przedziałami oraz test DeLonga dla dwóch skal – w R z pakietem pROC.
Czytaj →Masz w pracy regresję logistyczną i nie wiesz, jak opisać wyniki?
Pomożemy zbudować model do Twoich hipotez, sprawdzimy obliczenia w R lub SPSS i wyjaśnimy ilorazy szans tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Field, A. (2018). Discovering statistics using IBM SPSS Statistics (5th ed.). SAGE.
- Hanley, J. A., & McNeil, B. J. (1982). The meaning and use of the area under a receiver operating characteristic (ROC) curve. Radiology, 143(1), 29–36. https://doi.org/10.1148/radiology.143.1.7063747
- Menard, S. (2000). Coefficients of determination for multiple logistic regression analysis. The American Statistician, 54(1), 17–24. https://doi.org/10.1080/00031305.2000.10474502
- Nagelkerke, N. J. D. (1991). A note on a general definition of the coefficient of determination. Biometrika, 78(3), 691–692. https://doi.org/10.1093/biomet/78.3.691
- Peduzzi, P., Concato, J., Kemper, E., Holford, T. R., & Feinstein, A. R. (1996). A simulation study of the number of events per variable in logistic regression analysis. Journal of Clinical Epidemiology, 49(12), 1373–1379. https://doi.org/10.1016/s0895-4356(96)00236-3 ● Otwarty dostęp
- Peng, C.-Y. J., Lee, K. L., & Ingersoll, G. M. (2002). An introduction to logistic regression analysis and reporting. The Journal of Educational Research, 96(1), 3–14. https://doi.org/10.1080/00220670209598786
- van Smeden, M., de Groot, J. A. H., Moons, K. G. M., Collins, G. S., Altman, D. G., Eijkemans, M. J. C., & Reitsma, J. B. (2016). No rationale for 1 variable per 10 events criterion for binary logistic regression analysis. BMC Medical Research Methodology, 16(1), Article 163. https://doi.org/10.1186/s12874-016-0267-3 ● Otwarty dostęp
Cytowania BibTeX
@book{field2018discovering, author={Field, Andy}, title={{Discovering statistics using IBM SPSS Statistics}}, year={2018}, edition={5th}, publisher={SAGE}}@article{hanley1982meaning, author={Hanley, James A. and McNeil, Barbara J.}, title={{The meaning and use of the area under a receiver operating characteristic (ROC) curve}}, journal={Radiology}, year={1982}, volume={143}, number={1}, pages={29--36}, doi={10.1148/radiology.143.1.7063747}}@article{menard2000coefficients, author={Menard, Scott}, title={{Coefficients of determination for multiple logistic regression analysis}}, journal={The American Statistician}, year={2000}, volume={54}, number={1}, pages={17--24}, doi={10.1080/00031305.2000.10474502}}@article{nagelkerke1991note, author={Nagelkerke, N. J. D.}, title={{A note on a general definition of the coefficient of determination}}, journal={Biometrika}, year={1991}, volume={78}, number={3}, pages={691--692}, doi={10.1093/biomet/78.3.691}}@article{peduzzi1996simulation, author={Peduzzi, Peter and Concato, John and Kemper, Elizabeth and Holford, Theodore R. and Feinstein, Alvan R.}, title={{A simulation study of the number of events per variable in logistic regression analysis}}, journal={Journal of Clinical Epidemiology}, year={1996}, volume={49}, number={12}, pages={1373--1379}, doi={10.1016/s0895-4356(96)00236-3}}@article{peng2002introduction, author={Peng, Chao-Ying Joanne and Lee, Kuk Lida and Ingersoll, Gary M.}, title={{An introduction to logistic regression analysis and reporting}}, journal={The Journal of Educational Research}, year={2002}, volume={96}, number={1}, pages={3--14}, doi={10.1080/00220670209598786}}@article{vansmeden2016no, author={van Smeden, Maarten and de Groot, Joris A. H. and Moons, Karel G. M. and Collins, Gary S. and Altman, Douglas G. and Eijkemans, Marinus J. C. and Reitsma, Johannes B.}, title={{No rationale for 1 variable per 10 events criterion for binary logistic regression analysis}}, journal={BMC Medical Research Methodology}, year={2016}, volume={16}, number={1}, eid={163}, doi={10.1186/s12874-016-0267-3}}