Trzy grupy, dwie wariancje
Nazwa „analiza wariancji” myli, bo pytanie dotyczy średnich: czy trzy (albo więcej) grupy różnią się przeciętnym wynikiem. Odpowiedź przychodzi jednak przez porównanie dwóch rodzajów zmienności. Pierwszy to rozrzut średnich grup wokół średniej ogólnej (wariancja międzygrupowa). Drugi to rozrzut osób wokół średniej własnej grupy (wariancja wewnątrzgrupowa). Wzory, założenia, test Welcha, post hoc i zapis APA krok po kroku są we wpisie ANOVA krok po kroku. Tutaj tych procedur nie powtarzamy. Pokazujemy na pięciu rysunkach, co robi statystyka F, i sprawdzamy, czego z niej nie da się wyczytać.
Przykład jest fikcyjny: 45 osób czyta jedną z trzech wersji ulotki o leku (A, B, C – po 15 osób), a potem rozwiązuje test zrozumienia (0–100 pkt). Średnie grup ustawiliśmy ręcznie na 50, 55 i 60 pkt. Ten sam układ średnich dostał dwa warianty rozrzutu w grupach: SD = 5 i SD = 15. Odchylenia osób od średnich są w obu wariantach te same, tylko rozciągnięte trzy razy. Dzięki temu porównanie dotyczy wyłącznie rozrzutu, a różnice średnich zostają identyczne. Przy każdym rysunku znajdziesz: co widać, czego wykres nie pokazuje, gotowy podpis w stylu APA i zdanie do pracy.
Rysunek 1: te same średnie, inny rozrzut wewnątrz grup
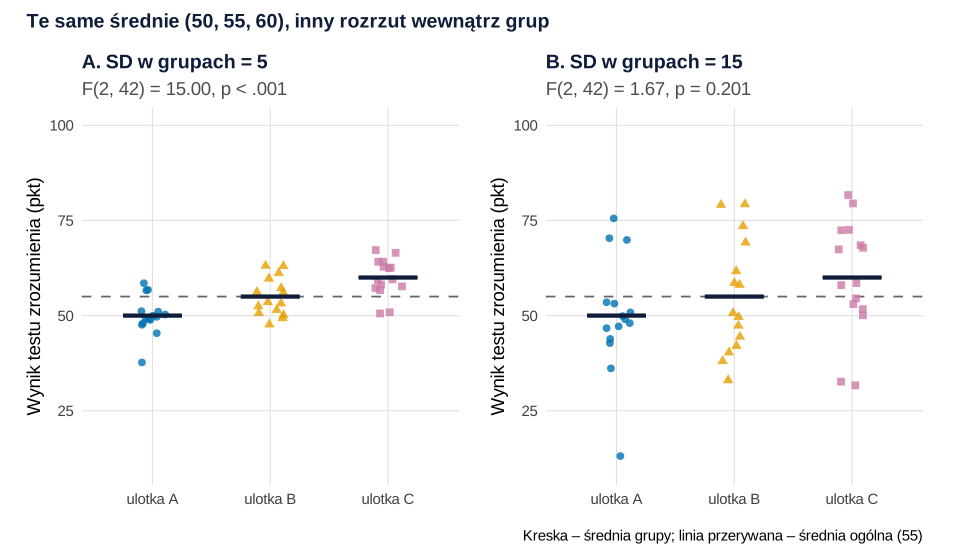
set.seed(578)).Co widać. W obu panelach kreski średnich leżą na tej samej wysokości: 50, 55 i 60 pkt. W panelu A punkty trzymają się blisko swoich kresek, a grupy prawie się nie przenikają; jednoczynnikowa ANOVA daje F(2, 42) = 15.00, p < .001. W panelu B te same osoby, z odchyleniami trzy razy większymi, wypełniają cały wykres, a punkty z różnych grup mocno się przenikają. Tu F(2, 42) = 1.67, p = .201. Wniosek z rysunku jest prosty: różnica średnich sama nic nie znaczy, dopóki nie zestawi się jej z rozrzutem osób. To właśnie robi F.
Czego ten wykres nie pokazuje. Rysunek nie mówi, czy rozrzut jest w grupach podobny – tu jest identyczny z konstrukcji, ale w prawdziwych danych homogeniczność wariancji trzeba sprawdzić, a przy różnych SD i różnych liczebnościach lepsza jest ANOVA Welcha. Przy 15 osobach w grupie punkty z jitterem są czytelne. Przy kilkuset osobach potrzebny jest inny wykres – porównanie wariantów (pudełko, skrzypce, raincloud) jest we wpisie od słupka do raincloud.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: odchylenie od średniej ogólnej rozbite na dwie części
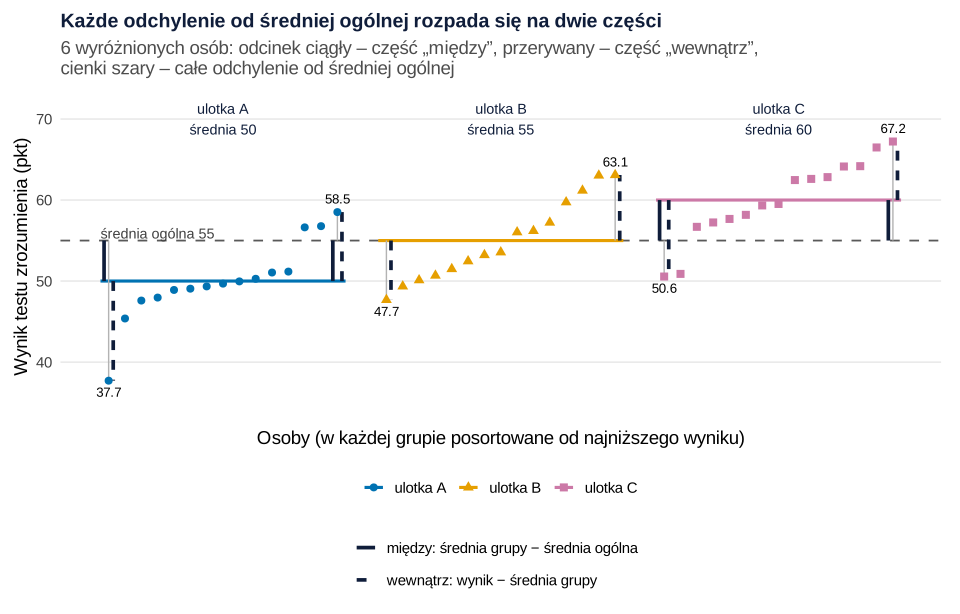
Co widać. Każdy wynik leży w jakiejś odległości od średniej ogólnej (cienki szary odcinek). Tę odległość da się zawsze rozłożyć na dwa kawałki. Pierwszy prowadzi od średniej ogólnej do średniej grupy i jest taki sam dla wszystkich osób w grupie (odcinek ciągły). Drugi prowadzi od średniej grupy do wyniku osoby (odcinek przerywany). Najsłabsza osoba z ulotki A ma 37.7 pkt, czyli −17.3 pkt od średniej ogólnej: −5 pkt przypada na grupę, a −12.3 na samą osobę. W ulotce B kawałek „między” ma długość zero, bo średnia tej grupy pokrywa się ze średnią ogólną. Po podniesieniu wszystkich kawałków do kwadratu i zsumowaniu po 45 osobach dostajemy trzy sumy kwadratów: SS między = 750, SS wewnątrz = 1050 i SS całkowitą = 1800. Suma pierwszych dwóch daje dokładnie trzecią. W panelu B rysunku 1 SS między zostaje równe 750, a SS wewnątrz rośnie do 9450.
Jak może zmylić. Odcinki się dodają, ale rozkład dotyczy kwadratów zsumowanych po wszystkich osobach, nie pojedynczych długości. Dla jednej osoby 17.3² ≠ 5² + 12.3², bo pojedyncze iloczyny mieszane nie znikają. Znikają dopiero w sumie, dlatego zdanie „osoba X jest odległa od średniej głównie z powodu grupy” nie ma sensu. Ta sama geometria rządzi regresją: SST = SSR + SSE z wpisu metoda najmniejszych kwadratów w obrazkach to ten sam rozkład, tylko z prostą zamiast średnich grup. ANOVA da się też ująć jako porównanie dwóch modeli liniowych: z osobną średnią dla każdej grupy i z jedną wspólną średnią. To ujęcie rozwijają Maxwell i in. (2018).
Podpis do pracy:
Zdanie do Metody (gdy wyjaśniasz logikę analizy, np. w pracy dydaktycznej):
Rysunek 3: F jako iloraz średnich kwadratów, η² jako udział
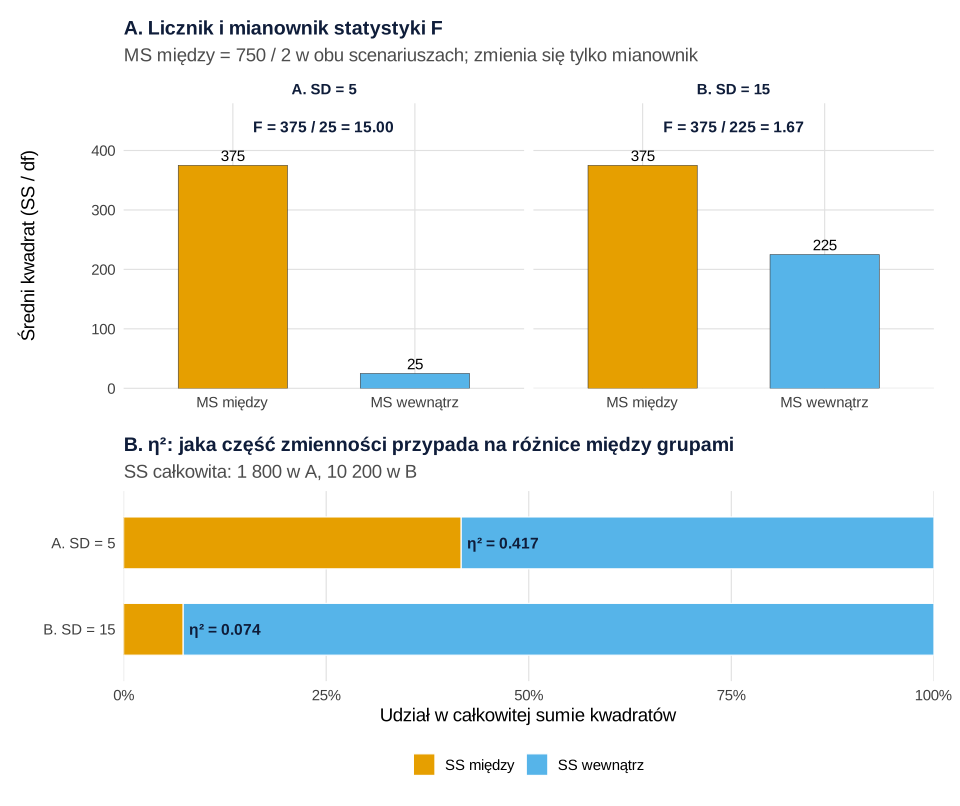
Co widać. Sumy kwadratów rosną z liczbą osób i grup, więc przed porównaniem dzieli się je przez stopnie swobody. Licznik to MS między = 750 / 2 = 375, mianownik to MS wewnątrz = 1050 / 42 = 25 w panelu A i 9450 / 42 = 225 w panelu B. F to iloraz tych dwóch słupków: 375 / 25 = 15.00 i 375 / 225 = 1.67. Licznik jest w obu scenariuszach ten sam, zmienia się tylko mianownik. Gdyby średnie w populacji były równe, oba średnie kwadraty szacowałyby tę samą wariancję i F krążyłoby wokół 1. Skąd bierze się sam rozkład F przy prawdziwej H0, pokazujemy we wpisie skąd się biorą rozkłady t, χ² i F.
Panel B pokazuje drugą liczbę z tych samych sum. η² to udział SS między w SS całkowitej, czyli odsetek całej zmienności wyników związany z przynależnością do grup (Richardson, 2011). W scenariuszu A wynosi .417, w scenariuszu B – .074. Mniej obciążony odpowiednik, ω², daje .384 i .029.
Czego ten wykres nie pokazuje. Słupki MS nie mają jednostek, które da się zinterpretować (to punkty do kwadratu), więc rysunek tłumaczy mechanizm, a nie nadaje się do raportu wyników. η² nie mówi też, które grupy się różnią: η² = .417 może powstać z wielu różnych układów średnich (rysunek 5). Przy kilku czynnikach η² i cząstkowe η² mają różne mianowniki i łatwo je pomylić. Jak liczyć i raportować wielkość efektu w ANOVA, żeby dało się ją porównywać między badaniami, opisuje Lakens (2013); zob. też wpis wielkość efektu – interpretacja.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: ta sama różnica średnich, rosnące n
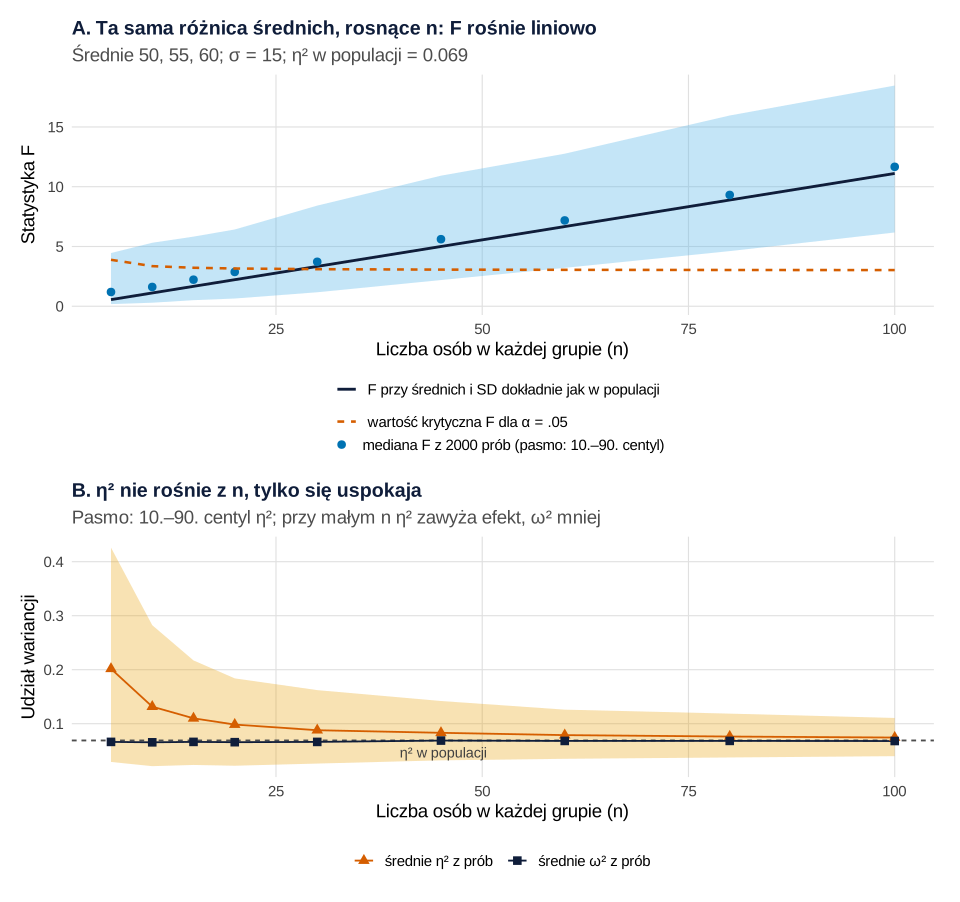
set.seed(5784), 2000 powtórzeń dla każdego n).Co widać. Średnie w populacji są stałe (50, 55, 60 pkt, σ = 15), a zmienia się tylko liczba osób w grupie. Ciemna prosta to F dla danych, w których średnie i SD wychodzą dokładnie jak w populacji: F = n/9, czyli 1.67 przy 15 osobach (scenariusz B z rysunku 1), 6.67 przy 60 i 11.11 przy 100. Licznik F to n razy rozrzut średnich, więc przy tej samej różnicy F rośnie proporcjonalnie do n. Punkty pokazują medianę F z 2000 losowych prób dla każdego n. Leżą nieco nad prostą, bo przy prawdziwej różnicy rozkład F jest prawoskośny (niecentralny). Pasmo 10.–90. centyla pokazuje, jak bardzo F skacze między próbami. Przy 15 osobach w grupie test był istotny w 32.8% prób (błąd Monte Carlo 1.0 pp), przy 60 – w 91.3% (0.6 pp). Krzywe mocy w zależności od n i wielkości efektu rysujemy we wpisie moc testu w obrazkach.
Panel B to druga strona tej samej symulacji. Efekt w populacji to η² = .069 i nie zależy od n. Średnie η² z prób wynosi jednak .202 przy 5 osobach w grupie, .110 przy 15 i dopiero przy 100 schodzi do .074. Przy małych grupach różnice średnich z próby są zawsze trochę większe niż w populacji, a η² zapisuje cały ten nadmiar jako efekt. Kelley (1935) zwracał uwagę, że stosunek korelacyjny z próby różni się od populacyjnego systematycznie, w zależności od liczby grup, i zaproponował miarę nieobciążoną. ω² koryguje to obciążenie: jego średnia leży przy .066–.069 dla każdego n.
Jak może zmylić. Duże F i małe p przy setkach osób nie oznaczają dużego efektu, a małe F przy 15 osobach nie oznacza braku różnic. Rysunek pokazuje jeden układ średnich i dane normalne o równych wariancjach. Nie pokazuje, co się dzieje przy nierównych grupach i różnych SD – tam klasyczne F może odrzucać H0 za często albo za rzadko.
Podpis do pracy:
Zdanie do Metody (przy uzasadnieniu liczebności):
Rysunek 5: czego nie mówi samo F – przedziały Tukeya
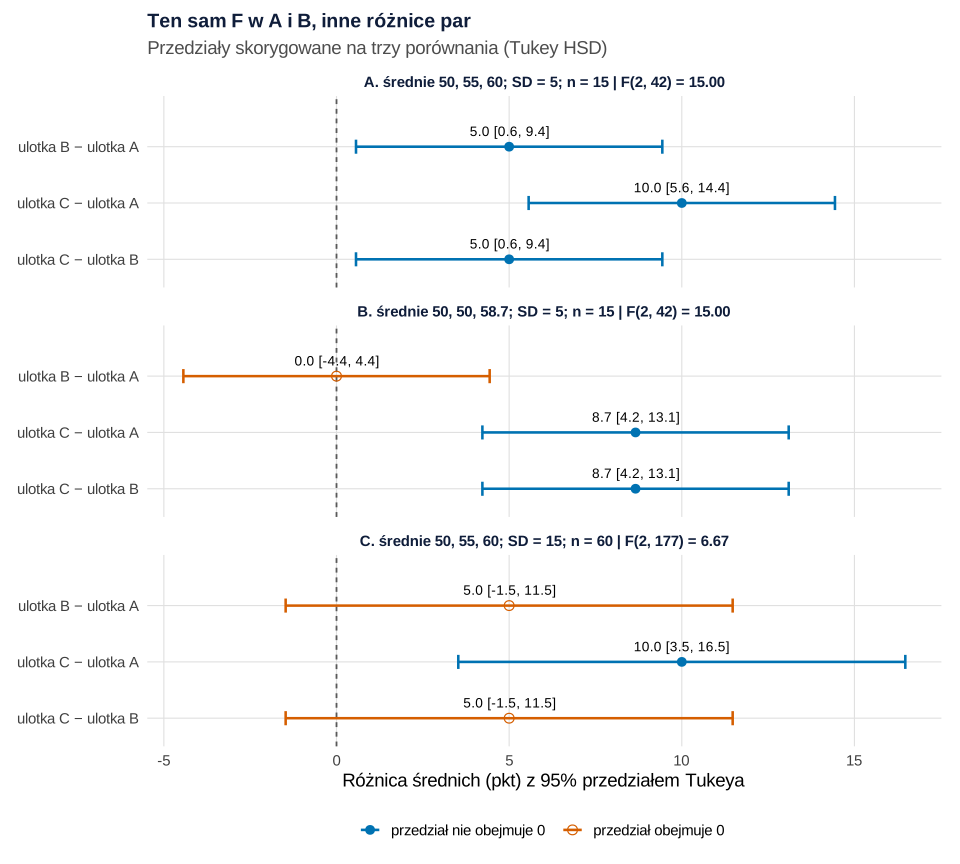
set.seed(578) i set.seed(5785)).Co widać. Istotne F mówi tylko, że nie wszystkie średnie w populacji są równe. Właśnie dlatego Tukey (1949) zaproponował procedurę porównywania poszczególnych średnich po ANOVA. Panele A i B mają identyczne F(2, 42) = 15.00 i identyczne η² = .417, a opowiadają inne historie. Średnie w B (50, 50 i 58.7) dobraliśmy ręcznie tak, żeby suma kwadratów między grupami była taka sama jak w A. W A każda kolejna ulotka jest lepsza od poprzedniej: wszystkie trzy przedziały leżą na prawo od zera, choć dwa ledwo (5.0 pkt, 95% CI [0.6, 9.4]). W B ulotki A i B nie różnią się wcale (0.0 [−4.4, 4.4]), a cała różnica to przewaga ulotki C (8.7 [4.2, 13.1]). Panel C to scenariusz z rysunku 4 przy 60 osobach w grupie: F(2, 177) = 6.67, p = .002. Mimo to tylko porównanie skrajnych wersji (10.0 [3.5, 16.5]) wyklucza zero, a sąsiednie różnice po 5 pkt mieszczą się w przedziale od −1.5 do 11.5.
Czego ten wykres nie pokazuje. Przedziały Tukeya są poszerzone tak, żeby wszystkie trzy jednocześnie obejmowały prawdziwe różnice z prawdopodobieństwem 95%. Dlatego są szersze niż zwykłe przedziały dla jednej różnicy, a ich szerokość zależy od tego, ile par porównujesz. Który test post hoc wybrać przy nierównych wariancjach, porównaniach z kontrolą albo kontrastach planowanych, opisuje wpis testy post hoc – który wybrać. Przegląd Midwaya i in. (2020) zaleca test HSD Tukeya (albo poprawkę Bonferroniego) do porównań wszystkich par, ale przede wszystkim porównania zaplanowane przed zebraniem danych. Rysunek nie pokazuje też rozrzutu osób. Różnica 10 pkt przy SD = 15 to wciąż mocno nakładające się grupy (zob. wielkość efektu w obrazkach).
Podpis do pracy:
Zdanie do Wyników (scenariusz C):
Który obraz do pracy
- Wyniki jednoczynnikowej ANOVA: punkty osób ze średnimi grup (rysunek 1) albo średnie z przedziałami ufności – plus tabela z F, df, p i η² (wzór: tabela ANOVA w APA).
- Istotne F i pytanie „które grupy?”: wykres różnic par z przedziałami Tukeya (rysunek 5). Pokazuje wielkość i niepewność różnic, a nie tylko gwiazdki.
- Wyjaśnienie logiki analizy (praca dydaktyczna, prezentacja na obronę): rozkład odchyleń (rysunek 2) i słupki średnich kwadratów (rysunek 3). Do rozdziału Wyników się nie nadają.
- Uzasadnienie liczebności próby: symulacja jak na rysunku 4, z efektem, który uważasz za najmniejszy ważny.
- Dane wyraźnie nienormalne albo porządkowe: rozważ test Kruskala–Wallisa; okna programów opisują wpisy ANOVA w jamovi i ANOVA w SPSS.
Kod R wszystkich rysunków i liczb
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 definiuje motyw, paletę i dane, z których korzystają następne. Każdy przepis tworzy obiekt wykresu (p1–p5); wpisz jego nazwę, żeby go wyświetlić, a do zapisu użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały dokładnie z tego kodu: motyw to skrócona wersja motywu serwisu, a pliki zapisano w formacie SVG.
Dane są fikcyjne. Średnie grup (50, 55, 60 pkt), odchylenia standardowe (5 i 15 pkt) i liczebności ustaliliśmy ręcznie tak, żeby różnica między scenariuszami dotyczyła tylko rozrzutu; losowe wartości z standaryzujemy w każdej grupie, więc średnie i SD wychodzą dokładnie takie, jak ustawione. Średnie scenariusza B na rysunku 5 (50, 50 i 50 + √75 ≈ 58.7) dobraliśmy tak, żeby F było identyczne jak w scenariuszu A. Ziarna ustaliliśmy raz i nie zmienialiśmy ich: 578 (dane do rysunków 1–3 i paneli A–B rysunku 5), 5784 (symulacja do rysunku 4) i 5785 (scenariusz C rysunku 5); każdy przepis, który losuje, ustawia własne ziarno. Symulacja w przepisie 4 ma 2000 powtórzeń dla każdej liczebności; błąd Monte Carlo odsetka istotnych wyników to √(p(1 − p)/2000). Dane obu scenariuszy z rysunku 1 (90 wierszy, wyniki zaokrąglone do trzech miejsc) pobierzesz jako plik anova-w-obrazkach-dane.csv (kolumny scenariusz, grupa, osoba, wynik).
1. Motyw, paleta, dane i dwa panele: Rysunek 1
R
# Rysunek 1. Te same średnie, różny rozrzut wewnątrz grup (dane fikcyjne: 3 wersje ulotki, po 15 osób)
library(ggplot2)
library(patchwork)

# Motyw i paleta (odcienie Okabe–Ito sprawdzone w symulacji deuteranopii; grupy mają też różne kształty)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.05)),
        plot.subtitle = element_text(colour = "grey30"),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        axis.text = element_text(colour = "grey25"), strip.text = element_text(face = "bold", colour = "#0f1d3a"),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA),
        plot.margin = margin(10, 14, 10, 10))
grupy <- c("ulotka A", "ulotka B", "ulotka C")
kol <- setNames(c("#0072B2", "#E69F00", "#CC79A7"), grupy)
ksztalt <- setNames(c(16, 17, 15), grupy)

# Dane fikcyjne: losowe z, potem standaryzacja w każdej grupie, żeby średnie i SD były dokładnie takie,
# jakie ustawiliśmy ręcznie (50, 55, 60; SD = 5 albo 15)
set.seed(578)                                   # ziarno ustalone raz, bez dobierania pod wynik
n <- 15
z <- apply(matrix(rnorm(n * 3), n, 3), 2, function(x) (x - mean(x)) / sd(x))
zbuduj <- function(srednie, sd, z) {
  data.frame(grupa = factor(rep(grupy, each = nrow(z)), levels = grupy),
             osoba = rep(seq_len(nrow(z)), 3),
             wynik = as.vector(sweep(sd * z, 2, srednie, "+")))
}
maly  <- zbuduj(c(50, 55, 60), sd = 5,  z = z)   # mały rozrzut wewnątrz grup
duzy  <- zbuduj(c(50, 55, 60), sd = 15, z = z)   # duży rozrzut, te same średnie
# write.csv(rbind(cbind(scenariusz = "SD 5", maly), cbind(scenariusz = "SD 15", duzy)),
#           "anova-w-obrazkach-dane.csv", row.names = FALSE)

opis_F <- function(d) {
  a <- summary(aov(wynik ~ grupa, data = d))[[1]]
  sprintf("F(%d, %d) = %.2f, p %s", a$Df[1], a$Df[2], a$`F value`[1],
          ifelse(a$`Pr(>F)`[1] < .001, "< .001", sprintf("= %.3f", a$`Pr(>F)`[1])))
}
aggregate(wynik ~ grupa, data = maly, function(x) c(M = mean(x), SD = sd(x)))
aggregate(wynik ~ grupa, data = duzy, function(x) c(M = mean(x), SD = sd(x)))
summary(aov(wynik ~ grupa, data = maly))
summary(aov(wynik ~ grupa, data = duzy))

panel1 <- function(d, tytul) {
  sr <- aggregate(wynik ~ grupa, data = d, mean)
  ggplot(d, aes(grupa, wynik, colour = grupa, shape = grupa)) +
    geom_hline(yintercept = mean(d$wynik), linetype = "dashed", colour = "grey40") +
    geom_jitter(width = 0.12, height = 0, size = 2.3, alpha = 0.8) +
    geom_crossbar(data = sr, aes(ymin = wynik, ymax = wynik), width = 0.5, linewidth = 0.6, colour = "#0f1d3a") +
    scale_colour_manual(values = kol, guide = "none") + scale_shape_manual(values = ksztalt, guide = "none") +
    coord_cartesian(ylim = c(10, 100)) +
    labs(x = NULL, y = "Wynik testu zrozumienia (pkt)", title = tytul, subtitle = opis_F(d)) + motyw
}
p1 <- panel1(maly, "A. SD w grupach = 5") + panel1(duzy, "B. SD w grupach = 15") +
  plot_annotation(title = "Te same średnie (50, 55, 60), inny rozrzut wewnątrz grup",
                  caption = "Kreska – średnia grupy; linia przerywana – średnia ogólna (55)",
                  theme = motyw)
# p1   # zapis: ggsave("anova-te-same-srednie-rozny-rozrzut.svg", p1, width = 10, height = 5.8)
Wynik w R
     grupa wynik.M wynik.SD
1 ulotka A      50        5
2 ulotka B      55        5
3 ulotka C      60        5
     grupa wynik.M wynik.SD
1 ulotka A      50       15
2 ulotka B      55       15
3 ulotka C      60       15
            Df Sum Sq Mean Sq F value   Pr(>F)
grupa        2    750     375      15 1.21e-05 ***
Residuals   42   1050      25
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
            Df Sum Sq Mean Sq F value Pr(>F)
grupa        2    750     375   1.667  0.201
Residuals   42   9450     225
2. Odchylenia „między” i „wewnątrz” oraz sumy kwadratów: Rysunek 2
R
# Rysunek 2. Odchylenie od średniej ogólnej = część „między” + część „wewnątrz” (dane `maly`, SD = 5)
# kontynuacja: maly, duzy, grupy, kol, ksztalt, motyw z bloku 1

d2 <- maly
d2$x <- ave(d2$wynik, d2$grupa, FUN = function(v) rank(v, ties.method = "first")) + (as.integer(d2$grupa) - 1) * 17
d2$srednia_grupy <- ave(d2$wynik, d2$grupa)
M <- mean(d2$wynik)

# Wyróżnione osoby: najniższy i najwyższy wynik w każdej grupie (reguła ustalona z góry)
wyr <- do.call(rbind, lapply(split(d2, d2$grupa), function(g) g[c(which.min(g$wynik), which.max(g$wynik)), ]))
wyr$calkowite <- wyr$wynik - M
wyr$miedzy    <- wyr$srednia_grupy - M
wyr$wewnatrz  <- wyr$wynik - wyr$srednia_grupy
print(transform(wyr[, c("grupa", "wynik", "srednia_grupy", "calkowite", "miedzy", "wewnatrz")],
                wynik = round(wynik, 2), calkowite = round(calkowite, 2), wewnatrz = round(wewnatrz, 2)),
      row.names = FALSE)

# Sumy kwadratów: SS całkowita = SS między + SS wewnątrz (dla obu scenariuszy)
sumy <- function(d) {
  m <- ave(d$wynik, d$grupa); M <- mean(d$wynik)
  c(SS_miedzy = sum((m - M)^2), SS_wewnatrz = sum((d$wynik - m)^2), SS_calkowita = sum((d$wynik - M)^2))
}
round(rbind(maly = sumy(maly), duzy = sumy(duzy)), 2)

grp_lin <- aggregate(cbind(x, srednia_grupy) ~ grupa, data = d2,
                     FUN = function(v) c(min = min(v), max = max(v), m = mean(v)))
grp_lin <- data.frame(grupa = grp_lin$grupa, x0 = grp_lin$x[, "min"] - 0.5, x1 = grp_lin$x[, "max"] + 0.5,
                      y = grp_lin$srednia_grupy[, "m"])
odc <- rbind(data.frame(x = wyr$x - 0.28, y0 = M, y1 = wyr$srednia_grupy, czesc = "między: średnia grupy − średnia ogólna"),
             data.frame(x = wyr$x + 0.28, y0 = wyr$srednia_grupy, y1 = wyr$wynik, czesc = "wewnątrz: wynik − średnia grupy"))
odc$czesc <- factor(odc$czesc, levels = unique(odc$czesc))

p2 <- ggplot(d2, aes(x, wynik)) +
  geom_hline(yintercept = M, linetype = "dashed", colour = "grey35") +
  annotate("text", x = 0.5, y = M + 0.9, label = "średnia ogólna 55", hjust = 0, size = 3.8, colour = "grey25") +
  geom_segment(data = grp_lin, aes(x = x0, xend = x1, y = y, yend = y, colour = grupa), linewidth = 1.1,
               inherit.aes = FALSE) +
  geom_segment(data = wyr, aes(x = x, xend = x, y = M, yend = wynik), colour = "grey70", linewidth = 0.5) +
  geom_segment(data = odc, aes(x = x, xend = x, y = y0, yend = y1, linetype = czesc), linewidth = 1.3,
               colour = "#0f1d3a", inherit.aes = FALSE) +
  geom_point(aes(colour = grupa, shape = grupa), size = 2.4) +
  geom_text(data = wyr, aes(label = sprintf("%.1f", wynik), vjust = ifelse(wewnatrz > 0, -0.9, 1.7)), size = 3.5) +
  annotate("text", x = grp_lin$x0 + 7.5, y = 70, label = paste0(grupy, "\nśrednia ", grp_lin$y), size = 3.8,
           colour = "#0f1d3a") +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = ksztalt, name = NULL) +
  scale_linetype_manual(values = c("solid", "22"), name = NULL) +
  scale_x_continuous(breaks = NULL) + coord_cartesian(ylim = c(34, 72)) +
  guides(colour = guide_legend(order = 1), shape = guide_legend(order = 1), linetype = guide_legend(nrow = 2, order = 2)) +
  labs(x = "Osoby (w każdej grupie posortowane od najniższego wyniku)", y = "Wynik testu zrozumienia (pkt)",
       title = "Każde odchylenie od średniej ogólnej rozpada się na dwie części",
       subtitle = "6 wyróżnionych osób: odcinek ciągły – część „między”, przerywany – część „wewnątrz”,\ncienki szary – całe odchylenie od średniej ogólnej") +
  motyw + theme(legend.box = "vertical")
# p2   # zapis: ggsave("anova-rozklad-odchylen-miedzy-wewnatrz.svg", p2, width = 10, height = 6.4)
Wynik w R
    grupa wynik srednia_grupy calkowite miedzy wewnatrz
 ulotka A 37.70            50    -17.30     -5   -12.30
 ulotka A 58.51            50      3.51     -5     8.51
 ulotka B 47.68            55     -7.32      0    -7.32
 ulotka B 63.09            55      8.09      0     8.09
 ulotka C 50.56            60     -4.44      5    -9.44
 ulotka C 67.22            60     12.22      5     7.22
     SS_miedzy SS_wewnatrz SS_calkowita
maly       750        1050         1800
duzy       750        9450        10200
3. Średnie kwadraty, F, η² i ω²: Rysunek 3
R
# Rysunek 3. F = MS między / MS wewnątrz (słupki) i η² = SS między / SS całkowita (udział)
# kontynuacja: maly, duzy, motyw z bloku 1

tabela <- function(d, nazwa) {
  a <- summary(aov(wynik ~ grupa, data = d))[[1]]
  data.frame(scenariusz = nazwa, SS_miedzy = a$`Sum Sq`[1], SS_wewnatrz = a$`Sum Sq`[2],
             df_miedzy = a$Df[1], df_wewnatrz = a$Df[2],
             MS_miedzy = a$`Mean Sq`[1], MS_wewnatrz = a$`Mean Sq`[2], F = a$`F value`[1],
             eta2 = a$`Sum Sq`[1] / sum(a$`Sum Sq`),
             omega2 = (a$`Sum Sq`[1] - a$Df[1] * a$`Mean Sq`[2]) / (sum(a$`Sum Sq`) + a$`Mean Sq`[2]))
}
t3 <- rbind(tabela(maly, "A. SD = 5"), tabela(duzy, "B. SD = 15"))
print(t3, digits = 4, row.names = FALSE)

d3a <- rbind(data.frame(scenariusz = t3$scenariusz, co = "MS między", MS = t3$MS_miedzy),
             data.frame(scenariusz = t3$scenariusz, co = "MS wewnątrz", MS = t3$MS_wewnatrz))
d3a$co <- factor(d3a$co, levels = c("MS między", "MS wewnątrz"))
p3a <- ggplot(d3a, aes(co, MS, fill = co)) +
  geom_col(width = 0.6, colour = "grey20", linewidth = 0.2) +
  geom_text(aes(label = sprintf("%.0f", MS)), vjust = -0.4, size = 4) +
  geom_text(data = t3, aes(x = 1.5, y = 440, label = sprintf("F = %.0f / %.0f = %.2f", MS_miedzy, MS_wewnatrz, F)),
            inherit.aes = FALSE, size = 4.1, fontface = "bold", colour = "#0f1d3a") +
  facet_wrap(~ scenariusz) +
  scale_fill_manual(values = c("MS między" = "#E69F00", "MS wewnątrz" = "#56B4E9"), guide = "none") +
  scale_y_continuous(limits = c(0, 470), expand = expansion(mult = c(0, 0.02))) +
  labs(x = NULL, y = "Średni kwadrat (SS / df)", title = "A. Licznik i mianownik statystyki F",
       subtitle = sprintf("MS między = %.0f / %d w obu scenariuszach; zmienia się tylko mianownik",
                         t3$SS_miedzy[1], t3$df_miedzy[1])) + motyw

d3b <- rbind(data.frame(scenariusz = t3$scenariusz, co = "SS między", SS = t3$SS_miedzy),
             data.frame(scenariusz = t3$scenariusz, co = "SS wewnątrz", SS = t3$SS_wewnatrz))
d3b$co <- factor(d3b$co, levels = c("SS wewnątrz", "SS między"))
d3b$scenariusz <- factor(d3b$scenariusz, levels = rev(t3$scenariusz))
p3b <- ggplot(d3b, aes(SS, scenariusz, fill = co)) +
  geom_col(position = "fill", width = 0.6, colour = "white", linewidth = 0.4) +
  geom_text(data = t3, aes(x = eta2, y = scenariusz, label = sprintf("η² = %.3f", eta2)), hjust = -0.08,
            inherit.aes = FALSE, size = 4.1, fontface = "bold", colour = "#0f1d3a") +
  scale_fill_manual(values = c("SS między" = "#E69F00", "SS wewnątrz" = "#56B4E9"), name = NULL,
                    breaks = c("SS między", "SS wewnątrz")) +
  scale_x_continuous(labels = scales::percent, expand = c(0, 0)) +
  labs(x = "Udział w całkowitej sumie kwadratów", y = NULL,
       title = "B. η²: jaka część zmienności przypada na różnice między grupami",
       subtitle = paste("SS całkowita:", format(round(t3$SS_miedzy[1] + t3$SS_wewnatrz[1]), big.mark = " "), "w A,",
                         format(round(t3$SS_miedzy[2] + t3$SS_wewnatrz[2]), big.mark = " "), "w B")) + motyw
p3 <- p3a / p3b + plot_layout(heights = c(1.5, 1))
# p3   # zapis: ggsave("anova-srednie-kwadraty-f-i-eta.svg", p3, width = 10, height = 8.4)
Wynik w R
 scenariusz SS_miedzy SS_wewnatrz df_miedzy df_wewnatrz MS_miedzy MS_wewnatrz
  A. SD = 5       750        1050         2          42       375          25
 B. SD = 15       750        9450         2          42       375         225
      F    eta2  omega2
 15.000 0.41667 0.38356
  1.667 0.07353 0.02878
4. Symulacja: F i η² a liczebność grup: Rysunek 4
R
# Rysunek 4. Ta sama różnica średnich (50, 55, 60; σ = 15), rosnące n w grupie: F rośnie, η² nie
# kontynuacja: motyw z bloku 1 (i pakiety ggplot2, patchwork)

set.seed(5784)                                  # ziarno symulacji ustalone raz
mu <- c(50, 55, 60); sigma <- 15; R <- 2000     # 2000 powtórzeń dla każdego n
n_siatka <- c(5, 10, 15, 20, 30, 45, 60, 80, 100)
eta2_pop <- (sum((mu - mean(mu))^2) / 3) / (sum((mu - mean(mu))^2) / 3 + sigma^2)

jedna_anova <- function(n) {                    # szybka jednoczynnikowa ANOVA dla 3 grup po n osób
  y <- matrix(rnorm(3 * n, mean = rep(mu, each = n), sd = sigma), n, 3)
  m <- colMeans(y); M <- mean(y)
  ssb <- n * sum((m - M)^2); ssw <- sum(sweep(y, 2, m)^2)
  F <- (ssb / 2) / (ssw / (3 * n - 3))
  c(F = F, p = pf(F, 2, 3 * n - 3, lower.tail = FALSE), eta2 = ssb / (ssb + ssw),
    omega2 = (ssb - 2 * ssw / (3 * n - 3)) / (ssb + ssw + ssw / (3 * n - 3)))
}
sym <- do.call(rbind, lapply(n_siatka, function(n) {
  w <- t(replicate(R, jedna_anova(n)))
  moc <- mean(w[, "p"] < .05)
  data.frame(n = n, F_wzorcowe = n * sum((mu - mean(mu))^2) / 2 / sigma^2,
             F_med = median(w[, "F"]), F_q10 = quantile(w[, "F"], .10), F_q90 = quantile(w[, "F"], .90),
             F_kryt = qf(.95, 2, 3 * n - 3), moc = moc, bladMC = sqrt(moc * (1 - moc) / R),
             eta2_sr = mean(w[, "eta2"]), omega2_sr = mean(w[, "omega2"]),
             eta2_q10 = quantile(w[, "eta2"], .10), eta2_q90 = quantile(w[, "eta2"], .90))
}))
rownames(sym) <- NULL
round(eta2_pop, 4)
print(round(sym, 3), row.names = FALSE)

p4a <- ggplot(sym, aes(n)) +
  geom_ribbon(aes(ymin = F_q10, ymax = F_q90), fill = "#56B4E9", alpha = 0.35) +
  geom_line(aes(y = F_wzorcowe, linetype = "F przy średnich i SD dokładnie jak w populacji"), colour = "#0f1d3a", linewidth = 1) +
  geom_point(aes(y = F_med, shape = "mediana F z 2000 prób (pasmo: 10.–90. centyl)"), colour = "#0072B2", size = 2.6) +
  geom_line(aes(y = F_kryt, linetype = "wartość krytyczna F dla α = .05"), colour = "#D55E00", linewidth = 0.9) +
  scale_linetype_manual(values = c("solid", "22"), name = NULL) + scale_shape_manual(values = 16, name = NULL) +
  guides(linetype = guide_legend(nrow = 2, order = 1), shape = guide_legend(order = 2)) +
  labs(x = "Liczba osób w każdej grupie (n)", y = "Statystyka F",
       title = "A. Ta sama różnica średnich, rosnące n: F rośnie liniowo",
       subtitle = sprintf("Średnie 50, 55, 60; σ = 15; η² w populacji = %.3f", eta2_pop)) +
  motyw + theme(legend.box = "vertical", legend.spacing.y = unit(0, "pt"), legend.margin = margin(0, 0, 0, 0))

d4b <- rbind(data.frame(n = sym$n, miara = "średnie η² z prób", wart = sym$eta2_sr),
             data.frame(n = sym$n, miara = "średnie ω² z prób", wart = sym$omega2_sr))
p4b <- ggplot(sym, aes(n)) +
  geom_ribbon(aes(ymin = eta2_q10, ymax = eta2_q90), fill = "#E69F00", alpha = 0.3) +
  geom_hline(yintercept = eta2_pop, linetype = "22", colour = "grey30") +
  annotate("text", x = 40, y = eta2_pop - 0.022, label = "η² w populacji", hjust = 0, size = 3.8, colour = "grey25") +
  geom_line(data = d4b, aes(y = wart, colour = miara)) +
  geom_point(data = d4b, aes(y = wart, colour = miara, shape = miara), size = 2.6) +
  scale_colour_manual(values = c("#D55E00", "#0f1d3a"), name = NULL) + scale_shape_manual(values = c(17, 15), name = NULL) +
  labs(x = "Liczba osób w każdej grupie (n)", y = "Udział wariancji",
       title = "B. η² nie rośnie z n, tylko się uspokaja",
       subtitle = "Pasmo: 10.–90. centyl η²; przy małym n η² zawyża efekt, ω² mniej") + motyw
p4 <- p4a / p4b
# p4   # zapis: ggsave("anova-f-a-liczebnosc-grup.svg", p4, width = 10, height = 9.4)
Wynik w R
[1] 0.069
   n F_wzorcowe  F_med F_q10  F_q90 F_kryt   moc bladMC eta2_sr omega2_sr
   5      0.556  1.192 0.180  4.454  3.885 0.127  0.007   0.202     0.066
  10      1.111  1.614 0.295  5.312  3.354 0.229  0.009   0.132     0.066
  15      1.667  2.223 0.509  5.825  3.220 0.328  0.010   0.110     0.066
  20      2.222  2.869 0.647  6.423  3.159 0.444  0.011   0.098     0.066
  30      3.333  3.720 1.170  8.420  3.101 0.603  0.011   0.088     0.066
  45      5.000  5.610 2.194 10.924  3.065 0.803  0.009   0.083     0.069
  60      6.667  7.180 3.214 12.763  3.047 0.913  0.006   0.079     0.068
  80      8.889  9.312 4.614 15.959  3.034 0.971  0.004   0.076     0.068
 100     11.111 11.665 6.172 18.466  3.026 0.991  0.002   0.074     0.068
 eta2_q10 eta2_q90
    0.029    0.426
    0.021    0.282
    0.024    0.217
    0.022    0.184
    0.026    0.162
    0.032    0.142
    0.035    0.126
    0.037    0.119
    0.040    0.111
5. Przedziały Tukeya w trzech scenariuszach: Rysunek 5
R
# Rysunek 5. Co mówi F, a co przedziały Tukeya: ten sam F, różne wzorce średnich
# kontynuacja: z, zbuduj(), maly, grupy, motyw z bloku 1

wzorzec <- zbuduj(c(50, 50, 50 + sqrt(75)), sd = 5, z = z)   # średnie dobrane ręcznie tak, by F było takie jak w A
set.seed(5785)                                  # nowe 60 osób w grupie: ziarno ustalone raz
z60 <- apply(matrix(rnorm(60 * 3), 60, 3), 2, function(x) (x - mean(x)) / sd(x))
duze_n <- zbuduj(c(50, 55, 60), sd = 15, z = z60)

scen <- list("A. średnie 50, 55, 60; SD = 5; n = 15" = maly,
             "B. średnie 50, 50, 58.7; SD = 5; n = 15" = wzorzec,
             "C. średnie 50, 55, 60; SD = 15; n = 60" = duze_n)
d5 <- do.call(rbind, lapply(names(scen), function(s) {
  d <- scen[[s]]
  a <- summary(aov(wynik ~ grupa, data = d))[[1]]
  tk <- TukeyHSD(aov(wynik ~ grupa, data = d), conf.level = .95)$grupa
  data.frame(scenariusz = s, para = rownames(tk), roznica = tk[, "diff"], dolna = tk[, "lwr"],
             gorna = tk[, "upr"], p_adj = tk[, "p adj"],
             F = sprintf("F(%d, %d) = %.2f", a$Df[1], a$Df[2], a$`F value`[1]), p_F = a$`Pr(>F)`[1])
}))
rownames(d5) <- NULL
print(transform(d5, roznica = round(roznica, 2), dolna = round(dolna, 2), gorna = round(gorna, 2),
                p_adj = round(p_adj, 4), p_F = signif(p_F, 3)), row.names = FALSE)

d5$para <- factor(sub("-", " − ", d5$para, fixed = TRUE),
                  levels = rev(c("ulotka B − ulotka A", "ulotka C − ulotka A", "ulotka C − ulotka B")))
d5$wniosek <- ifelse(d5$dolna > 0 | d5$gorna < 0, "przedział nie obejmuje 0", "przedział obejmuje 0")
d5$etykieta <- paste0(d5$scenariusz, "   |   ", d5$F)
p5 <- ggplot(d5, aes(roznica, para)) +
  geom_vline(xintercept = 0, linetype = "22", colour = "grey35") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna, colour = wniosek), width = 0.25, linewidth = 0.9, orientation = "y") +
  geom_point(aes(colour = wniosek, shape = wniosek), size = 3) +
  geom_text(aes(label = sprintf("%.1f [%.1f, %.1f]", roznica, dolna, gorna)), vjust = -1.1, size = 3.6) +
  facet_wrap(~ etykieta, ncol = 1) +
  scale_colour_manual(values = c("przedział nie obejmuje 0" = "#0072B2", "przedział obejmuje 0" = "#D55E00"), name = NULL) +
  scale_shape_manual(values = c("przedział nie obejmuje 0" = 16, "przedział obejmuje 0" = 1), name = NULL) +
  scale_y_discrete(expand = expansion(add = c(0.5, 0.9))) +
  labs(x = "Różnica średnich (pkt) z 95% przedziałem Tukeya", y = NULL,
       title = "Ten sam F w A i B, inne różnice par",
       subtitle = "Przedziały skorygowane na trzy porównania (Tukey HSD)") + motyw
# p5   # zapis: ggsave("anova-tukey-przedzialy-roznic.svg", p5, width = 10, height = 9)
Wynik w R
                              scenariusz              para roznica dolna gorna
   A. średnie 50, 55, 60; SD = 5; n = 15 ulotka B-ulotka A    5.00  0.56  9.44
   A. średnie 50, 55, 60; SD = 5; n = 15 ulotka C-ulotka A   10.00  5.56 14.44
   A. średnie 50, 55, 60; SD = 5; n = 15 ulotka C-ulotka B    5.00  0.56  9.44
 B. średnie 50, 50, 58.7; SD = 5; n = 15 ulotka B-ulotka A    0.00 -4.44  4.44
 B. średnie 50, 50, 58.7; SD = 5; n = 15 ulotka C-ulotka A    8.66  4.22 13.10
 B. średnie 50, 50, 58.7; SD = 5; n = 15 ulotka C-ulotka B    8.66  4.22 13.10
  C. średnie 50, 55, 60; SD = 15; n = 60 ulotka B-ulotka A    5.00 -1.47 11.47
  C. średnie 50, 55, 60; SD = 15; n = 60 ulotka C-ulotka A   10.00  3.53 16.47
  C. średnie 50, 55, 60; SD = 15; n = 60 ulotka C-ulotka B    5.00 -1.47 11.47
  p_adj                F      p_F
 0.0240 F(2, 42) = 15.00 1.21e-05
 0.0000 F(2, 42) = 15.00 1.21e-05
 0.0240 F(2, 42) = 15.00 1.21e-05
 1.0000 F(2, 42) = 15.00 1.21e-05
 0.0001 F(2, 42) = 15.00 1.21e-05
 0.0001 F(2, 42) = 15.00 1.21e-05
 0.1642 F(2, 177) = 6.67 1.62e-03
 0.0010 F(2, 177) = 6.67 1.62e-03
 0.1642 F(2, 177) = 6.67 1.62e-03
6. Kontrola palety: deuteranopia i protanopia
R
# Czy kolory rysunków przetrwają zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
roznica <- function(k) {                        # najmniejsza odległość ΔE (CIELAB) między kolorami zestawu
  lab <- coords(as(hex2RGB(k), "LAB")); min(dist(lab))
}
zestawy <- list("3 grupy (rysunki 1–2)" = c("#0072B2", "#E69F00", "#CC79A7"),
                "MS/SS między i wewnątrz (rysunek 3)" = c("#E69F00", "#56B4E9"),
                "linie i pasma (rysunek 4)" = c("#0f1d3a", "#D55E00", "#56B4E9", "#E69F00"),
                "przedziały Tukeya (rysunek 5)" = c("#0072B2", "#D55E00"),
                "czerwony – zielony (dla porównania)" = c("#E41A1C", "#4DAF4A"))
round(t(sapply(zestawy, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                      protanopia = roznica(protan(k))))), 1)
Wynik w R
                                    widzenie_typowe deuteranopia protanopia
3 grupy (rysunki 1–2)                          53.6         42.0       22.5
MS/SS między i wewnątrz (rysunek 3)           113.1        111.4      101.5
linie i pasma (rysunek 4)                      33.4         18.4       24.9
przedziały Tukeya (rysunek 5)                 114.6        108.3       91.9
czerwony – zielony (dla porównania)           121.7         21.1       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, aov(), TukeyHSD(), rozkład F – pakiet stats). Rysunki wykonano w ggplot2 (oś procentowa – pakiet scales), panele złożono pakietem patchwork i zapisano pakietem svglite; paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Ocena różnic „na oko” z samych średnich. Te same średnie dały F = 15.00 albo 1.67 – zależnie od rozrzutu w grupach (rysunek 1).
- Utożsamianie dużego F z dużym efektem. Przy tej samej różnicy F rośnie proporcjonalnie do n; o wielkości efektu mówi η² albo ω² (rysunek 4).
- Raportowanie samego η² z małych grup. Przy 5 osobach w grupie średnie η² było prawie trzy razy większe od populacyjnego; podaj też ω².
- Wniosek „wszystkie grupy się różnią” z istotnego F. F nie mówi, które średnie się różnią ani w którą stronę (rysunek 5).
- Testy post hoc bez korekty albo sto par porównań po fakcie zamiast dwóch zaplanowanych kontrastów – zob. wielokrotne testy w obrazkach.
Najczęstsze pytania
Co to jest wariancja międzygrupowa i wewnątrzgrupowa w ANOVA?
Wariancja międzygrupowa opisuje, jak daleko średnie grup leżą od średniej ogólnej; wewnątrzgrupowa – jak bardzo osoby różnią się od średniej własnej grupy. Każde odchylenie wyniku od średniej ogólnej da się rozłożyć na te dwie części, a po podniesieniu do kwadratu i zsumowaniu: SS całkowita = SS między + SS wewnątrz (w przykładzie na tej stronie 1800 = 750 + 1050).
Dlaczego te same średnie mogą dać istotną i nieistotną ANOVA?
Bo statystyka F porównuje różnice średnich z rozrzutem wyników wewnątrz grup. W przykładzie średnie 50, 55 i 60 pkt przy 15 osobach w grupie dały F(2, 42) = 15.00, p < .001, gdy SD w grupach wynosiło 5, i F(2, 42) = 1.67, p = .201, gdy wynosiło 15. Licznik F był w obu przypadkach ten sam (375), zmienił się tylko mianownik (25 i 225).
Czy duże F oznacza duży efekt?
Nie. Przy tej samej różnicy średnich F rośnie proporcjonalnie do liczby osób w grupie: w symulacji z tej strony od 1.67 przy 15 osobach do 11.11 przy 100, podczas gdy η² w populacji wynosiło stale .069. O wielkości efektu mówi η² albo ω². Przy małych grupach η² jest zawyżone (średnio .202 przy 5 osobach w grupie), dlatego warto podać też ω².
Co mówi, a czego nie mówi istotny wynik testu F?
Istotne F mówi tylko, że nie wszystkie średnie w populacji są równe. Nie mówi, które grupy się różnią, w którą stronę ani o ile. Na tej stronie dwa układy średnich (50, 55, 60 oraz 50, 50, 58.7) dały identyczne F(2, 42) = 15.00, a przedziały Tukeya pokazały w pierwszym różnicę każdej pary, w drugim – tylko przewagę jednej grupy.
Jak pokazać wyniki testów post hoc na wykresie?
Najczytelniej jako wykres różnic średnich par z 95% przedziałami ufności skorygowanymi metodą Tukeya: punkt to różnica, odcinek to przedział, a pionowa linia zaznacza zero. Przedział, który nie obejmuje zera, odpowiada istotnej różnicy po korekcie. Taki wykres pokazuje wielkość i niepewność różnic, a nie tylko gwiazdki istotności.
Powiązane hasła
Przeczytaj też
ANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikTesty post hoc – który wybrać?
Tabela sytuacja → test, Tukey, Games–Howell, Dunnett, Scheffé i Dunn na jednym przykładzie oraz symulacja błędu I rodzaju i mocy w R.
Czytaj →PoradnikSkąd się biorą rozkłady t, χ² i F
Rozkłady z tablic zbudowane w R z rozkładu normalnego: suma kwadratów, iloraz, stopnie swobody, obszar odrzucenia i skośne dane – sześć symulacji z kodem.
Czytaj →Nie wiesz, jak opisać swoją ANOVA?
Pomożemy policzyć analizę wariancji, dobrać porównania post hoc i wielkość efektu, przygotować wykres i opisać wynik w pracy – tak, żebyś umiał(a) go wyjaśnić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Kelley, T. L. (1935). An unbiased correlation ratio measure. Proceedings of the National Academy of Sciences, 21(9), 554–559. https://doi.org/10.1073/pnas.21.9.554 ● Otwarty dostęp: pełny tekst
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Midway, S., Robertson, M., Flinn, S., & Kaller, M. (2020). Comparing multiple comparisons: Practical guidance for choosing the best multiple comparisons test. PeerJ, 8, Article e10387. https://doi.org/10.7717/peerj.10387 ● Otwarty dostęp
- Richardson, J. T. E. (2011). Eta squared and partial eta squared as measures of effect size in educational research. Educational Research Review, 6(2), 135–147. https://doi.org/10.1016/j.edurev.2010.12.001
- Tukey, J. W. (1949). Comparing individual means in the analysis of variance. Biometrics, 5(2), 99–114. https://doi.org/10.2307/3001913
Cytowania BibTeX
@article{kelley1935unbiased, author={Kelley, Truman L.}, title={{An unbiased correlation ratio measure}}, journal={Proceedings of the National Academy of Sciences}, year={1935}, volume={21}, number={9}, pages={554--559}, doi={10.1073/pnas.21.9.554}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@book{maxwell2018designing, author={Maxwell, Scott E. and Delaney, Harold D. and Kelley, Ken}, title={{Designing experiments and analyzing data: A model comparison perspective}}, year={2018}, edition={3rd}, publisher={Routledge}, doi={10.4324/9781315642956}}@article{midway2020comparing, author={Midway, Stephen and Robertson, Matthew and Flinn, Shane and Kaller, Michael}, title={{Comparing multiple comparisons: Practical guidance for choosing the best multiple comparisons test}}, journal={PeerJ}, year={2020}, volume={8}, eid={e10387}, doi={10.7717/peerj.10387}}@article{richardson2011eta, author={Richardson, John T. E.}, title={{Eta squared and partial eta squared as measures of effect size in educational research}}, journal={Educational Research Review}, year={2011}, volume={6}, number={2}, pages={135--147}, doi={10.1016/j.edurev.2010.12.001}}@article{tukey1949comparing, author={Tukey, John W.}, title={{Comparing individual means in the analysis of variance}}, journal={Biometrics}, year={1949}, volume={5}, number={2}, pages={99--114}, doi={10.2307/3001913}}