Co to jest rozkład F?
Rozkład F (rozkład Fishera–Snedecora, ang. F distribution) to rozkład ilorazu dwóch niezależnych zmiennych o rozkładzie chi-kwadrat, z których każdą podzielono przez jej liczbę stopni swobody: F = (χ²₁/d₁)/(χ²₂/d₂). Ma więc dwa parametry – df licznika d₁ i df mianownika d₂. Przyjmuje tylko wartości nieujemne, jest prawoskośny, a jego średnia dla d₂ > 2 wynosi d₂/(d₂ − 2) (Forbes i in., 2010). W symulacji 10 000 ilorazów dla F(3, 20) w R (set.seed(4390)) średnia wyniosła 1.121 wobec teoretycznej 1.111.
Gdzie się pojawia?
Statystykę F ma analiza wariancji (wariancja międzygrupowa podzielona przez wewnątrzgrupową), ogólny test modelu regresji i porównanie modeli zagnieżdżonych, w tym test RESET. Z rozkładu F korzysta też test ilorazu dwóch wariancji. Markowski i Markowski (1990) pokazali jednak, że ten test jest wrażliwy na brak normalności i słabo sprawdza się jako test wstępny przed testem t (zob. homogeniczność wariancji).
Rozkład F wiąże się z rozkładem t: kwadrat zmiennej t z d df ma rozkład F(1, d). Dlatego qf(.95, 1, 20) i qt(.975, 20)^2 dają tę samą wartość 4.351.
Przykład: wartości krytyczne
Dla α = .05 wartość krytyczna wynosi 3.493 dla F(2, 20), 2.758 dla F(3, 60) i 2.463 dla F(4, 100). Kolejność df ma znaczenie: F(2, 20) i F(20, 2) to różne rozkłady. Inne wartości odczytasz z tablic rozkładów t, χ² i F albo z funkcji qf(1 - alfa, df1, df2).
Na rysunku
Skąd bierze się rozkład F i jak wygląda przy różnych parach df, pokazuje wpis Skąd się biorą rozkłady t, χ² i F, a jak powstaje statystyka F w analizie wariancji – ANOVA w obrazkach. Tu skupiamy się na ogonie: tym, jak df mianownika zmienia wartość krytyczną, i na tym, jak odczytać p z wykresu.
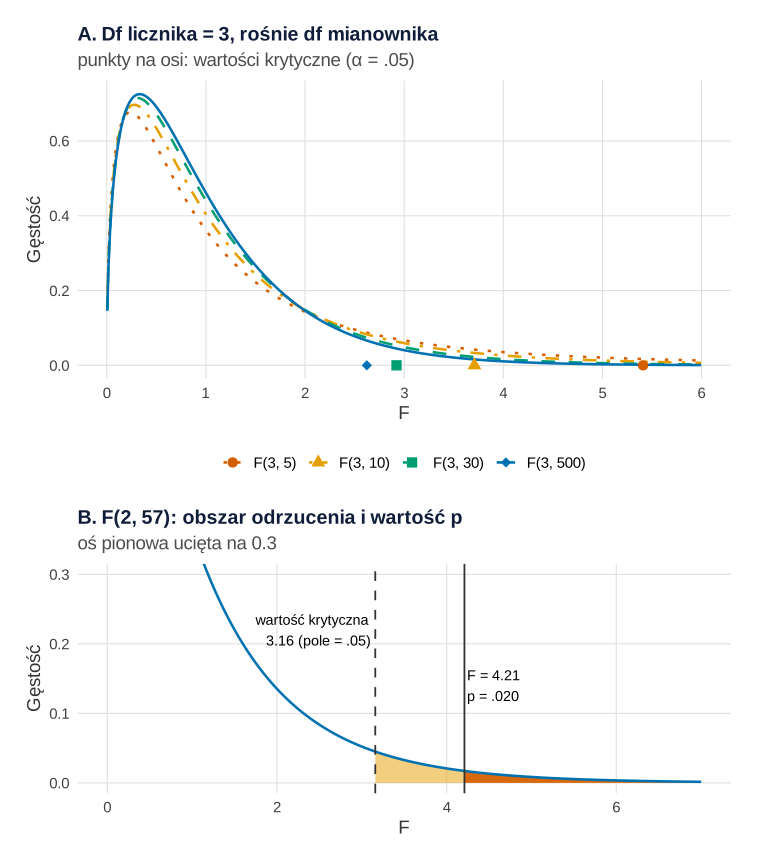
Co widać. Przy tym samym df licznika krzywe w środku prawie się nie różnią, ale ogon chudnie, gdy rośnie df mianownika. Wartość większą niż 3 ma 13.4% rozkładu F(3, 5), 8.2% F(3, 10), 4.6% F(3, 30) i 3.0% F(3, 500). Dlatego wartość krytyczna spada z 5.41 do 3.71, 2.92 i 2.62. Panel B to przykład z gotowego opisu niżej: jasne pole na prawo od 3.16 to α = .05, ciemne pole na prawo od zaobserwowanego F = 4.21 to p = .020. Wynik leży w obszarze odrzucenia, bo ciemne pole mieści się w jasnym.
Na co uważać. Oś pionowa panelu B jest ucięta na 0.3, żeby ogon był widoczny – przy zerze gęstość F(2, 57) wynosi 1. Rysunek pokazuje rozkład przy prawdziwej hipotezie zerowej i spełnionych założeniach (normalność, równe wariancje). Nie mówi, jak duża jest różnica między grupami – to opisuje wielkość efektu, a nie położenie w ogonie.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z tego akapitu. Jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka. Kod nic nie losuje.
Kod R rysunku 1
# Rysunek 1. Rozkład F: wpływ df mianownika na ogon i obszar krytyczny dla F(2, 57)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (czytelna przy zaburzeniach widzenia barw); do tego różne linie i kształty punktów
d2 <- c(5, 10, 30, 500)
etyk <- paste0("F(3, ", d2, ")")
kol <- setNames(c("#D55E00", "#E69F00", "#009E73", "#0072B2"), etyk)
lin <- setNames(c("dotted", "dotdash", "dashed", "solid"), etyk)
ksz <- setNames(c(16, 17, 15, 18), etyk)
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold"))

# Ten sam df licznika (3), rosnący df mianownika: wartość krytyczna i masa ogona powyżej 3
round(data.frame(df1 = 3, df2 = d2, kryt_05 = qf(.95, 3, d2),
                 P_powyzej_3 = pf(3, 3, d2, lower.tail = FALSE)), 3)

# A: gęstości F(3, d2); punkty na osi = wartości krytyczne przy α = .05
x <- seq(0.005, 6, by = 0.01)
gest <- do.call(rbind, lapply(d2, function(d) data.frame(x, y = df(x, 3, d), rozklad = paste0("F(3, ", d, ")"))))
gest$rozklad <- factor(gest$rozklad, etyk)
kr <- data.frame(x = qf(.95, 3, d2), y = 0, rozklad = factor(etyk, etyk))
pa <- ggplot(gest, aes(x, y, colour = rozklad, linetype = rozklad)) +
  geom_line(linewidth = 0.9) +
  geom_point(data = kr, aes(shape = rozklad), size = 3.2) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = lin, name = NULL) +
  scale_shape_manual(values = ksz, name = NULL) +
  scale_x_continuous(breaks = 0:6) +
  labs(title = "A. Df licznika = 3, rośnie df mianownika",
       subtitle = "punkty na osi: wartości krytyczne (α = .05)", x = "F", y = "Gęstość") + motyw

# B: F(2, 57) – obszar krytyczny (α = .05) i wartość p dla zaobserwowanego F = 4.21
kryt <- qf(.95, 2, 57); f_obs <- 4.21
round(c(kryt_05 = kryt, p = pf(f_obs, 2, 57, lower.tail = FALSE)), 3)
xb <- data.frame(x = seq(0, 7, by = 0.01))
xb$y <- df(xb$x, 2, 57)
pb <- ggplot(xb, aes(x, y)) +
  geom_area(data = subset(xb, x >= kryt), fill = "#E69F00", alpha = 0.5) +
  geom_area(data = subset(xb, x >= f_obs), fill = "#D55E00", alpha = 0.9) +
  geom_line(linewidth = 0.9, colour = "#0072B2") +
  geom_vline(xintercept = c(kryt, f_obs), linetype = c("dashed", "solid"), colour = "grey20") +
  annotate("text", x = kryt, y = 0.22, hjust = 1.05, size = 3.8,
           label = sprintf("wartość krytyczna\n%.2f (pole = .05)", kryt)) +
  annotate("text", x = f_obs, y = 0.14, hjust = -0.05, size = 3.8,
           label = sprintf("F = %.2f\np = %s", f_obs, sub("^0", "", sprintf("%.3f", pf(f_obs, 2, 57, lower.tail = FALSE))))) +
  coord_cartesian(ylim = c(0, 0.3)) +             # przy F = 0 gęstość wynosi 1 – oś ucięta, by ogon był widoczny
  labs(title = "B. F(2, 57): obszar odrzucenia i wartość p",
       subtitle = "oś pionowa ucięta na 0.3", x = "F", y = "Gęstość") + motyw

p1 <- pa / pb + plot_layout(heights = c(1.3, 1))
p1   # zapis: ggsave("rozklad-f-ogon-i-obszar-krytyczny.svg", p1, width = 8, height = 9)
Wynik w R
  df1 df2 kryt_05 P_powyzej_3
1   3   5   5.409       0.134
2   3  10   3.708       0.082
3   3  30   2.922       0.046
4   3 500   2.623       0.030
kryt_05       p
  3.159   0.020
Bibliografia oprogramowania
Rysunek i liczby w tej sekcji pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Rysunek wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Jak opisać w pracy
Na co uważać
- Zapis obu df. Podawaj F(df licznika, df mianownika) – sama wartość F bez df nie pozwala sprawdzić wyniku.
- Prawy ogon. W ANOVA i regresji test F jest prawostronny; nie dziel p przez 2.
- Założenia. Dokładny rozkład F wymaga normalności i równych wariancji; przy ich naruszeniu wynik jest tylko przybliżeniem.
Najczęstsze pytania
Co oznaczają dwie liczby w zapisie F(2, 57)?
Pierwsza to stopnie swobody licznika (w ANOVA: liczba grup minus 1), druga – mianownika (liczba osób minus liczba grup). Zapis F(2, 57) oznacza np. trzy grupy i 60 osób.
Jaki jest związek rozkładu F z rozkładem t?
Kwadrat zmiennej o rozkładzie t z d stopniami swobody ma rozkład F(1, d). Dlatego ANOVA dla dwóch grup daje F = t² i to samo p co dwustronny test t Studenta.
Czy statystyka F może być mniejsza od 1?
Tak. F < 1 oznacza, że zmienność wyjaśniona przez czynnik jest mniejsza niż losowa zmienność wewnątrz grup. Taki wynik nie jest błędem, ale nie daje podstaw do odrzucenia hipotezy zerowej.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Skąd się biorą rozkłady t, χ² i F
Rozkłady z tablic zbudowane w R z rozkładu normalnego: suma kwadratów, iloraz, stopnie swobody, obszar odrzucenia i skośne dane – sześć symulacji z kodem.
Czytaj →PoradnikTablice rozkładów t, χ², F i z
Wartości krytyczne t, χ², F i z policzone w R oraz kalkulator wartości krytycznej i p dla dowolnych df z wykresem obszaru odrzucenia.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Forbes, C., Evans, M., Hastings, N., & Peacock, B. (2010). Statistical distributions (4th ed.). Wiley. https://doi.org/10.1002/9780470627242
- Markowski, C. A., & Markowski, E. P. (1990). Conditions for the effectiveness of a preliminary test of variance. The American Statistician, 44(4), 322–326. https://doi.org/10.1080/00031305.1990.10475752
Cytowania BibTeX
@book{forbes2010statistical, author={Forbes, Catherine and Evans, Merran and Hastings, Nicholas and Peacock, Brian}, title={{Statistical distributions (4th ed.)}}, year={2010}, publisher={Wiley}, doi={10.1002/9780470627242}}@article{markowski1990conditions, author={Markowski, Carol A. and Markowski, Edward P.}, title={{Conditions for the effectiveness of a preliminary test of variance}}, journal={The American Statistician}, year={1990}, volume={44}, number={4}, pages={322--326}, doi={10.1080/00031305.1990.10475752}}