Jeden podział, pięć obrazów
Czym jest dzielenie medianą, znajdziesz w haśle słownika. Wpis dychotomizacja zmiennych ciągłych zbiera argumenty, tabele strat i to, co analizować zamiast grup. Ten wpis z serii „wizualizacja na obrazkach” pokazuje mechanizm na rysunkach: co dzieje się z chmurą punktów po podziale, jak wygląda strata w tysiącu badań, skąd biorą się pozorne efekty i czym mediana próby różni się od progu.
Przykład jest fikcyjny. 120 osób studiujących wypełniło skalę zaangażowania w naukę (0–40), a potem napisało egzamin (0–100 punktów). Parametry populacji ustawiliśmy ręcznie: średnie 22 i 60 punktów, SD 6 i 12, korelacja .30. Ziarno 594 ustalono raz i nie zmieniano go. Dane pobierzesz jako podzial-na-medianie-120-osob.csv. Przy każdym rysunku: co widać, czego wykres nie pokazuje, podpis i zdanie do pracy.
Rysunek 1: prosta zamienia się w schodek
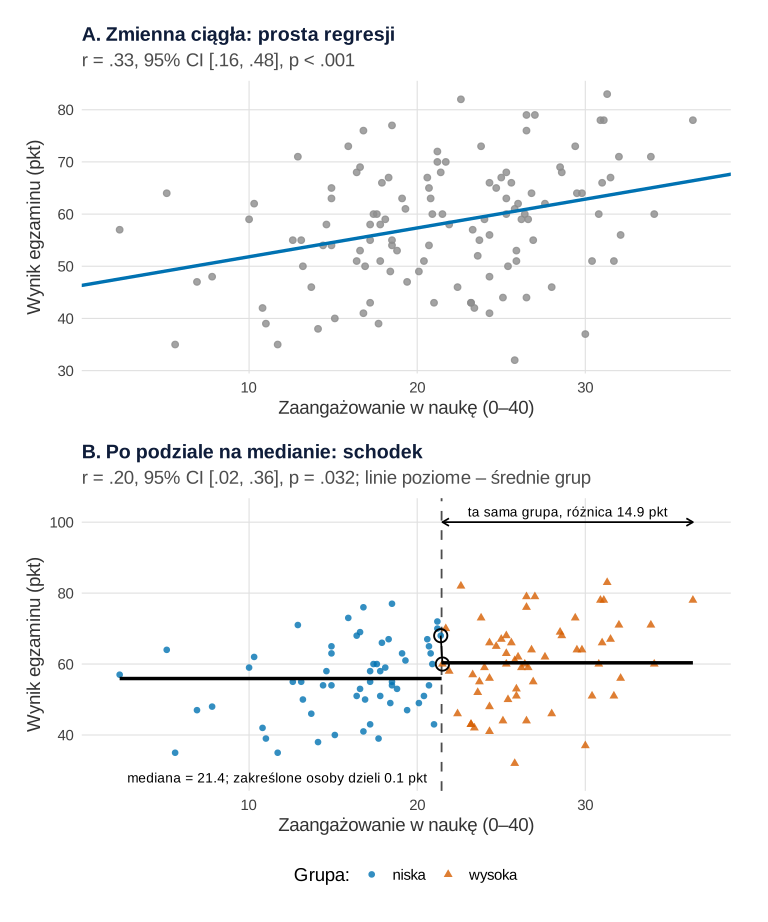
set.seed(594)).Co widać. Na panelu A prosta regresji przechodzi przez całą chmurę, a korelacja wynosi r = .33, 95% CI [.16, .48], p < .001. Na panelu B podzieliliśmy próbę medianą (21.45) na dwie grupy po 60 osób. Prosta zmienia się w schodek: model przewiduje 55.92 punktu każdemu w grupie „niskiej” i 60.35 każdemu w „wysokiej”. Ten sam związek, liczony jako korelacja punktowo-dwuseryjna, spada do r = .20, 95% CI [.02, .36], p = .032. Test t daje to samo p: różnica 4.43 punktu, t(118) = 2.16.
Zakreślone osoby pokazują, skąd strata. Dwie osoby z wynikami 21.4 i 21.5 dzieli 0.1 punktu skali, a trafiły do różnych grup. W grupie „wysokiej” znalazły się jednocześnie osoba z wynikiem 21.5 i osoba z 36.4. Dla analizy są identyczne, choć dzieli je 14.9 punktu. Zmienna 0/1 koreluje z oryginalnym zaangażowaniem na poziomie .82. MacCallum i in. (2002) opisują właśnie te konsekwencje dla pomiaru i analizy. Uznają, że dychotomizacja rzadko daje się obronić i często prowadzi do mylących wyników.
Czego ten wykres nie pokazuje. W tej próbie po podziale zostało tylko 36% wyjaśnianej wariancji (.20² wobec .33²). To więcej straty, niż zapowiada teoria (około 64% zostaje). Jedna próba nie mówi, ile tracisz przeciętnie, i to pokazuje rysunek 2. Schodek nie jest też „prawdziwym kształtem” zależności. Jeśli podejrzewasz, że związek zaczyna się dopiero od pewnego poziomu, sprawdź to splajnem albo modelem GAM, a nie progiem z mediany.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: tysiąc badań z jednej populacji
Powtarzamy badanie 1000 razy, za każdym razem 80 osób z populacji o korelacji ρ = .30. W każdej próbie liczymy korelację dwa razy: na zmiennej ciągłej i po podziale na medianie tej próby. Każdy punkt na wykresie to jedno badanie.
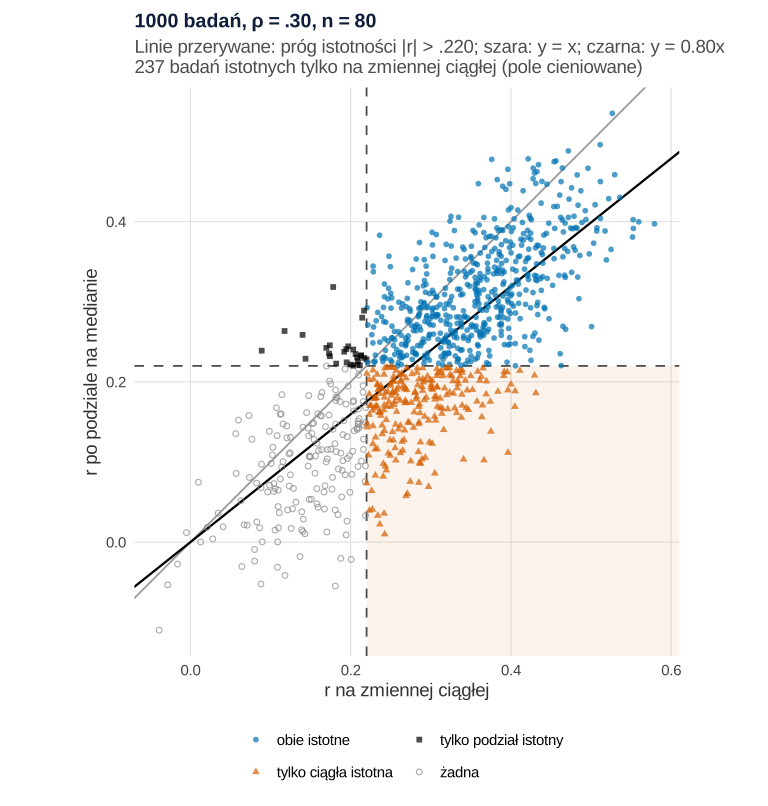
set.seed(594)).Co widać. Chmura leży przeważnie pod przekątną i układa się wzdłuż czarnej prostej y = 0.80x. Średnia korelacja spadła z .300 do .239, czyli do 0.796 wartości wyjściowej. Teoria przewiduje 0.798: tyle wynosi korelacja zmiennej o rozkładzie normalnym z jej wersją 0/1 po podziale w środku. Po podniesieniu do kwadratu daje to około 64% wyjaśnianej wariancji. Cohen (1983) wyprowadził tę stratę dla dwuwymiarowego rozkładu normalnego. Przy n = 80 korelacja jest istotna, gdy przekracza .220 (linie przerywane). Na zmiennej ciągłej przekroczyła ten próg w 796 badaniach na 1000, po podziale – w 587. W 237 badaniach (pole cieniowane) analiza ciągła wykryła związek, a analiza grup go zgubiła.
Czego ten wykres nie pokazuje (i jak może zmylić). W 28 badaniach (czarne kwadraty) było odwrotnie: istotny był tylko podział. W 18.6% badań korelacja po podziale była nawet wyższa niż na zmiennej ciągłej. To przypadek, nie zaleta podziału. Wykres dotyczy rozkładu normalnego i podziału dokładnie w medianie. Podział dalej od środka traci więcej (rysunek 1 we wpisie o dychotomizacji). Błąd Monte Carlo odsetków wynosi najwyżej 1.6 punktu procentowego.
Podpis do pracy (np. w aneksie metodologicznym):
Zdanie do Metody:
Rysunek 3: krzywe mocy dla zmiennej ciągłej i grup
Rysunek 2 dotyczył jednej liczebności. Teraz powtarzamy symulację dla dziesięciu liczebności od 20 do 300 osób, po 1000 badań na każdą, i liczymy moc testu, czyli odsetek badań z p < .05. Linie pokazują wynik ze wzoru (przybliżenie Fishera z). Dla grup wstawiamy do wzoru korelację pomniejszoną do 0.80ρ.
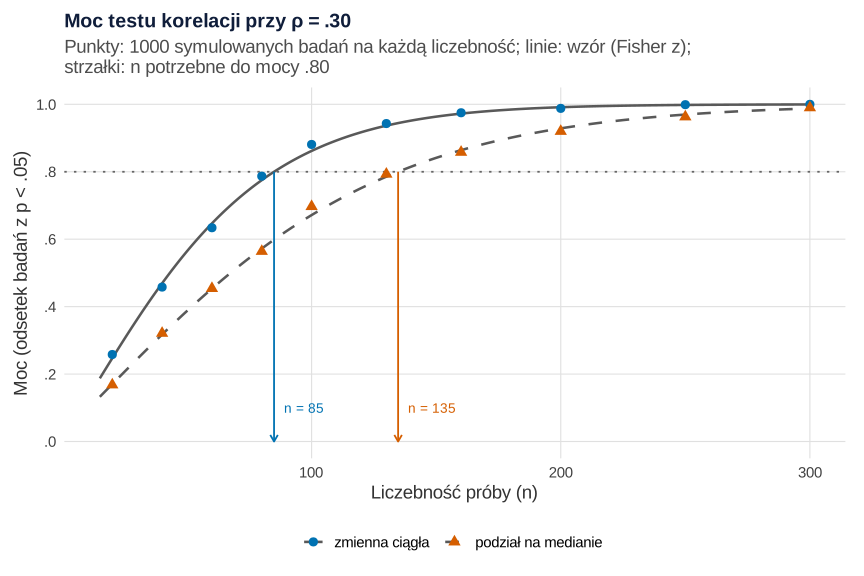
set.seed(594)).Co widać. Krzywa dla grup jest przesunięta w prawo. Przy 80 osobach zmienna ciągła wykrywa związek w 78.7% badań, a po podziale w 56.4%. Przy 130 osobach jest to 94.3% wobec 79.3%. Moc .80 osiąga zmienna ciągła przy około 85 osobach, a podział – dopiero przy 135. Podział kosztuje więc mniej więcej 1.6 raza więcej uczestników albo, inaczej licząc, oznacza wyrzucenie 37% zebranych danych. Cohen (1983) przeliczył tę stratę na odpowiednik odrzucenia 38% obserwacji. Punkty z symulacji leżą na liniach wzoru (różnice do 2.5 punktu procentowego przy błędzie Monte Carlo do 1.6).
Czego ten wykres nie pokazuje. Krzywe opisują jedną wartość ρ i rozkład normalny. Większa próba nie naprawia też problemów z rysunku 4. Ogólną logikę krzywych mocy omawia wpis moc testu w obrazkach, a liczebność dla korelacji policzysz w kalkulatorze korelacji.
Podpis do pracy (np. w uzasadnieniu liczebności):
Zdanie do Metody:
Rysunek 4: dwa podziały i efekt, którego nie ma
Przy jednym predyktorze podział „tylko” zabiera moc. Przy dwóch skorelowanych predyktorach dzieje się coś gorszego. Maxwell i Delaney (1993) pokazali, że dychotomizacja dwóch ciągłych zmiennych niezależnych może prowadzić do fałszywej istotności. Dlatego argument „podzieliłem, a wynik i tak wyszedł istotny” nie broni podziału. Zobaczmy mechanizm. W populacji X1 i X2 korelują na poziomie .50, wynik zależy tylko od X1 (β = .50), a X2 nie ma żadnego efektu. Te parametry ustawiliśmy ręcznie. Badanie ma 200 osób. Obie zmienne dzielimy medianą i liczymy ANOVA 2 × 2, a obok regresję wieloraką na zmiennych ciągłych.
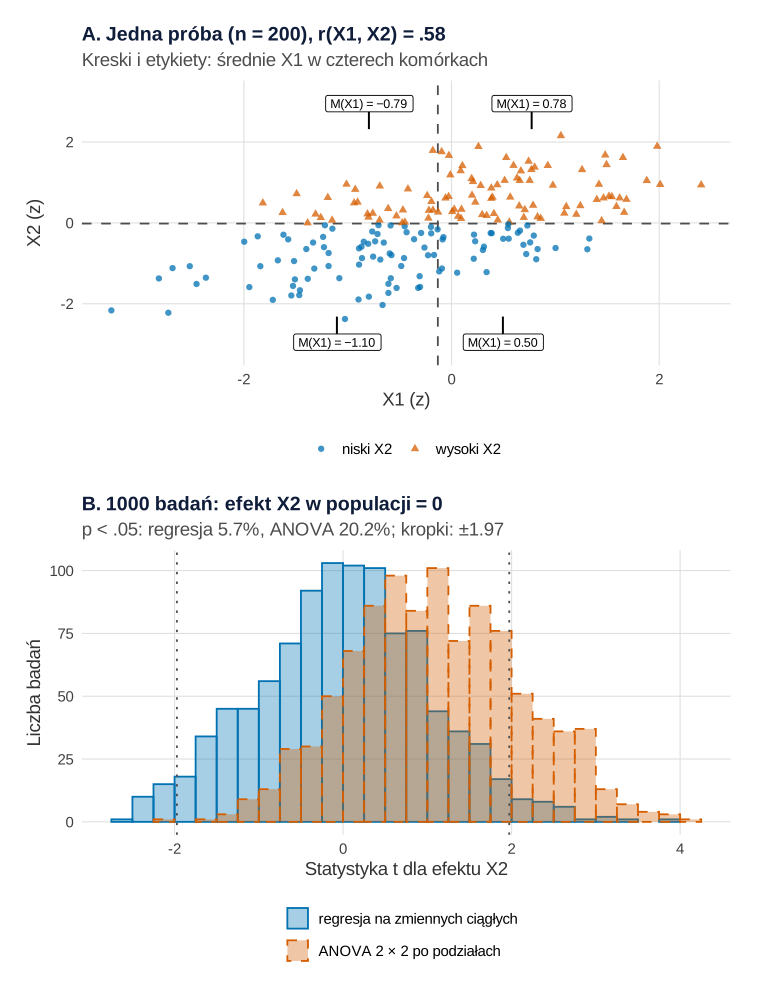
set.seed(594)).Co widać. Panel A pokazuje źródło kłopotu. W grupie „niski X1” osoby z wysokim X2 mają średnio X1 = −0.79, a osoby z niskim X2 – −1.10. W grupie „wysoki X1” jest podobnie: 0.78 wobec 0.50. Etykieta „niski X1” obejmuje więc ludzi o różnym X1, a ta różnica jest związana z X2. Część efektu X1, której podział nie „złapał”, przechodzi na X2. Panel B pokazuje skutek w 1000 badaniach. Regresja na zmiennych ciągłych daje rozkład t dla X2 wokół zera i 5.7% wyników istotnych, czyli tyle, ile powinno być. Rozkład z ANOVA jest przesunięty w prawo (średnie t około 1.1) i daje 20.2% fałszywych alarmów, cztery razy więcej niż nominalne 5% (błąd Monte Carlo 1.3 punktu procentowego).
Czego ten wykres nie pokazuje. W naszej jednej próbie ANOVA nie dała jeszcze istotnego wyniku (t = 1.21, p = .228), a regresja dała t = 0.05, p = .961. Problem widać dopiero w tysiącu badań. Wykres dotyczy fałszywego efektu głównego przy podziale w medianie. Pozorna interakcja pojawia się przy podziale poza medianą (np. „górne 30%”). Jak rośnie odsetek fałszywych wyników z liczebnością, pokazuje symulacja we wpisie o dychotomizacji. Ten sam mechanizm działa, gdy dzielisz na grupy zmienną zakłócającą, którą chcesz „kontrolować”. Royston i in. (2006) nazywają to niepełną kontrolą zakłócania (o samym zakłócaniu – wpis zmienna zakłócająca i collider – wizualizacja na obrazkach).
Podpis do pracy (np. w aneksie):
Zdanie do Metody:
Rysunek 5: mediana próby to nie próg
„Osoby z wysokim stresem” w pracy dyplomowej to często osoby powyżej mediany próby. Sprawdźmy, co ta etykieta znaczy w dwóch populacjach. Pierwsza to studenci ze średnią 17 punktów na fikcyjnej skali stresu 0–40, druga – osoby zgłaszające się do poradni ze średnią 25 (SD = 7 w obu). Dla porównania przyjmujemy stały punkt odcięcia 24 punkty. Wszystkie te wartości są wymyślone na potrzeby przykładu: próg ma tu udawać wartość z badania walidacyjnego. W każdej populacji powtarzamy badanie po 60 osób 1000 razy.
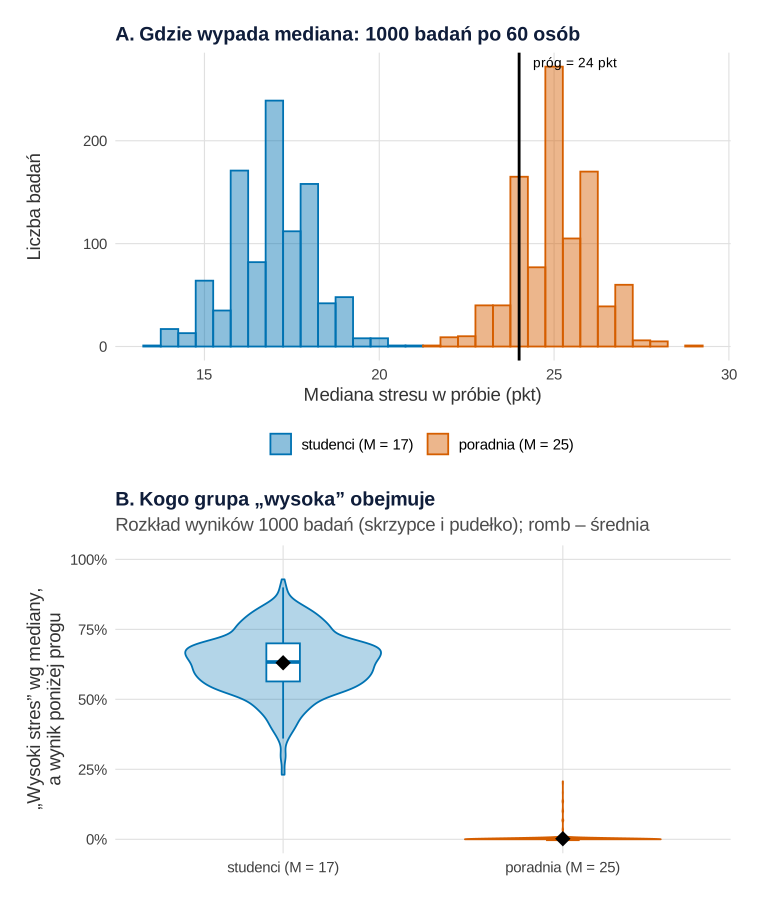
set.seed(594)).Co widać. Mediana wędruje razem z próbą. U studentów wynosiła od 13.5 do 21 punktów (średnio 16.9), w poradni od 21.5 do 29 (średnio 25.0). Podział na medianie zawsze daje „połowę osób z wysokim stresem”, niezależnie od tego, kogo badasz. Próg działa inaczej. Powyżej 24 punktów było średnio 17.4% studentów i 58.8% osób z poradni. Panel B pokazuje skutek dla etykiety: w badaniach studentów średnio 63.1% osób z grupy „wysokiej” miało wynik poniżej progu, a w pojedynczych badaniach od 23.1% do 92.9%. W poradni takich osób prawie nie było (średnio 0.2%). To samo słowo „wysoki” opisuje więc różnych ludzi.
Kiedy podział jest uzasadniony. Gdy próg pochodzi spoza Twojej próby, ma znaczenie merytoryczne i ustalasz go przed analizą. Przykłady to punkt odcięcia z badania walidacyjnego narzędzia, wyznaczony względem kryterium (zob. krzywa ROC w obrazkach), albo próg z norm testu. Tak liczy się np. wynik PHQ-9 we wpisie GAD-7 i PHQ-9 – jak policzyć wynik. Nawet wtedy hipotezę o związku najlepiej testować na wyniku ciągłym, a odsetek powyżej progu podać obok. Progu „optymalnego”, szukanego na tych samych danych, nie traktuj jak progu z literatury. Royston i in. (2006) oraz Naggara i in. (2011) ostrzegają, że prowadzi to do poważnego obciążenia wyników.
Czego ten wykres nie pokazuje. Nie mówi, że próg jest „prawdziwszy” niż wynik ciągły. Próg też wyrzuca informację (rysunki 1–3), tylko przynajmniej znaczy to samo w każdym badaniu.
Podpis do pracy (np. w Dyskusji, przy ograniczeniach):
Zdanie do Metody (gdy używasz progu):
Co zrobić w praktyce
- Zostaw zmienną ciągłą w analizie. Jeden predyktor to korelacja albo regresja, kilka – regresja wieloraka. Opis nie jest trudniejszy niż przy teście t.
- Grupy pokaż tylko na wykresie. Jeśli promotor chce zobaczyć „niskich” i „wysokich”, narysuj przewidywania modelu dla wybranych wartości, np. średnia ± 1 SD. Jak to zrobić, pokazuje wpis wynik regresji na wykresie.
- Pytanie „czy efekt zależy od W” to moderacja z ciągłym moderatorem, z prostymi nachyleniami zamiast grup. Obrazy pokazuje wpis moderacja – wizualizacja na obrazkach, a pojęcie wyjaśnia hasło efekt interakcji.
- Tercyle i kwartyle mają te same wady (hasło tercyle i podział kwantylowy). Zawężenie próby do jednej grupy to z kolei inny problem, opisany we wpisie ograniczony zakres zmiennej – wizualizacja na obrazkach.
- Decyzję zapisz w planie analizy przed zebraniem danych. Wybieranie między medianą, tercylami i „górnymi 25%” po obejrzeniu wyników to p-hacking.
Zdanie do pracy dyplomowej (rozdział o analizie danych):
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i funkcje pomocnicze, z których korzystają następne. Każdy przepis kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy przepis, który losuje (1–5), zaczyna się od własnego set.seed(594), więc skopiowany osobno da te same liczby co na stronie (przepis 4 ustawia ziarno dwa razy: przed pojedynczą próbą i przed symulacją). Ziarno 594 ustalono raz i nie zmieniano go. Ręcznie ustalono: w przykładzie 120 osób, średnie 22 i 60, SD 6 i 12, korelację .30; w symulacjach ρ = .30, liczebność 80 i siatkę liczebności od 20 do 300; korelację predyktorów .50, β = .50 i n = 200 w przepisie 4; średnie populacji 17 i 25, SD 7, próg 24 punkty i n = 60 w przepisie 5. Każda symulacja ma 1000 powtórzeń. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w kilka sekund.
1. Przykład 120 osób: prosta i schodek: Rysunek 1
R
# Rysunek 1. Ta sama chmura punktów przed podziałem na medianie i po nim – „schodek” zamiast prostej (dane fikcyjne)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (niebieski i cynober rozróżnialne także przy deuteranopii) i prosty motyw
kol <- c(ciagla = "#0072B2", podzial = "#D55E00", niska = "#0072B2", wysoka = "#D55E00", szary = "grey55")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
bz <- function(x, d = 2) sub("^(-?)0\\.", "\\1.", sprintf(paste0("%.", d, "f"), x))   # .03 zamiast 0.03
p_apa <- function(p) ifelse(p < .001, "p < .001", paste("p =", bz(p, 3)))

# 120 osób: zaangażowanie w naukę (skala 0–40) i wynik egzaminu (0–100 pkt).
# Parametry populacji ustalone ręcznie: średnie 22 i 60, SD 6 i 12, korelacja .30
n <- 120; r_pop <- 0.30
set.seed(594)                                    # ziarno ustalone raz, bez dobierania pod wynik
z1 <- rnorm(n); z2 <- rnorm(n)
zaangazowanie <- round(22 + 6 * z1, 1)
egzamin <- round(60 + 12 * (r_pop * z1 + sqrt(1 - r_pop^2) * z2))
mediana <- median(zaangazowanie)
grupa <- factor(ifelse(zaangazowanie > mediana, "wysoka", "niska"), c("niska", "wysoka"))
dane <- data.frame(osoba = 1:n, zaangazowanie, egzamin, grupa)
write.csv(dane, "podzial-na-medianie-120-osob.csv", row.names = FALSE)

# Analiza zmiennej ciągłej i ta sama analiza po podziale na medianie
r_ciagla <- cor.test(zaangazowanie, egzamin)
r_podzial <- cor.test(as.numeric(grupa == "wysoka"), egzamin)    # korelacja punktowo-dwuseryjna
tt <- t.test(egzamin[grupa == "wysoka"], egzamin[grupa == "niska"], var.equal = TRUE)   # wysoka − niska
round(c(mediana = mediana, n_niska = sum(grupa == "niska"), n_wysoka = sum(grupa == "wysoka"),
        r_ciagla = unname(r_ciagla$estimate), r_podzial = unname(r_podzial$estimate),
        r2_zachowane = unname((r_podzial$estimate / r_ciagla$estimate)^2),
        r_X_z_podzialem = cor(zaangazowanie, as.numeric(grupa == "wysoka"))), 3)
signif(c(p_ciagla = r_ciagla$p.value, p_podzial = r_podzial$p.value), 3)
round(rbind(ciagla = r_ciagla$conf.int, podzial = r_podzial$conf.int), 2)
round(c(M_niska = mean(egzamin[grupa == "niska"]), M_wysoka = mean(egzamin[grupa == "wysoka"]),
        roznica = unname(tt$estimate[1] - tt$estimate[2]), t = unname(tt$statistic), df = unname(tt$parameter)), 2)

# Dwie pary osób: najbliżej siebie po dwóch stronach mediany i najdalej od siebie w grupie „wysokiej”
nis <- dane[dane$grupa == "niska", ]; wys <- dane[dane$grupa == "wysoka", ]
para_blisko <- rbind(nis[which.max(nis$zaangazowanie), ], wys[which.min(wys$zaangazowanie), ])
para_daleko <- rbind(wys[which.min(wys$zaangazowanie), ], wys[which.max(wys$zaangazowanie), ])
para_blisko; para_daleko

prosta <- coef(lm(egzamin ~ zaangazowanie))
schodek <- data.frame(x = c(min(zaangazowanie), mediana), xend = c(mediana, max(zaangazowanie)),
                      y = tapply(egzamin, grupa, mean), grupa = levels(grupa))
skala_x <- scale_x_continuous(limits = range(zaangazowanie) + c(-0.5, 0.5))
pA <- ggplot(dane, aes(zaangazowanie, egzamin)) +
  geom_point(colour = kol[["szary"]], size = 1.9, alpha = 0.8) +
  geom_abline(intercept = prosta[1], slope = prosta[2], colour = kol[["ciagla"]], linewidth = 1.2) +
  skala_x + labs(x = "Zaangażowanie w naukę (0–40)", y = "Wynik egzaminu (pkt)",
                 title = "A. Zmienna ciągła: prosta regresji",
                 subtitle = sprintf("r = %s, 95%% CI [%s, %s], %s", bz(r_ciagla$estimate), bz(r_ciagla$conf.int[1]),
                                    bz(r_ciagla$conf.int[2]), p_apa(r_ciagla$p.value))) + motyw
pB <- ggplot(dane, aes(zaangazowanie, egzamin)) +
  geom_vline(xintercept = mediana, linetype = "dashed", colour = "grey30") +
  geom_point(aes(colour = grupa, shape = grupa), size = 1.9, alpha = 0.8) +
  geom_segment(data = schodek, aes(x = x, xend = xend, y = y, yend = y), colour = "black", linewidth = 1.2) +
  geom_line(data = para_blisko, colour = "black", linewidth = 0.6) +
  geom_point(data = para_blisko, shape = 21, size = 4, stroke = 1, colour = "black") +
  geom_line(data = para_daleko, aes(y = 100), colour = "black", linewidth = 0.6,
            arrow = arrow(ends = "both", length = unit(2, "mm"))) +
  annotate("text", x = mean(para_daleko$zaangazowanie), y = 103, size = 3.6,
           label = sprintf("ta sama grupa, różnica %.1f pkt", diff(para_daleko$zaangazowanie))) +
  annotate("text", x = mediana, y = min(egzamin) - 4, hjust = 1.05, size = 3.6,
           label = sprintf("mediana = %.1f; zakreślone osoby dzieli %.1f pkt", mediana, diff(para_blisko$zaangazowanie))) +
  scale_colour_manual(values = c(niska = kol[["niska"]], wysoka = kol[["wysoka"]]), name = "Grupa:") +
  scale_shape_manual(values = c(niska = 16, wysoka = 17), name = "Grupa:") +
  skala_x + labs(x = "Zaangażowanie w naukę (0–40)", y = "Wynik egzaminu (pkt)",
                 title = "B. Po podziale na medianie: schodek",
                 subtitle = sprintf("r = %s, 95%% CI [%s, %s], %s; linie poziome – średnie grup",
                                    bz(r_podzial$estimate), bz(r_podzial$conf.int[1]), bz(r_podzial$conf.int[2]),
                                    p_apa(r_podzial$p.value))) + motyw
p1 <- pA / pB
p1   # zapis: ggsave("podzial-na-medianie-schodek.svg", p1, width = 8, height = 9.6)
Wynik w R
        mediana         n_niska        n_wysoka        r_ciagla       r_podzial
         21.450          60.000          60.000           0.327           0.195
   r2_zachowane r_X_z_podzialem
          0.357           0.817
 p_ciagla p_podzial
 0.000265  0.032400
        [,1] [,2]
ciagla  0.16 0.48
podzial 0.02 0.36
 M_niska M_wysoka  roznica        t       df
   55.92    60.35     4.43     2.16   118.00
   osoba zaangazowanie egzamin  grupa
65    65          21.4      68  niska
26    26          21.5      60 wysoka
   osoba zaangazowanie egzamin  grupa
26    26          21.5      60 wysoka
40    40          36.4      78 wysoka
2. 1000 badań: r przed podziałem i po nim: Rysunek 2
R
# Rysunek 2. 1000 badań z tej samej populacji (ρ = .30, n = 80): r na zmiennej ciągłej a r po podziale na medianie
# (kontynuacja: kol, motyw, bz z bloku 1)
library(ggplot2)

n2 <- 80; rho <- 0.30; B <- 1000
set.seed(594)
r_obie <- t(replicate(B, {
  x <- rnorm(n2); y <- rho * x + sqrt(1 - rho^2) * rnorm(n2)
  c(ciagla = cor(x, y), podzial = cor(as.numeric(x > median(x)), y))
}))
r_kryt <- sqrt(qt(.975, n2 - 2)^2 / (qt(.975, n2 - 2)^2 + n2 - 2))   # najmniejsze |r| istotne przy α = .05
istotna <- abs(r_obie) > r_kryt
cwiartki <- table(ciagla = ifelse(istotna[, "ciagla"], "istotna", "nieistotna"),
                  podzial = ifelse(istotna[, "podzial"], "istotna", "nieistotna"))
round(c(r_kryt = r_kryt, sr_r_ciagla = mean(r_obie[, 1]), sr_r_podzial = mean(r_obie[, 2]),
        iloraz_srednich = mean(r_obie[, 2]) / mean(r_obie[, 1]), wzor_sqrt_2_pi = sqrt(2 / pi),
        moc_ciagla = mean(istotna[, 1]), moc_podzial = mean(istotna[, 2]),
        podzial_wiekszy_niz_ciagla = mean(r_obie[, 2] > r_obie[, 1])), 3)
cwiartki
round(100 * sqrt(.5 * .5 / B), 1)                   # największy błąd Monte Carlo odsetka (pp)

wyniki2 <- data.frame(r_obie, klasa = factor(ifelse(istotna[, 1] & !istotna[, 2], "tylko ciągła istotna",
                                              ifelse(istotna[, 1] & istotna[, 2], "obie istotne",
                                              ifelse(!istotna[, 1] & istotna[, 2], "tylko podział istotny", "żadna"))),
                                       c("obie istotne", "tylko ciągła istotna", "tylko podział istotny", "żadna")))
p2 <- ggplot(wyniki2, aes(ciagla, podzial)) +
  annotate("rect", xmin = r_kryt, xmax = Inf, ymin = -Inf, ymax = r_kryt, fill = kol[["podzial"]], alpha = 0.08) +
  geom_hline(yintercept = r_kryt, linetype = "dashed", colour = "grey30") +
  geom_vline(xintercept = r_kryt, linetype = "dashed", colour = "grey30") +
  geom_abline(slope = 1, intercept = 0, colour = "grey60") +
  geom_abline(slope = sqrt(2 / pi), intercept = 0, colour = "black", linewidth = 0.8) +
  geom_point(aes(colour = klasa, shape = klasa), size = 1.6, alpha = 0.7) +
  scale_colour_manual(values = c("obie istotne" = kol[["ciagla"]], "tylko ciągła istotna" = kol[["podzial"]],
                                 "tylko podział istotny" = "black", "żadna" = kol[["szary"]]), name = NULL) +
  scale_shape_manual(values = c("obie istotne" = 16, "tylko ciągła istotna" = 17, "tylko podział istotny" = 15,
                                "żadna" = 1), name = NULL) +
  guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2)) +
  coord_equal() +
  labs(x = "r na zmiennej ciągłej", y = "r po podziale na medianie",
       title = sprintf("1000 badań, ρ = .30, n = %d", n2),
       subtitle = sprintf("Linie przerywane: próg istotności |r| > %s; szara: y = x; czarna: y = 0.80x\n%d badań istotnych tylko na zmiennej ciągłej (pole cieniowane)",
                          bz(r_kryt, 3), cwiartki["istotna", "nieistotna"])) +
  motyw
p2   # zapis: ggsave("podzial-na-medianie-tysiac-badan.svg", p2, width = 8, height = 8)
Wynik w R
                    r_kryt                sr_r_ciagla
                     0.220                      0.300
              sr_r_podzial            iloraz_srednich
                     0.239                      0.796
            wzor_sqrt_2_pi                 moc_ciagla
                     0.798                      0.796
               moc_podzial podzial_wiekszy_niz_ciagla
                     0.587                      0.186
            podzial
ciagla       istotna nieistotna
  istotna        559        237
  nieistotna      28        176
[1] 1.6
3. Krzywe mocy: Rysunek 3
R
# Rysunek 3. Krzywe mocy: zmienna ciągła a podział na medianie, 1000 badań na każdą liczebność
# (kontynuacja: kol, motyw, bz z bloku 1)
library(ggplot2)

rho <- 0.30; B <- 1000; liczebnosci <- c(20, 40, 60, 80, 100, 130, 160, 200, 250, 300)
moc_wzor <- function(r, n) pnorm(atanh(r) * sqrt(n - 3) - qnorm(.975))   # przybliżenie Fishera z
set.seed(594)
moc <- do.call(rbind, lapply(liczebnosci, function(n) {
  p <- t(replicate(B, {
    x <- rnorm(n); y <- rho * x + sqrt(1 - rho^2) * rnorm(n)
    c(cor.test(x, y)$p.value, cor.test(as.numeric(x > median(x)), y)$p.value)
  }))
  data.frame(n = n, ciagla = mean(p[, 1] < .05), podzial = mean(p[, 2] < .05))
}))
moc$wzor_ciagla <- moc_wzor(rho, moc$n)
moc$wzor_podzial <- moc_wzor(rho * sqrt(2 / pi), moc$n)    # korelacja po podziale ≈ 0.80 · ρ
print(round(moc, 3), row.names = FALSE)
# Ile osób potrzeba do mocy .80 (ze wzoru) i ile to „kosztuje”
n80 <- sapply(c(ciagla = rho, podzial = rho * sqrt(2 / pi)), function(r)
  uniroot(function(n) moc_wzor(r, n) - .80, c(10, 2000))$root)
round(c(n80, iloraz = unname(n80[2] / n80[1])), 1)
round(100 * sqrt(.5 * .5 / B), 1)                   # największy błąd Monte Carlo mocy (pp)

dl <- rbind(data.frame(n = moc$n, moc = moc$ciagla, wzor = moc$wzor_ciagla, analiza = "zmienna ciągła"),
            data.frame(n = moc$n, moc = moc$podzial, wzor = moc$wzor_podzial, analiza = "podział na medianie"))
dl$analiza <- factor(dl$analiza, c("zmienna ciągła", "podział na medianie"))
siatka <- expand.grid(n = 15:300, analiza = levels(dl$analiza))
siatka$wzor <- moc_wzor(ifelse(siatka$analiza == "zmienna ciągła", rho, rho * sqrt(2 / pi)), siatka$n)
p3 <- ggplot(dl, aes(n, moc, colour = analiza, shape = analiza)) +
  geom_hline(yintercept = .80, colour = "grey40", linetype = "dotted") +
  geom_line(data = siatka, aes(n, wzor, linetype = analiza), linewidth = 0.9, inherit.aes = FALSE,
            colour = "grey35") +
  geom_point(size = 2.8) +
  annotate("segment", x = n80, xend = n80, y = .80, yend = 0, colour = c(kol[["ciagla"]], kol[["podzial"]]),
           arrow = arrow(length = unit(2, "mm"))) +
  annotate("text", x = n80 + 4, y = c(.1, .1), label = sprintf("n = %.0f", ceiling(n80)), size = 3.6, hjust = 0,
           colour = c(kol[["ciagla"]], kol[["podzial"]])) +
  scale_colour_manual(values = c("zmienna ciągła" = kol[["ciagla"]], "podział na medianie" = kol[["podzial"]]),
                      name = NULL) +
  scale_shape_manual(values = c("zmienna ciągła" = 16, "podział na medianie" = 17), name = NULL) +
  scale_linetype_manual(values = c("zmienna ciągła" = "solid", "podział na medianie" = "dashed"), name = NULL) +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, .2), labels = function(v) bz(v, 1)) +
  labs(x = "Liczebność próby (n)", y = "Moc (odsetek badań z p < .05)",
       title = "Moc testu korelacji przy ρ = .30",
       subtitle = "Punkty: 1000 symulowanych badań na każdą liczebność; linie: wzór (Fisher z);\nstrzałki: n potrzebne do mocy .80") +
  motyw
p3   # zapis: ggsave("podzial-na-medianie-krzywe-mocy.svg", p3, width = 9, height = 6)
Wynik w R
   n ciagla podzial wzor_ciagla wzor_podzial
  20  0.258   0.168       0.247        0.170
  40  0.458   0.321       0.469        0.317
  60  0.634   0.454       0.647        0.453
  80  0.787   0.564       0.775        0.572
 100  0.881   0.697       0.862        0.672
 130  0.943   0.793       0.937        0.786
 160  0.975   0.858       0.972        0.864
 200  0.988   0.920       0.991        0.929
 250  0.999   0.963       0.998        0.970
 300  1.000   0.990       1.000        0.988
 ciagla podzial  iloraz
   84.9   134.7     1.6
[1] 1.6
4. Dwa podziały i pozorny efekt X2: Rysunek 4
R
# Rysunek 4. Dwa skorelowane predyktory podzielone na medianie: pozorny efekt X2, którego w populacji nie ma
# (kontynuacja: kol, motyw, bz, p_apa z bloku 1)
library(ggplot2)
library(patchwork)

# Model populacji ustalony ręcznie: korelacja predyktorów .50, wynik zależy tylko od X1 (β1 = .50), X2 nie ma efektu
n4 <- 200; r12 <- 0.50; b1 <- 0.50
losuj <- function(n) {
  x1 <- rnorm(n); x2 <- r12 * x1 + sqrt(1 - r12^2) * rnorm(n)
  y <- b1 * x1 + sqrt(1 - b1^2) * rnorm(n)
  data.frame(x1, x2, y, g1 = factor(x1 > median(x1), c(FALSE, TRUE), c("niski X1", "wysoki X1")),
             g2 = factor(x2 > median(x2), c(FALSE, TRUE), c("niski X2", "wysoki X2")))
}
t_x2 <- function(d) {                                 # t dla X2: regresja na ciągłych i ANOVA 2 × 2 po podziałach
  reg <- summary(lm(y ~ x1 + x2, d))$coefficients["x2", c("t value", "Pr(>|t|)")]
  an <- summary(lm(y ~ g1 * g2, d, contrasts = list(g1 = "contr.sum", g2 = "contr.sum")))$coefficients
  c(t_reg = reg[[1]], p_reg = reg[[2]], t_anova = -an["g21", "t value"], p_anova = an["g21", "Pr(>|t|)"])
}
set.seed(594)
d4 <- losuj(n4)
round(c(r_X1_X2 = cor(d4$x1, d4$x2), t_kryt = qt(.975, n4 - 4), t_x2(d4)), 3)
# Mechanizm: w obrębie tej samej grupy X1 osoby z „wysokim X2” mają wyższe X1, a więc i wyższy wynik
komorki <- aggregate(cbind(x1, y) ~ g1 + g2, d4, mean)
komorki$n <- as.vector(table(d4$g1, d4$g2))
print(cbind(komorki[, 1:2], round(komorki[, 3:4], 2), n = komorki$n), row.names = FALSE)

# 1000 badań tym samym schematem
set.seed(594)
sym <- as.data.frame(t(replicate(1000, t_x2(losuj(n4)))))
round(c(odsetek_reg = mean(sym$p_reg < .05), odsetek_anova = mean(sym$p_anova < .05),
        sr_t_reg = mean(sym$t_reg), sr_t_anova = mean(sym$t_anova)), 3)
round(100 * sqrt(mean(sym$p_anova < .05) * (1 - mean(sym$p_anova < .05)) / 1000), 1)   # błąd MC (pp)

pA <- ggplot(d4, aes(x1, x2)) +
  geom_vline(xintercept = median(d4$x1), linetype = "dashed", colour = "grey30") +
  geom_hline(yintercept = median(d4$x2), linetype = "dashed", colour = "grey30") +
  geom_point(aes(colour = g2, shape = g2), size = 1.8, alpha = 0.75) +
  geom_point(data = komorki, aes(x1, ifelse(g2 == "wysoki X2", 2.6, -2.6)), shape = 124, size = 6) +
  geom_label(data = komorki, aes(x1, ifelse(g2 == "wysoki X2", 2.95, -2.95),
                                 label = sub("-", "−", sprintf("M(X1) = %.2f", x1))), size = 3.3) +
  scale_colour_manual(values = c("niski X2" = kol[["niska"]], "wysoki X2" = kol[["wysoka"]]), name = NULL) +
  scale_shape_manual(values = c("niski X2" = 16, "wysoki X2" = 17), name = NULL) +
  coord_cartesian(ylim = c(-3.2, 3.2)) +
  labs(x = "X1 (z)", y = "X2 (z)", title = sprintf("A. Jedna próba (n = %d), r(X1, X2) = %s", n4, bz(cor(d4$x1, d4$x2))),
       subtitle = "Kreski i etykiety: średnie X1 w czterech komórkach") + motyw
dlugi <- rbind(data.frame(t = sym$t_reg, analiza = "regresja na zmiennych ciągłych"),
               data.frame(t = sym$t_anova, analiza = "ANOVA 2 × 2 po podziałach"))
dlugi$analiza <- factor(dlugi$analiza, c("regresja na zmiennych ciągłych", "ANOVA 2 × 2 po podziałach"))
pB <- ggplot(dlugi, aes(t, fill = analiza, linetype = analiza)) +
  geom_histogram(aes(colour = analiza), binwidth = 0.25, position = "identity", alpha = 0.35, boundary = 0) +
  geom_vline(xintercept = c(-1, 1) * qt(.975, n4 - 4), colour = "grey30", linetype = "dotted") +
  scale_fill_manual(values = c(kol[["ciagla"]], kol[["podzial"]]), name = NULL) +
  scale_colour_manual(values = c(kol[["ciagla"]], kol[["podzial"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  guides(fill = guide_legend(nrow = 2), colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  labs(x = "Statystyka t dla efektu X2", y = "Liczba badań",
       title = "B. 1000 badań: efekt X2 w populacji = 0",
       subtitle = sprintf("p < .05: regresja %.1f%%, ANOVA %.1f%%; kropki: ±%.2f",
                          100 * mean(sym$p_reg < .05), 100 * mean(sym$p_anova < .05), qt(.975, n4 - 4))) + motyw
p4 <- pA / pB
p4   # zapis: ggsave("podzial-na-medianie-dwa-podzialy.svg", p4, width = 8, height = 10)
Wynik w R
r_X1_X2  t_kryt   t_reg   p_reg t_anova p_anova
  0.576   1.972   0.049   0.961   1.208   0.228
        g1        g2    x1     y  n
  niski X1  niski X2 -1.10 -0.68 71
 wysoki X1  niski X2  0.50  0.38 29
  niski X1 wysoki X2 -0.79 -0.39 29
 wysoki X1 wysoki X2  0.78  0.45 71
  odsetek_reg odsetek_anova      sr_t_reg    sr_t_anova
        0.057         0.202         0.011         1.105
[1] 1.3
5. Mediana próby a stały próg: Rysunek 5
R
# Rysunek 5. Mediana próby to nie próg: 1000 badań w dwóch populacjach a stały punkt odcięcia
# (kontynuacja: kol, motyw, bz z bloku 1)
library(ggplot2)
library(patchwork)

# Parametry ustalone ręcznie (fikcyjne): skala stresu 0–40; studenci M = 17, SD = 7; osoby zgłaszające się
# do poradni M = 25, SD = 7; „próg z badania walidacyjnego” = 24 pkt (wartość wymyślona na potrzeby przykładu)
prog <- 24; n5 <- 60; B <- 1000
popul <- c(studenci = 17, poradnia = 25)
set.seed(594)
sym5 <- do.call(rbind, lapply(names(popul), function(g) {
  t(replicate(B, {
    x <- pmin(pmax(round(rnorm(n5, popul[[g]], 7)), 0), 40)
    m <- median(x); wys <- x > m
    c(mediana = m, odsetek_nad_progiem = mean(x >= prog),
      wysocy_ponizej_progu = mean(x[wys] < prog))   # „wysoki stres” wg mediany, a poniżej progu
  })) |> as.data.frame() |> transform(populacja = g)
}))
sym5$populacja <- factor(sym5$populacja, names(popul), c("studenci (M = 17)", "poradnia (M = 25)"))
print(aggregate(cbind(mediana, odsetek_nad_progiem, wysocy_ponizej_progu) ~ populacja, sym5,
                function(v) round(c(sr = mean(v), min = min(v), max = max(v)), 3)))

pA <- ggplot(sym5, aes(mediana, fill = populacja)) +
  geom_histogram(aes(colour = populacja), binwidth = 0.5, position = "identity", alpha = 0.45, boundary = 0.25) +
  geom_vline(xintercept = prog, linewidth = 1, colour = "black") +
  annotate("text", x = prog + 0.4, y = Inf, vjust = 1.5, hjust = 0, size = 3.6, label = sprintf("próg = %d pkt", prog)) +
  scale_fill_manual(values = c(kol[["niska"]], kol[["wysoka"]]), name = NULL) +
  scale_colour_manual(values = c(kol[["niska"]], kol[["wysoka"]]), name = NULL) +
  labs(x = "Mediana stresu w próbie (pkt)", y = "Liczba badań",
       title = sprintf("A. Gdzie wypada mediana: 1000 badań po %d osób", n5)) + motyw
pB <- ggplot(sym5, aes(populacja, wysocy_ponizej_progu, colour = populacja)) +
  geom_violin(aes(fill = populacja), alpha = 0.3, scale = "width", width = 0.7) +
  geom_boxplot(width = 0.12, outlier.shape = NA, fill = "white") +
  stat_summary(fun = mean, geom = "point", size = 5, shape = 18, colour = "black") +
  scale_colour_manual(values = c(kol[["niska"]], kol[["wysoka"]]), guide = "none") +
  scale_fill_manual(values = c(kol[["niska"]], kol[["wysoka"]]), guide = "none") +
  scale_y_continuous(limits = c(0, 1), labels = function(v) paste0(100 * v, "%")) +
  labs(x = NULL, y = "„Wysoki stres” wg mediany,\na wynik poniżej progu",
       title = "B. Kogo grupa „wysoka” obejmuje",
       subtitle = "Rozkład wyników 1000 badań (skrzypce i pudełko); romb – średnia") + motyw
p5 <- pA / pB
p5   # zapis: ggsave("podzial-na-medianie-mediana-a-prog.svg", p5, width = 8, height = 9)
Wynik w R
          populacja mediana.sr mediana.min mediana.max odsetek_nad_progiem.sr
1 studenci (M = 17)     16.945      13.500      21.000                  0.174
2 poradnia (M = 25)     25.036      21.500      29.000                  0.588
  odsetek_nad_progiem.min odsetek_nad_progiem.max wysocy_ponizej_progu.sr
1                   0.033                   0.367                   0.631
2                   0.383                   0.800                   0.002
  wysocy_ponizej_progu.min wysocy_ponizej_progu.max
1                    0.231                    0.929
2                    0.000                    0.207
6. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (ciągła / podział; grupa niska / wysoka)" = c("#0072B2", "#D55E00"),
             "cynober – szary (tylko ciągła istotna / żadna)" = c("#D55E00", "#8C8C8C"),
             "niebieski – szary (obie istotne / żadna)" = c("#0072B2", "#8C8C8C"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                             widzenie_typowe
niebieski – cynober (ciągła / podział; grupa niska / wysoka)           114.6
cynober – szary (tylko ciągła istotna / żadna)                          76.8
niebieski – szary (obie istotne / żadna)                                43.2
czerwony – zielony (do unikania)                                       121.7
                                                             deuteranopia
niebieski – cynober (ciągła / podział; grupa niska / wysoka)        108.3
cynober – szary (tylko ciągła istotna / żadna)                       62.6
niebieski – szary (obie istotne / żadna)                             47.1
czerwony – zielony (do unikania)                                     21.1
                                                             protanopia
niebieski – cynober (ciągła / podział; grupa niska / wysoka)       91.9
cynober – szary (tylko ciągła istotna / żadna)                     54.8
niebieski – szary (obie istotne / żadna)                           39.2
czerwony – zielony (do unikania)                                   31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowania, korelacje, testy t, regresja i ANOVA – pakiety base i stats. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- „Po podziale wynik i tak wyszedł istotny, więc podział nie zaszkodził”. Przy dwóch skorelowanych predyktorach istotność bywa właśnie skutkiem podziału (rysunek 4).
- „U mnie po podziale korelacja wyszła wyższa”. Zdarza się to w niemal co piątym badaniu przypadkiem (rysunek 2) i nie jest argumentem za podziałem.
- Analiza mocy dla zmiennej ciągłej, a potem podział. Przy 80 osobach moc spada wtedy z .79 do .56 (rysunek 3).
- „Wysoki stres” jako wynik powyżej mediany. To tylko „wyżej niż połowa tej próby”, a w innej próbie znaczy coś innego (rysunek 5).
- Kontrolowanie zmiennej zakłócającej w dwóch grupach. Część zakłócania zostaje w modelu (rysunek 4 i Royston i in., 2006).
Najczęstsze pytania
Ile mocy tracę, dzieląc zmienną ciągłą na medianie?
Przy rozkładzie normalnym korelacja spada średnio do około 0.80 swojej wartości. W naszej symulacji (ρ = .30, 1000 badań na liczebność) moc przy 80 osobach wyniosła .79 dla zmiennej ciągłej i .56 po podziale. Moc .80 wymagała około 85 osób przy zmiennej ciągłej i 135 po podziale, czyli podział działa jak wyrzucenie ponad jednej trzeciej danych (Cohen, 1983, podaje 38%).
Po podziale wyszła mi wyższa korelacja niż na zmiennej ciągłej. Czy podział był lepszy?
Nie. W 1000 symulowanych badaniach korelacja po podziale była wyższa w 18.6% prób, a w 28 badaniach tylko podział dał wynik istotny. To przypadkowy układ punktów wokół mediany. Przeciętnie podział zaniża korelację, a analiza zmiennej ciągłej wykryła związek w 796 badaniach na 1000, podział – w 587.
Dlaczego dwa podziały na medianie mogą dać efekt, którego nie ma?
Bo etykieta „niski X1” obejmuje osoby o różnym X1, a te różnice są skorelowane z X2. Część efektu X1, której podział nie uchwycił, przechodzi na X2. Maxwell i Delaney (1993) pokazali, że dychotomizacja dwóch predyktorów może dawać fałszywą istotność. W naszej symulacji (korelacja predyktorów .50, n = 200) ANOVA 2 × 2 dała 20.2% fałszywie istotnych efektów X2, a regresja na zmiennych ciągłych 5.7%.
Kiedy wolno podzielić wynik kwestionariusza na grupy?
Gdy próg pochodzi spoza Twojej próby, np. z badania walidacyjnego narzędzia albo z norm, i ustalasz go przed analizą. Mediana próby takim progiem nie jest: w symulacji wynosiła u studentów od 13.5 do 21 punktów, a średnio 63.1% studentów z grupy „wysokiej” miało wynik poniżej stałego progu. Nawet przy progu hipotezę testuj na wyniku ciągłym, a odsetek powyżej progu podaj obok.
Jak pokazać „niskich” i „wysokich” bez podziału na grupy?
Policz regresję na zmiennej ciągłej, a na wykresie pokaż wartości przewidywane dla wybranych poziomów predyktora, np. średnia ± 1 SD. Przy pytaniu, czy efekt zależy od trzeciej zmiennej, użyj moderacji z ciągłym moderatorem i prostych nachyleń. Czytelność jest podobna, a nie tracisz danych.
Powiązane hasła
Przeczytaj też
Dychotomizacja zmiennych ciągłych
Ile mocy kosztuje podział zależnie od punktu cięcia, dlaczego dwa podziały dają pozorne efekty i interakcje, kiedy próg kliniczny ma sens i co analizować zamiast grup – z symulacjami w R.
Czytaj →PoradnikMoc testu w obrazkach
Pola α, β i mocy na dwóch rozkładach, krzywe mocy z symulacją, klątwa zwycięzcy przy niskiej mocy i moc po fakcie – pięć rysunków z kodem R.
Czytaj →PoradnikModeracja – wizualizacja na obrazkach
Proste nachylenia, obszar Johnsona–Neymana, mapa przewidywań, moderator dwuwartościowy, centrowanie i moc interakcji w 1000 badań – sześć rysunków z kodem R.
Czytaj →PoradnikKorelacje na wykresie
Mapa cieplna w dobrej kolejności, korekta zamiast gwiazdek, ggpairs ujawniający próg i sufit oraz korelacje z przedziałami ufności – pięć rysunków z kodem R.
Czytaj →Promotor chce grup „niskich” i „wysokich”?
Pomożemy przeprowadzić analizę na zmiennych ciągłych, przygotować wykres z wartościami przewidywanymi i opisać w pracy, dlaczego nie dzielimy zmiennych na grupy – tak, żebyś umiał(a) to uzasadnić promotorowi i recenzentowi.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cohen, J. (1983). The cost of dichotomization. Applied Psychological Measurement, 7(3), 249–253. https://doi.org/10.1177/014662168300700301 ● Otwarty dostęp: pełny tekst
- MacCallum, R. C., Zhang, S., Preacher, K. J., & Rucker, D. D. (2002). On the practice of dichotomization of quantitative variables. Psychological Methods, 7(1), 19–40. https://doi.org/10.1037/1082-989x.7.1.19 ● Otwarty dostęp: pełny tekst
- Maxwell, S. E., & Delaney, H. D. (1993). Bivariate median splits and spurious statistical significance. Psychological Bulletin, 113(1), 181–190. https://doi.org/10.1037/0033-2909.113.1.181
- Naggara, O., Raymond, J., Guilbert, F., Roy, D., Weill, A., & Altman, D. G. (2011). Analysis by categorizing or dichotomizing continuous variables is inadvisable: An example from the natural history of unruptured aneurysms. American Journal of Neuroradiology, 32(3), 437–440. https://doi.org/10.3174/ajnr.a2425 ● Otwarty dostęp
- Royston, P., Altman, D. G., & Sauerbrei, W. (2006). Dichotomizing continuous predictors in multiple regression: A bad idea. Statistics in Medicine, 25(1), 127–141. https://doi.org/10.1002/sim.2331
Cytowania BibTeX
@article{cohen1983cost, author={Cohen, Jacob}, title={{The cost of dichotomization}}, journal={Applied Psychological Measurement}, year={1983}, volume={7}, number={3}, pages={249--253}, doi={10.1177/014662168300700301}}@article{maccallum2002practice, author={MacCallum, Robert C. and Zhang, Shaobo and Preacher, Kristopher J. and Rucker, Derek D.}, title={{On the practice of dichotomization of quantitative variables}}, journal={Psychological Methods}, year={2002}, volume={7}, number={1}, pages={19--40}, doi={10.1037/1082-989x.7.1.19}}@article{maxwell1993bivariate, author={Maxwell, Scott E. and Delaney, Harold D.}, title={{Bivariate median splits and spurious statistical significance}}, journal={Psychological Bulletin}, year={1993}, volume={113}, number={1}, pages={181--190}, doi={10.1037/0033-2909.113.1.181}}@article{naggara2011analysis, author={Naggara, O. and Raymond, J. and Guilbert, F. and Roy, D. and Weill, A. and Altman, D. G.}, title={{Analysis by categorizing or dichotomizing continuous variables is inadvisable: An example from the natural history of unruptured aneurysms}}, journal={American Journal of Neuroradiology}, year={2011}, volume={32}, number={3}, pages={437--440}, doi={10.3174/ajnr.a2425}}@article{royston2006dichotomizing, author={Royston, Patrick and Altman, Douglas G. and Sauerbrei, Willi}, title={{Dichotomizing continuous predictors in multiple regression: A bad idea}}, journal={Statistics in Medicine}, year={2006}, volume={25}, number={1}, pages={127--141}, doi={10.1002/sim.2331}}