Dlaczego wynik różnicowy nie odpowiada na pytanie o dopasowanie
Wiele hipotez w psychologii pracy, osobowości i relacji dotyczy zgodności dwóch ocen. Czy pracownik jest bardziej zadowolony, gdy autonomia na stanowisku odpowiada jego potrzebie autonomii? Czy trafna samoocena wiąże się z lepszym przystosowaniem? Czy pary podobne pod względem cech są szczęśliwsze? Odruchowo liczy się wtedy różnicę obu ocen, jej wartość bezwzględną albo kwadrat i wstawia ją do regresji jako jeden predyktor.
Edwards (2001) przypomina, że takie wskaźniki są popularne w badaniach dopasowania, podobieństwa i zgodności, ale mają liczne problemy metodologiczne. Najważniejszy jest prosty: wynik różnicowy zakłada z góry, że liczy się tylko różnica, a poziom obu ocen nie ma znaczenia. Osoba, która potrzebuje mało autonomii i mało jej dostaje, ma tę samą różnicę zero co osoba, która potrzebuje dużo i dużo dostaje. Jeśli te dwie osoby różnią się satysfakcją, wskaźnik różnicowy tego nie pokaże, a jego współczynnik będzie mieszaniną kilku efektów.
To inny problem niż spór o analizę zmiany w badaniu przed–po, który omawia wpis paradoks Lorda: ANCOVA czy wynik różnicowy, oraz niż właściwości wyniku różnicowego jako miary zmiany. Tutaj różnica nie jest zmienną zależną, tylko predyktorem. Nie chodzi też o zgodność dwóch metod pomiaru tej samej wielkości – do tego służą metoda Blanda–Altmana i współczynniki opisane we wpisie zgodność dwóch metod pomiaru. RSA odpowiada na pytanie, jak zgodność dwóch zmiennych wiąże się z trzecią.
Regresja wielomianowa i powierzchnia odpowiedzi
Edwards i Parry (1993) zaproponowali, by zamiast wyniku różnicowego wstawić do modelu oba składniki osobno, razem z ich kwadratami i iloczynem:
To zwykła regresja wieloraka z pięcioma predyktorami, połączenie regresji krzywoliniowej i interakcji zmiennych. Przewidywane wartości Z tworzą zakrzywioną powierzchnię nad płaszczyzną X–Y i właśnie jej kształt się interpretuje (Shanock i in., 2010). Pojedynczych współczynników b1–b5 zwykle się nie czyta. Zamiast nich opisuje się powierzchnię wzdłuż dwóch prostych:
- linii zgodności (ang. line of congruence) X = Y – tu leżą osoby, u których obie oceny są równe, na różnych poziomach;
- linii niezgodności (ang. line of incongruence) X = −Y – tu przy tym samym przeciętnym poziomie rośnie rozbieżność w jedną albo w drugą stronę.
Barranti, Carlson i Côté (2017) porównują RSA z wynikami różnicowymi, resztami i zwykłą regresją z moderacją i pokazują, że te popularne podejścia mogą prowadzić do niepełnych albo mylących wniosków. Klasyczną moderację opisuje wpis analiza moderacji krok po kroku – RSA to jej rozszerzenie o człony kwadratowe, które pozwala zadać pytanie o zgodność wprost.
Przygotowanie danych: wspólna skala i rozbieżne oceny
Przykład dotyczy dopasowania osoba–praca (dane symulowane). Trzysta osób oceniło na skali 1–7, jak dużej autonomii potrzebuje (X: M = 4.66, SD = 1.12) i jak dużą autonomię daje im stanowisko (Y: M = 4.20, SD = 1.14), oraz swoją satysfakcję z pracy (M = 4.53, SD = 1.01). Obie oceny korelowały na poziomie r = .394.
Warunek pierwszy: X i Y muszą być mierzone na tej samej skali. Pytanie „czy autonomia odpowiada potrzebie” ma sens tylko wtedy, gdy 5 na jednej skali znaczy to samo co 5 na drugiej. Dlatego pozycje obu skal powinny być równoległe (ten sam wymiar, te same kotwice).
Warunek drugi: centrowanie na wspólnym punkcie. Obie zmienne odejmujemy od środka skali (4), a nie każdą od jej własnej średniej. Gdybyś wycentrował X i Y osobno, punkt (0, 0) oznaczałby różne wartości surowe i linia X = Y przestałaby być linią zgodności. Dalal i Zickar (2012) pokazują, że centrowanie nie zmienia współczynnika najwyższego rzędu ani dopasowania modelu – ułatwia tylko interpretację. W RSA to ważne, bo wysoka współliniowość X z X² przy niecentrowanych danych nie jest powodem do niepokoju.
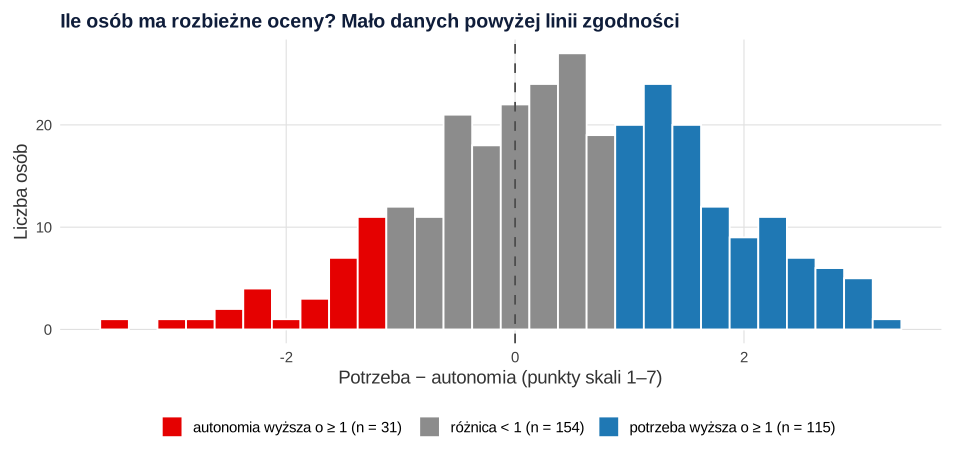
Warunek trzeci: dane po obu stronach linii zgodności. Przed analizą sprawdź, ile osób ma rozbieżne oceny. Popularny sposób to standaryzacja obu zmiennych i umowny próg różnicy ±0.5 SD. W przykładzie dał on trzy podobne grupy: 93 osoby (31.0%) z autonomią wyższą od potrzeby, 110 (36.7%) zgodnych i 97 (32.3%) z potrzebą wyższą od autonomii. Na surowej skali obraz jest jednak inny (rysunek 1): autonomię wyższą od potrzeby o co najmniej punkt miało tylko 31 osób, a odwrotną rozbieżność – 115. Standaryzacja usuwa różnicę średnich, a ta jest częścią pytania o zgodność. Gdy po jednej stronie linii zgodności jest mało osób, powierzchnia jest tam w dużej mierze ekstrapolacją.
Krok 1. Czy sama różnica wystarcza?
Kwadrat różnicy jako jedyny predyktor dał wynik, który łatwo uznać za potwierdzenie hipotezy: im większa rozbieżność, tym niższa satysfakcja, b = −0.157, SE = 0.024, p < .001, R² = .122. Model (X − Y)² jest jednak szczególnym przypadkiem modelu wielomianowego: po rozpisaniu kwadratu wymaga, by b1 = b2 = 0 oraz b3 = b5 = −b4/2. Te cztery ograniczenia da się sprawdzić zwykłym testem F porównującym model z kwadratem różnicy z pełnym modelem. Jeśli test je odrzuca, wynik różnicowy upraszcza dane w sposób, którego nie wolno pominąć.
W przykładzie ograniczenia zostały odrzucone, F(4, 294) = 13.34, p < .001. Pełny model wyjaśnił dwa razy więcej wariancji satysfakcji (R² = .257, skorygowane R² = .245). Współczynniki b1 = 0.160 i b2 = 0.202 były dodatnie, a więc poziom obu ocen też ma znaczenie. Tego wynik różnicowy nie pokazał.
Krok 2. Parametry powierzchni a1–a4 i ich błędy
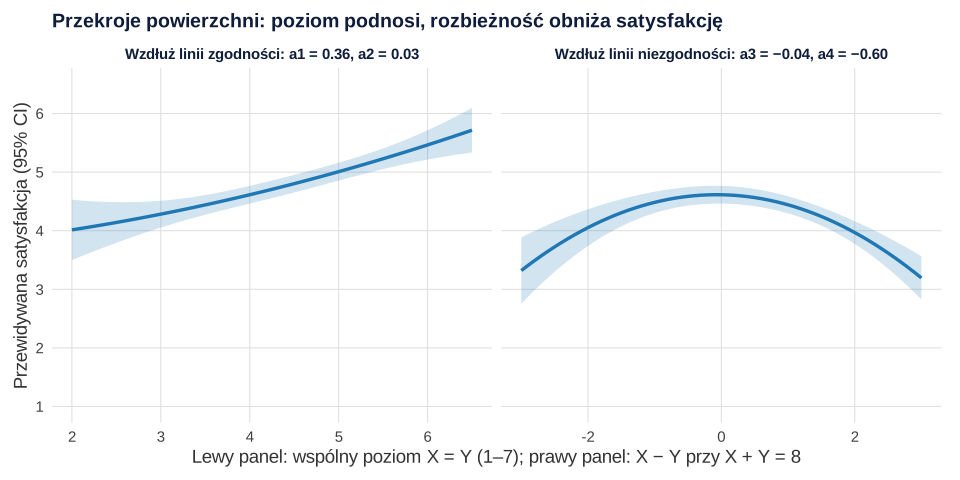
Kształt powierzchni wzdłuż obu linii opisują cztery kombinacje liniowe współczynników. Po podstawieniu X = Y otrzymujesz parabolę o nachyleniu a1 i krzywiźnie a2, a po podstawieniu X = −Y – parabolę o nachyleniu a3 i krzywiźnie a4.
| Parametr | Wzór | Co opisuje | Oszacowanie [95% CI] | p |
|---|---|---|---|---|
| a1 | b1 + b2 | nachylenie wzdłuż linii zgodności: czy przy zgodnych ocenach wyższy poziom daje wyższe Z | 0.362 [0.226, 0.499] | < .001 |
| a2 | b3 + b4 + b5 | krzywizna wzdłuż linii zgodności | 0.031 [−0.051, 0.114] | .455 |
| a3 | b1 − b2 | nachylenie wzdłuż linii niezgodności: czy jeden kierunek rozbieżności liniowo przeważa | −0.042 [−0.234, 0.150] | .668 |
| a4 | b3 − b4 + b5 | krzywizna wzdłuż linii niezgodności: ujemna, gdy rozbieżność w obie strony obniża Z | −0.603 [−0.795, −0.411] | < .001 |
Błąd standardowy każdej kombinacji policzysz bez specjalnego pakietu. Jeśli w to wektor wag (np. dla a4: 0, 0, 0, 1, −1, 1), a V to macierz kowariancji współczynników z vcov(), to:
Nie licz SE jako sumy błędów współczynników – pominiesz ich kowariancje. W przykładzie a4 = −0.603 przy SE = 0.098. Rysunek 2 pokazuje oba przekroje: wzdłuż linii zgodności satysfakcja rośnie prawie liniowo z poziomem, a wzdłuż linii niezgodności spada w obie strony od zgodności.
Krok 3. Hipoteza zgodności: lista kontrolna, nie jeden test
Najczęstszy błąd to uznanie istotnego a4 za dowód, że „liczy się dopasowanie”. Humberg, Nestler i Back (2019) pokazują, że test pojedynczego parametru RSA nie wskazuje efektu zgodności, i podają listę kontrolną. Jej sens geometryczny jest prosty: przy efekcie zgodności dla każdego poziomu najwyższe Z leży na linii X = Y. Powierzchnia ma więc grzbiet, a grzbiet pokrywa się z linią zgodności. Sprawdzasz to łącznie:
- Pierwsza główna oś leży na linii zgodności. Oś grzbietu zapisuje się jako Y = p10 + p11X, więc wymagasz p10 ≈ 0 i p11 ≈ 1. W przykładzie p10 = 0.075, 95% CI [−0.310, 0.427], i p11 = 0.981, 95% CI [0.725, 1.419]. Przedziały policzono metodą bootstrap (2000 prób, percentylowe), bo p10 i p11 są nieliniowymi funkcjami współczynników.
- a4 < 0 – rozbieżność w obie strony obniża Z. W przykładzie spełnione.
- a3 nie różni się od zera – maksimum na linii niezgodności leży w punkcie zgodności, a nie obok niego. W przykładzie p = .668.
Wszystkie trzy warunki są spełnione, więc dane są zgodne z szeroką hipotezą zgodności: przy każdym poziomie najlepiej jest, gdy autonomia odpowiada potrzebie. Ścisła wersja hipotezy wymaga dodatkowo a1 = 0 i a2 = 0, czyli tej samej wartości Z na całej linii zgodności. Tu a1 = 0.362 jest wyraźnie dodatnie: przy zgodnych ocenach 3 i 3 przewidywana satysfakcja wynosi 4.28, 95% CI [4.05, 4.51], a przy 6 i 6 – 5.46, 95% CI [5.21, 5.71]. Rysunek 3 pokazuje całą powierzchnię jako mapę konturową.
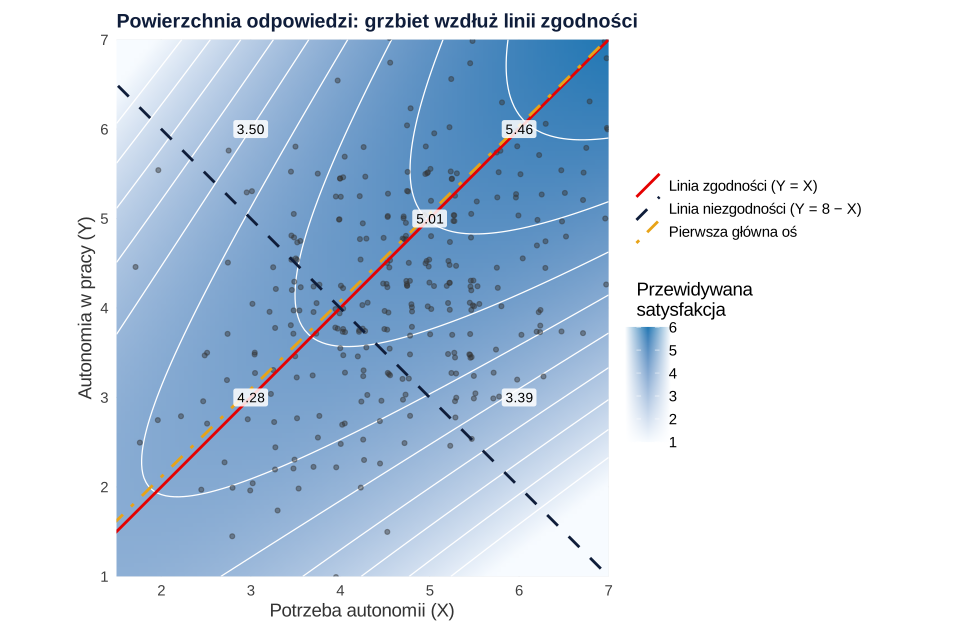
Dwie uwagi. Punkt stacjonarny powierzchni wypadł daleko poza skalą (−5.85 i −5.67 na skali wycentrowanej), bo a2 jest bliskie zera i powierzchnia nie ma wyraźnego szczytu, tylko wznoszący się grzbiet. Wtedy liczy się położenie osi, a nie samego punktu. Druga uwaga dotyczy kierunku rozbieżności. Przewidywana satysfakcja przy potrzebie 3 i autonomii 6 wyniosła 3.50, 95% CI [2.95, 4.05], a przy potrzebie 6 i autonomii 3 – 3.39, 95% CI [3.04, 3.74]. Kusi wniosek, że „za dużo autonomii szkodzi tak samo jak za mało”. Humberg i in. (2019) podkreślają jednak, że przy efekcie zgodności RSA nie rozstrzyga, czy rozbieżność w jednym kierunku jest lepsza czy gorsza niż w drugim. Szeroki przedział w pierwszym punkcie wynika też z tego, że osób z nadmiarem autonomii było mało.
Pary, wiele ocen i liczebność próby
Gdy X i Y pochodzą od dwóch osób z pary, a wynik mierzysz u obu partnerów, obserwacje nie są niezależne. Schönbrodt, Humberg i Nestler (2018) opisują diadyczną analizę powierzchni odpowiedzi, która łączy model wielomianowy z logiką modelu aktor–partner. Format danych i model APIM omawia wpis dane diadyczne i APIM krok po kroku.
Model ma sześć parametrów, w tym trzy człony drugiego rzędu, więc wymaga większej próby niż prosta regresja. Człony kwadratowe i iloczyn przenoszą też błąd pomiaru obu skal, co obniża moc – mechanizm opisują wpisy moc testu dla interakcji i błąd pomiaru w regresji. Jeśli spodziewasz się kształtów bardziej złożonych niż parabola, rozważ modele elastyczne, np. wielomiany ułamkowe, ale wtedy tracisz proste parametry a1–a4.
Jak opisać RSA w artykule
W metodzie podaj sposób centrowania, model, sposób liczenia błędów a1–a4 i przedziałów dla osi oraz kryteria hipotezy zgodności ustalone przed analizą. W wynikach pokaż współczynniki b1–b5 w tabeli, parametry a1–a4 z CI, położenie głównej osi i rysunek powierzchni. Jeśli potrzebujesz drugiej pary oczu przy modelu lub odpowiedzi recenzentowi, zobacz analizy statystyczne dla badaczy.
Przykład w R
Trzy pierwsze przepisy uruchamiasz po kolei w jednej sesji R. Pierwszy zapisuje dane do pliku dopasowanie-osoba-praca.csv (możesz go pobrać tutaj). Wszystkie parametry RSA liczymy funkcją lm() i rachunkiem macierzowym, bez specjalnego pakietu. Czwarty przepis to tylko przykład składni pakietu RSA. Potrzebne pakiety: MASS (losowanie danych) i boot.
1. Dane, wspólna skala i rozbieżne oceny
R
# Krok 1. Dane: dopasowanie osoba–praca (dane symulowane)
# potrzeba   – jak dużej autonomii pracownik potrzebuje (skala 1–7, średnia 4 pozycji)
# autonomia  – jak dużą autonomię daje stanowisko w ocenie pracownika (skala 1–7, średnia 4 pozycji)
# satysfakcja – satysfakcja z pracy (skala 1–7)
set.seed(3451)
N <- 300
S <- matrix(c(1.1^2, .40 * 1.1 * 1.2, .40 * 1.1 * 1.2, 1.2^2), 2)
xy <- MASS::mvrnorm(N, mu = c(4.6, 4.1), Sigma = S)
skala <- function(v) pmin(7, pmax(1, round(v * 4) / 4))       # wyniki co 0.25 punktu, w granicach 1–7
potrzeba <- skala(xy[, 1]); autonomia <- skala(xy[, 2])
x <- potrzeba - 4; y <- autonomia - 4                          # model populacyjny na skali wycentrowanej
satysfakcja <- 4.6 + 0.20 * x + 0.20 * y - 0.15 * x^2 + 0.30 * x * y - 0.15 * y^2 + rnorm(N, 0, 0.9)
satysfakcja <- pmin(7, pmax(1, round(satysfakcja, 2)))
dane <- data.frame(id = 1:N, potrzeba, autonomia, satysfakcja)
write.csv(dane, "dopasowanie-osoba-praca.csv", row.names = FALSE)

# Statystyki opisowe i korelacja ocen
round(sapply(dane[, -1], function(v) c(M = mean(v), SD = sd(v), min = min(v), max = max(v))), 2)
round(cor(dane$potrzeba, dane$autonomia), 3)

# Centrowanie na wspólnej skali: środek skali 1–7 (to samo zero dla obu predyktorów)
dane$X <- dane$potrzeba - 4
dane$Y <- dane$autonomia - 4

# Ile osób ma zgodne, a ile rozbieżne oceny? Różnica standaryzowana, próg ±0.5
zx <- as.numeric(scale(dane$potrzeba)); zy <- as.numeric(scale(dane$autonomia))
grupa <- cut(zx - zy, c(-Inf, -.5, .5, Inf),
             labels = c("autonomia > potrzeba", "zgodne", "potrzeba > autonomia"))
cbind(n = table(grupa), proc = round(100 * prop.table(table(grupa)), 1))
# Na surowej wspólnej skali: różnica co najmniej 1 punkt
table(cut(dane$potrzeba - dane$autonomia, c(-Inf, -1, 1 - 1e-9, Inf), right = FALSE,
          labels = c("autonomia wyższa o >= 1", "różnica < 1", "potrzeba wyższa o >= 1")))
Wynik w R
    potrzeba autonomia satysfakcja
M       4.66      4.20        4.53
SD      1.12      1.14        1.01
min     1.75      1.00        1.28
max     7.00      7.00        7.00
[1] 0.394
                       n proc
autonomia > potrzeba  93 31.0
zgodne               110 36.7
potrzeba > autonomia  97 32.3

autonomia wyższa o >= 1             różnica < 1  potrzeba wyższa o >= 1
                     31                     154                     115
2. Kwadrat różnicy a pełny model wielomianowy
R
# Krok 2. Wynik różnicowy a pełna regresja wielomianowa (wymaga obiektu dane z kroku 1)
dane$D <- dane$X - dane$Y

# (a) Kwadrat różnicy jako jedyny predyktor
m_d2 <- lm(satysfakcja ~ I(D^2), data = dane)
printCoefmat(summary(m_d2)$coefficients, digits = 3, signif.stars = FALSE)
round(summary(m_d2)$r.squared, 3)

# (b) Pełny model wielomianowy: Z = b0 + b1X + b2Y + b3X² + b4XY + b5Y²
m_pel <- lm(satysfakcja ~ X + Y + I(X^2) + I(X * Y) + I(Y^2), data = dane)
printCoefmat(summary(m_pel)$coefficients, digits = 3, signif.stars = FALSE)
round(c(R2 = summary(m_pel)$r.squared, R2_skor = summary(m_pel)$adj.r.squared), 3)

# (c) Model (a) to model (b) z ograniczeniami b1 = b2 = 0 i b3 = b5 = −b4/2.
#     Test F ograniczeń (4 df): czy wynik różnicowy wystarcza?
print(anova(m_d2, m_pel), signif.stars = FALSE)
Wynik w R
            Estimate Std. Error t value Pr(>|t|)
(Intercept)   4.8054     0.0696   69.03  < 2e-16
I(D^2)       -0.1571     0.0244   -6.45  4.5e-10
[1] 0.122
            Estimate Std. Error t value Pr(>|t|)
(Intercept)   4.6134     0.0768   60.06  < 2e-16
X             0.1602     0.0650    2.47  0.01427
Y             0.2022     0.0545    3.71  0.00025
I(X^2)       -0.1399     0.0371   -3.77  0.00019
I(X * Y)      0.3171     0.0511    6.20  1.9e-09
I(Y^2)       -0.1459     0.0362   -4.03  7.1e-05
     R2 R2_skor
  0.257   0.245
Analysis of Variance Table

Model 1: satysfakcja ~ I(D^2)
Model 2: satysfakcja ~ X + Y + I(X^2) + I(X * Y) + I(Y^2)
  Res.Df    RSS Df Sum of Sq      F    Pr(>F)
1    298 269.75
2    294 228.31  4    41.442 13.341 5.296e-10
3. Parametry a1–a4, główna oś i warunki zgodności
R
# Krok 3. Parametry powierzchni a1–a4, punkt stacjonarny, główna oś i warunki zgodności
# (wymaga obiektów dane i m_pel z kroków 1–2)
b <- coef(m_pel); V <- vcov(m_pel); df_r <- df.residual(m_pel)
# Wagi kombinacji liniowych współczynników (kolejność: b0, b1, b2, b3, b4, b5)
W <- rbind(a1 = c(0, 1,  1, 0,  0, 0),   # nachylenie wzdłuż linii zgodności X = Y
           a2 = c(0, 0,  0, 1,  1, 1),   # krzywizna wzdłuż linii zgodności
           a3 = c(0, 1, -1, 0,  0, 0),   # nachylenie wzdłuż linii niezgodności X = −Y
           a4 = c(0, 0,  0, 1, -1, 1))   # krzywizna wzdłuż linii niezgodności
est <- drop(W %*% b)
se  <- sqrt(diag(W %*% V %*% t(W)))      # SE kombinacji liniowej: sqrt(w' V w)
tab_a <- data.frame(est, se, t = est / se, p = 2 * pt(-abs(est / se), df_r),
                    dolna = est - qt(.975, df_r) * se, gorna = est + qt(.975, df_r) * se)
print(round(tab_a[, -4], 3)); signif(tab_a$p, 3)

# Punkt stacjonarny i pierwsza główna oś (Y = p10 + p11·X)
os_glowna <- function(b) {
  b1 <- b[2]; b2 <- b[3]; b3 <- b[4]; b4 <- b[5]; b5 <- b[6]
  X0 <- (b2 * b4 - 2 * b1 * b5) / (4 * b3 * b5 - b4^2)
  Y0 <- (b1 * b4 - 2 * b2 * b3) / (4 * b3 * b5 - b4^2)
  p11 <- (b5 - b3 + sqrt((b3 - b5)^2 + b4^2)) / b4
  c(X0 = unname(X0), Y0 = unname(Y0), p10 = unname(Y0 - p11 * X0), p11 = unname(p11))
}
round(os_glowna(b), 3)

# Bootstrap (2000 prób, przedziały percentylowe) dla p10 i p11
library(boot)
set.seed(3452)
bt <- boot(dane, function(d, i) os_glowna(coef(lm(satysfakcja ~ X + Y + I(X^2) + I(X * Y) + I(Y^2),
                                                  data = d[i, ]))), R = 2000)
ci <- t(sapply(3:4, function(k) boot.ci(bt, type = "perc", index = k)$percent[4:5]))
dimnames(ci) <- list(c("p10", "p11"), c("dolna", "gorna")); round(ci, 3)

# Lista kontrolna hipotezy zgodności (szeroka zgodność)
c(p10_zawiera_0 = ci[1, 1] < 0 & ci[1, 2] > 0,
  p11_zawiera_1 = ci[2, 1] < 1 & ci[2, 2] > 1,
  a3_nieistotne = tab_a["a3", "p"] >= .05,
  a4_ujemne     = tab_a["a4", "gorna"] < 0)

# Przewidywana satysfakcja w kilku punktach (skala 1–7)
pkt <- data.frame(potrzeba = c(3, 5, 6, 3, 6), autonomia = c(3, 5, 6, 6, 3))
pkt$X <- pkt$potrzeba - 4; pkt$Y <- pkt$autonomia - 4
cbind(pkt[, 1:2], round(predict(m_pel, pkt, interval = "confidence"), 2))
Wynik w R
      est    se      t  dolna  gorna
a1  0.362 0.069  5.217  0.226  0.499
a2  0.031 0.042  0.749 -0.051  0.114
a3 -0.042 0.098 -0.429 -0.234  0.150
a4 -0.603 0.098 -6.181 -0.795 -0.411
[1] 3.44e-07 4.55e-01 6.68e-01 2.12e-09
    X0     Y0    p10    p11
-5.854 -5.670  0.075  0.981
     dolna gorna
p10 -0.310 0.427
p11  0.725 1.419
p10_zawiera_0 p11_zawiera_1 a3_nieistotne     a4_ujemne
         TRUE          TRUE          TRUE          TRUE
  potrzeba autonomia  fit  lwr  upr
1        3         3 4.28 4.05 4.51
2        5         5 5.01 4.85 5.16
3        6         6 5.46 5.21 5.71
4        3         6 3.50 2.95 4.05
5        6         3 3.39 3.04 3.74
4. Ten sam model w pakiecie RSA (składnia, kod nieuruchamiany)
R
# Ten sam model w pakiecie RSA – przykład składni. Kodu nie uruchamialiśmy, więc nie ma wyników.
# library(RSA)
# wynik <- RSA(satysfakcja ~ X * Y, data = dane, models = "full")
# summary(wynik)      # współczynniki b1–b5, parametry a1–a4, punkt stacjonarny i główne osie
# plot(wynik)         # wykres powierzchni 3D
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–3 w R 4.5.3 (funkcje lm(), vcov(), anova() z pakietu stats) z pakietami MASS i boot; rysunki przygotowano w pakiecie ggplot2. Kodu pakietu RSA nie uruchamialiśmy.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- boot (wersja 1.3-32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions [R package]. https://doi.org/10.32614/CRAN.package.boot
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Wynik różnicowy bez testu ograniczeń. |X − Y| albo (X − Y)² to model z ukrytymi założeniami. Sprawdź je testem F wobec pełnego modelu.
- Jeden parametr jako dowód zgodności. Istotne a4 albo nieistotne a3 osobno niczego nie dowodzą. Sprawdź łącznie główną oś, a3 i a4.
- Centrowanie każdej zmiennej osobno. Przesuwa linię zgodności. Centruj obie na tym samym punkcie wspólnej skali.
- Skale nieporównywalne. Gdy X i Y mierzą różne rzeczy albo mają różne kotwice, pytanie o zgodność nie ma sensu. Wtedy zostaje zwykła regresja z interakcją.
- Brak danych po jednej stronie linii zgodności. Policz osoby z rozbieżnymi ocenami i pokaż dane na wykresie. Nie interpretuj powierzchni tam, gdzie nie ma obserwacji.
- Wniosek o kierunku rozbieżności z samego a3. Opisuj go ostrożnie, przez przewidywane wartości z CI w konkretnych punktach.
Najczęstsze pytania
Czym różni się RSA od wyniku różnicowego?
Wynik różnicowy (np. |X − Y| albo (X − Y)²) to regresja wielomianowa z ukrytymi ograniczeniami: zakłada, że liczy się tylko różnica, a poziom obu ocen nie ma znaczenia. RSA szacuje model bez tych ograniczeń i pozwala je sprawdzić testem F. W przykładzie ograniczenia kwadratu różnicy zostały odrzucone, F(4, 294) = 13.34, p < .001, a R² wzrosło z .122 do .257.
Jak policzyć parametry a1, a2, a3 i a4 w RSA?
Z współczynników regresji wielomianowej: a1 = b1 + b2, a2 = b3 + b4 + b5, a3 = b1 − b2, a4 = b3 − b4 + b5. Błąd standardowy każdej sumy policz jako √(w′Vw), gdzie w to wektor wag, a V – macierz kowariancji współczynników z vcov(). Pakiet nie jest do tego potrzebny.
Czy istotne a4 oznacza efekt zgodności?
Nie. Ujemne a4 mówi tylko, że wzdłuż linii niezgodności powierzchnia jest wklęsła. Efekt zgodności wymaga też, by grzbiet powierzchni leżał na linii zgodności (pierwsza główna oś: p10 ≈ 0, p11 ≈ 1) i by a3 nie różniło się od zera. Humberg, Nestler i Back (2019) pokazują, że test jednego parametru RSA nie wystarcza.
Jak centrować zmienne w analizie powierzchni odpowiedzi?
Obie zmienne odejmij od tej samej stałej – zwykle środka wspólnej skali (np. 4 na skali 1–7) – a nie każdą od jej własnej średniej. Linia zgodności X = Y ma sens tylko wtedy, gdy zero oznacza to samo dla obu predyktorów. Bez wspólnej skali pomiaru RSA nie odpowie na pytanie o zgodność.
Czy w RSA można sprawdzić, który kierunek rozbieżności jest gorszy?
Ostrożnie. Gdy jest efekt zgodności, sam test a3 nie rozstrzyga, czy gorzej jest, gdy X przewyższa Y, czy odwrotnie (Humberg i in., 2019). Porównaj raczej przewidywane wartości w konkretnych punktach z 95% CI i sprawdź, czy po obu stronach linii zgodności masz wystarczająco dużo osób.
Powiązane hasła
Przeczytaj też
Paradoks Lorda: ANCOVA czy wynik różnicowy?
Kiedy obie analizy badania przed–po się zgadzają, kiedy myli się każda z nich, regresja do średniej, graf przyczynowy i symulacja w R.
Czytaj →PoradnikDane diadyczne i APIM krok po kroku
Formaty danych par, ICC w diadach, APIM w gls i lavaan, test rozróżnialności i parametr k – na 200 parach w R.
Czytaj →PoradnikZgodność dwóch metod pomiaru: CCC, Deming, Passing–Bablok
CCC Lina, regresja Deminga i Passinga–Babloka, błąd stały i proporcjonalny, bootstrapowe przedziały ufności, przykład w R i wzór opisu.
Czytaj →Testujesz hipotezę dopasowania lub zgodności dwóch ocen?
Pomożemy sprawdzić, czy dane nadają się do RSA, policzyć model wielomianowy z parametrami a1–a4 i warunkami zgodności oraz przygotować wykres i opis, które samodzielnie obronisz przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Barranti, M., Carlson, E. N., & Côté, S. (2017). How to test questions about similarity in personality and social psychology research. Social Psychological and Personality Science, 8(4), 465–475. https://doi.org/10.1177/1948550617698204
- Dalal, D. K., & Zickar, M. J. (2012). Some common myths about centering predictor variables in moderated multiple regression and polynomial regression. Organizational Research Methods, 15(3), 339–362. https://doi.org/10.1177/1094428111430540
- Edwards, J. R. (2001). Ten difference score myths. Organizational Research Methods, 4(3), 265–287. https://doi.org/10.1177/109442810143005
- Edwards, J. R., & Parry, M. E. (1993). On the use of polynomial regression equations as an alternative to difference scores in organizational research. Academy of Management Journal, 36(6), 1577–1613. https://doi.org/10.2307/256822
- Humberg, S., Nestler, S., & Back, M. D. (2019). Response surface analysis in personality and social psychology: Checklist and clarifications for the case of congruence hypotheses. Social Psychological and Personality Science, 10(3), 409–419. https://doi.org/10.1177/1948550618757600
- Schönbrodt, F. D., Humberg, S., & Nestler, S. (2018). Testing similarity effects with dyadic response surface analysis. European Journal of Personality, 32(6), 627–641. https://doi.org/10.1002/per.2169 ● Otwarty dostęp
- Shanock, L. R., Baran, B. E., Gentry, W. A., Pattison, S. C., & Heggestad, E. D. (2010). Polynomial regression with response surface analysis: A powerful approach for examining moderation and overcoming limitations of difference scores. Journal of Business and Psychology, 25(4), 543–554. https://doi.org/10.1007/s10869-010-9183-4
Cytowania BibTeX
@article{barranti2017how, author={Barranti, Maxwell and Carlson, Erika N. and Côté, Stéphane}, title={{How to test questions about similarity in personality and social psychology research}}, journal={Social Psychological and Personality Science}, year={2017}, volume={8}, number={4}, pages={465--475}, doi={10.1177/1948550617698204}}@article{dalal2012some, author={Dalal, Dev K. and Zickar, Michael J.}, title={{Some common myths about centering predictor variables in moderated multiple regression and polynomial regression}}, journal={Organizational Research Methods}, year={2012}, volume={15}, number={3}, pages={339--362}, doi={10.1177/1094428111430540}}@article{edwards2001ten, author={Edwards, Jeffrey R.}, title={{Ten difference score myths}}, journal={Organizational Research Methods}, year={2001}, volume={4}, number={3}, pages={265--287}, doi={10.1177/109442810143005}}@article{edwards1993use, author={Edwards, Jeffrey R. and Parry, Mark E.}, title={{On the use of polynomial regression equations as an alternative to difference scores in organizational research}}, journal={Academy of Management Journal}, year={1993}, volume={36}, number={6}, pages={1577--1613}, doi={10.2307/256822}}@article{humberg2019response, author={Humberg, Sarah and Nestler, Steffen and Back, Mitja D.}, title={{Response surface analysis in personality and social psychology: Checklist and clarifications for the case of congruence hypotheses}}, journal={Social Psychological and Personality Science}, year={2019}, volume={10}, number={3}, pages={409--419}, doi={10.1177/1948550618757600}}@article{schonbrodt2018testing, author={Schönbrodt, Felix D. and Humberg, Sarah and Nestler, Steffen}, title={{Testing similarity effects with dyadic response surface analysis}}, journal={European Journal of Personality}, year={2018}, volume={32}, number={6}, pages={627--641}, doi={10.1002/per.2169}}@article{shanock2010polynomial, author={Shanock, Linda Rhoades and Baran, Benjamin E. and Gentry, William A. and Pattison, Stacy Clever and Heggestad, Eric D.}, title={{Polynomial regression with response surface analysis: A powerful approach for examining moderation and overcoming limitations of difference scores}}, journal={Journal of Business and Psychology}, year={2010}, volume={25}, number={4}, pages={543--554}, doi={10.1007/s10869-010-9183-4}}