Co to są wielomiany ułamkowe?
Wielomiany ułamkowe (ang. fractional polynomials, FP) to sposób modelowania nieliniowego wpływu ciągłego predyktora w regresji. Royston i Altman (1994) zaproponowali, by zamiast zwykłych potęg x, x² (zob. regresja krzywoliniowa) wybierać potęgi ze zbioru {−2, −1, −0.5, 0, 0.5, 1, 2, 3}, gdzie potęga 0 oznacza logarytm. Model FP1 ma jeden człon (np. log x albo 1/x), FP2 – dwa (np. x0.5 i x3; przy powtórzonej potędze drugi człon mnoży się przez log x). Kilka funkcji daje dużą elastyczność przy niewielu parametrach. Sauerbrei i Royston (1999) rozszerzyli podejście na wiele predyktorów (MFP) i porównali je z wyborem krokowym zmiennych skategoryzowanych.
Potęgi wybiera się sekwencją testów: najlepsze FP2 porównuje się z modelem bez x, z liniowym, a potem z najlepszym FP1. Metoda działa w regresji liniowej, logistycznej i modelu Coxa, a x musi być dodatnie (w razie potrzeby się je przesuwa).
Przykład
W symulowanych danych (n = 400, prawdziwa zależność logarytmiczna) najlepsze FP2 miało potęgi 0 i 3, ale nie było lepsze od FP1 (p = .798), za to wyraźnie lepsze od modelu liniowego (p < .001). Wybrano FP1 z potęgą 0, czyli log(x/10), ze współczynnikiem 3.025. AIC wyniosło 1117.8 wobec 1218.1 dla modelu kwadratowego i 1385.4 dla liniowego.
Na rysunku
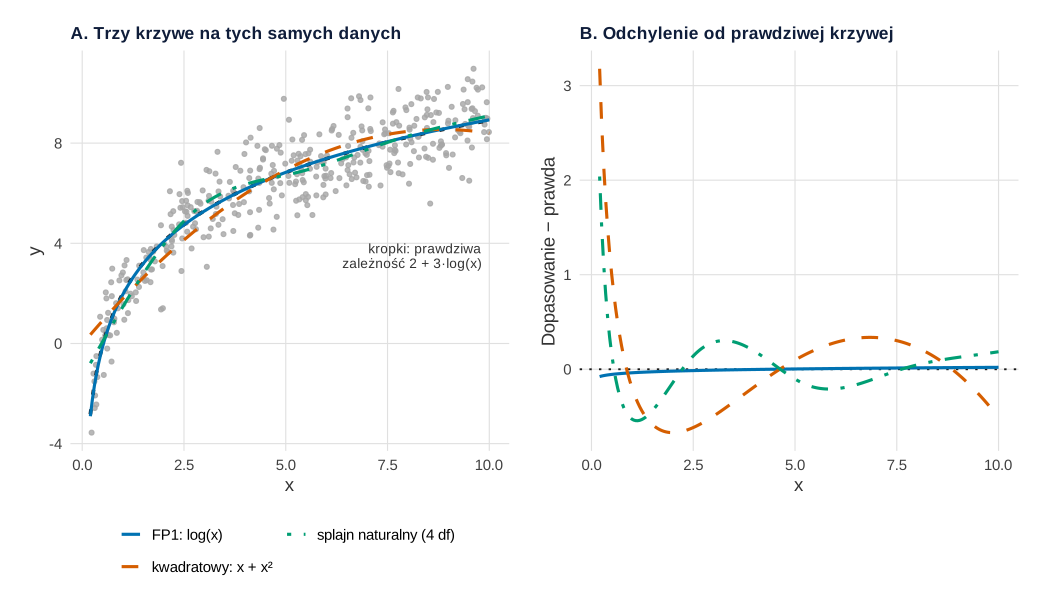
set.seed(693)).Co widać. To te same 400 obserwacji co w przykładzie niżej. W panelu A trzy krzywe wyglądają podobnie w środku zakresu, ale różnią się przy małych x, gdzie zależność jest najbardziej stroma. Panel B pokazuje to dokładniej. Wybrany przez procedurę FP1 (log x) odchyla się od prawdziwej krzywej najwyżej o 0.08. Wielomian kwadratowy nie umie jednocześnie oddać stromego początku i płaskiego końca: faluje wokół prawdy i przy x = 0.2 zawyża o 3.18. Splajn naturalny z tą samą liczbą stopni swobody co start procedury FP2 (4 df) radzi sobie lepiej (pierwiastek ze średniego kwadratu odchyleń 0.30 wobec 0.52), ale przy x = 0.2 też zawyża, o 2.04. Podobną kolejność daje AIC: 1117.8 dla FP1, 1138.3 dla splajnu i 1218.1 dla wielomianu kwadratowego.
Na co uważać. Porównanie sprzyja FP z założenia: dane wygenerowano z logarytmu, a logarytm jest jedną z potęg FP. Gdyby prawdziwa zależność miała np. lokalne wybrzuszenie, splajn mógłby wypaść lepiej. Panel B jest możliwy tylko w symulacji, bo w prawdziwych danych krzywej odniesienia nie znamy. Wykres nie pokazuje przedziałów ufności. Największe odchylenia przypadają na kraniec zakresu, gdzie zależność jest najbardziej stroma, więc wykres dopasowanej funkcji warto zawsze oglądać razem z danymi.
Podpis do pracy:
Kod losuje te same dane co przykład niżej z ziarnem set.seed(693), ustalonym raz. Liczbę stopni swobody splajnu (4) dobrano ręcznie tak, by równała się df startowego modelu FP2. Rysunek na stronie różni się od wyniku kodu tylko motywem serwisu.
Kod R rysunku 1
# Rysunek 1. Wielomian ułamkowy FP1 vs wielomian kwadratowy vs splajn naturalny dla zależności logarytmicznej (A)
# i odchylenie każdej dopasowanej krzywej od prawdziwej zależności (B)
library(ggplot2)
library(patchwork)
library(splines)
suppressPackageStartupMessages(library(mfp))

# Paleta Okabe–Ito i prosty motyw
kol <- c(fp = "#0072B2", kw = "#D55E00", ns = "#009E73")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

set.seed(693)                                       # te same dane co w przykładzie niżej
n <- 400
d <- data.frame(x = runif(n, 0.2, 10))
d$y <- 2 + 3 * log(d$x) + rnorm(n, sd = 1)
m_kw <- lm(y ~ x + I(x^2), d)
m_ns <- lm(y ~ ns(x, df = 4), d)                    # splajn naturalny, 4 df (wybrane ręcznie, jak start FP2)
m_fp <- mfp(y ~ fp(x, df = 4), data = d, family = gaussian)
round(c(AIC_kwadratowy = AIC(m_kw), AIC_splajn_df4 = AIC(m_ns), AIC_FP1 = AIC(m_fp)), 1)

siatka <- data.frame(x = seq(0.2, 10, length.out = 200))
prawda <- 2 + 3 * log(siatka$x)
przew <- cbind(FP1 = predict(m_fp, newdata = siatka), kwadratowy = predict(m_kw, siatka),
               splajn = predict(m_ns, siatka))
odch <- przew - prawda                              # dopasowanie minus prawdziwa krzywa
round(rbind(RMSE_wzgl_prawdy = sqrt(colMeans(odch^2)), max_odchylenie = apply(abs(odch), 2, max),
            odchylenie_przy_x_0.2 = odch[1, ]), 2)

nazwy <- c("FP1: log(x)", "kwadratowy: x + x²", "splajn naturalny (4 df)")
dl <- data.frame(x = rep(siatka$x, 3), fit = c(przew), odch = c(odch),
                 model = factor(rep(nazwy, each = 200), levels = nazwy))
pA <- ggplot(d, aes(x, y)) +
  geom_point(size = 1.3, colour = "grey65", alpha = 0.8) +
  geom_line(data = data.frame(x = siatka$x, y = prawda), colour = "grey10", linetype = "dotted", linewidth = 1.3) +
  geom_line(data = dl, aes(x, fit, colour = model, linetype = model), linewidth = 1.1) +
  annotate("text", x = 9.8, y = 3.5, hjust = 1, size = 3.6, colour = "grey20", label = "kropki: prawdziwa\nzależność 2 + 3·log(x)", lineheight = 0.9) +
  scale_colour_manual(values = unname(kol), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "dotdash"), name = NULL) +
  labs(title = "A. Trzy krzywe na tych samych danych", x = "x", y = "y") + motyw +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2))

pB <- ggplot(dl, aes(x, odch, colour = model, linetype = model)) +
  geom_hline(yintercept = 0, colour = "grey10", linetype = "dotted") +
  geom_line(linewidth = 1.1) +
  scale_colour_manual(values = unname(kol), guide = "none") +
  scale_linetype_manual(values = c("solid", "dashed", "dotdash"), guide = "none") +
  labs(title = "B. Odchylenie od prawdziwej krzywej", x = "x", y = "Dopasowanie − prawda") + motyw

p1 <- pA + pB + plot_layout(widths = c(1, 1))
p1
Wynik w R
AIC_kwadratowy AIC_splajn_df4        AIC_FP1
        1218.1         1138.3         1117.8
                        FP1 kwadratowy splajn
RMSE_wzgl_prawdy       0.02       0.52   0.30
max_odchylenie         0.08       3.18   2.04
odchylenie_przy_x_0.2 -0.08       3.18   2.04
Jak opisać w pracy
Na co uważać
- Nie zamieniaj krzywej na kategorie. FP to alternatywa dla dychotomizacji, która traci informację.
- Końce zakresu. Potęgi ujemne i sześcienne bywają niestabilne przy skrajnych x; pokaż wykres dopasowanej funkcji.
- Wybór oparty na danych zawyża dopasowanie i grozi przeuczeniem; przy złożonych kształtach rozważ splajny (zob. splajny i GAM).
Wielomiany ułamkowe w R
Kod dopasowuje model liniowy, kwadratowy i wielomian ułamkowy wybrany funkcją mfp::mfp(), pokazuje sekwencję testów i porównuje AIC. Liczby w tekście pochodzą z tego kodu.
Wybór potęg FP i porównanie z modelem liniowym i kwadratowym
R
set.seed(693)                                       # dane symulowane: n = 400, prawdziwa zależność y = 2 + 3·log(x)
suppressPackageStartupMessages(library(mfp))
n <- 400
d <- data.frame(x = runif(n, 0.2, 10))
d$y <- 2 + 3 * log(d$x) + rnorm(n, sd = 1)
m_lin <- lm(y ~ x, d)
m_kw  <- lm(y ~ x + I(x^2), d)
m_fp  <- mfp(y ~ fp(x, df = 4), data = d, family = gaussian)  # start od FP2, potęgi z {-2, -1, -0.5, 0, 0.5, 1, 2, 3}
signif(m_fp$pvalues, 3)          # sekwencja testów: FP2 vs brak x, vs liniowy, vs FP1 (najlepsze FP2: potęgi 0 i 3)
m_fp$fptable                     # wybrany model końcowy (potęga 0 = logarytm)
m_fp$trafo                       # x przeskalowane przez 10
round(coef(m_fp), 3)
round(c(AIC_liniowy = AIC(m_lin), AIC_kwadratowy = AIC(m_kw), AIC_FP1 = AIC(m_fp)), 1)
Wynik w R
     p.null    p.lin  p.FP power2 power4.1 power4.2
x 4.31e-300 6.12e-42 0.798      0        0        3
  df.initial select alpha df.final power1 power2
x          4      1  0.05        2      0      .
      formula
x log((x/10))
Intercept       x.1
    8.928     3.025
   AIC_liniowy AIC_kwadratowy        AIC_FP1
        1385.4         1218.1         1117.8
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet mfp 1.5.5.1). Splajn naturalny w rysunku 1 dopasowano funkcją ns() z pakietu splines (część R). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- mfp (wersja 1.5.5.1): Ambler, G., & Benner, A. (2025). mfp: Multivariable fractional polynomials (R package version 1.5.5.1) [Computer software]. https://doi.org/10.32614/CRAN.package.mfp
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym różnią się wielomiany ułamkowe od zwykłego wielomianu?
Zwykły wielomian używa potęg 1, 2, 3 i często źle zachowuje się na końcach zakresu. Wielomiany ułamkowe dopuszczają także potęgi ujemne, pierwiastek i logarytm, więc jedna lub dwie funkcje opisują wiele typowych kształtów.
Co zrobić, gdy predyktor ma wartości zerowe lub ujemne?
Przed transformacją przesuwa się go o stałą, tak aby wszystkie wartości były dodatnie. Pakiet mfp robi to automatycznie i podaje przesunięcie oraz skalę w opisie transformacji.
Wielomiany ułamkowe czy splajny?
Wielomiany ułamkowe dają jedną wygładzoną funkcję łatwą do zapisania wzorem. Splajny lepiej oddają lokalne zmiany kształtu. Przy prostych zależnościach FP są zwykle wystarczające i łatwiejsze do raportowania.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza powierzchni odpowiedzi (RSA)
Regresja wielomianowa zamiast wyniku różnicowego: parametry a1–a4, główna oś, warunki hipotezy zgodności i przykład dopasowania osoba–praca w R.
Czytaj →PoradnikNieliniowe zależności: splajny i GAM
Podział na grupy, parabola, splajn i GAM na jednym zbiorze: edf, REML, wybór k, diagnostyka, wykres krzywej i wzór opisu w R.
Czytaj →PoradnikDychotomizacja zmiennych ciągłych
Ile mocy kosztuje podział zależnie od punktu cięcia, dlaczego dwa podziały dają pozorne efekty i interakcje, kiedy próg kliniczny ma sens i co analizować zamiast grup – z symulacjami w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Royston, P., & Altman, D. G. (1994). Regression using fractional polynomials of continuous covariates: Parsimonious parametric modelling. Applied Statistics, 43(3), 429–467. https://doi.org/10.2307/2986270
- Sauerbrei, W., & Royston, P. (1999). Building multivariable prognostic and diagnostic models: Transformation of the predictors by using fractional polynomials. Journal of the Royal Statistical Society: Series A (Statistics in Society), 162(1), 71–94. https://doi.org/10.1111/1467-985x.00122
Cytowania BibTeX
@article{royston1994regression, author={Royston, Patrick and Altman, Douglas G.}, title={{Regression using fractional polynomials of continuous covariates: Parsimonious parametric modelling}}, journal={Applied Statistics}, year={1994}, volume={43}, number={3}, pages={429--467}, doi={10.2307/2986270}}@article{sauerbrei1999building, author={Sauerbrei, Willi and Royston, Patrick}, title={{Building multivariable prognostic and diagnostic models: Transformation of the predictors by using fractional polynomials}}, journal={Journal of the Royal Statistical Society: Series A (Statistics in Society)}, year={1999}, volume={162}, number={1}, pages={71--94}, doi={10.1111/1467-985x.00122}}