Dane z par: dlaczego zwykła regresja nie wystarczy
Badasz małżeństwa, pary matka–dziecko, współpracowników albo terapeutę i pacjenta. Od obu osób masz te same pomiary. Takie dane nazywamy diadycznymi. Wyniki dwóch osób z jednej pary prawie nigdy nie są niezależne. Kenny (1996) opisał trzy źródła tej zależności: zmienna jednej osoby wpływa na wynik partnera, wyniki partnerów wpływają na siebie nawzajem albo oba wyniki odzwierciedlają wspólny czynnik pary, np. warunki życia.
Definicję modelu i jego podstawową postać znajdziesz w haśle model APIM (aktor–partner). Ten wpis prowadzi przez całą analizę po kolei: przygotowanie danych, ocenę zależności, wybór między parami rozróżnialnymi a nierozróżnialnymi, dwa sposoby estymacji, interpretację parametru k i opis w artykule. Analiza danych diadycznych ma własny podręcznik (Kenny i in., 2006), a model APIM w obecnej postaci przedstawili Cook i Kenny (2005).
Przykład. 200 par kobieta–mężczyzna (dane symulowane, set.seed(3341)). Każda osoba oceniła stres w pracy (1–5) i satysfakcję ze związku (1–7). Pytanie brzmi: czy mój stres obniża moją satysfakcję (efekt aktora) i satysfakcję partnera (efekt partnera)? Dane możesz pobrać jako plik CSV (200 wierszy, jedna para na wiersz).
Krok 1. Trzy formaty danych par
Te same dane zapisuje się na trzy sposoby. Różnią się tym, co jest wierszem i czy w wierszu są zmienne partnera. Ogólne zasady przekształcania opisuje hasło format długi i szeroki danych.
| Format | Wiersz | Kolumny w przykładzie | Do czego |
|---|---|---|---|
| Diadyczny (szeroki) | para | para, stres_k, stres_m, sat_k, sat_m | SEM (lavaan), korelacje między partnerami |
| Indywidualny (długi) | osoba | para, plec, stres, sat | opis próby, rzadko analiza |
| „Pairwise” (par) | osoba | para, plec, stres, sat, stres_p, sat_p | APIM w gls lub modelu wielopoziomowym, ICC |
W formacie „pairwise” każda para zajmuje dwa wiersze. W wierszu kobiety jej stres jest predyktorem aktora, a stres mężczyzny predyktorem partnera. W wierszu mężczyzny role się odwracają. Przepis 1 w sekcji z kodem tworzy oba formaty z danych szerokich przez scalenie danych osoby z danymi partnera. Sprawdź po scaleniu, czy każda para ma dokładnie dwa wiersze i czy stres_p w wierszu jednej osoby równa się stres w wierszu drugiej.
Krok 2. Pary rozróżnialne czy nierozróżnialne
Pary są rozróżnialne, gdy jakaś zmienna w sensowny sposób odróżnia osoby w każdej parze: kobieta i mężczyzna, matka i dziecko, przełożony i podwładny. Są nierozróżnialne (wymienne), gdy takiej zmiennej nie ma, np. w parach przyjaciółek albo bliźniąt jednopłciowych. Od tej decyzji zależy, ile parametrów szacujesz: przy parach rozróżnialnych każda rola może mieć własną średnią, wariancję oraz efekty aktora i partnera.
Rozróżnialność koncepcyjna to dopiero hipoteza. To, że partnerzy mają różną płeć, nie znaczy jeszcze, że ich parametry się różnią. Sprawdź to testem (krok 5). Przy okazji ustal typ każdej zmiennej:
- między parami – ta sama wartość u obu osób, np. długość związku, liczba dzieci;
- wewnątrz par – suma w parze jest stała, różnią się osoby, np. płeć w parach różnej płci;
- mieszana – zmienia się i między parami, i wewnątrz nich, np. stres.
Garcia i in. (2015) pokazują, że od typu zmiennej zależy, jakie efekty moderacji w APIM w ogóle da się oszacować. Typ zmiennej decyduje też o skutkach pseudoreplikacji, co widać na rysunku 1.
Krok 3. Zależność w parze i ICC
Przed modelem opisz, jak silnie wyniki partnerów są powiązane. Przy parach rozróżnialnych wystarczy zwykła korelacja Pearsona między wynikiem kobiety i mężczyzny. Gonzalez i Griffin (1999) omawiają korelacje dla takich par i rozdzielenie ich na składnik pary i składnik osoby. W przykładzie satysfakcja partnerów korelowała na poziomie r = .44, 95% CI [.32, .54], p < .001, a stres na poziomie r = .30.
Przy parach nierozróżnialnych nie wiadomo, kogo wpisać jako „pierwszego”, więc zwykła korelacja zależy od przypadkowego uporządkowania. Rozwiązaniem jest korelacja na danych w podwójnym zapisie (pairwise): każda para występuje dwa razy, w obu kolejnościach. Olsen i Kenny (2006) używają tego zapisu także w SEM dla par wymiennych. Taka korelacja jest korelacją wewnątrzklasową (ICC). W przykładzie wyniosła .428, dokładnie tyle co korelacja reszt w pustym modelu gls z corCompSymm.
W parach ICC może być ujemne. Tak bywa przy kompensacji: gdy jedna osoba przejmuje więcej obowiązków, druga ma ich mniej. W drugim symulowanym zbiorze, z godzinami opieki nad dzieckiem, ICC wyniosło −.425. Model gls odtworzył tę wartość. Model wielopoziomowy z losowym wyrazem wolnym pary (lmer) oszacował wariancję pary na 0 i zgłosił singular fit, bo wariancja nie może być ujemna. Jeśli trafisz na taki komunikat, przeczytaj wpis o tym, co robić, gdy model mieszany się nie zbiega. W danych diadycznych najprostszym wyjściem jest właśnie gls.
Dlaczego to ważne? Zwykła regresja na 400 osobach traktuje je jak niezależne obserwacje. Rysunek 1 pokazuje skutek w symulacji ze 100 parami, w której prawdziwe efekty wynosiły zero.
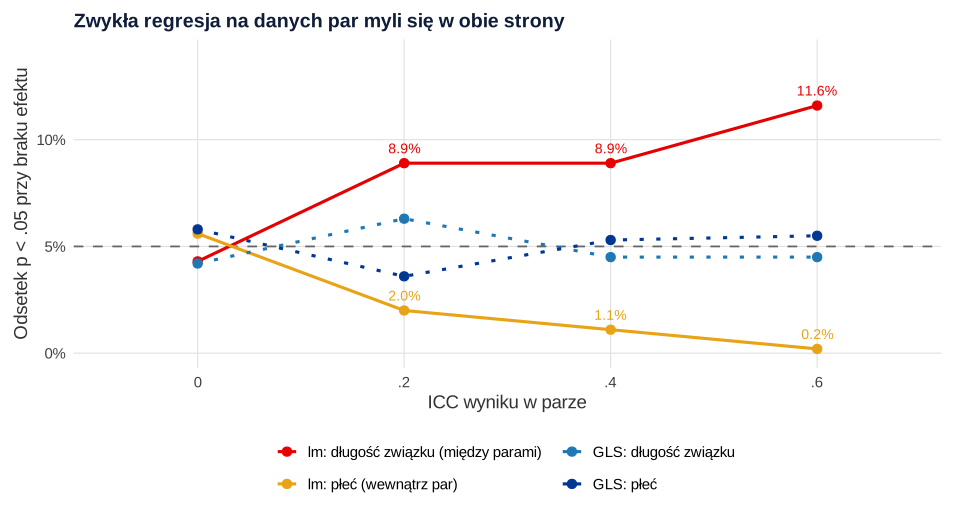
lm, kropkowane: gls z korelacją reszt w parze. Obliczenia: R, pakiet nlme (dane symulowane).Przy ICC = .6 zwykła regresja dawała istotny wynik dla długości związku w 11.6% zbiorów zamiast 5%. Dla płci, czyli zmiennej wewnątrz par, błąd idzie w drugą stronę: tylko 0.2% wyników istotnych. Test traci wtedy moc. GLS z korelacją w parze utrzymał odsetki między 3.6% a 6.3% (błąd Monte Carlo przy 5% to około 0.7 punktu procentowego). Ta sama logika stoi za błędami standardowymi w danych klastrowanych.
Krok 4–5. APIM w nlme::gls
Predyktory wycentruj na średniej wszystkich osób (centrowanie zmiennych). Wyraz wolny oznacza wtedy satysfakcję osoby o przeciętnym stresie, której partner też ma przeciętny stres. Model dopasowujemy metodą uogólnionych najmniejszych kwadratów (GLS) z korelacją reszt w parze. Zaczynamy od wersji nierozróżnialnej, potem rozdzielamy role.
| Efekt | Model nierozróżnialny b (SE) | Kobiety b (SE) | Mężczyźni b (SE) |
|---|---|---|---|
| Aktor: własny stres | −0.42 (0.05) | −0.64 (0.08) | −0.21 (0.08) |
| Partner: stres partnera | −0.21 (0.05) | −0.23 (0.08) | −0.20 (0.08) |
| Korelacja reszt w parze | – | .35 | |
| k = partner / aktor | 0.50 | 0.36 | 0.94 |
Model rozróżnialny ma postać „dwóch wyrazów wolnych”: sat ~ 0 + plec + plec:aktor + plec:partner, z osobną wariancją reszt dla każdej roli (varIdent). Przy dwóch osobach w parze corCompSymm razem z varIdent daje pełną macierz 2 × 2 reszt, czyli nie narzuca żadnych ograniczeń. Ten zapis od razu podaje efekty dla każdej roli.
Czy różnice między rolami są istotne? Odpowiadają na to dwa testy. Model interakcyjny z płcią zakodowaną jako ±0.5 (kodowanie efektów) testuje każdą różnicę osobno. Efekt aktora był u kobiet silniejszy o 0.43, t(394) = −3.70, p < .001. Efekt partnera nie różnił się między rolami, p = .777. Test omnibus rozróżnialności porównuje testem ilorazu wiarygodności model nierozróżnialny z rozróżnialnym, oba dopasowane metodą ML, bo modele różnią się efektami stałymi. Cztery dodatkowe parametry to średnia, wariancja oraz efekty aktora i partnera. Wynik χ²(4) = 24.86, p < .001 oznacza, że wspólny model nie pasuje. Gdyby test wyszedł nieistotny, model nierozróżnialny byłby lepszym wyborem: jest prostszy i ma większą moc.
Wspólny efekt aktora (−0.42) uśrednia dwie różne wartości, −0.64 i −0.21. Wniosek „stres obniża satysfakcję w podobnym stopniu u obojga partnerów” byłby tu błędny. Ten sam model nierozróżnialny możesz dopasować jako model wielopoziomowy z losowym wyrazem wolnym pary (lme). W przykładzie oba dały identyczne współczynniki, bo ICC jest dodatnie. Szerzej o takich modelach piszemy we wpisie model wielopoziomowy krok po kroku.
Krok 6. APIM w lavaan
W SEM APIM to model ścieżkowy na danych szerokich: dwie regresje, korelacja predyktorów i korelacja reszt. Pakiet lavaan (Rosseel, 2012) pozwala nazwać parametry etykietami, zdefiniować z nich nowe wielkości (np. k albo różnicę efektów aktora) i policzyć dla nich bootstrapowe przedziały. Składnię lavaan krok po kroku opisuje wpis o analizie ścieżek w lavaan.
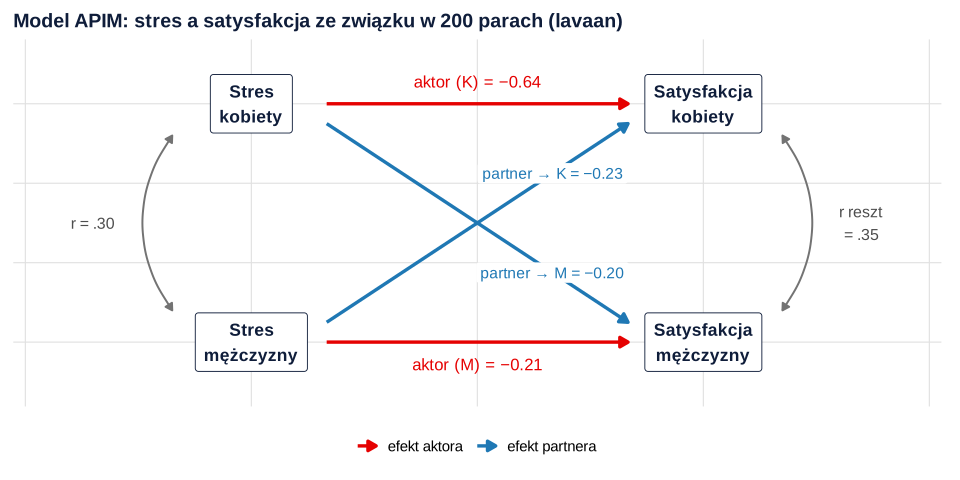
Oszacowania są takie same jak w gls z varIdent: efekty aktora −0.64 i −0.21, efekty partnera −0.23 i −0.20. Różnica efektów aktora wyniosła −0.43, 95% CI [−0.68, −0.18] (bootstrap percentylowy, 2000 prób). Model z równymi efektami aktora i partnera u obojga partnerów pasował wyraźnie gorzej, χ²(2) = 22.44, p < .001, RMSEA = .226. Ten test ma 2 stopnie swobody, a nie 4 jak w gls, bo porównuje tylko ścieżki. Pełny test nierozróżnialności w SEM obejmuje też równość średnich i wariancji obu ról. Ogólną strategię estymacji i porównywania takich modeli dla par wymiennych opisują Olsen i Kenny (2006).
Model nasycony ma 0 stopni swobody, więc nie raportuj dla niego wskaźników dopasowania. Mają one sens dopiero dla modeli z ograniczeniami.
Krok 7. Parametr k i wzorzec pary
Kenny i Ledermann (2010) proponują opisywać wzorzec APIM ilorazem k = efekt partnera / efekt aktora. Wartość bliska 1 oznacza wzorzec pary (liczy się suma stresu w parze), bliska 0 – wzorzec „tylko aktor”, bliska −1 – kontrast. Ponieważ k jest ilorazem, jego rozkład z próby bywa skośny, a przedział warto policzyć bootstrapem.
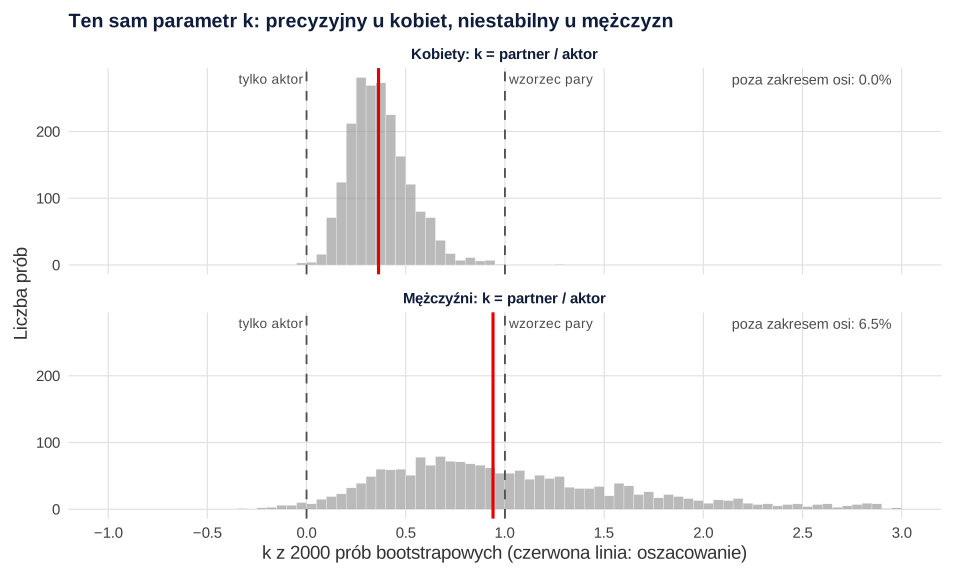
U kobiet k = 0.36, 95% CI [0.13, 0.70]. Przedział wyklucza zarówno 0, jak i 1: stres partnera ma znaczenie, ale mniejsze niż własny. U mężczyzn k = 0.94, co kusi, by mówić o wzorcu pary. Przedział [0.07, 4.92] pokazuje jednak, że dane prawie niczego nie rozstrzygają. Efekt aktora u mężczyzn jest mały, więc w 8.4% prób bootstrapowych był słabszy niż −0.1, a k przekraczało 2 w 13.5% prób. lavaan ostrzega wtedy o dużym rozrzucie bootstrapowego rozkładu. Nie interpretuj k, gdy efekt aktora jest bliski zera. Opisz wtedy oba efekty osobno.
Mediacja, moderacja i dane podłużne
APIM jest punktem wyjścia do bardziej złożonych modeli. Ledermann i in. (2011) pokazują mediację w rozszerzonym APIM, w którym efekty pośrednie mogą prowadzić przez mediator własny albo partnera. Przy parach rozróżnialnych model szybko się rozrasta, więc autorzy upraszczają go, zakładając określone wzorce diadyczne, a efekty pośrednie testują z przedziałami bootstrapowymi. Garcia i in. (2015) opisują moderację efektów aktora i partnera. Moderator może zmieniać się między parami, wewnątrz par albo w obu tych wymiarach. Zależnie od tego i od rozróżnialności par możliwych efektów moderacji jest do ośmiu, więc hipotezy o moderacji zapisz przed analizą. Cook i Kenny (2005) ujmują APIM także jako ogólny podłużny model dwukierunkowych wpływów w relacji. W takim schemacie podłużnym wynik osoby w drugim pomiarze przewiduje się z wcześniejszych wyników obu partnerów.
Jak opisać analizę w artykule
W metodach podaj: liczbę par, to, czy traktujesz je jako rozróżnialne i na jakiej podstawie (test omnibus), sposób centrowania, metodę estymacji, strukturę reszt oraz metodę przedziałów dla k. W wynikach podaj zależność w parze (r lub ICC), efekty aktora i partnera z SE lub CI dla każdej roli oraz k tylko wtedy, gdy efekt aktora jest wyraźny.
Jeśli recenzent pyta o rozróżnialność, zależność w parach albo sposób liczenia k, możemy wspólnie sprawdzić analizę w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Cztery przepisy uruchamiane po kolei w jednej sesji R. Pierwszy tworzy plik dane-diadyczne-pary.csv (możesz go pobrać tutaj). Potrzebne pakiety: nlme, lme4, MASS i lavaan.
1. Dane, trzy formaty i zależność w parze
R
# Dane symulowane: 200 par różnej płci; u każdej osoby stres w pracy (1–5) i satysfakcja ze związku (1–7).
# Prawdziwe efekty: aktor −0.45 (kobiety) i −0.35 (mężczyźni), partner −0.20 i −0.10, korelacja reszt w parze .35.
suppressPackageStartupMessages({library(nlme); library(lme4)})
set.seed(3341)
n <- 200
stres <- MASS::mvrnorm(n, c(3.0, 2.9), matrix(c(0.64, 0.19, 0.19, 0.64), 2))       # r = .30 w parze
reszty <- MASS::mvrnorm(n, c(0, 0), matrix(c(1, 0.35, 0.35, 1), 2) * 0.8)
sat_k <- 5.3 - 0.45 * (stres[, 1] - 3) - 0.20 * (stres[, 2] - 3) + reszty[, 1]
sat_m <- 5.5 - 0.35 * (stres[, 2] - 3) - 0.10 * (stres[, 1] - 3) + reszty[, 2]
ogr <- function(x, a, b) round(pmin(pmax(x, a), b), 2)
szer <- data.frame(para = 1:n, stres_k = ogr(stres[, 1], 1, 5), stres_m = ogr(stres[, 2], 1, 5),
                   sat_k = ogr(sat_k, 1, 7), sat_m = ogr(sat_m, 1, 7))
write.csv(szer, "dane-diadyczne-pary.csv", row.names = FALSE)

# Format 1 – diadyczny (szeroki): jeden wiersz na parę
head(szer, 3)

# Format 2 – indywidualny (długi): jeden wiersz na osobę, bez zmiennych partnera
dl <- rbind(data.frame(para = szer$para, plec = "K", stres = szer$stres_k, sat = szer$sat_k),
            data.frame(para = szer$para, plec = "M", stres = szer$stres_m, sat = szer$sat_m))
dl <- dl[order(dl$para, dl$plec), ]

# Format 3 – „pairwise” (par): długi + zmienne partnera w tym samym wierszu
partner <- dl[, c("para", "plec", "stres", "sat")]
partner$plec <- ifelse(partner$plec == "K", "M", "K")
names(partner)[3:4] <- c("stres_p", "sat_p")
pw <- merge(dl, partner, by = c("para", "plec"))
pw <- pw[order(pw$para, pw$plec), ]; rownames(pw) <- NULL
head(pw, 4)

# Niezależność w parze. Pary rozróżnialne: zwykła korelacja Pearsona wyników kobiety i mężczyzny
round(c(r_stres = cor(szer$stres_k, szer$stres_m), r_sat = cor(szer$sat_k, szer$sat_m)), 3)
ct <- cor.test(szer$sat_k, szer$sat_m)
round(c(r = unname(ct$estimate), dolny = ct$conf.int[1], gorny = ct$conf.int[2], p = ct$p.value), 3)

# Pary traktowane jako nierozróżnialne: korelacja „pairwise” (podwójny zapis obu osób) = ICC
icc_pw <- function(a, b) cor(c(a, b), c(b, a))
m0 <- gls(sat ~ 1, data = pw, correlation = corCompSymm(form = ~ 1 | para), method = "ML")
round(c(ICC_pairwise = icc_pw(szer$sat_k, szer$sat_m),
        rho_gls = coef(m0$modelStruct$corStruct, unconstrained = FALSE)), 3)

# Ujemna zależność (kompensacja): godziny opieki nad dzieckiem w tygodniu u obojga partnerów
opieka <- MASS::mvrnorm(n, c(14, 14), matrix(c(16, -6, -6, 16), 2))
op <- data.frame(para = rep(1:n, each = 2), godz = as.vector(t(opieka)))
round(c(ICC_pairwise = icc_pw(opieka[, 1], opieka[, 2])), 3)
m_cs <- gls(godz ~ 1, data = op, correlation = corCompSymm(form = ~ 1 | para), method = "ML")
round(coef(m_cs$modelStruct$corStruct, unconstrained = FALSE), 3)
m_ri <- lmer(godz ~ 1 + (1 | para), data = op)
print(VarCorr(m_ri), comp = "Variance")
isSingular(m_ri)
Wynik w R
  para stres_k stres_m sat_k sat_m
1    1    3.03    2.64  6.09  5.35
2    2    2.45    2.11  5.95  6.10
3    3    4.04    3.59  4.85  5.39
  para plec stres  sat stres_p sat_p
1    1    K  3.03 6.09    2.64  5.35
2    1    M  2.64 5.35    3.03  6.09
3    2    K  2.45 5.95    2.11  6.10
4    2    M  2.11 6.10    2.45  5.95
r_stres   r_sat
  0.299   0.439
    r dolny gorny     p
0.439 0.320 0.544 0.000
ICC_pairwise  rho_gls.Rho
       0.428        0.428
ICC_pairwise
      -0.425
   Rho
-0.425
boundary (singular) fit: see help('isSingular')
 Groups   Name        Variance
 para     (Intercept)  0.000
 Residual             18.406
[1] TRUE
2. APIM w gls: model nierozróżnialny, rozróżnialny i test rozróżnialności
R
# APIM w nlme::gls na danych „pairwise” (wymaga obiektu pw z przepisu 1)
suppressPackageStartupMessages(library(nlme))
sr <- mean(pw$stres)                                 # centrowanie na średniej wszystkich osób
pw$aktor <- pw$stres - sr; pw$partner <- pw$stres_p - sr
pw$plec <- factor(pw$plec)

# 1. Pary nierozróżnialne: wspólne efekty aktora i partnera, jedna wariancja, korelacja reszt w parze
m_nr <- gls(sat ~ aktor + partner, data = pw, correlation = corCompSymm(form = ~ 1 | para), method = "REML")
round(summary(m_nr)$tTable, 3)
round(intervals(m_nr, which = "coef")$coef, 3)

# 2. Pary rozróżnialne, model dwóch wyrazów wolnych: osobne efekty dla kobiet i mężczyzn
#    oraz osobne wariancje reszt (varIdent) – to pełna macierz 2 × 2 reszt w parze
m_r <- gls(sat ~ 0 + plec + plec:aktor + plec:partner, data = pw,
           correlation = corCompSymm(form = ~ 1 | para), weights = varIdent(form = ~ 1 | plec), method = "REML")
round(summary(m_r)$tTable, 3)
round(c(rho_reszt = coef(m_r$modelStruct$corStruct, unconstrained = FALSE),
        SD_reszt_K = sigma(m_r) * coef(m_r$modelStruct$varStruct, unconstrained = FALSE, allCoef = TRUE)[["K"]],
        SD_reszt_M = sigma(m_r) * coef(m_r$modelStruct$varStruct, unconstrained = FALSE, allCoef = TRUE)[["M"]]), 3)
b <- coef(m_r)
round(c(k_K = unname(b["plecK:partner"] / b["plecK:aktor"]), k_M = unname(b["plecM:partner"] / b["plecM:aktor"]),
        k_wspolne = unname(coef(m_nr)["partner"] / coef(m_nr)["aktor"])), 3)

# 3. Model interakcyjny: czy efekty aktora i partnera różnią się między kobietami a mężczyznami?
pw$plec_c <- ifelse(pw$plec == "K", 0.5, -0.5)      # kodowanie efektowe: K = 0.5, M = −0.5
m_int <- gls(sat ~ (aktor + partner) * plec_c, data = pw,
             correlation = corCompSymm(form = ~ 1 | para), weights = varIdent(form = ~ 1 | plec), method = "REML")
round(summary(m_int)$tTable, 3)

# 4. Test rozróżnialności (omnibus): 4 parametry więcej – średnia, wariancja, efekt aktora i partnera
nierozrozn_ML <- update(m_nr, method = "ML"); rozrozn_ML <- update(m_r, method = "ML")
anova(nierozrozn_ML, rozrozn_ML)

# 5. Ten sam model nierozróżnialny jako model wielopoziomowy z losowym wyrazem wolnym pary (działa, gdy ICC > 0)
m_lme <- lme(sat ~ aktor + partner, random = ~ 1 | para, data = pw, method = "REML")
round(rbind(gls = coef(m_nr), lme = fixef(m_lme)), 4)
Wynik w R
             Value Std.Error t-value p-value
(Intercept)  5.402     0.049 110.788       0
aktor       -0.423     0.053  -7.946       0
partner     -0.213     0.053  -4.010       0
             lower   est.  upper
(Intercept)  5.306  5.402  5.498
aktor       -0.528 -0.423 -0.318
partner     -0.318 -0.213 -0.109
attr(,"label")
[1] "Coefficients:"
               Value Std.Error t-value p-value
plecK          5.358     0.059  91.140   0.000
plecM          5.465     0.060  91.775   0.000
plecK:aktor   -0.640     0.079  -8.133   0.000
plecM:aktor   -0.212     0.077  -2.763   0.006
plecK:partner -0.232     0.076  -3.063   0.002
plecM:partner -0.199     0.080  -2.502   0.013
rho_reszt.Rho    SD_reszt_K    SD_reszt_M
        0.354         0.827         0.838
      k_K       k_M k_wspolne
    0.363     0.940     0.505
                Value Std.Error t-value p-value
(Intercept)     5.411     0.049 111.167   0.000
aktor          -0.426     0.052  -8.196   0.000
partner        -0.216     0.052  -4.150   0.000
plec_c         -0.107     0.067  -1.596   0.111
aktor:plec_c   -0.428     0.116  -3.700   0.000
partner:plec_c -0.033     0.116  -0.283   0.777
              Model df      AIC      BIC    logLik   Test  L.Ratio p-value
nierozrozn_ML     1  5 990.5901 1010.547 -490.2951
rozrozn_ML        2  9 973.7309 1009.654 -477.8654 1 vs 2 24.85923   1e-04
    (Intercept)   aktor partner
gls      5.4019 -0.4229 -0.2134
lme      5.4019 -0.4229 -0.2134
3. APIM w lavaan z bootstrapem i parametrem k
R
# APIM w lavaan na danych diadycznych (szerokich), wymaga obiektu szer z przepisu 1
suppressPackageStartupMessages(library(lavaan))
d <- szer
sr <- mean(c(d$stres_k, d$stres_m))
d$stres_k <- d$stres_k - sr; d$stres_m <- d$stres_m - sr

apim <- '
  sat_k ~ a_k * stres_k + p_k * stres_m     # aktor i partner dla kobiet
  sat_m ~ a_m * stres_m + p_m * stres_k     # aktor i partner dla mężczyzn
  sat_k ~~ sat_m                            # korelacja reszt w parze
  stres_k ~~ stres_m
  k_K := p_k / a_k
  k_M := p_m / a_m
  roznica_aktor := a_k - a_m
'
set.seed(3343)
fit <- sem(apim, data = d, se = "bootstrap", bootstrap = 2000)
pe <- parameterEstimates(fit, boot.ci.type = "perc")
print(pe[pe$label != "" | pe$op == "~~" & pe$lhs == "sat_k" & pe$rhs == "sat_m",
         c("lhs", "op", "rhs", "label", "est", "se", "ci.lower", "ci.upper")], digits = 3, row.names = FALSE)
round(inspect(fit, "rsquare"), 3)
bt <- lavInspect(fit, "boot")                       # 2000 bootstrapowych zestawów parametrów
k_boot <- data.frame(k_K = bt[, "p_k"] / bt[, "a_k"], k_M = bt[, "p_m"] / bt[, "a_m"])
round(c(odsetek_a_m_powyzej_minus_0.1 = mean(bt[, "a_m"] > -0.1),
        odsetek_k_M_powyzej_2 = mean(k_boot$k_M > 2)), 3)
write.csv(round(k_boot, 4), "b334-k-bootstrap.csv", row.names = FALSE)

# Te same efekty aktora i partnera u obojga partnerów: test ilorazu wiarygodności (2 df)
apim_rowne <- '
  sat_k ~ a * stres_k + p * stres_m
  sat_m ~ a * stres_m + p * stres_k
  sat_k ~~ sat_m
  stres_k ~~ stres_m
  k := p / a
'
fit_r <- sem(apim_rowne, data = d)
lavTestLRT(fit_r, fit)
round(fitMeasures(fit_r, c("chisq", "df", "pvalue", "cfi", "rmsea", "srmr")), 3)
Wynik w R
Warning: lavaan->lav_model_vcov_se():
   The following bootstrapped defined parameters have a high (>5) ratio of
   standard deviation to median absolute deviation: k_M. P-values and
   confidence intervals may not match.
           lhs op     rhs         label    est    se ci.lower ci.upper
         sat_k  ~ stres_k           a_k -0.640 0.085   -0.810   -0.477
         sat_k  ~ stres_m           p_k -0.232 0.074   -0.378   -0.090
         sat_m  ~ stres_m           a_m -0.212 0.082   -0.370   -0.049
         sat_m  ~ stres_k           p_m -0.199 0.086   -0.368   -0.027
         sat_k ~~   sat_m                0.241 0.043    0.155    0.324
           k_K := p_k/a_k           k_K  0.363 0.151    0.127    0.701
           k_M := p_m/a_m           k_M  0.940 6.555    0.073    4.923
 roznica_aktor := a_k-a_m roznica_aktor -0.428 0.129   -0.682   -0.178
sat_k sat_m
0.335 0.091
odsetek_a_m_powyzej_minus_0.1         odsetek_k_M_powyzej_2
                        0.084                         0.135

Chi-Squared Difference Test

      Df    AIC    BIC  Chisq Chisq diff   RMSEA Df diff Pr(>Chisq)
fit    0 1907.1 1940.1  0.000
fit_r  2 1925.6 1952.0 22.439     22.439 0.22605       2  1.341e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
 chisq     df pvalue    cfi  rmsea   srmr
22.439  2.000  0.000  0.854  0.226  0.114
4. Symulacja: zwykła regresja a GLS na danych par
R
# Symulacja: co się dzieje, gdy dane par analizujesz zwykłą regresją (pseudoreplikacja)?
# 100 par, prawdziwe efekty = 0: długość związku (zmienna między parami) i płeć (zmienna wewnątrz par).
# ICC wyniku w parze: 0, .2, .4, .6; 1000 zbiorów na wartość ICC.
suppressPackageStartupMessages(library(nlme))
set.seed(3344)
jeden <- function(icc, n = 100) {
  e <- MASS::mvrnorm(n, c(0, 0), matrix(c(1, icc, icc, 1), 2))
  d <- data.frame(para = rep(1:n, each = 2), plec = rep(c(0.5, -0.5), n),
                  lata = rep(rnorm(n, 8, 4), each = 2), y = as.vector(t(e)))
  p_lm <- summary(lm(y ~ lata + plec, data = d))$coefficients[c("lata", "plec"), 4]
  p_gls <- summary(gls(y ~ lata + plec, data = d, correlation = corCompSymm(form = ~ 1 | para)))$tTable[c("lata", "plec"), 4]
  c(lm_lata = p_lm[[1]], lm_plec = p_lm[[2]], gls_lata = p_gls[[1]], gls_plec = p_gls[[2]]) < .05
}
wyniki <- t(sapply(c(0, .2, .4, .6), function(icc) c(ICC = icc, rowMeans(replicate(1000, jeden(icc))))))
print(round(as.data.frame(wyniki), 3), row.names = FALSE)
round(c(blad_MC_przy_5_proc = sqrt(.05 * .95 / 1000)), 4)
Wynik w R
 ICC lm_lata lm_plec gls_lata gls_plec
 0.0   0.043   0.056    0.042    0.058
 0.2   0.089   0.020    0.063    0.036
 0.4   0.089   0.011    0.045    0.053
 0.6   0.116   0.002    0.045    0.055
blad_MC_przy_5_proc
             0.0069
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami nlme, lme4, MASS i lavaan; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- nlme (wersja 3.1.168): Pinheiro, J., Bates, D., & R Core Team. (2025). nlme: Linear and nonlinear mixed effects models [R package]. https://doi.org/10.32614/CRAN.package.nlme
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Zwykła regresja na wszystkich osobach. Zawyża istotność zmiennych między parami i zaniża istotność zmiennych wewnątrz par (rysunek 1).
- Rozróżnialność przyjęta bez testu. Osobne parametry dla ról mnożą liczbę efektów i obniżają moc. Wspólne parametry mogą z kolei ukryć różnicę, jak w przykładzie.
- Losowy wyraz wolny pary przy ujemnej zależności. Model oszacuje wariancję na zero i zgubi informację o kompensacji. Użyj
glszcorCompSymm. - Brak centrowania. Bez niego wyraz wolny opisuje osobę o stresie 0, a takiej na skali 1–5 nie ma.
- Interpretacja k przy słabym efekcie aktora. Iloraz ze zbyt małym mianownikiem jest niestabilny; podaj przedział i oba efekty.
- Efekt partnera opisany jak wpływ przyczynowy. W danych przekrojowych to związek. Wspólne czynniki pary mogą go częściowo tłumaczyć (Kenny, 1996).
Najczęstsze pytania
Czy korelacja wewnątrzklasowa w parach może być ujemna?
Tak. Ujemne ICC pojawia się, gdy partnerzy się uzupełniają, np. gdy jedna osoba przejmuje więcej opieki nad dzieckiem, a druga mniej. W przykładzie godzin opieki ICC wyniosło −.43. Model GLS ze stałą korelacją w parze odtworzył tę wartość, a model z losowym wyrazem wolnym pary oszacował wariancję pary na zero i zgłosił singular fit.
Czy APIM można policzyć w lme4 z losowym wyrazem wolnym pary?
Tak, jeśli zależność w parze jest dodatnia. W przykładzie model lme z losowym wyrazem wolnym dał te same efekty aktora i partnera co gls. Losowy wyraz wolny nie pozwala jednak na ujemną korelację, a przy dwóch osobach w parze zwykle nie da się dodać losowych nachyleń. Dlatego w danych diadycznych bezpieczniejszy jest gls z corCompSymm.
Jak sprawdzić, czy pary są rozróżnialne?
Porównaj testem ilorazu wiarygodności model, w którym obie role mają te same parametry, z modelem z osobnymi średnimi, wariancjami oraz efektami aktora i partnera. W przykładzie różnica była istotna, χ²(4) = 24.86, p < .001, więc kobiety i mężczyzn trzeba było analizować osobno. Gdy test nie wskazuje różnic, model nierozróżnialny jest prostszy i ma większą moc.
Co zrobić, gdy parametr k ma bardzo szeroki przedział ufności?
Sprawdź efekt aktora. Parametr k jest ilorazem efektu partnera i aktora, więc przy małym efekcie aktora mianownik bywa bliski zera, a iloraz wybucha. W przykładzie u mężczyzn 95% CI dla k wyniósł [0.07, 4.92]. Opisz wtedy oba efekty osobno i nie wyciągaj wniosku o wzorcu pary.
Ile par potrzeba do modelu APIM?
Nie ma jednej liczby. Efekty partnera są zwykle słabsze niż efekty aktora, więc to one wyznaczają potrzebną liczebność. Model z parami rozróżnialnymi ma dwa razy więcej parametrów niż model nierozróżnialny. Najrzetelniej zaplanujesz liczbę par symulacją z założonymi efektami i korelacją w parze, tak jak w analizie mocy modelu mieszanego.
Powiązane hasła
Przeczytaj też
Model wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →PoradnikAnaliza ścieżek w lavaan krok po kroku
Model na zmiennych obserwowalnych: identyfikacja i df, dopasowanie, efekty pośrednie i całkowite z bootstrapem, modele zagnieżdżone i alternatywne.
Czytaj →PoradnikGEE czy model mieszany?
Efekty brzegowe a warunkowe, robocza macierz korelacji, błąd kanapkowy i CR2, braki MCAR i MAR oraz QIC – na jednym przykładzie w R.
Czytaj →Masz dane od par i nie wiesz, jak je przeanalizować?
Pomożemy przygotować dane, dobrać model APIM do rozróżnialności par i sprawdzić analizę tak, żebyś mógł(a) samodzielnie opisać i obronić wyniki przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Cook, W. L., & Kenny, D. A. (2005). The actor–partner interdependence model: A model of bidirectional effects in developmental studies. International Journal of Behavioral Development, 29(2), 101–109. https://doi.org/10.1080/01650250444000405
- Garcia, R. L., Kenny, D. A., & Ledermann, T. (2015). Moderation in the actor–partner interdependence model. Personal Relationships, 22(1), 8–29. https://doi.org/10.1111/pere.12060
- Gonzalez, R., & Griffin, D. (1999). The correlational analysis of dyad-level data in the distinguishable case. Personal Relationships, 6(4), 449–469. https://doi.org/10.1111/j.1475-6811.1999.tb00203.x
- Kenny, D. A. (1996). Models of non-independence in dyadic research. Journal of Social and Personal Relationships, 13(2), 279–294. https://doi.org/10.1177/0265407596132007
- Kenny, D. A., & Ledermann, T. (2010). Detecting, measuring, and testing dyadic patterns in the actor–partner interdependence model. Journal of Family Psychology, 24(3), 359–366. https://doi.org/10.1037/a0019651
- Kenny, D. A., Kashy, D. A., & Cook, W. L. (2006). Dyadic data analysis. Guilford Press.
- Ledermann, T., Macho, S., & Kenny, D. A. (2011). Assessing mediation in dyadic data using the actor-partner interdependence model. Structural Equation Modeling: A Multidisciplinary Journal, 18(4), 595–612. https://doi.org/10.1080/10705511.2011.607099
- Olsen, J. A., & Kenny, D. A. (2006). Structural equation modeling with interchangeable dyads. Psychological Methods, 11(2), 127–141. https://doi.org/10.1037/1082-989x.11.2.127
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
Cytowania BibTeX
@article{cook2005actor, author={Cook, William L. and Kenny, David A.}, title={{The actor–partner interdependence model: A model of bidirectional effects in developmental studies}}, journal={International Journal of Behavioral Development}, year={2005}, volume={29}, number={2}, pages={101--109}, doi={10.1080/01650250444000405}}@article{garcia2015moderation, author={Garcia, Randi L. and Kenny, David A. and Ledermann, Thomas}, title={{Moderation in the actor–partner interdependence model}}, journal={Personal Relationships}, year={2015}, volume={22}, number={1}, pages={8--29}, doi={10.1111/pere.12060}}@article{gonzalez1999correlational, author={Gonzalez, Richard and Griffin, Dale}, title={{The correlational analysis of dyad-level data in the distinguishable case}}, journal={Personal Relationships}, year={1999}, volume={6}, number={4}, pages={449--469}, doi={10.1111/j.1475-6811.1999.tb00203.x}}@article{kenny1996models, author={Kenny, David A.}, title={{Models of non-independence in dyadic research}}, journal={Journal of Social and Personal Relationships}, year={1996}, volume={13}, number={2}, pages={279--294}, doi={10.1177/0265407596132007}}@article{kenny2010detecting, author={Kenny, David A. and Ledermann, Thomas}, title={{Detecting, measuring, and testing dyadic patterns in the actor–partner interdependence model}}, journal={Journal of Family Psychology}, year={2010}, volume={24}, number={3}, pages={359--366}, doi={10.1037/a0019651}}@book{kenny2006dyadic, author={Kenny, David A. and Kashy, Deborah A. and Cook, William L.}, title={{Dyadic data analysis}}, year={2006}, publisher={Guilford Press}, url={https://openlibrary.org/books/OL8734516M}}@article{ledermann2011assessing, author={Ledermann, Thomas and Macho, Siegfried and Kenny, David A.}, title={{Assessing mediation in dyadic data using the actor-partner interdependence model}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2011}, volume={18}, number={4}, pages={595--612}, doi={10.1080/10705511.2011.607099}}@article{olsen2006structural, author={Olsen, Joseph A. and Kenny, David A.}, title={{Structural equation modeling with interchangeable dyads}}, journal={Psychological Methods}, year={2006}, volume={11}, number={2}, pages={127--141}, doi={10.1037/1082-989x.11.2.127}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, pages={1--36}, doi={10.18637/jss.v048.i02}}