Co to jest model APIM?
Model APIM (actor–partner interdependence model) opisuje dane diadyczne, czyli pomiary od obu osób z pary: małżonków, matki i dziecka, rodzeństwa. Wynik każdej osoby zależy od jej własnej zmiennej (efekt aktora) i od tej samej zmiennej u partnera (efekt partnera). Cook i Kenny (2005) przedstawili APIM jako ogólny model wzajemnych wpływów w relacjach, także w danych podłużnych.
Dane i estymacja
Dane zapisuje się w formacie długim „par”: jeden wiersz na osobę, z jej własnym X, X partnera i identyfikatorem pary. Reszty osób z tej samej pary są skorelowane, więc zwykła regresja traktowałaby je jak niezależne obserwacje – to pseudoreplikacja. Model szacuje się jako model wielopoziomowy lub GLS ze wspólną korelacją reszt w parze (odpowiednik ICC) albo w SEM na danych szerokich. Analizę danych diadycznych obszernie omawia podręcznik Kenny’ego, Kashy i Cook (2006).
Pary rozróżnialne i nierozróżnialne
W parach kobieta–mężczyzna role można rozróżnić i oszacować osobne efekty dla każdej roli. Bliźnięta czy przyjaciele tej samej płci są nierozróżnialni – efekty są wspólne. Rozróżnialność warto sprawdzić testem ilorazu wiarygodności.
Przykład
W 150 symulowanych parach stres obniża własną satysfakcję ze związku (efekt aktora b = −0.35, SE = 0.06, p < .001) i satysfakcję partnera (b = −0.14, SE = 0.06, p = .015). Korelacja reszt w parze wynosi 0.32. Model z osobnymi efektami dla kobiet i mężczyzn nie pasuje istotnie lepiej, χ²(4) = 6.80, p = .147.
Na rysunku
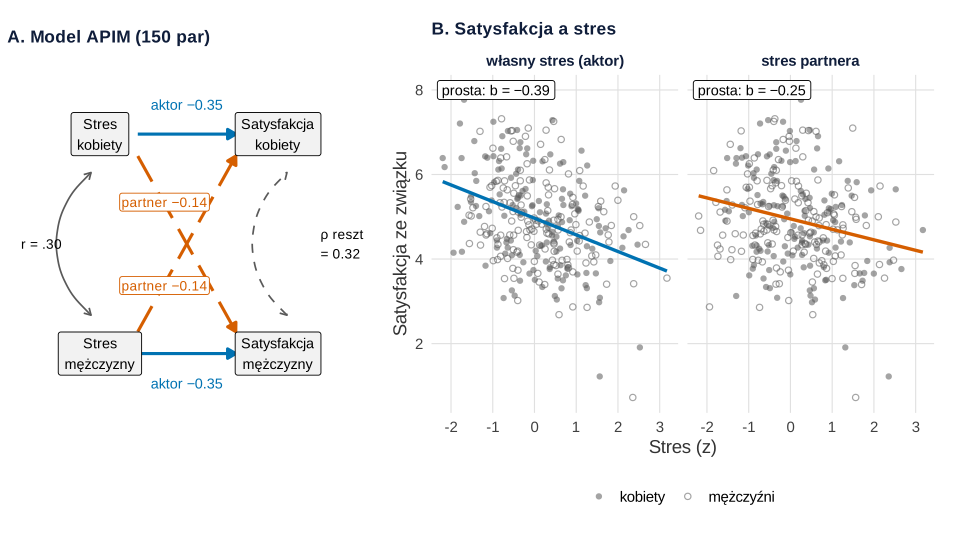
set.seed(7200)).Co widać. Panel A to diagram APIM z oszacowaniami z przykładu (pary nierozróżnialne, wspólne efekty dla obu ról). Poziome strzałki to efekt aktora (−0.35), ukośne – efekt partnera (−0.14). Łuk po lewej to korelacja stresu w parze (r = .30). Łuk po prawej to korelacja reszt satysfakcji (ρ = 0.32), czyli zależność obserwacji w parze, której zwykła regresja nie uwzględnia. Panel B pokazuje 300 osób na dwóch wykresach rozrzutu z prostymi regresji jednej zmiennej.
Na co uważać. Proste w panelu B nie są efektami APIM. Ich nachylenia wynoszą −0.39 dla własnego stresu i −0.25 dla stresu partnera, a model daje −0.35 i −0.14. Stres w parze jest skorelowany, więc każda prosta miesza oba efekty: −0.25 to w przybliżeniu efekt partnera plus 0.30 razy efekt aktora. Rozrzut pokazuje związek całkowity, a efekty aktora i partnera są cząstkowe, jak współczynniki w regresji wielorakiej. Punkty osób z tej samej pary nie są niezależne, choć na rozrzucie tak wyglądają. Rysunek nie pokazuje też różnic między kobietami i mężczyznami – sprawdza je test rozróżnialności z przykładu. Inny diagram ścieżek narysowany w ggplot2 zawiera wpis Mediacja w obrazkach.
Podpis do pracy:
Kod losuje te same dane co przykład, z tym samym ziarnem set.seed(7200), ustalonym raz. Położenie węzłów, strzałek i etykiet diagramu ustawiono ręcznie. Rysunek na stronie różni się od wyniku kodu tylko motywem serwisu w panelu B.
Kod R rysunku 1
# Rysunek 1. Diagram APIM z oszacowaniami (A) i satysfakcja wobec własnego stresu i stresu partnera (B)
library(ggplot2)
library(patchwork)
library(nlme)

# Paleta Okabe–Ito i prosty motyw
kol <- c(aktor = "#0072B2", partner = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold"), plot.background = element_rect(fill = "white", colour = NA))

set.seed(7200)                                       # te same dane co w przykładzie wyżej
n <- 150
x_k <- rnorm(n); x_m <- 0.3 * x_k + rnorm(n, 0, sqrt(1 - 0.09))   # stres kobiety i mężczyzny
e <- MASS::mvrnorm(n, c(0, 0), matrix(c(1, .4, .4, 1), 2))        # skorelowane reszty w parze
y_k <- 5 - 0.40 * x_k - 0.20 * x_m + e[, 1]
y_m <- 5 - 0.40 * x_m - 0.20 * x_k + e[, 2]
dl <- rbind(data.frame(para = 1:n, rola = "K", y = y_k, x_aktor = x_k, x_partner = x_m),
            data.frame(para = 1:n, rola = "M", y = y_m, x_aktor = x_m, x_partner = x_k))
m <- gls(y ~ x_aktor + x_partner, data = dl, correlation = corCompSymm(form = ~ 1 | para), method = "REML")
b   <- coef(m)
rho <- coef(m$modelStruct$corStruct, unconstrained = FALSE)
r_x <- cor(x_k, x_m)                                 # korelacja stresu w parze
# Nachylenia z prostych regresji jednej zmiennej (to, co pokazuje rozrzut)
b_proste <- c(aktor = unname(coef(lm(y ~ x_aktor, dl))[2]), partner = unname(coef(lm(y ~ x_partner, dl))[2]))
round(c(aktor_APIM = unname(b["x_aktor"]), partner_APIM = unname(b["x_partner"]), rho_reszt = unname(rho),
        r_stres = r_x, aktor_prosta = unname(b_proste["aktor"]), partner_prosta = unname(b_proste["partner"])), 2)

# A. Diagram: węzły, strzałki aktora (poziome) i partnera (ukośne), łuki korelacji
f2 <- function(x) sub("-", "−", sprintf("%.2f", x))
wezly <- data.frame(x = c(0, 0, 4, 4), y = c(2, 0, 2, 0),
                    et = c("Stres\nkobiety", "Stres\nmężczyzny", "Satysfakcja\nkobiety", "Satysfakcja\nmężczyzny"))
sciezki <- data.frame(x = 0.85, y = c(2, 0, 1.8, 0.2), xend = 3.05, yend = c(2, 0, 0.2, 1.8),
                      typ = c("aktor", "aktor", "partner", "partner"))
pA <- ggplot() +
  geom_segment(data = sciezki, aes(x, y, xend = xend, yend = yend, colour = typ, linetype = typ),
               linewidth = 1.1, arrow = arrow(length = unit(0.25, "cm"), type = "closed")) +
  geom_curve(aes(x = -0.2, y = 1.65, xend = -0.2, yend = 0.35), curvature = 0.5, linewidth = 0.6,
             arrow = arrow(length = unit(0.2, "cm"), ends = "both"), colour = "grey35") +
  geom_curve(aes(x = 4.2, y = 0.35, xend = 4.2, yend = 1.65), curvature = -0.5, linewidth = 0.6,
             arrow = arrow(length = unit(0.2, "cm"), ends = "both"), colour = "grey35", linetype = "dashed") +
  geom_label(data = wezly, aes(x, y, label = et), size = 3.8, label.padding = unit(0.35, "lines"), fill = "grey95") +
  annotate("text", x = 1.95, y = c(2.27, -0.27), label = paste("aktor", f2(b["x_aktor"])), size = 3.8,
           colour = kol[["aktor"]]) +
  annotate("label", x = 1.45, y = c(1.38, 0.62), label = paste("partner", f2(b["x_partner"])), size = 3.6,
           colour = kol[["partner"]], fill = "white") +
  annotate("text", x = -0.85, y = 1, label = paste0("r = ", sub("0.", ".", f2(r_x), fixed = TRUE)), size = 3.6, hjust = 1) +
  annotate("text", x = 4.95, y = 1, label = paste0("ρ reszt\n= ", f2(rho)), size = 3.6, hjust = 0) +
  scale_colour_manual(values = kol, guide = "none") +
  scale_linetype_manual(values = c(aktor = "solid", partner = "longdash"), guide = "none") +
  coord_cartesian(xlim = c(-1.7, 5.9), ylim = c(-0.4, 2.4)) +
  labs(title = "A. Model APIM (150 par)") + theme_void(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.background = element_rect(fill = "white", colour = NA))

# B. Rozrzut: satysfakcja wobec własnego stresu i stresu partnera (300 osób)
rozrzut <- rbind(data.frame(panel = "własny stres (aktor)", x = dl$x_aktor, y = dl$y, rola = dl$rola),
                 data.frame(panel = "stres partnera", x = dl$x_partner, y = dl$y, rola = dl$rola))
rozrzut$panel <- factor(rozrzut$panel, levels = c("własny stres (aktor)", "stres partnera"))
etyk <- data.frame(panel = factor(levels(rozrzut$panel), levels = levels(rozrzut$panel)),
                   lab = sprintf("prosta: b = %s", f2(b_proste)))
pB <- ggplot(rozrzut, aes(x, y)) +
  geom_point(aes(shape = rola), colour = "grey35", alpha = 0.55, size = 1.8) +
  geom_smooth(aes(colour = panel), method = "lm", formula = y ~ x, se = FALSE, linewidth = 1.2) +
  geom_label(data = etyk, aes(x = -Inf, y = Inf, label = lab), hjust = -0.05, vjust = 1.3, size = 3.8, fill = "white") +
  facet_wrap(~ panel) +
  scale_colour_manual(values = unname(kol), guide = "none") +
  scale_shape_manual(values = c(K = 16, M = 1), labels = c("kobiety", "mężczyźni"), name = NULL) +
  labs(title = "B. Satysfakcja a stres", x = "Stres (z)", y = "Satysfakcja ze związku") +
  motyw + theme(legend.position = "bottom")

p1 <- pA + pB + plot_layout(widths = c(1, 1.35))
p1
Wynik w R
    aktor_APIM   partner_APIM      rho_reszt        r_stres   aktor_prosta
         -0.35          -0.14           0.32           0.30          -0.39
partner_prosta
         -0.25
Jak opisać w pracy
Na co uważać
- Wzorzec efektów. Kenny i Ledermann (2010) proponują parametr k = efekt partnera / efekt aktora: k ≈ 1 to wzorzec „pary”, k ≈ 0 – „tylko aktor”, k ≈ −1 – kontrast. Tu k = 0.41.
- Nie łącz danych pary w średnią. Uśrednienie wyników gubi rozróżnienie aktora i partnera.
- Efekt partnera to nie przyczynowość. Bez układu podłużnego lub eksperymentu to tylko związek.
Model APIM w R
Kod symuluje dane 150 par, przekształca je do formatu długiego „par”, dopasowuje APIM funkcją nlme::gls() ze wspólną korelacją reszt w parze, porównuje błędy standardowe z naiwną regresją lm() i testuje rozróżnialność ról. Liczby w tekście pochodzą z tego kodu.
Efekty aktora i partnera w GLS
R
set.seed(7200)
library(nlme)
n <- 150                                         # 150 par (dane symulowane)
x_k <- rnorm(n); x_m <- 0.3 * x_k + rnorm(n, 0, sqrt(1 - 0.09))   # stres kobiety i mężczyzny
e <- MASS::mvrnorm(n, c(0, 0), matrix(c(1, .4, .4, 1), 2))        # skorelowane reszty w parze
y_k <- 5 - 0.40 * x_k - 0.20 * x_m + e[, 1]                        # satysfakcja: aktor -0.40, partner -0.20
y_m <- 5 - 0.40 * x_m - 0.20 * x_k + e[, 2]
szer <- data.frame(para = 1:n, x_k, x_m, y_k, y_m)
# Format długi "par": jeden wiersz na osobę, z własnym X (aktor) i X partnera
dl <- rbind(data.frame(para = szer$para, rola = "K", y = y_k, x_aktor = x_k, x_partner = x_m),
            data.frame(para = szer$para, rola = "M", y = y_m, x_aktor = x_m, x_partner = x_k))
dl <- dl[order(dl$para), ]
head(dl, 4)
m <- gls(y ~ x_aktor + x_partner, data = dl,
         correlation = corCompSymm(form = ~ 1 | para), method = "REML")
round(summary(m)$tTable, 3)
round(c(rho_reszt = coef(m$modelStruct$corStruct, unconstrained = FALSE),
        k = unname(coef(m)["x_partner"] / coef(m)["x_aktor"])), 3)
naiwny <- lm(y ~ x_aktor + x_partner, data = dl)   # ignoruje zależność w parach
round(cbind(b_gls = coef(m), se_gls = sqrt(diag(vcov(m))),
            b_lm = coef(naiwny), se_lm = sqrt(diag(vcov(naiwny)))), 3)
# Pary rozróżnialne: osobne efekty aktora i partnera dla kobiet i mężczyzn
m2 <- gls(y ~ 0 + rola + rola:x_aktor + rola:x_partner, data = dl,
          correlation = corCompSymm(form = ~ 1 | para), weights = varIdent(form = ~ 1 | rola),
          method = "ML")
m1 <- update(m, method = "ML")
round(coef(m2), 3)
anova(m1, m2)
Wynik w R
    para rola        y     x_aktor   x_partner
1      1    K 4.640264  0.43117504  0.02472376
151    1    M 4.919618  0.02472376  0.43117504
2      2    K 3.612939  0.75164066 -0.98755441
152    2    M 3.961420 -0.98755441  0.75164066
             Value Std.Error t-value p-value
(Intercept)  4.976     0.069  72.365   0.000
x_aktor     -0.351     0.059  -5.975   0.000
x_partner   -0.144     0.059  -2.448   0.015
rho_reszt.Rho             k
        0.319         0.410
             b_gls se_gls   b_lm se_lm
(Intercept)  4.976  0.069  4.976 0.060
x_aktor     -0.351  0.059 -0.351 0.062
x_partner   -0.144  0.059 -0.144 0.062
          rolaK           rolaM   rolaK:x_aktor   rolaM:x_aktor rolaK:x_partner
          5.028           4.924          -0.415          -0.271          -0.221
rolaM:x_partner
         -0.082
   Model df      AIC      BIC    logLik   Test  L.Ratio p-value
m1     1  5 859.0354 877.5543 -424.5177
m2     2  9 860.2386 893.5726 -421.1193 1 vs 2 6.796799   0.147
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety nlme i MASS). Rysunek 1 wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- nlme (wersja 3.1.168): Pinheiro, J., Bates, D., & R Core Team. (2025). nlme: Linear and nonlinear mixed effects models [R package]. https://doi.org/10.32614/CRAN.package.nlme
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym różni się efekt aktora od efektu partnera?
Efekt aktora to związek własnej zmiennej osoby z jej wynikiem, np. mój stres z moją satysfakcją. Efekt partnera to związek zmiennej partnera z moim wynikiem, np. stres partnera z moją satysfakcją, przy kontroli mojego stresu.
Jak przygotować dane do APIM?
Potrzebny jest format długi „par”: każda osoba ma wiersz z identyfikatorem pary, własnym wynikiem, własnym predyktorem i predyktorem partnera. W SEM używa się zwykle formatu szerokiego, jeden wiersz na parę.
Czy APIM można policzyć zwykłą regresją?
Nie wprost. Wyniki osób z tej samej pary są skorelowane, więc zwykła regresja daje błędne błędy standardowe. Potrzebny jest model z korelacją w parze: GLS, model wielopoziomowy albo SEM.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Model wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →PoradnikDane diadyczne i APIM krok po kroku
Formaty danych par, ICC w diadach, APIM w gls i lavaan, test rozróżnialności i parametr k – na 200 parach w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cook, W. L., & Kenny, D. A. (2005). The actor–partner interdependence model: A model of bidirectional effects in developmental studies. International Journal of Behavioral Development, 29(2), 101–109. https://doi.org/10.1080/01650250444000405
- Kenny, D. A., & Ledermann, T. (2010). Detecting, measuring, and testing dyadic patterns in the actor–partner interdependence model. Journal of Family Psychology, 24(3), 359–366. https://doi.org/10.1037/a0019651
- Kenny, D. A., Kashy, D. A., & Cook, W. L. (2006). Dyadic data analysis. Guilford Press.
Cytowania BibTeX
@article{cook2005actor, author={Cook, William L. and Kenny, David A.}, title={{The actor–partner interdependence model: A model of bidirectional effects in developmental studies}}, journal={International Journal of Behavioral Development}, year={2005}, volume={29}, number={2}, pages={101--109}, doi={10.1080/01650250444000405}}@article{kenny2010detecting, author={Kenny, David A. and Ledermann, Thomas}, title={{Detecting, measuring, and testing dyadic patterns in the actor–partner interdependence model}}, journal={Journal of Family Psychology}, year={2010}, volume={24}, number={3}, pages={359--366}, doi={10.1037/a0019651}}@book{kenny2006dyadic, author={Kenny, David A. and Kashy, Deborah A. and Cook, William L.}, title={{Dyadic data analysis}}, year={2006}, publisher={Guilford Press}, url={https://openlibrary.org/books/OL8734516M}}