Przykład: sieć sklepów z artykułami dziecięcymi i program punktowy
Fikcyjna sieć sklepów z artykułami dziecięcymi zna zakupy klientów z konta w aplikacji – także tych, którzy nie przystąpili do programu. W 9. miesiącu sieć uruchamia program punktowy: zapisać się można przy kasie, a punkty i kupony działają od następnego miesiąca. Po roku dział marketingu raportuje: członkowie wydają miesięcznie o ponad 50 zł więcej niż nieczłonkowie. Zarząd pyta: ile z tej różnicy zrobił program i czy zwraca się jego koszt?
Do programu nikt nie trafił losowo. Klienci sami się zapisują, częściej rodzice z dwójką dzieci, z niemowlęciem, przywiązani do sieci i… ci, którzy akurat kupują wózek. Tak samo opisują ten problem Leenheer i in. (2007): członkowie programów mają wyższy udział w portfelu, ale lojalni klienci sami wybierają członkostwo. Po uwzględnieniu samoselekcji efekt członkostwa wyszedł u nich siedem razy mniejszy niż w naiwnym modelu.
Dane są fikcyjne i znamy prawdę. Wygenerowaliśmy 3000 klientów i ich wydatki w 24 miesiącach. Do analizy bierzemy 2803 klientów, którzy kupili coś w miesiącach 6–8, czyli tuż przed startem programu. Zapisało się 773 z nich (w całej bazie 776). Program dodaje 10 zł do zakupów w pierwszym miesiącu z kartą, a potem coraz więcej, do około 30 zł. Nie każdy kupuje co miesiąc, a część klientów odchodzi, więc średnio wychodzi 16.91 zł miesięcznie na członka – to średni efekt u członków (ATT w języku modelu potencjalnych wyników). Parametry ustawiliśmy ręcznie (lista przy kodzie). Po pierwszych uruchomieniach zmieniliśmy szansę zapisu, moment dużego zakupu i sposób powstawania miesięcy bez zakupu; ziarna 670 nie zmienialiśmy. Dane: program-lojalnosciowy-sklepy-dzieciece.csv.
Rysunek 1: cztery porównania, jedna prawda
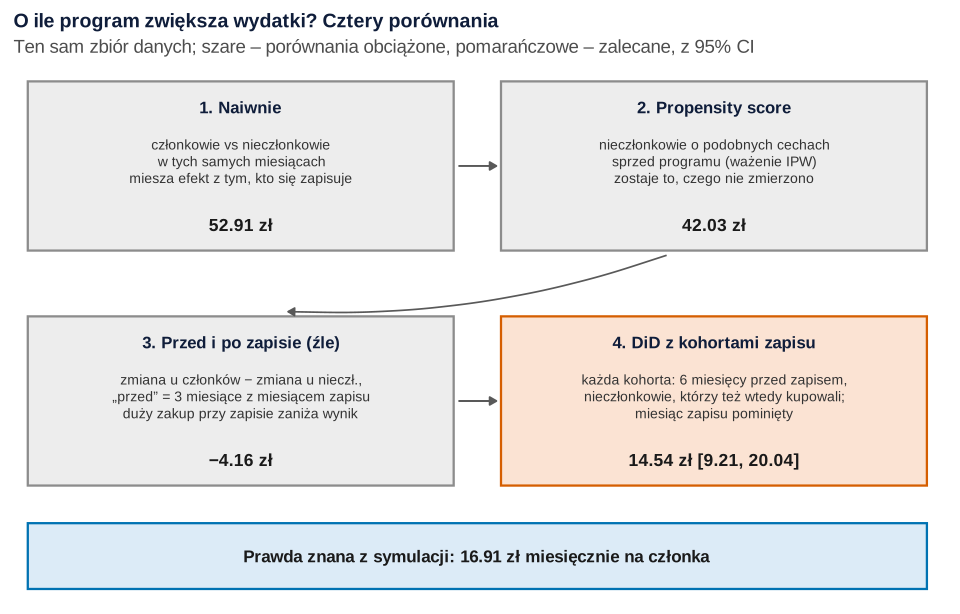
set.seed(670)).Co widać. Każde kolejne porównanie usuwa jedno źródło błędu. Naiwne daje 52.91 zł, czyli trzy razy więcej niż prawda. Propensity score zbija wynik do 42.03 zł, ale nadal jest daleko. Różnica w różnicach (DiD) porównuje zmianę wydatków członków ze zmianą u nieczłonków. Daje 14.54 zł, 95% przedział ufności [9.21, 20.04], i obejmuje prawdę. Ta sama różnica w różnicach ze źle wybranym okresem „przed” daje −4.16 zł.
Jak może zmylić. W prawdziwych danych nie ma niebieskiego paska, więc w pracy opisz, co każde porównanie zakłada, a nie tylko, ile wyszło.
Podpis do pracy:
Rysunek 2: członkowie wydawali więcej, zanim program powstał
Naiwne porównanie wygląda tak: weź miesiące, w których członek miał już kartę, i porównaj jego wydatki z wydatkami nieczłonków w tych samych miesiącach. Członkowie wydawali średnio 163.43 zł, nieczłonkowie 113.13 zł, różnica 52.91 zł, 95% CI [47.56, 58.26]. Wąski przedział mierzy tylko przypadkowy rozrzut, nie błąd selekcji.
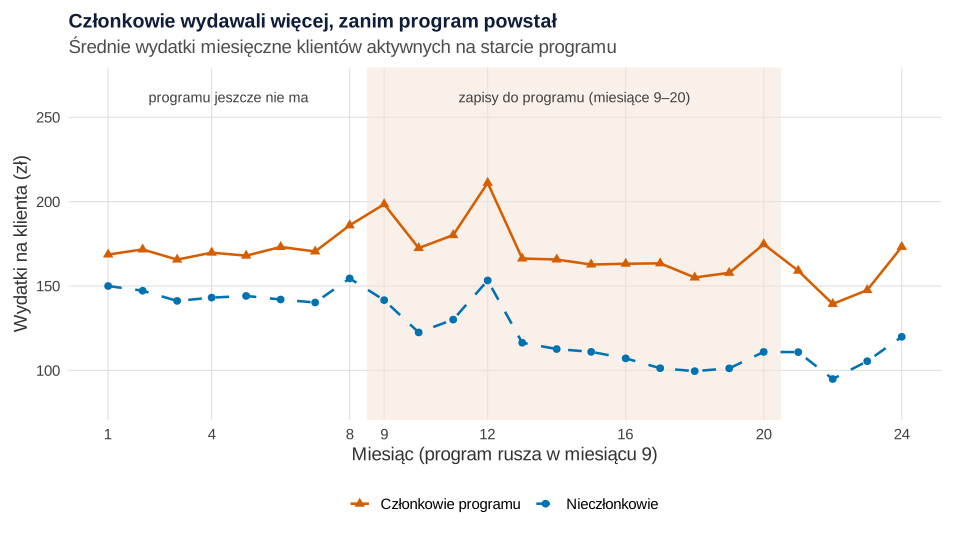
set.seed(670)).Co widać. W miesiącach 1–8 programu jeszcze nie było, a przyszli członkowie wydawali średnio 171.67 zł, nieczłonkowie 145.29 zł. Różnica 26.38 zł istniała, zanim ktokolwiek dostał punkty. To samoselekcja. Po starcie programu linia nieczłonków opada, bo część z nich odchodzi z sieci.
Jak może zmylić. Odejścia działają tylko na jedną stronę porównania. Członek musiał coś kupić, żeby się zapisać, więc w chwili zapisu na pewno był klientem. Wśród nieczłonków są też ci, którzy już odeszli i wydają zero. To błąd przeżywalności w wersji marketingowej. Gdy do porównania weźmiemy całą bazę, łącznie z klientami, którzy odeszli przed startem, naiwna różnica rośnie do 62.14 zł.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: propensity score i zbalansowanie cech
Pierwszy pomysł na samoselekcję: porównać członków z podobnymi nieczłonkami. Propensity score to prawdopodobieństwo zapisu przy danych cechach. Rosenbaum i Rubin (1983) pokazali, że korekta o tę jedną liczbę wystarcza, by usunąć obciążenie wynikające ze wszystkich zmierzonych cech. Policzyliśmy go z regresji logistycznej na cechach sprzed startu programu: wydatkach i liczbie miesięcy z zakupem w miesiącach 1–8, liczbie dzieci, wieku najmłodszego dziecka, odległości od sklepu i udziale zakupów online. Potem zrobiliśmy dwie rzeczy: ważenie odwrotnością prawdopodobieństwa (IPW, pakiet WeightIt) i dopasowanie 1:1 z kaliprem (pakiet MatchIt). Cel to podobne rozkłady cech w obu grupach, jak w eksperymencie (Stuart, 2010); procedurę opisuje wpis propensity score: dopasowanie i ważenie.
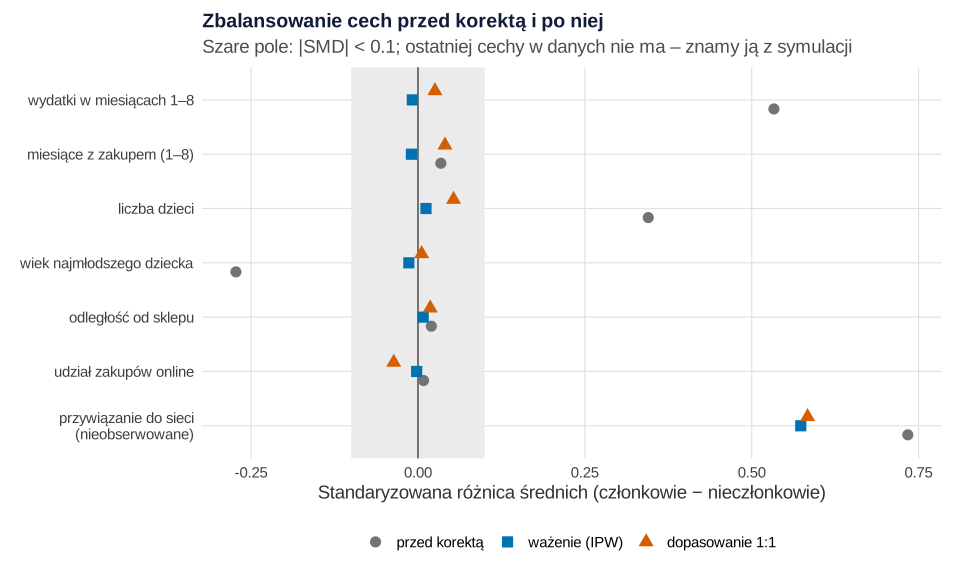
set.seed(670)).Co widać. To wykres zbalansowania, tzw. love plot. Każdy punkt to standaryzowana różnica średnich (SMD). Przed korektą członkowie mieli wyższe wydatki (SMD = 0.53), więcej dzieci (0.35) i młodsze dzieci (−0.27). Po ważeniu i po dopasowaniu wszystkie zmierzone cechy mieszczą się w pasie ±0.1. Austin (2009) omawia standaryzowane różnice jako podstawową miarę zbalansowania, obok ilorazów wariancji i wykresów. Ważenie zachowało efektywnie 1304 z 2030 nieczłonków, dopasowanie znalazło pary dla 752 z 773 członków.
Jak może zmylić. Ostatni wiersz to przywiązanie do sieci, którego w danych nie ma – znamy je tylko dlatego, że sami je wylosowaliśmy. Po korekcie jego SMD wciąż wynosi 0.57–0.58. Ładny wykres zbalansowania dotyczy tylko tego, co zmierzono. Efekt po ważeniu: 42.03 zł, 95% CI [36.00, 48.05], po dopasowaniu 42.50 zł [36.02, 48.98]. Prawda to 16.91 zł. Ile niezmierzonego zakłócenia trzeba, by podważyć wynik, ocenia E-wartość.
Podpis do pracy:
Rysunek 4: różnica w różnicach z kohortami zapisu
Propensity score porównuje poziomy wydatków. Przywiązanie do sieci podnosi poziom na stałe, więc zostaje w wyniku. Różnica w różnicach porównuje zmiany: o ile wzrosły wydatki członka po zapisie minus o ile w tych samych miesiącach zmieniły się wydatki nieczłonków. Stała różnica poziomów się odejmuje. Logikę metody opisuje wpis quasi-eksperyment i różnica w różnicach. W programie lojalnościowym dochodzi jednak problem: każdy zapisuje się w innym miesiącu.
Dlatego liczymy DiD osobno dla każdej kohorty zapisu (wszyscy, którzy zapisali się w tym samym miesiącu z), a potem uśredniamy wyniki z wagą liczby członków. Dla kohorty „przed” to miesiące z−6…z−1, a grupa porównawcza to nieczłonkowie, którzy też coś kupili w miesiącu z – tak jak członek, który zapisał się przy kasie. Miesiąc zapisu pomijamy. Przedziały pochodzą z bootstrapu klientów (300 prób).
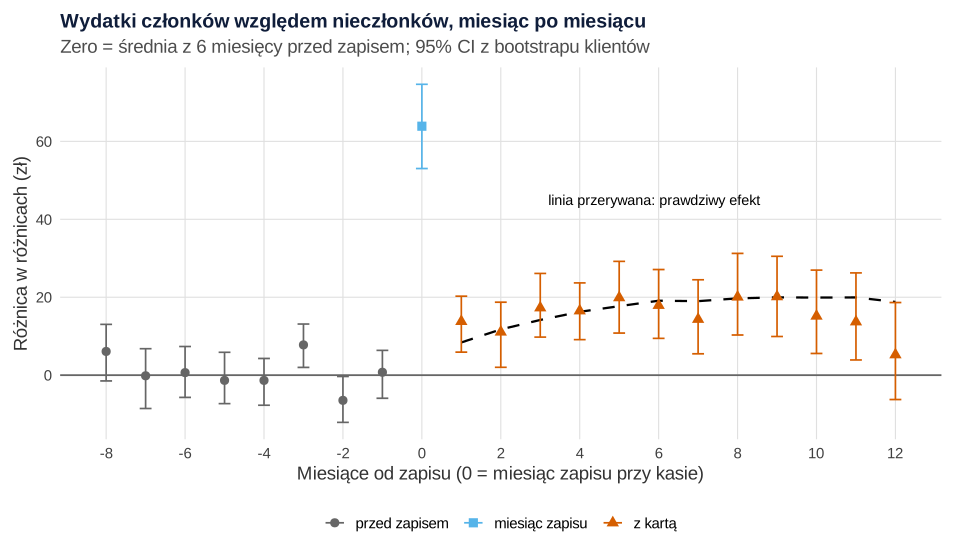
set.seed(670), bootstrap set.seed(6700)).Co widać. To model zdarzeń (event study): osobna różnica w różnicach dla każdego miesiąca od zapisu. Przed zapisem punkty leżą wokół zera (od −6.5 do 7.8 zł), więc członkowie i nieczłonkowie zmieniali się podobnie. W pierwszym miesiącu z kartą różnica wynosi 13.8 zł, w kolejnych od 11.1 do 20.1 zł. Linia przerywana to prawda (8.4 zł w pierwszym miesiącu, 19.1 zł w szóstym). Średnio: 14.54 zł, 95% CI [9.21, 20.04]. Kohorty dają podobne wyniki: 15.02 zł dla zapisanych na starcie (miesiące 9–10), 14.04 zł dla miesięcy 11–14, 13.66 zł dla miesięcy 15–20.
Jak może zmylić. Miesiąc zapisu odstaje o 63.9 zł. Co piąty członek (20.1%) zapisał się przy dużym zakupie – wózka albo fotelika – a w zwykłym miesiącu duży zakup zdarza się 3% klientów. To regresja do średniej: wybór nastąpił w wyjątkowo dobrym miesiącu, a potem wydatki wracają do normy. Barnett i in. (2005) podkreślają, że efekt jest najsilniejszy, gdy grupę wybiera się na podstawie skrajnego pomiaru. Jeśli „przed” to trzy miesiące przed aktywacją karty, czyli z miesiącem zapisu, DiD daje −4.16 zł i wniosek „program szkodzi”. Więcej o zjawisku: regresja do średniej w badaniu przed–po.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: siedem sposobów liczenia w 200 symulacjach
Jedne dane mogą mieć szczęście albo pecha, więc wygenerowaliśmy 200 nowych sieci i w każdej policzyliśmy efekt siedmioma sposobami. Trzy są nowe. TWFE to jedna regresja z efektami stałymi klienta i miesiąca dla wszystkich kohort naraz. Druga metoda to DiD z grupą porównawczą bez warunku zakupu w miesiącu zapisu. Trzecia to DiD z nieczłonkami ważonymi tak, by mieli podobne wydatki sprzed zapisu.
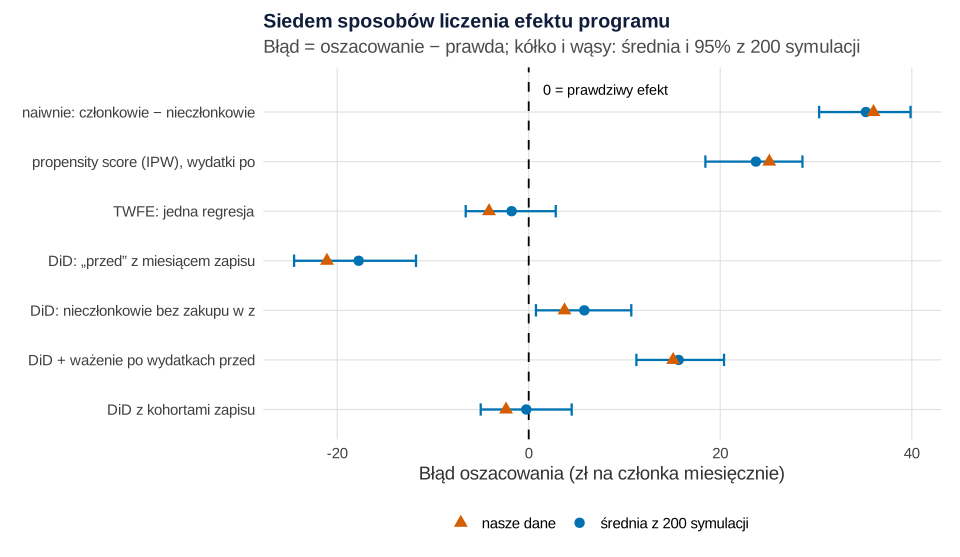
set.seed(6701)).Co widać. DiD z kohortami zapisu myli się średnio o −0.25 zł (błąd Monte Carlo 0.18), a 95% błędów mieści się między −5.01 a 4.49 zł. Naiwne porównanie zawyża o 35.21 zł, a propensity score o 23.73 zł. Pułapka miesiąca zapisu zaniża o 17.76 zł. Nieczłonkowie bez warunku zakupu zawyżają o 5.81 zł, bo część z nich właśnie odchodzi z sieci. Ważenie po wydatkach sprzed zapisu zawyża aż o 15.65 zł. Daw i Hatfield (2018) opisali ten mechanizm: gdy przydział wiąże się z poziomem wyniku, dopasowanie na poziomie sprzed interwencji wprowadza regresję do średniej.
Jak może zmylić. TWFE wyszło tu blisko prawdy (średnio −1.79 zł, w naszych danych 12.77 zł wobec 16.91). Przy zróżnicowanym momencie zapisu jedna regresja jest jednak średnią ważoną wielu porównań 2 × 2, także członków zapisanych wcześniej z późniejszymi. Gdy efekt zmienia się w czasie, bywa mocno obciążona (Goodman-Bacon, 2021). Nowsze metody dla takich danych porządkują Roth i in. (2023).
Podpis do pracy:
Co z tym zrobić w marketingu
- Policz opłacalność z efektu, nie z różnicy. Przy marży 35% i koszcie punktów 3% wydatków członków (parametry ustalone ręcznie) punkty kosztowały sieć 44 tys. zł do końca danych. Naiwna różnica obiecuje 166 tys. zł dodatkowej marży. DiD daje 46 tys. zł, 95% CI [29, 63], a prawda to 53 tys. zł. Program jest na granicy opłacalności, a nie zwraca się prawie cztery razy.
- Nie raportuj „członkowie wydają więcej”. To prawda o członkach, nie o programie.
- Następną zmianę sprawdź eksperymentem. Nowy próg punktów albo kupon dla członków można przydzielić losowo części klientów (test A/B).
- Patrz dłużej niż miesiąc. Efekt rośnie przez pół roku. Retencję członków i nieczłonków porównasz krzywymi przeżycia (churn jako analiza przeżycia), a wartość klienta – w modelu z wpisu CLV.
Zmiany retencji w kolejnych kohortach klientów po starcie programu pokazuje analiza kohortowa retencji. To, czy klient jest jeszcze aktywny, ocenia model BG/NBD. Czy wierność klientów to cecha marki, czy jej wielkości, pokazuje prawo podwójnego zagrożenia.
Jak opisać w pracy
W Metodzie opisz, kto mógł się zapisać i kiedy, jak zdefiniowano próbę (aktywni przed startem), okres przed i po dla każdej kohorty, grupę porównawczą i sposób liczenia przedziałów. W Wynikach pokaż rysunek 2 (samoselekcja), model zdarzeń i średni efekt z przedziałem. W Dyskusji nazwij założenia: podobne zmiany wydatków bez programu i brak innych zmian dotyczących tylko członków. Więcej wskazówek: statystyka w pracy z marketingu.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy generator, dane, paletę i motyw, przepisy 2–4 liczą porównania, przepis 5 – symulację, a przepis 6 rysuje grafikę z liczbami z przepisów 2–4. Przepisy 2–6 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1, 3, 4 i 5; każdy zaczyna od własnego ziarna: set.seed(670) w przepisach 1 i 3 (dopasowanie w przepisie 3 nie losuje, ziarno jest dla porządku), set.seed(6700) w przepisie 4 (bootstrap, 300 prób) i set.seed(6701) w przepisie 5 (200 symulowanych sieci). Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono (przepis 1): 3000 klientów, poziom wydatków (150 zł + 30 zł za każde kolejne dziecko − 4 zł za kilometr do sklepu + 20 zł × przywiązanie do sieci), dodatek na niemowlę (do 90 zł, malejąco do 30. miesiąca życia), sezon, szansę zakupu w miesiącu (85%) i dużego zakupu (3%, +350 zł), szum (SD = 40 zł), odejścia z sieci (0.8% miesięcznie, 2.8% przy dziecku starszym niż 4 lata), start programu (miesiąc 9), zapisy (miesiące 9–20, szansa zależna od przywiązania, liczby i wieku dzieci, dużego zakupu i startu programu) oraz efekt programu (10 zł w pierwszym miesiącu z kartą, rosnący do około 30 zł). W przepisie 4 ręcznie ustalono marżę (35%) i koszt punktów (3% wydatków członków), a okno „przed” (6 miesięcy) – przed obejrzeniem wyników. Po pierwszych uruchomieniach zmieniono: szansę zapisu (wyraz wolny −4.6 → −4.3, więcej członków), moment dużego zakupu (w miesiącu zapisu, wcześniej miesiąc przed nim) oraz sposób powstawania miesięcy bez zakupu (osobne losowanie zakupu zamiast obcinania ujemnych wydatków do zera; poziom 110 → 150 zł, szum 50 → 40 zł). Cały kod liczy się w około pół minuty.
1. Dane: 3000 klientów, 24 miesiące, zapisy do programu
R
# Przepis 1. Fikcyjna sieć sklepów z artykułami dziecięcymi: 3000 klientów, 24 miesiące, program od miesiąca 9
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c("Członkowie programu" = "#D55E00", "Nieczłonkowie" = "#0072B2")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Generator. Parametry ustalono ręcznie (zł miesięcznie): poziom klienta 150 + 30 za każde kolejne dziecko
# − 4 za km do sklepu + 20 × nieobserwowane przywiązanie do sieci (u); niemowlę dokłada do 90 zł, malejąco
# do 30. miesiąca życia; sezon (wyprawka w sierpniu–wrześniu, święta w listopadzie–grudniu); zakup w danym
# miesiącu z szansą 85%; duży zakup (wózek, fotelik) z szansą 3%, +350 zł; szum SD 40; odejście z sieci
# z ryzykiem 0.8% miesięcznie (2.8%, gdy najmłodsze dziecko ma ponad 4 lata). Program rusza w miesiącu 9.
# Zapisać się można przy kasie w miesiącach 9–20 – częściej robią to klienci przywiązani do sieci, z dwójką
# i trójką dzieci, z niemowlęciem i podczas dużego zakupu. Punkty działają od miesiąca po zapisie.
# Prawdziwy efekt: +10 zł w pierwszym miesiącu, potem rośnie do ok. +30 zł (punkty i kupony).
# Po pierwszych uruchomieniach zmieniono: wyraz wolny szansy zapisu (−4.6 → −4.3, więcej członków), zapis
# przy kasie w miesiącu zakupu (wcześniej: duży zakup miesiąc przed zapisem) oraz osobne losowanie, czy
# klient coś kupił (poziom 110 → 150 zł, szum SD 50 → 40), żeby zera nie brały się z obcinania. Ziarna nie zmieniano.
generuj <- function(n = 3000, start = 9, ost_zapis = 20) {
  M <- 24
  dzieci <- sample(1:3, n, replace = TRUE, prob = c(0.55, 0.33, 0.12))
  wiek <- outer(runif(n, 0, 60), 0:(M - 1), "+")          # wiek najmłodszego dziecka (miesiące)
  odl <- round(rlnorm(n, log(4), 0.6), 1)                  # km do najbliższego sklepu
  online <- round(rbeta(n, 2, 5), 2)                       # udział zakupów w sklepie internetowym
  u <- rnorm(n)                                            # przywiązanie do sieci – w danych go nie ma
  poziom <- 150 + 30 * (dzieci - 1) - 4 * odl + 20 * u + rnorm(n, 0, 15)
  sezon <- c(0, 0, 0, 0, 0, 0, 0, 25, 20, 0, 15, 45)[(0:(M - 1)) %% 12 + 1]
  aktywny <- matrix(1L, n, M)                              # klient nadal kupuje w sieci?
  for (m in 2:M) aktywny[, m] <- aktywny[, m - 1] * rbinom(n, 1, 1 - ifelse(wiek[, m] > 48, 0.028, 0.008))
  kupil <- aktywny * matrix(rbinom(n * M, 1, 0.85), n)     # czy w tym miesiącu był zakup
  duzy <- kupil * matrix(rbinom(n * M, 1, 0.03), n)        # duży zakup
  baza <- outer(poziom, rep(1, M)) + 90 * pmax(0, 1 - wiek / 30) + outer(rep(1, n), sezon) +
    350 * duzy + matrix(rnorm(n * M, 0, 40), n)
  Y0 <- round(kupil * pmax(10, baza))                      # wydatki bez programu
  zapis <- rep(NA_integer_, n)                             # miesiąc zapisu (przy kasie, podczas zakupu)
  for (m in start:ost_zapis) {
    mozna <- is.na(zapis) & kupil[, m] == 1               # zapisać się może tylko ktoś, kto właśnie kupuje
    p <- plogis(-4.3 + 0.7 * u + 0.5 * (dzieci - 1) + 1.0 * (wiek[, m] < 18) + 2.3 * duzy[, m] + 0.9 * (m <= 10))
    zapis[mozna & runif(n) < p] <- m
  }
  e <- outer(rep(1, n), 1:M) - outer(zapis, rep(1, M))     # miesiące od zapisu (NA dla nieczłonków)
  tau <- ifelse(!is.na(e) & e >= 1, 10 + 20 * (1 - exp(-(e - 1) / 4)), 0)   # punkty działają od miesiąca po zapisie
  Y1 <- round(kupil * pmax(10, baza + tau))                # wydatki z programem
  Y <- ifelse(!is.na(e) & e >= 1, Y1, Y0)                  # to widzi firma
  list(Y = Y, Y0 = Y0, Y1 = Y1, zapis = zapis, dzieci = dzieci, wiek8 = round(wiek[, 8]), odl = odl,
       online = online, aktywny = aktywny, duzy = duzy, u = u)
}

set.seed(670)                                              # ziarno ustalone raz, bez dobierania pod wynik
g <- generuj()
Y <- g$Y; zapis <- g$zapis; czl <- !is.na(zapis)
klienci <- data.frame(klient = sprintf("K%04d", seq_along(zapis)), zapis_od = zapis, dzieci = g$dzieci,
                      wiek_dziecka_m8 = g$wiek8, odleglosc_km = g$odl, udzial_online = g$online,
                      setNames(as.data.frame(Y), sprintf("wyd_m%02d", 1:24)))
write.csv(klienci, "program-lojalnosciowy-sklepy-dzieciece.csv", row.names = FALSE, na = "")

# Cechy sprzed startu programu (miesiące 1–8) – kandydaci do modelu propensity score
klienci$wyd_przed <- rowMeans(Y[, 1:8])                    # średnie wydatki miesięczne
klienci$mies_z_zakupem <- rowSums(Y[, 1:8] > 0)            # w ilu miesiącach coś kupił
klienci$czlonek <- as.integer(czl)
aktywny_start <- rowSums(Y[, 6:8]) > 0                     # kupił coś w miesiącach 6–8 = próba do analizy

# Prawda (znana tylko w symulacji): średni efekt w miesiącach po miesiącu zapisu, członkowie z próby
po_zapisie <- outer(czl & aktywny_start, rep(TRUE, 24)) & outer(zapis, rep(1, 24)) < outer(rep(1, nrow(Y)), 1:24)
po_zapisie[is.na(po_zapisie)] <- FALSE
prawda <- mean((g$Y1 - g$Y0)[po_zapisie])

cat("Klienci w bazie:", nrow(Y), " aktywni na starcie programu (zakup w miesiącach 6–8):", sum(aktywny_start), "\n")
cat("Członkowie:", sum(czl), sprintf("(%.1f%% bazy)", 100 * mean(czl)), " w tym w próbie:", sum(czl & aktywny_start), "\n")
cat("Zapisy według miesiąca:\n"); print(table(factor(zapis, levels = 9:20)))
cat("Członkowie z dużym zakupem w miesiącu zapisu:", sprintf("%.1f%%",
    100 * mean(g$duzy[cbind(which(czl), zapis[czl])])), " (w zwykłym miesiącu: 3%)\n")
cat("Komórek klient × miesiąc po zapisie:", sum(po_zapisie), "\n")
cat(sprintf("Prawdziwy średni efekt programu (ATT): %.2f zł miesięcznie na członka\n", prawda))
Wynik w R
Klienci w bazie: 3000  aktywni na starcie programu (zakup w miesiącach 6–8): 2803
Członkowie: 776 (25.9% bazy)  w tym w próbie: 773
Zapisy według miesiąca:

  9  10  11  12  13  14  15  16  17  18  19  20
191 165  59  58  50  36  43  31  44  37  45  17
Członkowie z dużym zakupem w miesiącu zapisu: 20.1%  (w zwykłym miesiącu: 3%)
Komórek klient × miesiąc po zapisie: 8967
Prawdziwy średni efekt programu (ATT): 16.91 zł miesięcznie na członka
2. Naiwne porównanie i wydatki przed startem: Rysunek 2
R
# Przepis 2. Naiwne porównanie członków i nieczłonków oraz wydatki przed startem programu: Rysunek 2
# (korzysta z Y, zapis, czl, aktywny_start, kol i motyw z przepisu 1)
library(ggplot2); library(fixest)

n <- nrow(Y)
dl <- data.frame(id = rep(1:n, times = 24), miesiac = rep(1:24, each = n), wydatki = as.vector(Y),
                 zapis = rep(zapis, times = 24), proba = rep(aktywny_start, times = 24))
dl$czlonek <- !is.na(dl$zapis)
dl$po_zapisie <- dl$czlonek & dl$miesiac > dl$zapis       # miesiące, w których członek zbiera punkty

# Naiwnie: miesiące członków po zapisie wobec nieczłonków w tych samych miesiącach (efekty stałe miesiąca)
naiwnie <- function(d) {
  d <- subset(d, po_zapisie | (!czlonek & miesiac >= 10))
  m <- feols(wydatki ~ po_zapisie | miesiac, data = d, vcov = ~id)
  c(czlonkowie = mean(d$wydatki[d$po_zapisie]), nieczlonkowie = mean(d$wydatki[!d$czlonek]),
    roznica = unname(coef(m)), lo = confint(m)[1, 1], hi = confint(m)[1, 2])
}
n_baza <- naiwnie(dl); n_proba <- naiwnie(subset(dl, proba))
cat("Naiwne porównanie (zł miesięcznie): członkowie po zapisie vs nieczłonkowie w tych samych miesiącach\n")
cat(format("", width = 42), " członek  nieczł.\n")
pokaz <- function(x, opis) cat(format(opis, width = 42), sprintf("%7.2f %7.2f   różnica %6.2f  95%% CI [%.2f, %.2f]\n",
                                                                x[1], x[2], x[3], x[4], x[5]))
pokaz(n_baza, "cała baza (z klientami, którzy odeszli):"); pokaz(n_proba, "aktywni na starcie programu:")

# Samoselekcja: kto się zapisał, wydawał więcej, zanim program w ogóle istniał
przed <- rowMeans(Y[, 1:8])
cat(sprintf("\nMiesiące 1–8 (przed startem): przyszli członkowie %.2f zł, nieczłonkowie %.2f zł, różnica %.2f zł\n",
            mean(przed[czl & aktywny_start]), mean(przed[!czl & aktywny_start]),
            mean(przed[czl & aktywny_start]) - mean(przed[!czl & aktywny_start])))

# Rysunek 2: średnie wydatki w kalendarzu – przyszli członkowie i nieczłonkowie (aktywni na starcie)
tr <- data.frame(miesiac = rep(1:24, 2), grupa = factor(rep(names(kol), each = 24), levels = names(kol)),
                 wydatki = c(colMeans(Y[czl & aktywny_start, ]), colMeans(Y[!czl & aktywny_start, ])))
p2 <- ggplot(tr, aes(miesiac, wydatki, colour = grupa, shape = grupa, linetype = grupa)) +
  annotate("rect", xmin = 8.5, xmax = 20.5, ymin = -Inf, ymax = Inf, fill = "#F5E3D6", alpha = 0.5) +
  annotate("text", x = 14.5, y = 262, label = "zapisy do programu (miesiące 9–20)", size = 3.8, colour = "grey25") +
  annotate("text", x = 4.5, y = 262, label = "programu jeszcze nie ma", size = 3.8, colour = "grey25") +
  geom_line(linewidth = 0.9) + geom_point(size = 2.3) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(17, 16), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_x_continuous(breaks = c(1, 4, 8, 9, 12, 16, 20, 24)) + scale_y_continuous(limits = c(80, 270)) +
  labs(title = "Członkowie wydawali więcej, zanim program powstał",
       subtitle = "Średnie wydatki miesięczne klientów aktywnych na starcie programu",
       x = "Miesiąc (program rusza w miesiącu 9)", y = "Wydatki na klienta (zł)") + motyw
p2   # zapis: ggsave("program-lojalnosciowy-wydatki-w-czasie.svg", p2, width = 10, height = 5.6)
Wynik w R
Naiwne porównanie (zł miesięcznie): członkowie po zapisie vs nieczłonkowie w tych samych miesiącach
                                            członek  nieczł.
cała baza (z klientami, którzy odeszli):    163.28  103.58   różnica  62.14  95% CI [56.75, 67.53]
aktywni na starcie programu:                163.43  113.13   różnica  52.91  95% CI [47.56, 58.26]

Miesiące 1–8 (przed startem): przyszli członkowie 171.67 zł, nieczłonkowie 145.29 zł, różnica 26.38 zł
3. Propensity score: ważenie, dopasowanie i zbalansowanie: Rysunek 3
R
# Przepis 3. Propensity score: ważenie (WeightIt) i dopasowanie (MatchIt), zbalansowanie i wynik: Rysunek 3
# (korzysta z klienci, aktywny_start, g, motyw z przepisu 1 oraz dl i naiwnie() z przepisu 2)
library(ggplot2); library(fixest); library(WeightIt); library(MatchIt)

k <- klienci[aktywny_start, ]
k$id <- which(aktywny_start)
f_ps <- czlonek ~ wyd_przed + mies_z_zakupem + factor(dzieci) + wiek_dziecka_m8 + odleglosc_km + udzial_online
W <- weightit(f_ps, data = k, method = "glm", estimand = "ATT")         # wagi ATT: nieczłonkowie ps / (1 − ps)
k$w_ipw <- W$weights
set.seed(670)                                              # dopasowanie bez losowości; ziarno dla porządku
M <- matchit(f_ps, data = k, method = "nearest", distance = "glm", caliper = 0.2, ratio = 1)
k$w_dop <- M$weights
cat("Ważenie: efektywna liczba nieczłonków", round(sum(k$w_ipw[k$czlonek == 0])^2 / sum(k$w_ipw[k$czlonek == 0]^2)),
    "z", sum(k$czlonek == 0), "\n")
cat("Dopasowanie 1:1 (kaliper 0.2 SD logitu ps): par", sum(k$w_dop[k$czlonek == 1] > 0),
    "z", sum(k$czlonek == 1), "członków\n")

# Standaryzowana różnica średnich (SMD): mianownik – odchylenie z próby przed korektą (Austin, 2009)
k$przywiazanie <- g$u[k$id]                                # nieobserwowane – znamy je tylko dzięki symulacji
zm <- c(wyd_przed = "wydatki w miesiącach 1–8", mies_z_zakupem = "miesiące z zakupem (1–8)",
        dzieci = "liczba dzieci", wiek_dziecka_m8 = "wiek najmłodszego dziecka",
        odleglosc_km = "odległość od sklepu", udzial_online = "udział zakupów online",
        przywiazanie = "przywiązanie do sieci\n(nieobserwowane)")
smd <- function(x, t, w) {
  s <- sqrt((var(x[t == 1]) + var(x[t == 0])) / 2)
  (weighted.mean(x[t == 1], w[t == 1]) - weighted.mean(x[t == 0], w[t == 0])) / s
}
bal <- do.call(rbind, lapply(names(zm), function(v) data.frame(zmienna = zm[[v]],
  wersja = c("przed korektą", "ważenie (IPW)", "dopasowanie 1:1"),
  smd = c(smd(k[[v]], k$czlonek, rep(1, nrow(k))), smd(k[[v]], k$czlonek, k$w_ipw), smd(k[[v]], k$czlonek, k$w_dop)))))
bal$wersja <- factor(bal$wersja, levels = c("przed korektą", "ważenie (IPW)", "dopasowanie 1:1"))
bal$zmienna <- factor(bal$zmienna, levels = rev(unname(zm)))
cat("\nStandaryzowane różnice średnich (członkowie − nieczłonkowie):\n")
tab_bal <- matrix(round(bal$smd, 2), ncol = 3, byrow = TRUE, dimnames = list(names(zm), c("przed", "IPW", "dopasowanie")))
print(tab_bal)

# Efekt programu po korekcie: te same porównania co w przepisie 2, z wagami
dw <- subset(dl, proba & (po_zapisie | (!czlonek & miesiac >= 10)))
dw$w_ipw <- k$w_ipw[match(dw$id, k$id)]; dw$w_dop <- k$w_dop[match(dw$id, k$id)]
m_ipw <- feols(wydatki ~ po_zapisie | miesiac, data = dw, weights = ~w_ipw, vcov = ~id)
m_dop <- feols(wydatki ~ po_zapisie | miesiac, data = subset(dw, w_dop > 0), weights = ~w_dop, vcov = ~id)
ps_wyn <- rbind(ipw = c(coef(m_ipw), unlist(confint(m_ipw)[1, ])), dopasowanie = c(coef(m_dop), unlist(confint(m_dop)[1, ])))
cat("\nEfekt programu po korekcie (zł miesięcznie):\n")
cat(sprintf("%-12s %6.2f  95%% CI [%.2f, %.2f]\n", rownames(ps_wyn), ps_wyn[, 1], ps_wyn[, 2], ps_wyn[, 3]), sep = "")
cat(sprintf("Prawda: %.2f zł\n", prawda))

kw <- c("przed korektą" = "grey45", "ważenie (IPW)" = "#0072B2", "dopasowanie 1:1" = "#D55E00")
p3 <- ggplot(bal, aes(smd, zmienna, colour = wersja, shape = wersja)) +
  annotate("rect", xmin = -0.1, xmax = 0.1, ymin = -Inf, ymax = Inf, fill = "grey92") +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_point(size = 3.2, stroke = 1.1, position = position_dodge(width = 0.5)) +
  scale_colour_manual(values = kw, name = NULL) + scale_shape_manual(values = c(16, 15, 17), name = NULL) +
  labs(title = "Zbalansowanie cech przed korektą i po niej",
       subtitle = "Szare pole: |SMD| < 0.1; ostatniej cechy w danych nie ma – znamy ją z symulacji",
       x = "Standaryzowana różnica średnich (członkowie − nieczłonkowie)", y = NULL) + motyw
p3   # zapis: ggsave("program-lojalnosciowy-zbalansowanie.svg", p3, width = 10, height = 6)
Wynik w R
Ważenie: efektywna liczba nieczłonków 1304 z 2030
Dopasowanie 1:1 (kaliper 0.2 SD logitu ps): par 752 z 773 członków

Standaryzowane różnice średnich (członkowie − nieczłonkowie):
                przed   IPW dopasowanie
wyd_przed        0.53 -0.01        0.03
mies_z_zakupem   0.03 -0.01        0.04
dzieci           0.35  0.01        0.05
wiek_dziecka_m8 -0.27 -0.01        0.01
odleglosc_km     0.02  0.01        0.02
udzial_online    0.01  0.00       -0.04
przywiazanie     0.73  0.57        0.58

Efekt programu po korekcie (zł miesięcznie):
ipw           42.03  95% CI [36.00, 48.05]
dopasowanie   42.50  95% CI [36.02, 48.98]
Prawda: 16.91 zł
4. Różnica w różnicach z kohortami zapisu i model zdarzeń: Rysunek 4
R
# Przepis 4. Różnica w różnicach z kohortami zapisu, model zdarzeń i warianty z pułapkami: Rysunek 4
# (korzysta z Y, zapis, czl, aktywny_start, g, prawda, motyw z przepisu 1 oraz dl i n_proba z przepisu 2)
library(ggplot2); library(fixest)

# Dla każdej kohorty (miesiąc zapisu z): członkowie z tej kohorty vs nieczłonkowie, którzy też coś kupili
# w miesiącu z. „Przed” = miesiące z−6…z−1, miesiąc zapisu pomijamy. Wynik: różnica w różnicach dla
# każdego miesiąca kalendarza, potem średnia ważona liczbą członków kohorty.
did_kohorty <- function(Y, zapis, ids, przed = -6:-1, zakup_w_z = TRUE, dopasuj_wydatki = FALSE) {
  czl <- !is.na(zapis); wyn <- list()
  for (z in 9:20) {
    T_ <- ids[czl[ids] & zapis[ids] %in% z]
    if (length(T_) == 0) next
    C_ <- ids[!czl[ids]]
    if (zakup_w_z) C_ <- C_[Y[C_, z] > 0]                  # nieczłonek też musiał być wtedy w sklepie
    w <- rep(1, length(C_))
    if (dopasuj_wydatki) {                                 # PUŁAPKA: wagi z poziomu wydatków sprzed zapisu
      wp <- rowMeans(Y[c(T_, C_), z + przed, drop = FALSE]); t <- rep(1:0, c(length(T_), length(C_)))
      ps <- fitted(glm(t ~ wp, family = binomial)); w <- (ps / (1 - ps))[t == 0]
    }
    bazaT <- mean(Y[T_, z + przed]); bazaC <- weighted.mean(rowMeans(Y[C_, z + przed, drop = FALSE]), w)
    wyn[[length(wyn) + 1]] <- data.frame(z = z, miesiac = 1:24, e = 1:24 - z, nT = length(T_),
      d = (colMeans(Y[T_, , drop = FALSE]) - bazaT) - (colSums(Y[C_, , drop = FALSE] * w) / sum(w) - bazaC))
  }
  do.call(rbind, wyn)
}
att <- function(r, kohorty = 9:20) { p <- subset(r, e >= 1 & z %in% kohorty); weighted.mean(p$d, p$nT) }
zdarzenia <- function(r) { a <- aggregate(cbind(dn = d * nT, nT) ~ e, data = r, FUN = sum); setNames(a$dn / a$nT, a$e) }

ids0 <- which(aktywny_start)                               # próba: aktywni na starcie programu
r <- did_kohorty(Y, zapis, ids0)
warianty <- c("DiD z kohortami (przed: z−6…z−1)" = att(r),
              "„przed” = z−2…z (z miesiącem zapisu)" = att(did_kohorty(Y, zapis, ids0, przed = -2:0)),
              "nieczłonkowie bez warunku zakupu w z" = att(did_kohorty(Y, zapis, ids0, zakup_w_z = FALSE)),
              "ważenie po wydatkach sprzed zapisu" = att(did_kohorty(Y, zapis, ids0, dopasuj_wydatki = TRUE)))

# Przedział: bootstrap klientów (losujemy klientów ze zwracaniem i liczymy wszystko od nowa)
set.seed(6700)
B <- 300
boot <- replicate(B, { rb <- did_kohorty(Y, zapis, sample(ids0, replace = TRUE))
  c(att = att(rb), zdarzenia(rb)[as.character(-8:12)]) })
ci <- apply(boot, 1, quantile, c(0.025, 0.975), na.rm = TRUE)
cat(sprintf("DiD z kohortami zapisu: %.2f zł, 95%% CI [%.2f, %.2f] (bootstrap, %d prób); prawda %.2f zł\n",
            warianty[1], ci[1, "att"], ci[2, "att"], B, prawda))
cat("\nWarianty na tych samych danych (zł miesięcznie):\n")
cat(paste0("  ", format(names(warianty), width = 40), sprintf("%7.2f", warianty)), sep = "\n")

# Klasyczna regresja z efektami stałymi klienta i miesiąca (TWFE) na wszystkich miesiącach
m_twfe <- feols(wydatki ~ po_zapisie | id + miesiac, data = subset(dl, proba), vcov = ~id)
cat(paste0("  ", format("TWFE: jedna regresja, wszystkie kohorty", width = 40),
           sprintf("%7.2f  95%% CI [%.2f, %.2f]", coef(m_twfe), confint(m_twfe)[1, 1], confint(m_twfe)[1, 2])), "\n")

grupy <- list("9–10 (start programu)" = 9:10, "11–14" = 11:14, "15–20" = 15:20)
cat("\nEfekt według kohorty zapisu (zł):\n")
for (nm in names(grupy)) cat("  zapis w miesiącach", format(nm, width = 22), sprintf("%6.2f", att(r, grupy[[nm]])), "\n")

# Rysunek 4: model zdarzeń – różnica w różnicach według miesięcy od zapisu
E <- outer(rep(1, nrow(Y)), 1:24) - outer(zapis, rep(1, 24)); E[!aktywny_start, ] <- NA
ef <- tapply((g$Y1 - g$Y0)[!is.na(E) & E >= 1], E[!is.na(E) & E >= 1], mean)
zd <- data.frame(e = -8:12, b = zdarzenia(r)[as.character(-8:12)], lo = ci[1, -1], hi = ci[2, -1])
zd$okres <- factor(ifelse(zd$e < 0, "przed zapisem", ifelse(zd$e == 0, "miesiąc zapisu", "z kartą")),
                   levels = c("przed zapisem", "miesiąc zapisu", "z kartą"))
cat("\nModel zdarzeń (zł względem średniej z miesięcy z−6…z−1):\n"); print(round(setNames(zd$b, zd$e), 1))
cat("Prawdziwy efekt w 1., 6. i 12. miesiącu z kartą:", round(ef[c("1", "6", "12")], 1), "\n")

# Czy program się opłaca? Ręczne parametry: marża 35% od dodatkowej sprzedaży, koszt punktów 3% wydatków członków
po <- outer(czl & aktywny_start, rep(TRUE, 24)) & outer(zapis, rep(1, 24)) < outer(rep(1, nrow(Y)), 1:24)
po[is.na(po)] <- FALSE
koszt <- 0.03 * sum(Y[po]) / 1000; marza <- function(efekt) 0.35 * efekt * sum(po) / 1000
cat(sprintf("\nKoszt punktów: %.0f tys. zł. Dodatkowa marża (tys. zł): naiwnie %.0f, DiD %.0f [%.0f, %.0f], prawda %.0f\n",
            koszt, marza(n_proba[3]), marza(warianty[1]), marza(ci[1, "att"]), marza(ci[2, "att"]), marza(prawda)))

ko <- c("przed zapisem" = "grey40", "miesiąc zapisu" = "#56B4E9", "z kartą" = "#D55E00")
p4 <- ggplot(zd, aes(e, b, colour = okres, shape = okres)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_line(data = data.frame(e = as.numeric(names(ef))[1:12], b = ef[1:12]), aes(e, b),
            inherit.aes = FALSE, linetype = "dashed", linewidth = 0.8) +
  annotate("text", x = 3.2, y = 45, label = "linia przerywana: prawdziwy efekt", hjust = 0, size = 3.8) +
  geom_errorbar(aes(ymin = lo, ymax = hi), width = 0.3, linewidth = 0.6) + geom_point(size = 2.8) +
  scale_colour_manual(values = ko, name = NULL) + scale_shape_manual(values = c(16, 15, 17), name = NULL) +
  scale_x_continuous(breaks = seq(-8, 12, 2)) +
  labs(title = "Wydatki członków względem nieczłonków, miesiąc po miesiącu",
       subtitle = "Zero = średnia z 6 miesięcy przed zapisem; 95% CI z bootstrapu klientów",
       x = "Miesiące od zapisu (0 = miesiąc zapisu przy kasie)", y = "Różnica w różnicach (zł)") + motyw
p4   # zapis: ggsave("program-lojalnosciowy-model-zdarzen.svg", p4, width = 10, height = 5.8)
Wynik w R
DiD z kohortami zapisu: 14.54 zł, 95% CI [9.21, 20.04] (bootstrap, 300 prób); prawda 16.91 zł

Warianty na tych samych danych (zł miesięcznie):
  DiD z kohortami (przed: z−6…z−1)          14.54
  „przed” = z−2…z (z miesiącem zapisu)      -4.16
  nieczłonkowie bez warunku zakupu w z      20.64
  ważenie po wydatkach sprzed zapisu        31.99
  TWFE: jedna regresja, wszystkie kohorty   12.77  95% CI [7.84, 17.69]

Efekt według kohorty zapisu (zł):
  zapis w miesiącach 9–10 (start programu)   15.02
  zapis w miesiącach 11–14                   14.04
  zapis w miesiącach 15–20                   13.66

Model zdarzeń (zł względem średniej z miesięcy z−6…z−1):
  -8   -7   -6   -5   -4   -3   -2   -1    0    1    2    3    4    5    6    7
 6.1 -0.2  0.7 -1.3 -1.3  7.8 -6.5  0.7 63.9 13.8 11.1 17.3 16.5 19.9 17.9 14.3
   8    9   10   11   12
20.1 20.1 15.2 13.7  5.2
Prawdziwy efekt w 1., 6. i 12. miesiącu z kartą: 8.4 19.1 18.8

Koszt punktów: 44 tys. zł. Dodatkowa marża (tys. zł): naiwnie 166, DiD 46 [29, 63], prawda 53
5. 200 symulowanych sieci: siedem metod: Rysunek 5
R
# Przepis 5. 200 symulowanych sieci: które porównanie trafia w prawdziwy efekt? Rysunek 5
# (korzysta z generuj() i motyw z przepisu 1, did_kohorty() i att() z przepisu 4 oraz n_proba, ps_wyn,
#  warianty i m_twfe z przepisów 2–4 – to oszacowania z naszych danych)
library(ggplot2); library(fixest)

jedna_siec <- function(g) {
  Y <- g$Y; zapis <- g$zapis; czl <- !is.na(zapis); n <- nrow(Y)
  proba <- rowSums(Y[, 6:8]) > 0; ids <- which(proba)
  po <- outer(czl & proba, rep(TRUE, 24)) & outer(zapis, rep(1, 24)) < outer(rep(1, n), 1:24); po[is.na(po)] <- FALSE
  d <- data.frame(id = rep(1:n, 24), miesiac = rep(1:24, each = n), wydatki = as.vector(Y), po = as.vector(po),
                  czlonek = rep(czl, 24))[rep(proba, 24), ]
  # propensity score z cech sprzed startu (to samo co weightit(..., estimand = "ATT") w przepisie 3)
  k <- data.frame(t = as.integer(czl), wp = rowMeans(Y[, 1:8]), mz = rowSums(Y[, 1:8] > 0), dz = g$dzieci,
                  wiek = g$wiek8, odl = g$odl, onl = g$online)[proba, ]
  ps <- fitted(glm(t ~ wp + mz + factor(dz) + wiek + odl + onl, family = binomial, data = k))
  d$w <- ifelse(k$t == 1, 1, ps / (1 - ps))[match(d$id, ids)]
  dp <- subset(d, po | (!czlonek & miesiac >= 10))
  c(prawda = mean((g$Y1 - g$Y0)[po]),
    naiwnie = unname(coef(feols(wydatki ~ po | miesiac, dp))),
    ipw = unname(coef(feols(wydatki ~ po | miesiac, dp, weights = ~w))),
    twfe = unname(coef(feols(wydatki ~ po | id + miesiac, d))),
    przed_z_zapisem = att(did_kohorty(Y, zapis, ids, przed = -2:0)),
    bez_warunku = att(did_kohorty(Y, zapis, ids, zakup_w_z = FALSE)),
    wazenie_wydatki = att(did_kohorty(Y, zapis, ids, dopasuj_wydatki = TRUE)),
    did_kohorty = att(did_kohorty(Y, zapis, ids)))
}

set.seed(6701)                                             # osobne ziarno dla symulacji
R <- 200
sym <- t(replicate(R, jedna_siec(generuj())))
obc <- sym[, -1] - sym[, "prawda"]                          # błąd każdej metody w każdej sieci
metody <- c(naiwnie = "naiwnie: członkowie − nieczłonkowie", ipw = "propensity score (IPW), wydatki po",
            twfe = "TWFE: jedna regresja", przed_z_zapisem = "DiD: „przed” z miesiącem zapisu",
            bez_warunku = "DiD: nieczłonkowie bez zakupu w z", wazenie_wydatki = "DiD + ważenie po wydatkach przed",
            did_kohorty = "DiD z kohortami zapisu")
nasze <- c(n_proba[3], ps_wyn["ipw", 1], coef(m_twfe), warianty[2], warianty[3], warianty[4], warianty[1])
wyn <- data.frame(metoda = factor(metody, levels = rev(metody)), obciazenie = colMeans(obc),
                  blad_mc = apply(obc, 2, sd) / sqrt(R), q025 = apply(obc, 2, quantile, 0.025),
                  q975 = apply(obc, 2, quantile, 0.975), nasze = nasze - prawda)
cat(sprintf("Średni prawdziwy efekt w %d sieciach: %.2f zł (od %.2f do %.2f)\n", R, mean(sym[, "prawda"]),
            min(sym[, "prawda"]), max(sym[, "prawda"])))
cat("Błąd oszacowania = oszacowanie − prawda (zł miesięcznie)\n")
cat(paste0(format(metody, width = 38), sprintf("obciążenie %6.2f (błąd MC %.2f)  95%% błędów [%6.2f, %6.2f]  nasze %6.2f",
           wyn$obciazenie, wyn$blad_mc, wyn$q025, wyn$q975, wyn$nasze)), sep = "\n")

p5 <- ggplot(wyn, aes(y = metoda)) +
  geom_vline(xintercept = 0, linetype = "dashed") +
  annotate("text", x = 1.5, y = 7.45, label = "0 = prawdziwy efekt", hjust = 0, size = 3.8) +
  geom_errorbar(aes(xmin = q025, xmax = q975), orientation = "y", width = 0.25, colour = "#0072B2", linewidth = 0.8) +
  geom_point(aes(x = obciazenie, shape = "średnia z 200 symulacji"), colour = "#0072B2", size = 3.2) +
  geom_point(aes(x = nasze, shape = "nasze dane"), colour = "#D55E00", size = 3.2) +
  scale_shape_manual(values = c("średnia z 200 symulacji" = 16, "nasze dane" = 17), name = NULL) +
  scale_y_discrete(expand = expansion(add = c(0.6, 0.9))) +
  labs(title = "Siedem sposobów liczenia efektu programu",
       subtitle = "Błąd = oszacowanie − prawda; kółko i wąsy: średnia i 95% z 200 symulacji",
       x = "Błąd oszacowania (zł na członka miesięcznie)", y = NULL) + motyw
p5   # zapis: ggsave("program-lojalnosciowy-symulacja.svg", p5, width = 10, height = 5.8)
Wynik w R
Średni prawdziwy efekt w 200 sieciach: 17.24 zł (od 16.51 do 17.94)
Błąd oszacowania = oszacowanie − prawda (zł miesięcznie)
naiwnie: członkowie − nieczłonkowie   obciążenie  35.21 (błąd MC 0.18)  95% błędów [ 30.32,  39.87]  nasze  36.00
propensity score (IPW), wydatki po    obciążenie  23.73 (błąd MC 0.19)  95% błędów [ 18.45,  28.58]  nasze  25.12
TWFE: jedna regresja                  obciążenie  -1.79 (błąd MC 0.18)  95% błędów [ -6.58,   2.82]  nasze  -4.14
DiD: „przed” z miesiącem zapisu       obciążenie -17.76 (błąd MC 0.23)  95% błędów [-24.50, -11.77]  nasze -21.07
DiD: nieczłonkowie bez zakupu w z     obciążenie   5.81 (błąd MC 0.19)  95% błędów [  0.76,  10.71]  nasze   3.74
DiD + ważenie po wydatkach przed      obciążenie  15.65 (błąd MC 0.16)  95% błędów [ 11.24,  20.40]  nasze  15.08
DiD z kohortami zapisu                obciążenie  -0.25 (błąd MC 0.18)  95% błędów [ -5.01,   4.49]  nasze  -2.37
6. Grafika: cztery porównania: Rysunek 1
R
# Przepis 6. Grafika: cztery porównania i prawda z symulacji (Rysunek 1)
# (korzysta z prawda i motyw z przepisu 1, n_proba z przepisu 2, ps_wyn z przepisu 3, warianty i ci z przepisu 4)
library(ggplot2)

f <- function(x) sub("-", "−", formatC(x, format = "f", digits = 2))   # minus typograficzny
karty <- data.frame(
  x = c(1, 2, 1, 2), y = c(2, 2, 1, 1),
  rodzaj = c("zle", "zle", "zle", "dobre"),
  tytul = c("1. Naiwnie", "2. Propensity score", "3. Przed i po zapisie (źle)", "4. DiD z kohortami zapisu"),
  tekst = c("członkowie vs nieczłonkowie\nw tych samych miesiącach\nmiesza efekt z tym, kto się zapisuje",
            "nieczłonkowie o podobnych cechach\nsprzed programu (ważenie IPW)\nzostaje to, czego nie zmierzono",
            "zmiana u członków − zmiana u nieczł.,\n„przed” = 3 miesiące z miesiącem zapisu\nduży zakup przy zapisie zaniża wynik",
            "każda kohorta: 6 miesięcy przed zapisem,\nnieczłonkowie, którzy też wtedy kupowali;\nmiesiąc zapisu pominięty"),
  wynik = c(paste0(f(n_proba[3]), " zł"), paste0(f(ps_wyn["ipw", 1]), " zł"), paste0(f(warianty[2]), " zł"),
            paste0(f(warianty[1]), " zł  [", f(ci[1, "att"]), ", ", f(ci[2, "att"]), "]")))
wyp <- c(zle = "grey93", dobre = "#FBE3D3"); ram <- c(zle = "grey55", dobre = "#D55E00")
strzalki <- data.frame(x = c(1.46, 1.46), xend = c(1.54, 1.54), y = c(2, 1), yend = c(2, 1))
p1 <- ggplot(karty) +
  geom_rect(aes(xmin = x - 0.45, xmax = x + 0.45, ymin = y - 0.36, ymax = y + 0.36, fill = rodzaj, colour = rodzaj),
            linewidth = 0.8) +
  geom_text(aes(x = x, y = y + 0.25, label = tytul), fontface = "bold", size = 4.4, colour = "#0f1d3a") +
  geom_text(aes(x = x, y = y + 0.02, label = tekst), size = 3.7, colour = "grey20", lineheight = 1.0) +
  geom_text(aes(x = x, y = y - 0.25, label = wynik), fontface = "bold", size = 4.6, colour = "grey10") +
  geom_segment(data = strzalki, aes(x = x, xend = xend, y = y, yend = yend),
               arrow = arrow(length = unit(0.2, "cm"), type = "closed"), colour = "grey35", linewidth = 0.7) +
  annotate("curve", x = 1.9, xend = 1.1, y = 1.62, yend = 1.38, curvature = -0.1,
           arrow = arrow(length = unit(0.2, "cm"), type = "closed"), colour = "grey35", linewidth = 0.6) +
  annotate("rect", xmin = 0.55, xmax = 2.45, ymin = 0.2, ymax = 0.48, fill = "#DCEBF7", colour = "#0072B2", linewidth = 0.8) +
  annotate("text", x = 1.5, y = 0.34, size = 4.5, colour = "grey10", fontface = "bold",
           label = paste0("Prawda znana z symulacji: ", f(prawda), " zł miesięcznie na członka")) +
  scale_fill_manual(values = wyp, guide = "none") + scale_colour_manual(values = ram, guide = "none") +
  coord_cartesian(xlim = c(0.52, 2.48), ylim = c(0.15, 2.42), expand = FALSE) +
  labs(title = "O ile program zwiększa wydatki? Cztery porównania",
       subtitle = "Ten sam zbiór danych; szare – porównania obciążone, pomarańczowe – zalecane, z 95% CI") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major = element_blank())
p1   # zapis: ggsave("program-lojalnosciowy-schemat-porownan.svg", p1, width = 10, height = 6.4)
7. Sprawdzenie palety (deuteranopia i protanopia)
R
# Przepis 7. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("członkowie – nieczłonkowie" = c("#D55E00", "#0072B2"),
             "przed korektą – IPW" = c("grey45", "#0072B2"), "IPW – dopasowanie" = c("#0072B2", "#D55E00"),
             "miesiąc zapisu – z kartą" = c("#56B4E9", "#D55E00"), "przed zapisem – miesiąc zapisu" = c("grey40", "#56B4E9"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(hex(k))),
                                   protanopia = roznica(protan(hex(k)))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
członkowie – nieczłonkowie                 114.6        108.3       91.9
przed korektą – IPW                         41.5         45.1       38.2
IPW – dopasowanie                          114.6        108.3       91.9
miesiąc zapisu – z kartą                   113.6        101.1       89.0
przed zapisem – miesiąc zapisu              45.4         45.3       43.4
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, regresję logistyczną propensity score w symulacji i bootstrap wykonano pakietem stats wbudowanym w R. Wagi propensity score policzono pakietem WeightIt, dopasowanie – pakietem MatchIt, a regresje z efektami stałymi i błędami klastrowanymi – pakietem fixest. Rysunki wykonano w pakiecie ggplot2 i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- WeightIt (wersja 2.1.0): Greifer, N. (2026). WeightIt: Weighting for covariate balance in observational studies [R package]. https://doi.org/10.32614/CRAN.package.WeightIt
- MatchIt (wersja 4.8.2): Ho, D. E., Imai, K., King, G., & Stuart, E. A. (2011). MatchIt: Nonparametric preprocessing for parametric causal inference. Journal of Statistical Software, 42(8). https://doi.org/10.18637/jss.v042.i08
- fixest (wersja 0.14.2): Bergé, L. R., Butts, K., & McDermott, G. (2026). Fast and user-friendly econometrics estimations: The R package fixest. arXiv preprint arXiv:2601.21749. https://doi.org/10.48550/arXiv.2601.21749
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Naiwne porównanie członków i nieczłonków. Mierzy, kto się zapisuje, a nie, co robi program.
- Wiara w wykres zbalansowania. Propensity score wyrównuje tylko zmierzone cechy.
- Miesiąc zapisu w okresie „przed”. Zapis przy dużym zakupie to wybór w szczycie, a potem regresja do średniej.
- Dopasowanie na wydatkach sprzed zapisu w DiD. Wygląda porządnie, a zawyża wynik.
- Przeżycie klientów. Członek był klientem w dniu zapisu, a nieczłonek mógł już odejść. Grupę porównawczą wybieraj spośród osób aktywnych w tym samym czasie.
- Jedna regresja dla wszystkich kohort. Przy zapisach rozłożonych w czasie licz efekt kohortami.
Najczęstsze pytania
Jak zmierzyć efekt programu lojalnościowego?
Porównaj zmianę wydatków członków przed zapisem i po nim ze zmianą wydatków nieczłonków w tych samych miesiącach (różnica w różnicach). Gdy klienci zapisują się w różnych miesiącach, licz efekt osobno dla każdej kohorty zapisu i uśrednij. Najmocniejszy dowód daje losowe przydzielenie oferty programu części klientów.
Dlaczego członkowie programu lojalnościowego wydają więcej?
Głównie dlatego, że do programu zapisują się klienci, którzy już wcześniej wydawali więcej – to samoselekcja. W przykładzie przyszli członkowie wydawali o 26.38 zł miesięcznie więcej, zanim program w ogóle powstał. Leenheer i in. (2007) po uwzględnieniu samoselekcji otrzymali efekt siedem razy mniejszy niż w naiwnym modelu.
Czy propensity score wystarczy do oceny programu lojalnościowego?
Tylko wtedy, gdy zmierzono wszystkie cechy, które wpływają jednocześnie na zapis i wydatki. Wykres zbalansowania pokazuje wyłącznie cechy zmierzone. W przykładzie po ważeniu wszystkie miały |SMD| < 0.1, a wynik wciąż wynosił 42.03 zł przy prawdzie 16.91 zł, bo nieobserwowane przywiązanie do sieci zostało niezbalansowane.
Co to jest regresja do średniej przy zapisie do programu?
Klienci często zapisują się przy dużym zakupie, czyli w wyjątkowo dobrym miesiącu. Później ich wydatki wracają do normy, niezależnie od programu. Jeśli miesiąc zapisu trafi do okresu „przed”, różnica w różnicach zaniża efekt – w przykładzie dała −4.16 zł zamiast około 17 zł. Pomiń miesiąc zapisu i weź kilka wcześniejszych.
Czy w różnicy w różnicach dopasowywać klientów po wydatkach sprzed zapisu?
Ostrożnie. Gdy członkowie mają wyższy stały poziom wydatków, dopasowanie na wydatkach sprzed zapisu wybiera nieczłonków w chwilowo dobrej formie, którzy potem wracają do swojej średniej (Daw i Hatfield, 2018). W symulacji takie ważenie zawyżało efekt średnio o 15.65 zł. Dopasowuj na cechach, które wpływają na zmianę wydatków, i sprawdzaj okres przed na wykresie.
Powiązane hasła
Przeczytaj też
Propensity score: dopasowanie i ważenie
Badanie obserwacyjne krok po kroku w R: ATE czy ATT, dopasowanie 1:1 z kaliprem, wagi IPTW, równowaga SMD, bootstrap, E-value i opis do artykułu.
Czytaj →PoradnikQuasi-eksperyment i różnica w różnicach (DiD)
Ocena programu bez losowania: równoległe trendy, regresja z interakcją, błędy klastrowane, model zdarzeń, test placebo, zagrożenia trafności i kod R.
Czytaj →PoradnikModel BG/NBD – aktywni klienci
Sklep z przyprawami: BG/NBD napisany ręcznie w R, P(aktywny), prognoza zakupów na rok 2 i porównanie z regułą 180 dni – sześć rysunków.
Czytaj →Oceniasz program lojalnościowy w pracy z marketingu?
Pomożemy dobrać grupę porównawczą i okres odniesienia, policzyć propensity score i różnicę w różnicach z kohortami zapisu oraz opisać wynik i jego ograniczenia tak, żebyś umiał(a) go obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Austin, P. C. (2009). Balance diagnostics for comparing the distribution of baseline covariates between treatment groups in propensity-score matched samples. Statistics in Medicine, 28(25), 3083–3107. https://doi.org/10.1002/sim.3697 ● Otwarty dostęp
- Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215–220. https://doi.org/10.1093/ije/dyh299 ● Otwarty dostęp
- Daw, J. R., & Hatfield, L. A. (2018). Matching and regression to the mean in difference-in-differences analysis. Health Services Research, 53(6), 4138–4156. https://doi.org/10.1111/1475-6773.12993 ● Otwarty dostęp
- Goodman-Bacon, A. (2021). Difference-in-differences with variation in treatment timing. Journal of Econometrics, 225(2), 254–277. https://doi.org/10.1016/j.jeconom.2021.03.014
- Leenheer, J., van Heerde, H. J., Bijmolt, T. H. A., & Smidts, A. (2007). Do loyalty programs really enhance behavioral loyalty? An empirical analysis accounting for self-selecting members. International Journal of Research in Marketing, 24(1), 31–47. https://doi.org/10.1016/j.ijresmar.2006.10.005 ● Otwarty dostęp: pełny tekst
- Rosenbaum, P. R., & Rubin, D. B. (1983). The central role of the propensity score in observational studies for causal effects. Biometrika, 70(1), 41–55. https://doi.org/10.1093/biomet/70.1.41 ● Otwarty dostęp
- Roth, J., Sant’Anna, P. H. C., Bilinski, A., & Poe, J. (2023). What’s trending in difference-in-differences? A synthesis of the recent econometrics literature. Journal of Econometrics, 235(2), 2218–2244. https://doi.org/10.1016/j.jeconom.2023.03.008 ● Otwarty dostęp: pełny tekst
- Stuart, E. A. (2010). Matching methods for causal inference: A review and a look forward. Statistical Science, 25(1), 1–21. https://doi.org/10.1214/09-sts313 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{austin2009balance, author={Austin, Peter C.}, title={{Balance diagnostics for comparing the distribution of baseline covariates between treatment groups in propensity-score matched samples}}, journal={Statistics in Medicine}, year={2009}, volume={28}, number={25}, pages={3083--3107}, doi={10.1002/sim.3697}}@article{barnett2005regression, author={Barnett, Adrian G. and van der Pols, Jolieke C. and Dobson, Annette J.}, title={{Regression to the mean: What it is and how to deal with it}}, journal={International Journal of Epidemiology}, year={2005}, volume={34}, number={1}, pages={215--220}, doi={10.1093/ije/dyh299}}@article{daw2018matching, author={Daw, Jamie R. and Hatfield, Laura A.}, title={{Matching and regression to the mean in difference-in-differences analysis}}, journal={Health Services Research}, year={2018}, volume={53}, number={6}, pages={4138--4156}, doi={10.1111/1475-6773.12993}}@article{goodmanbacon2021difference, author={Goodman-Bacon, Andrew}, title={{Difference-in-differences with variation in treatment timing}}, journal={Journal of Econometrics}, year={2021}, volume={225}, number={2}, pages={254--277}, doi={10.1016/j.jeconom.2021.03.014}}@article{leenheer2007do, author={Leenheer, Jorna and van Heerde, Harald J. and Bijmolt, Tammo H. A. and Smidts, Ale}, title={{Do loyalty programs really enhance behavioral loyalty? An empirical analysis accounting for self-selecting members}}, journal={International Journal of Research in Marketing}, year={2007}, volume={24}, number={1}, pages={31--47}, doi={10.1016/j.ijresmar.2006.10.005}}@article{rosenbaum1983central, author={Rosenbaum, Paul R. and Rubin, Donald B.}, title={{The central role of the propensity score in observational studies for causal effects}}, journal={Biometrika}, year={1983}, volume={70}, number={1}, pages={41--55}, doi={10.1093/biomet/70.1.41}}@article{roth2023whats, author={Roth, Jonathan and Sant’Anna, Pedro H. C. and Bilinski, Alyssa and Poe, John}, title={{What’s trending in difference-in-differences? A synthesis of the recent econometrics literature}}, journal={Journal of Econometrics}, year={2023}, volume={235}, number={2}, pages={2218--2244}, doi={10.1016/j.jeconom.2023.03.008}}@article{stuart2010matching, author={Stuart, Elizabeth A.}, title={{Matching methods for causal inference: A review and a look forward}}, journal={Statistical Science}, year={2010}, volume={25}, number={1}, pages={1--21}, doi={10.1214/09-sts313}}