Co to jest model komplementarny log-log?
Model komplementarny log-log (ang. complementary log-log, cloglog) to model dla zmiennej binarnej, w którym prawdopodobieństwo p łączy się z predyktorem liniowym η = β0 + β1x1 + … przez funkcję log(−log(1 − p)) = η, czyli p = 1 − exp(−exp(η)). To jedna z funkcji łączących w modelu dwumianowym (McCullagh i Nelder, 1989), obok logitu i probitu. W odróżnieniu od nich jest asymetryczna: p zbliża się do 1 szybciej niż do 0.
Główne zastosowanie to analiza przeżycia w czasie dyskretnym. Gdy zdarzenie zapisujemy w przedziałach (rok, wizyta), dane zamienia się na format osoba-okres i modeluje dyskretny hazard – prawdopodobieństwo zdarzenia w okresie pod warunkiem dotrwania do niego. Prentice i Gloeckler (1978) zaproponowali wersję modelu proporcjonalnych hazardów dla danych zgrupowanych i z wieloma wiązaniami czasów; w praktyce jest to regresja cloglog z osobnym wyrazem wolnym dla każdego okresu. Jeśli w czasie ciągłym hazardy są proporcjonalne, jak w modelu Coxa, współczynnik cloglog szacuje ten sam logarytm ilorazu hazardów, niezależnie od szerokości przedziałów. Współczynnik logitu (log ilorazu szans) zależy zaś od tego, jak częste jest zdarzenie w okresie. Metody czasu dyskretnego dla historii zdarzeń omawia Allison (1982).
Przykład
Dla 2000 symulowanych osób wylosowano czasy do zdarzenia z prawdziwym HR = exp(0.5) = 1.65, ale zapisano je tylko w pełnych latach (do 6 lat, 5639 wierszy osoba-okres). Model cloglog dał b = 0.484 (SE = 0.048), HR = 1.62 – prawie tyle co model Coxa na dokładnych czasach (HR = 1.62). Logit dał OR = 1.80, bo roczne prawdopodobieństwo zdarzenia jest wysokie: w pierwszym roku dla grupy x = 1 model przewiduje p = 1 − exp(−exp(η)) = 0.41.
Na rysunku
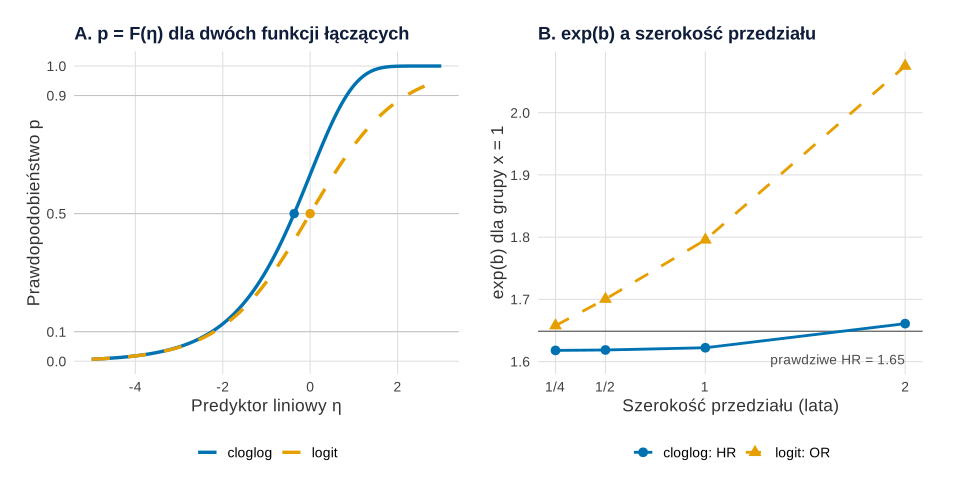
set.seed(1689)).Co widać. Panel A: krzywa logitu jest symetryczna – żeby przejść od p = .5 do .9 albo do .1, predyktor liniowy musi się zmienić o 2.20. Krzywa cloglog mija p = .5 przy η = −0.37 i dalej rośnie stromo: do .9 wystarczy zmiana o 1.20, a w dół do .1 trzeba 1.88. Przy małych p obie krzywe prawie się pokrywają. Panel B: te same 2000 czasów z przykładu (prawdziwe HR = 1.65) zapisano w przedziałach od kwartału do dwóch lat. HR z modelu cloglog wynosi od 1.62 do 1.66 bez względu na szerokość przedziału, a OR z logitu rośnie od 1.66 do 2.08 – razem z odsetkiem zdarzeń w pierwszym przedziale (od 0.09 do 0.54).
Na co uważać. Stały HR w panelu B wynika z tego, że dane wygenerowano z proporcjonalnymi hazardami w czasie ciągłym. Gdy hazardy nie są proporcjonalne, także cloglog nie da jednej liczby niezależnej od przedziałów; tę samą transformację log(−log) wykorzystuje wykres log(−log) przeżycia do sprawdzania proporcjonalności. Panel B to jeden zbiór danych – różnica 1.62 wobec 1.66 jest mniejsza niż błąd standardowy z przykładu (SE = 0.048 w skali log). Pokrywanie się krzywych przy małym p tłumaczy, dlaczego przy rzadkich zdarzeniach OR i HR są podobne. Inne funkcje łączące porównuje hasło funkcja łącząca, skale logitu i prawdopodobieństwa – wpis Regresja logistyczna w obrazkach.
Podpis do pracy:
Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne. Ziarno 1689 jest to samo co w przykładzie, a szerokości przedziałów (1/4, 1/2, 1 i 2 lata) wybrano ręcznie; panel A niczego nie losuje.
Kod R rysunku 1
# Rysunek 1. Asymetria krzywej cloglog (A) i HR z cloglog a OR z logitu przy różnej szerokości przedziałów (B)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(cloglog = "#0072B2", logit = "#E69F00")      # Okabe–Ito; logit dodatkowo linią przerywaną
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom")
# A: p jako funkcja predyktora liniowego eta
eta <- seq(-5, 3, by = 0.02)
krzywe <- rbind(data.frame(eta, p = 1 - exp(-exp(eta)), link = "cloglog"),
                data.frame(eta, p = plogis(eta), link = "logit"))
# ile trzeba zmienić eta, żeby przejść od p = .5 do .9 i od p = .5 do .1
odl <- function(q) c(do_0.9 = q(0.9) - q(0.5), do_0.1 = q(0.5) - q(0.1))
cll <- function(p) log(-log(1 - p))
round(rbind(cloglog = odl(cll), logit = odl(qlogis)), 2)
pA <- ggplot(krzywe, aes(eta, p, colour = link, linetype = link)) +
  geom_hline(yintercept = c(0.1, 0.5, 0.9), colour = "grey75", linewidth = 0.3) +
  geom_line(linewidth = 1.2) +
  annotate("point", x = c(cll(0.5), 0), y = 0.5, colour = kol[c("cloglog", "logit")], size = 2.5) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = c(cloglog = "solid", logit = "dashed"), name = NULL) +
  scale_y_continuous(breaks = c(0, 0.1, 0.5, 0.9, 1)) +
  labs(title = "A. p = F(η) dla dwóch funkcji łączących", x = "Predyktor liniowy η", y = "Prawdopodobieństwo p")
# B: te same czasy ciągłe (prawdziwe HR = 1.65) zapisane w przedziałach różnej szerokości
set.seed(1689)                                        # te same dane co w przykładzie
n <- 2000
x <- rbinom(n, 1, 0.5)
t <- rexp(n, rate = 0.3 * exp(0.5 * x))
szer <- c(0.25, 0.5, 1, 2)                            # szerokość przedziału w latach, obserwacja do 6 lat
wyn <- do.call(rbind, lapply(szer, function(h) {
  K <- 6 / h
  okres <- pmin(ceiling(t / h), K)
  zd <- as.integer(t <= 6)
  pp <- data.frame(x = rep(x, okres), okres = sequence(okres))
  pp$y <- as.integer(pp$okres == rep(okres, okres) & rep(zd, okres))
  b_c <- coef(glm(y ~ factor(okres) + x, family = binomial("cloglog"), data = pp))[["x"]]
  b_l <- coef(glm(y ~ factor(okres) + x, family = binomial("logit"), data = pp))[["x"]]
  data.frame(szer = h, p_okres1 = mean(pp$y[pp$okres == 1]),
             link = c("cloglog", "logit"), exp_b = exp(c(b_c, b_l)))
}))
print(transform(wyn, p_okres1 = round(p_okres1, 3), exp_b = round(exp_b, 2)), row.names = FALSE)
pB <- ggplot(wyn, aes(szer, exp_b, colour = link, linetype = link, shape = link)) +
  geom_hline(yintercept = exp(0.5), colour = "grey30", linewidth = 0.4) +
  annotate("text", x = 2, y = exp(0.5) - 0.045, label = "prawdziwe HR = 1.65", hjust = 1, size = 3.6, colour = "grey30") +
  geom_line(linewidth = 1) + geom_point(size = 3) +
  scale_colour_manual(values = kol, labels = c(cloglog = "cloglog: HR", logit = "logit: OR"), name = NULL) +
  scale_linetype_manual(values = c(cloglog = "solid", logit = "dashed"), labels = c(cloglog = "cloglog: HR", logit = "logit: OR"), name = NULL) +
  scale_shape_manual(values = c(cloglog = 16, logit = 17), labels = c(cloglog = "cloglog: HR", logit = "logit: OR"), name = NULL) +
  scale_x_continuous(breaks = szer, labels = c("1/4", "1/2", "1", "2")) +
  labs(title = "B. exp(b) a szerokość przedziału", x = "Szerokość przedziału (lata)", y = "exp(b) dla grupy x = 1")
p1 <- (pA + pB) & motyw
p1
Wynik w R
        do_0.9 do_0.1
cloglog    1.2   1.88
logit      2.2   2.20
 szer p_okres1    link exp_b
 0.25    0.092 cloglog  1.62
 0.25    0.092   logit  1.66
 0.50    0.180 cloglog  1.62
 0.50    0.180   logit  1.70
 1.00    0.342 cloglog  1.62
 1.00    0.342   logit  1.80
 2.00    0.543 cloglog  1.66
 2.00    0.543   logit  2.08
Jak opisać w pracy
Na co uważać
- Kodowanie ma znaczenie. Zamiana 0 i 1 w logicie zmienia tylko znak współczynników; w cloglog daje inny model (log-log).
- Funkcja czasu. Jeden wspólny wyraz wolny zakłada stały hazard; zwykle wpisuje się okres jako czynnik albo elastyczną funkcję czasu.
- Proporcjonalność hazardów można sprawdzić interakcją predyktora z okresem.
- Obserwacje cenzurowane wnoszą wiersze tylko do ostatniego okresu obserwacji, z y = 0.
Model cloglog w czasie dyskretnym w R
Kod tworzy dane osoba-okres, dopasowuje glm() z funkcją łączącą cloglog i logit oraz model Coxa na dokładnych czasach. Liczby w tekście pochodzą z tego kodu.
Cloglog, logit i model Coxa dla zgrupowanych czasów
R
set.seed(1689)                                        # dane symulowane: czas ciągły, proporcjonalne hazardy
n <- 2000
x <- rbinom(n, 1, 0.5)                               # np. grupa interwencyjna
t <- rexp(n, rate = 0.3 * exp(0.5 * x))             # prawdziwy log HR = 0.5
okres <- pmin(ceiling(t), 6)                         # zdarzenie zapisane tylko w pełnych latach, obserwacja do 6 lat
zdarzenie <- as.integer(t <= 6)
pp <- data.frame(id = rep(1:n, okres), x = rep(x, okres))     # format osoba-okres
pp$okres <- sequence(okres)
pp$y <- as.integer(pp$okres == rep(okres, okres) & rep(zdarzenie, okres))
nrow(pp)
m_cll <- glm(y ~ factor(okres) + x, family = binomial(link = "cloglog"), data = pp)
m_log <- glm(y ~ factor(okres) + x, family = binomial(link = "logit"), data = pp)
library(survival)
m_cox <- coxph(Surv(pmin(t, 6), zdarzenie) ~ x)      # czas ciągły (niedostępny w danych zgrupowanych)
wsp <- rbind(cloglog = coef(summary(m_cll))["x", 1:2],
             logit   = coef(summary(m_log))["x", 1:2],
             Cox     = coef(summary(m_cox))["x", c(1, 3)])
round(cbind(wsp, exp_b = exp(wsp[, 1])), 3)
eta <- coef(m_cll)[["(Intercept)"]] + coef(m_cll)[["x"]]   # okres 1, x = 1
round(c(p_zdarzenia = 1 - exp(-exp(eta)), z_predict = unname(predict(m_cll,
  data.frame(okres = 1, x = 1), type = "response"))), 4)
Wynik w R
[1] 5639
        Estimate Std. Error exp_b
cloglog    0.484      0.048 1.622
logit      0.585      0.059 1.796
Cox        0.479      0.048 1.615
p_zdarzenia   z_predict
     0.4075      0.4075
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet survival 3.8.6; rysunek 1 – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R (R package version 3.8-6) [Computer software]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kiedy wybrać cloglog zamiast regresji logistycznej?
Gdy modelujesz czas do zdarzenia zapisany w okresach (lata, wizyty) i chcesz interpretować efekty jako ilorazy hazardów, porównywalne z modelem Coxa. Poza tym cloglog pasuje, gdy prawdopodobieństwo rośnie asymetrycznie; w pozostałych sytuacjach zwykle wystarcza logit.
Jak interpretować exp(b) w modelu cloglog?
W danych osoba-okres exp(b) to iloraz hazardów: exp(b) = 1.62 oznacza o 62% wyższy hazard zdarzenia w grupie porównywanej przy tym samym okresie. To nie jest iloraz szans – ten daje logit i przy częstych zdarzeniach jest od HR wyraźnie większy.
Jak dopasować model cloglog w R?
Przekształć dane do formatu osoba-okres (np. funkcją survSplit() z pakietu survival albo ręcznie) i użyj glm(y ~ factor(okres) + x, family = binomial(link = "cloglog")). Czynnik okresu pozwala hazardowi bazowemu zmieniać się w czasie.
Powiązane hasła
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Allison, P. D. (1982). Discrete-time methods for the analysis of event histories. Sociological Methodology, 13, 61. https://doi.org/10.2307/270718
- McCullagh, P., & Nelder, J. A. (1989). Generalized linear models (2nd ed.). Chapman and Hall. https://doi.org/10.1007/978-1-4899-3242-6
- Prentice, R. L., & Gloeckler, L. A. (1978). Regression analysis of grouped survival data with application to breast cancer data. Biometrics, 34(1), 57–67. https://doi.org/10.2307/2529588
Cytowania BibTeX
@article{allison1982discrete, author={Allison, Paul D.}, title={{Discrete-time methods for the analysis of event histories}}, journal={Sociological Methodology}, year={1982}, volume={13}, pages={61}, doi={10.2307/270718}}@book{mccullagh1989generalized, author={McCullagh, P. and Nelder, J. A.}, title={{Generalized linear models}}, year={1989}, edition={2}, publisher={Chapman and Hall}, doi={10.1007/978-1-4899-3242-6}}@article{prentice1978regression, author={Prentice, R. L. and Gloeckler, L. A.}, title={{Regression analysis of grouped survival data with application to breast cancer data}}, journal={Biometrics}, year={1978}, volume={34}, number={1}, pages={57--67}, doi={10.2307/2529588}}