Przykład: portal z przepisami i cztery nagłówki
Fikcyjny portal z przepisami kulinarnymi ma na stronie głównej zajawkę przepisu na krem z dyni. Redakcja napisała cztery nagłówki i pyta: który pokazywać, żeby jak najwięcej osób kliknęło – i ile kliknięć kosztuje samo sprawdzanie? Zwykła odpowiedź to test A/B: równy podział ruchu, potem wdrożenie zwycięzcy. Alternatywa to wieloręki bandyta – algorytm, który w trakcie testu przesuwa ruch w stronę nagłówka wygrywającego.
| Nagłówek | Treść | Prawdziwy CTR |
|---|---|---|
| A | Zupa krem z dyni – przepis | 3.5% |
| B | Krem z dyni w 30 minut | 4.0% |
| C | Zupa z dyni, którą zjedzą nawet dzieci | 5.0% |
| D | Najprostszy krem z dyni z 5 składników | 4.4% |
Dane są fikcyjne, a parametry ustaliliśmy ręcznie: prawdziwe CTR (odsetek odsłon zakończonych kliknięciem) jak w tabeli, 20 000 odsłon zajawki, test A/B trwający 8000 odsłon, ε = 0.10. Strategie tych wartości nie znają; my znamy je, więc widzimy, ile kliknięć traci każda strategia. Każdą strategię powtórzyliśmy w 1000 niezależnych przebiegach (ziarna 657, 6571 i 6572 ustalone raz i niezmieniane). Wynik każdego przebiegu – liczbę odsłon i kliknięć każdego nagłówka – pobierzesz jako wielorekie-bandyty-przebiegi.csv.
Rysunek 1: automat z czterema ramionami
Nazwa pochodzi od automatu do gry z kilkoma dźwigniami („ramionami”): każda wypłaca z inną, nieznaną szansą. Każda odsłona to jedno pociągnięcie: strategia wybiera nagłówek, czytelnik klika albo nie, strategia aktualizuje wiedzę. Pierwsze prace o takim sekwencyjnym planowaniu eksperymentów, w którym liczebność i skład prób zależą od samych obserwacji, pochodzą z lat 50. (Robbins, 1952).
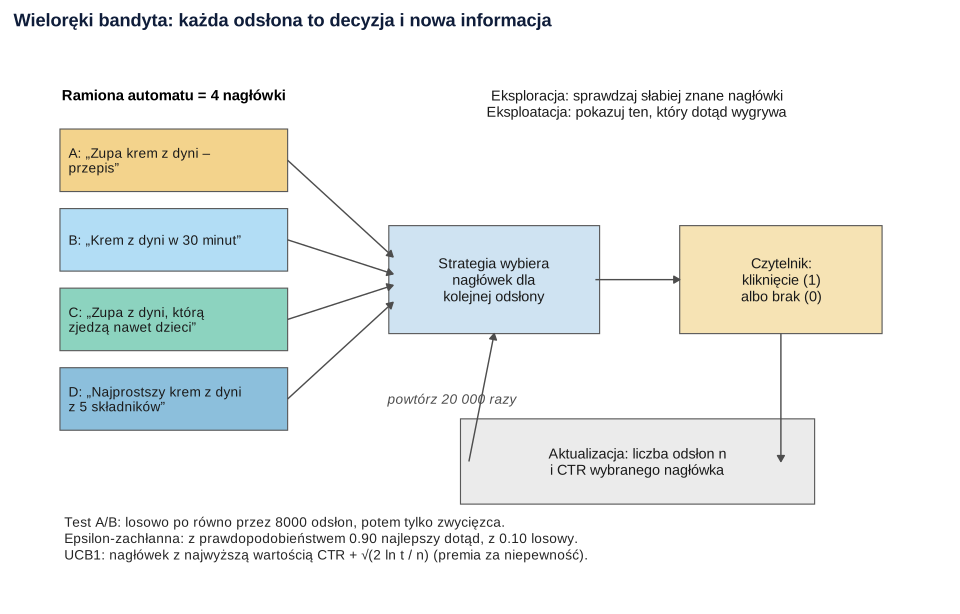
Co widać. Sedno to kompromis eksploracja–eksploatacja: trzymać się nagłówka, który dotąd dawał najwięcej kliknięć, czy sprawdzać słabiej znane, które mogą okazać się lepsze (Bubeck i Cesa-Bianchi, 2012). Trzy strategie rozstrzygają go inaczej:
- Test A/B z równym podziałem – najpierw sama eksploracja (8000 odsłon losowo po równo), potem sama eksploatacja (tylko zwycięzca).
- Strategia epsilon-zachłanna – w 90% odsłon pokazuje nagłówek z najwyższym dotąd CTR, w 10% (ε = 0.10) losowy.
- UCB1 (górna granica ufności) – pokazuje nagłówek z najwyższą sumą: zaobserwowany CTR + premia za niepewność.
gdzie p̂k to dotychczasowy CTR nagłówka k, nk – liczba jego odsłon, a t – liczba wszystkich odsłon. Nagłówek rzadko pokazywany ma dużą premię, więc prędzej czy później zostanie sprawdzony.
Jak może zmylić. Schemat sugeruje, że wynik przychodzi od razu; kliknięcia (a tym bardziej zakupy) mogą spływać z opóźnieniem.
Podpis do pracy:
Rysunek 2: jeden przebieg z bliska
Najpierw jeden przebieg każdej strategii (pierwszy z tysiąca – nie wybieraliśmy go).
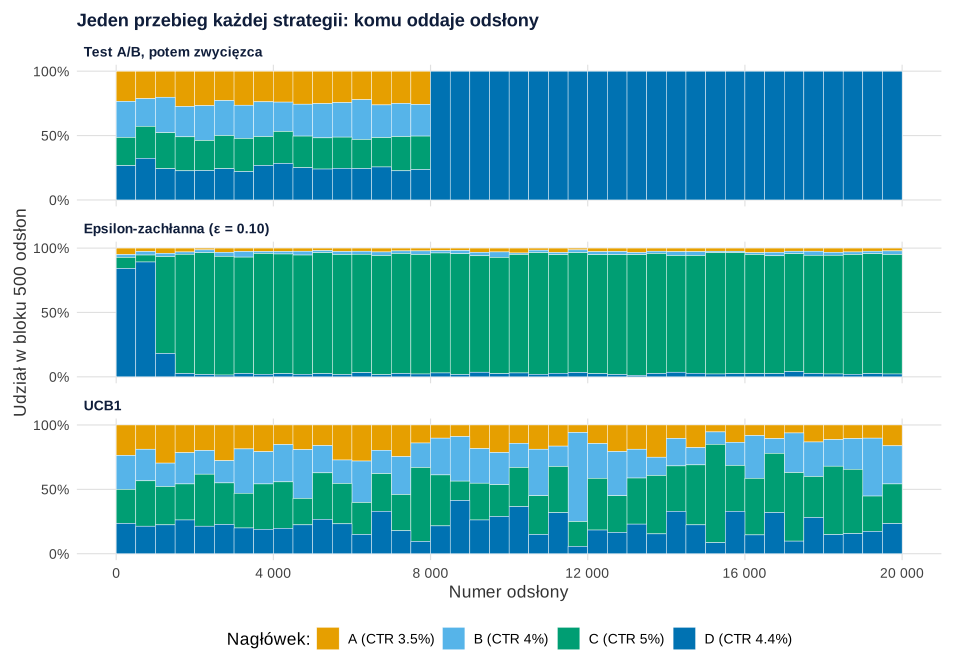
set.seed(657)).Co widać. Test A/B przez 8000 odsłon dzieli ruch po równo, a potem – w tym przebiegu – wdraża niewłaściwy nagłówek D, bo w teście D wypadł przypadkiem lepiej niż C. Strategia epsilon-zachłanna przez pierwsze ok. 1000 odsłon trzymała się D, który na starcie miał szczęście, a potem przełączyła się na C i pokazywała go w ok. 90% odsłon (pozostałe 10% to losowa eksploracja). UCB1 do końca pokazuje wszystkie cztery nagłówki, choć C coraz częściej. Średnio w 1000 przebiegów strategia epsilon-zachłanna oddała nagłówkowi C 12 376 odsłon, test A/B – 11 527, a UCB1 – tylko 6330.
Jak może zmylić. Jeden przebieg to anegdota – dlatego dalej patrzymy na 1000 przebiegów.
Podpis do pracy:
Rysunek 3: ile kliknięć kosztuje uczenie się
Gdybyśmy od początku wiedzieli, że najlepszy jest C, 20 000 odsłon dałoby średnio 1000 kliknięć. Każda odsłona innego nagłówka to strata: przy A – 1.5 punktu procentowego oczekiwanego kliknięcia, przy D – 0.6. Suma tych strat to skumulowany żal (regret) – utracone kliknięcia, czyli wartość oczekiwana tego, co strategia oddała za naukę.
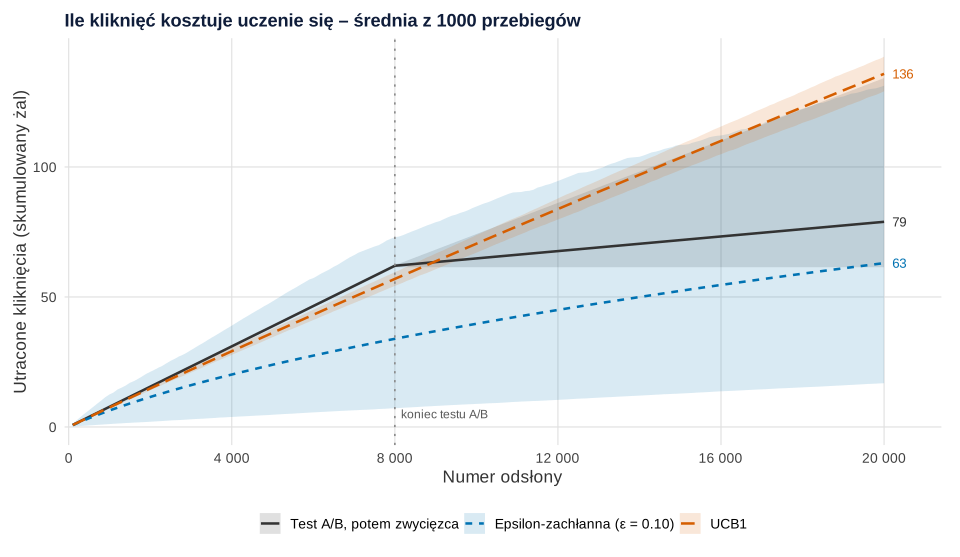
set.seed(657)).Co widać. Test A/B w fazie testu traci kliknięcia liniowo: 62.0 do 8000. odsłony. Potem krzywa się wypłaszcza, ale nie dla wszystkich przebiegów: 90. percentyl to 134.2, bo co piąty test wdraża zły nagłówek i traci aż do końca. Strategia epsilon-zachłanna ma najniższy średni żal (63.0 wobec 78.9), ale największy rozrzut – od 16.8 do 131.2. UCB1 traci najwięcej: 135.8 kliknięć. Przy CTR rzędu 5% premia za niepewność wielokrotnie przewyższa różnice między nagłówkami, więc UCB1 eksploruje prawie do końca.
Wynik zależy od parametrów (przepis 3): przy ε = 0.20 żal wyniósł 66.3, przy ε = 0.05 – 71.8; krótszy test A/B (4000 odsłon) – 69.9, dłuższy (12 000) – 101.6; UCB z premią pomniejszoną pięciokrotnie – 71.4.
Jak może zmylić. Żal wymaga znajomości prawdziwych CTR – to miara do porównywania strategii w symulacji, nie do policzenia na danych z portalu.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: czy strategia wskazuje właściwy nagłówek
Drugie pytanie redakcji: który nagłówek jest naprawdę najlepszy? Za wskazanie strategii przyjmujemy nagłówek z najwyższym dotąd CTR, a w teście A/B po 8000 odsłon – wdrożonego zwycięzcę.
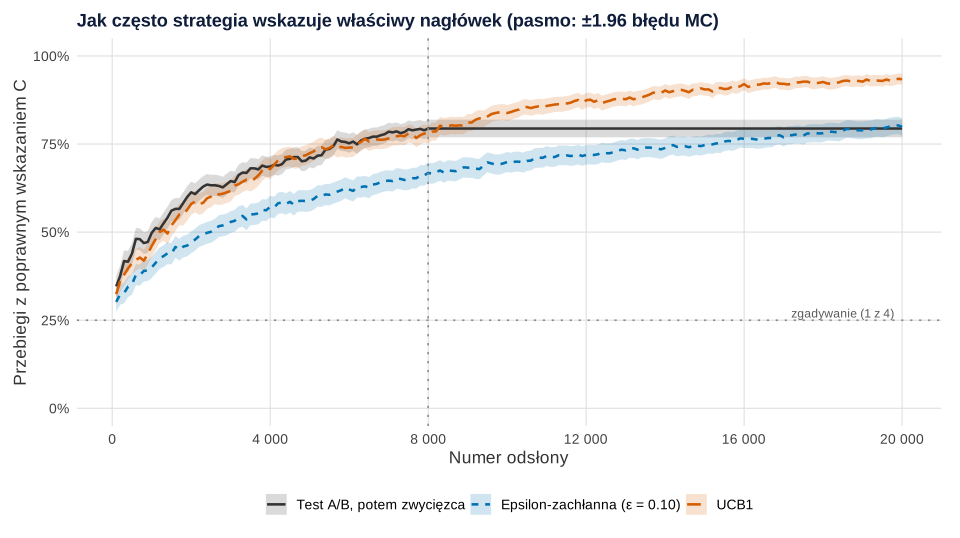
set.seed(657)).Co widać. Tu kolejność jest odwrotna niż na rysunku 3. UCB1 wskazuje C w 93.4% przebiegów (błąd Monte Carlo 0.79 pp), test A/B – w 79.4% (16.8% wdraża D), strategia epsilon-zachłanna – w 79.9%. Po 2000 odsłon strategia epsilon-zachłanna trafia tylko w 47.1% przebiegów. To klasyczny kompromis: im mniej kliknięć tracisz w trakcie, tym słabiej poznajesz przegrane warianty. Villar i in. (2015) opisują to samo w badaniach klinicznych: reguły bandyckie przydzielają więcej uczestników do lepszej terapii, ale mają niską moc.
Jak może zmylić. „Wskazuje C” nie znaczy „wykazał istotną przewagę C”. Przy różnicy 0.6 pp i ok. 2000 odsłon na nagłówek test różnicy C i D ma małą moc; jak ją policzyć przed startem, opisuje wpis test A/B – plan i analiza.
Podpis do pracy:
Rysunek 5: dlaczego bandyta utrudnia wnioskowanie
Po teście redakcja chce napisać w raporcie: „CTR nagłówka C wyniósł 5.0%, 95% CI [4.6, 5.4]”. Przy teście A/B to uprawnione. Przy bandycie – nie całkiem. Nagłówek, który na początku miał pecha, strategia porzuca, więc jego zaniżona średnia się nie poprawia; ten, który miał szczęście, dostaje więcej odsłon i jego średnia wraca do prawdy. W efekcie średnie z próby są zaniżone, a liczebności nierówne i losowe.
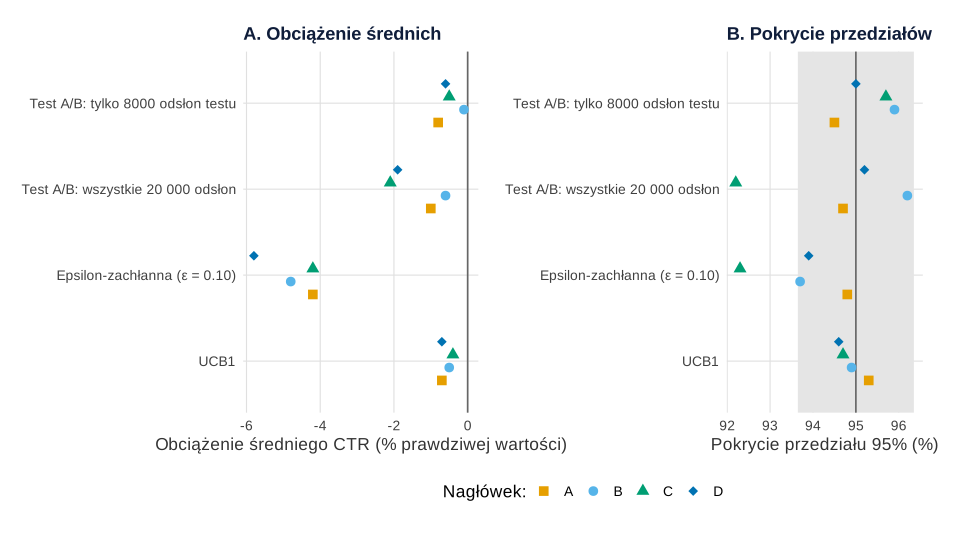
set.seed(657)).Co widać. Gdy analizujemy tylko fazę testu A/B (po ok. 2000 odsłon na nagłówek), obciążenie mieści się w szumie symulacji (od −0.8% do −0.1% prawdziwej wartości), a pokrycie przedziału – w granicach 94.5–95.9%. W strategii epsilon-zachłannej średnie CTR są zaniżone o 4.2–5.8%, a przedział ufności dla proporcji nagłówka C pokrywa prawdę w 92.3% przebiegów (błąd MC 0.69 pp). Mechanizm dobrze widać na nagłówku B: w przebiegach, w których dostał najwyżej 1000 odsłon, jego CTR był zaniżony średnio o 0.31 pp, a gdy dostał ponad 3000 – zawyżony o 0.08 pp. Uwaga na test A/B: jeśli policzysz CTR ze wszystkich 20 000 odsłon, także po wdrożeniu, decyzja o wdrożeniu zależała od danych i średnie C i D są zaniżone o ok. 2%.
Średnia z próby przestaje być estymatorem nieobciążonym, bo liczba obserwacji zależy od ich wartości. Hadad i in. (2021) pokazują, że przy danych zebranych adaptacyjnie zwykłe średnie mogą być obciążone, a ich rozkład ma grube ogony, i proponują ważone estymatory z poprawnymi przedziałami. Pokrewną klątwę zwycięzcy opisuje wpis o teście A/B z wieloma wariantami.
Jak może zmylić. Obciążenie rzędu 5% wygląda niewinnie, ale przy różnicach między nagłówkami rzędu 10–15% potrafi odwrócić kolejność w raporcie.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: gdy najlepszy nagłówek zmienia się w czasie
Wszystkie dotychczasowe strategie zakładały, że CTR są stałe. Załóżmy teraz, że po 10 000 odsłon (np. przed weekendem) czytelnicy szukają prostych przepisów: C spada do 3.8%, a D rośnie do 5.2% (wartości ustalone ręcznie). Dodajemy czwartą strategię: epsilon-zachłanną z zapominaniem – po każdej odsłonie stare dane tracą wagę (mnożnik γ = 0.9995, czyli pamięć rzędu 2000 ostatnich odsłon). Besbes i in. (2019) pokazują, że gdy średnie nagrody się zmieniają, strategię trzeba porównywać z wyrocznią, która w każdej chwili wybiera aktualnie najlepszą opcję.
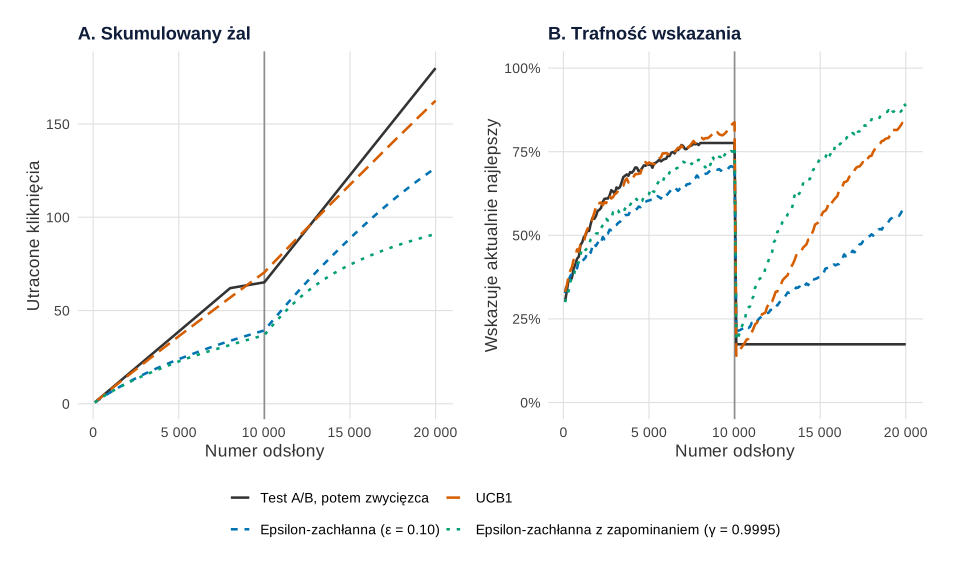
set.seed(6572)).Co widać. Test A/B zakończył się przed zmianą i dalej pokazuje C: po zmianie traci 114.8 kliknięć, a D wskazuje tylko w 17.4% przebiegów (tam, gdzie przez pomyłkę wdrożył D). Zwykła strategia epsilon-zachłanna traci 87.1 i po 10 000 kolejnych odsłon wskazuje D w 57.9% przebiegów – tysiące starych odsłon C długo trzymają jej średnią w górze. Wersja z zapominaniem traci 54.3 kliknięcia i wskazuje D w 88.6%. UCB1 reaguje lepiej niż zwykła epsilon-zachłanna (83.7%), bo i tak cały czas eksploruje.
Jak może zmylić. Przy stałych CTR krótka pamięć szkodzi. Pokrewne zjawisko w teście A/B to efekt nowości – zob. pułapki testów A/B na obrazkach.
Podpis do pracy:
Kiedy test A/B, a kiedy bandyta
| Sytuacja | Lepszy wybór |
|---|---|
| Chcesz wiedzieć, o ile C jest lepszy, z przedziałem ufności i testem – np. do pracy dyplomowej lub decyzji na lata | Test A/B z planem i liczebnością ustaloną z góry |
| Krótkie okno (nagłówek na kilka dni, promocja świąteczna), liczy się suma kliknięć teraz | Bandyta (np. epsilon-zachłanna) |
| Preferencje zmieniają się w czasie | Bandyta z zapominaniem lub ponawiane testy |
| Metryka spływa z opóźnieniem (zakup po tygodniu, rezygnacja z abonamentu) | Test A/B – bandyta uczy się na niepełnych danych |
Bandyta nie zwalnia z planu analizy przed startem. Ciągłe zaglądanie do testu A/B to inny problem – opcjonalne zatrzymywanie; klasyczne wartości p są wtedy niewiarygodne, a rozwiązaniem są wnioskowania zawsze ważne (Johari i in., 2022).
Co z tym zrobić w firmie
- Najpierw nazwij cel. „Zarobić jak najwięcej kliknięć w tym tygodniu” to zadanie dla bandyty. „Dowiedzieć się, który nagłówek jest lepszy i o ile” – dla testu A/B.
- Policz koszt eksploracji przed startem. Symulacja jak tutaj (przepisy 2–3) z realnymi CTR z przeszłości pokaże, ile kliknięć kosztuje test i jak często wdroży się zły wariant – w przykładzie co piąty test.
- Nie stosuj UCB1 „z podręcznika” do rzadkich zdarzeń. Przy CTR rzędu kilku procent premia za niepewność jest za duża; dobierz jej skalę w symulacji.
- Raportuj ostrożnie. Do decyzji na dłużej zrób krótki test potwierdzający z równym podziałem.
- Zapisuj prawdopodobieństwa przydziału. Bez nich nie da się później poprawić obciążenia (ważenie przez odwrotność prawdopodobieństwa).
- Zostaw stałą eksplorację (np. 5–10% ruchu), gdy preferencje mogą się zmieniać.
Inne metody eksperymentów w firmie: redukcja wariancji w CUPED i testy, w których grupy wpływają na siebie nawzajem – efekt sieciowy i switchback. Kontrolowany eksperyment pozostaje najlepszym sposobem ustalenia, czy zmiana na stronie zmienia zachowanie (Kohavi i in., 2009) – bandyta inaczej rozdziela tylko ruch.
Jak opisać w pracy
Porównanie strategii przydziału pasuje do prac z marketingu internetowego, e-commerce i zarządzania produktem (zob. statystyka w pracy z zarządzania i ekonomii i statystyka w pracy z marketingu). Badanie symulacyjne zaplanuj według schematu ADEMP – zob. jak zaplanować badanie symulacyjne. W Metodzie podaj: warianty i metrykę, prawdziwe parametry symulacji, horyzont, reguły strategii z parametrami, liczbę przebiegów, ziarno i miary oceny.
W Wynikach użyj zdań spod rysunków 3 i 5. W ograniczeniach napisz wprost, że wnioski dotyczą przyjętych CTR i horyzontu, a przy innych parametrach kolejność strategii może się zmienić (przepis 3). Strukturę całej pracy omawia wpis jak napisać pracę z zarządzania i ekonomii.
Kod R: test A/B, strategia epsilon-zachłanna i UCB1 w symulacji
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków w bazowym R i ggplot2 – bez pakietów do bandytów (strategie są zapisane w kilkunastu wierszach funkcji symuluj()). Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i tabelę nagłówków, przepis 2 – funkcję symuluj() i główną symulację, z której korzystają przepisy 3–5. Funkcja liczy 1000 przebiegów naraz (wektorowo), więc każdy przepis trwa kilka sekund. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 2, 3 i 6; każdy zaczyna od własnego set.seed() (657, 6571 i 6572). Ziaren nie zmienialiśmy po pierwszym uruchomieniu. Ręcznie ustalono: prawdziwe CTR nagłówków (przepis 1) i ich zmianę po 10 000 odsłon (przepis 6), horyzont 20 000 odsłon, długość testu A/B (8000), ε = 0.10, γ = 0.9995 i warianty parametrów w przepisie 3.
1. Paleta, nagłówki i schemat: Rysunek 1
R
# Rysunek 1. Fikcyjny portal z przepisami kulinarnymi: wieloręki bandyta jako pętla decyzji
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(pomarancz = "#E69F00", blekit = "#56B4E9", zielony = "#009E73", fiolet = "#CC79A7",
         niebieski = "#0072B2", cynober = "#D55E00", szary = "grey60", ciemny = "grey20")
kol_wariant <- c(A = "#E69F00", B = "#56B4E9", C = "#009E73", D = "#0072B2")
kol_strategia <- c("Test A/B, potem zwycięzca" = "grey20", "Epsilon-zachłanna (ε = 0.10)" = "#0072B2",
                   "UCB1" = "#D55E00")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a", hjust = 0), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Cztery nagłówki zajawki tego samego przepisu i ich prawdziwe CTR (ustalone ręcznie; strategie ich nie znają)
naglowki <- data.frame(
  wariant = c("A", "B", "C", "D"),
  tekst = c("Zupa krem z dyni – przepis", "Krem z dyni w 30 minut",
            "Zupa z dyni, którą zjedzą nawet dzieci", "Najprostszy krem z dyni z 5 składników"),
  ctr_prawdziwy = c(0.035, 0.040, 0.050, 0.044))
print(naglowki, row.names = FALSE)

# Rysunek 1: schemat – ramiona automatu (nagłówki) → strategia → czytelnik → aktualizacja → strategia
ramiona <- data.frame(x = 1.2, y = c(7.6, 6.2, 4.8, 3.4), wariant = naglowki$wariant,
                      tekst = paste0(naglowki$wariant, ": „", sapply(strwrap(naglowki$tekst, 24, simplify = FALSE), paste, collapse = "\n"), "”"))
pola <- data.frame(
  x = c(5.0, 8.4, 6.7, 6.7), y = c(5.5, 5.5, 2.3, 8.6), w = c(2.5, 2.4, 4.2, 6.0), h = c(1.9, 1.9, 1.5, 1.2),
  tekst = c("Strategia wybiera\nnagłówek dla\nkolejnej odsłony",
            "Czytelnik:\nkliknięcie (1)\nalbo brak (0)",
            "Aktualizacja: liczba odsłon n\ni CTR wybranego nagłówka",
            "Eksploracja: sprawdzaj słabiej znane nagłówki\nEksploatacja: pokazuj ten, który dotąd wygrywa"))
strzalki <- data.frame(x = c(2.55, 2.55, 2.55, 2.55, 6.2, 8.4, 4.7), y = c(7.6, 6.2, 4.8, 3.4, 5.5, 4.55, 2.3),
                       xend = c(3.8, 3.8, 3.8, 3.8, 7.2, 8.4, 5.0), yend = c(5.9, 5.6, 5.4, 5.1, 5.5, 2.3, 4.55))
p1 <- ggplot() +
  geom_rect(data = ramiona, aes(xmin = x - 1.35, xmax = x + 1.35, ymin = y - 0.55, ymax = y + 0.55, fill = wariant),
            colour = "grey35", linewidth = 0.4, alpha = 0.45) +
  geom_text(data = ramiona, aes(x - 1.25, y, label = tekst), hjust = 0, size = 3.6, lineheight = 0.9, colour = "grey10") +
  annotate("text", x = 1.2, y = 8.75, label = "Ramiona automatu = 4 nagłówki", fontface = "bold", size = 3.9) +
  geom_rect(data = pola, aes(xmin = x - w / 2, xmax = x + w / 2, ymin = y - h / 2, ymax = y + h / 2),
            fill = c("#CFE3F2", "#F6E3B4", "grey92", "white"), colour = c("grey35", "grey35", "grey35", NA),
            linewidth = 0.4) +
  geom_text(data = pola, aes(x, y, label = tekst), size = 3.8, lineheight = 0.95, colour = "grey10") +
  geom_segment(data = strzalki, aes(x = x, y = y, xend = xend, yend = yend),
               arrow = arrow(length = unit(0.18, "cm"), type = "closed"), colour = "grey30", linewidth = 0.5) +
  annotate("text", x = 4.5, y = 3.4, label = "powtórz 20 000 razy", size = 3.6, colour = "grey30", fontface = "italic") +
  annotate("text", x = -0.1, y = 0.95, hjust = 0, size = 3.6, colour = "grey15", lineheight = 1.0,
           label = paste("Test A/B: losowo po równo przez 8000 odsłon, potem tylko zwycięzca.",
                         "Epsilon-zachłanna: z prawdopodobieństwem 0.90 najlepszy dotąd, z 0.10 losowy.",
                         "UCB1: nagłówek z najwyższą wartością CTR + √(2 ln t / n) (premia za niepewność).", sep = "\n")) +
  scale_fill_manual(values = kol_wariant, guide = "none") +
  coord_cartesian(xlim = c(-0.2, 9.8), ylim = c(0.3, 9.3)) +
  labs(title = "Wieloręki bandyta: każda odsłona to decyzja i nowa informacja") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major = element_blank())
p1   # zapis: ggsave("wielorekie-bandyty-schemat.svg", p1, width = 10, height = 6.4)
Wynik w R
 wariant                                  tekst ctr_prawdziwy
       A             Zupa krem z dyni – przepis         0.035
       B                 Krem z dyni w 30 minut         0.040
       C Zupa z dyni, którą zjedzą nawet dzieci         0.050
       D Najprostszy krem z dyni z 5 składników         0.044
2. Funkcja symuluj() i 1000 przebiegów trzech strategii: Rysunek 2
R
# Rysunek 2. Trzy strategie w 1000 przebiegach po 20 000 odsłon i jeden przebieg z bliska; wymaga przepisu 1
# Funkcja symuluje R przebiegów naraz (wektorowo): w każdym kroku każdy przebieg wybiera jeden nagłówek
symuluj <- function(strategia, mu1, mu2 = mu1, t_zmiana = Inf, T = 20000, R = 1000,
                    eps = 0.10, n_test = 8000, c_ucb = 1, gamma = 1, co = 100) {
  K <- length(mu1)
  N <- matrix(0, R, K); S <- matrix(0, R, K)      # liczba odsłon i kliknięć: wiersz = przebieg, kolumna = nagłówek
  zal <- numeric(R); wybor <- integer(R); N_test <- S_test <- NULL
  zapis <- data.frame(t = seq(co, T, by = co), zal_sr = NA, zal_p10 = NA, zal_p90 = NA, trafny = NA)
  przebieg1 <- integer(T)
  for (t in seq_len(T)) {
    mu <- if (t <= t_zmiana) mu1 else mu2           # prawdziwe CTR w chwili t
    if (strategia == "ab") {                          # test A/B: równy losowy podział, potem tylko zwycięzca
      if (t <= n_test) a <- sample.int(K, R, replace = TRUE)
      else {
        if (t == n_test + 1) { wybor <- max.col(S / N, ties.method = "random"); N_test <- N; S_test <- S }
        a <- wybor
      }
    } else if (strategia == "eps") {                  # epsilon-zachłanna
      m <- S / N; m[N == 0] <- Inf                    # nagłówek jeszcze niepokazany ma pierwszeństwo
      a <- max.col(m, ties.method = "random")
      losowo <- runif(R) < eps
      a[losowo] <- sample.int(K, sum(losowo), replace = TRUE)
    } else {                                          # UCB1: CTR + premia za niepewność
      if (t <= K) a <- rep(t, R)
      else a <- max.col(S / N + c_ucb * sqrt(2 * log(t - 1) / N), ties.method = "random")
    }
    klik <- runif(R) < mu[a]
    if (gamma < 1) { N <- gamma * N; S <- gamma * S }  # wersja z zapominaniem starszych odsłon (przepis 6)
    ia <- cbind(seq_len(R), a)
    N[ia] <- N[ia] + 1; S[ia] <- S[ia] + klik
    zal <- zal + max(mu) - mu[a]                      # żal: oczekiwane kliknięcia utracone w tej odsłonie
    przebieg1[t] <- a[1]
    if (t %% co == 0) {
      m <- S / N; m[N == 0] <- -Inf                 # wskazanie: najwyższy dotąd CTR (w teście A/B po wdrożeniu – zwycięzca)
      wsk <- if (strategia == "ab" && t > n_test) wybor else max.col(m, ties.method = "random")
      zapis[t / co, 2:5] <- c(mean(zal), quantile(zal, c(0.1, 0.9)), mean(wsk == which.max(mu)))
    }
  }
  list(zapis = zapis, N = N, S = S, zal = zal, przebieg1 = przebieg1, N_test = N_test, S_test = S_test, wybor = wybor)
}

mu <- setNames(naglowki$ctr_prawdziwy, naglowki$wariant)
set.seed(657)
wyniki <- list("Test A/B, potem zwycięzca" = symuluj("ab", mu),
               "Epsilon-zachłanna (ε = 0.10)" = symuluj("eps", mu),
               "UCB1" = symuluj("ucb", mu))

# Dane do pobrania: wynik każdego z 1000 przebiegów każdej strategii (odsłony i kliknięcia nagłówków, żal)
dane <- do.call(rbind, lapply(names(wyniki), function(s) {
  w <- wyniki[[s]]
  data.frame(strategia = s, przebieg = 1:1000, setNames(as.data.frame(w$N), paste0("odslony_", names(mu))),
             setNames(as.data.frame(w$S), paste0("klikniecia_", names(mu))), zal = round(w$zal, 3))
}))
write.csv(dane, "wielorekie-bandyty-przebiegi.csv", row.names = FALSE)

# Średni podział 20 000 odsłon między nagłówki i kliknięcia w porównaniu z „wyrocznią” (zawsze C)
podzial <- t(sapply(wyniki, function(w) round(colMeans(w$N))))
kliki <- sapply(wyniki, function(w) round(mean(rowSums(w$S)), 1))
print(cbind(podzial, sr_klikniec = kliki, sr_utraconych = round(sapply(wyniki, function(w) mean(w$zal)), 1)))
data.frame(klikniecia_wyroczni = 20000 * max(mu), klikniecia_przy_rownym_podziale = 20000 * mean(mu))

# Rysunek 2: przebieg nr 1 każdej strategii – udział nagłówków w kolejnych blokach po 500 odsłon
blok <- do.call(rbind, lapply(names(wyniki), function(s) {
  b <- ceiling(seq_len(20000) / 500)
  tab <- prop.table(table(factor(b, 1:40), factor(wyniki[[s]]$przebieg1, 1:4, names(mu))), 1)
  data.frame(strategia = s, odslona = 500 * as.numeric(rownames(tab))[row(tab)] - 250,
             wariant = colnames(tab)[col(tab)], udzial = as.vector(tab))
}))
blok$strategia <- factor(blok$strategia, levels = names(wyniki))
p2 <- ggplot(blok, aes(odslona, udzial, fill = wariant)) +
  geom_col(width = 500, colour = "white", linewidth = 0.15) +
  facet_wrap(~ strategia, ncol = 1) +
  scale_fill_manual(values = kol_wariant, labels = paste0(naglowki$wariant, " (CTR ", 100 * mu, "%)"), name = "Nagłówek:") +
  scale_x_continuous(breaks = seq(0, 20000, 4000), labels = function(x) format(x, big.mark = " ")) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), breaks = c(0, 0.5, 1)) +
  labs(x = "Numer odsłony", y = "Udział w bloku 500 odsłon",
       title = "Jeden przebieg każdej strategii: komu oddaje odsłony") +
  motyw
p2   # zapis: ggsave("wielorekie-bandyty-jeden-przebieg.svg", p2, width = 10, height = 7)
Wynik w R
                                                  sr_klikniec sr_utraconych
Test A/B, potem zwycięzca    2047 2409 11527 4017       918.9          78.9
Epsilon-zachłanna (ε = 0.10) 1002 2062 12376 4560       937.3          63.0
UCB1                         3944 4570  6330 5155       863.2         135.8
  klikniecia_wyroczni klikniecia_przy_rownym_podziale
1                1000                             845
3. Skumulowany żal i wrażliwość na parametry: Rysunek 3
R
# Rysunek 3. Skumulowany żal (utracone kliknięcia) w czasie i wrażliwość na parametry strategii; wymaga przepisów 1–2
zal_t <- do.call(rbind, lapply(names(wyniki), function(s) data.frame(strategia = s, wyniki[[s]]$zapis)))
zal_t$strategia <- factor(zal_t$strategia, levels = names(wyniki))
print(subset(zal_t, t %in% c(2000, 8000, 20000), c(strategia, t, zal_sr, zal_p10, zal_p90)), row.names = FALSE, digits = 4)

# Wrażliwość: inne ε, inna długość testu A/B i UCB z premią zmniejszoną 5 razy (po 1000 przebiegów)
set.seed(6571)
warianty <- list("Test A/B, 4000 odsłon" = list("ab", n_test = 4000), "Test A/B, 12 000 odsłon" = list("ab", n_test = 12000),
                 "Epsilon-zachłanna, ε = 0.05" = list("eps", eps = 0.05), "Epsilon-zachłanna, ε = 0.20" = list("eps", eps = 0.20),
                 "UCB z premią × 0.2" = list("ucb", c_ucb = 0.2))
wrazliwosc <- do.call(rbind, lapply(names(warianty), function(n) {
  w <- do.call(symuluj, c(warianty[[n]], list(mu1 = mu)))
  data.frame(wariant = n, sr_utraconych = round(mean(w$zal), 1), se = round(sd(w$zal) / sqrt(1000), 2),
             trafny_na_koniec_proc = round(100 * tail(w$zapis$trafny, 1), 1))
}))
print(wrazliwosc, row.names = FALSE)

# Rysunek 3: średni skumulowany żal z pasmem od 10. do 90. percentyla przebiegów
konce <- subset(zal_t, t == 20000)
p3 <- ggplot(zal_t, aes(t, zal_sr, colour = strategia, fill = strategia)) +
  geom_ribbon(aes(ymin = zal_p10, ymax = zal_p90), alpha = 0.15, colour = NA) +
  geom_line(aes(linetype = strategia), linewidth = 0.9) +
  geom_vline(xintercept = 8000, colour = "grey55", linetype = "dotted") +
  annotate("text", x = 8150, y = 5, label = "koniec testu A/B", hjust = 0, size = 3.2, colour = "grey35") +
  geom_text(data = konce, aes(x = 20200, label = sprintf("%.0f", zal_sr)), hjust = 0, size = 3.5, show.legend = FALSE) +
  scale_colour_manual(values = kol_strategia, name = NULL) +
  scale_fill_manual(values = kol_strategia, name = NULL) +
  scale_linetype_manual(values = c("solid", "22", "42"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 20000, 4000), labels = function(x) format(x, big.mark = " "),
                     expand = expansion(mult = c(0.01, 0.06))) +
  labs(x = "Numer odsłony", y = "Utracone kliknięcia (skumulowany żal)",
       title = "Ile kliknięć kosztuje uczenie się – średnia z 1000 przebiegów") +
  motyw
p3   # zapis: ggsave("wielorekie-bandyty-zal.svg", p3, width = 10, height = 5.8)
Wynik w R
                    strategia     t zal_sr zal_p10 zal_p90
    Test A/B, potem zwycięzca  2000  15.50  15.186   15.83
    Test A/B, potem zwycięzca  8000  62.00  61.373   62.61
    Test A/B, potem zwycięzca 20000  78.90  61.456  134.19
 Epsilon-zachłanna (ε = 0.10)  2000  11.53   2.013   21.21
 Epsilon-zachłanna (ε = 0.10)  8000  33.91   7.211   72.99
 Epsilon-zachłanna (ε = 0.10) 20000  63.01  16.820  131.22
                         UCB1  2000  14.80  14.074   15.54
                         UCB1  8000  56.94  54.231   59.55
                         UCB1 20000 135.80 129.093  142.39
                     wariant sr_utraconych   se trafny_na_koniec_proc
       Test A/B, 4000 odsłon          69.9 1.94                  68.3
     Test A/B, 12 000 odsłon         101.6 0.63                  83.4
 Epsilon-zachłanna, ε = 0.05          71.8 2.09                  70.8
 Epsilon-zachłanna, ε = 0.20          66.3 1.31                  86.1
          UCB z premią × 0.2          71.4 0.63                  96.6
4. Trafność wskazania w czasie: Rysunek 4
R
# Rysunek 4. Odsetek przebiegów, w których strategia uznaje za najlepszy prawdziwie najlepszy nagłówek C; wymaga przepisów 1–2
traf <- do.call(rbind, lapply(names(wyniki), function(s) {
  z <- wyniki[[s]]$zapis
  data.frame(strategia = s, t = z$t, trafny = z$trafny, se = sqrt(z$trafny * (1 - z$trafny) / 1000))  # błąd Monte Carlo
}))
traf$strategia <- factor(traf$strategia, levels = names(wyniki))
print(transform(subset(traf, t %in% c(2000, 8000, 20000)), trafny = round(100 * trafny, 1), se = round(100 * se, 2)),
      row.names = FALSE)

# Który nagłówek wskazuje strategia po 20 000 odsłon (najwyższy CTR; w teście A/B – wdrożony zwycięzca)?
wybrany <- t(sapply(wyniki, function(w) {
  m <- w$S / w$N; m[w$N == 0] <- -Inf
  wsk <- if (length(w$N_test)) w$wybor else max.col(m, ties.method = "random")
  round(100 * prop.table(table(factor(wsk, 1:4, names(mu)))), 1)
}))
print(wybrany)

p4 <- ggplot(traf, aes(t, trafny, colour = strategia, fill = strategia)) +
  geom_ribbon(aes(ymin = trafny - 1.96 * se, ymax = trafny + 1.96 * se), alpha = 0.18, colour = NA) +
  geom_line(aes(linetype = strategia), linewidth = 0.9) +
  geom_hline(yintercept = 0.25, colour = "grey55", linetype = "dotted") +
  annotate("text", x = 19800, y = 0.27, label = "zgadywanie (1 z 4)", hjust = 1, size = 3.2, colour = "grey35") +
  geom_vline(xintercept = 8000, colour = "grey55", linetype = "dotted") +
  scale_colour_manual(values = kol_strategia, name = NULL) +
  scale_fill_manual(values = kol_strategia, name = NULL) +
  scale_linetype_manual(values = c("solid", "22", "42"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 20000, 4000), labels = function(x) format(x, big.mark = " ")) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 1)) +
  labs(x = "Numer odsłony", y = "Przebiegi z poprawnym wskazaniem C",
       title = "Jak często strategia wskazuje właściwy nagłówek (pasmo: ±1.96 błędu MC)") +
  motyw
p4   # zapis: ggsave("wielorekie-bandyty-trafnosc.svg", p4, width = 10, height = 5.6)
Wynik w R
                    strategia     t trafny   se
    Test A/B, potem zwycięzca  2000   61.3 1.54
    Test A/B, potem zwycięzca  8000   79.4 1.28
    Test A/B, potem zwycięzca 20000   79.4 1.28
 Epsilon-zachłanna (ε = 0.10)  2000   47.1 1.58
 Epsilon-zachłanna (ε = 0.10)  8000   66.8 1.49
 Epsilon-zachłanna (ε = 0.10) 20000   79.9 1.27
                         UCB1  2000   58.0 1.56
                         UCB1  8000   77.7 1.32
                         UCB1 20000   93.4 0.79
                               A   B    C    D
Test A/B, potem zwycięzca    0.4 3.4 79.4 16.8
Epsilon-zachłanna (ε = 0.10) 0.2 3.1 79.9 16.8
UCB1                         0.0 0.5 93.3  6.2
5. Obciążenie średnich i pokrycie przedziałów: Rysunek 5
R
# Rysunek 5. Dlaczego bandyta utrudnia wnioskowanie: obciążone średnie i zbyt wąskie przedziały; wymaga przepisów 1–2
library(patchwork)
ocen <- function(N, S, s) {                         # CTR każdego nagłówka i 95% przedział Walda w każdym przebiegu
  p <- S / N; se <- sqrt(p * (1 - p) / N)
  pokryte <- (p - 1.96 * se <= rep(mu, each = nrow(N))) & (rep(mu, each = nrow(N)) <= p + 1.96 * se)
  data.frame(analiza = s, wariant = names(mu), sr_n = round(colMeans(N)),
             obciazenie_pp = round(100 * (colMeans(p, na.rm = TRUE) - mu), 3),
             wzgledne_proc = round(100 * (colMeans(p, na.rm = TRUE) - mu) / mu, 1),
             pokrycie_proc = round(100 * colMeans(pokryte, na.rm = TRUE), 1), row.names = NULL)
}
wn <- rbind(ocen(wyniki[[1]]$N_test, wyniki[[1]]$S_test, "Test A/B: tylko 8000 odsłon testu"),
            ocen(wyniki[[1]]$N, wyniki[[1]]$S, "Test A/B: wszystkie 20 000 odsłon"),
            ocen(wyniki[[2]]$N, wyniki[[2]]$S, names(wyniki)[2]),
            ocen(wyniki[[3]]$N, wyniki[[3]]$S, names(wyniki)[3]))
wn$analiza <- factor(wn$analiza, levels = rev(unique(wn$analiza)))
print(wn, row.names = FALSE)
cat("Błąd Monte Carlo pokrycia 95% przy 1000 przebiegów:", round(100 * sqrt(0.95 * 0.05 / 1000), 2), "pp\n")

# Odsłony nagłówka B w epsilon-zachłannej: zależą od tego, jak wypadł na początku
eB <- wyniki[[2]]
cat("Nagłówek B (ε = 0.10): mediana odsłon", median(eB$N[, 2]), "; P10–P90:", quantile(eB$N[, 2], c(0.1, 0.9)), "\n")
round(tapply(eB$S[, 2] / eB$N[, 2] - mu[2], cut(eB$N[, 2], c(0, 1000, 3000, Inf), dig.lab = 5), mean) * 100, 2)

pa <- ggplot(wn, aes(wzgledne_proc, analiza, colour = wariant, shape = wariant)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_point(size = 3, position = position_dodge(width = 0.6)) +
  scale_colour_manual(values = kol_wariant, name = "Nagłówek:") +
  scale_shape_manual(values = c(15, 16, 17, 18), name = "Nagłówek:") +
  labs(x = "Obciążenie średniego CTR (% prawdziwej wartości)", y = NULL, title = "A. Obciążenie średnich") + motyw
pb <- ggplot(wn, aes(pokrycie_proc, analiza, colour = wariant, shape = wariant)) +
  annotate("rect", xmin = 95 - 1.96 * 0.69, xmax = 95 + 1.96 * 0.69, ymin = -Inf, ymax = Inf, fill = "grey90") +
  geom_vline(xintercept = 95, colour = "grey40") +
  geom_point(size = 3, position = position_dodge(width = 0.6)) +
  scale_colour_manual(values = kol_wariant, name = "Nagłówek:") +
  scale_shape_manual(values = c(15, 16, 17, 18), name = "Nagłówek:") +
  labs(x = "Pokrycie przedziału 95% (%)", y = NULL, title = "B. Pokrycie przedziałów") +
  motyw + theme(axis.text.y = element_blank())
p5 <- pa + pb + plot_layout(widths = c(1.2, 1), guides = "collect") & theme(legend.position = "bottom")
p5   # zapis: ggsave("wielorekie-bandyty-wnioskowanie.svg", p5, width = 10, height = 5.6)
Wynik w R
                           analiza wariant  sr_n obciazenie_pp wzgledne_proc
 Test A/B: tylko 8000 odsłon testu       A  1999        -0.029          -0.8
 Test A/B: tylko 8000 odsłon testu       B  2001        -0.003          -0.1
 Test A/B: tylko 8000 odsłon testu       C  1999        -0.026          -0.5
 Test A/B: tylko 8000 odsłon testu       D  2001        -0.025          -0.6
 Test A/B: wszystkie 20 000 odsłon       A  2047        -0.033          -1.0
 Test A/B: wszystkie 20 000 odsłon       B  2409        -0.024          -0.6
 Test A/B: wszystkie 20 000 odsłon       C 11527        -0.103          -2.1
 Test A/B: wszystkie 20 000 odsłon       D  4017        -0.084          -1.9
      Epsilon-zachłanna (ε = 0.10)       A  1002        -0.147          -4.2
      Epsilon-zachłanna (ε = 0.10)       B  2062        -0.194          -4.8
      Epsilon-zachłanna (ε = 0.10)       C 12376        -0.211          -4.2
      Epsilon-zachłanna (ε = 0.10)       D  4560        -0.256          -5.8
                              UCB1       A  3944        -0.023          -0.7
                              UCB1       B  4570        -0.018          -0.5
                              UCB1       C  6330        -0.022          -0.4
                              UCB1       D  5155        -0.031          -0.7
 pokrycie_proc
          94.5
          95.9
          95.7
          95.0
          94.7
          96.2
          92.2
          95.2
          94.8
          93.7
          92.3
          93.9
          95.3
          94.9
          94.7
          94.6
Błąd Monte Carlo pokrycia 95% przy 1000 przebiegów: 0.69 pp
Nagłówek B (ε = 0.10): mediana odsłon 651.5 ; P10–P90: 499 5206.3
   (0,1000] (1000,3000]  (3000,Inf]
      -0.31        0.01        0.08
6. Zmiana najlepszego nagłówka w czasie: Rysunek 6
R
# Rysunek 6. Efekt zmieniający się w czasie: po 10 000 odsłon najlepszy staje się nagłówek D; wymaga przepisów 1–2
mu_po <- c(A = 0.035, B = 0.040, C = 0.038, D = 0.052)    # ustalone ręcznie: C traci, D zyskuje
set.seed(6572)
zmiana <- list("Test A/B, potem zwycięzca" = symuluj("ab", mu, mu_po, t_zmiana = 10000),
               "Epsilon-zachłanna (ε = 0.10)" = symuluj("eps", mu, mu_po, t_zmiana = 10000),
               "UCB1" = symuluj("ucb", mu, mu_po, t_zmiana = 10000),
               "Epsilon-zachłanna z zapominaniem (γ = 0.9995)" = symuluj("eps", mu, mu_po, t_zmiana = 10000, gamma = 0.9995))
zm <- do.call(rbind, lapply(names(zmiana), function(s) data.frame(strategia = s, zmiana[[s]]$zapis)))
zm$strategia <- factor(zm$strategia, levels = names(zmiana))
podsum <- do.call(rbind, lapply(names(zmiana), function(s) {
  z <- zmiana[[s]]$zapis
  data.frame(strategia = s, zal_do_10000 = round(z$zal_sr[z$t == 10000], 1),
             zal_po_zmianie = round(z$zal_sr[z$t == 20000] - z$zal_sr[z$t == 10000], 1),
             wskazuje_D_po_12000_proc = round(100 * z$trafny[z$t == 12000], 1),
             wskazuje_D_na_koniec_proc = round(100 * z$trafny[z$t == 20000], 1))
}))
print(podsum, row.names = FALSE)

kol_zm <- c(kol_strategia, "Epsilon-zachłanna z zapominaniem (γ = 0.9995)" = "#009E73")
p6a <- ggplot(zm, aes(t, zal_sr, colour = strategia, linetype = strategia)) +
  geom_vline(xintercept = 10000, colour = "grey55") +
  geom_line(linewidth = 0.9) +
  scale_colour_manual(values = kol_zm, name = NULL) +
  scale_linetype_manual(values = c("solid", "22", "42", "12"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 20000, 5000), labels = function(x) format(x, big.mark = " ")) +
  labs(x = "Numer odsłony", y = "Utracone kliknięcia", title = "A. Skumulowany żal") + motyw
p6b <- ggplot(zm, aes(t, trafny, colour = strategia, linetype = strategia)) +
  geom_vline(xintercept = 10000, colour = "grey55") +
  geom_line(linewidth = 0.9) +
  scale_colour_manual(values = kol_zm, name = NULL) +
  scale_linetype_manual(values = c("solid", "22", "42", "12"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 20000, 5000), labels = function(x) format(x, big.mark = " ")) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 1)) +
  labs(x = "Numer odsłony", y = "Wskazuje aktualnie najlepszy", title = "B. Trafność wskazania") + motyw
p6 <- p6a + p6b + plot_layout(guides = "collect") & theme(legend.position = "bottom") &
  guides(colour = guide_legend(ncol = 2), linetype = guide_legend(ncol = 2))
p6   # zapis: ggsave("wielorekie-bandyty-zmiana.svg", p6, width = 10, height = 6)
Wynik w R
                                     strategia zal_do_10000 zal_po_zmianie
                     Test A/B, potem zwycięzca         65.1          114.8
                  Epsilon-zachłanna (ε = 0.10)         39.3           87.1
                                          UCB1         70.5           92.0
 Epsilon-zachłanna z zapominaniem (γ = 0.9995)         36.8           54.3
 wskazuje_D_po_12000_proc wskazuje_D_na_koniec_proc
                     17.4                      17.4
                     26.9                      57.9
                     29.4                      83.7
                     42.7                      88.6
7. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("pomarańczowy – zielony (nagłówki A / C)" = c("#E69F00", "#009E73"),
             "błękitny – niebieski (nagłówki B / D)" = c("#56B4E9", "#0072B2"),
             "zielony – niebieski (nagłówki C / D; też zapominanie / epsilon-zachłanna)" = c("#009E73", "#0072B2"),
             "błękitny – zielony (nagłówki B / C)" = c("#56B4E9", "#009E73"),
             "niebieski – cynober (epsilon-zachłanna / UCB1)" = c("#0072B2", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                          widzenie_typowe
pomarańczowy – zielony (nagłówki A / C)                                              88.7
błękitny – niebieski (nagłówki B / D)                                                26.4
zielony – niebieski (nagłówki C / D; też zapominanie / epsilon-zachłanna)            70.1
błękitny – zielony (nagłówki B / C)                                                  59.5
niebieski – cynober (epsilon-zachłanna / UCB1)                                      114.6
czerwony – zielony (do unikania)                                                    121.7
                                                                          deuteranopia
pomarańczowy – zielony (nagłówki A / C)                                           66.3
błękitny – niebieski (nagłówki B / D)                                             24.7
zielony – niebieski (nagłówki C / D; też zapominanie / epsilon-zachłanna)         55.4
błękitny – zielony (nagłówki B / C)                                               48.8
niebieski – cynober (epsilon-zachłanna / UCB1)                                   108.3
czerwony – zielony (do unikania)                                                  21.1
                                                                          protanopia
pomarańczowy – zielony (nagłówki A / C)                                         51.5
błękitny – niebieski (nagłówki B / D)                                           24.6
zielony – niebieski (nagłówki C / D; też zapominanie / epsilon-zachłanna)       58.0
błękitny – zielony (nagłówki B / C)                                             51.9
niebieski – cynober (epsilon-zachłanna / UCB1)                                  91.9
czerwony – zielony (do unikania)                                                31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, macierze, kwantyle – pakiety base i stats). Rysunki wykonano w ggplot2 i złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Raportowanie CTR z bandyty jak z testu A/B. Średnie są zaniżone, a przedziały za wąskie (rysunek 5). Analizuj fazę z losowym, równym podziałem albo użyj estymatorów dla danych adaptacyjnych.
- Zbyt mała eksploracja. Przy ε = 0.05 strategia częściej utyka na złym nagłówku (70.8% trafnych wskazań wobec 86.1% przy ε = 0.20).
- Bandyta dla metryk z opóźnieniem. Jeśli kliknięcie liczy się dopiero po zakupie za tydzień, strategia przez tydzień uczy się na niepełnych danych.
Najczęstsze pytania
Czym różni się wieloręki bandyta od testu A/B?
Test A/B dzieli ruch po równo przez z góry ustalony czas, a potem wdraża zwycięzcę – najpierw tylko się uczy, potem tylko zarabia. Bandyta robi jedno i drugie naraz: po każdej odsłonie przesuwa ruch w stronę wariantu, który dotąd wypada najlepiej. W przykładzie strategia epsilon-zachłanna straciła średnio 63.0 kliknięcia, a test A/B 78.9.
Co to jest żal (regret) w problemie wielorękiego bandyty?
To suma oczekiwanych strat względem strategii, która od początku zna najlepszy wariant: przy każdej odsłonie gorszego wariantu dodajemy różnicę jego prawdziwego CTR i CTR najlepszego. Żal da się policzyć tylko w symulacji, gdzie prawdziwe wartości są znane (Bubeck i Cesa-Bianchi, 2012).
Jak dobrać epsilon w strategii epsilon-zachłannej?
Symulacją z realistycznymi CTR i horyzontem. W przykładzie ε = 0.05 dało 71.8 utraconego kliknięcia i 70.8% trafnych wskazań, ε = 0.10 – 63.0 i 79.9%, a ε = 0.20 – 66.3 i 86.1%. Mała eksploracja grozi utknięciem na złym wariancie, duża – stałą stratą na słabych wariantach.
Czy po teście bandyckim można policzyć przedział ufności dla CTR?
Zwykły przedział Walda bywa wtedy mylący: liczba odsłon wariantu zależy od jego wcześniejszych wyników, więc średnie są zaniżone, a pokrycie spada (w przykładzie do 92.3%). Użyj estymatorów dla danych zebranych adaptacyjnie (Hadad i in., 2021) albo zrób test potwierdzający z równym podziałem.
Dlaczego UCB1 traci tyle kliknięć przy niskim CTR?
Premia za niepewność √(2 ln t / n) jest skrojona na nagrody z przedziału od 0 do 1 i przy CTR rzędu 5% wielokrotnie przewyższa różnice między wariantami, więc UCB1 długo pokazuje słabe nagłówki. W przykładzie pomniejszenie premii pięciokrotnie obniżyło żal ze 135.8 do 71.4 kliknięć.
Powiązane hasła
Przeczytaj też
Test A/B – plan i analiza
Metryka główna, liczebność z power.prop.test, losowanie i czas trwania, skutki podglądania wyników w symulacji oraz różnica odsetków z CI i względny wzrost.
Czytaj →PoradnikPułapki testów A/B na obrazkach
Zaglądanie do p, wiele wersji i metryk, efekt nowości i SRM w symulacjach 1000 testów A/A – pięć rysunków z kodem R i lista kontrolna.
Czytaj →PoradnikTest A/B z wieloma wariantami
Pięć tematów maila i kontrola: Dunnett, Holm i Tukey, klątwa zwycięzcy w 1000 symulacji, test potwierdzający i moc – pięć rysunków z kodem R.
Czytaj →PoradnikCUPED – krótszy test A/B
Wydatki sprzed testu jako kowariant: węższy przedział, symulacja 1000 testów, związek z ANCOVA i pułapka kowariantu po starcie – z kodem R.
Czytaj →PoradnikIle kreacji testować przy małym budżecie
20 000 wyświetleń i pytanie: 2, 4 czy 8 kreacji? Szansa wyboru najlepszej, wartość informacji w zł i klątwa zwycięzcy – z kodem R.
Czytaj →Piszesz pracę o eksperymentach online?
Pomożemy zaplanować test A/B lub porównanie strategii przydziału, przeprowadzić symulację i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Besbes, O., Gur, Y., & Zeevi, A. (2019). Optimal exploration–exploitation in a multi-armed bandit problem with non-stationary rewards. Stochastic Systems, 9(4), 319–337. https://doi.org/10.1287/stsy.2019.0033 ● Otwarty dostęp
- Bubeck, S., & Cesa-Bianchi, N. (2012). Regret analysis of stochastic and nonstochastic multi-armed bandit problems. Foundations and Trends in Machine Learning, 5(1), 1–122. https://doi.org/10.1561/2200000024 ● Otwarty dostęp: pełny tekst
- Hadad, V., Hirshberg, D. A., Zhan, R., Wager, S., & Athey, S. (2021). Confidence intervals for policy evaluation in adaptive experiments. Proceedings of the National Academy of Sciences, 118(15), Article e2014602118. https://doi.org/10.1073/pnas.2014602118 ● Otwarty dostęp
- Johari, R., Koomen, P., Pekelis, L., & Walsh, D. (2022). Always valid inference: Continuous monitoring of A/B tests. Operations Research, 70(3), 1806–1821. https://doi.org/10.1287/opre.2021.2135
- Kohavi, R., Longbotham, R., Sommerfield, D., & Henne, R. M. (2009). Controlled experiments on the web: Survey and practical guide. Data Mining and Knowledge Discovery, 18(1), 140–181. https://doi.org/10.1007/s10618-008-0114-1 ● Otwarty dostęp
- Robbins, H. (1952). Some aspects of the sequential design of experiments. Bulletin of the American Mathematical Society, 58(5), 527–535. https://doi.org/10.1090/s0002-9904-1952-09620-8 ● Otwarty dostęp
- Villar, S. S., Bowden, J., & Wason, J. (2015). Multi-armed bandit models for the optimal design of clinical trials: Benefits and challenges. Statistical Science, 30(2), 199–215. https://doi.org/10.1214/14-sts504 ● Otwarty dostęp
Cytowania BibTeX
@article{besbes2019optimal, author={Besbes, Omar and Gur, Yonatan and Zeevi, Assaf}, title={{Optimal exploration–exploitation in a multi-armed bandit problem with non-stationary rewards}}, journal={Stochastic Systems}, year={2019}, volume={9}, number={4}, pages={319--337}, doi={10.1287/stsy.2019.0033}}@article{bubeck2012regret, author={Bubeck, Sébastien and Cesa-Bianchi, Nicolò}, title={{Regret analysis of stochastic and nonstochastic multi-armed bandit problems}}, journal={Foundations and Trends in Machine Learning}, year={2012}, volume={5}, number={1}, pages={1--122}, doi={10.1561/2200000024}}@article{hadad2021confidence, author={Hadad, Vitor and Hirshberg, David A. and Zhan, Ruohan and Wager, Stefan and Athey, Susan}, title={{Confidence intervals for policy evaluation in adaptive experiments}}, journal={Proceedings of the National Academy of Sciences}, year={2021}, volume={118}, number={15}, eid={e2014602118}, doi={10.1073/pnas.2014602118}}@article{johari2022always, author={Johari, Ramesh and Koomen, Pete and Pekelis, Leonid and Walsh, David}, title={{Always valid inference: Continuous monitoring of A/B tests}}, journal={Operations Research}, year={2022}, volume={70}, number={3}, pages={1806--1821}, doi={10.1287/opre.2021.2135}}@article{kohavi2009controlled, author={Kohavi, Ron and Longbotham, Roger and Sommerfield, Dan and Henne, Randal M.}, title={{Controlled experiments on the web: Survey and practical guide}}, journal={Data Mining and Knowledge Discovery}, year={2009}, volume={18}, number={1}, pages={140--181}, doi={10.1007/s10618-008-0114-1}}@article{robbins1952some, author={Robbins, Herbert}, title={{Some aspects of the sequential design of experiments}}, journal={Bulletin of the American Mathematical Society}, year={1952}, volume={58}, number={5}, pages={527--535}, doi={10.1090/s0002-9904-1952-09620-8}}@article{villar2015multi, author={Villar, Sofía S. and Bowden, Jack and Wason, James}, title={{Multi-armed bandit models for the optimal design of clinical trials: Benefits and challenges}}, journal={Statistical Science}, year={2015}, volume={30}, number={2}, pages={199--215}, doi={10.1214/14-sts504}}