Przykład: zakład opakowań kartonowych i 650 pracowników
Fikcyjny zakład produkuje kartony. Pracuje w nim 650 osób na czterech wydziałach: tektura falista, sztancowanie i klejenie, magazyn i wysyłka oraz administracja; na trzech pierwszych część osób ma nocne zmiany. Dział kadr ma rejestr nieobecności chorobowych z lat 2024–2025 i pyta: gdzie absencja jest naprawdę wyższa, czy „poniedziałkowe zwolnienia” to fakt i czy wskaźnik Bradforda dobrze wskazuje osoby do rozmowy?
W dwa lata zarejestrowano 2346 epizodów nieobecności. Tylko 73.8% osób pracowało przez cały okres (523 dni robocze). Znamy wydział, zmianę, wiek i dni pracy osoby oraz dzień rozpoczęcia i długość każdego epizodu. Hensing i in. (1998) zalecają, by częstość (liczbę epizodów) i długość absencji raportować osobno – tak robimy i tutaj.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Bazowa częstość to 1.6 epizodu na rok pracy (250 dni roboczych). Mnożą ją: wydział (sztancowanie × 1.15, magazyn × 1.30, administracja × 0.75), nocna zmiana (× 1.40) i każde 10 lat wieku (× 0.92). Każda osoba ma ukrytą skłonność do absencji (rozkład gamma, średnia 1, wariancja 0.67). 55% epizodów trwa 1–3 dni; od 2% do 20% (więcej u starszych) to długie zwolnienia powyżej 15 dni. Krótkie epizody zaczynają się w poniedziałek z prawdopodobieństwem .32, dłuższe – .22. Po pierwszym uruchomieniu zmieniliśmy dwa parametry: wariancję skłonności z 1 na 0.67 i mnożnik nocnej zmiany z 1.35 na 1.40, bo pierwsza wersja dawała oszacowanie efektu nocnej zmiany 1.02, 95% CI [0.85, 1.22], daleko od ustawionej prawdy. Ziarna 715 nie zmienialiśmy. Dane: absencja-pracownicy-zaklad-opakowan.csv i absencja-epizody-zaklad-opakowan.csv.
Rysunek 1: epizody i dni – dużo zer i długi ogon
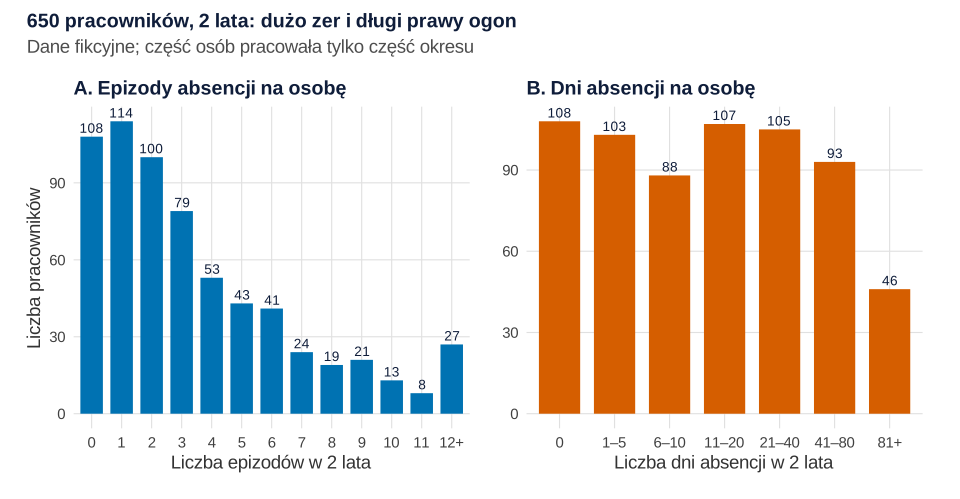
set.seed(715)).Co widać. 108 osób (16.6%) nie miało żadnego epizodu. Średnio przypada 3.6 epizodu na osobę przy wariancji 13.0 – 3.6 razy większej od średniej, co zapowiada nadmierną dyspersję (sprawdzamy ją w modelu). Dni absencji mają jeszcze dłuższy ogon: średnia 25.4, mediana 12, maksimum 269 dni. 5% osób z najdłuższą absencją odpowiada za 27.4% wszystkich dni, a epizody od 30 dni (5.0% epizodów) – za 39.6% dni.
Jak może zmylić. Rysunek pomija czas zatrudnienia: osoba przyjęta w listopadzie 2025 nie zdążyła zachorować. Dlatego w modelach jest offset – logarytm lat pracy.
Podpis do pracy:
Rysunek 2: Poisson, ujemny dwumianowy czy hurdle?
Liczbę epizodów opisujemy trzema modelami: regresji Poissona, regresji ujemnej dwumianowej (NB) i modelu hurdle, który osobno opisuje „czy w ogóle” i „ile razy” (Zeileis i in., 2008). Predyktory: wydział, nocna zmiana, wiek i offset. Dopasowanie oceniamy wiszącymi słupkami (rootogramem; Kleiber i Zeileis, 2016) i AIC.
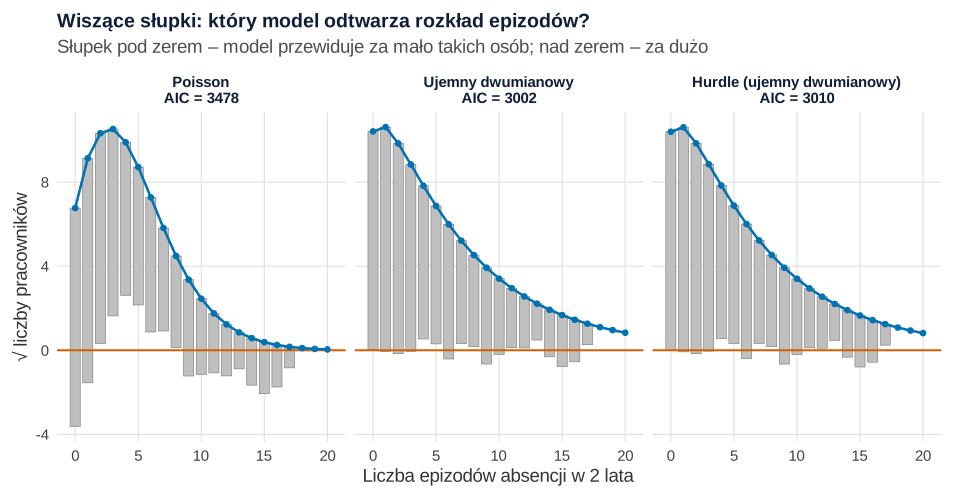
set.seed(715)).Co widać. Model Poissona przewiduje 45.7 osoby bez epizodu, a jest ich 108, i 11.9 osoby z co najmniej 10 epizodami (jest 46). Współczynnik dyspersji wynosi 2.82. Model NB przewiduje 108.3 zera i 44.8 osoby z 10+ epizodami (θ = 1.90, SE = 0.18). Hurdle odtwarza zera z definicji (108.0), ale ma 14 parametrów zamiast 7 i wyższe AIC: 3010.4 wobec 3001.6.
Jak może zmylić. Dużo zer nie oznacza nadmiaru zer. Tu zera wynikają z różnej skłonności do absencji, którą rozkład ujemny dwumianowy już opisuje. Inaczej było w przykładzie liczby zakupów z nadmiarem zer, gdzie zakup „czy w ogóle” był osobnym procesem. Model Poissona przy nadmiernej dyspersji zaniża błędy standardowe (Gardner i in., 1995). Dni absencji są rozproszone jeszcze bardziej (dyspersja Poissona 43.11, θ modelu NB 0.56), więc opisuj je osobno, medianą i odsetkiem długich zwolnień. Pełną procedurę opisuje wpis regresja dla zliczeń krok po kroku.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: efekt poniedziałku – test i model
Gdyby dzień startu nie miał znaczenia, na każdy dzień roboczy przypadałoby 20% epizodów. Sprawdzamy to testem chi-kwadrat zgodności osobno dla epizodów krótkich (1–3 dni) i dłuższych, a potem regresją logistyczną szansy startu w poniedziałek. Epizody jednej osoby nie są niezależne, więc używamy błędów standardowych odpornych na klastrowanie według pracownika.
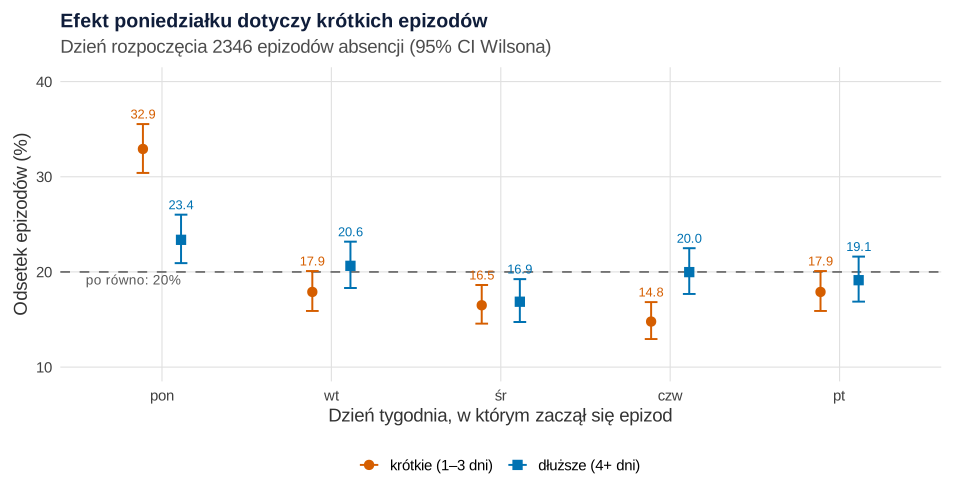
set.seed(715)).Co widać. 32.9% krótkich epizodów zaczyna się w poniedziałek, χ²(4) = 138.2, p < .001. Dla dłuższych odchylenie jest małe: 23.4% w poniedziałek, χ²(4) = 11.9, p = .018. W modelu krótki epizod ma 1.61 raza większą szansę startu w poniedziałek niż dłuższy, OR = 1.61, 95% CI [1.35, 1.93], przy podobnych szansach na wszystkich wydziałach i zmianach.
Jak może zmylić. Efekt poniedziałku nie dowodzi symulowania choroby. Infekcja, która zaczęła się w sobotę, trafia do rejestru w poniedziałek. W badaniach urazów zgłaszanych w poniedziałek popularne wyjaśnienie „to urazy spoza pracy” nie znalazło potwierdzenia (Card i McCall, 1996). Przy 2346 epizodach patrz na odsetki, nie tylko na p.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: wydziały i nocna zmiana – z korektą
Raport kadrowy zwykle podaje średnią liczbę epizodów na osobę: magazyn 4.88, sztancowanie 3.67, tektura 3.43, administracja 2.39. Pomija ona czas zatrudnienia, a nocna zmiana, obecna tylko na trzech wydziałach, jest zmienną zakłócającą. Dlatego dopasowujemy model ujemny dwumianowy z offsetem w dwóch wersjach: z samym wydziałem oraz z wydziałem, nocną zmianą i wiekiem.
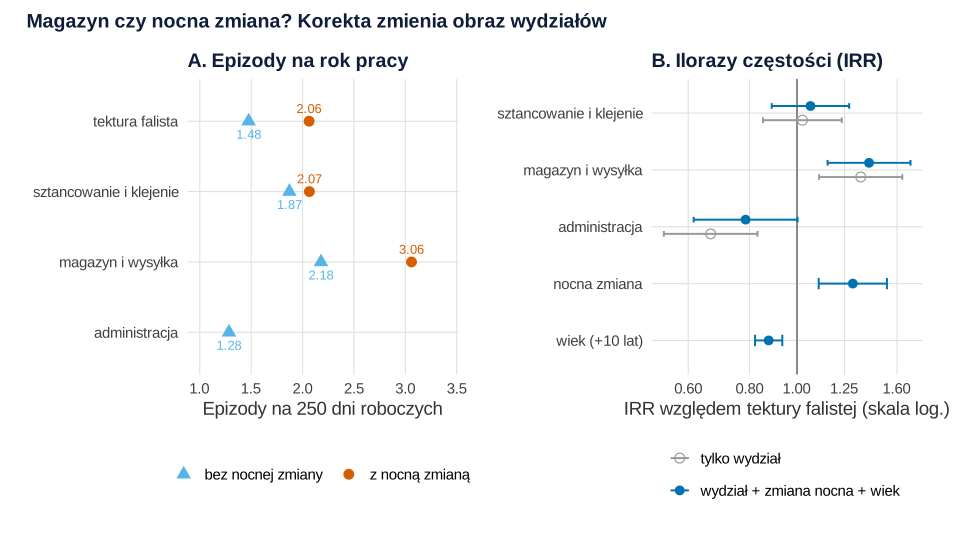
set.seed(715)).Co widać. Na każdym wydziale produkcyjnym osoby z nocną zmianą mają więcej epizodów. Po korekcie nocna zmiana wiąże się z 30% wyższą częstością, IRR = 1.30, 95% CI [1.11, 1.53], a każde 10 lat wieku z niższą (IRR = 0.88, 95% CI [0.82, 0.93]). Administracja bez korekty wygląda na wydział z o 33% niższą absencją (IRR = 0.67, 95% CI [0.54, 0.83]). Z korektą różnica maleje do IRR = 0.79, 95% CI [0.62, 1.00] – część „przewagi” administracji to brak nocnej zmiany. Magazyn ma wyższą częstość niż tektura falista także po korekcie (IRR = 1.40, 95% CI [1.15, 1.70]). Po poprawce Holma na sześć porównań par wydziałów różnią się magazyn od tektury (p = .003) i od sztancowania (p = .026), a administracja od sztancowania (p = .040) i magazynu (p < .001), ale nie od tektury (p = .105).
Jak może zmylić. Prawdziwe mnożniki z symulacji to 1.40 i 0.75 – model trafia blisko, ale nie dokładnie. W prawdziwych badaniach związek pracy zmianowej z absencją nie jest jednoznaczny (Tüchsen i in., 2008). Do tego działa efekt zdrowego pracownika: osoby, które źle znoszą noce, przechodzą na dzień albo odchodzą. Model pokazuje związek, nie przyczynę.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: karta „Bradford: 1 × 10 dni vs 10 × 1 dzień”
Wskaźnik Bradforda to popularna w działach kadr miara absencji, zwykle liczona za ostatnie 52 tygodnie:
gdzie S to liczba epizodów, a D – łączna liczba dni absencji. Kwadrat sprawia, że liczba przerw waży dużo więcej niż ich długość; w założeniu krótkie, niezapowiedziane nieobecności bardziej dezorganizują zmianę niż jedno długie zastępstwo.
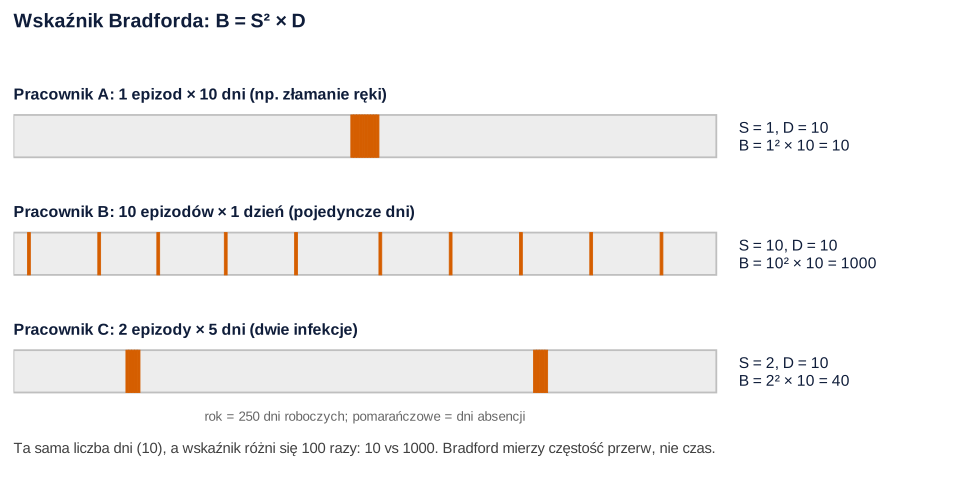
Co widać. Każdy z trzech pracowników był nieobecny 10 dni. Pracownik A ze złamaną ręką ma wskaźnik 10, pracownik B z dziesięcioma pojedynczymi dniami – 1000, a C z dwiema infekcjami – 40. Wskaźnik mierzy częstość przerw, a długości prawie nie widzi.
Jak może zmylić. Dwie zwykłe infekcje dają wskaźnik czterokrotnie wyższy niż złamanie. A to długa absencja jest dobrym sygnałem stanu zdrowia (Kivimäki i in., 2003).
Podpis do pracy:
Rysunek 6: co premiuje wskaźnik Bradforda i jak myli
Sprawdzamy, co dzieje się ze wskaźnikiem, gdy 12 dni dzielimy na coraz więcej epizodów, i ile osób przekroczy przykładowy próg 250 (próg ustaliliśmy ręcznie; firmy stosują różne) wyłącznie przez przypadek. Symulujemy 1000 identycznych pracowników: każdy ma średnio 1.8 epizodu w roku, a długości epizodów losujemy z rejestru zakładu.
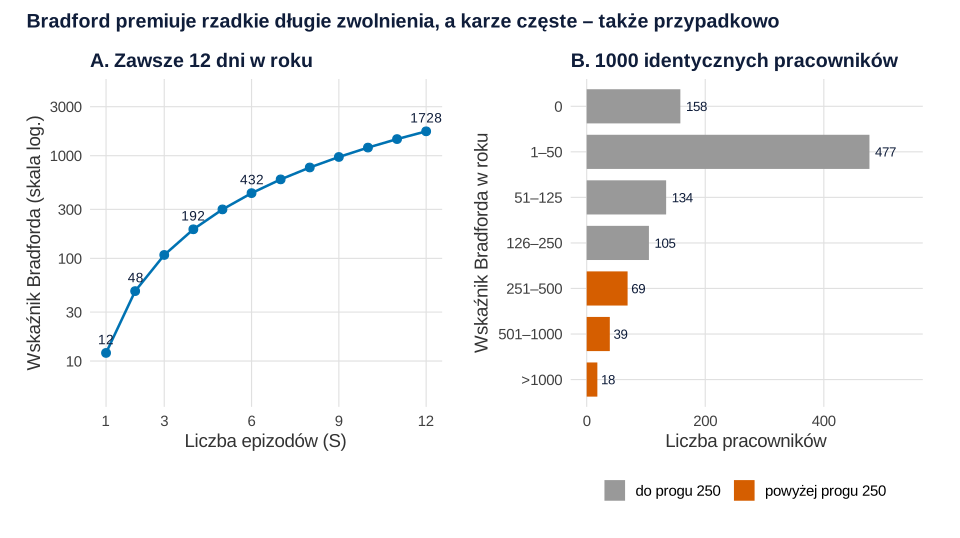
set.seed(715)).Co widać. Przy 12 dniach wskaźnik rośnie od 12 (jeden epizod) do 1728 (dwanaście epizodów) – 144 razy. Wśród 1000 identycznych pracowników 12.6% przekracza próg 250, choć nikt nie różni się od innych niczym poza przypadkiem. Mediana wskaźnika to 24. W zakładzie wśród 480 osób zatrudnionych przez cały okres 84 przekroczyły próg w 2024 roku. W 2025 roku przekroczyło go znowu 46 z nich (54.8%) i 12.9% osób, które w 2024 roku były poniżej progu. Korelacja Spearmana wskaźnika z obu lat wynosi .50.
Jak może zmylić. Osoba z wysokim wskaźnikiem w jednym roku zwykle ma niższy w następnym, nawet bez żadnej rozmowy – to regresja do średniej. W zakładzie 45.2% wskazanych spadło poniżej progu bez żadnej interwencji – gdyby z nimi rozmawiano, rozmowa wyglądałaby na skuteczną. Podobny problem z rankingami opisuje wpis skargi na 1000 zamówień.
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w firmie
- Raportuj osobno liczbę epizodów i liczbę dni, zawsze na rok pracy, a dni także medianą i odsetkiem długich zwolnień.
- Porównuj wydziały z modelu z offsetem i korektą o nocną zmianę i wiek. W przykładzie przyczyny warto szukać w magazynie i w organizacji nocnych zmian, a nie w administracji.
- Poniedziałki: sprawdź obsadę porannej zmiany w poniedziałek i rozważ elastyczne zgłaszanie krótkiej niedyspozycji, zanim uznasz efekt za nadużycie.
- Wskaźnika Bradforda nie używaj jako automatu do kar. Jeśli firma go stosuje, traktuj próg jako sygnał do rozmowy o przyczynach, a skutek rozmów oceniaj na grupie porównawczej.
- Długie zwolnienia to sprawa dla medycyny pracy i planowania zastępstw, nie dla wskaźnika.
Związek absencji z wynagrodzeniem opisuje wpis siatka płac, a odejścia pracowników – rotacja pracowników w analizie przeżycia. Inne tematy prac: statystyka w pracy z zarządzania i ekonomii.
Jak opisać w pracy
Tabela do Wyników:
| Predyktor | IRR | 95% CI |
|---|---|---|
| Sztancowanie i klejenie (vs tektura falista) | 1.07 | [0.89, 1.28] |
| Magazyn i wysyłka | 1.40 | [1.15, 1.70] |
| Administracja | 0.79 | [0.62, 1.00] |
| Nocna zmiana (tak vs nie) | 1.30 | [1.11, 1.53] |
| Wiek (na 10 lat) | 0.88 | [0.82, 0.93] |
Pod tabelą dopisz θ = 1.90 i AIC.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy 1–6 po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, a kolejne korzystają z obiektów poprzednich. Przepis 7 jest samodzielny. Przepisy 1–6 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 i 6 – każdy zaczyna się od własnego set.seed(715). Ziarno 715 ustalono raz i nie zmieniano go. Pozostałe przepisy nie losują, więc uruchomione po przepisie 1 dadzą te same liczby co na stronie. Ręcznie ustalono: liczbę pracowników (650), udziały wydziałów, odsetki osób z nocną zmianą, rozkład wieku, odsetki przyjętych i odchodzących w trakcie, bazową częstość epizodów z mnożnikami, wariancję ukrytej skłonności, rozkład długości epizodów i prawdopodobieństwa dnia rozpoczęcia (przepis 1) oraz średnią 1.8 epizodu i próg 250 w symulacji (przepis 6). Po pierwszym uruchomieniu zmieniono dwa z nich: wariancję skłonności (1 → 0.67) i mnożnik nocnej zmiany (1.35 → 1.40). Wektor u to ukryta skłonność, której firma nie zna; w plikach CSV jej nie ma. Cały kod liczy się w kilka sekund.
1. Dane i rozkład epizodów i dni: Rysunek 1
R
# Rysunek 1. Fikcyjny zakład opakowań kartonowych: ile epizodów i ile dni absencji chorobowej w 2 lata
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii; sprawdzenie w przepisie 7) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", rozowy = "#CC79A7", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# 650 pracowników, okres 1.01.2024–31.12.2025. Wszystkie parametry ustalono ręcznie.
set.seed(715)                                    # ziarno ustalone raz, bez dobierania pod wynik
n <- 650
wydzialy <- c("tektura falista", "sztancowanie i klejenie", "magazyn i wysyłka", "administracja")
prac <- data.frame(id = sprintf("P%03d", 1:n),
                   wydzial = factor(sample(wydzialy, n, replace = TRUE, prob = c(.34, .28, .22, .16)), wydzialy))
# system trzyzmianowy z nocną zmianą: tylko na wydziałach produkcyjnych i w magazynie
prac$nocna <- ifelse(prac$wydzial == "administracja", 0,
                     rbinom(n, 1, ifelse(prac$wydzial == "magazyn i wysyłka", .40, .65)))
prac$wiek <- round(pmin(64, pmax(19, rnorm(n, 41, 11))))
# okres zatrudnienia w czasie analizy: 18% przyjęto w trakcie, 10% odeszło w trakcie
dni_rob <- seq(as.Date("2024-01-01"), as.Date("2025-12-31"), by = "day")
dni_rob <- dni_rob[as.integer(format(dni_rob, "%u")) <= 5]        # dni robocze pn–pt (bez świąt)
prac$od <- as.Date("2024-01-01"); prac$do <- as.Date("2025-12-31")
przyjeci <- runif(n) < .18
prac$od[przyjeci] <- sample(dni_rob[dni_rob < as.Date("2025-10-01")], sum(przyjeci), replace = TRUE)
odeszli <- !przyjeci & runif(n) < .10
prac$do[odeszli] <- sample(dni_rob[dni_rob > as.Date("2024-04-01")], sum(odeszli), replace = TRUE)
prac$dni_robocze <- sapply(1:n, function(i) sum(dni_rob >= prac$od[i] & dni_rob <= prac$do[i]))

# Ukryty mechanizm (prawda znana, bo dane są fikcyjne)
u <- rgamma(n, shape = 1.5, rate = 1.5)          # skłonność do absencji: średnia 1, wariancja 0.67
mnoz_wydz <- c(1, 1.15, 1.30, 0.75)[as.integer(prac$wydzial)]
czestosc <- 0.0064 * mnoz_wydz * 1.40^prac$nocna * 0.92^((prac$wiek - 40) / 10) * u   # epizodów na dzień roboczy
ile <- rpois(n, czestosc * prac$dni_robocze)
p_dzien_krotki <- c(.32, .18, .16, .16, .18)     # epizody 1–3 dni: częściej od poniedziałku
p_dzien_dluzszy <- c(.22, .20, .19, .20, .19)
nazwy_dni <- c("pon", "wt", "śr", "czw", "pt")
epi <- do.call(rbind, lapply(which(ile > 0), function(i) {
  k <- ile[i]
  p_dlugi <- min(.20, max(.02, .06 + .003 * (prac$wiek[i] - 40)))
  typ <- sample(c("krótki", "średni", "długi"), k, replace = TRUE, prob = c(.55, .45 - p_dlugi, p_dlugi))
  dni <- ifelse(typ == "krótki", sample(1:3, k, replace = TRUE, prob = c(.35, .35, .30)),
         ifelse(typ == "średni", pmin(14, 4 + rnbinom(k, mu = 4, size = 2)),
                pmin(182, round(exp(rnorm(k, log(35), 0.6))) + 15)))
  dzien <- sapply(dni, function(d) sample(1:5, 1, prob = if (d <= 3) p_dzien_krotki else p_dzien_dluzszy))
  moje <- dni_rob[dni_rob >= prac$od[i] & dni_rob <= prac$do[i]]
  start <- as.Date(sapply(dzien, function(w) { m <- moje[as.integer(format(moje, "%u")) == w]
                                              m[sample.int(length(m), 1)] }), origin = "1970-01-01")
  data.frame(id = prac$id[i], start = start, dzien = factor(nazwy_dni[dzien], nazwy_dni),
             dni = as.numeric(pmin(dni, prac$do[i] - start + 1)))          # zwolnienie ucięte na końcu zatrudnienia
}))
epi <- epi[order(epi$id, epi$start), ]
# epizod zaczynający się w trakcie poprzedniego zwolnienia tej samej osoby – odrzucony
koniec_pop <- ave(as.numeric(epi$start + epi$dni - 1), epi$id, FUN = function(x) c(-Inf, cummax(x)[-length(x)]))
epi <- epi[as.numeric(epi$start) > koniec_pop, ]
epi$rok <- as.integer(format(epi$start, "%Y"))

prac$epizody <- as.vector(table(factor(epi$id, prac$id)))
prac$dni_absencji <- as.vector(tapply(epi$dni, factor(epi$id, prac$id), sum, default = 0))
write.csv(prac[c("id", "wydzial", "nocna", "wiek", "dni_robocze", "epizody", "dni_absencji")],
          "absencja-pracownicy-zaklad-opakowan.csv", row.names = FALSE)
write.csv(epi[c("id", "start", "dzien", "dni")], "absencja-epizody-zaklad-opakowan.csv", row.names = FALSE)

c(pracownicy = n, epizody = nrow(epi), caly_okres_proc = round(100 * mean(prac$dni_robocze == length(dni_rob)), 1),
  dni_roboczych_max = length(dni_rob))
round(c(sr_epizody = mean(prac$epizody), war_epizody = var(prac$epizody), zero_epizodow_proc = 100 * mean(prac$epizody == 0),
        sr_dni = mean(prac$dni_absencji), war_dni = var(prac$dni_absencji), mediana_dni = median(prac$dni_absencji),
        maks_dni = max(prac$dni_absencji)), 1)
# Jaką część wszystkich dni absencji „zrobiło” 5% osób z najdłuższą absencją?
dni_sort <- sort(prac$dni_absencji, decreasing = TRUE)
round(c(udzial_top5_proc = 100 * sum(dni_sort[1:ceiling(.05 * n)]) / sum(dni_sort),
        epizody_do_3_dni_proc = 100 * mean(epi$dni <= 3), epizody_od_30_dni_proc = 100 * mean(epi$dni >= 30),
        dni_z_epizodow_od_30_proc = 100 * sum(epi$dni[epi$dni >= 30]) / sum(epi$dni)), 1)
table(wydzial = prac$wydzial, nocna = prac$nocna)

# Rysunek: A – liczba epizodów na osobę, B – liczba dni absencji na osobę (przedziały)
A <- as.data.frame(table(epizody = pmin(prac$epizody, 12)))
A$etyk <- ifelse(A$epizody == "12", "12+", as.character(A$epizody))
A$etyk <- factor(A$etyk, A$etyk)
granice <- c(-Inf, 0, 5, 10, 20, 40, 80, Inf)
B <- as.data.frame(table(dni = cut(prac$dni_absencji, granice,
                                   labels = c("0", "1–5", "6–10", "11–20", "21–40", "41–80", "81+"))))
pA <- ggplot(A, aes(etyk, Freq)) +
  geom_col(fill = kol[["niebieski"]], width = 0.75) +
  geom_text(aes(label = Freq), vjust = -0.4, size = 3.6, colour = "#0f1d3a") +
  labs(title = "A. Epizody absencji na osobę", x = "Liczba epizodów w 2 lata", y = "Liczba pracowników") + motyw
pB <- ggplot(B, aes(dni, Freq)) +
  geom_col(fill = kol[["pomaranczowy"]], width = 0.75) +
  geom_text(aes(label = Freq), vjust = -0.4, size = 3.6, colour = "#0f1d3a") +
  labs(title = "B. Dni absencji na osobę", x = "Liczba dni absencji w 2 lata", y = NULL) + motyw
p1 <- (pA | pB) + plot_annotation(
  title = "650 pracowników, 2 lata: dużo zer i długi prawy ogon",
  subtitle = "Dane fikcyjne; część osób pracowała tylko część okresu", theme = motyw)
p1                       # do pliku: ggsave("absencja-rozklad-epizodow-i-dni.svg", p1, width = 10, height = 5.2)
Wynik w R
       pracownicy           epizody   caly_okres_proc dni_roboczych_max
            650.0            2346.0              73.8             523.0
        sr_epizody        war_epizody zero_epizodow_proc             sr_dni
               3.6               13.0               16.6               25.4
           war_dni        mediana_dni           maks_dni
            1211.7               12.0              269.0
         udzial_top5_proc     epizody_do_3_dni_proc    epizody_od_30_dni_proc
                     27.4                      54.8                       5.0
dni_z_epizodow_od_30_proc
                     39.6
                         nocna
wydzial                     0   1
  tektura falista          66 147
  sztancowanie i klejenie  77 104
  magazyn i wysyłka        73  63
  administracja           120   0
2. Poisson, ujemny dwumianowy i hurdle: Rysunek 2
R
# Rysunek 2. Poisson, ujemny dwumianowy czy hurdle? Wiszące słupki (rootogram) narysowane ręcznie
# Dane wejściowe: prac, kol i motyw z przepisu 1.
library(MASS)                                    # glm.nb – regresja ujemna dwumianowa
library(pscl)                                    # hurdle – model z barierą zera

# Ekspozycja: lata pracy (250 dni roboczych = 1 rok), w modelu jako offset log(lata)
prac$lata <- prac$dni_robocze / 250
prac$wiek10 <- (prac$wiek - 40) / 10
f_licz <- epizody ~ wydzial + nocna + wiek10 + offset(log(lata))
m_pois <- glm(f_licz, family = poisson, data = prac)
m_nb   <- glm.nb(f_licz, data = prac)
m_hnb  <- hurdle(epizody ~ wydzial + nocna + wiek10 + offset(log(lata)) | wydzial + nocna + wiek10 + log(lata),
                 dist = "negbin", zero.dist = "binomial", data = prac)
modele <- list("Poisson" = m_pois, "Ujemny dwumianowy" = m_nb, "Hurdle (ujemny dwumianowy)" = m_hnb)

# Dyspersja modelu Poissona (suma kwadratów reszt Pearsona / df) i theta modelu NB
round(c(dyspersja_poisson = sum(residuals(m_pois, type = "pearson")^2) / df.residual(m_pois),
        theta_nb = m_nb$theta, se_theta = m_nb$SE.theta), 2)
# AIC i liczba parametrów
round(sapply(modele, function(m) c(AIC = AIC(m), parametry = attr(logLik(m), "df"))), 1)

# Oczekiwana liczba osób z k epizodami = suma P(Y = k) po wszystkich pracownikach
K <- 0:20
ocz <- list("Poisson" = sapply(K, function(k) sum(dpois(k, fitted(m_pois)))),
            "Ujemny dwumianowy" = sapply(K, function(k) sum(dnbinom(k, mu = fitted(m_nb), size = m_nb$theta))),
            "Hurdle (ujemny dwumianowy)" = colSums(predict(m_hnb, type = "prob", at = K)))
obs <- sapply(K, function(k) sum(prac$epizody == k))
round(t(sapply(ocz, function(e) c(zera = e[1], jeden = e[2], od_10 = sum(e[11:21])))), 1)
c(obserwowane_zera = obs[1], obserwowane_jeden = obs[2], obserwowane_od_10 = sum(obs[11:21]))

# Dni absencji to inny wynik: jeszcze większe rozproszenie (długie zwolnienia)
m_dni_p  <- glm(dni_absencji ~ wydzial + nocna + wiek10 + offset(log(lata)), family = poisson, data = prac)
m_dni_nb <- glm.nb(dni_absencji ~ wydzial + nocna + wiek10 + offset(log(lata)), data = prac)
round(c(dyspersja_poisson_dni = sum(residuals(m_dni_p, type = "pearson")^2) / df.residual(m_dni_p),
        theta_nb_dni = m_dni_nb$theta), 2)

# Wiszące słupki: słupek √obserwowanych zawieszony na krzywej √oczekiwanych
rg <- do.call(rbind, lapply(names(ocz), function(m)
  data.frame(model = m, k = K, ocz = sqrt(ocz[[m]]), obs = sqrt(obs))))
rg$model <- factor(rg$model, names(ocz),
                   labels = paste0(names(ocz), "\nAIC = ", round(sapply(modele, AIC))))
rg$dol <- rg$ocz - rg$obs
p2 <- ggplot(rg) +
  geom_rect(aes(xmin = k - 0.4, xmax = k + 0.4, ymin = dol, ymax = ocz), fill = "grey75", colour = "grey45",
            linewidth = 0.2) +
  geom_hline(yintercept = 0, colour = kol[["pomaranczowy"]], linewidth = 0.7) +
  geom_line(aes(k, ocz), colour = kol[["niebieski"]], linewidth = 0.9) +
  geom_point(aes(k, ocz), colour = kol[["niebieski"]], size = 1.5) +
  facet_wrap(~ model, ncol = 3) +
  scale_x_continuous(breaks = seq(0, 20, 5)) +
  labs(x = "Liczba epizodów absencji w 2 lata", y = "√ liczby pracowników",
       title = "Wiszące słupki: który model odtwarza rozkład epizodów?",
       subtitle = "Słupek pod zerem – model przewiduje za mało takich osób; nad zerem – za dużo") + motyw
p2                       # do pliku: ggsave("absencja-rootogram-poisson-nb-hurdle.svg", p2, width = 10, height = 5.2)
Wynik w R
dyspersja_poisson          theta_nb          se_theta
             2.82              1.90              0.18
          Poisson Ujemny dwumianowy Hurdle (ujemny dwumianowy)
AIC        3477.5            3001.6                     3010.4
parametry     6.0               7.0                       14.0
                            zera jeden od_10
Poisson                     45.7  83.4  11.9
Ujemny dwumianowy          108.3 112.6  44.8
Hurdle (ujemny dwumianowy) 108.0 112.4  44.2
 obserwowane_zera obserwowane_jeden obserwowane_od_10
              108               114                46
dyspersja_poisson_dni          theta_nb_dni
                43.11                  0.56
3. Efekt poniedziałku – test i model: Rysunek 3
R
# Rysunek 3. Efekt poniedziałku: w który dzień tygodnia zaczynają się epizody absencji?
# Dane wejściowe: epi, prac, kol i motyw z przepisu 1.
library(sandwich)                                # błędy standardowe odporne na klastrowanie (vcovCL)
library(lmtest)                                  # coeftest i coefci z podaną macierzą kowariancji

epi$dlugosc <- factor(ifelse(epi$dni <= 3, "krótkie (1–3 dni)", "dłuższe (4+ dni)"),
                      c("krótkie (1–3 dni)", "dłuższe (4+ dni)"))
tab <- table(epi$dlugosc, epi$dzien)
tab
round(100 * prop.table(tab, 1), 1)

pz <- function(p) if (p < .001) "p < .001" else paste("p =", sub("^0", "", formatC(p, format = "f", digits = 3)))
# Test zgodności: czy starty rozkładają się po równo na 5 dni roboczych (po 20%)?
for (g in levels(epi$dlugosc)) {
  t <- chisq.test(tab[g, ], p = rep(.2, 5))
  cat(g, ": chi2(", t$parameter, ") = ", round(t$statistic, 1), ", ", pz(t$p.value),
      "\n", sep = "")
}

# Model: szansa startu w poniedziałek a długość epizodu, wydział i zmiana nocna.
# Epizody jednej osoby nie są niezależne – błędy standardowe odporne na klastrowanie według osoby.
epi <- merge(epi, prac[c("id", "wydzial", "nocna")], by = "id")
epi$poniedzialek <- as.integer(epi$dzien == "pon")
epi$krotki <- as.integer(epi$dni <= 3)           # 1 = epizod 1–3 dni, 0 = 4 dni i dłużej
m_pon <- glm(poniedzialek ~ krotki + wydzial + nocna, family = binomial, data = epi)
V <- vcovCL(m_pon, cluster = ~ id)
wsp <- coeftest(m_pon, vcov. = V)
or <- data.frame(OR = exp(coef(m_pon)), exp(coefci(m_pon, vcov. = V)))[-1, ]
names(or) <- c("OR", "CI_dolna", "CI_gorna")
cbind(round(or, 2), p = sapply(wsp[-1, 4], pz))

# Rysunek: odsetek startów w każdy dzień z 95% CI (Wilsona), osobno dla krótkich i dłuższych epizodów
dz <- as.data.frame(tab)
names(dz) <- c("dlugosc", "dzien", "n")
dz$suma <- ave(dz$n, dz$dlugosc, FUN = sum)
ci <- t(mapply(function(x, m) prop.test(x, m, correct = FALSE)$conf.int, dz$n, dz$suma))
dz$proc <- 100 * dz$n / dz$suma; dz$dol <- 100 * ci[, 1]; dz$gora <- 100 * ci[, 2]
p3 <- ggplot(dz, aes(dzien, proc, colour = dlugosc, shape = dlugosc)) +
  geom_hline(yintercept = 20, linetype = "dashed", colour = "grey45") +
  geom_errorbar(aes(ymin = dol, ymax = gora), width = 0.15, position = position_dodge(0.45), linewidth = 0.7) +
  geom_point(size = 3.2, position = position_dodge(0.45)) +
  annotate("text", x = 0.55, y = 19.2, label = "po równo: 20%", hjust = 0, size = 3.6, colour = "grey35") +
  geom_text(aes(y = gora, label = sprintf("%.1f", proc)), position = position_dodge(0.45), vjust = -0.6, size = 3.4,
            show.legend = FALSE) +
  scale_colour_manual(values = c(kol[["pomaranczowy"]], kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c(16, 15), name = NULL) +
  scale_y_continuous(limits = c(10, 40)) +
  labs(title = "Efekt poniedziałku dotyczy krótkich epizodów",
       subtitle = paste0("Dzień rozpoczęcia ", nrow(epi), " epizodów absencji (95% CI Wilsona)"),
       x = "Dzień tygodnia, w którym zaczął się epizod", y = "Odsetek epizodów (%)") + motyw
p3                       # do pliku: ggsave("absencja-efekt-poniedzialku.svg", p3, width = 10, height = 5.2)
Wynik w R
                    pon  wt  śr czw  pt
  krótkie (1–3 dni) 423 230 212 190 230
  dłuższe (4+ dni)  248 219 179 212 203

                     pon   wt   śr  czw   pt
  krótkie (1–3 dni) 32.9 17.9 16.5 14.8 17.9
  dłuższe (4+ dni)  23.4 20.6 16.9 20.0 19.1
krótkie (1–3 dni): chi2(4) = 138.2, p < .001
dłuższe (4+ dni): chi2(4) = 11.9, p = .018
                                 OR CI_dolna CI_gorna        p
krotki                         1.61     1.35     1.93 p < .001
wydzialsztancowanie i klejenie 1.09     0.87     1.38 p = .456
wydzialmagazyn i wysyłka       0.91     0.72     1.16 p = .453
wydzialadministracja           0.85     0.62     1.16 p = .297
nocna                          0.87     0.70     1.07 p = .180
4. Wydziały, nocna zmiana i poprawka Holma: Rysunek 4
R
# Rysunek 4. Wydziały i zmiana nocna: surowe częstości i ilorazy częstości (IRR) z modelu ujemnego dwumianowego
# Dane wejściowe: prac, m_nb, kol i motyw z przepisów 1–2.
library(MASS)

# Surowe częstości: epizody na rok pracy (250 dni roboczych) w wydziałach i według zmiany
cz <- aggregate(cbind(epizody, lata) ~ wydzial + nocna, data = prac, FUN = sum)
cz$na_rok <- cz$epizody / cz$lata
cz$osoby <- aggregate(epizody ~ wydzial + nocna, data = prac, FUN = length)$epizody
cz[order(cz$wydzial), c("wydzial", "nocna", "osoby", "na_rok")] |> transform(na_rok = round(na_rok, 2))
# Średnia liczba epizodów na osobę bez uwzględnienia czasu zatrudnienia (to, co często trafia do raportu)
round(tapply(prac$epizody, prac$wydzial, mean), 2)

# Dwa modele ujemne dwumianowe z offsetem: tylko wydział i wydział + zmiana nocna + wiek (m_nb z przepisu 2)
m_wydz <- glm.nb(epizody ~ wydzial + offset(log(lata)), data = prac)
irr <- function(m, nazwa) {
  b <- coef(m)[-1]; se <- sqrt(diag(vcov(m)))[-1]
  data.frame(model = nazwa, czynnik = names(b), IRR = exp(b), dolna = exp(b - 1.96 * se), gorna = exp(b + 1.96 * se),
             row.names = NULL)
}
wyn <- rbind(irr(m_wydz, "tylko wydział"), irr(m_nb, "wydział + zmiana nocna + wiek"))
transform(wyn, IRR = round(IRR, 2), dolna = round(dolna, 2), gorna = round(gorna, 2))

# Porównania wydziałów parami (z modelu pełnego) z poprawką Holma na 6 porównań
b <- coef(m_nb); V <- vcov(m_nb)
w <- c("tektura falista" = NA, setNames(names(b)[2:4], levels(prac$wydzial)[2:4]))
pary <- combn(levels(prac$wydzial), 2)
por <- do.call(rbind, lapply(1:ncol(pary), function(j) {
  c1 <- setNames(rep(0, length(b)), names(b))
  if (!is.na(w[pary[2, j]])) c1[w[pary[2, j]]] <- 1
  if (!is.na(w[pary[1, j]])) c1[w[pary[1, j]]] <- -1
  est <- sum(c1 * b); se <- sqrt(drop(t(c1) %*% V %*% c1))
  data.frame(porownanie = paste(pary[2, j], "vs", pary[1, j]), IRR = round(exp(est), 2),
             p = 2 * pnorm(-abs(est / se)))
}))
por$p_holm <- p.adjust(por$p, "holm")
por$p <- round(por$p, 4); por$p_holm <- round(por$p_holm, 4)
por

# Dni absencji: jedna osoba z długim zwolnieniem a średnia wydziału
dni <- do.call(rbind, lapply(split(prac, prac$wydzial), function(d) {
  top <- which.max(d$dni_absencji)
  data.frame(wydzial = d$wydzial[1], dni_na_rok = sum(d$dni_absencji) / sum(d$lata),
             bez_1_osoby = sum(d$dni_absencji[-top]) / sum(d$lata[-top]), maks_osoba = d$dni_absencji[top],
             mediana_na_rok = median(d$dni_absencji / d$lata))
}))
transform(dni, dni_na_rok = round(dni_na_rok, 1), bez_1_osoby = round(bez_1_osoby, 1),
          mediana_na_rok = round(mediana_na_rok, 1))

# Rysunek: A – surowe częstości, B – IRR z dwóch modeli
cz$zmiana <- factor(ifelse(cz$nocna == 1, "z nocną zmianą", "bez nocnej zmiany"), c("bez nocnej zmiany", "z nocną zmianą"))
pA <- ggplot(cz, aes(na_rok, wydzial, colour = zmiana, shape = zmiana)) +
  geom_point(size = 3.4) +
  geom_text(aes(label = sprintf("%.2f", na_rok), vjust = ifelse(nocna == 1, -0.9, 1.9)), size = 3.4, show.legend = FALSE) +
  scale_y_discrete(limits = rev(levels(prac$wydzial))) +
  scale_colour_manual(values = c(kol[["blekit"]], kol[["pomaranczowy"]]), name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) +
  scale_x_continuous(limits = c(1, 3.4)) +
  labs(title = "A. Epizody na rok pracy", x = "Epizody na 250 dni roboczych", y = NULL) + motyw
etyk <- c("wydzialsztancowanie i klejenie" = "sztancowanie i klejenie", "wydzialmagazyn i wysyłka" = "magazyn i wysyłka",
          "wydzialadministracja" = "administracja", "nocna" = "nocna zmiana", "wiek10" = "wiek (+10 lat)")
wyn$czynnik <- factor(etyk[wyn$czynnik], rev(etyk))
wyn$model <- factor(wyn$model, c("tylko wydział", "wydział + zmiana nocna + wiek"))
pB <- ggplot(wyn, aes(IRR, czynnik, colour = model, shape = model)) +
  geom_vline(xintercept = 1, colour = "grey50") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, orientation = "y", linewidth = 0.7,
                position = position_dodge(0.5)) +
  geom_point(size = 3, position = position_dodge(0.5)) +
  scale_x_log10(breaks = c(0.6, 0.8, 1, 1.25, 1.6)) +
  scale_colour_manual(values = c(kol[["szary"]], kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c(1, 16), name = NULL) +
  labs(title = "B. Ilorazy częstości (IRR)", x = "IRR względem tektury falistej (skala log.)", y = NULL) + motyw +
  guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2))
p4 <- (pA | pB) + plot_annotation(title = "Magazyn czy nocna zmiana? Korekta zmienia obraz wydziałów", theme = motyw)
p4                       # do pliku: ggsave("absencja-wydzialy-nocna-zmiana.svg", p4, width = 10, height = 5.6)
Wynik w R
                  wydzial nocna osoby na_rok
1         tektura falista     0    66   1.48
5         tektura falista     1   147   2.06
2 sztancowanie i klejenie     0    77   1.87
6 sztancowanie i klejenie     1   104   2.07
3       magazyn i wysyłka     0    73   2.18
7       magazyn i wysyłka     1    63   3.06
4           administracja     0   120   1.28
        tektura falista sztancowanie i klejenie       magazyn i wysyłka
                   3.43                    3.67                    4.88
          administracja
                   2.39
                          model                        czynnik  IRR dolna gorna
1                 tylko wydział wydzialsztancowanie i klejenie 1.03  0.85  1.23
2                 tylko wydział       wydzialmagazyn i wysyłka 1.35  1.11  1.64
3                 tylko wydział           wydzialadministracja 0.67  0.54  0.83
4 wydział + zmiana nocna + wiek wydzialsztancowanie i klejenie 1.07  0.89  1.28
5 wydział + zmiana nocna + wiek       wydzialmagazyn i wysyłka 1.40  1.15  1.70
6 wydział + zmiana nocna + wiek           wydzialadministracja 0.79  0.62  1.00
7 wydział + zmiana nocna + wiek                          nocna 1.30  1.11  1.53
8 wydział + zmiana nocna + wiek                         wiek10 0.88  0.82  0.93
                                    porownanie  IRR      p p_holm
1   sztancowanie i klejenie vs tektura falista 1.07 0.4957 0.4957
2         magazyn i wysyłka vs tektura falista 1.40 0.0007 0.0033
3             administracja vs tektura falista 0.79 0.0525 0.1050
4 magazyn i wysyłka vs sztancowanie i klejenie 1.32 0.0065 0.0260
5     administracja vs sztancowanie i klejenie 0.74 0.0133 0.0398
6           administracja vs magazyn i wysyłka 0.56 0.0000 0.0000
                                        wydzial dni_na_rok bez_1_osoby
tektura falista                 tektura falista       14.2        13.6
sztancowanie i klejenie sztancowanie i klejenie       14.9        14.3
magazyn i wysyłka             magazyn i wysyłka       16.2        15.7
administracja                     administracja        8.3         7.7
                        maks_osoba mediana_na_rok
tektura falista                269            7.6
sztancowanie i klejenie        232            7.6
magazyn i wysyłka              154            9.1
administracja                  154            2.9
5. Karta wskaźnika Bradforda: Rysunek 5
R
# Rysunek 5. Karta „Bradford: 1 × 10 dni vs 10 × 1 dzień” – grafika z prostokątów w ggplot2
# Dane wejściowe: kol i motyw z przepisu 1 (nic nie losuje).
library(ggplot2)

# Wskaźnik Bradforda B = S² × D, gdzie S – liczba epizodów, D – łączna liczba dni absencji (zwykle w 52 tygodniach)
bradford <- function(S, D) S^2 * D
osoby <- data.frame(
  osoba = c("Pracownik A", "Pracownik B", "Pracownik C"),
  opis = c("1 epizod × 10 dni (np. złamanie ręki)", "10 epizodów × 1 dzień (pojedyncze dni)",
           "2 epizody × 5 dni (dwie infekcje)"),
  S = c(1, 10, 2), D = c(10, 10, 10))
osoby$B <- bradford(osoby$S, osoby$D)
osoby

# 250 dni roboczych w roku jako pasek; zaznaczone dni absencji
dni_A <- 121:130
dni_B <- c(6, 31, 52, 76, 101, 131, 156, 181, 206, 231)       # co ok. 5 tygodni, w poniedziałki
dni_C <- c(41:45, 186:190)
kafle <- rbind(data.frame(osoba = "Pracownik A", dzien = dni_A), data.frame(osoba = "Pracownik B", dzien = dni_B),
               data.frame(osoba = "Pracownik C", dzien = dni_C))
kafle$y <- 3 - match(kafle$osoba, osoby$osoba) + 1            # A na górze
osoby$y <- 3:1
p5 <- ggplot() +
  geom_rect(data = osoby, aes(xmin = 0, xmax = 250, ymin = y - 0.18, ymax = y + 0.18), fill = "grey93", colour = "grey75") +
  geom_rect(data = kafle, aes(xmin = dzien - 1, xmax = dzien, ymin = y - 0.18, ymax = y + 0.18),
            fill = kol[["pomaranczowy"]], colour = kol[["pomaranczowy"]], linewidth = 0.3) +
  geom_text(data = osoby, aes(x = 0, y = y + 0.36, label = paste0(osoba, ": ", opis)), hjust = 0, size = 4.2,
            fontface = "bold", colour = "#0f1d3a") +
  geom_text(data = osoby, aes(x = 258, y = y, label = paste0("S = ", S, ", D = ", D, "\nB = ", S, "² × ", D, " = ", B)),
            hjust = 0, size = 4.1, colour = "#0f1d3a", lineheight = 0.95) +
  annotate("text", x = 0, y = 0.35, hjust = 0, size = 3.9, colour = "grey25",
           label = "Ta sama liczba dni (10), a wskaźnik różni się 100 razy: 10 vs 1000. Bradford mierzy częstość przerw, nie czas.") +
  annotate("text", x = 125, y = 0.62, size = 3.5, colour = "grey40", label = "rok = 250 dni roboczych; pomarańczowe = dni absencji") +
  scale_x_continuous(limits = c(0, 330), expand = c(0, 0)) +
  scale_y_continuous(limits = c(0.2, 3.65)) +
  labs(title = "Wskaźnik Bradforda: B = S² × D", x = NULL, y = NULL) +
  motyw + theme(axis.text = element_blank(), panel.grid.major = element_blank())
p5                       # do pliku: ggsave("absencja-karta-bradforda.svg", p5, width = 10, height = 5.2)
Wynik w R
        osoba                                   opis  S  D    B
1 Pracownik A  1 epizod × 10 dni (np. złamanie ręki)  1 10   10
2 Pracownik B 10 epizodów × 1 dzień (pojedyncze dni) 10 10 1000
3 Pracownik C      2 epizody × 5 dni (dwie infekcje)  2 10   40
6. Bradford: ten sam czas, 1000 identycznych pracowników i dwa lata: Rysunek 6
R
# Rysunek 6. Co premiuje wskaźnik Bradforda i jak myli: ten sam czas absencji, różna liczba epizodów,
# oraz 1000 identycznych pracowników, których różni tylko przypadek
# Dane wejściowe: prac, epi, kol i motyw z przepisu 1.
library(ggplot2)
library(patchwork)
bradford <- function(S, D) S^2 * D

# A. Ten sam czas: 12 dni absencji w roku, podzielone na 1–12 epizodów
A <- data.frame(S = 1:12, D = 12)
A$B <- bradford(A$S, A$D)
t(A)

# B. 1000 pracowników o identycznej skłonności: liczba epizodów w roku ~ Poisson(1.8),
# długość epizodu losowana z długości epizodów w zakładzie (przepis 1)
set.seed(715)
sym <- data.frame(S = rpois(1000, 1.8))
sym$D <- sapply(sym$S, function(s) sum(sample(epi$dni, s, replace = TRUE)))
sym$B <- bradford(sym$S, sym$D)
prog <- 250                                       # przykładowy próg „rozmowy z przełożonym”, ustalony ręcznie
round(c(srednia_epizodow = mean(sym$S), zero_proc = 100 * mean(sym$S == 0),
        powyzej_progu_proc = 100 * mean(sym$B > prog), mediana_B = median(sym$B),
        p90_B = unname(quantile(sym$B, .9)), maks_B = max(sym$B)), 1)

# Zakład: czy wskaźnik z 2024 przewiduje wskaźnik z 2025? (osoby zatrudnione przez cały okres)
caly <- prac$id[prac$dni_robocze == max(prac$dni_robocze)]
rok <- function(r) { e <- epi[epi$rok == r & epi$id %in% caly, ]
  data.frame(id = caly, S = as.vector(table(factor(e$id, caly))),
             D = as.vector(tapply(e$dni, factor(e$id, caly), sum, default = 0))) }
r24 <- rok(2024); r25 <- rok(2025)
b24 <- bradford(r24$S, r24$D); b25 <- bradford(r25$S, r25$D)
flaga24 <- b24 > prog; flaga25 <- b25 > prog
c(osoby = length(caly), powyzej_progu_2024 = sum(flaga24), z_nich_takze_2025 = sum(flaga24 & flaga25),
  powyzej_progu_2025_wsrod_ponizej_2024 = sum(!flaga24 & flaga25))
round(c(spearman_B = cor(b24, b25, method = "spearman"), spearman_dni = cor(r24$D, r25$D, method = "spearman"),
        proc_flag24_takze_2025 = 100 * mean(flaga25[flaga24]), proc_flag25_wsrod_niefl24 = 100 * mean(flaga25[!flaga24])), 2)

pA <- ggplot(A, aes(S, B)) +
  geom_line(colour = kol[["niebieski"]], linewidth = 0.9) +
  geom_point(colour = kol[["niebieski"]], size = 2.6) +
  geom_text(data = A[A$S %in% c(1, 2, 4, 6, 12), ], aes(label = B), vjust = -0.9, size = 3.6, colour = "#0f1d3a") +
  scale_y_log10(limits = c(5, 4000), breaks = c(10, 30, 100, 300, 1000, 3000)) +
  scale_x_continuous(breaks = c(1, 3, 6, 9, 12)) +
  labs(title = "A. Zawsze 12 dni w roku", x = "Liczba epizodów (S)", y = "Wskaźnik Bradforda (skala log.)") + motyw
sym$przedzial <- cut(sym$B, c(-Inf, 0, 50, 125, 250, 500, 1000, Inf),
                     labels = c("0", "1–50", "51–125", "126–250", "251–500", "501–1000", ">1000"), right = TRUE)
Bd <- as.data.frame(table(przedzial = sym$przedzial))
Bd$nad <- ifelse(as.integer(Bd$przedzial) >= 5, "powyżej progu 250", "do progu 250")
pB <- ggplot(Bd, aes(Freq, przedzial, fill = nad)) +
  geom_col(width = 0.75) +
  geom_text(aes(label = Freq), hjust = -0.25, size = 3.5, colour = "#0f1d3a") +
  scale_y_discrete(limits = rev(levels(Bd$przedzial))) +
  scale_x_continuous(limits = c(0, 540)) +
  scale_fill_manual(values = c(kol[["szary"]], kol[["pomaranczowy"]]), name = NULL) +
  labs(title = "B. 1000 identycznych pracowników", x = "Liczba pracowników", y = "Wskaźnik Bradforda w roku") +
  motyw
p6 <- (pA | pB) + plot_annotation(title = "Bradford premiuje rzadkie długie zwolnienia, a karze częste – także przypadkowo",
                                  theme = motyw)
p6                       # do pliku: ggsave("absencja-bradford-symulacja.svg", p6, width = 10, height = 5.6)
Wynik w R
  [,1] [,2] [,3] [,4] [,5] [,6] [,7] [,8] [,9] [,10] [,11] [,12]
S    1    2    3    4    5    6    7    8    9    10    11    12
D   12   12   12   12   12   12   12   12   12    12    12    12
B   12   48  108  192  300  432  588  768  972  1200  1452  1728
  srednia_epizodow          zero_proc powyzej_progu_proc          mediana_B
               1.9               15.8               12.6               24.0
             p90_B             maks_B
             305.6             6419.0
                                osoby                    powyzej_progu_2024
                                  480                                    84
                    z_nich_takze_2025 powyzej_progu_2025_wsrod_ponizej_2024
                                   46                                    51
               spearman_B              spearman_dni    proc_flag24_takze_2025
                     0.50                      0.40                     54.76
proc_flag25_wsrod_niefl24
                    12.88
7. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("epizody – dni (rys. 1)" = c("#0072B2", "#D55E00"),
             "krótkie – dłuższe epizody" = c("#D55E00", "#0072B2"),
             "bez nocnej – z nocną zmianą" = c("#56B4E9", "#D55E00"),
             "model bez korekty – z korektą" = c("#999999", "#0072B2"),
             "do progu – powyżej progu" = c("#999999", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
epizody – dni (rys. 1)                     114.6        108.3       91.9
krótkie – dłuższe epizody                  114.6        108.3       91.9
bez nocnej – z nocną zmianą                113.6        101.1       89.0
model bez korekty – z korektą               44.9         48.9       40.6
do progu – powyżej progu                    77.2         62.9       56.0
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, regresja Poissona i logistyczna, testy chi-kwadrat i poprawka Holma – bazowy R (pakiety stats i base); regresja ujemna dwumianowa (glm.nb()) – pakiet MASS; model hurdle (hurdle()) – pakiet pscl; błędy standardowe odporne na klastrowanie (vcovCL()) – pakiet sandwich, a ich użycie w testach i przedziałach (coeftest(), coefci()) – pakiet lmtest. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- pscl (wersja 1.5.9): Zeileis, A., Kleiber, C., & Jackman, S. (2008). Regression models for count data in R. Journal of Statistical Software, 27(8), 1–25. https://doi.org/10.18637/jss.v027.i08
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lmtest (wersja 0.9-40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Absencja zgłaszana a rzeczywista. Rejestr zawiera tylko zwolnienia lekarskie i zgłoszone nieobecności. Urlop zamiast zwolnienia i praca w chorobie w nim nie istnieją, a zmiana zasad zgłaszania zmienia dane bez zmiany zdrowia.
- Długie zwolnienia jednej osoby. Na wydziale tektury falistej jedna osoba miała 269 dni absencji. Mediana dni na rok pracy (7.6) jest tam niemal dwa razy niższa od średniej (14.2), a w administracji – 2.9 wobec 8.3. Podawaj medianę i odsetek długich epizodów obok średniej.
- Brak offsetu. Średnia na osobę karze wydziały z małą rotacją i nagradza te, gdzie wiele osób pracowało krótko (rysunek 4).
- Prywatność. Dane o absencji chorobowej to dane o zdrowiu: do analizy przekaż je bez nazwisk i kodów chorób, po pseudonimizacji, a małe wydziały łącz w raportach.
Najczęstsze pytania
Jak analizować liczbę dni absencji chorobowej?
Oddziel liczbę epizodów od liczby dni. Epizody modeluj regresją ujemną dwumianową z offsetem czasu zatrudnienia. Dni mają bardzo długi ogon – w przykładzie dyspersja Poissona wynosiła 43.11 – więc opisuj je medianą i odsetkiem długich zwolnień, a w modelu użyj rozkładu ujemnego dwumianowego i sprawdź wpływ pojedynczych długich zwolnień.
Model Poissona, ujemny dwumianowy czy hurdle dla absencji?
Zacznij od Poissona z offsetem i policz dyspersję; przy wartości wyraźnie większej od 1 przejdź do modelu ujemnego dwumianowego. Model hurdle wybierz, gdy NB nie odtwarza liczby zer i potrafisz uzasadnić osobny proces „czy w ogóle”. W przykładzie NB przewidział 108.3 zera przy 108 obserwowanych i miał niższe AIC (3001.6) niż hurdle (3010.4).
Co to jest wskaźnik Bradforda i jak go policzyć?
To S² × D, gdzie S to liczba epizodów nieobecności, a D – łączna liczba dni, zwykle w ostatnich 52 tygodniach. Jeden epizod 10-dniowy daje 10, a dziesięć jednodniowych – 1000. Wskaźnik mierzy częstość przerw, nie stan zdrowia, i silnie zależy od przypadku.
Czy efekt poniedziałku w absencji oznacza nadużycia?
Nie musi. Choroby, które zaczęły się w weekend, trafiają do rejestru w poniedziałek. Sprawdź efekt osobno dla krótkich i dłuższych epizodów testem chi-kwadrat zgodności i regresją logistyczną z błędami odpornymi na klastrowanie według pracownika. W przykładzie w poniedziałek zaczynało się 32.9% krótkich epizodów i 23.4% dłuższych.
Jak porównać absencję między wydziałami?
Licz częstość na rok pracy, a nie średnią na osobę, i dopasuj model z offsetem oraz korektą o zmienne, które różnią wydziały, np. nocną zmianę i wiek. Porównania wydziałów parami skoryguj, np. poprawką Holma. W przykładzie przewaga administracji spadła z IRR = 0.67 do 0.79 po uwzględnieniu nocnej zmiany.
Powiązane hasła
Przeczytaj też
Regresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →PoradnikRotacja pracowników jako analiza przeżycia
Magazyn, 1800 pracowników: cenzurowanie, Kaplan–Meier, skok odejść po okresie próbnym, odejścia i zwolnienia jako ryzyka konkurencyjne, model Coxa.
Czytaj →PoradnikSiatka płac z regresji
220 płac w biurze projektowym: log(płacy) w procentach, przedział predykcji, płace poza siatką i widełki z regresji kwantylowej – z kodem R.
Czytaj →Analizujesz absencję albo dane kadrowe do pracy?
Pomożemy przygotować rejestr nieobecności, dobrać model zliczeń z offsetem, porównać wydziały i opisać wyniki – tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Card, D., & McCall, B. P. (1996). Is workers’ compensation covering uninsured medical costs? Evidence from the “Monday effect”. ILR Review, 49(4), 690–706. https://doi.org/10.1177/001979399604900407
- Gardner, W., Mulvey, E. P., & Shaw, E. C. (1995). Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models. Psychological Bulletin, 118(3), 392–404. https://doi.org/10.1037/0033-2909.118.3.392
- Hensing, G., Alexanderson, K., Allebeck, P., & Bjurulf, P. (1998). How to measure sickness absence? Literature review and suggestion of five basic measures. Scandinavian Journal of Social Medicine, 26(2), 133–144. https://doi.org/10.1177/14034948980260020201
- Kivimäki, M., Head, J., Ferrie, J. E., Shipley, M. J., Vahtera, J., & Marmot, M. G. (2003). Sickness absence as a global measure of health: Evidence from mortality in the Whitehall II prospective cohort study. BMJ, 327(7411), 364. https://doi.org/10.1136/bmj.327.7411.364 ● Otwarty dostęp
- Kleiber, C., & Zeileis, A. (2016). Visualizing count data regressions using rootograms. The American Statistician, 70(3), 296–303. https://doi.org/10.1080/00031305.2016.1173590 ● Otwarty dostęp: pełny tekst
- Tüchsen, F., Christensen, K. B., & Lund, T. (2008). Shift work and sickness absence. Occupational Medicine, 58(4), 302–304. https://doi.org/10.1093/occmed/kqn019
- Zeileis, A., Kleiber, C., & Jackman, S. (2008). Regression models for count data in R. Journal of Statistical Software, 27(8), 1–25. https://doi.org/10.18637/jss.v027.i08 ● Otwarty dostęp
Cytowania BibTeX
@article{card1996workers, author={Card, David and McCall, Brian P.}, title={{Is workers’ compensation covering uninsured medical costs? Evidence from the “Monday effect”}}, journal={ILR Review}, year={1996}, volume={49}, number={4}, pages={690--706}, doi={10.1177/001979399604900407}}@article{gardner1995regression, author={Gardner, William and Mulvey, Edward P. and Shaw, Esther C.}, title={{Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models}}, journal={Psychological Bulletin}, year={1995}, volume={118}, number={3}, pages={392--404}, doi={10.1037/0033-2909.118.3.392}}@article{hensing1998how, author={Hensing, Gunnel and Alexanderson, Kristina and Allebeck, Peter and Bjurulf, Per}, title={{How to measure sickness absence? Literature review and suggestion of five basic measures}}, journal={Scandinavian Journal of Social Medicine}, year={1998}, volume={26}, number={2}, pages={133--144}, doi={10.1177/14034948980260020201}}@article{kivimaki2003sickness, author={Kivimäki, Mika and Head, Jenny and Ferrie, Jane E. and Shipley, Martin J. and Vahtera, Jussi and Marmot, Michael G.}, title={{Sickness absence as a global measure of health: Evidence from mortality in the Whitehall II prospective cohort study}}, journal={BMJ}, year={2003}, volume={327}, number={7411}, pages={364}, doi={10.1136/bmj.327.7411.364}}@article{kleiber2016visualizing, author={Kleiber, Christian and Zeileis, Achim}, title={{Visualizing count data regressions using rootograms}}, journal={The American Statistician}, year={2016}, volume={70}, number={3}, pages={296--303}, doi={10.1080/00031305.2016.1173590}}@article{tuchsen2008shift, author={Tüchsen, Finn and Christensen, Karl Bang and Lund, Thomas}, title={{Shift work and sickness absence}}, journal={Occupational Medicine}, year={2008}, volume={58}, number={4}, pages={302--304}, doi={10.1093/occmed/kqn019}}@article{zeileis2008regression, author={Zeileis, Achim and Kleiber, Christian and Jackman, Simon}, title={{Regression models for count data in R}}, journal={Journal of Statistical Software}, year={2008}, volume={27}, number={8}, pages={1--25}, doi={10.18637/jss.v027.i08}}