Co to jest wykres warstwowy?
Wykres warstwowy (ang. stacked area chart) pokazuje kilka szeregów czasowych ułożonych jeden na drugim: grubość każdej warstwy to wartość danej kategorii, a górna krawędź całości – suma. Jest odpowiednikiem skumulowanego wykresu słupkowego dla osi ciągłej. W wariancie 100% każdy punkt czasu sumuje się do 100, więc warstwy pokazują udziały – to coś jak seria wykresów kołowych rozciągnięta w czasie.
Jak czytać wykres
- Górna krawędź to suma wszystkich kategorii – to odczytuje się najłatwiej.
- Dolna warstwa leży na osi, więc jej przebieg też widać dobrze.
- Warstwy środkowe trzeba czytać jako grubość pasa między dwiema krzywymi, które same się wznoszą i opadają. Oko ocenia raczej nachylenie krawędzi niż odległość między nimi, więc stała warstwa na rosnącym podłożu wygląda, jakby rosła.
Cleveland i McGill (1984) uszeregowali zadania percepcyjne według dokładności odczytu: najlepiej porównujemy położenie na wspólnej skali, gorzej długości bez wspólnej podstawy – a tak właśnie czyta się warstwy środkowe. Byron i Wattenberg (2008), analizując warianty wykresów warstwowych, omawiają kolejność i barwy warstw jako decyzje, w których estetyka musi się godzić z czytelnością.
Przykład
Symulowano liczbę badań ankietowych w ośrodku w latach 2006–2025 według trybu: wywiad osobisty z papierowym kwestionariuszem (PAPI), telefoniczny (CATI), internetowy (CAWI) i pocztowy. Oczekiwana liczba badań CATI była stała (30 rocznie), PAPI i pocztowych malała, a CAWI rosła wykładniczo; liczby losowano z rozkładu Poissona (parametry ustawione ręcznie, ziarno 777). Badań CATI było od 20 do 39 rocznie: 20 w 2006 r. i 23 w 2025 r. Łączna liczba badań wzrosła z 96 do 158.
Na rysunku
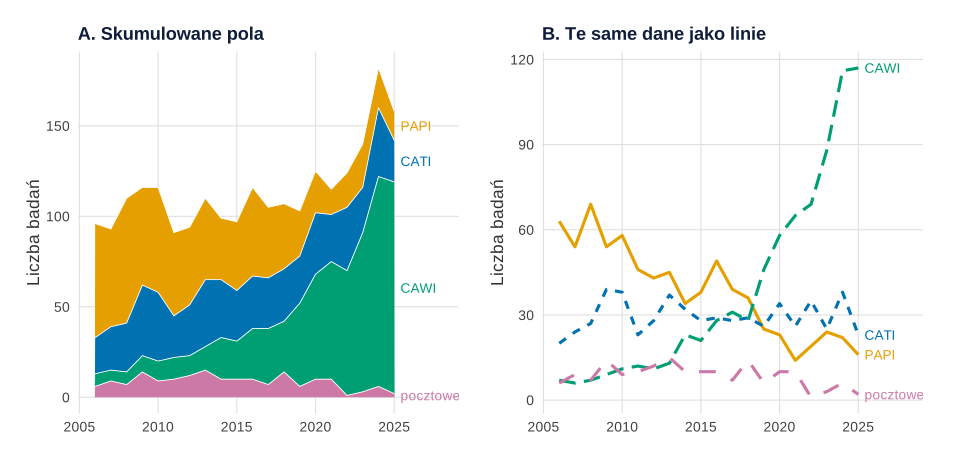
set.seed(777)).Co widać. Panel A dobrze pokazuje dwie rzeczy: wzrost łącznej liczby badań i rosnącą zieloną warstwę CAWI u podstawy. Niebieska warstwa CATI po 2018 r. pnie się stromo w górę, bo leży na rosnącym CAWI – a w panelu B widać, że CATI przez 20 lat waha się wokół 30 badań. Spadek PAPI w panelu A też trudno ocenić, bo górna warstwa jest wypychana przez wszystko, co pod nią.
Na co uważać. Wykres warstwowy sugeruje ciągłość między latami; przy danych rocznych linie łączą tylko punkty pomiaru. Kolejność warstw zmienia obraz: ta warstwa, która leży na osi, jest czytelna, pozostałe nie.
Podpis do pracy:
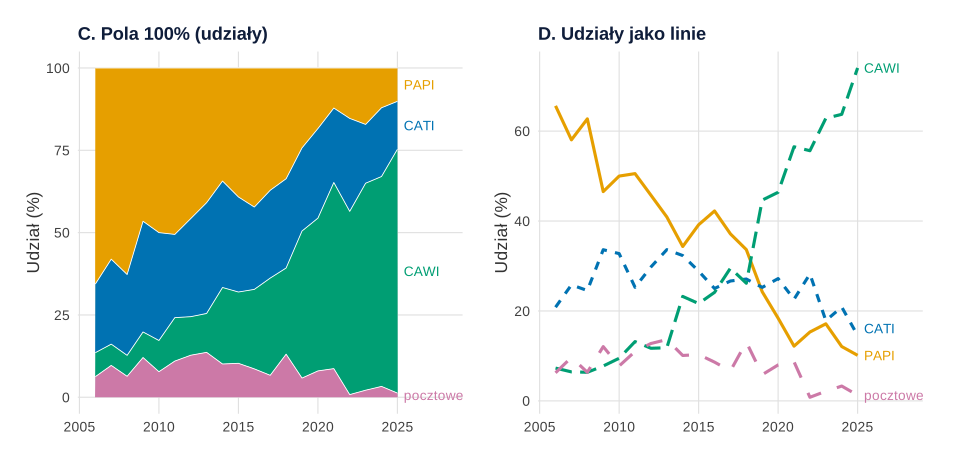
set.seed(777)).Co widać. Wykres 100% odpowiada na inne pytanie niż rysunek 1: nie „ile”, lecz „jaka część”. Udział CATI spadł z 20.8% do 14.6%, choć liczba badań się nie zmieniła – zmalał, bo urosła reszta. W 2025 r. CAWI to 74.1% badań, PAPI 10.1%.
Na co uważać. Wykres 100% ukrywa sumę: z panelu C nie wiadomo, że badań było o 65% więcej. Jeśli liczy się i skład, i wielkość, pokaż oba wykresy albo podaj sumy w podpisie. Udziały to dane kompozycyjne – wzrost jednego udziału musi obniżyć inne.
Podpis do pracy:
Jak opisać w pracy
Na co uważać
- Za dużo warstw. Przy więcej niż 4–5 kategoriach środkowe warstwy stają się nieczytelne; lepiej użyć małych wielokrotności – jedna kategoria na panel.
- Zła kolejność. Kategorię najważniejszą dla pytania połóż na dole, przy osi; najbardziej zmienną – na górze, żeby nie „falowała” pozostałymi.
- Wahania sezonowe. Przy danych miesięcznych sezonowość jednej warstwy przenosi się na wszystkie leżące nad nią.
- Wartości ujemne. Warstw nie da się sensownie układać, gdy kategoria może być ujemna.
Ten sam wykres pojawia się w analizie przeżycia jako skumulowane funkcje częstości zdarzeń – zob. ryzyko konkurencyjne i CIF.
Wykres warstwowy w R
W ggplot2 warstwy tworzy geom_area(); kolejność ustala się poziomami czynnika (pierwszy poziom ląduje na górze). Udziały liczy się przed rysowaniem – ave() daje sumę w każdym roku. Etykiety przy prawej krawędzi zastępują legendę, więc kolor nie jest jedynym nośnikiem informacji. Rysunki na stronie powstały z obiektów p1 i p2 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Skumulowane pola, pola 100% i linie z tych samych danych
R
# Wykres warstwowy (stacked area): skumulowane pola vs linie vs 100% pola
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(PAPI = "#E69F00", CATI = "#0072B2", CAWI = "#009E73", pocztowe = "#CC79A7")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "none")
# Liczba badań ankietowych w ośrodku w latach 2006–2025 według trybu zbierania danych
set.seed(777)
lata <- 2006:2025; t <- seq_along(lata) - 1
oczek <- data.frame(PAPI = 60 - 2.4 * t, CATI = rep(30, 20), CAWI = 5 * exp(0.17 * t), pocztowe = 15 - 0.5 * t)
liczby <- sapply(oczek, function(m) rpois(length(m), m))
dane <- data.frame(rok = rep(lata, 4), tryb = factor(rep(names(kol), each = 20), levels = names(kol)),
                   n = as.vector(liczby))
dane$udzial <- dane$n / ave(dane$n, dane$rok, FUN = sum) * 100
# Pozycje etykiet w środku każdej warstwy w ostatnim roku (kolejność warstw jak w legendzie: PAPI na górze)
etyk <- function(zm) {
  d <- dane[dane$rok == max(lata), ]; d <- d[rev(order(d$tryb)), ]
  d$y <- cumsum(d[[zm]]) - d[[zm]] / 2; d
}
pA <- ggplot(dane, aes(rok, n, fill = tryb)) + geom_area(colour = "white", linewidth = 0.3) +
  geom_text(data = etyk("n"), aes(x = max(lata) + 0.4, y = y, label = tryb, colour = tryb), hjust = 0, size = 3.6) +
  scale_fill_manual(values = kol) + scale_colour_manual(values = kol) +
  coord_cartesian(xlim = c(2006, 2028)) + labs(title = "A. Skumulowane pola", x = NULL, y = "Liczba badań")
pB <- ggplot(dane, aes(rok, n, colour = tryb, linetype = tryb)) + geom_line(linewidth = 1.1) +
  geom_text(data = dane[dane$rok == max(lata), ], aes(x = max(lata) + 0.4, label = tryb), hjust = 0, size = 3.6) +
  scale_colour_manual(values = kol) + coord_cartesian(xlim = c(2006, 2028)) +
  labs(title = "B. Te same dane jako linie", x = NULL, y = "Liczba badań")
pC <- ggplot(dane, aes(rok, udzial, fill = tryb)) + geom_area(colour = "white", linewidth = 0.3) +
  geom_text(data = etyk("udzial"), aes(x = max(lata) + 0.4, y = y, label = tryb, colour = tryb), hjust = 0, size = 3.6) +
  scale_fill_manual(values = kol) + scale_colour_manual(values = kol) +
  coord_cartesian(xlim = c(2006, 2028)) + labs(title = "C. Pola 100% (udziały)", x = NULL, y = "Udział (%)")
# D. Udziały jako linie; etykiety rozsunięte w pionie co najmniej o 6 punktów procentowych
ost <- dane[dane$rok == max(lata), ]; ost <- ost[order(ost$udzial), ]
ost$y <- ost$udzial; for (i in 2:nrow(ost)) ost$y[i] <- max(ost$y[i], ost$y[i - 1] + 6)
pD <- ggplot(dane, aes(rok, udzial, colour = tryb, linetype = tryb)) + geom_line(linewidth = 1.1) +
  geom_text(data = ost, aes(x = max(lata) + 0.4, y = y, label = tryb), hjust = 0, size = 3.6) +
  scale_colour_manual(values = kol) + coord_cartesian(xlim = c(2006, 2028)) +
  labs(title = "D. Udziały jako linie", x = NULL, y = "Udział (%)")
p1 <- (pA + pB) & motyw
p2 <- (pC + pD) & motyw
# Wyniki: CATI w pierwszym i ostatnim roku, łączna liczba badań i udział CATI
w <- dane[dane$tryb == "CATI" & dane$rok %in% range(lata), c("rok", "n", "udzial")]
w$razem <- tapply(dane$n, dane$rok, sum)[as.character(w$rok)]
print(transform(w, udzial = round(udzial, 1)), row.names = FALSE)
print(transform(ost[, c("tryb", "n", "udzial")], udzial = round(udzial, 1)), row.names = FALSE)
round(c(cati_min = min(dane$n[dane$tryb == "CATI"]), cati_max = max(dane$n[dane$tryb == "CATI"])), 0)
p1
Wynik w R
  rok  n udzial razem
 2006 20   20.8    96
 2025 23   14.6   158
     tryb   n udzial
 pocztowe   2    1.3
     PAPI  16   10.1
     CATI  23   14.6
     CAWI 117   74.1
cati_min cati_max
      20       39
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe rpois(), ave(); rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kiedy wykres warstwowy jest lepszy od wykresu liniowego?
Gdy najważniejsza jest suma i to, jak składa się z kilku części – np. łączna liczba badań i jej podział na tryby. Jeśli pytanie dotyczy przebiegu każdej kategorii osobno, czytelniejsze są linie albo osobne panele.
Czym różni się wykres warstwowy 100% od zwykłego?
Zwykły pokazuje wartości bezwzględne, więc górna krawędź to suma. Wariant 100% przelicza każdy punkt czasu na udziały: widać skład, ale nie widać, czy całość rosła, czy malała.
W jakiej kolejności układać warstwy?
Kategorię najważniejszą dla pytania badawczego połóż na dole, przy osi – tylko jej przebieg odczytuje się dokładnie. Najbardziej zmienne kategorie układaj wyżej, żeby nie zniekształcały wszystkich warstw nad sobą.
Powiązane hasła
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Byron, L., & Wattenberg, M. (2008). Stacked graphs – geometry & aesthetics. IEEE Transactions on Visualization and Computer Graphics, 14(6), 1245–1252. https://doi.org/10.1109/tvcg.2008.166
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
Cytowania BibTeX
@article{byron2008stacked, author={Byron, Lee and Wattenberg, Martin}, title={{Stacked graphs – geometry \& aesthetics}}, journal={IEEE Transactions on Visualization and Computer Graphics}, year={2008}, volume={14}, number={6}, pages={1245--1252}, doi={10.1109/tvcg.2008.166}}@article{cleveland1984graphical, author={Cleveland, William S. and McGill, Robert}, title={{Graphical perception: Theory, experimentation, and application to the development of graphical methods}}, journal={Journal of the American Statistical Association}, year={1984}, volume={79}, number={387}, pages={531--554}, doi={10.1080/01621459.1984.10478080}}