Co to jest wykres kołowy i pierścieniowy?
Wykres kołowy (ang. pie chart) dzieli koło na wycinki proporcjonalne do udziału kategorii w całości: kategoria z 25% zajmuje ćwierć koła, czyli kąt 90°. Wykres pierścieniowy (ang. donut chart) to to samo koło z wyciętym środkiem; wycinki ocenia się wtedy po długości łuku, a w środku można wpisać np. liczebność całej próby. Oba nadają się tylko do kategorii, które się wykluczają i razem dają 100%. Wykres kołowy ma ponad 200 lat – Spence (2005) opisuje jego pochodzenie od Williama Playfaira i to, że mimo rad ekspertów, by go unikać, pozostaje bardzo popularny.
Kiedy go użyć
- Dwie–trzy części całości, gdy pytanie brzmi „jaka część całości?” – np. odsetek osób, które przeżyły. Spence i Lewandowsky (1991) nie znaleźli wyraźnej przewagi słupków nad kołem przy ocenie odsetków, a przy złożonych porównaniach koło wypadało nieco lepiej.
- Nie przy wielu kategoriach o podobnych udziałach. Cleveland i McGill (1984) uporządkowali zadania percepcyjne według dokładności: ocena kąta wypada gorzej niż ocena położenia na wspólnej osi, dlatego proponowali w miejsce wykresu kołowego m.in. wykres punktowy.
- Nie przy pytaniach wielokrotnego wyboru, bo odsetki nie sumują się do 100%.
Przykład
Symulowano odpowiedzi 400 studentów na pytanie o główny powód wyboru kierunku, z pięcioma bliskimi udziałami w populacji (23, 21, 20, 19 i 17%; wartości ustawione ręcznie, ziarno 767). W próbie: zarobki 25.0% (95% CI [21.0, 29.5]), zainteresowania 21.0% [17.3, 25.3], praca po studiach 20.8% [17.1, 25.0], blisko domu 17.0% [13.6, 21.0], rodzina i znajomi 16.2% [13.0, 20.2] – przedziały Wilsona, opisane w haśle o przedziale ufności dla proporcji. Drugi przykład to wbudowany zbiór Titanic: z 2201 osób przeżyło 711 (32.3%), zginęło 1490 (67.7%).
Na rysunku
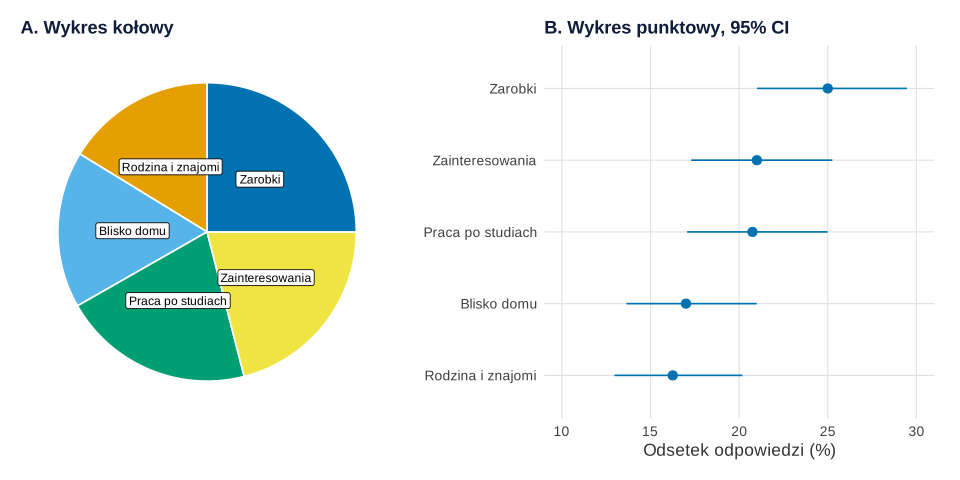
set.seed(767)).Co widać. Na kole wszystkie wycinki wyglądają podobnie i bez liczb nie da się ustalić kolejności zainteresowań i pracy po studiach (21.0 i 20.8%). Na wykresie punktowym ranking czyta się od góry, a przedziały pokazują, że większość różnic mieści się w niepewności próby.
Na co uważać. Dopisanie odsetków do wycinków naprawia odczyt, ale wtedy wykres jest w praktyce tabelą. Żaden z dwóch wykresów nie pokazuje, kto odpowiadał – przy porównaniu grup potrzebujesz słupków lub punktów dla każdej grupy.
Podpis do pracy:
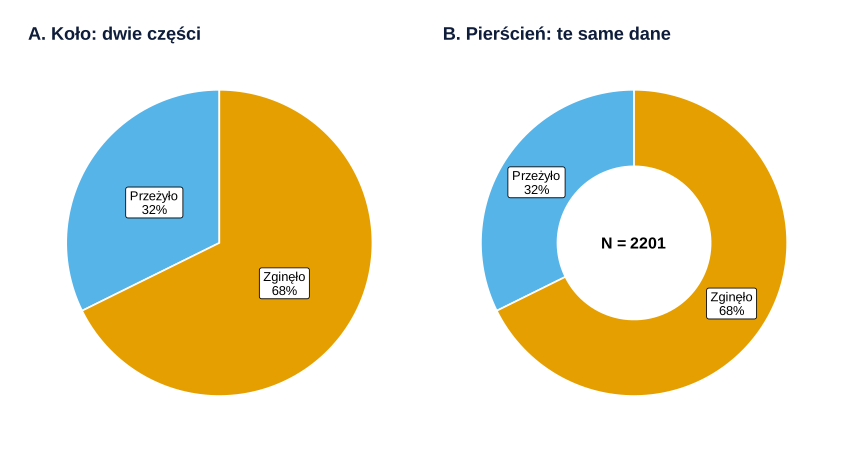
Titanic).Co widać. Przy dwóch częściach koło działa: od razu widać, że przeżyła mniej niż jedna trzecia osób. Pierścień mówi to samo, a w środku mieści liczebność całości.
Na co uważać. Nie rysuj koła w 3D – perspektywa zmienia wielkość wycinków z przodu i z tyłu; przykład pokazuje wpis poprawki promotora w rozdziale wyników. Nie stawiaj też kilku kół obok siebie, żeby porównać grupy – lepszy jest jeden wykres słupkowy.
Podpis do pracy:
Jak opisać w pracy
Podaj liczebności i odsetki w tekście albo w tabeli. Ogólne zasady wyboru wykresu do pracy, z porównaniem koła i słupków, opisuje wpis wykresy w pracy dyplomowej.
Na co uważać
- Za dużo wycinków. Przy więcej niż 3–4 kategoriach wybierz posortowane słupki lub punkty. Jeśli zależy Ci na pokazaniu całości, rozważ wykres waflowy.
- Brak N. Koło wygląda tak samo dla 10 i dla 10 000 osób.
- Legenda zamiast etykiet. Podpisuj wycinki bezpośrednio – kolor nie powinien być jedynym nośnikiem kategorii.
- Kategorie, które się nie wykluczają. Suma powyżej 100% oznacza, że koło jest złym wyborem.
Wykres kołowy i pierścieniowy w R
W ggplot2 koło to skumulowany słupek we współrzędnych biegunowych (coord_polar(theta = "y")), a pierścień – ten sam słupek z pustym środkiem (xlim() zaczynające się przed słupkiem). Kod liczy też odsetki z przedziałami Wilsona (prop.test(correct = FALSE)). Rysunki na stronie powstały z tych samych obiektów wykresów z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Koło vs wykres punktowy i dwie części całości
Kod R rysunków 1 i 2
# Wykres kołowy i pierścieniowy: pięć bliskich odsetków (koło vs punkty) i dwie części całości
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
oi <- c("#E69F00", "#56B4E9", "#009E73", "#F0E442", "#0072B2")   # Okabe–Ito; każdy wycinek ma też etykietę
motyw <- theme_minimal(base_size = 13) + theme(plot.title = element_text(face = "bold"), legend.position = "none")
bez_osi <- theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid = element_blank())
# Rysunek 1: główny powód wyboru studiów, N = 400 (dane symulowane, odsetki w populacji 23, 21, 20, 19, 17%)
set.seed(767)
powody <- c("Zainteresowania", "Praca po studiach", "Zarobki", "Rodzina i znajomi", "Blisko domu")
odp <- sample(powody, 400, replace = TRUE, prob = c(.23, .21, .20, .19, .17))
d <- as.data.frame(table(powod = odp), responseFreq = "n")
names(d)[2] <- "n"
ci <- t(sapply(d$n, function(k) prop.test(k, 400, correct = FALSE)$conf.int))   # przedział Wilsona
d$procent <- 100 * d$n / 400; d$dolna <- 100 * ci[, 1]; d$gorna <- 100 * ci[, 2]
d <- d[order(d$procent), ]
d$powod <- factor(d$powod, levels = d$powod)
print(data.frame(d[, c("powod", "n")], round(d[, c("procent", "dolna", "gorna")], 1)), row.names = FALSE)
kolo <- ggplot(d, aes(x = 1, y = n, fill = powod)) +
  geom_col(width = 1, colour = "white") +
  geom_label(aes(label = powod, group = powod), position = position_stack(vjust = 0.5), fill = "white", size = 3.2) +
  scale_fill_manual(values = oi) + coord_polar(theta = "y") + labs(title = "A. Wykres kołowy")
punkty <- ggplot(d, aes(x = procent, y = powod)) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0, orientation = "y", colour = "#0072B2") +
  geom_point(size = 2.8, colour = "#0072B2") +
  scale_x_continuous(limits = c(10, 30)) +
  labs(title = "B. Wykres punktowy, 95% CI", x = "Odsetek odpowiedzi (%)", y = NULL)
p1 <- (kolo + motyw + bez_osi) + (punkty + motyw)
# Rysunek 2: dwie części całości – przeżycie pasażerów Titanica (wbudowany zbiór Titanic)
t2 <- data.frame(wynik = c("Przeżyło", "Zginęło"), n = as.vector(apply(Titanic, 4, sum)[c("Yes", "No")]))
t2$procent <- 100 * t2$n / sum(t2$n)
t2$wynik <- factor(t2$wynik, levels = t2$wynik)
print(data.frame(t2[, c("wynik", "n")], procent = round(t2$procent, 1)), row.names = FALSE)
etykiety <- geom_label(aes(label = paste0(wynik, "\n", round(procent), "%"), group = wynik),
                       position = position_stack(vjust = 0.5), fill = "white", size = 3.4, lineheight = 0.9)
kolo2 <- ggplot(t2, aes(x = 2, y = n, fill = wynik)) + geom_col(width = 1, colour = "white") + etykiety +
  scale_fill_manual(values = oi[c(2, 1)]) + coord_polar(theta = "y") + labs(title = "A. Koło: dwie części")
pierscien <- ggplot(t2, aes(x = 2, y = n, fill = wynik)) + geom_col(width = 1, colour = "white") + etykiety +
  annotate("text", x = 0.5, y = 0, label = paste0("N = ", sum(t2$n)), size = 4.2, fontface = "bold") +
  scale_fill_manual(values = oi[c(2, 1)]) + coord_polar(theta = "y") + xlim(0.5, 2.5) +
  labs(title = "B. Pierścień: te same dane")
p2 <- (kolo2 + pierscien) & motyw & bez_osi
p1
p2
Wynik w R
             powod   n procent dolna gorna
 Rodzina i znajomi  65    16.2  13.0  20.2
       Blisko domu  68    17.0  13.6  21.0
 Praca po studiach  83    20.8  17.1  25.0
   Zainteresowania  84    21.0  17.3  25.3
           Zarobki 100    25.0  21.0  29.5
    wynik    n procent
 Przeżyło  711    32.3
  Zginęło 1490    67.7
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (dane i przedziały – funkcje bazowe sample(), prop.test(); rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kiedy można użyć wykresu kołowego?
Gdy kategorie się wykluczają, sumują się do 100%, a części są dwie lub trzy i pytanie dotyczy udziału w całości, np. odsetka osób, które przeżyły. Przy wielu kategoriach o podobnych udziałach wybierz posortowany wykres punktowy albo słupkowy.
Czym wykres pierścieniowy różni się od kołowego?
Ma wycięty środek, więc wycinki ocenia się po długości łuku, a nie po kącie w środku koła. W pustym miejscu można wpisać np. liczebność całej próby. Poza tym ma te same zalety i ograniczenia co koło.
Czy wykres kołowy zawsze jest gorszy od słupkowego?
Nie. Przy ocenie, jaką część całości stanowi kategoria, koło nie wypada wyraźnie gorzej od słupków. Przegrywa przy porównywaniu wielu podobnych udziałów i przy porównaniu kilku grup na kilku kołach.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →PoradnikPoprawki promotora w rozdziale wyników
15 najczęstszych uwag do rozdziału wyników z przykładami „przed → po”, wzorem tabeli poprawek do pobrania i wiadomością do promotora.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Spence, I. (2005). No humble pie: The origins and usage of a statistical chart. Journal of Educational and Behavioral Statistics, 30(4), 353–368. https://doi.org/10.3102/10769986030004353
- Spence, I., & Lewandowsky, S. (1991). Displaying proportions and percentages. Applied Cognitive Psychology, 5(1), 61–77. https://doi.org/10.1002/acp.2350050106
Cytowania BibTeX
@article{cleveland1984graphical, author={Cleveland, William S. and McGill, Robert}, title={{Graphical perception: Theory, experimentation, and application to the development of graphical methods}}, journal={Journal of the American Statistical Association}, year={1984}, volume={79}, number={387}, pages={531--554}, doi={10.1080/01621459.1984.10478080}}@article{spence2005no, author={Spence, Ian}, title={{No humble pie: The origins and usage of a statistical chart}}, journal={Journal of Educational and Behavioral Statistics}, year={2005}, volume={30}, number={4}, pages={353--368}, doi={10.3102/10769986030004353}}@article{spence1991displaying, author={Spence, Ian and Lewandowsky, Stephan}, title={{Displaying proportions and percentages}}, journal={Applied Cognitive Psychology}, year={1991}, volume={5}, number={1}, pages={61--77}, doi={10.1002/acp.2350050106}}