Co to jest wykres waflowy?
Wykres waflowy (ang. waffle chart, też square pie chart) to siatka 10 × 10 kwadratów, w której każdy kwadrat to 1% całości. Kwadraty koloruje się według kategorii, więc kategoria z 48% zajmuje 48 kratek. Pokazuje to samo co wykres kołowy – podział całości na części – ale zamiast kątów porównuje się liczby kratek i pełne wiersze (10% każdy). Nadaje się do zmiennych o kilku kategoriach na skali nominalnej, które sumują się do 100%.
Jak czytać wykres waflowy
- Jedna kratka = 1%, jeden wiersz = 10%. Nie musisz liczyć kratek, wystarczy policzyć pełne wiersze i resztę.
- Kolejność: kategorie wypełniają siatkę wierszami od lewego górnego rogu, zwykle od największej. Zwarte bloki łatwiej ocenić niż kratki rozrzucone – podobnie jak przy wykresie z ikonami (Ancker i in., 2011).
- Etykiety na blokach albo obok siatki podają nazwę i liczbę kratek. Kolor nie powinien być jedynym nośnikiem kategorii.
Hollands i Spence (1998) pokazali, że ocena części całości trwa dłużej przy zwykłych słupkach niż przy wykresie, w którym całość jest jednym obiektem (kołem, słupkiem dzielonym) – przy słupkach trzeba najpierw w myślach zsumować składowe. Wykres waflowy też pokazuje całość jako jeden obiekt. Nie jest to jednak lekarstwo na „zły” wykres kołowy: Spence i Lewandowsky (1991) nie znaleźli wyraźnej przewagi słupków nad kołem przy ocenie odsetków.
Przykład
Wbudowany w R zbiór HairEyeColor opisuje 592 studentów statystyki. Kolor włosów: brązowe 286 osób (48.31%), blond 127 (21.45%), czarne 108 (18.24%), rude 71 (11.99%). Po zwykłym zaokrągleniu odsetki to 48 + 21 + 18 + 12 = 99, więc siatka miałaby jedną pustą kratkę. Metoda największych reszt bierze części całkowite (48, 21, 18, 11 – razem 98) i brakujące kratki przydziela kategoriom o największej części ułamkowej: rudym (.99) i blond (.45). Wynik: 48, 22, 18, 12 – razem 100. Jedna kratka odpowiada tu 5.92 osoby.
Na rysunku
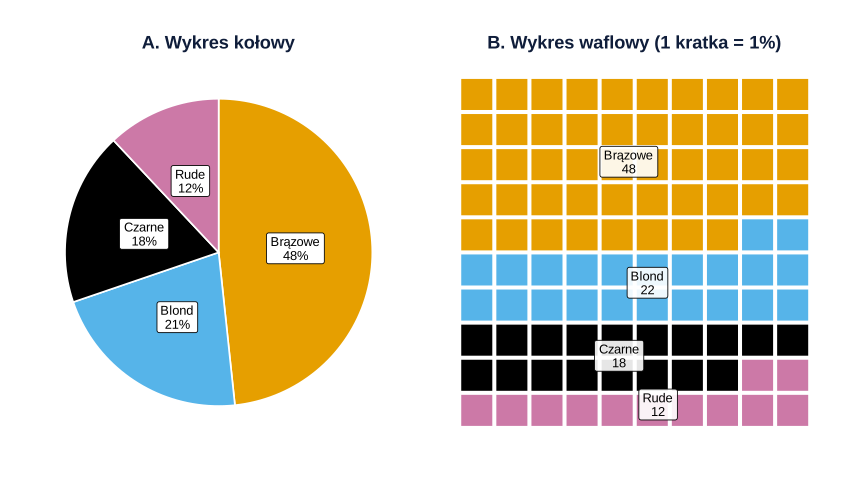
HairEyeColor).Co widać. Na kole widać, że brązowe włosy ma prawie połowa osób, ale czy blond i czarne różnią się o 3 punkty procentowe, trudno ocenić z kątów. Na waflu blond zajmuje 22 kratki, a czarne 18 – różnicę widać jako prawie pół wiersza. Etykiety koła to zwykłe zaokrąglenie (blond 21%), a wafel ma 22 kratki blond – o tej rozbieżności jest rysunek 2.
Na co uważać. Wafel pokazuje odsetki, nie liczebności: siatka wygląda tak samo dla 59 i dla 5920 osób. Podaj N w podpisie. Wykres nie pokazuje też niepewności oszacowań.
Podpis do pracy:
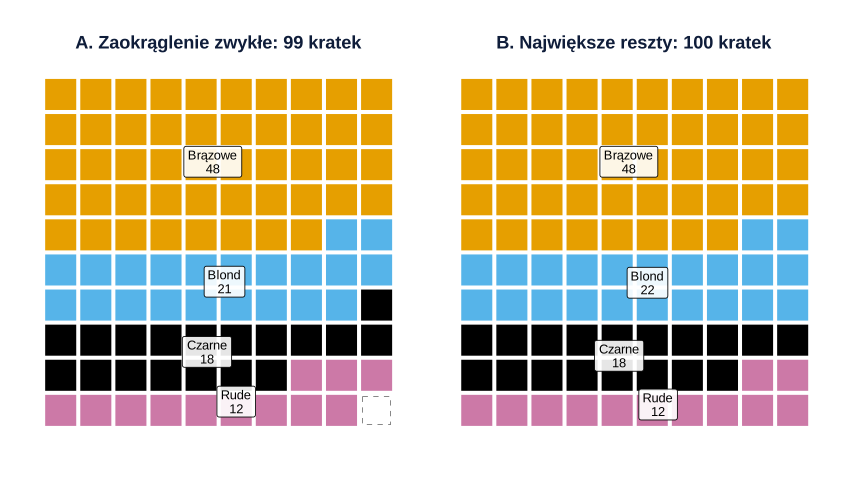
HairEyeColor).Co widać. Zwykłe zaokrąglenie zostawia jedną pustą kratkę, którą czytelnik może wziąć za brak odpowiedzi. Przy innych danych suma może wynieść 101 i kratek zabraknie. Metoda największych reszt zawsze daje 100.
Na co uważać. Każde zaokrąglenie do całych procentów zmienia obraz o ułamek kratki, a kategoria poniżej 0.5% może zniknąć. Prawdziwe odsetki podaj w tekście lub tabeli. Do porównania kilku grup lepiej nadają się słupki skumulowane do 100% albo rozbieżny wykres skumulowany niż kilka wafli obok siebie.
Podpis do pracy:
Jak opisać w pracy
W tekście podaj liczebności i odsetki z jednym miejscem po przecinku – wykres jest ilustracją. Ogólne zasady podpisu i numeracji rysunków omawia wpis wykresy w pracy dyplomowej.
Na co uważać
- Zbyt wiele kategorii. Przy więcej niż 4–5 kategoriach bloki stają się wąskie, a kolory trudne do odróżnienia. Wtedy wybierz posortowany wykres słupkowy albo wykres punktowy.
- Odpowiedzi wielokrotnego wyboru. Gdy osoba może wskazać kilka odpowiedzi, odsetki nie sumują się do 100% i wafel (tak jak koło) jest błędny.
- Małe próby. Przy 20 osobach jedna osoba to 5 kratek – lepiej pokazać same liczby.
- Brak N. Bez liczebności czytelnik nie wie, ile osób kryje się za kratką.
Wykres waflowy w R
Wykres waflowy to w ggplot2 zwykła siatka kafelków (geom_tile) – osobny pakiet nie jest potrzebny. Kod liczy odsetki, zaokrągla je zwykle i metodą największych reszt, a potem rysuje koło i dwa wafle. Rysunki na stronie powstały z tych samych obiektów p1 i p2 z krojem i tłem serwisu; dane, geometrie i skale są identyczne.
Koło, wafel i zaokrąglanie do 100 kratek
Kod R rysunków 1 i 2
# Wykres waflowy (siatka 10 × 10) vs kołowy i zaokrąglanie odsetków do 100 kratek
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c("Brązowe" = "#E69F00", "Blond" = "#56B4E9", "Czarne" = "#000000", "Rude" = "#CC79A7")  # Okabe–Ito
motyw <- theme_void(base_size = 13) + theme(plot.title = element_text(face = "bold", hjust = 0.5),
                                            legend.position = "none")
# Kolor włosów 592 studentów (wbudowany zbiór HairEyeColor, suma po kolorze oczu i płci)
n <- apply(HairEyeColor, 1, sum)
names(n) <- c("Czarne", "Brązowe", "Rude", "Blond")
n <- sort(n, decreasing = TRUE)
procent <- 100 * n / sum(n)
# Zaokrąglenie zwykłe vs metoda największych reszt (suma zawsze 100)
najwieksze_reszty <- function(x, razem = 100) {
  q <- x / sum(x) * razem; k <- floor(q)
  brak <- razem - sum(k)
  dodaj <- order(q - k, decreasing = TRUE)[seq_len(brak)]
  k[dodaj] <- k[dodaj] + 1
  k
}
tab <- data.frame(kolor = names(n), n = as.vector(n), procent = round(as.vector(procent), 2),
                  zwykle = round(as.vector(procent)), reszty = najwieksze_reszty(as.vector(n)))
print(tab, row.names = FALSE)
c(suma_zwykle = sum(tab$zwykle), suma_reszty = sum(tab$reszty), osob_na_kratke = sum(n) / 100)
# Siatka 10 × 10: kratki wypełniane wierszami od lewego górnego rogu, kategorie od największej
wafel <- function(kratki, tytul) {
  d <- data.frame(nr = 1:100, x = rep(1:10, times = 10), y = rep(10:1, each = 10))
  d$kolor <- c(rep(as.character(tab$kolor), times = kratki), rep(NA, 100 - sum(kratki)))
  d$kolor <- factor(d$kolor, levels = tab$kolor)
  et <- aggregate(cbind(x, y) ~ kolor, data = d, FUN = mean)
  et$tekst <- paste0(et$kolor, "\n", kratki[match(as.character(et$kolor), as.character(tab$kolor))])
  ggplot(d, aes(x, y)) +
    geom_tile(aes(fill = kolor), colour = "white", linewidth = 0.8, width = 0.95, height = 0.95) +
    geom_tile(data = d[is.na(d$kolor), ], fill = "white", colour = "grey30", linetype = "dashed", width = 0.8, height = 0.8) +
    geom_label(data = et, aes(label = tekst), size = 3.4, fill = "white", alpha = 0.9, lineheight = 0.9) +
    scale_fill_manual(values = kol, na.value = "white") + coord_fixed() + labs(title = tytul)
}
# Rysunek 1: koło vs wafel (kratki z metody największych reszt)
tab$kolor <- factor(tab$kolor, levels = tab$kolor)
kolo <- ggplot(tab, aes(x = 1, y = n, fill = kolor)) +
  geom_col(width = 1, colour = "white") +
  geom_label(aes(label = paste0(kolor, "\n", round(procent), "%"), group = kolor), position = position_stack(vjust = 0.5),
             fill = "white", size = 3.4, lineheight = 0.9) +
  scale_fill_manual(values = kol) + coord_polar(theta = "y", direction = -1) + labs(title = "A. Wykres kołowy")
p1 <- (kolo + wafel(tab$reszty, "B. Wykres waflowy (1 kratka = 1%)")) & motyw
# Rysunek 2: zwykłe zaokrąglenie zostawia pustą kratkę
p2 <- (wafel(tab$zwykle, "A. Zaokrąglenie zwykłe: 99 kratek") +
         wafel(tab$reszty, "B. Największe reszty: 100 kratek")) & motyw
p1
p2
Wynik w R
   kolor   n procent zwykle reszty
 Brązowe 286   48.31     48     48
   Blond 127   21.45     21     22
  Czarne 108   18.24     18     18
    Rude  71   11.99     12     12
   suma_zwykle    suma_reszty osob_na_kratke
         99.00         100.00           5.92
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (odsetki i zaokrąglanie – funkcje bazowe; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Ile kratek ma wykres waflowy?
Zwykle 100 w siatce 10 × 10, więc jedna kratka to 1%, a jeden wiersz to 10%. Przy bardzo małych kategoriach można użyć 1000 kratek, ale wtedy wykres traci prostotę.
Co zrobić, gdy odsetki po zaokrągleniu nie sumują się do 100?
Zaokrąglij metodą największych reszt: weź części całkowite odsetków, a brakujące kratki przydziel kategoriom o największej części ułamkowej. Suma zawsze wyniesie 100, a żadna kategoria nie zmieni się o więcej niż jedną kratkę.
Czy wykres waflowy jest lepszy od kołowego?
Nie zawsze. Różnice kilku punktów procentowych widać na nim łatwiej, bo porównuje się liczby kratek, a nie kąty. Przy dwóch–trzech kategoriach koło wystarcza, a przy wielu kategoriach lepszy od obu jest posortowany wykres słupkowy.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Ancker, J. S., Weber, E. U., & Kukafka, R. (2011). Effect of arrangement of stick figures on estimates of proportion in risk graphics. Medical Decision Making, 31(1), 143–150. https://doi.org/10.1177/0272989x10369006 ● Otwarty dostęp: pełny tekst
- Hollands, J. G., & Spence, I. (1998). Judging proportion with graphs: The summation model. Applied Cognitive Psychology, 12(2), 173–190. https://doi.org/10.1002/(sici)1099-0720(199804)12:2<173::aid-acp499>3.0.co;2-k
- Spence, I., & Lewandowsky, S. (1991). Displaying proportions and percentages. Applied Cognitive Psychology, 5(1), 61–77. https://doi.org/10.1002/acp.2350050106
Cytowania BibTeX
@article{ancker2011effect, author={Ancker, Jessica S. and Weber, Elke U. and Kukafka, Rita}, title={{Effect of arrangement of stick figures on estimates of proportion in risk graphics}}, journal={Medical Decision Making}, year={2011}, volume={31}, number={1}, pages={143--150}, doi={10.1177/0272989x10369006}}@article{hollands1998judging, author={Hollands, J. G. and Spence, Ian}, title={{Judging proportion with graphs: The summation model}}, journal={Applied Cognitive Psychology}, year={1998}, volume={12}, number={2}, pages={173--190}, doi={10.1002/(sici)1099-0720(199804)12:2<173::aid-acp499>3.0.co;2-k}}@article{spence1991displaying, author={Spence, Ian and Lewandowsky, Stephan}, title={{Displaying proportions and percentages}}, journal={Applied Cognitive Psychology}, year={1991}, volume={5}, number={1}, pages={61--77}, doi={10.1002/acp.2350050106}}