Co to jest rozbieżny wykres skumulowany?
Rozbieżny wykres skumulowany (ang. diverging stacked bar chart) pokazuje rozkład odpowiedzi na kilka pytań zadanych na skali Likerta. Każde stwierdzenie ma jeden poziomy słupek podzielony na kategorie odpowiedzi. Słupki nie zaczynają się jednak od zera po lewej stronie. Ustawia się je wokół wspólnej pionowej linii: odpowiedzi niezgody idą w lewo, odpowiedzi zgody w prawo. Heiberger i Robbins (2014) zalecają ten wykres jako podstawowy sposób pokazywania skal Likerta i innych skal ocen. To odmiana wykresu słupkowego dla danych porządkowych, więc nie wymaga liczenia średnich.
Jak czytać wykres
- Długość na lewo od zera to łączny odsetek niezgody, a długość na prawo – łączny odsetek zgody. Obie długości mierzysz od tej samej linii, więc łatwo porównać stwierdzenia.
- Ciemniejszy odcinek na końcu to odpowiedzi skrajne („zdecydowanie”), jaśniejszy przy zerze – umiarkowane.
- Środek skali („ani tak, ani nie”) można przeciąć na pół po obu stronach zera albo pokazać w osobnym panelu. Osobny panel nie przesuwa słupków i lepiej sprawdza się wtedy, gdy środek wybiera dużo osób.
- Kolejność stwierdzeń wynika z sortowania według odsetka zgody, a nie z kolejności w kwestionariuszu.
Przykład
W symulowanych danych 240 pracowników oceniło siedem stwierdzeń o warunkach pracy na skali od 1 do 5. Z pomocą kolegów zgadzało się 76.7% osób, a z tym, że wynagrodzenie jest adekwatne – tylko 15.4% (niezgoda: 60.0%). Najwięcej odpowiedzi środkowych dotyczyło wpływu na organizację pracy (37.9%). Położenia odpowiedzi w stwierdzeniach i progi kategorii ustawiono ręcznie tak, by stwierdzenia wyraźnie się różniły; ziarna (757) nie zmieniano.
Na rysunku
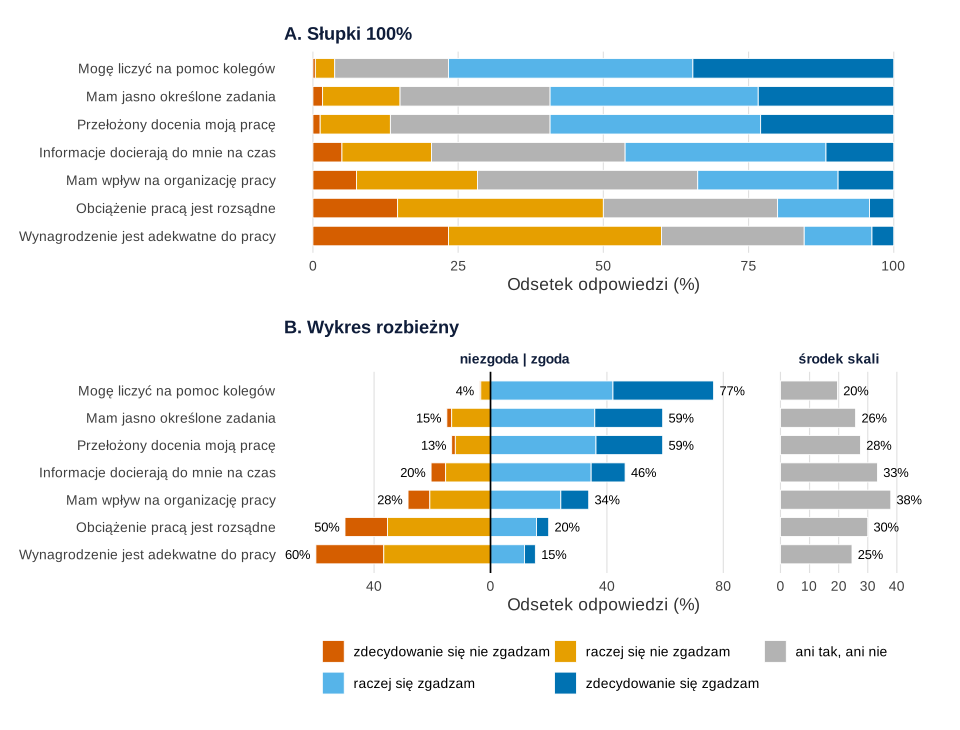
set.seed(757)).Co widać. W panelu A łączną niezgodę odczytasz od lewej krawędzi, a łączną zgodę od prawej. Trudniej porównać odcinki w środku, bo każdy zaczyna się w innym miejscu. Panel B ustawia wszystkie słupki przy jednej linii zera. Od razu widać, że opinie o wynagrodzeniu i obciążeniu pracą są przesunięte w lewo, a o pomocy kolegów – w prawo. Stwierdzenia o przełożonym i o jasnych zadaniach mają tę samą zgodę (59.2%), ale różnią się niezgodą (13.3% i 15.0%). Cleveland i McGill (1984) pokazali, że położenie na wspólnej skali odczytujemy dokładniej niż długości odcinków bez wspólnej linii bazowej.
Na co uważać. Wykres nie pokazuje liczebności ani niepewności odsetków – przy małej próbie podaj n w podpisie. Nie pokazuje też braków odpowiedzi ani „nie wiem”. W przykładzie braków nie ma, więc odsetki liczono od 240 osób; w prawdziwych danych napisz, od jakiej liczby osób liczysz odsetki. Kolor nie jest tu jedynym nośnikiem informacji: kierunek odczytasz z położenia względem zera, a skrajność z kolejności odcinków. Pełny przepis z tabelą odsetków i porównaniem grup pokazuje wpis odpowiedzi Likerta w raporcie, w którym środek skali jest przecięty na pół.
Podpis do pracy:
Kod rysunku i tabelę odsetków znajdziesz w sekcji Wykres rozbieżny w R.
Jak opisać w pracy
Na co uważać
- Para czerwony–zielony. Dla osób z zaburzeniami widzenia barw jest nieczytelna. Lepsza jest para pomarańcz–błękit i szary środek.
- Różne skale na jednym wykresie. Na jednej osi zera umieszczaj tylko pozycje o tych samych kategoriach odpowiedzi.
- Środek przecięty na pół przesuwa słupki, gdy odpowiedzi neutralnych jest dużo, i utrudnia porównanie niezgody. Wtedy pokaż środek osobno.
- Średnie zamiast rozkładu. Wykres pokazuje odsetki, więc nie dopisuj do niego średnich pozycji bez komentarza – o tym, kiedy średnia ma sens, piszemy we wpisie skala Likerta: średnia czy mediana.
Gdy chcesz pokazać jedną liczbę na stwierdzenie, na przykład odsetek zgody z przedziałem ufności, lepszy bywa wykres punktowy Clevelanda. Inne typy rysunków porządkuje wpis wykresy w pracy dyplomowej.
Wykres rozbieżny w R
Kod symuluje odpowiedzi, liczy odsetki każdej kategorii, sortuje stwierdzenia według zgody i rysuje oba panele rysunku 1 w ggplot2. W panelu B każdy odcinek to prostokąt (geom_rect) z wyliczonym początkiem: niezgoda ma współrzędne ujemne, zgoda dodatnie, a środek skali trafia do osobnego panelu. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Odsetki niezgody, środka i zgody oraz rysunek 1
R
# Rysunek 1. Te same odpowiedzi na skali Likerta: słupki 100% (A) i wykres rozbieżny ze środkiem osobno (B)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kat <- c("zdecydowanie się nie zgadzam", "raczej się nie zgadzam", "ani tak, ani nie",
         "raczej się zgadzam", "zdecydowanie się zgadzam")
kol <- c("#D55E00", "#E69F00", "grey70", "#56B4E9", "#0072B2")   # Okabe–Ito: niezgoda – zgoda
names(kol) <- kat
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), panel.grid.major.y = element_blank(), legend.position = "bottom")
stw <- c("Mogę liczyć na pomoc kolegów", "Przełożony docenia moją pracę", "Mam jasno określone zadania",
         "Informacje docierają do mnie na czas", "Mam wpływ na organizację pracy",
         "Obciążenie pracą jest rozsądne", "Wynagrodzenie jest adekwatne do pracy")
set.seed(757)                                       # 240 pracowników, 7 stwierdzeń, odpowiedzi 1–5
n <- 240
polozenie <- c(1.0, 0.6, 0.5, 0.1, -0.1, -0.5, -0.9)   # przesunięcie zgody w stwierdzeniach (ustawione ręcznie)
progi <- c(-1.6, -0.6, 0.3, 1.3)
odp <- sapply(polozenie, function(m) findInterval(rnorm(n, m), progi) + 1)
colnames(odp) <- stw
tab <- t(apply(odp, 2, function(x) table(factor(x, levels = 1:5)) / n * 100))
colnames(tab) <- kat
tab <- tab[order(tab[, 4] + tab[, 5]), ]            # sortowanie według odsetka zgody
d <- data.frame(stw = factor(rep(rownames(tab), 5), levels = rownames(tab)),
                kat = factor(rep(kat, each = nrow(tab)), levels = kat), proc = c(tab))
# A: zwykłe słupki 100%, każdy zaczyna się od zera
pA <- ggplot(d, aes(proc, stw, fill = kat)) +
  geom_col(width = 0.7, position = position_stack(reverse = TRUE), colour = "white", linewidth = 0.3) +
  scale_fill_manual(values = kol, name = NULL) +
  labs(title = "A. Słupki 100%", x = "Odsetek odpowiedzi (%)", y = NULL) + motyw
# B: wykres rozbieżny – niezgoda na lewo od zera, zgoda na prawo, środek w osobnym panelu
d$y <- as.numeric(d$stw)
start <- cbind(-(tab[, 1] + tab[, 2]), -tab[, 2], 0, 0, tab[, 4])   # gdzie zaczyna się każdy odcinek
d$xmin <- c(start)
d$xmax <- d$xmin + d$proc
d$panel <- factor(ifelse(as.integer(d$kat) == 3, "środek skali", "niezgoda | zgoda"),
                  levels = c("niezgoda | zgoda", "środek skali"))
sumy <- data.frame(stw = rownames(tab), y = seq_len(nrow(tab)),
                   nie = tab[, 1] + tab[, 2], tak = tab[, 4] + tab[, 5],
                   srodek = tab[, 3], panel = factor("niezgoda | zgoda", levels = levels(d$panel)))
pB <- ggplot(d) +
  geom_rect(aes(xmin = xmin, xmax = xmax, ymin = y - 0.35, ymax = y + 0.35, fill = kat),
            colour = "white", linewidth = 0.3) +
  geom_vline(data = data.frame(panel = factor("niezgoda | zgoda", levels = levels(d$panel))),
             aes(xintercept = 0), linewidth = 0.6) +
  geom_text(data = sumy, aes(x = -nie - 2, y = y, label = sprintf("%.0f%%", nie)), hjust = 1, size = 3.4) +
  geom_text(data = sumy, aes(x = tak + 2, y = y, label = sprintf("%.0f%%", tak)), hjust = 0, size = 3.4) +
  geom_text(data = transform(sumy, panel = factor("środek skali", levels = levels(d$panel))),
            aes(x = srodek + 2, y = y, label = sprintf("%.0f%%", srodek)), hjust = 0, size = 3.4) +
  facet_grid(. ~ panel, scales = "free_x", space = "free_x") +
  scale_y_continuous(breaks = seq_len(nrow(tab)), labels = rownames(tab)) +
  scale_x_continuous(labels = function(x) abs(x), expand = expansion(add = 9)) +
  scale_fill_manual(values = kol, name = NULL, drop = FALSE) +
  labs(title = "B. Wykres rozbieżny", x = "Odsetek odpowiedzi (%)", y = NULL) + motyw
p1 <- pA / pB + plot_layout(guides = "collect") & theme(legend.position = "bottom") &
  guides(fill = guide_legend(nrow = 2, byrow = TRUE))
round(cbind(niezgoda = tab[, 1] + tab[, 2], srodek = tab[, 3], zgoda = tab[, 4] + tab[, 5]), 1)
p1
Wynik w R
                                      niezgoda srodek zgoda
Wynagrodzenie jest adekwatne do pracy     60.0   24.6  15.4
Obciążenie pracą jest rozsądne            50.0   30.0  20.0
Mam wpływ na organizację pracy            28.3   37.9  33.8
Informacje docierają do mnie na czas      20.4   33.3  46.2
Przełożony docenia moją pracę             13.3   27.5  59.2
Mam jasno określone zadania               15.0   25.8  59.2
Mogę liczyć na pomoc kolegów               3.8   19.6  76.7
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym rozbieżny wykres skumulowany różni się od słupków 100%?
W słupkach 100% każdy słupek zaczyna się od zera po lewej, więc środkowe kategorie zaczynają się w różnych miejscach. Na wykresie rozbieżnym niezgoda i zgoda leżą po obu stronach wspólnej linii zera, dlatego ich łączne odsetki porównasz między stwierdzeniami jednym spojrzeniem.
Czy na rozbieżnym wykresie skumulowanym trzeba pokazywać odpowiedź środkową?
Tak, bo inaczej odsetki zgody i niezgody wyglądają na większe, niż są. Środek można przeciąć na pół po obu stronach zera albo pokazać w osobnym panelu. Osobny panel jest czytelniejszy, gdy odpowiedzi neutralnych jest dużo – w przykładzie od 19.6% do 37.9%.
W jakiej kolejności ułożyć stwierdzenia na wykresie rozbieżnym?
Najczęściej według łącznego odsetka zgody, od najniższego do najwyższego albo odwrotnie. Kolejność z kwestionariusza nic nie mówi czytelnikowi. Jeśli stwierdzenia tworzą podskale, możesz najpierw je pogrupować, a sortować wewnątrz grup.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Odpowiedzi Likerta w raporcie
Tabela odsetków, odpowiedź „nie wiem”, wykres rozbieżny w ggplot2 i porównanie grup z poprawką Holma – z kodem R i wzorem opisu.
Czytaj →PoradnikSkala Likerta: średnia czy mediana?
Pozycja jest porządkowa, wynik skali – zwykle ilościowy. Kiedy mediana i odsetki, kiedy M, SD i test t, z przykładem w R i opisem APA.
Czytaj →PoradnikWykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Heiberger, R. M., & Robbins, N. B. (2014). Design of diverging stacked bar charts for Likert scales and other applications. Journal of Statistical Software, 57(5), 1–32. https://doi.org/10.18637/jss.v057.i05 ● Otwarty dostęp
Cytowania BibTeX
@article{cleveland1984graphical, author={Cleveland, William S. and McGill, Robert}, title={{Graphical perception: Theory, experimentation, and application to the development of graphical methods}}, journal={Journal of the American Statistical Association}, year={1984}, volume={79}, number={387}, pages={531--554}, doi={10.1080/01621459.1984.10478080}}@article{heiberger2014design, author={Heiberger, Richard M. and Robbins, Naomi B.}, title={{Design of diverging stacked bar charts for Likert scales and other applications}}, journal={Journal of Statistical Software}, year={2014}, volume={57}, number={5}, pages={1--32}, doi={10.18637/jss.v057.i05}}