Co to jest współczynnik niepewności Theila?
Współczynnik niepewności Theila (ang. Theil’s uncertainty coefficient, U, także entropy coefficient) to miara związku dwóch zmiennych nominalnych, która mówi, o jaką część zmniejsza się niepewność co do zmiennej Y, gdy znamy X. Niepewność mierzy się entropią Shannona (Shannon, 1948), a informacyjne miary siły wyjaśniania dla zmiennych jakościowych opisał Theil (1970). Współczynnik przyjmuje wartości od 0 (brak związku) do 1 (X w pełni wyznacza Y).
Wzór i wersje
U(Y|X) = [H(Y) − H(Y|X)] / H(Y) = I(X; Y) / H(Y), gdzie I to informacja wzajemna. Miara jest asymetryczna: U(X|Y) dzieli tę samą informację przez H(X). Wersja symetryczna to 2I / [H(X) + H(Y)]. Podobnie jak lambda Goodmana–Kruskala wynika z logiki przewidywania jednej zmiennej na podstawie drugiej (Goodman i Kruskal, 1954), ale bierze pod uwagę cały rozkład, a nie tylko kategorię modalną. Dlatego nie spada do zera, gdy we wszystkich grupach dominuje ta sama kategoria.
Przykład
W tabeli krzyżowej 2 × 3 (dwie grupy po 50 osób, trzy możliwe wybory) U(Y|X) = 0.136: znajomość grupy zmniejsza niepewność co do wyboru o 13.6%. W drugą stronę U(X|Y) = 0.215, a wersja symetryczna wynosi 0.167. Dla tych samych danych lambda = 0.308, a V Craméra = 0.526 – miary mają różne skale i nie należy ich porównywać wprost. Istotność sprawdza test ilorazu wiarygodności G = 2N · I = 29.85 (df = 2, p < .001), bliski testowi chi-kwadrat niezależności.
Na rysunku
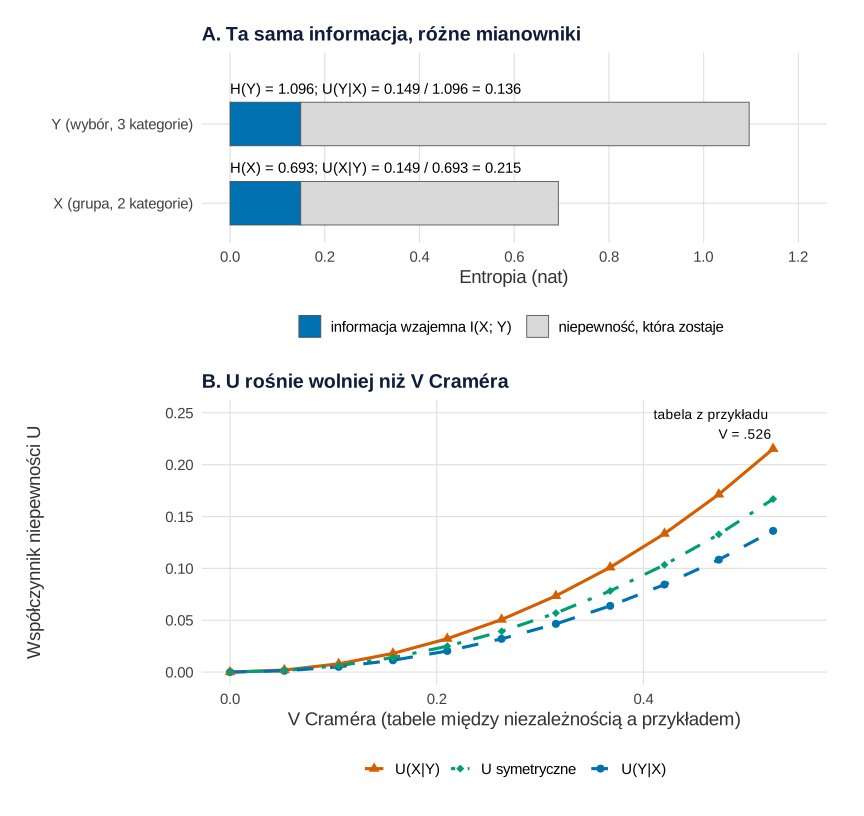
Co widać. Panel A rozkłada niepewność obu zmiennych z przykładu. Wybór (Y, trzy kategorie) ma entropię 1.096 nata, grupa (X, dwie kategorie) – 0.693 nata. Informacja wzajemna, 0.149 nata, jest wspólna dla obu pasków: tyle samo wiedzy daje grupa o wyborze, co wybór o grupie. Różnią się tylko mianowniki, dlatego U(Y|X) = 0.136, a U(X|Y) = 0.215. Wyższy jest więc współczynnik dla tej zmiennej przewidywanej, która ma mniejszą entropię, czyli mniej kategorii albo bardziej nierówne liczebności. Panel B zestawia U z V Craméra. Tabele powstały przez mieszanie tabeli z przykładu z tabelą niezależności o tych samych brzegach (udział tabeli z przykładu od 0 do 1 co 0.1). Krzywe rosną wypukło: przy V = .263 U(Y|X) wynosi 0.032, a przy dwa razy większym V = .526 – 0.136, czyli ponad cztery razy więcej.
Na co uważać. Ta sama tabela daje U około 0.14–0.22 i V około 0.53, więc wartości z różnych miar nie przekładają się na wspólne progi „słaby–silny”. Rysunek dotyczy jednej rodziny tabel o stałych brzegach; przy innych brzegach krzywe w panelu B ułożą się inaczej. Nie pokazuje też niepewności oszacowania z próby – przy 100 osobach warto podać przedział ufności. Inne sposoby pokazania tej samej tabeli porównuje wpis Tabela krzyżowa na wykresie.
Podpis do pracy:
Kod rysunku korzysta z tabeli z przykładu i niczego nie losuje. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Jedna informacja wzajemna, dwa mianowniki: U(Y|X) i U(X|Y) dla tabeli z przykładu oraz U a V Craméra
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

H <- function(p) { p <- p[p > 0]; -sum(p * log(p)) }        # entropia (nat)
miary <- function(tab) {
  P <- tab / sum(tab)
  H_X <- H(rowSums(P)); H_Y <- H(colSums(P)); I <- H_X + H_Y - H(P)
  chi2 <- suppressWarnings(chisq.test(tab, correct = FALSE)$statistic)
  c(H_X = H_X, H_Y = H_Y, I = I, U_Y_przy_X = I / H_Y, U_X_przy_Y = I / H_X,
    U_sym = 2 * I / (H_X + H_Y), V = sqrt(unname(chi2) / (sum(tab) * (min(dim(tab)) - 1))))
}

# Tabela z przykładu: grupy A i B po 50 osób, wybory y1–y3
tab <- matrix(c(30, 10, 10,
                 5, 25, 20), nrow = 2, byrow = TRUE,
              dimnames = list(X = c("A", "B"), Y = c("y1", "y2", "y3")))
m <- miary(tab); round(m, 3)

# Panel A: entropia każdej zmiennej = informacja wspólna + niepewność, która zostaje
dA <- data.frame(zmienna = rep(c("Y (wybór, 3 kategorie)", "X (grupa, 2 kategorie)"), each = 2),
                 czesc = rep(c("informacja wzajemna I(X; Y)", "niepewność, która zostaje"), 2),
                 nat = c(m["I"], m["H_Y"] - m["I"], m["I"], m["H_X"] - m["I"]))
dA$czesc <- factor(dA$czesc, levels = c("niepewność, która zostaje", "informacja wzajemna I(X; Y)"))
et <- data.frame(zmienna = c("Y (wybór, 3 kategorie)", "X (grupa, 2 kategorie)"),
                 H = c(m["H_Y"], m["H_X"]),
                 tekst = c(sprintf("H(Y) = %.3f;  U(Y|X) = %.3f / %.3f = %.3f", m["H_Y"], m["I"], m["H_Y"], m["U_Y_przy_X"]),
                           sprintf("H(X) = %.3f;  U(X|Y) = %.3f / %.3f = %.3f", m["H_X"], m["I"], m["H_X"], m["U_X_przy_Y"])))
pA <- ggplot(dA, aes(x = nat, y = zmienna)) +
  geom_col(aes(fill = czesc), width = 0.55, colour = "grey30", linewidth = 0.3, orientation = "y") +
  geom_text(data = et, aes(x = 0, label = tekst), nudge_y = 0.45, hjust = 0, size = 3.9) +
  scale_fill_manual(values = c("informacja wzajemna I(X; Y)" = "#0072B2", "niepewność, która zostaje" = "grey85"),
                    breaks = c("informacja wzajemna I(X; Y)", "niepewność, która zostaje"), name = NULL) +
  scale_x_continuous(limits = c(0, 1.2), breaks = seq(0, 1.2, 0.2)) +
  scale_y_discrete(expand = expansion(add = c(0.5, 0.9))) +
  labs(title = "A. Ta sama informacja, różne mianowniki", x = "Entropia (nat)", y = NULL) +
  motyw

# Panel B: tabele od niezależności (w = 0) do tabeli z przykładu (w = 1) przy tych samych brzegach
niez <- outer(rowSums(tab), colSums(tab)) / sum(tab)
szer <- as.data.frame(t(sapply(seq(0, 1, by = 0.1), function(w) {
  mm <- miary(w * tab + (1 - w) * niez)
  c(w = w, mm[c("V", "U_Y_przy_X", "U_X_przy_Y", "U_sym")])
})))
round(szer, 3)
dB <- data.frame(V = rep(szer$V, 3), miara = rep(c("U(Y|X)", "U(X|Y)", "U symetryczne"), each = nrow(szer)),
                 U = c(szer$U_Y_przy_X, szer$U_X_przy_Y, szer$U_sym))
dB$miara <- factor(dB$miara, levels = c("U(X|Y)", "U symetryczne", "U(Y|X)"))
pB <- ggplot(dB, aes(V, U, colour = miara, linetype = miara)) +
  geom_line(linewidth = 1.1) +
  geom_point(aes(shape = miara), size = 2.4) +
  annotate("text", x = m["V"], y = 0.225, label = "tabela z przykładu\nV = .526", size = 3.6, hjust = 1.05, vjust = 0) +
  scale_colour_manual(values = c("U(X|Y)" = "#D55E00", "U symetryczne" = "#009E73", "U(Y|X)" = "#0072B2"), name = NULL) +
  scale_linetype_manual(values = c("U(X|Y)" = "solid", "U symetryczne" = "dotdash", "U(Y|X)" = "dashed"), name = NULL) +
  scale_shape_manual(values = c("U(X|Y)" = 17, "U symetryczne" = 18, "U(Y|X)" = 16), name = NULL) +
  coord_cartesian(xlim = c(0, 0.55), ylim = c(0, 0.25)) +
  labs(title = "B. U rośnie wolniej niż V Craméra",
       x = "V Craméra (tabele między niezależnością a przykładem)", y = "Współczynnik niepewności U") +
  motyw

p <- pA / pB + plot_layout(heights = c(0.8, 1.2))
p
Wynik w R
       H_X        H_Y          I U_Y_przy_X U_X_przy_Y      U_sym          V
     0.693      1.096      0.149      0.136      0.215      0.167      0.526
     w     V U_Y_przy_X U_X_przy_Y U_sym
1  0.0 0.000      0.000      0.000 0.000
2  0.1 0.053      0.001      0.002 0.002
3  0.2 0.105      0.005      0.008 0.006
4  0.3 0.158      0.011      0.018 0.014
5  0.4 0.210      0.020      0.032 0.025
6  0.5 0.263      0.032      0.051 0.039
7  0.6 0.315      0.046      0.074 0.057
8  0.7 0.368      0.064      0.101 0.078
9  0.8 0.420      0.084      0.134 0.103
10 0.9 0.473      0.108      0.171 0.133
11 1.0 0.526      0.136      0.215 0.167
Jak opisać w pracy
Na co uważać
- Zawsze podaj kierunek: która zmienna jest przewidywana. W pakiecie DescTools
direction = "column"oznacza zmienną w kolumnach jako zależną. - Nie myl tej miary ze statystyką U Theila do oceny trafności prognoz ani z estymatorem Theila–Sena.
- Jednostka logarytmu (bity, naty) skraca się w ilorazie, więc nie zmienia U; przy H i I trzeba ją podać.
Współczynnik niepewności Theila w R
Kod liczy entropie, informację wzajemną i trzy wersje U ręcznie, sprawdza je funkcją UncertCoef() z pakietu DescTools, porównuje z lambdą i V Craméra oraz liczy test G.
Entropia, informacja wzajemna i U
R
# Współczynnik niepewności Theila U(Y|X) = [H(Y) - H(Y|X)] / H(Y)
tab <- matrix(c(30, 10, 10,
                 5, 25, 20), nrow = 2, byrow = TRUE,
              dimnames = list(X = c("A", "B"), Y = c("y1", "y2", "y3")))
H <- function(p) { p <- p[p > 0]; -sum(p * log(p)) }   # entropia (nat)
P <- tab / sum(tab)
H_X <- H(rowSums(P)); H_Y <- H(colSums(P)); H_XY <- H(P)
I_XY <- H_X + H_Y - H_XY                                # informacja wzajemna
round(c(H_Y = H_Y, H_Y_przy_X = H_XY - H_X, I = I_XY,
        U_Y_przy_X = I_XY / H_Y, U_X_przy_Y = I_XY / H_X,
        U_sym = 2 * I_XY / (H_X + H_Y)), 3)
library(DescTools)
# DescTools: direction = "column" - zmienna w kolumnach (Y) zależna
round(c(U_Y_przy_X = UncertCoef(tab, direction = "column"),
        U_X_przy_Y = UncertCoef(tab, direction = "row"),
        U_sym = UncertCoef(tab, direction = "symmetric")), 3)
round(c(lambda_Y_przy_X = Lambda(tab, direction = "column"),
        V_Cramera = CramerV(tab)), 3)
# test istotności: statystyka G (ilorazu wiarygodności) = 2 * N * I
G <- 2 * sum(tab) * I_XY
round(c(G = G, df = (nrow(tab) - 1) * (ncol(tab) - 1),
        p = pchisq(G, df = 2, lower.tail = FALSE)), 4)
Wynik w R
       H_Y H_Y_przy_X          I U_Y_przy_X U_X_przy_Y      U_sym
     1.096      0.947      0.149      0.136      0.215      0.167
U_Y_przy_X U_X_przy_Y      U_sym
     0.136      0.215      0.167
lambda_Y_przy_X       V_Cramera
          0.308           0.526
      G      df       p
29.8516  2.0000  0.0000
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://CRAN.R-project.org/package=DescTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym współczynnik niepewności Theila różni się od lambdy?
Lambda patrzy tylko na kategorię modalną i bywa równa zeru mimo związku. Współczynnik Theila korzysta z całego rozkładu przez entropię, więc wychwytuje także słabsze różnice między grupami.
Którą wersję współczynnika U podać w pracy?
Wersję asymetryczną, gdy jedna zmienna jest wyjaśniana, np. U(wybór|grupa). Symetryczną, gdy żadna nie jest wyróżniona. Zawsze napisz, w którą stronę liczono.
Jak sprawdzić istotność współczynnika niepewności Theila?
Najprościej testem ilorazu wiarygodności G = 2N · I, gdzie I to informacja wzajemna w natach; ma on w przybliżeniu rozkład chi-kwadrat z (r − 1)(c − 1) stopniami swobody.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Goodman, L. A., & Kruskal, W. H. (1954). Measures of association for cross classifications. Journal of the American Statistical Association, 49(268), 732–764. https://doi.org/10.1080/01621459.1954.10501231
- Shannon, C. E. (1948). A mathematical theory of communication. Bell System Technical Journal, 27(3), 379–423. https://doi.org/10.1002/j.1538-7305.1948.tb01338.x
- Theil, H. (1970). On the estimation of relationships involving qualitative variables. American Journal of Sociology, 76(1), 103–154. https://doi.org/10.1086/224909
Cytowania BibTeX
@article{goodman1954measures, author={Goodman, Leo A. and Kruskal, William H.}, title={{Measures of association for cross classifications}}, journal={Journal of the American Statistical Association}, year={1954}, volume={49}, number={268}, pages={732--764}, doi={10.1080/01621459.1954.10501231}}@article{shannon1948mathematical, author={Shannon, Claude E.}, title={{A mathematical theory of communication}}, journal={Bell System Technical Journal}, year={1948}, volume={27}, number={3}, pages={379--423}, doi={10.1002/j.1538-7305.1948.tb01338.x}}@article{theil1970estimation, author={Theil, Henri}, title={{On the estimation of relationships involving qualitative variables}}, journal={American Journal of Sociology}, year={1970}, volume={76}, number={1}, pages={103--154}, doi={10.1086/224909}}