Co to jest estymator Theila–Sena?
Estymator Theila–Sena (ang. Theil–Sen estimator, też nachylenie Sena) to odporna, nieparametryczna metoda dopasowania prostej w regresji z jedną zmienną niezależną. Nachyleniem jest mediana nachyleń wszystkich odcinków łączących pary punktów. Pomysł pochodzi od Henriego Theila, a Sen (1968) pokazał, że to estymator oparty na tau Kendalla, i podał dla niego przedział ufności.
Jak liczyć
- Dla każdej pary obserwacji z różnym x policz nachylenie Sij = (yj − yi) / (xj − xi). Przy n obserwacjach par jest n(n − 1)/2.
- Nachylenie b to mediana wszystkich Sij.
- Wyraz wolny a to najczęściej mediana wartości yi − bxi.
- Granice 95% przedziału ufności to dwa nachylenia o rzędach wyznaczonych z rozkładu statystyki Kendalla (Sen, 1968).
Pojedynczy błędny punkt zmienia tylko część nachyleń, więc mediana prawie się nie przesuwa. Dietz (1989) porównała estymatory prostej regresji pod względem efektywności i punktu załamania i poleca nachylenie Theila jako odporną, wydajną i łatwą w obliczeniu alternatywę dla metody najmniejszych kwadratów (MNK).
Przykład
W symulowanych danych 30 osób wynik testu rósł o 1.5 pkt na rok stażu. Trzem osobom z najdłuższym stażem wpisano wynik o 30 pkt za niski. MNK dało nachylenie 0.70, a bez tych wierszy 1.54. Estymator Theila–Sena z 435 par dał 1.28, 95% CI [0.84, 1.64], czyli przedział obejmuje prawdziwą wartość mimo błędnych danych.
Na rysunku
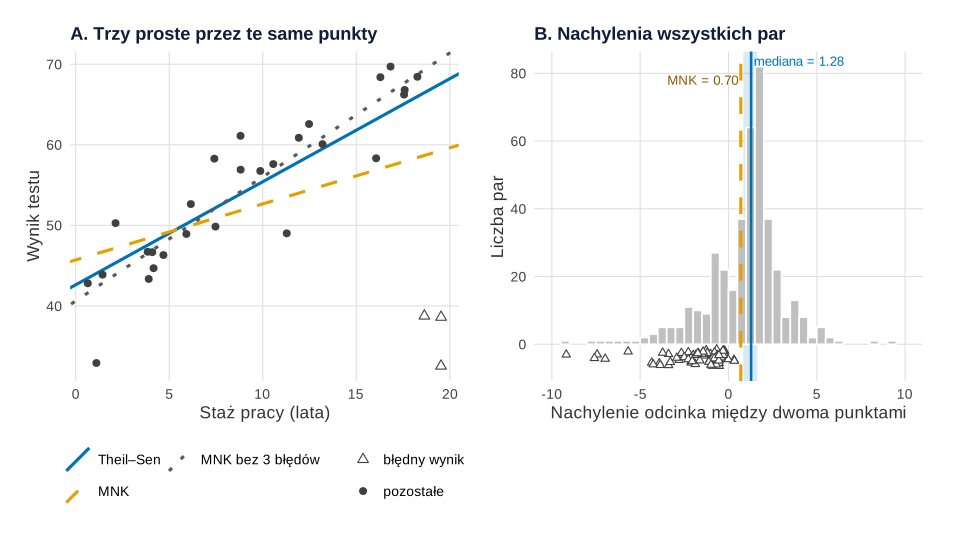
set.seed(4901)).Co widać. W panelu A trzy błędne wyniki (trójkąty) ściągają prostą MNK w dół: nachylenie spada do 0.70. Prosta Theila–Sena (1.28) biegnie blisko prostej MNK policzonej bez błędnych wierszy (1.54). Panel B wyjaśnia dlaczego. Z 435 par tylko 84 zawierają błędny punkt; 96% ich nachyleń jest ujemnych (mediana −1.72), ale tworzą one lewy ogon histogramu, a nie jego środek. Pozostałe pary mają medianę 1.57, więc mediana wszystkich nachyleń przesuwa się tylko trochę. MNK nie „głosuje” parami – wkład punktu do nachylenia rośnie z iloczynem jego odchyleń od średniej x i od średniej y, a błędne punkty leżą daleko od średniej x.
Na co uważać. Oś panelu B obcięto do przedziału od −10 do 10: 30 par leży dalej, bo punkty o prawie równym x dają nachylenia rzędu setek. Mediana jest na nie niewrażliwa, ale średnia nachyleń par byłaby bezużyteczna. Odporność ma granicę: gdy błędnych punktów jest tak dużo, że ich pary przeważą, mediana też się przesunie. Rysunek nie mówi, czy te trzy wyniki są błędem, czy prawdziwym spadkiem u najdłużej pracujących – to trzeba sprawdzić w danych. Jak pojedynczy punkt przestawia prostą MNK w różnych miejscach wykresu, pokazuje wpis Obserwacje wpływowe – wizualizacja.
Podpis do pracy:
Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne. Ziarno 4901 jest to samo co w przykładzie; drugie ziarno (seed = 1 w position_jitter) służy tylko do rozsunięcia trójkątów w pionie.
Kod R rysunku 1
# Rysunek 1. Trzy proste (A) i rozkład nachyleń wszystkich 435 par punktów (B) – dane z przykładu
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(ts = "#0072B2", ols = "#E69F00", bez = "grey35")   # Okabe–Ito; linie różnią się też rodzajem
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom")
set.seed(4901)
n <- 30
x <- runif(n, 0, 20)
y <- 40 + 1.5 * x + rnorm(n, sd = 4)
odst <- order(x, decreasing = TRUE)[1:3]
y[odst] <- y[odst] - 30                                      # trzy błędnie wpisane wyniki
p <- combn(n, 2)
s <- (y[p[2, ]] - y[p[1, ]]) / (x[p[2, ]] - x[p[1, ]])
z_bledem <- p[1, ] %in% odst | p[2, ] %in% odst              # para zawiera błędny punkt
b <- median(s); a <- median(y - b * x)
N <- length(s); C <- qnorm(0.975) * sqrt(n * (n - 1) * (2 * n + 5) / 18)
ci <- sort(s)[c(floor((N - C) / 2), ceiling((N + C) / 2) + 1)]
ols <- coef(lm(y ~ x)); ols_cz <- coef(lm(y[-odst] ~ x[-odst]))
zakres <- c(-10, 10)                                         # oś panelu B (bliskie x dają nachylenia ±setki)
round(c(par = N, par_z_bledem = sum(z_bledem), poza_osia = sum(s < zakres[1] | s > zakres[2]),
        mediana_z_bledem = median(s[z_bledem]), mediana_bez_bledu = median(s[!z_bledem]),
        odsetek_ujemnych_z_bledem = mean(s[z_bledem] < 0)), 2)
d <- data.frame(x, y, typ = ifelse(seq_len(n) %in% odst, "błędny wynik", "pozostałe"))
proste <- data.frame(metoda = factor(c("Theil–Sen", "MNK", "MNK bez 3 błędów"),
                                     levels = c("Theil–Sen", "MNK", "MNK bez 3 błędów")),
                     a = c(a, ols[1], ols_cz[1]), b = c(b, ols[2], ols_cz[2]))
pA <- ggplot(d, aes(x, y)) +
  geom_abline(data = proste, aes(intercept = a, slope = b, colour = metoda, linetype = metoda), linewidth = 1.1) +
  geom_point(aes(shape = typ), size = 2.4, colour = "grey25", fill = "white") +
  scale_shape_manual(values = c("błędny wynik" = 24, "pozostałe" = 16), name = NULL) +
  scale_colour_manual(values = unname(kol), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "dotted"), name = NULL) +
  labs(title = "A. Trzy proste przez te same punkty", x = "Staż pracy (lata)", y = "Wynik testu") +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2), shape = guide_legend(nrow = 2))
ds <- subset(data.frame(s, z_bledem), s >= zakres[1] & s <= zakres[2])   # pary poza osią pominięte
pB <- ggplot(ds, aes(s)) +
  annotate("rect", xmin = ci[1], xmax = ci[2], ymin = -Inf, ymax = Inf, fill = kol[["ts"]], alpha = 0.15) +
  geom_histogram(binwidth = 0.5, boundary = 0, fill = "grey75", colour = "white") +
  geom_point(data = subset(ds, z_bledem), aes(x = s, y = -4), shape = 24, size = 1.8, colour = "grey25",
             fill = "white", position = position_jitter(width = 0, height = 2.5, seed = 1)) +
  geom_vline(xintercept = b, colour = kol[["ts"]], linewidth = 0.9) +
  geom_vline(xintercept = ols[2], colour = kol[["ols"]], linetype = "dashed", linewidth = 1.1) +
  annotate("text", x = b + 0.15, y = Inf, vjust = 1.5, hjust = 0, size = 3.5, colour = kol[["ts"]],
           label = sprintf("mediana = %.2f", b)) +
  annotate("text", x = ols[2] - 0.15, y = Inf, vjust = 3.5, hjust = 1, size = 3.5, colour = "#8a5a00",
           label = sprintf("MNK = %.2f", ols[2])) +
  coord_cartesian(xlim = zakres) +
  labs(title = "B. Nachylenia wszystkich par", x = "Nachylenie odcinka między dwoma punktami",
       y = "Liczba par")
p1 <- (pA + pB) & motyw
p1
Wynik w R
                      par              par_z_bledem                 poza_osia
                   435.00                     84.00                     30.00
         mediana_z_bledem         mediana_bez_bledu odsetek_ujemnych_z_bledem
                    -1.72                      1.57                      0.96
Jak opisać w pracy
Na co uważać
- Jedna zmienna niezależna. Przy kilku predyktorach sięgnij po estymator M lub MM; porównanie metod daje wpis regresja odporna.
- Porównanie metod pomiaru. Gdy obie zmienne mają błąd pomiaru, a wynik nie powinien zależeć od zamiany osi, użyj regresji Passinga–Babloka, która przesuwa medianę nachyleń.
- Nie usuwaj problemu z oczu. Odporna prosta nie zastępuje sprawdzenia, skąd wzięła się obserwacja odstająca, ani modelu dla krzywizny. Szerzej o regresji odpornej, także przy heteroskedastyczności, pisze Wilcox (2021).
Estymator Theila–Sena w R
Kod liczy estymator ręcznie: nachylenia wszystkich par, ich medianę, wyraz wolny i przedział ufności Sena, a potem porównuje wynik z MNK. Funkcja mblm::mblm() z repeated = FALSE daje te same współczynniki (42.62 i 1.28). Jej confint() liczy jednak przedział z testu Wilcoxona dla nachyleń par, a nie przedział Sena: [0.82, 1.26], który nie obejmuje nawet mediany 1.28. Przedział nachylenia podawaj więc metodą Sena.
Mediana nachyleń par a MNK przy błędnych wierszach
R
set.seed(4901)
n <- 30
x <- runif(n, 0, 20)                         # staż pracy w latach
y <- 40 + 1.5 * x + rnorm(n, sd = 4)         # wynik testu; prawdziwe nachylenie 1.5
odst <- order(x, decreasing = TRUE)[1:3]     # 3 osoby z największym x...
y[odst] <- y[odst] - 30                      # ...z błędnie wpisanym wynikiem
p <- combn(n, 2)                             # wszystkie pary punktów
s <- (y[p[2, ]] - y[p[1, ]]) / (x[p[2, ]] - x[p[1, ]])
s <- sort(s[is.finite(s)])
b <- median(s)                               # nachylenie Theila–Sena
a <- median(y - b * x)                       # wyraz wolny: mediana y - b*x
N <- length(s)                               # przedział Sena (1968) z rzędów nachyleń
C <- qnorm(0.975) * sqrt(n * (n - 1) * (2 * n + 5) / 18)
ci <- s[c(floor((N - C) / 2), ceiling((N + C) / 2) + 1)]
ols <- coef(lm(y ~ x)); ols_cz <- coef(lm(y[-odst] ~ x[-odst]))
round(rbind(TheilSen = c(a, b), OLS = ols, OLS_bez_bledow = ols_cz), 2)
c(par = N, CI_dol = round(ci[1], 2), CI_gor = round(ci[2], 2))
m <- mblm::mblm(y ~ x, repeated = FALSE)     # to samo w pakiecie mblm
round(coef(m), 2)
round(suppressWarnings(confint(m)), 2)       # uwaga: przedział z testu Wilcoxona, nie Sena
Wynik w R
               (Intercept)    x
TheilSen             42.62 1.28
OLS                  45.71 0.70
OLS_bez_bledow       40.62 1.54
   par CI_dol CI_gor
435.00   0.84   1.64
(Intercept)           x
      42.62        1.28
            0.025 0.975
(Intercept) 39.53 44.25
x            0.82  1.26
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats oraz pakiet mblm 0.12.1; rysunek 1 – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- mblm (wersja 0.12.1): Komsta, L. (2019). mblm: Median-based linear models (R package version 0.12.1) [Computer software]. https://doi.org/10.32614/CRAN.package.mblm
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym estymator Theila–Sena różni się od regresji Passinga–Babloka?
Obie metody używają mediany nachyleń par. Passing–Bablok przesuwa medianę, by wynik nie zależał od zamiany osi, i służy do porównania metod pomiaru. Theil–Sen traktuje x jako predyktor.
Ile obserwacji odstających wytrzymuje estymator Theila–Sena?
Nachylenie pozostaje ograniczone, dopóki odstaje mniej niż około 29% punktów. Nachylenie z metody najmniejszych kwadratów może dowolnie przesunąć już jedna skrajna obserwacja.
Jak policzyć estymator Theila–Sena w R bez dodatkowych pakietów?
Funkcja combn() tworzy pary punktów, z nich liczysz nachylenia (yj − yi)/(xj − xi), a median() daje nachylenie. Wyraz wolny to mediana y − b·x.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Dietz, E. J. (1989). Teaching regression in a nonparametric statistics course. The American Statistician, 43(1), 35–40. https://doi.org/10.1080/00031305.1989.10475606
- Sen, P. K. (1968). Estimates of the regression coefficient based on Kendall’s tau. Journal of the American Statistical Association, 63(324), 1379–1389. https://doi.org/10.1080/01621459.1968.10480934
- Wilcox, R. R. (2021). Introduction to robust estimation and hypothesis testing (5th ed.). Academic Press.
Cytowania BibTeX
@article{dietz1989teaching, author={Dietz, E. Jacquelin}, title={{Teaching regression in a nonparametric statistics course}}, journal={The American Statistician}, year={1989}, volume={43}, number={1}, pages={35--40}, doi={10.1080/00031305.1989.10475606}}@article{sen1968estimates, author={Sen, Pranab Kumar}, title={{Estimates of the regression coefficient based on Kendall’s tau}}, journal={Journal of the American Statistical Association}, year={1968}, volume={63}, number={324}, pages={1379--1389}, doi={10.1080/01621459.1968.10480934}}@book{wilcox2021introduction, author={Wilcox, Rand R.}, title={{Introduction to robust estimation and hypothesis testing (5th ed.)}}, year={2021}, publisher={Academic Press}}