Jedna osoba, sześć miejsc na wykresie
Definicje znajdziesz w hasłach obserwacja odstająca, dźwignia i odległość Cooka. Procedurę wykrywania (także w SPSS) i reguły decyzji opisują wpisy wartości odstające: jak je wykryć i czy można usunąć obserwacje odstające. Tu przesuwamy jedną osobę po wykresie i sprawdzamy, gdzie zaczyna rządzić prostą regresji, a potem – co z tego zostaje przy n = 200 i w 1000 badań.
Przykład jest fikcyjny. Dwudziestu studentów podało, ile godzin tygodniowo poświęca na aktywność fizyczną, i wypełniło skalę samopoczucia (10–50 punktów). Parametry populacji ustawiliśmy ręcznie: aktywność średnio 5 godzin (SD = 2), samopoczucie = 20 + 1.5 × aktywność + błąd o SD = 4. W próbie średnia aktywność wyniosła 5.45 godziny (SD = 2.23), r = .63, a prosta: samopoczucie = 21.98 + 1.39 × aktywność. Ziarno 595 ustalono raz i nie zmieniano go. Dane pobierzesz jako obserwacje-wplywowe-20-osob.csv. Położenia dopisanej 21. osoby (14 i 9 godzin, odchylenia od prostej o +15, −15 i −7 punktów) też wybraliśmy ręcznie.
Rysunek 1: ta sama osoba w sześciu miejscach
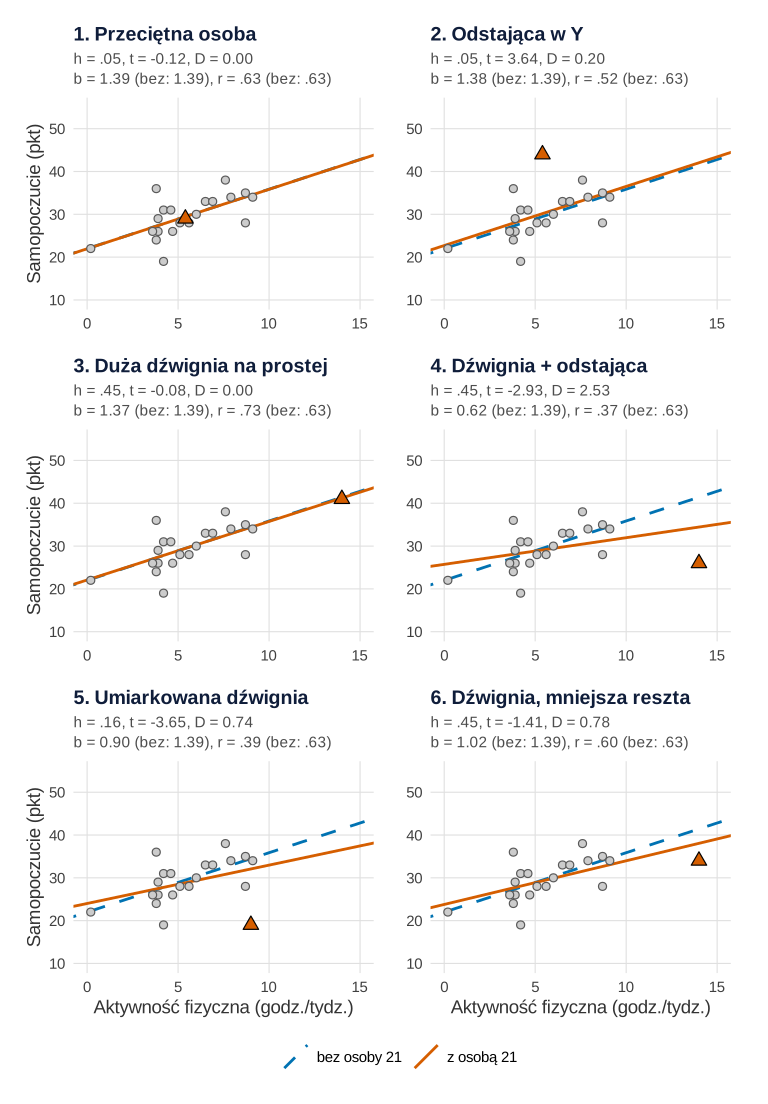
set.seed(595)).Co widać. Osoba „przeciętna” (panel 1) nie zmienia niczego. Osoba odstająca w Y (panel 2) ma największą resztę studentyzowaną (t = 3.64), ale nachylenie prawie stoi w miejscu (1.38 wobec 1.39). Ma za to wpływ na siłę związku: r spada z .63 do .52, bo dokłada dużo rozrzutu wokół prostej. Panel 3 to lustrzane odbicie: dźwignia h = .45, reszta bliska zera, nachylenie bez zmian, a r rośnie do .73. Osoba ze skrajną wartością X leżąca na prostej „przedłuża” chmurę punktów i sztucznie wzmacnia korelację. Ten sam mechanizm, tylko dla całej próby, pokazuje wpis ograniczony zakres zmiennej. Dopiero połączenie obu cech (panel 4) przestawia prostą: nachylenie spada do 0.62, r do .37, a D = 2.53. Panele 5 i 6 (mniejsza dźwignia albo mniejsza reszta) dają D około 0.75 i nachylenie 0.90 lub 1.02 – wpływ narasta stopniowo.
Czego ten wykres nie pokazuje. Każdy panel to jedna wybrana pozycja; czy granica „wpływowości” jest ostra, pokazuje rysunek 2. Nie mówi też, czy to błąd wpisania (14 zamiast 1.4), czy prawdziwy maratończyk. Galerię tych samych trzech typów na wykresach reszt znajdziesz we wpisie galeria wykresów reszt, a mechanikę kwadratów reszt – we wpisie metoda najmniejszych kwadratów w obrazkach.
Podpis do pracy (np. w aneksie):
Zdanie do Wyników:
Rysunek 2: mapa wpływu – gdzie osoba 21 przestawia prostą
Zamiast sześciu pozycji sprawdzamy wszystkie: osobę 21 stawiamy w każdym punkcie siatki (aktywność 0–16 godzin co 0.25, samopoczucie 5–60 punktów co 1, łącznie 3640 położeń).
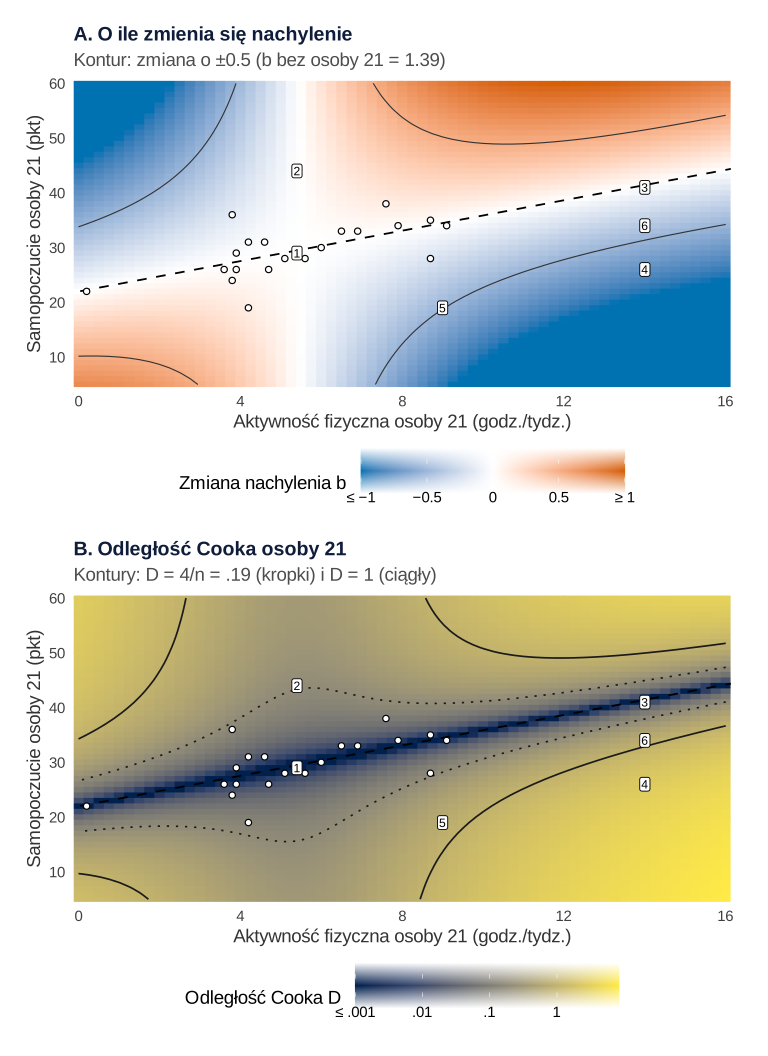
Co widać. Biały pas w panelu A biegnie wzdłuż pionu przy średniej aktywności (ok. 5.4 godziny). Osoba postawiona tam przesuwa tylko wyraz wolny, nie nachylenie. Drugi biały pas to sama prosta: osoba leżąca na niej też nie zmienia nachylenia. Wpływ rośnie w czterech „rogach”, z dala od obu pasów. Przy tym samym odchyleniu od prostej (−15 punktów) zmiana nachylenia wynosi 0.01 przy 5.4 godziny, −0.48 przy 9 godzinach i −0.75 przy 14. Przy 14 godzinach zależy liniowo od odchylenia: −0.25, −0.50, −0.75 i −0.99 przy odchyleniu −5, −10, −15 i −20 punktów. Panel B pokazuje to samo w odległości Cooka. Ciemna „rynna” wzdłuż prostej to D bliskie zera. Kontur D = 4/n (.19) obejmuje wąski pas wokół prostej, a D = 1 zaczyna się dopiero w rogach. Przy 14 godzinach i odchyleniu −15 punktów D = 2.44 (na rysunku 1 wyszło 2.53, bo tam wynik zaokrąglono do pełnego punktu).
Czego ten wykres nie pokazuje. Mapa dotyczy tylko tych 20 osób i jednej dopisanej. Gdy nietypowe są dwie osoby obok siebie, każda „chowa” drugą i diagnostyka „po jednej obserwacji” tego nie wykryje.
Podpis do pracy (np. na zajęcia lub obronę):
Zdanie do Metody (uzasadnienie diagnostyki):
Rysunek 3: dźwignia, reszta i Cook na jednym wykresie
W pracy zwykle rysuje się odpowiednik tej mapy: dźwignia na osi poziomej, reszta studentyzowana na pionowej i krzywe stałej odległości Cooka. Cook (1977) zbudował swoją miarę właśnie z reszty i informacji o wariancji reszt i wartości przewidywanych, czyli z dźwigni. Macierz, z której pochodzi dźwignia, opisują Hoaglin i Welsch (1978). Chatterjee i Hadi (1986) pokazali, że wiele proponowanych miar wpływu jest ze sobą powiązanych i że kilka z nich razem z wykresami daje pełny obraz.
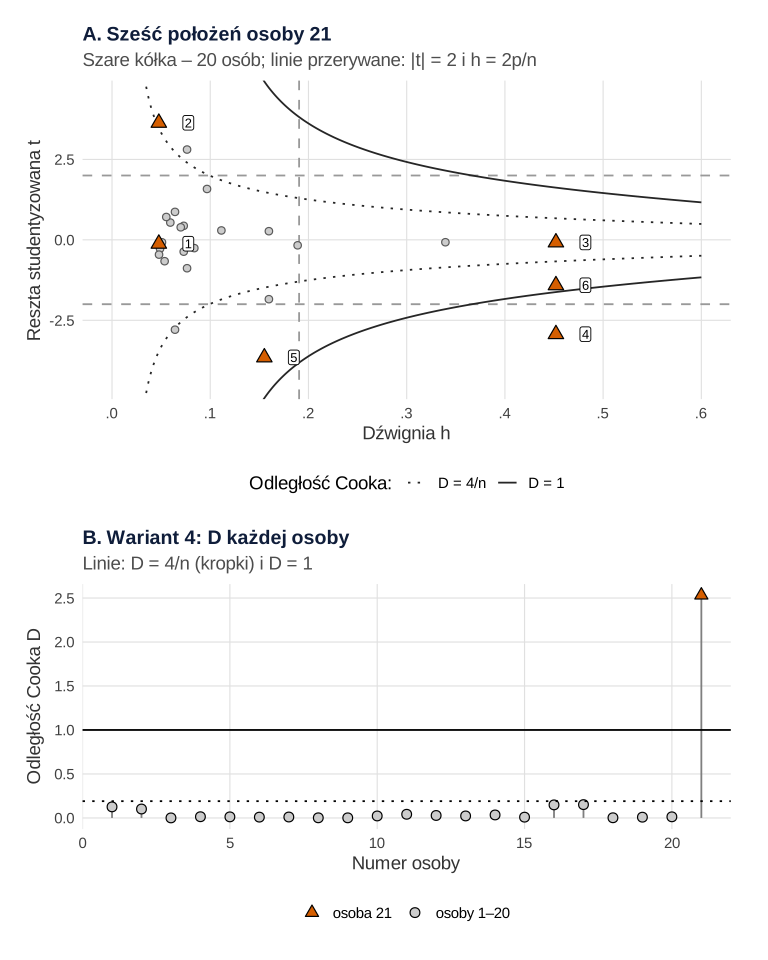
Co widać. Panel A: sześć położeń osoby 21 to sześć punktów na płaszczyźnie (h, t). Osoba 2 jest wysoko (t = 3.64), ale przy lewej krawędzi (h = .05) – leży tuż za kropkowaną krzywą D = 4/n. Osoba 3 jest daleko w prawo (h = .45), ale na zerze. Osoba 4 leży za ciągłą krzywą D = 1. Krzywe stałego D opadają w prawo: im większa dźwignia, tym mniejsza reszta wystarcza do tego samego wpływu. Panel B to typowy wydruk programu: D każdej osoby w wariancie 4. Osoba 21 ma D = 2.53, a najwyższe D wśród pozostałych to 0.15. Tylko ona przekracza 4/n.
Czego ten wykres nie pokazuje. Odległość Cooka mierzy przesunięcie wszystkich współczynników naraz, w jednostkach ich niepewności. Nie mówi, który współczynnik się zmienił ani czy zmienił się wniosek – do tego służą DFBETAS i porównanie modeli z osobą i bez niej. Progi 4/n i 1 to heurystyki, nie testy (rysunek 5). Bollen i Jackman (1985) podkreślają, że diagnostyki nie wolno stosować mechanicznie. Ważniejsze od progu jest pytanie, dlaczego obserwacja jest wpływowa. Pełny zestaw wykresów diagnostycznych w R opisuje wpis diagnostyka regresji w R.
Podpis do pracy:
Z osobą 21 i bez niej. Cook (1979) pokazał, że usunięcie jednej obserwacji może istotnie zmienić analizę: testy, reszty i oszacowania współczynników. W wariancie 4 jedna osoba zmienia wniosek. Model w obu wersjach:
| Model | n | b [95% CI] | SE | p | r | R² |
|---|---|---|---|---|---|---|
| z osobą 21 | 21 | 0.62 [−0.13, 1.38] | 0.36 | .100 | .37 | .14 |
| bez osoby 21 | 20 | 1.39 [0.55, 2.23] | 0.40 | .003 | .63 | .40 |
Zdanie do Wyników (analiza wrażliwości):
Rysunek 4: ta sama osoba przy n = 20 i n = 200
Dopisujemy tę samą osobę P (14 godzin, 26 punktów – jak w wariancie 4) do próby 20 osób i do próby 200 osób wylosowanej z tej samej populacji.
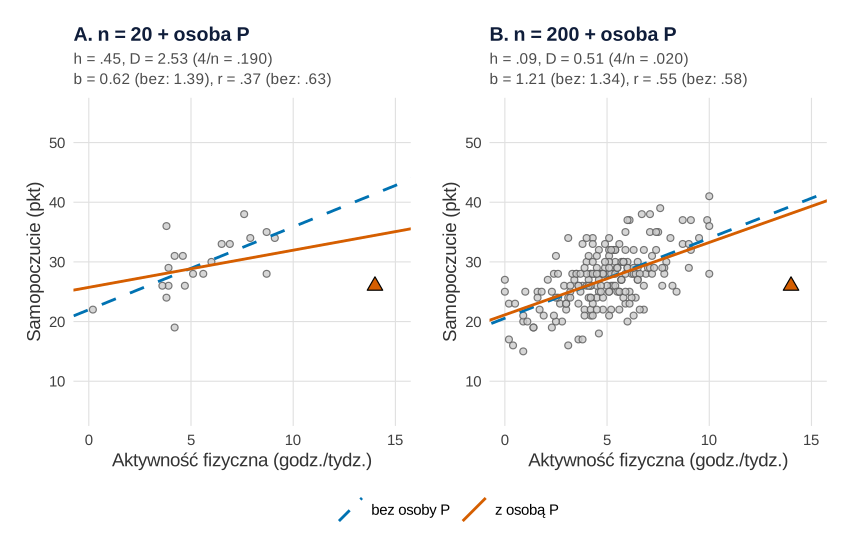
set.seed(595)).Co widać. Przy n = 20 osoba P ma dźwignię .45 i D = 2.53. Nachylenie spada z 1.39 do 0.62, r z .63 do .37, a p testu korelacji rośnie z .003 do .100. Przy n = 200 ta sama osoba ma dźwignię tylko .09. Dźwignia porównuje odległość osoby od średniej X z rozrzutem X w całej próbie, a ta suma odchyleń rośnie razem z liczbą osób. Jej reszta studentyzowana jest nawet większa (−3.26), ale D = 0.51, a nachylenie zmienia się z 1.34 na 1.21 i r z .58 na .55. Wniosek zostaje ten sam (p < .001 w obu wersjach). Uwaga na próg: 4/n wynosi .190 przy 21 osobach i .020 przy 201. Osoba P przekracza go w obu próbach (ponad 13 razy i ponad 25 razy), choć tylko w małej próbie zmienia wniosek.
Czego ten wykres nie pokazuje. To dwie pojedyncze próby. Czy wynik jest typowy, sprawdza rysunek 5. Duża próba nie chroni też przed grupą nietypowych osób – kilka podobnych osób P może przestawić prostą także przy n = 200.
Podpis do pracy:
Zdanie do Ograniczeń:
Rysunek 5: 1000 badań – wpływ i fałszywe alarmy
Symulacja: dla n = 20, 50 i 200 losujemy po 1000 prób z tej samej populacji. W każdej (A) dopisujemy osobę P i patrzymy, co się zmienia, oraz (B) liczymy w danych bez osoby P, ile osób przekracza popularne progi. W danych B nie ma żadnej nietypowej osoby – każdy alarm jest fałszywy. Błąd Monte Carlo odsetka wynosi najwyżej 1.6 punktu procentowego (przy 54%).
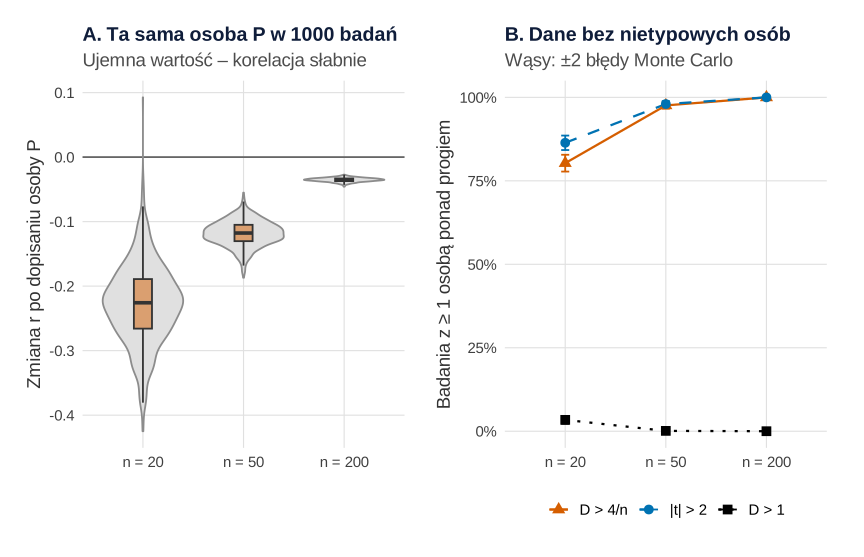
set.seed(595)).Co widać. Panel A: przy n = 20 osoba P obniża r o medianę .23, przy 50 – o .12, przy 200 – o .04. Mediana jej D to 2.92, 1.82 i 0.65. Przy n = 20 wniosek o istotności korelacji zmienił się w 54.3% badań, przy 50 – w 3.0%, przy 200 – w żadnym. Przy n = 50 osoba P miała D > 1 w 92.0% badań, a wniosek zmieniała rzadko: D mierzy przesunięcie oszacowań, nie zmianę decyzji o istotności. Panel B: w czystych danych próg 4/n wskazał co najmniej jedną „wpływową” osobę w 80.3% badań przy n = 20, w 97.6% przy 50 i we wszystkich przy 200. Przy 200 osobach to średnio 10.2 osoby na badanie (5.1% próby). Reszta |t| > 2 zachowuje się podobnie. Próg D > 1 dał alarm w 3.4% badań przy n = 20 i prawie nigdy przy większych próbach.
Czego ten wykres nie pokazuje. Próg 4/n nie jest testem i z definicji „znajduje” kilka procent osób w każdych danych. Usuwając wszystkie takie osoby, usuwasz zwykłych ludzi. Aguinis i in. (2013) pokazali, że różne sposoby definiowania i usuwania obserwacji odstających zmieniają wnioski merytoryczne. Symulacja zakłada też model liniowy i normalny rozkład błędów.
Podpis do pracy:
Zdanie do Metody (reguła ustalona przed analizą):
Co raportować w pracy
- Zapisz regułę przed analizą. Który wskaźnik, jaki próg i co robisz z obserwacją, która go przekroczy. Najlepiej w planie analizy (zob. plan analizy statystycznej i prerejestracja).
- Najpierw sprawdź dane źródłowe. Błąd wpisania poprawiasz, a nie usuwasz. Prawdziwa, nietypowa osoba to też wynik badania.
- Pokaż model z osobą i bez niej. Tabela jak przy rysunku 3 w aneksie i jedno zdanie w Wynikach. To jest analiza wrażliwości.
- Zamiast usuwać, rozważ model mniej wrażliwy na pojedyncze osoby – regresję odporną albo korelację Spearmana jako dodatkową analizę.
- Narysuj dane. Wykres rozrzutu z zaznaczoną osobą wyjaśnia więcej niż tabela miar (zob. zawsze narysuj dane i wykresy w pracy dyplomowej).
Zdanie do pracy dyplomowej (rozdział Metoda):
Jak przedstawić gotowy model na wykresie, pokazuje wpis wynik regresji na wykresie, a pojedyncze osoby w macierzy korelacji – korelacje na wykresie.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i funkcje pomocnicze, z których korzystają następne. Każdy przepis kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy przepis, który losuje (1, 4 i 5), zaczyna się od własnego set.seed(595), więc skopiowany osobno da te same liczby co na stronie. Ziarno 595 ustalono raz i nie zmieniano go. Ręcznie ustalono: parametry populacji (aktywność M = 5, SD = 2; samopoczucie = 20 + 1.5 × aktywność + błąd o SD = 4), liczebności 20, 50 i 200, sześć położeń osoby 21 (14 i 9 godzin; odchylenia +15, −15 i −7 punktów od prostej), osobę P (14 godzin, 26 punktów), zakres siatki mapy wpływu i 1000 powtórzeń symulacji. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w kilka sekund.
1. Dane i sześć położeń osoby 21: Rysunek 1
R
# Rysunek 1. Jedna dopisana osoba w sześciu miejscach wykresu: prosta z nią i bez niej (dane fikcyjne)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (niebieski i cynober rozróżnialne także przy deuteranopii) i prosty motyw
kol <- c(bez = "#0072B2", z = "#D55E00", dane = "grey55")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
bz <- function(x, d = 2) sub("^(-?)0\\.", "\\1.", sprintf(paste0("%.", d, "f"), x))   # .03 zamiast 0.03

# 20 osób: aktywność fizyczna (godziny tygodniowo) i wynik skali samopoczucia (10–50 pkt).
# Parametry populacji ustalone ręcznie: aktywność M = 5, SD = 2; samopoczucie = 20 + 1.5·aktywność + błąd (SD 4)
set.seed(595)                                    # ziarno ustalone raz, bez dobierania pod wynik
n <- 20
aktywnosc <- round(pmax(0, rnorm(n, 5, 2)), 1)
samopoczucie <- round(20 + 1.5 * aktywnosc + rnorm(n, 0, 4))
baza <- data.frame(osoba = 1:n, aktywnosc, samopoczucie)
write.csv(baza, "obserwacje-wplywowe-20-osob.csv", row.names = FALSE)
m0 <- lm(samopoczucie ~ aktywnosc, data = baza)
round(c(M_x = mean(aktywnosc), SD_x = sd(aktywnosc), r = cor(aktywnosc, samopoczucie),
        b0 = coef(m0)[[1]], b = coef(m0)[[2]]), 2)

# Dopisana 21. osoba w sześciu miejscach; „na prostej” = na prostej z 20 osób, odchylenia ustalone ręcznie
prosta <- function(x) unname(predict(m0, data.frame(aktywnosc = x)))
xm <- round(mean(aktywnosc), 1)
miejsca <- data.frame(
  wariant = c("1. Przeciętna osoba", "2. Odstająca w Y", "3. Duża dźwignia na prostej",
              "4. Dźwignia + odstająca", "5. Umiarkowana dźwignia", "6. Dźwignia, mniejsza reszta"),
  aktywnosc = c(xm, xm, 14, 14, 9, 14),
  odchylenie = c(0, 15, 0, -15, -15, -7))
miejsca$samopoczucie <- round(prosta(miejsca$aktywnosc) + miejsca$odchylenie)

# Dla każdego wariantu: dźwignia h, reszta studentyzowana t, odległość Cooka D i nachylenie z osobą 21
diag21 <- do.call(rbind, lapply(seq_len(nrow(miejsca)), function(i) {
  d <- rbind(baza, data.frame(osoba = 21, miejsca[i, c("aktywnosc", "samopoczucie")]))
  m <- lm(samopoczucie ~ aktywnosc, data = d)
  data.frame(wariant = miejsca$wariant[i], x = miejsca$aktywnosc[i], y = miejsca$samopoczucie[i],
             h = hatvalues(m)[[21]], t = rstudent(m)[[21]], D = cooks.distance(m)[[21]],
             b0_z = coef(m)[[1]], b_z = coef(m)[[2]], r_z = cor(d$aktywnosc, d$samopoczucie))
}))
print(cbind(diag21[1], round(diag21[-1], 3)), row.names = FALSE)   # bez osoby 21: b i r z wiersza wyżej
round(c(prog_dzwigni_2p_n = 2 * 2 / 21, prog_Cooka_4_n = 4 / 21), 3)

# Sześć paneli: szare kółka – 20 osób, trójkąt – osoba 21; linia przerywana – prosta bez niej, ciągła – z nią
panel <- function(i) {
  w <- diag21[i, ]
  linie <- data.frame(model = factor(c("bez osoby 21", "z osobą 21"), c("bez osoby 21", "z osobą 21")),
                      b0 = c(coef(m0)[[1]], w$b0_z), b = c(coef(m0)[[2]], w$b_z))
  ggplot(baza, aes(aktywnosc, samopoczucie)) +
    geom_abline(data = linie, aes(intercept = b0, slope = b, colour = model, linetype = model), linewidth = 1) +
    geom_point(shape = 21, size = 2.4, fill = "grey80", colour = "grey35") +
    geom_point(data = w, aes(x, y), shape = 24, size = 3.6, fill = kol[["z"]], colour = "black") +
    scale_colour_manual(values = c("bez osoby 21" = kol[["bez"]], "z osobą 21" = kol[["z"]]), name = NULL) +
    scale_linetype_manual(values = c("bez osoby 21" = "dashed", "z osobą 21" = "solid"), name = NULL) +
    coord_cartesian(xlim = c(0, 15), ylim = c(10, 55)) +
    labs(x = if (i >= 5) "Aktywność fizyczna (godz./tydz.)" else NULL,
         y = if (i %% 2 == 1) "Samopoczucie (pkt)" else NULL, title = w$wariant,
         subtitle = sprintf("h = %s, t = %.2f, D = %.2f\nb = %.2f (bez: %.2f), r = %s (bez: %s)", bz(w$h), w$t, w$D,
                           w$b_z, coef(m0)[[2]], bz(w$r_z), bz(cor(aktywnosc, samopoczucie)))) +
    motyw + theme(plot.subtitle = element_text(size = rel(0.82), lineheight = 1.1))
}
p1 <- wrap_plots(lapply(1:6, panel), ncol = 2) + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p1   # zapis: ggsave("obserwacje-wplywowe-szesc-miejsc.svg", p1, width = 8, height = 11)
Wynik w R
  M_x  SD_x     r    b0     b
 5.45  2.23  0.63 21.98  1.39
                      wariant    x  y     h      t     D   b0_z   b_z   r_z
          1. Przeciętna osoba  5.4 29 0.048 -0.120 0.000 21.957 1.389 0.632
             2. Odstająca w Y  5.4 44 0.048  3.639 0.201 22.713 1.381 0.525
  3. Duża dźwignia na prostej 14.0 41 0.452 -0.080 0.003 22.085 1.368 0.727
      4. Dźwignia + odstająca 14.0 26 0.452 -2.932 2.532 25.733 0.623 0.369
      5. Umiarkowana dźwignia  9.0 19 0.155 -3.654 0.743 24.009 0.897 0.390
 6. Dźwignia, mniejsza reszta 14.0 34 0.452 -1.411 0.780 23.787 1.020 0.600
prog_dzwigni_2p_n    prog_Cooka_4_n
             0.19              0.19
2. Mapa wpływu: Rysunek 2
R
# Rysunek 2. Mapa wpływu: jak zmienia się nachylenie i odległość Cooka, gdy osobę 21 postawić w dowolnym
# miejscu wykresu (kontynuacja: baza, m0, miejsca, kol, motyw z bloku 1; bez losowania)
library(ggplot2)
library(patchwork)

# Siatka możliwych położeń osoby 21: aktywność 0–16 godzin co 0.25, samopoczucie 5–60 punktów co 1
siatka <- expand.grid(x = seq(0, 16, by = 0.25), y = seq(5, 60, by = 1))
wplyw <- function(x0, y0) {
  X <- cbind(1, c(baza$aktywnosc, x0)); y <- c(baza$samopoczucie, y0)
  fit <- lm.fit(X, y)
  h <- sum(solve(crossprod(X), X[21, ]) * X[21, ])           # dźwignia osoby 21
  s2 <- sum(fit$residuals^2) / (21 - 2)
  c(db = fit$coefficients[[2]] - coef(m0)[[2]], D = fit$residuals[[21]]^2 / (2 * s2) * h / (1 - h)^2)
}
siatka <- cbind(siatka, t(mapply(wplyw, siatka$x, siatka$y)))
c(liczba_polozen = nrow(siatka))
# Przekroje mapy: to samo odchylenie od prostej (−15 pkt) przy rosnącej aktywności
# oraz rosnące odchylenie przy tej samej skrajnej aktywności (14 godzin)
x_do <- c(5.4, 7, 9, 11, 14, 16)
round(rbind(x = x_do, sapply(x_do, function(x0) wplyw(x0, prosta(x0) - 15))), 3)
odch <- c(0, -5, -10, -15, -20)
round(rbind(odchylenie = odch, sapply(odch, function(o) wplyw(14, prosta(14) + o))), 3)

etykiety <- data.frame(x = miejsca$aktywnosc, y = miejsca$samopoczucie, nr = 1:6)
warstwy <- list(
  geom_abline(intercept = coef(m0)[[1]], slope = coef(m0)[[2]], colour = "black", linetype = "dashed"),
  geom_point(data = baza, aes(aktywnosc, samopoczucie), inherit.aes = FALSE, shape = 21, size = 1.8,
             fill = "white", colour = "black"),
  geom_label(data = etykiety, aes(x, y, label = nr), inherit.aes = FALSE, size = 3.2, label.padding = unit(0.12, "lines")),
  scale_x_continuous(expand = c(0, 0)), scale_y_continuous(expand = c(0, 0)),
  labs(x = "Aktywność fizyczna osoby 21 (godz./tydz.)", y = "Samopoczucie osoby 21 (pkt)"), motyw)

# A: zmiana nachylenia (rozbieżna skala: niebieski – spadek, cynober – wzrost, biały – bez zmiany)
pa <- ggplot(siatka, aes(x, y)) + geom_raster(aes(fill = pmax(pmin(db, 1), -1))) +
  geom_contour(aes(z = db), breaks = c(-0.5, 0.5), colour = "grey20", linewidth = 0.4) +
  scale_fill_gradient2(low = kol[["bez"]], mid = "white", high = kol[["z"]], midpoint = 0, limits = c(-1, 1),
                       breaks = c(-1, -0.5, 0, 0.5, 1), labels = c("≤ −1", "−0.5", "0", "0.5", "≥ 1"),
                       name = "Zmiana nachylenia b") +
  warstwy + labs(title = "A. O ile zmienia się nachylenie", subtitle = "Kontur: zmiana o ±0.5 (b bez osoby 21 = 1.39)") +
  theme(legend.key.width = unit(1.4, "cm"))

# B: odległość Cooka osoby 21 (skala logarytmiczna), kontury D = 4/n i D = 1
pb <- ggplot(siatka, aes(x, y)) + geom_raster(aes(fill = pmax(D, 0.001))) +
  geom_contour(aes(z = D), breaks = 4 / 21, colour = "grey10", linewidth = 0.6, linetype = "dotted") +
  geom_contour(aes(z = D), breaks = 1, colour = "grey10", linewidth = 0.6) +
  scale_fill_viridis_c(trans = "log10", option = "cividis", breaks = c(0.001, 0.01, 0.1, 1, 10),
                       labels = c("≤ .001", ".01", ".1", "1", "10"), name = "Odległość Cooka D") +
  warstwy + labs(title = "B. Odległość Cooka osoby 21", subtitle = "Kontury: D = 4/n = .19 (kropki) i D = 1 (ciągły)") +
  theme(legend.key.width = unit(1.4, "cm"))
p2 <- pa / pb
p2   # zapis: ggsave("obserwacje-wplywowe-mapa-wplywu.svg", p2, width = 8, height = 11)
Wynik w R
liczba_polozen
          3640
    [,1]   [,2]   [,3]   [,4]   [,5]   [,6]
x  5.400  7.000  9.000 11.000 14.000 16.000
db 0.008 -0.229 -0.477 -0.641 -0.745 -0.752
D  0.209  0.311  0.716  1.339  2.438  3.153
           [,1]   [,2]    [,3]    [,4]    [,5]
odchylenie    0 -5.000 -10.000 -15.000 -20.000
db            0 -0.248  -0.497  -0.745  -0.993
D             0  0.374   1.310   2.438   3.489
3. Dźwignia, reszta, Cook i model z osobą 21 i bez niej: Rysunek 3
R
# Rysunek 3. Dźwignia, reszta studentyzowana i odległość Cooka na jednym wykresie oraz analiza z osobą 21
# i bez niej (kontynuacja: baza, m0, miejsca, diag21, kol, motyw, bz z bloku 1; bez losowania)
library(ggplot2)
library(patchwork)

# Kontury odległości Cooka na płaszczyźnie (dźwignia h, reszta studentyzowana t) dla n = 21 i p = 2:
# D = r²/p · h/(1 − h), gdzie r – reszta standaryzowana; t² = r²(n − p − 1)/(n − p − r²)
n1 <- 21; p <- 2
kontur <- function(D, h) { r2 <- D * p * (1 - h) / h; sqrt(r2 * (n1 - p - 1) / (n1 - p - r2)) }
hh <- seq(0.02, 0.6, by = 0.002)
kontury <- do.call(rbind, lapply(c(4 / n1, 1), function(D) {
  t <- suppressWarnings(kontur(D, hh)); ok <- is.finite(t)
  rbind(data.frame(D = D, h = hh[ok], t = t[ok], znak = "+"), data.frame(D = D, h = hh[ok], t = -t[ok], znak = "−"))
}))
kontury$prog <- factor(ifelse(kontury$D == 1, "D = 1", "D = 4/n"), c("D = 4/n", "D = 1"))

# 20 osób z modelu z „przeciętną” osobą 21 (wariant 1) jako tło
d1 <- rbind(baza, data.frame(osoba = 21, miejsca[1, c("aktywnosc", "samopoczucie")]))
m1 <- lm(samopoczucie ~ aktywnosc, data = d1)
tlo <- data.frame(h = hatvalues(m1)[1:20], t = rstudent(m1)[1:20])
pa <- ggplot(diag21, aes(h, t)) +
  geom_hline(yintercept = c(-2, 2), colour = "grey60", linetype = "dashed") +
  geom_vline(xintercept = 2 * p / n1, colour = "grey60", linetype = "dashed") +
  geom_path(data = kontury, aes(group = interaction(D, znak), linetype = prog), colour = "grey15") +
  geom_point(data = tlo, shape = 21, size = 2.2, fill = "grey80", colour = "grey35") +
  geom_point(shape = 24, size = 3.6, fill = kol[["z"]], colour = "black") +
  geom_label(aes(label = substr(wariant, 1, 1)), nudge_x = 0.03, size = 3.4, label.padding = unit(0.12, "lines")) +
  scale_linetype_manual(values = c("D = 4/n" = "dotted", "D = 1" = "solid"), name = "Odległość Cooka:") +
  scale_x_continuous(limits = c(0, 0.6), breaks = seq(0, 0.6, 0.1), labels = function(x) bz(x, 1)) +
  coord_cartesian(ylim = c(-4.5, 4.5)) +
  labs(x = "Dźwignia h", y = "Reszta studentyzowana t", title = "A. Sześć położeń osoby 21",
       subtitle = "Szare kółka – 20 osób; linie przerywane: |t| = 2 i h = 2p/n") + motyw

# B: odległość Cooka wszystkich 21 osób w wariancie 4 (dźwignia + odstająca)
d4 <- rbind(baza, data.frame(osoba = 21, miejsca[4, c("aktywnosc", "samopoczucie")]))
m4 <- lm(samopoczucie ~ aktywnosc, data = d4)
cook4 <- data.frame(osoba = 1:21, D = cooks.distance(m4), dopisana = c(rep("osoby 1–20", 20), "osoba 21"))
round(c(max_D_osoby_1_20 = max(cook4$D[1:20]), ile_D_ponad_4_n = sum(cook4$D > 4 / 21), D_osoby_21 = cook4$D[21]), 3)
pb <- ggplot(cook4, aes(osoba, D)) +
  geom_segment(aes(xend = osoba, yend = 0), colour = "grey50") +
  geom_point(aes(shape = dopisana, fill = dopisana), size = 3) +
  geom_hline(yintercept = 4 / 21, linetype = "dotted") + geom_hline(yintercept = 1) +
  scale_shape_manual(values = c("osoby 1–20" = 21, "osoba 21" = 24), name = NULL) +
  scale_fill_manual(values = c("osoby 1–20" = "grey80", "osoba 21" = kol[["z"]]), name = NULL) +
  labs(x = "Numer osoby", y = "Odległość Cooka D", title = "B. Wariant 4: D każdej osoby",
       subtitle = "Linie: D = 4/n (kropki) i D = 1") + motyw

# Analiza wrażliwości dla wariantu 4: ten sam model z osobą 21 i bez niej
z_bez <- function(m, d) {
  ci <- confint(m)[2, ]; ct <- cor.test(d$aktywnosc, d$samopoczucie)
  c(n = nrow(d), b = coef(m)[[2]], SE = coef(summary(m))[2, 2], CI_dolna = ci[[1]], CI_gorna = ci[[2]],
    p_b = coef(summary(m))[2, 4], r = unname(ct$estimate), R2 = summary(m)$r.squared)
}
round(rbind(z_osoba_21 = z_bez(m4, d4), bez_osoby_21 = z_bez(m0, baza)), 3)

p3 <- pa + pb + plot_layout(ncol = 1, heights = c(1.3, 1))
p3   # zapis: ggsave("obserwacje-wplywowe-dzwignia-reszta-cook.svg", p3, width = 8, height = 10)
Wynik w R
max_D_osoby_1_20  ile_D_ponad_4_n       D_osoby_21
           0.151            1.000            2.532
              n     b    SE CI_dolna CI_gorna   p_b     r    R2
z_osoba_21   21 0.623 0.360   -0.130    1.376 0.100 0.369 0.136
bez_osoby_21 20 1.389 0.401    0.546    2.231 0.003 0.632 0.400
4. Ta sama osoba przy n = 20 i n = 200: Rysunek 4
R
# Rysunek 4. Ta sama dopisana osoba przy n = 20 i n = 200 (kontynuacja: baza, kol, motyw, bz z bloku 1)
library(ggplot2)
library(patchwork)

# Osoba P: 14 godzin aktywności i 26 punktów samopoczucia (jak wariant 4 z rysunku 1)
P <- data.frame(aktywnosc = 14, samopoczucie = 26)
# Większa próba z tej samej populacji (parametry jak w bloku 1)
set.seed(595)
n2 <- 200
x200 <- round(pmax(0, rnorm(n2, 5, 2)), 1)
duza <- data.frame(aktywnosc = x200, samopoczucie = round(20 + 1.5 * x200 + rnorm(n2, 0, 4)))

porownaj <- function(d) {
  dz <- rbind(d, P); m <- lm(samopoczucie ~ aktywnosc, data = d); mz <- lm(samopoczucie ~ aktywnosc, data = dz)
  k <- nrow(dz)
  c(n_z_P = k, h_P = hatvalues(mz)[[k]], t_P = rstudent(mz)[[k]], D_P = cooks.distance(mz)[[k]], prog_4_n = 4 / k,
    b_bez = coef(m)[[2]], b_z = coef(mz)[[2]], r_bez = cor(d)[1, 2], r_z = cor(dz)[1, 2],
    p_bez = cor.test(d$aktywnosc, d$samopoczucie)$p.value, p_z = cor.test(dz$aktywnosc, dz$samopoczucie)$p.value)
}
wyn4 <- rbind(n_20 = porownaj(baza[, c("aktywnosc", "samopoczucie")]), n_200 = porownaj(duza))
round(wyn4[, 1:9], 3)
p_tab <- sapply(c("p_bez", "p_z"), function(k) format.pval(wyn4[, k], digits = 3, eps = .001))
rownames(p_tab) <- rownames(wyn4)
noquote(p_tab)                                   # p testu korelacji bez osoby P i z nią

panel4 <- function(d, w, tytul) {
  dz <- rbind(d, P)
  linie <- data.frame(model = factor(c("bez osoby P", "z osobą P"), c("bez osoby P", "z osobą P")),
                      b0 = c(coef(lm(samopoczucie ~ aktywnosc, d))[[1]], coef(lm(samopoczucie ~ aktywnosc, dz))[[1]]),
                      b = c(w[["b_bez"]], w[["b_z"]]))
  ggplot(d, aes(aktywnosc, samopoczucie)) +
    geom_point(shape = 21, size = 2, fill = "grey80", colour = "grey35", alpha = 0.8) +
    geom_abline(data = linie, aes(intercept = b0, slope = b, colour = model, linetype = model), linewidth = 1) +
    geom_point(data = P, shape = 24, size = 3.6, fill = kol[["z"]], colour = "black") +
    scale_colour_manual(values = c("bez osoby P" = kol[["bez"]], "z osobą P" = kol[["z"]]), name = NULL) +
    scale_linetype_manual(values = c("bez osoby P" = "dashed", "z osobą P" = "solid"), name = NULL) +
    coord_cartesian(xlim = c(0, 15), ylim = c(5, 55)) +
    labs(x = "Aktywność fizyczna (godz./tydz.)", y = "Samopoczucie (pkt)", title = tytul,
         subtitle = sprintf("h = %s, D = %.2f (4/n = %s)\nb = %.2f (bez: %.2f), r = %s (bez: %s)",
                            bz(w[["h_P"]]), w[["D_P"]], bz(w[["prog_4_n"]], 3), w[["b_z"]], w[["b_bez"]],
                            bz(w[["r_z"]]), bz(w[["r_bez"]]))) +
    motyw + theme(plot.subtitle = element_text(size = rel(0.82), lineheight = 1.1))
}
p4 <- panel4(baza[, c("aktywnosc", "samopoczucie")], wyn4["n_20", ], "A. n = 20 + osoba P") +
  panel4(duza, wyn4["n_200", ], "B. n = 200 + osoba P") + plot_layout(guides = "collect") &
  theme(legend.position = "bottom")
p4   # zapis: ggsave("obserwacje-wplywowe-n20-n200.svg", p4, width = 9, height = 5.6)
Wynik w R
      n_z_P   h_P    t_P   D_P prog_4_n b_bez   b_z r_bez   r_z
n_20     21 0.452 -2.932 2.532     0.19 1.389 0.623 0.632 0.369
n_200   201 0.091 -3.259 0.508     0.02 1.341 1.214 0.584 0.553
      p_bez   p_z
n_20  0.00277 0.0996
n_200 < 0.001 <0.001
5. 1000 badań: Rysunek 5
R
# Rysunek 5. 1000 badań: wpływ tej samej osoby P przy różnych n i progi Cooka w danych bez żadnej
# nietypowej osoby (kontynuacja: P, kol, motyw, bz z bloków 1 i 4)
library(ggplot2)
library(patchwork)

set.seed(595)
R <- 1000                                         # liczba badań dla każdego n
ns <- c(20, 50, 200)
jedno_badanie <- function(n) {
  x <- round(pmax(0, rnorm(n, 5, 2)), 1)
  d <- data.frame(aktywnosc = x, samopoczucie = round(20 + 1.5 * x + rnorm(n, 0, 4)))
  m <- lm(samopoczucie ~ aktywnosc, data = d)
  D <- cooks.distance(m); t <- rstudent(m)
  dz <- rbind(d, P); mz <- lm(samopoczucie ~ aktywnosc, data = dz)
  c(n = n, db = coef(mz)[[2]] - coef(m)[[2]], dr = cor(dz)[1, 2] - cor(d)[1, 2],
    D_P = cooks.distance(mz)[[n + 1]],
    zmiana_wniosku = (cor.test(d$aktywnosc, d$samopoczucie)$p.value < .05) !=
      (cor.test(dz$aktywnosc, dz$samopoczucie)$p.value < .05),
    # dane bez osoby P – czyli bez żadnej nietypowej osoby
    ile_D_4n = sum(D > 4 / n), ile_D_1 = sum(D > 1), ile_t_2 = sum(abs(t) > 2))
}
sym <- as.data.frame(do.call(rbind, lapply(ns, function(n) t(replicate(R, jedno_badanie(n))))))

# A. Wpływ osoby P: mediana zmiany nachylenia i r, mediana D osoby P, odsetek badań ze zmianą wniosku (p < .05)
podsum <- t(sapply(split(sym, sym$n), function(s) c(
  mediana_db = median(s$db), mediana_dr = median(s$dr), mediana_D_P = median(s$D_P),
  odsetek_D_P_ponad_1 = mean(s$D_P > 1), odsetek_zmiana_wniosku = mean(s$zmiana_wniosku))))
round(podsum, 3)

# B. Dane bez nietypowych osób: odsetek osób i odsetek badań z co najmniej jedną osobą ponad progiem
progi <- do.call(rbind, lapply(split(sym, sym$n), function(s) data.frame(
  n = s$n[1], kryterium = c("D > 4/n", "|t| > 2", "D > 1"),
  odsetek_osob = c(mean(s$ile_D_4n), mean(s$ile_t_2), mean(s$ile_D_1)) / s$n[1],
  odsetek_badan = c(mean(s$ile_D_4n > 0), mean(s$ile_t_2 > 0), mean(s$ile_D_1 > 0)))))
progi$blad_MC_badan <- sqrt(progi$odsetek_badan * (1 - progi$odsetek_badan) / R)   # błąd Monte Carlo odsetka
progi$sr_liczba_osob <- progi$odsetek_osob * progi$n
print(cbind(progi[1:2], round(progi[-(1:2)], 3)), row.names = FALSE)

sym$n_et <- factor(paste("n =", sym$n), paste("n =", ns))
pa <- ggplot(sym, aes(n_et, dr)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_violin(fill = "grey88", colour = "grey55", scale = "width", width = 0.8) +
  geom_boxplot(width = 0.18, outlier.shape = NA, fill = kol[["z"]], alpha = 0.5) +
  labs(x = NULL, y = "Zmiana r po dopisaniu osoby P", title = "A. Ta sama osoba P w 1000 badań",
       subtitle = "Ujemna wartość – korelacja słabnie") + motyw

progi$n_et <- factor(paste("n =", progi$n), paste("n =", ns))
progi$kryterium <- factor(progi$kryterium, c("D > 4/n", "|t| > 2", "D > 1"))
pb <- ggplot(progi, aes(n_et, odsetek_badan, group = kryterium)) +
  geom_line(aes(linetype = kryterium, colour = kryterium), linewidth = 0.8) +
  geom_errorbar(aes(ymin = odsetek_badan - 2 * blad_MC_badan, ymax = odsetek_badan + 2 * blad_MC_badan,
                    colour = kryterium), width = 0.08) +
  geom_point(aes(shape = kryterium, colour = kryterium), size = 3) +
  scale_colour_manual(values = c("D > 4/n" = kol[["z"]], "|t| > 2" = kol[["bez"]], "D > 1" = "black"), name = NULL) +
  scale_shape_manual(values = c("D > 4/n" = 17, "|t| > 2" = 16, "D > 1" = 15), name = NULL) +
  scale_linetype_manual(values = c("D > 4/n" = "solid", "|t| > 2" = "dashed", "D > 1" = "dotted"), name = NULL) +
  scale_y_continuous(limits = c(0, 1), labels = function(x) paste0(round(100 * x), "%")) +
  labs(x = NULL, y = "Badania z ≥ 1 osobą ponad progiem", title = "B. Dane bez nietypowych osób",
       subtitle = "Wąsy: ±2 błędy Monte Carlo") + motyw
p5 <- pa + pb
p5   # zapis: ggsave("obserwacje-wplywowe-1000-badan.svg", p5, width = 9, height = 5.6)
Wynik w R
    mediana_db mediana_dr mediana_D_P odsetek_D_P_ponad_1
20      -0.840     -0.226       2.918               0.931
50      -0.480     -0.118       1.821               0.920
200     -0.155     -0.035       0.649               0.016
    odsetek_zmiana_wniosku
20                   0.543
50                   0.030
200                  0.000
   n kryterium odsetek_osob odsetek_badan blad_MC_badan sr_liczba_osob
  20   D > 4/n        0.064         0.803         0.013          1.276
  20   |t| > 2        0.061         0.864         0.011          1.226
  20     D > 1        0.002         0.034         0.006          0.034
  50   D > 4/n        0.055         0.976         0.005          2.753
  50   |t| > 2        0.051         0.980         0.004          2.537
  50     D > 1        0.000         0.001         0.001          0.001
 200   D > 4/n        0.051         1.000         0.000         10.193
 200   |t| > 2        0.047         1.000         0.000          9.369
 200     D > 1        0.000         0.000         0.000          0.000
6. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (bez osoby / z osobą)" = c("#0072B2", "#D55E00"),
             "cynober – jasnoszary (osoba 21 / pozostałe)" = c("#D55E00", "#CCCCCC"),
             "niebieski – biały (spadek b / bez zmiany)" = c("#0072B2", "#FFFFFF"),
             "cynober – biały (wzrost b / bez zmiany)" = c("#D55E00", "#FFFFFF"),
             "cividis: małe D – duże D" = viridisLite::cividis(2),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                            widzenie_typowe deuteranopia
niebieski – cynober (bez osoby / z osobą)             114.6        108.3
cynober – jasnoszary (osoba 21 / pozostałe)            81.6         67.1
niebieski – biały (spadek b / bez zmiany)              68.1         71.8
cynober – biały (wzrost b / bez zmiany)                89.3         75.4
cividis: małe D – duże D                              135.2        134.0
czerwony – zielony (do unikania)                      121.7         21.1
                                            protanopia
niebieski – cynober (bez osoby / z osobą)         91.9
cynober – jasnoszary (osoba 21 / pozostałe)       63.9
niebieski – biały (spadek b / bez zmiany)         63.4
cynober – biały (wzrost b / bez zmiany)           75.1
cividis: małe D – duże D                         136.7
czerwony – zielony (do unikania)                  31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Modele liniowe, dźwignia, reszty studentyzowane, odległość Cooka, test korelacji i losowania – pakiet stats. Rysunki wykonano w pakiecie ggplot2 (skala cividis z pakietu viridisLite), panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- viridisLite (wersja 0.4.3): Garnier, S., Ross, N., Rudis, R., Camargo, P. A., Sciaini, M., & Scherer, C. (2026). viridis(Lite): Colorblind-friendly color maps for R [Computer software]. https://doi.org/10.5281/zenodo.4678326
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Szukanie wpływu tylko na wykresie reszt. Osoba o dużej dźwigni przyciąga prostą i ma małą zwykłą resztę (rysunki 1 i 3).
- „Odstająca = wpływowa”. Osoba odstająca w Y przy średnim X prawie nie zmienia nachylenia, choć obniża r (rysunek 1, panel 2).
- Usuwanie wszystkich osób z D > 4/n. W danych bez żadnej nietypowej osoby próg wskazuje średnio 5–6% próby (rysunek 5).
- Ten sam niepokój przy n = 20 i n = 200. Jedna osoba P zmieniła wniosek w 54% małych badań i w żadnym dużym (rysunek 5).
- Raport tylko „po czyszczeniu”. Bez wersji z obserwacją czytelnik nie wie, że wniosek wisi na jednej osobie (tabela przy rysunku 3).
Najczęstsze pytania
Czym różni się obserwacja odstająca od obserwacji wpływowej?
Odstająca leży daleko od prostej regresji (duża reszta). Wpływowa zmienia oszacowania, gdy ją usunąć. Odstająca przy średniej wartości X prawie nie zmienia nachylenia: w naszym przykładzie reszta studentyzowana wyniosła 3.64, a nachylenie zmieniło się z 1.39 na 1.38. Wpływ pojawia się dopiero wtedy, gdy duża reszta łączy się z dużą dźwignią.
Czy punkt o dużej dźwigni zawsze jest groźny?
Nie. Osoba ze skrajną wartością X leżąca na przedłużeniu prostej nie zmienia nachylenia (w przykładzie h = .45, D = 0.00). Może jednak zawyżyć korelację: r wzrosło z .63 do .73, bo osoba „przedłużyła” chmurę punktów. Warto więc patrzeć na dźwignię także wtedy, gdy odległość Cooka jest mała.
Jaki próg odległości Cooka przyjąć: 4/n czy 1?
To heurystyki, nie testy. W 1000 symulowanych badań bez żadnej nietypowej osoby próg 4/n wskazał co najmniej jedną osobę w 80% badań przy n = 20 i we wszystkich przy n = 200 (średnio 5–6% próby). Próg 1 dał alarm w 3.4% badań przy n = 20 i prawie nigdy przy większych próbach. Przekroczenie progu to sygnał do sprawdzenia danych, a nie powód do usunięcia.
Czy w dużej próbie obserwacje wpływowe mają znaczenie?
Pojedyncza osoba – zwykle mniejsze. Ta sama osoba miała przy n = 20 odległość Cooka 2.53 i zmieniła p z .003 na .100, a przy n = 200 – D = 0.51 i nachylenie zmieniło się tylko z 1.34 na 1.21. W symulacji zmieniała wniosek w 54% badań z 20 osobami i w żadnym z 200. Grupa podobnych osób może jednak przestawić prostą także w dużej próbie.
Jak opisać obserwację wpływową w pracy dyplomowej?
Podaj jej dźwignię i odległość Cooka, napisz, czy sprawdzono dane źródłowe, i pokaż wynik z obserwacją i bez niej (np. b = 0.62, p = .100 z nią i b = 1.39, p = .003 bez niej). Regułę postępowania zapisz przed analizą. Prawdziwej, nietypowej osoby nie usuwaj bez uzasadnienia – lepiej raportuj obie wersje albo dodaj model mniej wrażliwy na pojedyncze obserwacje.
Powiązane hasła
Przeczytaj też
Wartości odstające: jak je wykryć i co z nimi zrobić
Reguły ustalone z góry, MAD zamiast ±3 SD, Mahalanobis i MCD, odległość Cooka, winsoryzacja, test Yuena, analiza wrażliwości i opis APA – z kodem R.
Czytaj →PoradnikCzy można usunąć obserwacje odstające?
Kiedy usunięcie wyniku jest uzasadnione, a kiedy staje się manipulacją: tabela decyzji, analiza wrażliwości w R i gotowy opis do pracy.
Czytaj →PoradnikGaleria wykresów reszt
Łuk, lejek, skos, dźwignia, dwa pasma i fale w czasie – jak wyglądają złamane założenia regresji na wykresach reszt z R, z podpisami i ćwiczeniem.
Czytaj →PoradnikMetoda najmniejszych kwadratów w obrazkach
Reszty jako kwadraty, parabola sumy kwadratów, regresja y na x i x na y, oś główna, dźwignia i R² – skąd się bierze prosta regresji, na rysunkach z R.
Czytaj →Jedna osoba zmienia wynik Twojej regresji?
Pomożemy sprawdzić dane, ocenić dźwignię i odległość Cooka, przeprowadzić analizę wrażliwości i opisać decyzję w pracy – tak, żebyś umiał(a) ją uzasadnić promotorowi i recenzentowi.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Aguinis, H., Gottfredson, R. K., & Joo, H. (2013). Best-practice recommendations for defining, identifying, and handling outliers. Organizational Research Methods, 16(2), 270–301. https://doi.org/10.1177/1094428112470848
- Bollen, K. A., & Jackman, R. W. (1985). Regression diagnostics: An expository treatment of outliers and influential cases. Sociological Methods & Research, 13(4), 510–542. https://doi.org/10.1177/0049124185013004004
- Chatterjee, S., & Hadi, A. S. (1986). Influential observations, high leverage points, and outliers in linear regression. Statistical Science, 1(3), 379–393. https://doi.org/10.1214/ss/1177013622 ● Otwarty dostęp
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- Cook, R. D. (1979). Influential observations in linear regression. Journal of the American Statistical Association, 74(365), 169–174. https://doi.org/10.1080/01621459.1979.10481634 ● Otwarty dostęp: pełny tekst
- Hoaglin, D. C., & Welsch, R. E. (1978). The hat matrix in regression and ANOVA. The American Statistician, 32(1), 17–22. https://doi.org/10.1080/00031305.1978.10479237 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{aguinis2013best, author={Aguinis, Herman and Gottfredson, Ryan K. and Joo, Harry}, title={{Best-practice recommendations for defining, identifying, and handling outliers}}, journal={Organizational Research Methods}, year={2013}, volume={16}, number={2}, pages={270--301}, doi={10.1177/1094428112470848}}@article{bollen1985regression, author={Bollen, Kenneth A. and Jackman, Robert W.}, title={{Regression diagnostics: An expository treatment of outliers and influential cases}}, journal={Sociological Methods \& Research}, year={1985}, volume={13}, number={4}, pages={510--542}, doi={10.1177/0049124185013004004}}@article{chatterjee1986influential, author={Chatterjee, Samprit and Hadi, Ali S.}, title={{Influential observations, high leverage points, and outliers in linear regression}}, journal={Statistical Science}, year={1986}, volume={1}, number={3}, pages={379--393}, doi={10.1214/ss/1177013622}}@article{cook1977detection, author={Cook, R. Dennis}, title={{Detection of influential observation in linear regression}}, journal={Technometrics}, year={1977}, volume={19}, number={1}, pages={15--18}, doi={10.1080/00401706.1977.10489493}}@article{cook1979influential, author={Cook, R. Dennis}, title={{Influential observations in linear regression}}, journal={Journal of the American Statistical Association}, year={1979}, volume={74}, number={365}, pages={169--174}, doi={10.1080/01621459.1979.10481634}}@article{hoaglin1978hat, author={Hoaglin, David C. and Welsch, Roy E.}, title={{The hat matrix in regression and ANOVA}}, journal={The American Statistician}, year={1978}, volume={32}, number={1}, pages={17--22}, doi={10.1080/00031305.1978.10479237}}