Co to jest analiza logliniowa?
Analiza logliniowa (ang. log-linear analysis) to modelowanie liczebności w tabeli krzyżowej trzech lub więcej zmiennych jakościowych. Logarytm oczekiwanej liczebności komórki zapisuje się jako sumę efektów głównych i interakcji zmiennych. Birch (1963) zdefiniował interakcje w tabelach trójdzielczych właśnie jako kombinacje logarytmów liczebności oczekiwanych i opisał ich estymację metodą największej wiarygodności. Żadna zmienna nie jest tu zależna: model opisuje układ powiązań między wszystkimi naraz.
Modele hierarchiczne i ich porównanie
Model oznacza się nawiasami najwyższych interakcji. Dla zmiennych T (tryb studiów), P (praca) i W (wypalenie) zapis [TP][PW] oznacza, że T i W są niezależne warunkowo przy danym P. Model jest hierarchiczny: zawiera też wszystkie niższe składniki, np. [TP] obejmuje T i P. Goodman (1970) pokazał, jak testować takie hipotezy, w tym niezależność warunkową, i jak rozkładać je na kolejne kroki.
Dopasowanie mierzy statystyka G², czyli dewiancja modelu wobec modelu nasyconego. Różnica G² dwóch modeli zagnieżdżonych to test ilorazu wiarygodności. Zwykle zaczyna się od modelu nasyconego i usuwa kolejne interakcje, dopóki G² nie wzrośnie istotnie.
Przykład
W danych symulowanych 400 studentów model bez interakcji trzech zmiennych, [TP][TW][PW], pasował dobrze: G²(1) = 0.00, p = .950. Po usunięciu [TW] model [TP][PW] nadal pasował, G²(2) = 0.75, p = .688. Usunięcie [PW] pogorszyło dopasowanie o ΔG²(1) = 21.79, p < .001. Interakcję PW czytamy jako iloraz szans: pracujący mieli 2.80 razy większe szanse wypalenia, 95% CI [1.79, 4.37], niezależnie od trybu studiów. Ten sam model dopasowany jako regresja Poissona dał identyczną dewiancję.
Na rysunku
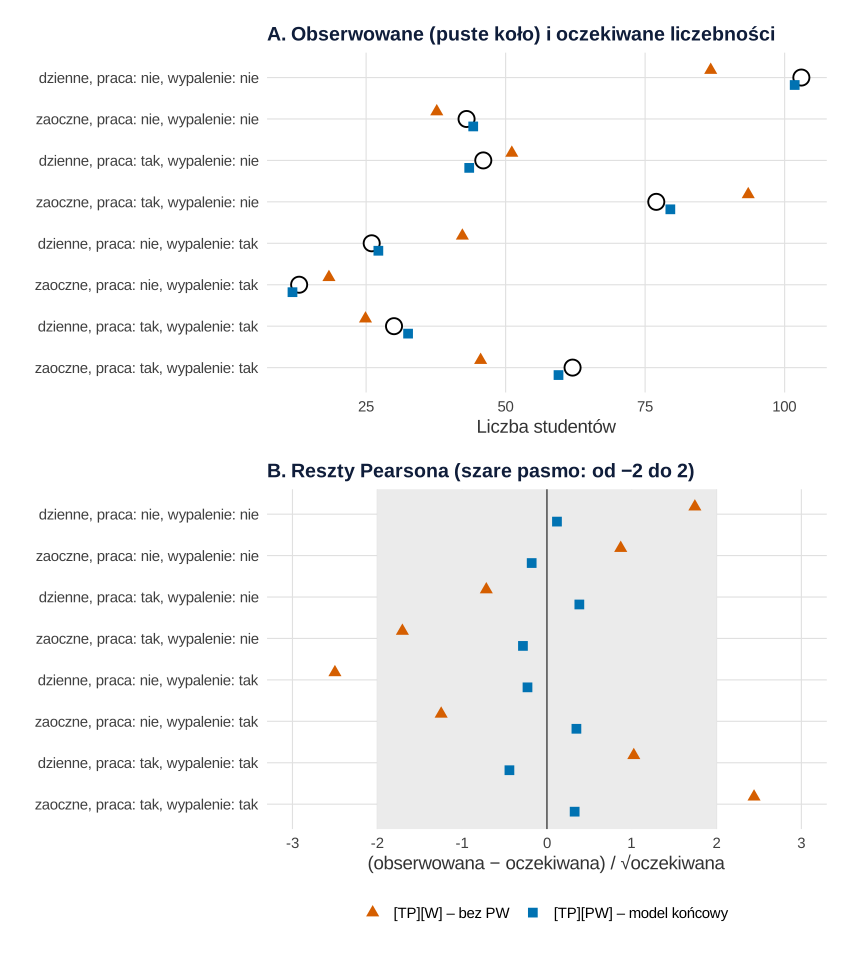
set.seed(4571)).Co widać. Model logliniowy przewiduje liczebność każdej komórki tabeli, więc jego dopasowanie można zobaczyć komórka po komórce. Puste koła w panelu A to osiem liczebności z przykładu. Trójkąty to przewidywania modelu [TP][W], w którym wypalenie nie zależy od pracy: model ten myli się nawet o kilkanaście osób, np. wśród niepracujących studentów dziennych z wypaleniem oczekuje 42.2 osoby, a jest ich 26. Kwadraty modelu końcowego [TP][PW] leżą prawie na kołach. Panel B pokazuje to samo jako reszty Pearsona, czyli różnice podzielone przez pierwiastek z liczebności oczekiwanej. W modelu bez PW reszty sięgają od −2.50 do 2.44 i mają wyraźny wzór: nadwyżka w komórkach „pracuje i wypalony” oraz „nie pracuje i niewypalony”, niedobór w dwóch pozostałych. To właśnie pominięta interakcja PW. Suma kwadratów tych reszt to χ² Pearsona, 22.03 przy 3 stopniach swobody (G² = 22.53); w modelu końcowym reszty mieszczą się między −0.44 a 0.38, a χ² = G² = 0.75.
Na co uważać. Rysunek ocenia dopasowanie, a nie siłę związku – tę opisuje iloraz szans z modelu. Przy ośmiu komórkach pojedyncza reszta powyżej 2 co do modułu może być przypadkiem, dlatego wzór reszt jest ważniejszy niż jedna komórka. W większych tabelach takie reszty zwykle pokazuje się kolorem na wykresie mozaikowym; różne sposoby rysowania tabeli krzyżowej porównuje wpis Tabela krzyżowa na wykresie.
Podpis do pracy:
Kod rysunku odtwarza dane z przykładu (set.seed(4571)). Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Liczebności obserwowane i oczekiwane w dwóch modelach logliniowych oraz reszty Pearsona (dane z przykładu)
suppressPackageStartupMessages({ library(MASS); library(ggplot2); library(patchwork) })

# Paleta Okabe–Ito i prosty motyw
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# Dane z przykładu (te same co w haśle, set.seed(4571))
set.seed(4571)
n <- 400
tryb  <- factor(sample(c("dzienne", "zaoczne"), n, TRUE), levels = c("dzienne", "zaoczne"))
praca <- factor(ifelse(runif(n) < ifelse(tryb == "zaoczne", .75, .35), "tak", "nie"), levels = c("nie", "tak"))
wypal <- factor(ifelse(runif(n) < ifelse(praca == "tak", .40, .20), "tak", "nie"), levels = c("nie", "tak"))
tab <- table(tryb, praca, wypal)

modele <- list("[TP][W] – bez PW" = loglm(~ tryb * praca + wypal, data = tab, fitted = TRUE),
               "[TP][PW] – model końcowy" = loglm(~ tryb * praca + praca * wypal, data = tab, fitted = TRUE))
d <- as.data.frame(tab)
d$komorka <- with(d, paste0(tryb, ", praca: ", praca, ", wypalenie: ", wypal))
d$komorka <- factor(d$komorka, levels = rev(d$komorka))
dl <- do.call(rbind, lapply(names(modele), function(nm) {
  oczek <- as.vector(fitted(modele[[nm]]))
  data.frame(d, model = nm, oczekiwana = oczek, reszta = (d$Freq - oczek) / sqrt(oczek))
}))
dl$model <- factor(dl$model, levels = names(modele))
print(data.frame(komorka = d$komorka, obserwowana = d$Freq,
                 oczek_bez_PW = round(dl$oczekiwana[dl$model == names(modele)[1]], 1),
                 reszta_bez_PW = round(dl$reszta[dl$model == names(modele)[1]], 2),
                 oczek_TP_PW = round(dl$oczekiwana[dl$model == names(modele)[2]], 1),
                 reszta_TP_PW = round(dl$reszta[dl$model == names(modele)[2]], 2)), row.names = FALSE)
round(sapply(modele, function(m) c(G2 = m$lrt, X2 = m$pearson, df = m$df)), 2)

kol <- c("[TP][W] – bez PW" = "#D55E00", "[TP][PW] – model końcowy" = "#0072B2")
ksz <- c("[TP][W] – bez PW" = 17, "[TP][PW] – model końcowy" = 15)
pA <- ggplot(dl, aes(y = komorka)) +
  geom_point(data = d, aes(x = Freq), shape = 21, size = 5, fill = "white", colour = "black", stroke = 1) +
  geom_point(aes(x = oczekiwana, colour = model, shape = model), size = 3,
             position = position_nudge(y = ifelse(dl$model == names(modele)[1], 0.18, -0.18))) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = ksz, name = NULL) +
  labs(title = "A. Obserwowane (puste koło) i oczekiwane liczebności", x = "Liczba studentów", y = NULL) +
  motyw

pB <- ggplot(dl, aes(x = reszta, y = komorka, colour = model, shape = model)) +
  annotate("rect", xmin = -2, xmax = 2, ymin = -Inf, ymax = Inf, fill = "grey92") +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_point(size = 3, position = position_nudge(y = ifelse(dl$model == names(modele)[1], 0.18, -0.18))) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = ksz, name = NULL) +
  scale_x_continuous(limits = c(-3, 3), breaks = seq(-3, 3, 1)) +
  labs(title = "B. Reszty Pearsona (szare pasmo: od −2 do 2)",
       x = "(obserwowana − oczekiwana) / √oczekiwana", y = NULL) +
  motyw

p <- pA / pB + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p
Wynik w R
                             komorka obserwowana oczek_bez_PW reszta_bez_PW
 dzienne, praca: nie, wypalenie: nie         103         86.8          1.74
 zaoczne, praca: nie, wypalenie: nie          43         37.7          0.87
 dzienne, praca: tak, wypalenie: nie          46         51.1         -0.71
 zaoczne, praca: tak, wypalenie: nie          77         93.5         -1.70
 dzienne, praca: nie, wypalenie: tak          26         42.2         -2.50
 zaoczne, praca: nie, wypalenie: tak          13         18.3         -1.25
 dzienne, praca: tak, wypalenie: tak          30         24.9          1.02
 zaoczne, praca: tak, wypalenie: tak          62         45.5          2.44
 oczek_TP_PW reszta_TP_PW
       101.8         0.12
        44.2        -0.18
        43.5         0.38
        79.5        -0.28
        27.2        -0.23
        11.8         0.35
        32.5        -0.44
        59.5         0.33
   [TP][W] – bez PW [TP][PW] – model końcowy
G2            22.53                     0.75
X2            22.03                     0.75
df             3.00                     2.00
Jak opisać w pracy
Na co uważać
- Zmienna wynikowa. Gdy jedna zmienna jest wyraźnie zależna, prostsza do opisu jest regresja logistyczna. Daje te same ilorazy szans co odpowiadający jej model logliniowy.
- Puste komórki. Przy małych liczebnościach G² słabo przybliża rozkład χ².
- Tabela 2 × 2 × K. Gdy pytasz tylko o związek dwóch zmiennych przy kontroli trzeciej, wystarczy test Cochrana–Mantela–Haenszela. Pełną procedurę opisuje wpis Analiza logliniowa tabel wielodzielczych.
Analiza logliniowa w R
Kod tworzy tabelę 2 × 2 × 2, dopasowuje modele hierarchiczne funkcją MASS::loglm, porównuje je statystyką G² i dopasowuje model końcowy jako regresję Poissona (glm).
Eliminacja wsteczna i iloraz szans z modelu końcowego
R
suppressPackageStartupMessages(library(MASS))
set.seed(4571)
n <- 400
tryb  <- factor(sample(c("dzienne", "zaoczne"), n, TRUE), levels = c("dzienne", "zaoczne"))
praca <- factor(ifelse(runif(n) < ifelse(tryb == "zaoczne", .75, .35), "tak", "nie"), levels = c("nie", "tak"))
wypal <- factor(ifelse(runif(n) < ifelse(praca == "tak", .40, .20), "tak", "nie"), levels = c("nie", "tak"))
tab <- table(tryb, praca, wypal); print(ftable(tab))
modele <- list(
  "[TPW] nasycony"            = loglm(~ tryb * praca * wypal, data = tab),
  "[TP][TW][PW]"              = loglm(~ (tryb + praca + wypal)^2, data = tab),
  "[TP][PW]"                  = loglm(~ tryb * praca + praca * wypal, data = tab),
  "[TP][W] (bez PW)"          = loglm(~ tryb * praca + wypal, data = tab))
print(t(sapply(modele, function(m) c(G2 = round(m$lrt, 2), df = m$df,
       p = round(pchisq(m$lrt, m$df, lower.tail = FALSE), 3)))))
dG2 <- modele[[4]]$lrt - modele[[3]]$lrt
cat("usuniecie [PW]: dG2 =", round(dG2, 2), " df = 1  p =", signif(pchisq(dG2, 1, lower.tail = FALSE), 3), "\n")
# ten sam model [TP][PW] jako regresja Poissona
d <- as.data.frame(tab)
g <- glm(Freq ~ tryb * praca + praca * wypal, family = poisson, data = d)
cat("dewiancja glm:", round(deviance(g), 2), " df:", df.residual(g), "\n")
cat("OR praca-wypalenie:", round(exp(coef(g)["pracatak:wypaltak"]), 2),
    " 95% CI:", round(exp(confint.default(g)["pracatak:wypaltak", ]), 2), "\n")
Wynik w R
              wypal nie tak
tryb    praca
dzienne nie         103  26
        tak          46  30
zaoczne nie          43  13
        tak          77  62
                    G2 df     p
[TPW] nasycony    0.00  0 1.000
[TP][TW][PW]      0.00  1 0.950
[TP][PW]          0.75  2 0.688
[TP][W] (bez PW) 22.53  3 0.000
usuniecie [PW]: dG2 = 21.79  df = 1  p = 3.05e-06
dewiancja glm: 0.75  df: 2
OR praca-wypalenie: 2.8  95% CI: 1.79 4.37
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet MASS). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Co oznacza zapis [AB][BC] w analizie logliniowej?
Model z interakcjami A × B i B × C oraz wszystkimi efektami niższego rzędu. Brak [AC] oznacza, że A i C są niezależne warunkowo przy danym poziomie B.
Czym analiza logliniowa różni się od regresji logistycznej?
Analiza logliniowa traktuje wszystkie zmienne symetrycznie i modeluje liczebności. Regresja logistyczna wyróżnia jedną zmienną zależną. Odpowiadające sobie modele dają te same ilorazy szans.
Czy analizę logliniową można zrobić funkcją glm w R?
Tak. Model logliniowy to regresja Poissona dla liczebności komórek: glm(Freq ~ A * B + B * C, family = poisson, data = as.data.frame(tabela)). Dewiancja równa się G² z MASS::loglm.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza logliniowa tabel wielodzielczych
Modele hierarchiczne, G² i selekcja wsteczna, interakcje jako ilorazy szans oraz równoważność z regresją Poissona na tabeli 2 × 2 × 2.
Czytaj →PoradnikTest chi-kwadrat krok po kroku
Test zgodności i niezależności na jednym badaniu: odsetki, liczebności oczekiwane, reszty, V Craméra, test Fishera i gotowy opis APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Birch, M. W. (1963). Maximum likelihood in three-way contingency tables. Journal of the Royal Statistical Society: Series B (Methodological), 25(1), 220–233. https://doi.org/10.1111/j.2517-6161.1963.tb00504.x
- Goodman, L. A. (1970). The multivariate analysis of qualitative data: Interactions among multiple classifications. Journal of the American Statistical Association, 65(329), 226–256. https://doi.org/10.1080/01621459.1970.10481076
Cytowania BibTeX
@article{birch1963maximum, author={Birch, M. W.}, title={{Maximum likelihood in three-way contingency tables}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1963}, volume={25}, number={1}, pages={220--233}, doi={10.1111/j.2517-6161.1963.tb00504.x}}@article{goodman1970multivariate, author={Goodman, Leo A.}, title={{The multivariate analysis of qualitative data: Interactions among multiple classifications}}, journal={Journal of the American Statistical Association}, year={1970}, volume={65}, number={329}, pages={226--256}, doi={10.1080/01621459.1970.10481076}}