glm() albo w MASS::loglm(), a gdy jedna zmienna jest wynikiem, prościej opisać go regresją logistyczną.Kiedy tabela krzyżowa przestaje wystarczać
Test χ² w tabeli krzyżowej odpowiada na jedno pytanie: czy dwie zmienne kategorialne są niezależne. Krok po kroku opisuje go poradnik o teście chi-kwadrat. W badaniach rzadko kończy się jednak na dwóch zmiennych. Masz trzy albo cztery cechy na skali nominalnej i chcesz wiedzieć, które pary są ze sobą związane, czy związek utrzymuje się po uwzględnieniu trzeciej zmiennej i czy siła związku zależy od poziomu tej trzeciej zmiennej.
Do takich pytań służy analiza logliniowa (ang. log-linear analysis). Modeluje ona logarytm liczebności oczekiwanych w komórkach tabeli wielodzielczej. Zmiennych nie dzieli się na zależne i niezależne: wszystkie traktuje się symetrycznie. Krótką definicję znajdziesz w haśle analiza logliniowa. W tym wpisie przechodzimy przez pełną analizę tabeli 2 × 2 × 2: od oznaczeń modeli, przez porównanie dewiancji i selekcję wsteczną, po interpretację interakcji jako ilorazów szans i decyzję, kiedy lepiej sięgnąć po regresję logistyczną.
Model logliniowy i oznaczenia modeli
Dla trzech zmiennych P, S i L z komórką (i, j, k) model nasycony ma postać:
Wyrazy jednej zmiennej odtwarzają tylko jej rozkład brzegowy. Treść merytoryczną niosą interakcje. Birch (1963) zdefiniował interakcje w tabelach trój- i wielodzielczych właśnie jako kombinacje liniowe logarytmów liczebności oczekiwanych i opisał ich estymację metodą największej wiarygodności. Goodman (1970) rozwinął testowanie hierarchicznych hipotez o tych interakcjach, w tym niezależności warunkowej.
Model hierarchiczny spełnia jedną zasadę: jeśli zawiera interakcję, zawiera też wszystkie wyrazy niższego rzędu złożone z tych samych zmiennych. Dlatego zapisuje się go skrótowo, przez najwyższe interakcje w nawiasach kwadratowych. Zapis [PS][SL] oznacza model z interakcjami PS i SL oraz wszystkimi efektami jednej zmiennej.
| Zapis | Co zakłada | df w tabeli 2 × 2 × 2 |
|---|---|---|
| [PSL] | model nasycony, odtwarza dane idealnie | 0 |
| [PS][PL][SL] | jednorodny związek: OR każdej pary jest taki sam na każdym poziomie trzeciej zmiennej | 1 |
| [PS][SL] | P i L niezależne warunkowo przy ustalonym S | 2 |
| [P][SL] | P niezależne od pary (S, L) | 3 |
| [P][S][L] | pełna wzajemna niezależność | 4 |
Stopnie swobody to liczba komórek minus liczba wolnych parametrów. Tabela 2 × 2 × 2 ma 8 komórek, a model nasycony 8 parametrów, więc df = 0.
Przykład: praca, sen i lęk u studentów
W ankiecie wzięło udział 900 studentów (dane symulowane, set.seed(3394)). Zapisano trzy zmienne dychotomiczne: P – czy student pracuje zarobkowo, S – czy zgłasza zaburzenia snu, L – czy ma wysoki poziom lęku. Liczebności komórek są w pliku CSV.
| Praca | Zaburzenia snu | Lęk niski | Lęk wysoki |
|---|---|---|---|
| nie | nie | 342 | 79 |
| nie | tak | 73 | 70 |
| tak | nie | 150 | 43 |
| tak | tak | 70 | 73 |
Zwykły test χ² w tabeli brzegowej praca × lęk daje wynik istotny: wysoki lęk ma 34.5% pracujących i 26.4% niepracujących, χ²(1) = 6.66, p = .010, a iloraz szans wynosi 1.47. Na tym wiele prac się kończy. Pytanie brzmi jednak, czy praca wiąże się z lękiem bezpośrednio, czy tylko przez to, że pracujący studenci częściej źle śpią.
Porównanie modeli: G² i selekcja wsteczna
Dopasowanie modelu mierzy statystyka ilorazu wiarygodności G² = 2 Σ n ln(n / μ̂). To dewiancja modelu względem modelu nasyconego. Małe G² przy danym df oznacza, że model dobrze odtwarza liczebności. Różnica G² dwóch modeli zagnieżdżonych to test ilorazu wiarygodności z df równym różnicy df.
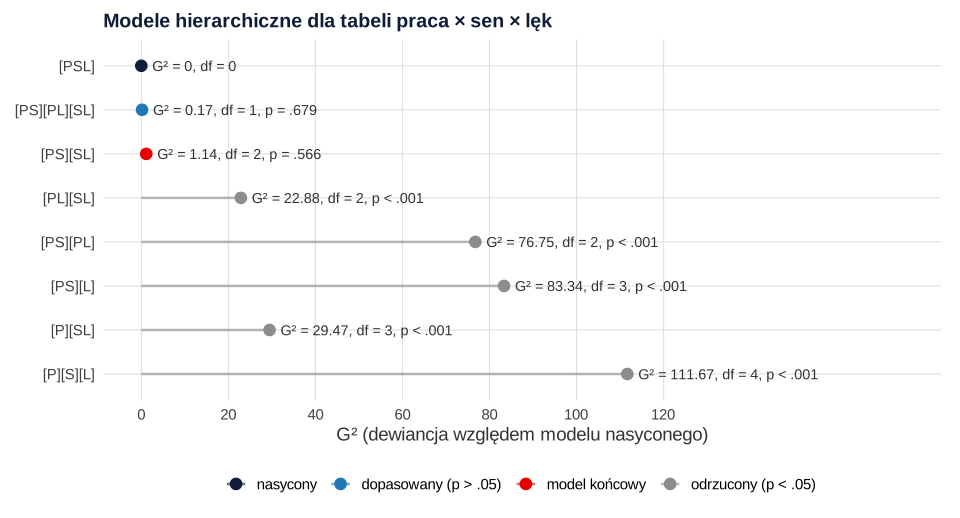
| Model | G² | df | p | AIC* |
|---|---|---|---|---|
| [PSL] | 0.00 | 0 | – | 16.00 |
| [PS][PL][SL] | 0.17 | 1 | .679 | 14.17 |
| [PS][SL] | 1.14 | 2 | .566 | 13.14 |
| [PL][SL] | 22.88 | 2 | < .001 | 34.88 |
| [PS][PL] | 76.75 | 2 | < .001 | 88.75 |
| [P][SL] | 29.47 | 3 | < .001 | 39.47 |
| [PS][L] | 83.34 | 3 | < .001 | 93.34 |
| [P][S][L] | 111.67 | 4 | < .001 | 119.67 |
* AIC liczone jako G² + 2 × liczba parametrów; liczą się tylko różnice między modelami (zob. AIC i BIC).
Goodman (1971) zaproponował budowanie modeli tabel wielodzielczych procedurami podobnymi do krokowych metod regresji. Najczęściej stosuje się selekcję wsteczną: zaczynasz od modelu nasyconego i usuwasz interakcje od najwyższego rzędu, za każdym razem sprawdzając różnicę G². Zgodnie z zasadą hierarchii nie usuwasz wyrazu, który wchodzi w skład interakcji pozostającej w modelu.
Krok 1. Interakcja trzech zmiennych. Usunięcie [PSL] zwiększa G² o 0.17, df = 1, p = .679. Związek każdej pary jest więc podobny na obu poziomach trzeciej zmiennej. Przechodzisz do modelu [PS][PL][SL].
Krok 2. Interakcje dwóch zmiennych. Usuwasz każdą z nich po kolei:
- bez PL: ΔG² = 0.97, df = 1, p = .326;
- bez PS: ΔG² = 22.71, df = 1, p < .001;
- bez SL: ΔG² = 76.58, df = 1, p < .001.
Najmniej traci się po usunięciu PL, a strata jest nieistotna. Zostaje model [PS][SL].
Krok 3. Sprawdzenie, czy można iść dalej. Usunięcie PS z [PS][SL] daje ΔG² = 28.33, a usunięcie SL – ΔG² = 82.20 (oba df = 1, p < .001). Selekcja kończy się na modelu [PS][SL]: G²(2) = 1.14, p = .566. Ma on też najniższe AIC w tabeli. Największa reszta Pearsona w tym modelu wynosi 0.75 co do wartości bezwzględnej, więc żadna komórka nie odstaje.
Automatyczna selekcja ma swoje ryzyka. W badaniu symulacyjnym procedur krokowych w regresji to, czy w modelu końcowym znalazły się prawdziwe predyktory, zależało od korelacji między nimi, a liczba zmiennych szumowych – od liczby kandydatów (Derksen i Keselman, 1992). Opisuje to też hasło metoda krokowa. W tabeli 2 × 2 × 2 modeli jest niewiele, ale przy czterech i pięciu zmiennych liczba kombinacji szybko rośnie. Jeśli masz hipotezy, przetestuj od razu model, który z nich wynika, a selekcję wsteczną opisz jako analizę eksploracyjną.
Interakcje jako ilorazy szans
W tabeli 2 × 2 × 2 każda interakcja dwóch zmiennych odpowiada warunkowemu ilorazowi szans, czyli OR tej pary przy ustalonym poziomie trzeciej zmiennej. Przy kodowaniu zero-jedynkowym (dummy coding) OR = exp(λ). W modelu jednorodnego związku [PS][PL][SL] otrzymujesz:
| Interakcja | λ (SE) | Warunkowy OR [95% CI] |
|---|---|---|
| praca × sen | 0.733 (0.154) | 2.08 [1.54, 2.82] |
| praca × lęk | 0.157 (0.159) | 1.17 [0.86, 1.60] |
| sen × lęk | 1.367 (0.158) | 3.92 [2.88, 5.35] |
Pracujący mają około dwa razy większą szansę zaburzeń snu, a osoby z zaburzeniami snu prawie czterokrotnie większą szansę wysokiego lęku. Związek pracy z lękiem przy ustalonym śnie jest słaby, a przedział obejmuje 1. Brzegowy OR 1.47 był więc w dużej części skutkiem ścieżki przez sen. W warstwach OR praca–lęk wynosi 1.24 u osób bez zaburzeń snu i 1.09 u osób z zaburzeniami (rysunek 2). W modelu końcowym [PS][SL], bez interakcji PL, OR wynoszą 2.18, 95% CI [1.64, 2.91] dla pary praca–sen i 4.03, 95% CI [2.97, 5.47] dla pary sen–lęk.
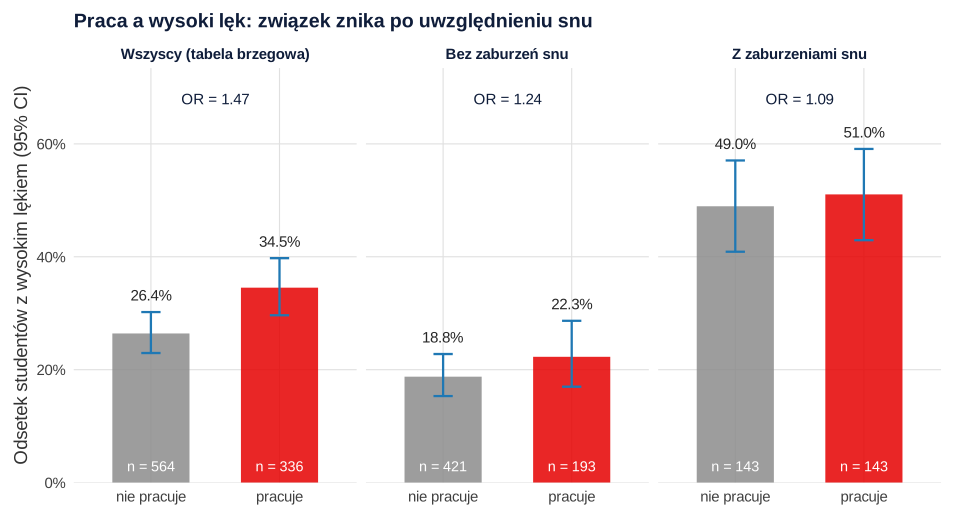
Interakcja trzech zmiennych w modelu nasyconym to logarytm ilorazu dwóch warunkowych OR. Tutaj exp(λPSL) = 0.876, czyli dokładnie 1.09 / 1.24. Gdy ta interakcja jest istotna, związek dwóch zmiennych zależy od poziomu trzeciej, jak w interakcji trójczynnikowej w ANOVA. Wtedy nie raportujesz jednego OR, tylko OR w każdej warstwie.
Programy, które stosują kodowanie efektów (parametry sumują się do zera), podają inne liczby. W tabeli 2 × 2 warunkowy OR = exp(4λ). W przykładzie λSL = 0.342, a exp(4 × 0.342) = 3.92, czyli ten sam OR. Zanim zinterpretujesz λ z wydruku, sprawdź, jakie kodowanie stosuje program.
Ten sam wniosek o pracy i lęku daje test Cochrana–Mantela–Haenszela z warstwami według snu (Mantel i Haenszel, 1959): χ²MH(1) = 0.97, p = .325, wspólny OR = 1.17, 95% CI [0.86, 1.60]. Test CMH odpowiada na jedno pytanie o jedną parę. Model logliniowy ocenia całą strukturę związków naraz. Różnica między OR brzegowym a warunkowym to ten sam mechanizm, który w skrajnej postaci daje paradoks Simpsona. Kievit i in. (2013) przypominają, że same dane nie rozstrzygną, czy trzecia zmienna jest zmienną zakłócającą, czy mediatorem. Tu sen może leżeć na ścieżce od pracy do lęku, ale z danych przekrojowych tego nie udowodnisz.
Ten sam model w glm i w MASS::loglm
Model logliniowy jest szczególnym przypadkiem uogólnionego modelu liniowego. Nelder i Wedderburn (1972) pokazali, że takie modele dla rozkładów z rodziny wykładniczej, w tym rozkładu Poissona, szacuje się jednym algorytmem, a porównuje analizą dewiancji. W praktyce oznacza to, że analiza logliniowa to regresja Poissona, w której jednostką analizy jest komórka tabeli, a zmienną zależną – liczebność komórki. W R masz dwie równoważne drogi:
glm(Freq ~ praca * sen + sen * lek, family = poisson)na danych w formacie „jedna komórka = jeden wiersz”;MASS::loglm(~ praca * sen + sen * lek, data = tab)na obiekcie tabeli (Venables i Ripley, 2002).
W przykładzie dewiancja resztowa glm wynosi 1.137 przy df = 2, a G² z loglm – też 1.137. Sekwencja anova(..., test = "LRT") na trzech modelach glm daje te same różnice dewiancji co kroki selekcji: 0.97 i 0.17. Wersja glm ma tę przewagę, że od razu podaje SE i przedziały ufności dla λ. Więcej o samej regresji Poissona przeczytasz w poradniku o regresji dla zliczeń.
Kiedy wybrać regresję logistyczną
Analiza logliniowa jest najlepsza, gdy wszystkie zmienne są równorzędne i pytasz o strukturę związków. Gdy jedna zmienna jest wynikiem, a pozostałe jej predyktorami, prostsza w interpretacji jest regresja logistyczna. Obie drogi są ze sobą ściśle powiązane. Agresti (2013) poświęca temu związkowi osobny podrozdział, a Goodman (1970) wiązał hipotezy logliniowe z analizą logitową.
W przykładzie regresja logistyczna wysokiego lęku na pracę i sen (na danych zagregowanych) daje współczynniki 0.1566 i 1.3670. To dokładnie λPL i λSL z modelu [PS][PL][SL], a dewiancje obu modeli wynoszą 0.171. Model logistyczny z predyktorami P i S odpowiada modelowi logliniowemu, który zawiera pełną interakcję predyktorów [PS] i interakcje każdego z nich z wynikiem.
| Sytuacja | Lepszy wybór |
|---|---|
| Wszystkie zmienne kategorialne, pytanie o to, kto z kim jest powiązany | analiza logliniowa |
| Jedna zmienna wyniku, kilka kategorialnych predyktorów | regresja logistyczna (OR wprost dla wyniku) |
| Predyktory ciągłe (wiek, wynik skali) | regresja logistyczna – tabela wymagałaby kategoryzacji |
| Wynik o więcej niż dwóch kategoriach | wielomianowa regresja logistyczna albo model logliniowy |
| Pomiary powtarzane tych samych osób | ani jedno, ani drugie w podstawowej wersji (zob. test McNemara) |
Jak raportować model z wynikiem binarnym, pokazuje regresja logistyczna krok po kroku.
Jak opisać analizę logliniową w artykule
W metodzie podaj zmienne i ich kategorie, sposób doboru modelu (z góry albo selekcja wsteczna z kryterium p lub AIC) i program. W wynikach podaj tabelę liczebności, G² z df i p dla modelu końcowego, testy usuwanych wyrazów i warunkowe OR z 95% CI. Pojedyncze tabele brzegowe 2 × 2 policzysz w kalkulatorze tabeli 2×2.
Jeśli Twoja tabela ma cztery lub pięć wymiarów i potrzebujesz pomocy przy wyborze modelu, zajrzyj do oferty analiz statystycznych dla badaczy.
Przykład w R
Dwa przepisy uruchamiane po kolei w jednej sesji. Model logliniowy dopasowujemy funkcją loglm() z pakietu MASS i jako regresję Poissona w glm(); oba sposoby dają te same liczby.
1. Tabela, modele hierarchiczne i selekcja wsteczna
R
# Dane symulowane: ankieta 900 studentów, trzy zmienne dychotomiczne
# P – praca zarobkowa w trakcie studiów, S – zaburzenia snu, L – wysoki lęk.
suppressPackageStartupMessages(library(MASS))   # loglm()
set.seed(3394)
n <- 900
praca <- rbinom(n, 1, .40)
sen   <- rbinom(n, 1, plogis(-1.1 + 0.75 * praca))   # praca sprzyja zaburzeniom snu
lek   <- rbinom(n, 1, plogis(-1.3 + 1.2 * sen))      # zaburzenia snu sprzyjają lękowi
d <- data.frame(praca = factor(praca, 0:1, c("nie", "tak")),
                sen   = factor(sen,   0:1, c("nie", "tak")),
                lek   = factor(lek,   0:1, c("niski", "wysoki")))
tab <- xtabs(~ praca + sen + lek, data = d)                  # tabela 2 × 2 × 2
ftable(tab, row.vars = c("praca", "sen"))
dane <- as.data.frame(tab)                                    # format: jedna komórka = jeden wiersz
write.csv(dane, "../analiza-logliniowa-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")

# Tabela brzegowa praca × lęk (bez uwzględnienia snu): zwykły test chi-kwadrat
pl <- margin.table(tab, c(1, 3))
round(100 * prop.table(pl, 1), 1)                             # % wysokiego lęku: nie pracuje / pracuje
chisq.test(pl, correct = FALSE)

# Odsetek wysokiego lęku według pracy osobno w warstwach snu
round(100 * prop.table(tab, c(1, 2))[, , "wysoki"], 1)

# Modele hierarchiczne: od nasyconego [PSL] w dół (G² = dewiancja względem modelu nasyconego)
modele <- list(
  "[PSL]"        = loglm(~ praca * sen * lek, data = tab),
  "[PS][PL][SL]" = loglm(~ praca * sen + praca * lek + sen * lek, data = tab),
  "[PS][SL]"     = loglm(~ praca * sen + sen * lek, data = tab, fit = TRUE),
  "[PL][SL]"     = loglm(~ praca * lek + sen * lek, data = tab),
  "[PS][PL]"     = loglm(~ praca * sen + praca * lek, data = tab),
  "[PS][L]"      = loglm(~ praca * sen + lek, data = tab),
  "[P][SL]"      = loglm(~ praca + sen * lek, data = tab),
  "[P][S][L]"    = loglm(~ praca + sen + lek, data = tab))
dopasowanie <- data.frame(model = names(modele),
  G2 = sapply(modele, function(m) m$lrt), df = sapply(modele, function(m) m$df))
dopasowanie$p   <- pchisq(dopasowanie$G2, dopasowanie$df, lower.tail = FALSE)
dopasowanie$AIC <- dopasowanie$G2 + 2 * (8 - dopasowanie$df)   # AIC względem modelu nasyconego (stała pominięta)
print(transform(dopasowanie, G2 = round(G2, 2), p = round(p, 3), AIC = round(AIC, 2)), row.names = FALSE)

# Selekcja wsteczna: różnica G² między modelami zagnieżdżonymi (test ilorazu wiarygodności)
porownaj <- function(prostszy, zlozony) {
  dG2 <- modele[[prostszy]]$lrt - modele[[zlozony]]$lrt
  ddf <- modele[[prostszy]]$df - modele[[zlozony]]$df
  c(dG2 = round(dG2, 2), ddf = ddf, p = round(pchisq(dG2, ddf, lower.tail = FALSE), 3))
}
# Krok 1: czy potrzebna interakcja trzech zmiennych?
porownaj("[PS][PL][SL]", "[PSL]")
# Krok 2: usuwamy po kolei każdą interakcję dwóch zmiennych z modelu [PS][PL][SL]
rbind("bez PL" = porownaj("[PS][SL]", "[PS][PL][SL]"),
      "bez PS" = porownaj("[PL][SL]", "[PS][PL][SL]"),
      "bez SL" = porownaj("[PS][PL]", "[PS][PL][SL]"))
# Krok 3: z modelu [PS][SL] próbujemy usunąć kolejną interakcję
rbind("bez PS" = porownaj("[P][SL]", "[PS][SL]"),
      "bez SL" = porownaj("[PS][L]", "[PS][SL]"))

# Model końcowy [PS][SL]: liczebności oczekiwane i reszty Pearsona
koncowy <- modele[["[PS][SL]"]]
ftable(round(fitted(koncowy), 1), row.vars = c("praca", "sen"))
round(max(abs(residuals(koncowy, type = "pearson"))), 2)
Wynik w R
          lek niski wysoki
praca sen
nie   nie       342     79
      tak        73     70
tak   nie       150     43
      tak        70     73
     lek
praca niski wysoki
  nie  73.6   26.4
  tak  65.5   34.5

	Pearson's Chi-squared test

data:  pl
X-squared = 6.6587, df = 1, p-value = 0.009867

     sen
praca  nie  tak
  nie 18.8 49.0
  tak 22.3 51.0
        model     G2 df     p    AIC
        [PSL]   0.00  0 1.000  16.00
 [PS][PL][SL]   0.17  1 0.679  14.17
     [PS][SL]   1.14  2 0.566  13.14
     [PL][SL]  22.88  2 0.000  34.88
     [PS][PL]  76.75  2 0.000  88.75
      [PS][L]  83.34  3 0.000  93.34
      [P][SL]  29.47  3 0.000  39.47
    [P][S][L] 111.67  4 0.000 119.67
  dG2   ddf     p
0.170 1.000 0.679
         dG2 ddf     p
bez PL  0.97   1 0.326
bez PS 22.71   1 0.000
bez SL 76.58   1 0.000
         dG2 ddf p
bez PS 28.33   1 0
bez SL 82.20   1 0
          lek niski wysoki
praca sen
nie   nie     337.3   83.7
      tak      71.5   71.5
tak   nie     154.7   38.3
      tak      71.5   71.5
[1] 0.75
2. Regresja Poissona, ilorazy szans i regresja logistyczna
R
# Kontynuacja przepisu 1: ten sam model jako regresja Poissona, ilorazy szans i porównanie z regresją logistyczną
dane <- as.data.frame(tab)   # kolumny: praca, sen, lek, Freq (liczebność komórki)

# Regresja Poissona na liczebnościach komórek = model logliniowy
g_pelny  <- glm(Freq ~ praca * sen * lek, family = poisson, data = dane)            # [PSL]
g_hom    <- glm(Freq ~ (praca + sen + lek)^2, family = poisson, data = dane)         # [PS][PL][SL]
g_konc   <- glm(Freq ~ praca * sen + sen * lek, family = poisson, data = dane)       # [PS][SL]
round(c(dewiancja_glm = deviance(g_konc), df = df.residual(g_konc),
        G2_loglm = koncowy$lrt), 3)                                                  # ta sama liczba
anova(g_konc, g_hom, g_pelny, test = "LRT")                                          # selekcja jako analiza dewiancji

# Interakcje jako ilorazy szans (kodowanie zero-jedynkowe: exp(współczynnik) = warunkowy OR)
wsp <- coef(summary(g_hom))[c("pracatak:sentak", "pracatak:lekwysoki", "sentak:lekwysoki"), ]
ci  <- confint.default(g_hom)[rownames(wsp), ]
round(cbind(b = wsp[, 1], SE = wsp[, 2], OR = exp(wsp[, 1]), dolny = exp(ci[, 1]), gorny = exp(ci[, 2])), 3)

# Te same OR w modelu końcowym [PS][SL]
round(exp(cbind(OR = coef(g_konc), confint.default(g_konc)))[c("pracatak:sentak", "sentak:lekwysoki"), ], 3)

# OR praca–lęk w tabeli brzegowej i w warstwach snu (sprawdzenie „ręczne”)
or2x2 <- function(t) (t[1, 1] * t[2, 2]) / (t[1, 2] * t[2, 1])
round(c(brzegowy = or2x2(pl), sen_nie = or2x2(tab[, "nie", ]), sen_tak = or2x2(tab[, "tak", ])), 3)

# Dla porównania: test CMH i wspólny OR Mantela–Haenszela (praca × lęk w warstwach snu)
mantelhaen.test(aperm(tab, c(1, 3, 2)), correct = FALSE)

# Regresja logistyczna lęku na zagregowanych danych daje te same OR co model [PS][PL][SL]
szer <- reshape(dane, idvar = c("praca", "sen"), timevar = "lek", direction = "wide")
logit <- glm(cbind(Freq.wysoki, Freq.niski) ~ praca + sen, family = binomial, data = szer)
round(cbind(b_logit = coef(logit)[2:3],
            b_loglin = coef(g_hom)[c("pracatak:lekwysoki", "sentak:lekwysoki")]), 4)
round(c(dewiancja_logit = deviance(logit), dewiancja_loglin = deviance(g_hom)), 3)

# Interakcja trzech zmiennych w modelu nasyconym = log ilorazu dwóch warunkowych OR
round(c(exp_b_PSL = exp(coef(g_pelny)[["pracatak:sentak:lekwysoki"]]),
        OR_sen_tak_przez_OR_sen_nie = or2x2(tab[, "tak", ]) / or2x2(tab[, "nie", ])), 3)

# Parametry λ z kodowaniem efektów (suma = 0), jak w wydrukach programów do analizy logliniowej:
# w tabeli 2 × 2 × 2 warunkowy OR = exp(4λ)
lam <- loglm(~ (praca + sen + lek)^2, data = tab, param = TRUE)$param
round(c(lambda_SL = lam[["sen.lek"]][1, 1], OR_z_lambdy = exp(4 * lam[["sen.lek"]][1, 1])), 3)
Wynik w R
dewiancja_glm            df      G2_loglm
        1.137         2.000         1.137
Analysis of Deviance Table

Model 1: Freq ~ praca * sen + sen * lek
Model 2: Freq ~ (praca + sen + lek)^2
Model 3: Freq ~ praca * sen * lek
  Resid. Df Resid. Dev Df Deviance Pr(>Chi)
1         2    1.13731
2         1    0.17142  1  0.96589   0.3257
3         0    0.00000  1  0.17142   0.6789
                       b    SE    OR dolny gorny
pracatak:sentak    0.733 0.154 2.082 1.540 2.816
pracatak:lekwysoki 0.157 0.159 1.170 0.857 1.597
sentak:lekwysoki   1.367 0.158 3.923 2.879 5.347
                    OR 2.5 % 97.5 %
pracatak:sentak  2.181 1.636  2.908
sentak:lekwysoki 4.033 2.973  5.471
brzegowy  sen_nie  sen_tak
   1.469    1.241    1.088

	Mantel-Haenszel chi-squared test without continuity correction

data:  aperm(tab, c(1, 3, 2))
Mantel-Haenszel X-squared = 0.96923, df = 1, p-value = 0.3249
alternative hypothesis: true common odds ratio is not equal to 1
95 percent confidence interval:
 0.8564644 1.5951621
sample estimates:
common odds ratio
         1.168845

         b_logit b_loglin
pracatak  0.1566   0.1566
sentak    1.3670   1.3670
 dewiancja_logit dewiancja_loglin
           0.171            0.171
                  exp_b_PSL OR_sen_tak_przez_OR_sen_nie
                      0.876                       0.876
  lambda_SL OR_z_lambdy
      0.342       3.923
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje xtabs(), chisq.test(), glm(), mantelhaen.test()) i pakietu MASS (loglm()); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Rzadkie tabele. Przy wielu pustych komórkach i małych liczebnościach oczekiwanych rozkład χ² źle przybliża G², a niektóre parametry są nieoszacowalne. Agresti (2013) poświęca pustym komórkom i rzadkim tabelom osobny podrozdział. Zanim dodasz czwartą zmienną, sprawdź, ile obserwacji przypada na komórkę.
- Model niehierarchiczny. Interakcja PS bez efektów P i S zmienia znaczenie parametrów. W standardowej analizie trzymaj się zasady hierarchii.
- Interpretacja efektów jednej zmiennej. λP mówi tylko, że pracujących jest mniej niż niepracujących. Nie jest to „efekt pracy”.
- Wnioski z tabeli brzegowej. Sumowanie tabeli po trzeciej zmiennej może zmienić, a nawet odwrócić związek. Agresti (2013) omawia warunki, w których takie „zwijanie” tabeli jest dopuszczalne.
- Obserwacje zależne. Każda osoba powinna trafić do dokładnie jednej komórki. Te same osoby w dwóch pomiarach to dane sparowane.
- Selekcja wsteczna jako test hipotez. p z modelu wybranego na tych samych danych jest zbyt optymistyczne. Jeśli hipotezy były wcześniej, testuj je wprost.
- Analiza logliniowa zamiast regresji logistycznej przy wyraźnej zmiennej wyniku. Wynik bywa ten sam, ale OR z modelu logistycznego łatwiej opisać czytelnikowi.
Klasyczne, pełniejsze omówienie modeli logliniowych dla tabel wielodzielczych znajdziesz w monografii Bishop, Fienberga i Hollanda (2007).
Najczęstsze pytania
Czym różni się analiza logliniowa od testu chi-kwadrat?
Test χ² sprawdza niezależność dwóch zmiennych w jednej tabeli. Analiza logliniowa obejmuje trzy i więcej zmiennych naraz, pozwala sprawdzić niezależność warunkową i interakcję trzech zmiennych oraz porównywać modele. W tabeli dwudzielczej G² modelu niezależności jest odpowiednikiem testu χ² niezależności opartym na ilorazie wiarygodności.
Jak czytać zapis [PS][SL] w analizie logliniowej?
Nawiasy podają najwyższe interakcje w modelu hierarchicznym. [PS][SL] zawiera interakcje P × S i S × L oraz efekty wszystkich trzech zmiennych, ale nie zawiera interakcji P × L ani P × S × L. Oznacza to, że P i L są niezależne warunkowo przy ustalonym S.
Jak przeliczyć parametr λ na iloraz szans?
Przy kodowaniu zero-jedynkowym, jak w glm() w R, warunkowy OR = exp(λ). Przy kodowaniu efektów, w którym parametry sumują się do zera, w tabeli 2 × 2 OR = exp(4λ). Sprawdź w dokumentacji programu, którego kodowania używa.
Czy analizę logliniową można zrobić w regresji Poissona?
Tak. Ustaw dane w formacie „jedna komórka tabeli = jeden wiersz” z liczebnością jako zmienną zależną i dopasuj glm() z rodziną Poissona. Dewiancja resztowa jest wtedy równa G² modelu logliniowego, a różnice dewiancji dają testy kolejnych interakcji.
Kiedy lepiej użyć regresji logistycznej niż analizy logliniowej?
Gdy jedna zmienna jest wynikiem, a pozostałe jej predyktorami, zwłaszcza jeśli część predyktorów jest ciągła. Model logistyczny daje wtedy te same OR co odpowiadający mu model logliniowy, ale wyniki łatwiej opisać. Analiza logliniowa zostaje dla pytań o strukturę związków między równorzędnymi zmiennymi.
Powiązane hasła
Przeczytaj też
Test chi-kwadrat krok po kroku
Test zgodności i niezależności na jednym badaniu: odsetki, liczebności oczekiwane, reszty, V Craméra, test Fishera i gotowy opis APA.
Czytaj →PoradnikRegresja logistyczna krok po kroku
Ilorazy szans i prawdopodobieństwa przewidywane, założenia, separacja, pseudo-R², AUC i kalibracja, tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikRegresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →Analizujesz tabelę z trzema lub więcej zmiennymi kategorialnymi?
Pomożemy dobrać model logliniowy albo logistyczny, sprawdzić rzadkie komórki, policzyć warunkowe ilorazy szans z przedziałami ufności i opisać wyniki tak, żebyś mógł(a) je samodzielnie obronić przed recenzentem.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Agresti, A. (2013). Categorical data analysis (3rd ed.). Wiley.
- Birch, M. W. (1963). Maximum likelihood in three-way contingency tables. Journal of the Royal Statistical Society: Series B (Methodological), 25(1), 220–233. https://doi.org/10.1111/j.2517-6161.1963.tb00504.x
- Bishop, Y. M. M., Fienberg, S. E., & Holland, P. W. (2007). Discrete multivariate analysis: Theory and practice. Springer. https://doi.org/10.1007/978-0-387-72806-3
- Derksen, S., & Keselman, H. J. (1992). Backward, forward and stepwise automated subset selection algorithms: Frequency of obtaining authentic and noise variables. British Journal of Mathematical and Statistical Psychology, 45(2), 265–282. https://doi.org/10.1111/j.2044-8317.1992.tb00992.x
- Goodman, L. A. (1970). The multivariate analysis of qualitative data: Interactions among multiple classifications. Journal of the American Statistical Association, 65(329), 226–256. https://doi.org/10.1080/01621459.1970.10481076
- Goodman, L. A. (1971). The analysis of multidimensional contingency tables: Stepwise procedures and direct estimation methods for building models for multiple classifications. Technometrics, 13(1), 33–61. https://doi.org/10.1080/00401706.1971.10488753
- Kievit, R. A., Frankenhuis, W. E., Waldorp, L. J., & Borsboom, D. (2013). Simpson's paradox in psychological science: A practical guide. Frontiers in Psychology, 4, Article 513. https://doi.org/10.3389/fpsyg.2013.00513 ● Otwarty dostęp
- Mantel, N., & Haenszel, W. (1959). Statistical aspects of the analysis of data from retrospective studies of disease. Journal of the National Cancer Institute, 22(4), 719–748. https://doi.org/10.1093/jnci/22.4.719
- Nelder, J. A., & Wedderburn, R. W. M. (1972). Generalized linear models. Journal of the Royal Statistical Society: Series A (General), 135(3), 370–384. https://doi.org/10.2307/2344614
- Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
Cytowania BibTeX
@book{agresti2013categorical, author={Agresti, Alan}, title={{Categorical data analysis (3rd ed.)}}, year={2013}, publisher={Wiley}, url={https://openlibrary.org/books/OL25290020M}}@article{birch1963maximum, author={Birch, M. W.}, title={{Maximum likelihood in three-way contingency tables}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1963}, volume={25}, number={1}, pages={220--233}, doi={10.1111/j.2517-6161.1963.tb00504.x}}@book{bishop2007discrete, author={Bishop, Yvonne M. M. and Fienberg, Stephen E. and Holland, Paul W.}, title={{Discrete multivariate analysis: Theory and practice}}, year={2007}, publisher={Springer}, doi={10.1007/978-0-387-72806-3}}@article{derksen1992backward, author={Derksen, Shelley and Keselman, H. J.}, title={{Backward, forward and stepwise automated subset selection algorithms: Frequency of obtaining authentic and noise variables}}, journal={British Journal of Mathematical and Statistical Psychology}, year={1992}, volume={45}, number={2}, pages={265--282}, doi={10.1111/j.2044-8317.1992.tb00992.x}}@article{goodman1970multivariate, author={Goodman, Leo A.}, title={{The multivariate analysis of qualitative data: Interactions among multiple classifications}}, journal={Journal of the American Statistical Association}, year={1970}, volume={65}, number={329}, pages={226--256}, doi={10.1080/01621459.1970.10481076}}@article{goodman1971analysis, author={Goodman, Leo A.}, title={{The analysis of multidimensional contingency tables: Stepwise procedures and direct estimation methods for building models for multiple classifications}}, journal={Technometrics}, year={1971}, volume={13}, number={1}, pages={33--61}, doi={10.1080/00401706.1971.10488753}}@article{kievit2013simpson, author={Kievit, Rogier A. and Frankenhuis, Willem E. and Waldorp, Lourens J. and Borsboom, Denny}, title={{Simpson's paradox in psychological science: A practical guide}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={513}, doi={10.3389/fpsyg.2013.00513}}@article{mantel1959statistical, author={Mantel, Nathan and Haenszel, William}, title={{Statistical aspects of the analysis of data from retrospective studies of disease}}, journal={Journal of the National Cancer Institute}, year={1959}, volume={22}, number={4}, pages={719--748}, doi={10.1093/jnci/22.4.719}}@article{nelder1972generalized, author={Nelder, J. A. and Wedderburn, R. W. M.}, title={{Generalized linear models}}, journal={Journal of the Royal Statistical Society: Series A (General)}, year={1972}, volume={135}, number={3}, pages={370--384}, doi={10.2307/2344614}}@book{venables2002modern, author={Venables, W. N. and Ripley, B. D.}, title={{Modern applied statistics with S (4th ed.)}}, year={2002}, publisher={Springer}, doi={10.1007/978-0-387-21706-2}}