Co to jest wykres mozaikowy?
Wykres mozaikowy (ang. mosaic plot) przedstawia tabelę krzyżową jako prostokąt podzielony na kafelki, których pole jest proporcjonalne do liczebności komórek. Prostokąt dzieli się najpierw według jednej zmiennej (szerokość kolumny = liczebność grupy), a potem każdą kolumnę według drugiej (wysokość kafelka = odsetek w tej grupie). Friendly (1994) pokazał, że taki wykres łatwo uogólnia się na tabele wielodzielcze, i zaproponował barwienie kafelków według znaku i wielkości reszt z modelu niezależności.
Jak czytać wykres mozaikowy
- Szerokość kolumny – liczebność grupy; wąska kolumna to mała grupa.
- Wysokość kafelka – odsetek kategorii w danej grupie, jak w słupku 100% na wykresie słupkowym, ale z widoczną liczebnością.
- Niezależność – gdy zmienne nie są związane, poziome granice kafelków biegną w jednej linii przez wszystkie kolumny. Rozjechane granice to związek.
- Kolor i ramka – reszta Pearsona (O − E)/√E: niebieski kafelek z ciągłą ramką to więcej obserwacji, niż oczekiwano przy braku związku, cynobrowy z przerywaną – mniej, szary – odchylenie małe.
Przykład
Zbiór Arthritis z pakietu vcd opisuje 84 pacjentów z reumatoidalnym zapaleniem stawów, którzy w badaniu klinicznym dostali lek albo placebo; poprawę oceniono jako brak, pewną lub wyraźną. Wyraźną poprawę miało 51.2% osób z grupy leku i 16.3% z grupy placebo, brak poprawy – 31.7% i 67.4%. Test chi-kwadrat niezależności dał χ²(2, N = 84) = 13.06, p = .001, a V Craméra = .39.
Na rysunku
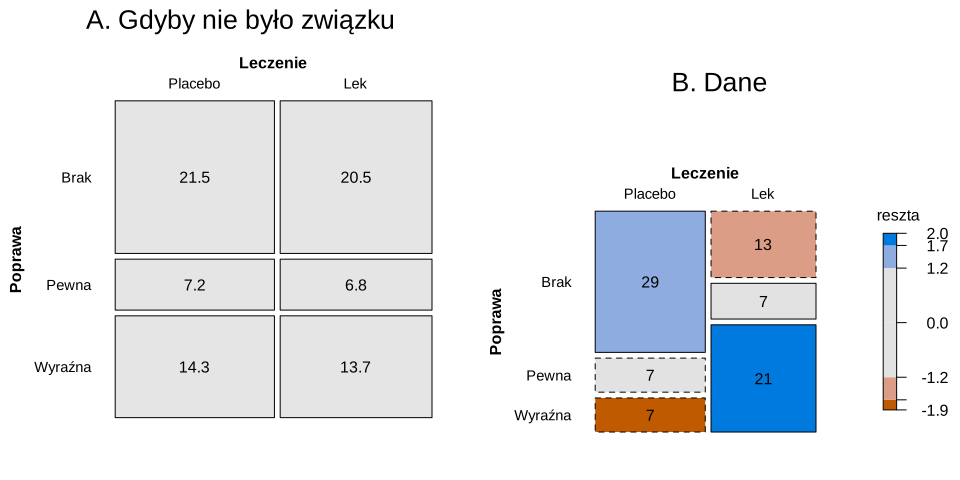
Arthritis, set.seed(744) dla testu permutacyjnego).Co widać. W panelu A (brak związku) granice kafelków biegną w jednej linii, w panelu B się rozjeżdżają – w kolumnie placebo największy jest kafelek „brak” (29 osób), w kolumnie leku – „wyraźna” (21). Barwy pochodzą z cieniowania opartego na teście maksimum reszt (Zeileis i in., 2007): pełna barwa, gdy |reszta| przekracza 99. percentyl rozkładu permutacyjnego (1.71), jasna – 90. percentyl (1.21). Test maksimum dał p = .001.
Na co uważać. Mozaika nie pokazuje niepewności odsetków, a pola porównuje się trudniej niż długości – odsetki podaj w tabeli. Kolejność dzielenia zmienia pytanie: tu widać rozkład poprawy w grupach leczenia, a nie odwrotnie.
Podpis do pracy:
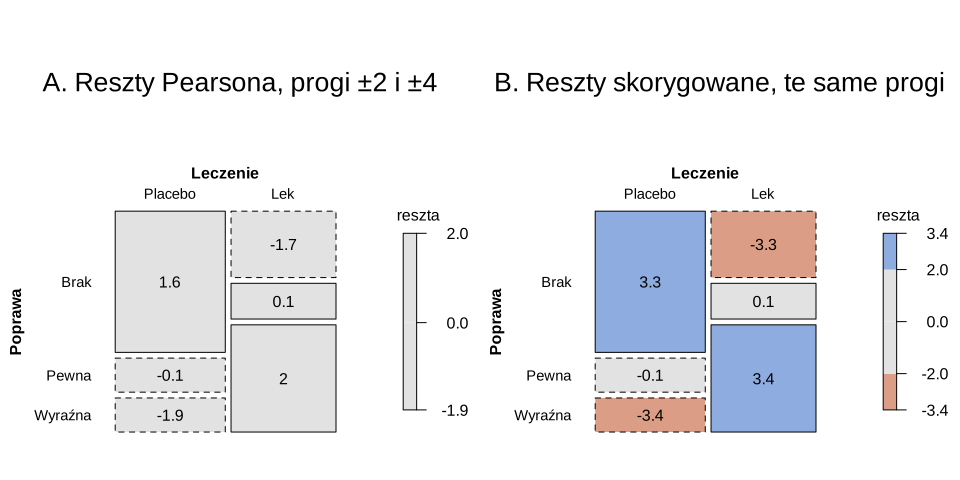
Arthritis).Co widać. Przy progach ±2 i ±4 reszty Pearsona (najwyżej 1.98) nie barwią żadnego kafelka, choć test χ² jest istotny. Reszty standaryzowane skorygowane – dzielone dodatkowo przez pierwiastek z iloczynu (1 − udział wiersza)(1 − udział kolumny) – wynoszą ±3.27 i ±3.40 i barwią cztery kafelki.
Na co uważać. Szara mozaika nie oznacza braku związku. Próg 2 pasuje do reszt skorygowanych, które przy niezależności mają w przybliżeniu rozkład normalny standardowy; dla reszt Pearsona jest zbyt surowy. W podpisie zawsze napisz, które reszty i jakie progi zastosowano.
Podpis do pracy:
Jak opisać w pracy
Na co uważać
- Kolor bez opisu. Meyer, Zeileis i Hornik (2006) opisują w pakiecie vcd wiele wariantów cieniowania i legendy – podaj, którego użyto.
- Mozaika zamiast testu. Wykres pokazuje, gdzie leży związek; wniosek opiera się na teście i wielkości efektu.
- Zbyt wiele zmiennych. Przy trzech i więcej zmiennych kafelki szybko stają się kreskami; złożone układy lepiej modelować analizą logliniową.
- Zmienna porządkowa w przypadkowej kolejności. Kategorie takie jak stopień poprawy ustaw w naturalnym porządku, inaczej wzór związku się rozmywa.
Mozaikę narysowaną ręcznie w ggplot2 obok słupków, mapy reszt i odsetków z przedziałami ufności pokazuje wpis Tabela krzyżowa na wykresie.
Wykres mozaikowy w R
Kod liczy test χ², obie odmiany reszt i permutacyjny test maksimum reszt, a następnie rysuje rysunki 1 i 2 funkcją mosaic() z pakietu vcd. Rysunki na stronie powstały z tych samych funkcji rysunek1() i rysunek2(). Ziarno 744 ustalono raz i nie zmieniano; dane są wbudowane w pakiet. Najprostszy wykres mozaikowy rysuje też bazowa funkcja mosaicplot().
Rysunki 1 i 2: mozaika z cieniowaniem reszt
R
# Wykres mozaikowy tabeli 2 × 3: leczenie a poprawa (wbudowany zbiór Arthritis z pakietu vcd, N = 84)
suppressPackageStartupMessages({library(vcd); library(grid)})
tab <- xtabs(~ Treatment + Improved, data = Arthritis)
dimnames(tab) <- list(Leczenie = c("Placebo", "Lek"), Poprawa = c("Brak", "Pewna", "Wyraźna"))
test <- chisq.test(tab)
tab                                    # liczebności obserwowane
round(100 * prop.table(tab, 1), 1)     # odsetki w wierszach (szerokość kolumn mozaiki = liczebność grup)
round(test$expected, 1)                # oczekiwane przy braku związku
round(test$residuals, 2)               # reszty Pearsona (O − E)/√E
round(test$stdres, 2)                  # reszty standaryzowane skorygowane
round(c(chi2 = unname(test$statistic), df = unname(test$parameter), p = test$p.value,
        V = assocstats(tab)$cramer), 4)
set.seed(744)                          # test permutacyjny maksimum |reszt Pearsona|
maks <- coindep_test(tab, n = 5000)
maks
odcinanie <- c(0.90, 0.99)             # progi kolorów w shading_max: kwantyle rozkładu permutacyjnego
round(quantile(maks$dist, odcinanie), 2)
# odcienie zbliżone do Okabe–Ito (niebieski = więcej niż oczekiwano, cynobrowy = mniej);
# znak reszty niesie też ramka: ciągła dla dodatniej, przerywana dla ujemnej
kolory <- list(h = c(250, 30), lty = 1:2, n = 5000, level = odcinanie)
etykiety <- function(typ) labeling_values(value_type = typ, digits = 1, suppress = 0,   # liczby w kafelkach
  gp_labels = gpar(fontsize = 11), gp_varnames = gpar(fontsize = 12, fontface = "bold"),
  rot_labels = c(left = 0), just_labels = c(left = "right"), offset_varnames = c(left = 3.2),
  offset_labels = c(left = 0.3))
panel <- function(kolumna, rysuj) {
  pushViewport(viewport(layout.pos.col = kolumna)); rysuj(); popViewport()
}
rysunek1 <- function() {               # A: oczekiwane przy niezależności, B: obserwowane z cieniowaniem reszt
  grid.newpage(); pushViewport(viewport(layout = grid.layout(1, 2)))
  panel(1, function() mosaic(tab, split_vertical = TRUE, margins = c(left = 6), type = "expected", newpage = FALSE, gp = gpar(fill = "grey90"),
                             main = "A. Gdyby nie było związku", labeling = etykiety("expected")))
  set.seed(744)                        # shading_max ponownie losuje permutacje
  panel(2, function() mosaic(tab, split_vertical = TRUE, margins = c(left = 6), newpage = FALSE, gp = shading_max, gp_args = kolory,
                             main = "B. Dane", labeling = etykiety("observed"),
                             legend = legend_resbased(text = "reszta", pvalue = FALSE)))
  popViewport()
}
rysunek2 <- function() {               # te same dane: zwykłe progi ±2 i ±4 dla reszt Pearsona i dla skorygowanych
  grid.newpage(); pushViewport(viewport(layout = grid.layout(1, 2)))
  panel(1, function() mosaic(tab, split_vertical = TRUE, margins = c(left = 6), newpage = FALSE, gp = shading_hcl, gp_args = list(h = c(250, 30), lty = 1:2),
                             main = "A. Reszty Pearsona, progi ±2 i ±4", labeling = etykiety("residuals"),
                             legend = legend_resbased(text = "reszta", pvalue = FALSE)))
  panel(2, function() mosaic(tab, split_vertical = TRUE, margins = c(left = 6), newpage = FALSE, residuals = test$stdres, gp = shading_hcl,
                             gp_args = list(h = c(250, 30), lty = 1:2), main = "B. Reszty skorygowane, te same progi",
                             labeling = etykiety("residuals"),
                             legend = legend_resbased(text = "reszta", pvalue = FALSE)))
  popViewport()
}
rysunek1()
rysunek2()
Wynik w R
         Poprawa
Leczenie  Brak Pewna Wyraźna
  Placebo   29     7       7
  Lek       13     7      21
         Poprawa
Leczenie  Brak Pewna Wyraźna
  Placebo 67.4  16.3    16.3
  Lek     31.7  17.1    51.2
         Poprawa
Leczenie  Brak Pewna Wyraźna
  Placebo 21.5   7.2    14.3
  Lek     20.5   6.8    13.7
         Poprawa
Leczenie   Brak Pewna Wyraźna
  Placebo  1.62 -0.06   -1.94
  Lek     -1.66  0.06    1.98
         Poprawa
Leczenie   Brak Pewna Wyraźna
  Placebo  3.27 -0.10   -3.40
  Lek     -3.27  0.10    3.40
   chi2      df       p       V
13.0550  2.0000  0.0015  0.3942

	Permutation test for conditional independence

data:  tab
f(x) = 1.9837, p-value = 0.0014

 90%  99%
1.21 1.71
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe xtabs(), chisq.test(), pakiet grid; rysunki 1 i 2 – pakiet vcd). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- vcd (wersja 1.4.13): Meyer, D., Zeileis, A., Hornik, K., & Friendly, M. (2024). vcd: Visualizing categorical data [R package]. https://doi.org/10.32614/CRAN.package.vcd
Najczęstsze pytania
Czym wykres mozaikowy różni się od skumulowanych słupków 100%?
Słupki 100% mają jednakową szerokość, więc ukrywają liczebność grup. W mozaice szerokość kolumny odpowiada liczebności grupy, dlatego pole kafelka pokazuje liczbę osób w komórce, a nie tylko odsetek.
Co oznaczają kolory na wykresie mozaikowym?
Zwykle znak i wielkość reszty z modelu niezależności: jeden kolor dla komórek z nadwyżką obserwacji, drugi dla komórek z niedoborem, szary dla małych odchyleń. Progi barw zależą od rodzaju reszt (Pearsona czy skorygowanych), dlatego trzeba je podać w podpisie.
Jak narysować wykres mozaikowy w R?
Najprościej funkcją mosaic() z pakietu vcd (argument shade = TRUE dodaje cieniowanie resztami) albo bazową funkcją mosaicplot(). Mozaikę można też zbudować ręcznie w ggplot2 z prostokątów geom_rect().
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Tabela krzyżowa na wykresie
Słupki 100% w wierszach i kolumnach, mozaika, mapa reszt χ² z korektą i odsetki z CI – jedna tabela 3 × 4, pięć rysunków z R, podpisy APA.
Czytaj →PoradnikTest chi-kwadrat krok po kroku
Test zgodności i niezależności na jednym badaniu: odsetki, liczebności oczekiwane, reszty, V Craméra, test Fishera i gotowy opis APA.
Czytaj →PoradnikChi-kwadrat i tabele krzyżowe – zadania z rozwiązaniami
Dziesięć zadań z testu χ²: zgodność, tabele krzyżowe, reszty skorygowane, φ i V, Yates, małe liczności, test trendu i paradoks Simpsona – krok po kroku.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Friendly, M. (1994). Mosaic displays for multi-way contingency tables. Journal of the American Statistical Association, 89(425), 190–200. https://doi.org/10.1080/01621459.1994.10476460
- Meyer, D., Zeileis, A., & Hornik, K. (2006). The strucplot framework: Visualizing multi-way contingency tables with vcd. Journal of Statistical Software, 17(3). https://doi.org/10.18637/jss.v017.i03 ● Otwarty dostęp
- Zeileis, A., Meyer, D., & Hornik, K. (2007). Residual-based shadings for visualizing (conditional) independence. Journal of Computational and Graphical Statistics, 16(3), 507–525. https://doi.org/10.1198/106186007x237856
Cytowania BibTeX
@article{friendly1994mosaic, author={Friendly, Michael}, title={{Mosaic displays for multi-way contingency tables}}, journal={Journal of the American Statistical Association}, year={1994}, volume={89}, number={425}, pages={190--200}, doi={10.1080/01621459.1994.10476460}}@article{meyer2006strucplot, author={Meyer, David and Zeileis, Achim and Hornik, Kurt}, title={{The strucplot framework: Visualizing multi-way contingency tables with vcd}}, journal={Journal of Statistical Software}, year={2006}, volume={17}, number={3}, doi={10.18637/jss.v017.i03}}@article{zeileis2007residual, author={Zeileis, Achim and Meyer, David and Hornik, Kurt}, title={{Residual-based shadings for visualizing (conditional) independence}}, journal={Journal of Computational and Graphical Statistics}, year={2007}, volume={16}, number={3}, pages={507--525}, doi={10.1198/106186007x237856}}