Co to jest test MCAR Little’a?
Test MCAR Little’a (ang. Little’s MCAR test) sprawdza hipotezę zerową, że braki danych są całkowicie losowe (MCAR), czyli nie zależą ani od wartości obserwowanych, ani od brakujących. Little (1988) zaproponował jedną globalną statystykę zamiast wielu skorelowanych testów t porównujących osoby z brakami i bez braków. Mechanizmy MCAR, MAR i MNAR opisujemy w haśle braki danych.
Jak działa test
Dane dzieli się na wzorce braków (grupy osób z tym samym zestawem brakujących zmiennych). Dla każdego wzorca test porównuje średnie zmiennych obserwowanych z oszacowaniami dla całej próby, uzyskanymi algorytmem EM. Ważone odległości sumuje się do statystyki d², która przy MCAR ma w przybliżeniu rozkład chi-kwadrat z liczbą stopni swobody równą sumie liczby zmiennych obserwowanych we wzorcach minus liczba zmiennych. Test jest przeznaczony dla zmiennych ilościowych (Li, 2013).
Przykład
W danych symulowanych brak wyniku depresji zależał od lęku (MAR), a wsparcie społeczne nie miało braków. Przy 50 osobach test dał χ²(2) = 3.91, p = .142, a przy 500 osobach przy tym samym mechanizmie χ²(2) = 6.99, p = .030. Wynik nieistotny w małej próbie nie oznaczał więc MCAR, tylko małą moc.
Na rysunku
Rysunek 1 pokazuje, co test porównuje (panel A, dane z przykładu przy n = 500) i jak często wykrywa ten sam mechanizm MAR przy różnych liczebnościach (panel B, symulacja). Liczebności w panelu B wybrano ręcznie; drugie ziarno (6091) ustalono raz i nie zmieniano.
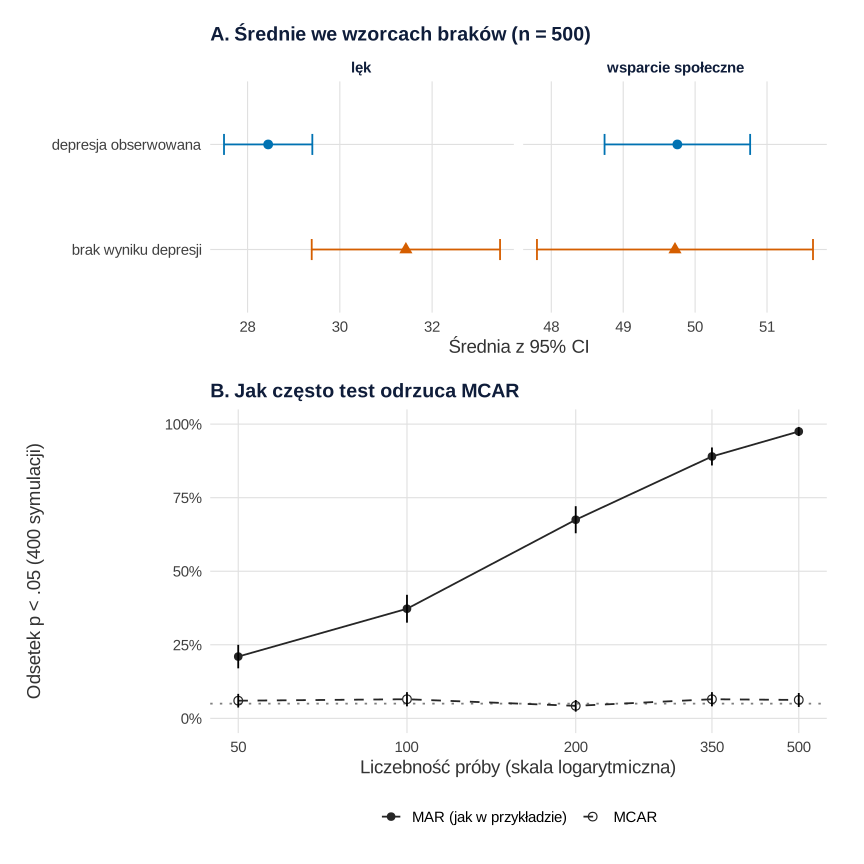
set.seed(609) i set.seed(6091)).Co widać. W panelu A osoby bez wyniku depresji mają wyższy lęk (31.4 wobec 28.4), a wsparcie społeczne w obu wzorcach jest takie samo. Właśnie takie różnice średnich między wzorcami test sumuje w statystykę χ², tu χ²(2) = 6.99, p = .030. Panel B pokazuje moc testu: przy tym samym mechanizmie MAR wykrywa go 21.0% badań z 50 osobami, 67.5% z 200 i 97.5% z 500. Gdy braki są naprawdę MCAR, odsetek odrzuceń leży blisko 5% (4.3–6.5%; błąd Monte Carlo około 1 punktu procentowego).
Na co uważać. Panel B to jeden konkretny mechanizm: około 18–19% braków, umiarkowany związek braku z lękiem. Przy słabszym związku krzywa MAR rośnie wolniej, a przy MNAR zależnym tylko od samej depresji test może nic nie zobaczyć, bo porównuje jedynie zmienne obserwowane. Wykres nie pokazuje też, które zmienne brakują razem w większych zbiorach – do tego służy mapa braków i wykres wzorców, opisane we wpisie braki danych na wykresie.
Podpis do pracy:
Kod rysunku odtwarza dane z przykładu (to samo ziarno 609), a symulację mocy liczy z osobnym ziarnem; wykonanie trwa około 50 sekund. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Co porównuje test Little'a (A) i jak jego moc zależy od liczebności próby (B)
library(naniar)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
kol <- c("depresja obserwowana" = "#0072B2", "brak wyniku depresji" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# Ten sam mechanizm co w przykładzie: brak depresji tym częstszy, im wyższy lęk (MAR)
symuluj <- function(n, mar = TRUE) {
  lek <- rnorm(n, 30, 10)
  depresja <- 0.5 * lek + rnorm(n, 0, 8)
  wsparcie <- rnorm(n, 50, 10)
  p_braku <- if (mar) plogis(-1.5 + 0.05 * (lek - 30)) else rep(plogis(-1.5), n)   # MCAR: stała szansa braku
  depresja[runif(n) < p_braku] <- NA
  data.frame(lek, depresja, wsparcie)
}

# Panel A: dane z przykładu (n = 500; to samo ziarno i kolejność losowań co w przykładzie)
set.seed(609)
invisible(symuluj(50))
d500 <- symuluj(500)
wzorzec <- ifelse(is.na(d500$depresja), "brak wyniku depresji", "depresja obserwowana")
sr <- do.call(rbind, lapply(c("lek", "wsparcie"), function(v) do.call(rbind, lapply(names(kol), function(w) {
  x <- d500[[v]][wzorzec == w]
  data.frame(zmienna = v, wzorzec = w, n = length(x), M = mean(x), lo = mean(x) - 1.96 * sd(x) / sqrt(length(x)),
             hi = mean(x) + 1.96 * sd(x) / sqrt(length(x)))
}))))
print(transform(sr, M = round(M, 1), lo = round(lo, 1), hi = round(hi, 1)), row.names = FALSE)
t500 <- mcar_test(d500)
round(c(chi2 = t500$statistic, df = t500$df, p = t500$p.value), 3)

# Panel B: odsetek odrzuceń H0 (MCAR) w 400 symulacjach na każdą liczebność, przy MAR i przy MCAR
set.seed(6091)                     # osobne ziarno, ustalone raz
R <- 400
ny <- c(50, 100, 200, 350, 500)
moc <- expand.grid(n = ny, mechanizm = c("MAR (jak w przykładzie)", "MCAR"))
moc$odrzucenia <- mapply(function(n, m) mean(replicate(R, mcar_test(symuluj(n, mar = m != "MCAR"))$p.value < .05)),
                         moc$n, as.character(moc$mechanizm))
moc$bladMC <- sqrt(moc$odrzucenia * (1 - moc$odrzucenia) / R)
print(transform(moc, odrzucenia = round(odrzucenia, 3), bladMC = round(bladMC, 3)), row.names = FALSE)

sr$zmienna <- factor(sr$zmienna, levels = c("lek", "wsparcie"), labels = c("lęk", "wsparcie społeczne"))
sr$wzorzec <- factor(sr$wzorzec, levels = rev(names(kol)))
pA <- ggplot(sr, aes(M, wzorzec, colour = wzorzec, shape = wzorzec)) +
  geom_errorbar(aes(xmin = lo, xmax = hi), orientation = "y", width = 0.2) +
  geom_point(size = 3) +
  facet_wrap(~ zmienna, scales = "free_x") +
  scale_colour_manual(values = kol, guide = "none") + scale_shape_manual(values = c(17, 16), guide = "none") +
  labs(title = "A. Średnie we wzorcach braków (n = 500)", x = "Średnia z 95% CI", y = NULL) +
  motyw

pB <- ggplot(moc, aes(n, odrzucenia, linetype = mechanizm, shape = mechanizm)) +
  geom_hline(yintercept = 0.05, colour = "grey50", linetype = "dotted") +
  geom_line(colour = "grey15") + geom_point(size = 2.6, colour = "grey15") +
  geom_errorbar(aes(ymin = odrzucenia - 1.96 * bladMC, ymax = odrzucenia + 1.96 * bladMC), width = 0, linetype = 1) +
  scale_x_continuous(trans = "log10", breaks = ny) +
  scale_y_continuous(limits = c(0, 1), labels = function(x) paste0(100 * x, "%")) +
  scale_shape_manual(values = c(16, 1), name = NULL) + scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  labs(title = "B. Jak często test odrzuca MCAR", x = "Liczebność próby (skala logarytmiczna)",
       y = "Odsetek p < .05 (400 symulacji)") +
  motyw

p <- pA / pB + plot_layout(heights = c(1, 1.4))
p
Wynik w R
  zmienna              wzorzec   n    M   lo   hi
      lek depresja obserwowana 404 28.4 27.5 29.4
      lek brak wyniku depresji  96 31.4 29.4 33.5
 wsparcie depresja obserwowana 404 49.8 48.7 50.8
 wsparcie brak wyniku depresji  96 49.7 47.8 51.6
 chi2    df     p
6.994 2.000 0.030
   n               mechanizm odrzucenia bladMC
  50 MAR (jak w przykładzie)      0.210  0.020
 100 MAR (jak w przykładzie)      0.372  0.024
 200 MAR (jak w przykładzie)      0.675  0.023
 350 MAR (jak w przykładzie)      0.890  0.016
 500 MAR (jak w przykładzie)      0.975  0.008
  50                    MCAR      0.060  0.012
 100                    MCAR      0.065  0.012
 200                    MCAR      0.043  0.010
 350                    MCAR      0.065  0.012
 500                    MCAR      0.062  0.012
Jak opisać w pracy
Na co uważać
Brak odrzucenia hipotezy nie jest dowodem MCAR. Test nie odróżnia też MAR od MNAR: mechanizmu zależnego od samych brakujących wartości nie da się sprawdzić na podstawie danych. Jamshidian i Jalal (2010) zwracają uwagę, że testy MCAR wymagają dużych prób (także w poszczególnych wzorcach braków) i często zawodzą przy danych nienormalnych. Wynik testu nie powinien więc sam decydować o usuwaniu przypadków. Bezpieczniejszym domyślnym wyborem jest imputacja wielokrotna lub FIML ze zmiennymi związanymi z brakami, a nie proste imputacje. Pełną diagnozę braków w R pokazujemy we wpisie braki danych i imputacja wielokrotna w R.
Test MCAR Little’a w R
Kod symuluje braki MAR w jednej zmiennej przy dwóch liczebnościach próby i wykonuje test funkcją naniar::mcar_test().
Ten sam mechanizm MAR przy n = 50 i n = 500
R
# Test MCAR Little'a: braki MAR przy małej i dużej próbie
library(naniar)
set.seed(609)
symuluj <- function(n) {
  lek <- rnorm(n, 30, 10)
  depresja <- 0.5 * lek + rnorm(n, 0, 8)
  wsparcie <- rnorm(n, 50, 10)
  # MAR: im wyższy lęk, tym częściej brak wyniku depresji
  p_braku <- plogis(-1.5 + 0.05 * (lek - 30))
  depresja[runif(n) < p_braku] <- NA
  data.frame(lek, depresja, wsparcie)
}
wyniki <- lapply(c(50, 500), function(n) {
  d <- symuluj(n)
  t <- mcar_test(d)
  data.frame(n = n, braki_proc = round(100 * mean(is.na(d$depresja)), 1),
             chi2 = round(t$statistic, 2), df = t$df,
             p = round(t$p.value, 4), wzorce = t$missing.patterns)
})
do.call(rbind, wyniki)
Wynik w R
    n braki_proc chi2 df      p wzorce
1  50       18.0 3.91  2 0.1416      2
2 500       19.2 6.99  2 0.0303      2
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem naniar 1.1.0. Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- naniar (wersja 1.1.0): Tierney, N., & Cook, D. (2023). Expanding tidy data principles to facilitate missing data exploration, visualization and assessment of imputations. Journal of Statistical Software, 105(7), 1–31. https://doi.org/10.18637/jss.v105.i07
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Co oznacza nieistotny wynik testu MCAR Little’a?
Tylko tyle, że dane nie dały podstaw do odrzucenia MCAR. Przy małej próbie lub niewielu osobach w niektórych wzorcach braków test ma małą moc, więc nie traktuj takiego wyniku jako dowodu, że braki są całkowicie losowe.
Czy test Little’a odróżnia braki MAR od MNAR?
Nie. Test sprawdza tylko hipotezę MCAR. Braki MNAR zależą od wartości, których nie zaobserwowano, więc żaden test na samych danych tego nie rozstrzygnie – pomaga analiza wrażliwości.
Jak wykonać test MCAR Little’a w R?
Najprościej funkcją mcar_test() z pakietu naniar, podając ramkę danych ze zmiennymi ilościowymi. Funkcja zwraca statystykę chi-kwadrat, stopnie swobody, wartość p i liczbę wzorców braków.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Braki danych i imputacja wielokrotna w R
MCAR, MAR i MNAR, test Little’a, symulacja metod i imputacja wielokrotna w R krok po kroku – z kodem, regułami Rubina i gotowym opisem APA.
Czytaj →PoradnikBraki danych w ankiecie – co zrobić?
Jak policzyć braki, kiedy wystarczy reguła proporcjonalna, jak sprawdzić osoby, które przerwały ankietę, i jak opisać braki w pracy.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Jamshidian, M., & Jalal, S. (2010). Tests of homoscedasticity, normality, and missing completely at random for incomplete multivariate data. Psychometrika, 75(4), 649–674. https://doi.org/10.1007/s11336-010-9175-3 ● Otwarty dostęp: pełny tekst
- Li, C. (2013). Little’s test of missing completely at random. The Stata Journal, 13(4), 795–809. https://doi.org/10.1177/1536867x1301300407 ● Otwarty dostęp
- Little, R. J. A. (1988). A test of missing completely at random for multivariate data with missing values. Journal of the American Statistical Association, 83(404), 1198–1202. https://doi.org/10.1080/01621459.1988.10478722
Cytowania BibTeX
@article{jamshidian2010tests, author={Jamshidian, Mortaza and Jalal, Siavash}, title={{Tests of homoscedasticity, normality, and missing completely at random for incomplete multivariate data}}, journal={Psychometrika}, year={2010}, volume={75}, number={4}, pages={649--674}, doi={10.1007/s11336-010-9175-3}}@article{li2013little, author={Li, Cheng}, title={{Little’s test of missing completely at random}}, journal={The Stata Journal}, year={2013}, volume={13}, number={4}, pages={795--809}, doi={10.1177/1536867x1301300407}}@article{little1988test, author={Little, Roderick J. A.}, title={{A test of missing completely at random for multivariate data with missing values}}, journal={Journal of the American Statistical Association}, year={1988}, volume={83}, number={404}, pages={1198--1202}, doi={10.1080/01621459.1988.10478722}}