Co to jest imputacja hot-deck?
Imputacja hot-deck (ang. hot deck imputation) zastępuje brakującą wartość wartością zaobserwowaną u „podobnej” osoby z tego samego zbioru, zwanej dawcą (Andridge i Little, 2010). Osoba z brakiem to biorca. Ponieważ wstawiane są prawdziwe odpowiedzi, imputowane wartości mieszczą się w zakresie skali i zachowują kształt rozkładu – inaczej niż średnia wstawiana każdemu z prostych imputacji. Nazwa pochodzi z czasów kart perforowanych; „cold deck” to dawca z innego, wcześniejszego zbioru.
Odmiany
- losowy hot-deck w klasach – osoby dzieli się na klasy imputacyjne (np. płeć × wiek), a dawcę losuje się z tej samej klasy;
- najbliższy sąsiad – dawcą jest osoba najbliższa biorcy według miary odległości na zmiennych pomocniczych;
- sekwencyjny – dawcą jest poprzedni przypadek w posortowanym pliku.
Andridge i Little (2010) opisują te warianty, m.in. hot-deck stosowany przez U.S. Census Bureau w badaniu CPS, i podkreślają, że nie ma zgody, jak najlepiej go stosować i wnioskować z uzupełnionych danych.
Przykład
W danych symulowanych 78 z 400 osób nie podało dochodu, częściej w wieku 50+. Prawdziwa średnia wynosiła 4302.8 zł (SD = 1234.6). Pełne przypadki dały 4233.1 zł, imputacja średnią – tę samą średnią i zaniżone SD = 1108.1, a losowy hot-deck w klasach płeć × wiek – 4325.7 zł i SD = 1247.3.
Na rysunku
Rysunek 1 pokazuje dane z przykładu trzy razy: z prawdziwymi dochodami 78 osób, które ich nie podały (znanymi tylko w symulacji), po imputacji średnią i po losowym hot-decku w klasach.
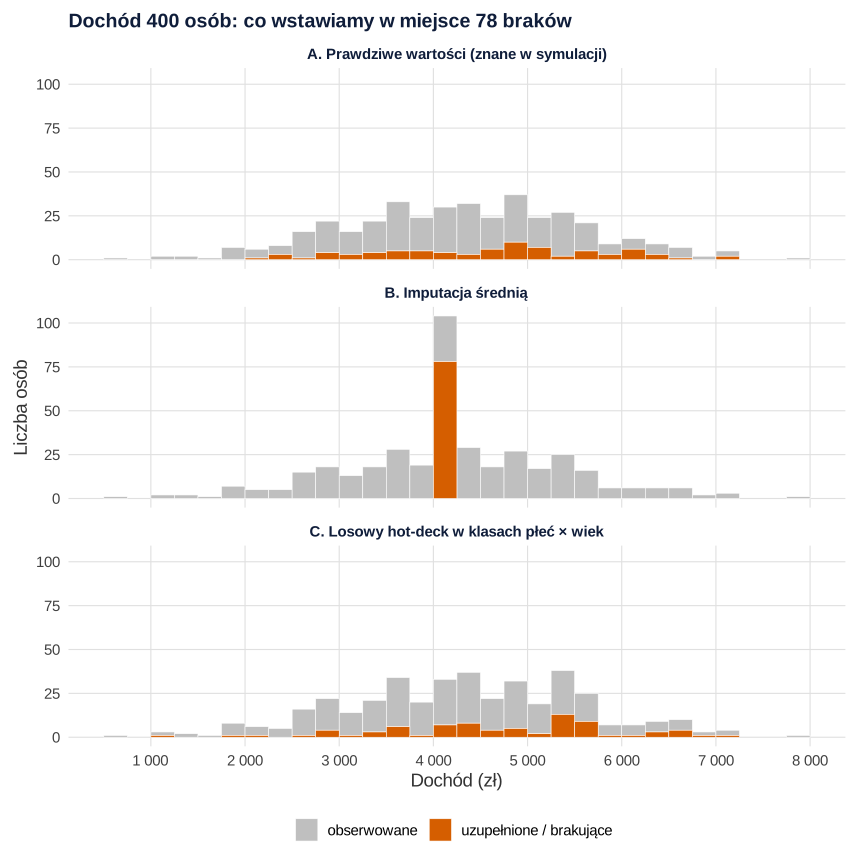
set.seed(610)).Co widać. Imputacja średnią wstawia wszystkim 78 osobom tę samą wartość, 4233.1 zł, i tworzy w środku rozkładu sztuczny szczyt. Stąd zaniżone SD z przykładu. Hot-deck wstawia prawdziwe odpowiedzi dawców, więc pomarańczowe wartości rozkładają się podobnie jak prawdziwe dochody tych osób: średnia 4707.8 zł i SD = 1230.7 wobec prawdziwych 4590.3 zł i 1196.7. Średnia wstawiona jest wyższa od średniej pełnych przypadków, bo dawców losowano w obrębie klas wieku, a braki dotyczyły głównie osób 50+.
Na co uważać. Podobny kształt histogramu nie oznacza, że każda osoba dostała swój prawdziwy dochód – wartości są wylosowane, a 78 brakom przypisano tylko 63 różne wartości, bo niektórzy dawcy zostali użyci kilka razy. Przy małych klasach jeden dawca może się powtarzać wielokrotnie. Rysunek nie pokazuje też niepewności: pojedynczy hot-deck daje jeden z wielu możliwych zbiorów, dlatego błędy standardowe trzeba liczyć z wielu powtórzeń. Inne wykresy do oceny braków przed imputacją zebraliśmy we wpisie braki danych na wykresie.
Podpis do pracy:
Kod rysunku odtwarza dane i hot-deck z przykładu (to samo ziarno 610 i ta sama kolejność losowań, bez części z pakietem VIM). Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Rozkład dochodu: prawdziwe wartości, imputacja średnią i losowy hot-deck w klasach
library(ggplot2)

# Paleta Okabe–Ito i prosty motyw
kol <- c("obserwowane" = "grey75", "uzupełnione / brakujące" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# Te same dane i ten sam hot-deck co w przykładzie (to samo ziarno i kolejność losowań)
set.seed(610)
n <- 400
plec <- sample(c("K", "M"), n, replace = TRUE)
wiek <- sample(c("18-29", "30-49", "50+"), n, replace = TRUE)
dochod <- round(3000 + 800 * (plec == "M") + 1200 * (wiek == "30-49") +
                1800 * (wiek == "50+") + rnorm(n, 0, 900))
brak <- runif(n) < ifelse(wiek == "50+", 0.40, 0.10)
obs <- dochod; obs[brak] <- NA
klasa <- interaction(plec, wiek)
hot <- obs
for (k in levels(klasa)) {
  biorcy <- which(klasa == k & is.na(obs))
  dawcy  <- which(klasa == k & !is.na(obs))
  if (length(biorcy) > 0)
    hot[biorcy] <- obs[dawcy[sample.int(length(dawcy), length(biorcy), replace = TRUE)]]
}
srednia_imp <- ifelse(is.na(obs), mean(obs, na.rm = TRUE), obs)

# Trzy wersje tego samego zbioru; wyróżnione są wartości 78 osób z brakiem
panele <- c("A. Prawdziwe wartości (znane w symulacji)", "B. Imputacja średnią", "C. Losowy hot-deck w klasach płeć × wiek")
dl <- data.frame(panel = factor(rep(panele, each = n), levels = panele),
                 dochod = c(dochod, srednia_imp, hot),
                 rodzaj = factor(rep(ifelse(brak, "uzupełnione / brakujące", "obserwowane"), 3), levels = names(kol)))
# Wartości wstawione osobom z brakiem w porównaniu z ich prawdziwymi dochodami
round(rbind(prawdziwe_u_osob_z_brakiem = c(srednia = mean(dochod[brak]), SD = sd(dochod[brak])),
            wstawione_srednia          = c(mean(srednia_imp[brak]), sd(srednia_imp[brak])),
            wstawione_hot_deck         = c(mean(hot[brak]), sd(hot[brak]))), 1)
c(roznych_wartosci_wstawionych_hot_deck = length(unique(hot[brak])), roznych_dawcow_mozliwych = sum(!brak))

p <- ggplot(dl, aes(dochod, fill = rodzaj)) +
  geom_histogram(binwidth = 250, boundary = 0, colour = "white", linewidth = 0.2) +
  facet_wrap(~ panel, ncol = 1) +
  scale_fill_manual(values = kol, name = NULL) +
  scale_x_continuous(breaks = seq(0, 9000, 1000), labels = function(x) format(x, big.mark = " ")) +
  labs(title = "Dochód 400 osób: co wstawiamy w miejsce 78 braków", x = "Dochód (zł)", y = "Liczba osób") +
  motyw
p
Wynik w R
                           srednia     SD
prawdziwe_u_osob_z_brakiem  4590.3 1196.7
wstawione_srednia           4233.1    0.0
wstawione_hot_deck          4707.8 1230.7
roznych_wartosci_wstawionych_hot_deck              roznych_dawcow_mozliwych
                                   63                                   322
Na co uważać
Hot-deck usuwa obciążenie tylko wtedy, gdy klasy imputacyjne obejmują zmienne związane z brakami, czyli przy brakach MAR względem tych zmiennych (zob. braki danych). Pojedyncze uzupełnienie traktuje wstawione wartości jak obserwowane, więc zaniża błędy standardowe. Dlatego hot-deck warto powtórzyć wiele razy i połączyć wyniki jak w imputacji wielokrotnej; pokrewna metoda predictive mean matching (mice, method = "pmm") wybiera dawców według wartości przewidywanych z modelu. Myers (2011) proponuje hot-deck jako praktyczną alternatywę dla usuwania przypadków. Przed imputacją opisz wzorce braków, np. testem MCAR Little’a; o brakach w ankietach piszemy we wpisie braki danych w ankiecie.
Imputacja hot-deck w R
Kod wykonuje losowy hot-deck w klasach imputacyjnych (płeć × wiek) w R bazowym i porównuje go z analizą pełnych przypadków i imputacją średnią. Funkcja VIM::hotdeck() z klasą jako domain_var stosuje ten sam schemat; inne losowanie dawców daje 4337.8 i SD = 1269.0. Pokrewną metodę z pakietu mice pokazano jako komentarz.
Losowy hot-deck w klasach a prostsze metody
R
# Losowy hot-deck w klasach imputacyjnych (R bazowy)
set.seed(610)
n <- 400
plec <- sample(c("K", "M"), n, replace = TRUE)
wiek <- sample(c("18-29", "30-49", "50+"), n, replace = TRUE)
dochod <- round(3000 + 800 * (plec == "M") + 1200 * (wiek == "30-49") +
                1800 * (wiek == "50+") + rnorm(n, 0, 900))
prawdziwa <- mean(dochod)
# MAR: osoby 50+ częściej nie podają dochodu
brak <- runif(n) < ifelse(wiek == "50+", 0.40, 0.10)
obs <- dochod; obs[brak] <- NA

klasa <- interaction(plec, wiek)                 # klasy imputacyjne
hot <- obs
for (k in levels(klasa)) {
  biorcy <- which(klasa == k & is.na(obs))
  dawcy  <- which(klasa == k & !is.na(obs))
  if (length(biorcy) > 0)                        # losujemy dawcę ze zwracaniem
    hot[biorcy] <- obs[dawcy[sample.int(length(dawcy), length(biorcy), replace = TRUE)]]
}
srednia_imp <- ifelse(is.na(obs), mean(obs, na.rm = TRUE), obs)

round(rbind(
  prawdziwe          = c(srednia = prawdziwa, SD = sd(dochod)),
  pelne_przypadki    = c(mean(obs, na.rm = TRUE), sd(obs, na.rm = TRUE)),
  imputacja_srednia  = c(mean(srednia_imp), sd(srednia_imp)),
  hot_deck_w_klasach = c(mean(hot), sd(hot))), 1)
cat("Braki:", sum(brak), "z", n, "\n")
# Ten sam schemat w pakiecie VIM: dawca losowany w obrębie klasy (inne losowanie, więc nieco inne liczby)
library(VIM)
vim <- hotdeck(data.frame(klasa, dochod = obs), variable = "dochod", domain_var = "klasa")
round(c(srednia = mean(vim$dochod), SD = sd(vim$dochod)), 1)
# Pokrewna metoda: mice::mice(dane, method = "pmm") - dawca z najbliższą wartością przewidywaną
Wynik w R
                   srednia     SD
prawdziwe           4302.8 1234.6
pelne_przypadki     4233.1 1235.4
imputacja_srednia   4233.1 1108.1
hot_deck_w_klasach  4325.7 1247.3
Braki: 78 z 400
srednia      SD
 4337.8  1269.0
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem VIM 7.3.1. Rysunek 1 wykonano w pakiecie ggplot2, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- VIM (wersja 7.3.1): Templ, M., Kowarik, A., Alfons, A., Gussenbauer, J., Niederhametner, N., Vattheuer, E., de Cillia, G., & Rannetbauer, W. (2026). VIM: Visualization and imputation of missing values (R package version 7.3.1) [Computer software]. https://doi.org/10.32614/CRAN.package.VIM
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym imputacja hot-deck różni się od imputacji średnią?
Imputacja średnią wstawia wszystkim tę samą wartość, więc zaniża zmienność. Hot-deck wstawia prawdziwe odpowiedzi dawców, dlatego zachowuje zakres skali i kształt rozkładu, a przy dobrze dobranych klasach zmniejsza też obciążenie średniej.
Jak dobrać klasy imputacyjne w hot-decku?
Do klas wybierz zmienne związane zarówno z brakami, jak i z uzupełnianą zmienną, np. wiek i płeć przy dochodzie. Każda klasa musi mieć wystarczająco wielu dawców, inaczej te same osoby będą użyte wielokrotnie.
Czy hot-deck można połączyć z imputacją wielokrotną?
Tak. Losowanie dawców powtarza się wiele razy, analizuje każdy uzupełniony zbiór i łączy wyniki regułami Rubina. Podobnie działa predictive mean matching w pakiecie mice.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Braki danych w ankiecie – co zrobić?
Jak policzyć braki, kiedy wystarczy reguła proporcjonalna, jak sprawdzić osoby, które przerwały ankietę, i jak opisać braki w pracy.
Czytaj →PoradnikBraki danych i imputacja wielokrotna w R
MCAR, MAR i MNAR, test Little’a, symulacja metod i imputacja wielokrotna w R krok po kroku – z kodem, regułami Rubina i gotowym opisem APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Andridge, R. R., & Little, R. J. A. (2010). A review of hot deck imputation for survey non-response. International Statistical Review, 78(1), 40–64. https://doi.org/10.1111/j.1751-5823.2010.00103.x ● Otwarty dostęp: pełny tekst
- Myers, T. A. (2011). Goodbye, listwise deletion: Presenting hot deck imputation as an easy and effective tool for handling missing data. Communication Methods and Measures, 5(4), 297–310. https://doi.org/10.1080/19312458.2011.624490
Cytowania BibTeX
@article{andridge2010review, author={Andridge, Rebecca R. and Little, Roderick J. A.}, title={{A review of hot deck imputation for survey non-response}}, journal={International Statistical Review}, year={2010}, volume={78}, number={1}, pages={40--64}, doi={10.1111/j.1751-5823.2010.00103.x}}@article{myers2011goodbye, author={Myers, Teresa A.}, title={{Goodbye, listwise deletion: Presenting hot deck imputation as an easy and effective tool for handling missing data}}, journal={Communication Methods and Measures}, year={2011}, volume={5}, number={4}, pages={297--310}, doi={10.1080/19312458.2011.624490}}