Imputation_ i przepisuj wiersz Pooled – ale pamiętaj, że SPSS nie łączy wszystkiego, np. R² w regresji liniowej ani testu chi-kwadrat.Co SPSS robi z brakami danych
Większość procedur SPSS po cichu usuwa cały przypadek, gdy brakuje choć jednej wartości. Do pracy z brakami służą dwie grupy procedur: Missing Value Analysis (opis braków, testy, test MCAR Little’a) i Multiple Imputation (wzorce braków, imputacja wielokrotna i automatyczne łączenie wyników). Obie według dokumentacji IBM wymagają opcji Missing Values albo wydania Professional (IBM Corp., b.d.-a, b.d.-c), więc sprawdź, czy masz je w swojej wersji.
Tu zajmujemy się tylko SPSS. Teorię (MCAR, MAR, MNAR, dlaczego imputacja wielokrotna działa) wyjaśnia poradnik braki danych i imputacja wielokrotna w R i hasło braki danych MCAR, MAR i MNAR. Krótka ścieżka decyzji jest we wpisie braki danych w ankiecie. Nazwy menu, okien i opcji sprawdziliśmy w dokumentacji IBM SPSS Statistics 31 i podajemy po angielsku. Polska dokumentacja podaje m.in. ścieżki Analizuj → Wielokrotne imputowanie → Imputuj brakujące wartości danych i Analizuj → Analiza brakujących wartości (IBM Corp., b.d.-a, b.d.-c), ale etykiety w polskim interfejsie mogą brzmieć inaczej.
Przykład i pliki do pobrania
Dane są symulowane: 240 osób studiujących, płeć, frekwencja na zajęciach (%), godziny nauki w tygodniu, lęk egzaminacyjny (10–40) i wynik egzaminu (0–100). Pytanie: czy więcej godzin nauki i niższy lęk wiążą się z lepszym wynikiem? Frekwencji nie ma w modelu analizy, ale przyda się jako zmienna pomocnicza, bo osoby rzadko obecne częściej nie mają wyniku egzaminu.
Pobierz plik .sav z etykietami zmiennych i wartości albo ten sam zbiór w pliku CSV (puste komórki to braki). Format SPSS opisuje hasło plik .sav.
Przygotowanie danych przed imputacją
- Kody braków. Kody typu 99 czy 999 zdefiniuj jako braki użytkownika w widoku zmiennych. Inaczej program potraktuje je jak zwykłe liczby. Imputacja traktuje braki użytkownika i systemowe tak samo: oba rodzaje uzupełnia (IBM Corp., b.d.-a). Jak to ustawić, pokazuje wpis przygotowanie danych w SPSS.
- Poziom pomiaru. W kolumnie Measure ustaw
plecjako Nominal, a pozostałe zmienne jako Scale. Procedura nie uruchomi się, dopóki jakaś zmienna ma nieznany poziom pomiaru (IBM Corp., b.d.-a). Od poziomu zależy model imputacji: zmienne porządkowe i nominalne są kategorialne i imputowane regresją logistyczną (IBM Corp., b.d.-d), więc pozycja Likerta oznaczona jako Ordinal nie będzie imputowana jak liczba. - Nazwy. Zmiennej
Imputation_procedura tworzy sama, więc w pliku jej nie może być (IBM Corp., b.d.-d).
Krok 1: Analyze Patterns – ile i gdzie brakuje
Analyze → Multiple Imputation → Analyze Patterns. Przenieś co najmniej dwie zmienne analizy, tu wszystkie pięć (IBM Corp., b.d.-a). Wykres Summary of missing values pokazuje trzy proporcje. W przykładzie braki mają 3 z 5 zmiennych, 81 z 240 osób (33.8%) i 93 z 1200 wartości (7.8%). Brakuje niewielu komórek, ale usuwanie przypadków wyrzuciłoby co trzecią osobę.
Tabela Variables with the highest frequency of missing values domyślnie pokazuje tylko zmienne z co najmniej 10% braków (IBM Corp., b.d.-d). Zmienna z 6% braków po prostu się w niej nie pojawi, więc próg obniż w oknie albo przeczytaj tabelę z Missing Value Analysis.
| Zmienna | Braki: n | Braki: % | N ważnych | M | SD |
|---|---|---|---|---|---|
| Wynik egzaminu (0–100) | 41 | 17.1 | 199 | 64.14 | 14.56 |
| Lęk egzaminacyjny (10–40) | 27 | 11.2 | 213 | 25.34 | 6.19 |
| Godziny nauki w tygodniu | 25 | 10.4 | 215 | 8.46 | 3.98 |
| Frekwencja (%) | 0 | 0.0 | 240 | 78.03 | 13.70 |
| Płeć | 0 | 0.0 | 240 | – | – |
Wykres Patterns pokazuje 7 wzorców: 159 osób ma komplet, 32 brak tylko egzaminu, po 20 brak tylko godzin albo tylko lęku, a 9 osób braki w dwóch lub trzech zmiennych. Wzorzec nie jest monotoniczny, czyli zmiennych nie da się ułożyć tak, by brak w jednej pociągał braki we wszystkich następnych. Według dokumentacji przy takim wzorcu właściwa jest metoda FCS, a nie monotoniczna (IBM Corp., b.d.-a).
Krok 2: Missing Value Analysis – od czego zależą braki
Analyze → Missing Value Analysis. Zmienne ilościowe przenieś do listy ilościowych, plec do kategorialnych. W Descriptives zaznacz testy t dla grup tworzonych przez wskaźniki braku i tabele krzyżowe, a w sekcji Estimation zaznacz EM (IBM Corp., b.d.-c).
- Testy t. Osoby bez wyniku egzaminu miały niższą frekwencję: M = 67.34 wobec 80.24, t(238) = 5.86, p < .001. Godziny nauki (p = .661) i lęk (p = .889) od braku egzaminu nie zależały. Dokumentacja mówi o statystyce t Studenta i ostrzega, że przy wielu testach podanych p nie należy traktować jak testów istotności (IBM Corp., b.d.-c). Wersja Welcha daje tu ten sam wniosek, t(53.42) = 5.37, p < .001.
- Tabela krzyżowa dla płci. Lęku nie podało 17.2% mężczyzn i 7.5% kobiet, więc płeć wchodzi do modelu imputacji.
- Test MCAR Little’a. SPSS drukuje go jako przypis pod macierzami EM (IBM Corp., b.d.-c). W przykładzie χ²(14) = 42.69, p < .001, więc braki nie są całkowicie losowe.
Little (1988) zaproponował jeden globalny test MCAR zamiast wielu skorelowanych porównań. Wynik nieistotny nie dowodzi jednak MCAR, a żaden test nie odróżni MAR od MNAR (zob. test MCAR Little’a). Testy t są bardziej użyteczne: pokazują, którą zmienną pomocniczą dołożyć do modelu imputacji. Uzupełnianie braków metodą EM lub regresją w tym oknie to imputacja pojedyncza. Dokumentacja sama przyznaje, że imputacja wielokrotna jest zwykle dokładniejsza (IBM Corp., b.d.-c); zob. też LOCF i proste imputacje.
Krok 3: Impute Missing Data Values – ustawienia
Najpierw ustal ziarno losowania: Transform → Random Number Generators, Set Active Generator: Mersenne Twister, Set Starting Point: Fixed Value (IBM Corp., b.d.-e). Bez tego każde uruchomienie da inne wyniki. Potem Analyze → Multiple Imputation → Impute Missing Data Values (IBM Corp., b.d.-a).
| Karta | Ustawienie | Dlaczego |
|---|---|---|
| Variables | plec, frekwencja, godziny, lek, egzamin | Zmienna zależna, predyktory i zmienne związane z brakami. W FCS każda zmienna jest imputowana z pozostałych (IBM Corp., b.d.-d). |
| Variables | liczba imputacji: 40; zapis do nowego zbioru danych imputacje | Domyślne 5 to mało (zob. ile imputacji). |
| Method | Custom → Fully conditional specification, Maximum iterations: 10, Linear Regression | Przy metodzie Automatic nie zmienisz liczby iteracji ani modelu (IBM Corp., b.d.-d). Regresja liniowa jest potrzebna do ograniczeń Min i Max. |
| Constraints | Scan Data; Min/Max: godziny 0–30, lęk 10–40, egzamin 0–100 | Wartość spoza zakresu jest losowana ponownie (IBM Corp., b.d.-a). |
| Output | Imputation model, Descriptive statistics, Create iteration history | Kontrola wartości imputowanych i zbieżności FCS. |
Alternatywą jest Predictive Mean Matching: wartość pochodzi od jednej z k osób (domyślnie 5) o najbliższej wartości przewidywanej, więc zawsze jest realna, ale Min i Max nie ustawisz (IBM Corp., b.d.-a). White i in. (2011) opisują, jak dobierać model imputacji dla zmiennych ilościowych, kategorialnych i skośnych.
Zmiennych pomocniczych nie usuwaj tylko dlatego, że nie ma ich w hipotezie: to frekwencja „tłumaczy” brak wyniku egzaminu. Zmienną, która ma być tylko predyktorem, oznacz na karcie Constraints rolą Use as predictor only (IBM Corp., b.d.-a).
Krok 4: Sprawdź wartości imputowane i zbieżność
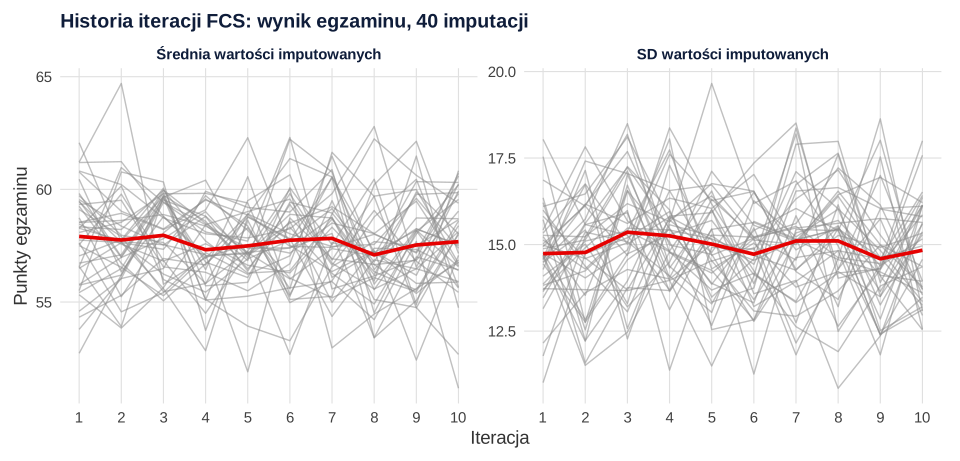
Tabela Imputation Models podaje model dla każdej zmiennej i liczbę imputowanych wartości: braki × liczba imputacji, np. dla egzaminu 41 × 40 = 1640 (IBM Corp., b.d.-e). Tabela Descriptive Statistics zestawia dane oryginalne, wartości imputowane i dane kompletne w każdej imputacji (IBM Corp., b.d.-a). Obserwowany wynik egzaminu ma M = 64.14 (SD = 14.56), a wartości imputowane – średnio od 51.17 do 60.83 w 40 zbiorach. Są niższe, bo brakuje głównie osób z niską frekwencją. To oczekiwany skutek MAR, nie błąd. Niepokój powinny budzić wartości niemożliwe. W samouczku IBM pierwsza automatyczna imputacja dała ujemne wartości i model trzeba było powtórzyć z ograniczeniami (IBM Corp., b.d.-e).
Zbieżność FCS sprawdzisz wykresem liniowym zbioru z historią iteracji w Graphs → Chart Builder (IBM Corp., b.d.-e). Linie średnich i SD nie powinny tworzyć trendu.
Krok 5: analiza i wyniki łączone (Pooled)
Nowy zbiór ma 240 × 41 = 9840 wierszy: dane oryginalne (Imputation_ = 0) i 40 kompletów. SPSS sam dzieli go według Imputation_ (IBM Corp., b.d.-a). Po ponownym otwarciu pliku włącz podział przez Data → Split File → Compare groups z Imputation Number albo przez View → Mark Imputed Data. Teraz uruchom zwykłą procedurę, tu Analyze → Regression → Linear (egzamin na godziny i lęk). Obsługiwana procedura domyślnie daje wynik dla danych oryginalnych, dla każdej imputacji i wiersz Pooled (IBM Corp., b.d.-b). Jak czytać pozostałe tabele regresji, pokazuje wpis korelacja i regresja w SPSS.
| Imputation Number | Predyktor | B | SE | 95% CI | df | FMI | RIV | RE |
|---|---|---|---|---|---|---|---|---|
| Original data (n = 159) | godziny | 1.664 | 0.247 | [1.176, 2.151] | 156 | |||
| lek | −0.870 | 0.152 | [−1.171, −0.569] | 156 | ||||
| 1 | godziny | 1.598 | 0.204 | |||||
| lek | −0.817 | 0.130 | ||||||
| 2 | godziny | 1.458 | 0.195 | |||||
| lek | −0.796 | 0.126 | ||||||
| 3–40 | … | |||||||
| Pooled (N = 240) | godziny | 1.551 | 0.245 | [1.067, 2.036] | 118.5 | .314 | .433 | .992 |
| lek | −0.800 | 0.150 | [−1.096, −0.504] | 145.2 | .241 | .299 | .994 | |
Wiersz Original data to analiza przypadków kompletnych (159 osób). Do pracy przepisujesz wiersz Pooled: godziny nauki B = 1.55, t(118.5) = 6.34, p < .001, lęk B = −0.80, t(145.2) = −5.34, p < .001. Kolumny diagnostyczne to frakcja brakującej informacji (FMI), względny przyrost wariancji (RIV) i względna efektywność (RE) (IBM Corp., b.d.-b). Dla godzin FMI = .31: tyle niepewności oszacowania wynika z braków (zob. frakcja brakującej informacji). Stopnie swobody to poprawka Barnarda–Rubina z pakietu mice. Dokumentacja SPSS mówi tylko o „efektywnych stopniach swobody”, a SPSS ma własny generator liczb losowych, więc twoje liczby będą bliskie, ale nie identyczne.
Nie wszystko jest łączone. W regresji liniowej dokumentacja wymienia łączenie B w tabeli Coefficients oraz łączenie naiwne statystyk opisowych i korelacji (IBM Corp., b.d.-b). Nie wymienia tabel Model Summary i ANOVA ani współczynników Beta. R² zobaczysz więc osobno dla każdej imputacji, u nas od .242 do .388. Nie przepisuj R² z jednej imputacji. Połączone R² = .295, 95% CI [.184, .411], policzyliśmy w R. Jak to zrobić, opisuje wpis reguły Rubina w praktyce. Przy regresji krokowej wiersza Pooled może nie być, bo imputacje wybiorą różne predyktory (IBM Corp., b.d.-e).
| Procedura | Łączenie jednowymiarowe | Tylko naiwne lub brak |
|---|---|---|
| Descriptives, Frequencies | średnia, jeśli zaznaczysz S.E. mean | N, liczności |
| Testy t, One-Way ANOVA | średnie, różnice średnich, kontrasty | N |
| Linear Regression | B | statystyki opisowe, korelacje, statystyki reszt |
| Regresja logistyczna, GLM, Linear Mixed Models | B, średnie brzegowe (GLM, MIXED) | N i statystyki opisowe (GLM, MIXED) |
| Bivariate Correlations | korelacje (po transformacji z Fishera) | średnie |
| Crosstabs, testy nieparametryczne | – | liczności, średnie rangi |
Średni wynik egzaminu połączysz w Descriptives z zaznaczonym S.E. mean. Wśród 199 osób z wynikiem M = 64.14, a po imputacji M = 63.03, 95% CI [61.01, 65.05]. Testu chi-kwadrat z Crosstabs SPSS nie połączy. Efekty stałe połączy natomiast model mieszany (zob. MIXED w SPSS).
Ile imputacji ustawić
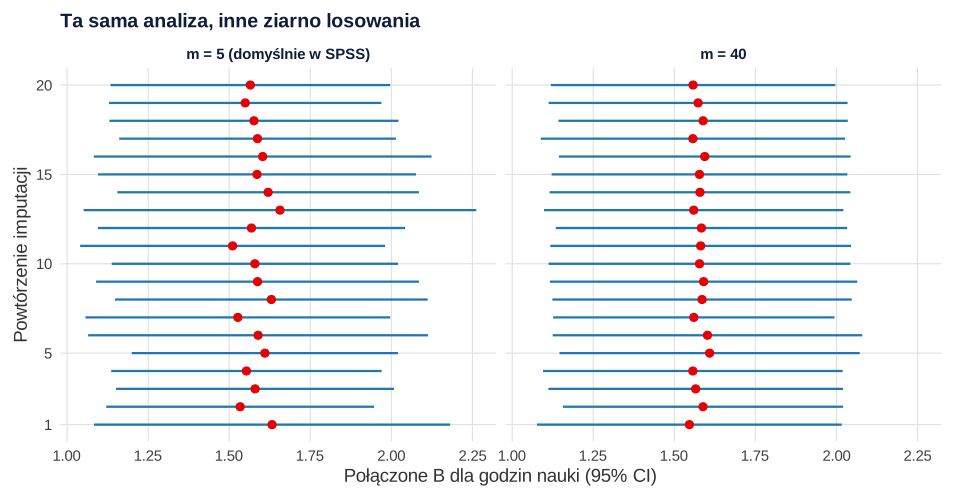
Dokumentacja mówi tylko: im więcej brakującej informacji, tym więcej imputacji (IBM Corp., b.d.-d). White i in. (2011) radzą liczbę imputacji zbliżoną do odsetka niepełnych przypadków. U nas to 33.8%, więc ustawiliśmy 40. Kolumna RE porównuje wynik z nieskończoną liczbą imputacji; przy FMI = .31 nawet 5 imputacji dałoby RE = .941. Graham i in. (2007) pokazali jednak w symulacji, że przy małej liczbie imputacji moc spada szybciej, niż wynika z RE, i zalecają znacznie więcej imputacji niż 3–5. Rysunek 2 pokazuje drugi problem: przy 5 imputacjach połączone B dla godzin wahało się między powtórzeniami od 1.510 do 1.657, a przy 40 od 1.547 do 1.609.
Jak opisać imputację w pracy
W metodzie podaj braki i ich związki z innymi zmiennymi, metodę, program, ustawienia, zmienne w modelu imputacji i liczbę imputacji. W wynikach – wartości połączone i, dla porównania, przypadki kompletne. Wzory:
Tabelę zbudujesz według wzoru tabela regresji w APA, a zdania do innych analiz przygotuje generator opisu wyników APA. Jak podać wersję SPSS i R w bibliografii, opisuje wpis jak cytować SPSS i R.
Składnia SPSS i kod R
Przepis 1 to składnia do wklejenia w edytorze składni SPSS, napisana według Command Syntax Reference (IBM Corp., b.d.-d). Nie uruchamialiśmy jej w SPSS. Przepisy 2 i 3 w R tworzą pliki do pobrania i liczą wszystkie liczby z tego wpisu (pakiety haven, naniar i mice). Losowanie z ograniczeniem zakresu napisaliśmy według opisu karty Constraints w dokumentacji IBM. To nie jest kod SPSS, a liczby z SPSS będą bliskie, ale nie identyczne.
1. Składnia SPSS: wzorce braków, MVA, imputacja i analiza
SPSS
* Składnia zgodna z Command Syntax Reference (IBM SPSS Statistics 31); nie była uruchamiana w SPSS.
* Krok 1. Wzorce braków bez imputacji (wszystkie zmienne w tabeli: MINPCTMISSING=0).
MULTIPLE IMPUTATION plec frekwencja godziny lek egzamin
  /IMPUTE METHOD=NONE
  /MISSINGSUMMARIES OVERALL VARIABLES(MAXVARS=25 MINPCTMISSING=0) PATTERNS.

* Krok 2. Missing Value Analysis: testy t, tabele krzyżowe, wzorce i EM z testem Little'a.
MVA VARIABLES=plec frekwencja godziny lek egzamin
  /CATEGORICAL=plec
  /TTEST PERCENT=5 PROB
  /CROSSTAB PERCENT=5
  /TPATTERN PERCENT=1
  /EM.

* Krok 3. Ziarno generatora i imputacja wielokrotna FCS z ograniczeniami.
SET RNG=MT MTINDEX=20261110.
DATASET DECLARE imputacje.
DATASET DECLARE iteracje.
MULTIPLE IMPUTATION plec frekwencja godziny lek egzamin
  /IMPUTE METHOD=FCS NIMPUTATIONS=40 MAXITER=10 SCALEMODEL=LINEAR
  /CONSTRAINTS godziny (MIN=0 MAX=30)
  /CONSTRAINTS lek (MIN=10 MAX=40)
  /CONSTRAINTS egzamin (MIN=0 MAX=100)
  /MISSINGSUMMARIES NONE
  /IMPUTATIONSUMMARIES MODELS DESCRIPTIVES
  /OUTFILE IMPUTATIONS=imputacje FCSITERATIONS=iteracje.

* Krok 4. Analiza na danych imputowanych: wyniki dla każdej imputacji i Pooled.
DATASET ACTIVATE imputacje.
SPLIT FILE LAYERED BY Imputation_.
REGRESSION
  /STATISTICS=COEFF OUTS CI(95) R ANOVA
  /DEPENDENT=egzamin
  /METHOD=ENTER godziny lek.
DESCRIPTIVES VARIABLES=egzamin
  /STATISTICS=MEAN STDDEV SEMEAN.
2. Dane i diagnoza braków w R
R
# B538 – braki danych w SPSS: dane do pobrania i diagnoza braków
# Dane symulowane, set.seed(538): 240 osób studiujących, egzamin końcowy ze statystyki.
# Braki: wynik egzaminu częściej brakuje przy niskiej frekwencji (MAR),
# lęk egzaminacyjny częściej pomijają mężczyźni, godziny nauki brakują losowo.
suppressPackageStartupMessages({ library(haven); library(naniar) })
set.seed(538)
n <- 240
plec <- sample(1:2, n, replace = TRUE, prob = c(.6, .4))          # 1 = kobieta, 2 = mężczyzna
frekwencja <- round(pmin(100, pmax(20, rnorm(n, 78, 14))))         # % obecności na zajęciach
godziny <- round(pmin(30, pmax(0, rnorm(n, 8 + 0.10 * (frekwencja - 78), 4))))
lek <- round(pmin(40, pmax(10, rnorm(n, 23 + 3 * (plec == 1), 6)))) # lęk egzaminacyjny 10–40
egzamin <- round(pmin(100, pmax(0, 38 + 1.5 * godziny - 0.6 * lek + 0.35 * frekwencja + rnorm(n, 0, 11))))
dane <- data.frame(id = 1:n, plec, frekwencja, godziny, lek, egzamin)

# Braki danych
dane$egzamin[runif(n) < plogis(-1.6 - 0.07 * (frekwencja - 78))] <- NA  # MAR: zależy od frekwencji
dane$lek[runif(n) < plogis(-2.6 + 1.0 * (plec == 2))] <- NA             # zależy od płci
dane$godziny[runif(n) < .08] <- NA                                       # MCAR

# Plik .sav z etykietami i poziomem pomiaru oraz ten sam zbiór w CSV
sav <- dane
sav$id <- labelled(sav$id, label = "Numer osoby")
sav$plec <- labelled(sav$plec, labels = c("kobieta" = 1, "mężczyzna" = 2), label = "Płeć")
sav$frekwencja <- labelled(sav$frekwencja, label = "Frekwencja na zajęciach (%)")
sav$godziny <- labelled(sav$godziny, label = "Godziny nauki w tygodniu")
sav$lek <- labelled(sav$lek, label = "Lęk egzaminacyjny (10–40)")
sav$egzamin <- labelled(sav$egzamin, label = "Wynik egzaminu (0–100)")
write_sav(sav, "imputacja-spss-dane.sav")
write.csv(dane, "imputacja-spss-dane.csv", row.names = FALSE, na = "", fileEncoding = "UTF-8")

# Analyze Patterns: Overall Summary (zmienne, przypadki, wartości) – 5 zmiennych analizy
an <- dane[, c("plec", "frekwencja", "godziny", "lek", "egzamin")]
cat("Zmienne z brakami:", sum(colSums(is.na(an)) > 0), "z", ncol(an), "\n")
cat("Przypadki z brakami:", sum(!complete.cases(an)), "z", nrow(an),
    sprintf("(%.1f%%)", 100 * mean(!complete.cases(an))), "\n")
cat("Wartości brakujące:", sum(is.na(an)), "z", length(as.matrix(an)),
    sprintf("(%.1f%%)", 100 * mean(is.na(an))), "\n")

# Variable Summary: braki, odsetek, N ważnych, średnia i SD (domyślnie tylko zmienne z >= 10% braków)
vs <- data.frame(zmienna = names(an), braki = colSums(is.na(an)),
                 proc = round(100 * colMeans(is.na(an)), 1), N_waznych = colSums(!is.na(an)),
                 M = round(sapply(an, mean, na.rm = TRUE), 2), SD = round(sapply(an, sd, na.rm = TRUE), 2))
print(vs[order(-vs$proc), ], row.names = FALSE)

# Patterns: wzorce braków i ich liczebności (1 = wartość jest, 0 = brak)
wz <- apply(1 * !is.na(an[, c("godziny", "lek", "egzamin")]), 1, paste, collapse = "")
print(sort(table(wz), decreasing = TRUE))

# Missing Value Analysis: t tests (test t Studenta) dla grup z brakiem i bez braku egzaminu
for (v in c("frekwencja", "godziny", "lek")) {
  tt <- t.test(dane[[v]] ~ is.na(dane$egzamin), var.equal = TRUE)
  cat(sprintf("%-10s brak egzaminu: M = %.2f (n = %d); jest: M = %.2f (n = %d); t(%.0f) = %.2f (jest − brak), Sig. = %.3f\n",
      v, tt$estimate[2], sum(is.na(dane$egzamin) & !is.na(dane[[v]])), tt$estimate[1],
      sum(!is.na(dane$egzamin) & !is.na(dane[[v]])), tt$parameter, tt$statistic, tt$p.value))
}
# To samo porównanie frekwencji w wersji dla nierównych wariancji (Welch)
print(t.test(frekwencja ~ is.na(egzamin), data = dane))
# Lęk: czy brak zależy od płci?
print(round(100 * tapply(is.na(dane$lek), dane$plec, mean), 1))

# Test MCAR Little'a (w SPSS: przypis pod tabelami EM) na zmiennych ilościowych
print(as.data.frame(mcar_test(dane[, c("frekwencja", "godziny", "lek", "egzamin")])))
Wynik:
Zmienne z brakami: 3 z 5
Przypadki z brakami: 81 z 240 (33.8%)
Wartości brakujące: 93 z 1200 (7.8%)
    zmienna braki proc N_waznych     M    SD
    egzamin    41 17.1       199 64.14 14.56
        lek    27 11.2       213 25.34  6.19
    godziny    25 10.4       215  8.46  3.98
       plec     0  0.0       240  1.39  0.49
 frekwencja     0  0.0       240 78.03 13.70
wz
111 110 011 101 100 000 010
159  32  20  20   4   3   2
frekwencja brak egzaminu: M = 67.34 (n = 41); jest: M = 80.24 (n = 199); t(238) = 5.86 (jest − brak), Sig. = 0.000
godziny    brak egzaminu: M = 8.72 (n = 36); jest: M = 8.40 (n = 179); t(213) = -0.44 (jest − brak), Sig. = 0.661
lek        brak egzaminu: M = 25.21 (n = 34); jest: M = 25.37 (n = 179); t(211) = 0.14 (jest − brak), Sig. = 0.889

	Welch Two Sample t-test

data:  frekwencja by is.na(egzamin)
t = 5.3736, df = 53.418, p-value = 1.727e-06
alternative hypothesis: true difference in means between group FALSE and group TRUE is not equal to 0
95 percent confidence interval:
  8.082523 17.706912
sample estimates:
mean in group FALSE  mean in group TRUE
           80.23618            67.34146

   1    2
 7.5 17.2
  statistic df      p.value missing.patterns
1  42.68905 14 9.604994e-05                7
3. Imputacja wielokrotna FCS i łączenie wyników w R
R
# B538 – wielokrotna imputacja jak w SPSS (FCS, regresja liniowa z ograniczeniami) i łączenie wyników
# Dane: imputacja-spss-dane.csv z przepisu 1. Pakiet mice; liczby losowe mice i SPSS są inne,
# więc wartości z SPSS będą bliskie, ale nie identyczne.
suppressPackageStartupMessages(library(mice))
dane <- read.csv("imputacja-spss-dane.csv")
dane$plec <- factor(dane$plec, levels = 1:2, labels = c("kobieta", "mężczyzna"))  # Nominal
an <- dane[, c("plec", "frekwencja", "godziny", "lek", "egzamin")]

# Regresja liniowa z losowaniem parametrów i reszty; wartość spoza [min, max] jest losowana ponownie
# (do 50 prób na przypadek, potem nowe parametry – jak opisuje karta Constraints w SPSS)
ograniczona <- function(min, max, proby = 50, parametry = 2) {
  function(y, ry, x, wy = NULL, ...) {
    if (is.null(wy)) wy <- !ry
    x <- cbind(1, as.matrix(x))
    wynik <- rep(NA_real_, sum(wy))
    for (k in seq_len(parametry)) {
      p <- .norm.draw(y, ry, x, ...)
      mu <- drop(x[wy, , drop = FALSE] %*% p$beta)
      for (j in seq_len(proby)) {
        b <- is.na(wynik)
        if (!any(b)) return(wynik)
        los <- mu[b] + rnorm(sum(b)) * p$sigma
        wynik[b] <- ifelse(los >= min & los <= max, los, NA)
      }
    }
    if (anyNA(wynik)) stop("nie udało się wylosować wartości z zakresu")
    wynik
  }
}
mice.impute.godz <- ograniczona(0, 30)
mice.impute.lek <- ograniczona(10, 40)
mice.impute.egz <- ograniczona(0, 100)

# Kolejność zmiennych = kolejność imputacji w FCS; 40 imputacji, 10 iteracji
metody <- c(plec = "", frekwencja = "", godziny = "godz", lek = "lek", egzamin = "egz")
imp <- mice(an, m = 40, maxit = 10, method = metody, seed = 20261110, printFlag = FALSE)

# Imputation Models: liczba braków i liczba wartości imputowanych (braki × m)
print(data.frame(braki = colSums(is.na(an)), imputowane = colSums(is.na(an)) * imp$m)[3:5, ])

# Descriptive Statistics dla egzaminu: dane oryginalne, wartości imputowane, dane kompletne
opis <- function(x) round(c(N = length(x), M = mean(x), SD = sd(x), Min = min(x), Max = max(x)), 2)
cat("Original data:\n"); print(opis(na.omit(an$egzamin)))
for (i in 1:3) {
  zb <- complete(imp, i)
  cat("Imputacja", i, "– imputed values:\n"); print(opis(zb$egzamin[is.na(an$egzamin)]))
  cat("Imputacja", i, "– complete data:\n"); print(opis(zb$egzamin))
}
sr_imp <- sapply(1:imp$m, function(i) mean(complete(imp, i)$egzamin[is.na(an$egzamin)]))
cat(sprintf("Średnia wartości imputowanych w 40 zbiorach: od %.2f do %.2f\n", min(sr_imp), max(sr_imp)))

# Regresja: Original data (usuwanie przypadków), pierwsze imputacje i wynik łączny (Pooled)
m0 <- lm(egzamin ~ godziny + lek, data = an)
cat("Original data, N =", nobs(m0), "df reszt =", df.residual(m0), "\n")
print(round(cbind(summary(m0)$coefficients, confint(m0)), 3))
fit <- with(imp, lm(egzamin ~ godziny + lek))
for (i in 1:3) { cat("Imputacja", i, "\n"); print(round(summary(fit$analyses[[i]])$coefficients[, 1:2], 3)) }
pl <- pool(fit)
s <- summary(pl, conf.int = TRUE)
tab <- data.frame(B = s$estimate, SE = s$std.error, t = s$statistic, df = s$df, p = s$p.value,
                  dolna = s[["2.5 %"]], gorna = s[["97.5 %"]], RIV = pl$pooled$riv, FMI = pl$pooled$fmi,
                  RE = 1 / (1 + pl$pooled$fmi / imp$m), row.names = s$term)   # RE = relative efficiency
print(signif(tab, 4))
cat("RE przy tych samych FMI, gdyby m = 5:", round(1 / (1 + pl$pooled$fmi / 5), 3), "\n")

# R² nie jest łączony w tabeli Coefficients: R² w kolejnych zbiorach i R² połączone (Harel)
r2 <- sapply(fit$analyses, function(m) summary(m)$r.squared)
cat(sprintf("R² w 40 zbiorach: od %.3f do %.3f; Original data: %.3f\n", min(r2), max(r2), summary(m0)$r.squared))
print(round(pool.r.squared(fit), 3))

# Średni wynik egzaminu: dane obserwowane i średnia połączona (Descriptives z S.E. mean)
srednie <- sapply(1:imp$m, function(i) mean(complete(imp, i)$egzamin))
wariancje <- sapply(1:imp$m, function(i) var(complete(imp, i)$egzamin) / nrow(an))
ps <- pool.scalar(srednie, wariancje, n = nrow(an))
cat(sprintf("Obserwowane: M = %.2f (n = %d); połączone: M = %.2f, SE = %.2f, 95%% CI [%.2f, %.2f], FMI = %.2f\n",
    mean(an$egzamin, na.rm = TRUE), sum(!is.na(an$egzamin)), ps$qbar, sqrt(ps$t),
    ps$qbar - qt(.975, ps$df) * sqrt(ps$t), ps$qbar + qt(.975, ps$df) * sqrt(ps$t), ps$fmi))

# Domyślne 5 imputacji a 40: ta sama analiza powtórzona z 20 różnymi ziarnami
powtorz <- function(m, ziarno) {
  im <- mice(an, m = m, maxit = 10, method = metody, seed = ziarno, printFlag = FALSE)
  w <- summary(pool(with(im, lm(egzamin ~ godziny + lek))))
  c(m = m, B = w$estimate[2], SE = w$std.error[2], p = w$p.value[2])
}
proby <- as.data.frame(rbind(t(sapply(1:20, function(z) powtorz(5, z))), t(sapply(1:20, function(z) powtorz(40, z)))))
print(aggregate(cbind(B, SE) ~ m, data = proby, FUN = function(x) round(c(min = min(x), max = max(x)), 3)))
Wynik:
        braki imputowane
godziny    25       1000
lek        27       1080
egzamin    41       1640
Original data:
     N      M     SD    Min    Max
199.00  64.14  14.56  26.00 100.00
Imputacja 1 – imputed values:
    N     M    SD   Min   Max
41.00 60.24 16.36 24.72 92.31
Imputacja 1 – complete data:
     N      M     SD    Min    Max
240.00  63.47  14.92  24.72 100.00
Imputacja 2 – imputed values:
    N     M    SD   Min   Max
41.00 58.39 13.72 28.24 91.20
Imputacja 2 – complete data:
     N      M     SD    Min    Max
240.00  63.15  14.55  26.00 100.00
Imputacja 3 – imputed values:
    N     M    SD   Min   Max
41.00 58.70 15.37 23.93 91.46
Imputacja 3 – complete data:
     N      M     SD    Min    Max
240.00  63.21  14.81  23.93 100.00
Średnia wartości imputowanych w 40 zbiorach: od 51.17 do 60.83
Original data, N = 159 df reszt = 156
            Estimate Std. Error t value Pr(>|t|)  2.5 % 97.5 %
(Intercept)   72.520      4.572  15.863        0 63.489 81.550
godziny        1.664      0.247   6.740        0  1.176  2.151
lek           -0.870      0.152  -5.712        0 -1.171 -0.569
Imputacja 1
            Estimate Std. Error
(Intercept)   70.585      3.850
godziny        1.598      0.204
lek           -0.817      0.130
Imputacja 2
            Estimate Std. Error
(Intercept)   70.843      3.734
godziny        1.458      0.195
lek           -0.796      0.126
Imputacja 3
            Estimate Std. Error
(Intercept)   72.517      3.915
godziny        1.535      0.205
lek           -0.878      0.133
                  B     SE      t    df         p  dolna  gorna    RIV    FMI
(Intercept) 70.1400 4.4800 15.660 140.5 1.319e-32 61.280 79.000 0.3195 0.2527
godziny      1.5510 0.2447  6.340 118.5 4.332e-09  1.067  2.036 0.4329 0.3136
lek         -0.8001 0.1498 -5.341 145.2 3.490e-07 -1.096 -0.504 0.2992 0.2407
                RE
(Intercept) 0.9937
godziny     0.9922
lek         0.9940
RE przy tych samych FMI, gdyby m = 5: 0.952 0.941 0.954
R² w 40 zbiorach: od 0.242 do 0.388; Original data: 0.349
      est lo 95 hi 95   fmi
R^2 0.295 0.184 0.411 0.292
Obserwowane: M = 64.14 (n = 199); połączone: M = 63.03, SE = 1.03, 95% CI [61.01, 65.05], FMI = 0.14
   m B.min B.max SE.min SE.max
1  5 1.510 1.657  0.208  0.283
2 40 1.547 1.609  0.219  0.241
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki wykonano w pakiecie ggplot2 na podstawie tego samego modelu imputacji. Składni SPSS nie uruchamiano. W pracy podaj wersję SPSS lub R, której faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- mice (wersja 3.19.0): van Buuren, S., & Groothuis-Oudshoorn, K. (2011). mice: Multivariate imputation by chained equations in R. Journal of Statistical Software, 45(3), 1–67. https://doi.org/10.18637/jss.v045.i03
- naniar (wersja 1.1.0): Tierney, N., & Cook, D. (2023). Expanding tidy data principles to facilitate missing data exploration, visualization and assessment of imputations. Journal of Statistical Software, 105(7), 1–31. https://doi.org/10.18637/jss.v105.i07
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Typowe błędy
- Imputacja bez zmiennej zależnej. Bez niej związki z predyktorami słabną.
- Pominięcie zmiennych pomocniczych związanych z brakami.
- Raportowanie wiersza Original data albo jednej imputacji zamiast Pooled.
- Domyślne 5 imputacji przy dużym odsetku niepełnych przypadków.
- Brak ustalonego ziarna.
- Ręczna poprawa wartości imputowanych – dokumentacja tego nie zaleca (IBM Corp., b.d.-a).
- Nieistotny test Little’a jako „dowód MCAR”.
- R² lub F przepisane z jednej imputacji albo regresja krokowa na danych imputowanych.
Gdy wynik wygląda dziwnie, zajrzyj do wpisu wynik wygląda podejrzanie. Gdy braki biorą się z niepołączonych ankiet przed i po, zacznij od wpisu nie da się połączyć pomiaru przed i po. Zasady czytania wydruku: jak czytać wyniki z SPSS. Analizę dobierzesz w kreatorze testu.
Najczęstsze pytania
Gdzie w SPSS jest imputacja wielokrotna i czy mam ją w swojej wersji?
W menu Analyze → Multiple Imputation (Analyze Patterns i Impute Missing Data Values), a opis braków z testem Little’a w Analyze → Missing Value Analysis. Według dokumentacji IBM obie procedury wymagają opcji Missing Values albo wydania Professional (IBM Corp., b.d.-a, b.d.-c). Jeśli tych pozycji nie ma w menu, Twoja licencja ich nie obejmuje.
Dlaczego po imputacji w SPSS nie widzę wiersza Pooled?
Najczęściej plik nie jest podzielony według Imputation_ (włącz Data → Split File → Compare groups albo View → Mark Imputed Data), procedura nie obsługuje łączenia albo tabela nie należy do łączonych, np. Model Summary w regresji liniowej (IBM Corp., b.d.-b). Przy regresji krokowej wiersza Pooled nie ma, gdy w imputacjach wybrano różne predyktory (IBM Corp., b.d.-e).
Czy imputacja metodą EM z Missing Value Analysis wystarczy do pracy?
Zwykle nie. EM w tym oknie uzupełnia każdy brak jedną wartością, więc kolejne analizy traktują ją jak prawdziwy pomiar i zaniżają błędy standardowe. Dokumentacja IBM sama zaznacza, że imputacja wielokrotna daje na ogół dokładniejsze wyniki (IBM Corp., b.d.-c). Z tego okna warto wziąć opis braków, testy t i test Little’a.
Dlaczego moje wyniki imputacji w SPSS różnią się od wyników kolegi na tych samych danych?
Imputacja losuje wartości, więc bez tego samego ziarna generatora, tej samej kolejności przypadków i zmiennych oraz tych samych ustawień wyniki będą się różnić (IBM Corp., b.d.-a). Ustal ziarno w Transform → Random Number Generators i opisz je w pracy. Przy większej liczbie imputacji różnice między uruchomieniami maleją: w przykładzie B dla godzin nauki wahało się od 1.510 do 1.657 przy 5 imputacjach i od 1.547 do 1.609 przy 40.
Czy zmienne porządkowe, np. pozycje Likerta, mogę imputować w SPSS jako Ordinal?
Możesz, ale SPSS traktuje zmienne porządkowe tak samo jak nominalne, czyli jako kategorialne, i imputuje je regresją logistyczną (IBM Corp., b.d.-d). Przy wielu kategoriach i małej próbie model może mieć bardzo dużo parametrów. Wynik skali liczony ze średniej pozycji często lepiej oznaczyć jako Scale i imputować z ograniczeniem Min/Max.
Powiązane hasła
Przeczytaj też
Braki danych i imputacja wielokrotna w R
MCAR, MAR i MNAR, test Little’a, symulacja metod i imputacja wielokrotna w R krok po kroku – z kodem, regułami Rubina i gotowym opisem APA.
Czytaj →PoradnikImputacja wielokrotna: reguły Rubina w praktyce
Wydruk pool() i FMI, imputacja interakcji, R² i test D1, SEM na danych imputowanych z D2 i porównanie z FIML – z kodem w R.
Czytaj →PoradnikBraki danych w ankiecie – co zrobić?
Jak policzyć braki, kiedy wystarczy reguła proporcjonalna, jak sprawdzić osoby, które przerwały ankietę, i jak opisać braki w pracy.
Czytaj →Masz braki danych i nie wiesz, czy imputować?
Sprawdzimy wzorce braków, przygotujemy imputację wielokrotną i wyniki łączone oraz wyjaśnimy je tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Graham, J. W., Olchowski, A. E., & Gilreath, T. D. (2007). How many imputations are really needed? Some practical clarifications of multiple imputation theory. Prevention Science, 8(3), 206–213. https://doi.org/10.1007/s11121-007-0070-9
- IBM Corp. (b.d.-a). Multiple Imputation. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/mva/multiple_imputation_intro.html ● Otwarty dostęp
- IBM Corp. (b.d.-b). Analyzing Multiple Imputation Data. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/mva/mi_analysis.html ● Otwarty dostęp
- IBM Corp. (b.d.-c). Missing Value Analysis. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/mva/idh_miss.html ● Otwarty dostęp
- IBM Corp. (b.d.-d). MULTIPLE IMPUTATION. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/mva/syn_multiple_imputation.html ● Otwarty dostęp
- IBM Corp. (b.d.-e). Using multiple imputation to complete and analyze a dataset. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_casestudies_project_ddita/spss/tutorials/mi_telco_intro.html ● Otwarty dostęp
- Little, R. J. A. (1988). A test of missing completely at random for multivariate data with missing values. Journal of the American Statistical Association, 83(404), 1198–1202. https://doi.org/10.1080/01621459.1988.10478722
- White, I. R., Royston, P., & Wood, A. M. (2011). Multiple imputation using chained equations: Issues and guidance for practice. Statistics in Medicine, 30(4), 377–399. https://doi.org/10.1002/sim.4067
Cytowania BibTeX
@article{graham2007many, author={Graham, John W. and Olchowski, Allison E. and Gilreath, Tamika D.}, title={{How many imputations are really needed? Some practical clarifications of multiple imputation theory}}, journal={Prevention Science}, year={2007}, volume={8}, number={3}, pages={206--213}, doi={10.1007/s11121-007-0070-9}}@misc{ibmndmultipleimputation31, author={{IBM Corp.}}, title={{Multiple Imputation}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-a}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/mva/multiple_imputation_intro.html}}@misc{ibmndmianalysis31, author={{IBM Corp.}}, title={{Analyzing Multiple Imputation Data}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-b}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/mva/mi_analysis.html}}@misc{ibmndmva31, author={{IBM Corp.}}, title={{Missing Value Analysis}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-c}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/mva/idh_miss.html}}@misc{ibmndmisyntax31, author={{IBM Corp.}}, title={{MULTIPLE IMPUTATION}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-d}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/mva/syn_multiple_imputation.html}}@misc{ibmndmitutorial31, author={{IBM Corp.}}, title={{Using multiple imputation to complete and analyze a dataset}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-e}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_casestudies_project_ddita/spss/tutorials/mi_telco_intro.html}}@article{little1988test, author={Little, Roderick J. A.}, title={{A test of missing completely at random for multivariate data with missing values}}, journal={Journal of the American Statistical Association}, year={1988}, volume={83}, number={404}, pages={1198--1202}, doi={10.1080/01621459.1988.10478722}}@article{white2011multiple, author={White, Ian R. and Royston, Patrick and Wood, Angela M.}, title={{Multiple imputation using chained equations: Issues and guidance for practice}}, journal={Statistics in Medicine}, year={2011}, volume={30}, number={4}, pages={377--399}, doi={10.1002/sim.4067}}