Co to jest model wielostanowy?
Model wielostanowy (ang. multi-state model) opisuje, jak osoby przechodzą w czasie między skończoną liczbą stanów, np. zdrowy → chory → zgon. Klasyczna analiza przeżycia to najprostszy przypadek z dwoma stanami (żywy → zgon), a ryzyka konkurujące – stan początkowy z kilkoma stanami końcowymi. Andersen i Keiding (2002) pokazują te przypadki oraz model choroba–zgon (ang. illness–death) jako warianty jednego schematu, w którym model określa się przez intensywności przejść.
Intensywności przejść i prawdopodobieństwa stanów
Intensywność przejścia to hazard dla jednej „strzałki” na diagramie stanów. Każde przejście może mieć własne predyktory i własne efekty – w praktyce dopasowuje się osobny model Coxa dla każdego przejścia, a w zbiorze ryzyka są tylko osoby przebywające w stanie wyjściowym. Drugim wynikiem są prawdopodobieństwa przebywania w stanach w chwili t, szacowane estymatorem Aalena–Johansena, który uogólnia krzywą Kaplana–Meiera. Putter, Fiocco i Geskus (2007) podkreślają, że takie analizy da się wykonać w standardowym oprogramowaniu, ale wymagają starannego przygotowania danych: każdy pobyt w stanie to osobny wiersz (tstart, tstop], podobnie jak przy zmiennych zależnych od czasu.
Przykład
W symulacji modelu choroba–zgon dla 600 osób zaobserwowano 308 przejść zdrowy → chory, 103 zgony bez choroby i 170 zgonów po zachorowaniu. Czynnik x zwiększał hazard zachorowania: HR = 2.34, 95% CI [1.86, 2.95] (prawdziwa wartość 2), bez wyraźnego wpływu na pozostałe przejścia (HR = 1.19 i 0.84). Po 5 latach zdrowych pozostawało 49.2% osób z x = 0 i 23.7% z x = 1, a chorych było odpowiednio 21.4% i 38.4%.
Na rysunku
Model wielostanowy ma dwa naturalne obrazy: diagram stanów ze strzałkami przejść i wykres, który pokazuje, jaka część osób przebywa w każdym stanie w kolejnych latach. Rysunek używa danych z przykładu wyżej (set.seed(648)).
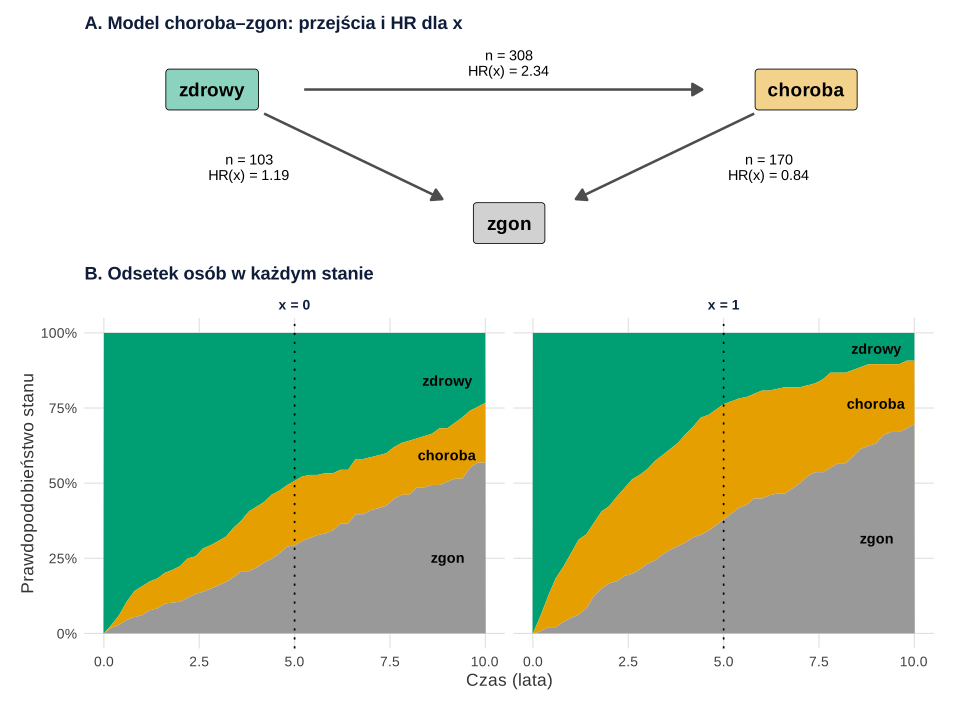
Co widać. Diagram streszcza tablicę przejść i model Coxa dla każdej strzałki osobno: czynnik x działa tylko na przejście zdrowy → chory (HR = 2.34). W panelu B wysokość każdego pasa to odsetek osób w danym stanie, a pasy zawsze sumują się do 100%. W 5. roku (linia kropkowana) zdrowych jest 49.2% osób z x = 0 i 23.7% z x = 1, chorych 21.4% i 38.4%. To liczby z przykładu, ale widać też ich drogę: przy x = 1 pas choroby rośnie szybciej, a pas zgonu rośnie za nim, bo chorzy umierają częściej niż zdrowi.
Na co uważać. Wykres warstwowy nie pokazuje przedziałów ufności ani liczby osób w obserwacji, która pod koniec maleje przez cenzurowanie. Granice między pasami trudno porównywać, bo każdy pas leży na innym (zob. wykres warstwowy). Do porównań lepiej narysować prawdopodobieństwo jednego stanu jako osobną linię. Pas „zgon” sumuje zgony bez choroby i po niej. Rozdzielenie ich na dwa stany końcowe daje skumulowane częstości ryzyk konkurujących. Położenie strzałek i ramek na diagramie dobrano ręcznie; ich odległości nic nie znaczą.
Podpis do pracy:
Kod poniżej odtwarza rysunek i odsetki z 5. roku. Jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka.
Kod R rysunku 1
# Rysunek 1. Diagram modelu choroba–zgon z liczbą przejść i HR dla x (A) oraz prawdopodobieństwa
# przebywania w stanach w czasie, estymator Aalena–Johansena (B). Dane jak w przykładzie hasła (set.seed(648)).
library(survival)
library(ggplot2)
library(patchwork)
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom", plot.title = element_text(face = "bold"))
kol <- c(zdrowy = "#009E73", choroba = "#E69F00", zgon = "#999999")   # Okabe–Ito; stany opisane też etykietami

# --- dane: kod identyczny z przykładem w haśle ---
set.seed(648)
n <- 600
x <- rbinom(n, 1, 0.5)
t_choroba <- rexp(n, 0.10 * exp(log(2) * x))
t_zgon0   <- rexp(n, 0.05)
t_cenz    <- runif(n, 2, 12)
wiersze <- vector("list", n)
for (i in 1:n) {
  if (min(t_choroba[i], t_zgon0[i]) > t_cenz[i]) {
    wiersze[[i]] <- data.frame(id = i, tstart = 0, tstop = t_cenz[i], stan = "cenzura", x = x[i])
  } else if (t_zgon0[i] < t_choroba[i]) {
    wiersze[[i]] <- data.frame(id = i, tstart = 0, tstop = t_zgon0[i], stan = "zgon", x = x[i])
  } else {
    t_zgon1 <- t_choroba[i] + rexp(1, 0.20)
    koniec <- min(t_zgon1, t_cenz[i])
    wiersze[[i]] <- data.frame(id = i, tstart = c(0, t_choroba[i]), tstop = c(t_choroba[i], koniec),
                               stan = c("choroba", if (t_zgon1 <= t_cenz[i]) "zgon" else "cenzura"), x = x[i])
  }
}
d <- do.call(rbind, wiersze)
d$stan <- factor(d$stan, c("cenzura", "choroba", "zgon"))
sc <- survcheck(Surv(tstart, tstop, stan) ~ 1, data = d, id = id)
m  <- coxph(Surv(tstart, tstop, stan) ~ x, data = d, id = id)
aj <- survfit(Surv(tstart, tstop, stan) ~ x, data = d, id = id)

# --- A. diagram stanów: liczba przejść z survcheck() i HR dla x z coxph() ---
hr <- summary(m)$conf.int[, 1]
wezly <- data.frame(x = c(0, 4, 2), y = c(1, 1, 0), stan = c("zdrowy", "choroba", "zgon"))
strz <- data.frame(x0 = c(0.62, 0.35, 3.65), y0 = c(1, 0.82, 0.82), x1 = c(3.3, 1.55, 2.45), y1 = c(1, 0.18, 0.18),
                   etyk = sprintf("n = %d\nHR(x) = %.2f",
                                  c(sc$transitions["(s0)", "choroba"], sc$transitions["(s0)", "zgon"],
                                    sc$transitions["choroba", "zgon"]), hr),
                   lx = c(2, 0.25, 3.75), ly = c(1.2, 0.42, 0.42))
pA <- ggplot() +
  geom_segment(data = strz, aes(x0, y0, xend = x1, yend = y1), linewidth = 0.9, colour = "grey30",
               arrow = arrow(length = unit(3, "mm"), type = "closed")) +
  geom_label(data = wezly, aes(x, y, label = stan, fill = stan), size = 5, fontface = "bold",
             label.padding = unit(0.6, "lines"), show.legend = FALSE) +
  geom_text(data = strz, aes(lx, ly, label = etyk), size = 3.8, lineheight = 0.9) +
  scale_fill_manual(values = alpha(kol, 0.45)) +
  coord_cartesian(xlim = c(-0.6, 4.6), ylim = c(-0.15, 1.35)) +
  labs(title = "A. Model choroba–zgon: przejścia i HR dla x") + theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold"))

# --- B. prawdopodobieństwa stanów w czasie (Aalen–Johansen), osobno dla x = 0 i x = 1 ---
czasy <- seq(0, 10, by = 0.2)                     # siatka co 0.2 roku (mniejszy plik SVG)
s <- summary(aj, times = czasy, extend = TRUE)
ps <- data.frame(t = rep(s$time, 3), grupa = rep(as.character(s$strata), 3),
                 stan = factor(rep(c("zdrowy", "choroba", "zgon"), each = length(s$time)), names(kol)),
                 p = c(s$pstate[, 1], s$pstate[, 2], s$pstate[, 3]))
ps$grupa <- factor(ifelse(ps$grupa == "x=0", "x = 0", "x = 1"))
round(100 * xtabs(p ~ grupa + stan, subset(ps, t == 5)), 1)     # przekrój w 5. roku (jak w przykładzie)
etyk_B <- subset(ps, t == 9)                                     # etykiety stanów w środku pasów w 9. roku
etyk_B <- do.call(rbind, lapply(split(etyk_B, etyk_B$grupa), function(z) {
  z <- z[order(z$stan, decreasing = TRUE), ]; z$y <- cumsum(z$p) - z$p / 2; z }))
pB <- ggplot(ps, aes(t, p, fill = stan)) +
  geom_area() +                                                 # pasy ułożone: zgon na dole, zdrowy na górze
  geom_vline(xintercept = 5, linetype = "dotted") +
  geom_text(data = etyk_B, aes(9, y, label = stan), size = 3.8, fontface = "bold") +
  facet_wrap(~ grupa) +
  scale_fill_manual(values = kol, name = "Stan:") +
  scale_y_continuous(labels = function(v) paste0(100 * v, "%")) +
  labs(title = "B. Odsetek osób w każdym stanie", x = "Czas (lata)", y = "Prawdopodobieństwo stanu") + motyw
p1 <- pA / pB + plot_layout(heights = c(0.8, 1.2))
p1   # zapis: ggsave("model-wielostanowy-diagram-i-stany.svg", p1, width = 10, height = 7.4)
Wynik w R
       stan
grupa   zdrowy choroba zgon
  x = 0   49.2    21.4 29.3
  x = 1   23.7    38.4 37.9
Na co uważać
- Założenie Markowa. Standardowe estymatory zakładają, że przyszłe przejścia zależą od obecnego stanu, a nie od całej historii.
- Choroba jako zmienna z początku obserwacji. Przypisanie osobom grupy „chory” od startu, choć zachorowały później, prowadzi do błędu czasu nieśmiertelnego.
- Zgon to nie cenzurowanie. Traktowanie zgonu jak cenzurowania zawyża szacowaną częstość choroby.
- Sposób obserwacji. Jeśli stan sprawdzano tylko podczas wizyt, dokładny czas przejścia jest nieznany i potrzebne są metody dla danych przedziałowych.
Estymator Aalena–Johansena dla ryzyk konkurujących omawia wpis Ryzyka konkurencyjne: Fine–Gray i CIF.
Model choroba–zgon w R
Kod symuluje model choroba–zgon, zapisuje dane w formacie (tstart, tstop], sprawdza przejścia funkcją survcheck(), szacuje prawdopodobieństwa stanów estymatorem Aalena–Johansena i dopasowuje model Coxa z osobnym efektem dla każdego przejścia. Liczby w tekście pochodzą z tego kodu.
Przejścia, prawdopodobieństwa stanów i HR dla przejść
R
library(survival)
set.seed(648)
n <- 600
x <- rbinom(n, 1, 0.5)                          # np. czynnik ryzyka
t_choroba <- rexp(n, 0.10 * exp(log(2) * x))    # zdrowy -> chory: HR = 2 dla x = 1
t_zgon0   <- rexp(n, 0.05)                      # zdrowy -> zgon
t_cenz    <- runif(n, 2, 12)
wiersze <- vector("list", n)
for (i in 1:n) {
  if (min(t_choroba[i], t_zgon0[i]) > t_cenz[i]) {
    wiersze[[i]] <- data.frame(id = i, tstart = 0, tstop = t_cenz[i], stan = "cenzura", x = x[i])
  } else if (t_zgon0[i] < t_choroba[i]) {
    wiersze[[i]] <- data.frame(id = i, tstart = 0, tstop = t_zgon0[i], stan = "zgon", x = x[i])
  } else {
    t_zgon1 <- t_choroba[i] + rexp(1, 0.20)     # chory -> zgon
    koniec <- min(t_zgon1, t_cenz[i])
    wiersze[[i]] <- data.frame(id = i, tstart = c(0, t_choroba[i]), tstop = c(t_choroba[i], koniec),
                               stan = c("choroba", if (t_zgon1 <= t_cenz[i]) "zgon" else "cenzura"), x = x[i])
  }
}
d <- do.call(rbind, wiersze)
d$stan <- factor(d$stan, c("cenzura", "choroba", "zgon"))
sc <- survcheck(Surv(tstart, tstop, stan) ~ 1, data = d, id = id)
sc$transitions                                   # liczba przejść między stanami
aj <- survfit(Surv(tstart, tstop, stan) ~ x, data = d, id = id)   # Aalen–Johansen dla wielu stanów
aj$states                                        # kolejność stanów w pstate: (s0) = stan początkowy
s5 <- summary(aj, times = 5)
p5 <- s5$pstate; dimnames(p5) <- list(c("x=0", "x=1"), c("zdrowy", "choroba", "zgon"))
round(100 * p5, 1)                               # % osób w każdym stanie po 5 latach
m <- coxph(Surv(tstart, tstop, stan) ~ x, data = d, id = id)      # osobny model dla każdego przejścia
round(summary(m)$conf.int[, c(1, 3, 4)], 2)        # HR: 1:2 zdrowy->choroba, 1:3 zdrowy->zgon, 2:3 choroba->zgon
Wynik w R
         to
from      choroba zgon (censored)
  (s0)        308  103        189
  choroba       0  170        138
  zgon          0    0          0
[1] "(s0)"    "choroba" "zgon"
    zdrowy choroba zgon
x=0   49.2    21.4 29.3
x=1   23.7    38.4 37.9
      exp(coef) lower .95 upper .95
x_1:2      2.34      1.86      2.95
x_1:3      1.19      0.80      1.77
x_2:3      0.84      0.61      1.16
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet survival: survcheck(), survfit(), coxph()). Rysunek 1 wykonano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R (R package version 3.8-6) [Computer software]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym model wielostanowy różni się od analizy ryzyk konkurujących?
Ryzyka konkurujące to prosty przypadek modelu wielostanowego: jeden stan początkowy i kilka stanów końcowych, bez dalszych przejść. Model wielostanowy dopuszcza stany pośrednie, np. chorobę, z której można jeszcze przejść do zgonu, i pozwala badać, jak predyktory działają na każde przejście osobno.
Jak przygotować dane do modelu wielostanowego w R?
Każdy pobyt w stanie to osobny wiersz z identyfikatorem osoby, początkiem i końcem przedziału (tstart, tstop] oraz stanem, do którego osoba przeszła na końcu przedziału (czynnik z pierwszym poziomem oznaczającym cenzurowanie). Funkcja survcheck() z pakietu survival pokazuje tablicę przejść i wykrywa błędy, np. nakładające się przedziały.
Co oznacza założenie Markowa w modelu wielostanowym?
Że hazard przejścia zależy tylko od obecnego stanu, czasu od początku obserwacji i predyktorów, a nie od wcześniejszej historii, np. tego, jak długo osoba jest już chora. Gdy to wątpliwe, można mierzyć czas od wejścia do stanu (model semi-Markowa) albo dodać czas pobytu jako predyktor.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Andersen, P. K., & Keiding, N. (2002). Multi-state models for event history analysis. Statistical Methods in Medical Research, 11(2), 91–115. https://doi.org/10.1191/0962280202sm276ra
- Putter, H., Fiocco, M., & Geskus, R. B. (2007). Tutorial in biostatistics: Competing risks and multi-state models. Statistics in Medicine, 26(11), 2389–2430. https://doi.org/10.1002/sim.2712
Cytowania BibTeX
@article{andersen2002multistate, author={Andersen, Per Kragh and Keiding, Niels}, title={{Multi-state models for event history analysis}}, journal={Statistical Methods in Medical Research}, year={2002}, volume={11}, number={2}, pages={91--115}, doi={10.1191/0962280202sm276ra}}@article{putter2007tutorial, author={Putter, Hein and Fiocco, Marta and Geskus, Ronald B.}, title={{Tutorial in biostatistics: Competing risks and multi-state models}}, journal={Statistics in Medicine}, year={2007}, volume={26}, number={11}, pages={2389--2430}, doi={10.1002/sim.2712}}