Co to są zdarzenia nawracające?
Zdarzenia nawracające (ang. recurrent events) to zdarzenia, które mogą wystąpić u tej samej osoby więcej niż raz: nawroty nowotworu, hospitalizacje, napady padaczkowe, infekcje. Amorim i Cai (2015) zauważają, że większość analiz ogranicza się do czasu do pierwszego zdarzenia i pomija kolejne. Omawiają modele dla wielu zdarzeń: warunkowe AG, PWP-TT i PWP-GT, modele brzegowe średnich i częstości, modele słabości i modele wielostanowe.
Andersen–Gill i PWP
Andersen i Gill (1982) rozszerzyli model Coxa na wielowymiarowe procesy liczące: predyktory działają proporcjonalnie na intensywność zdarzeń, co pozwala analizować zdarzenia nawracające przy złożonym cenzurowaniu i zmiennych zależnych od czasu. W modelu AG wszystkie zdarzenia mają wspólny hazard bazowy, a dane zapisuje się jako przedziały (start, stop].
Prentice, Williams i Peterson (1981) zaproponowali modele stratyfikowane według kolejnego numeru zdarzenia. Czas liczy się od początku badania (PWP-TT, ang. total time) albo od poprzedniego zdarzenia (PWP-GT, ang. gap time). Do zbioru ryzyka dla k-tego zdarzenia wchodzą tylko osoby, które miały już k − 1 zdarzeń.
Na rysunku
Zanim wybierze się model, warto zobaczyć same zdarzenia: kto ma nawroty, ile i kiedy. Rysunek używa danych bladder2 z przykładu niżej, bez losowania.
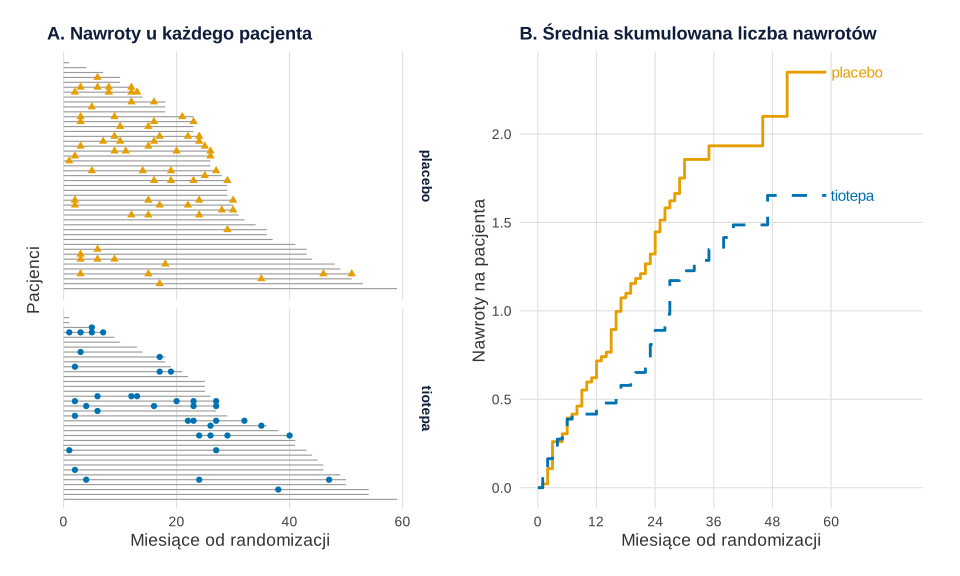
bladder2).Co widać. Panel A to prosta oś czasu, podobna do wykresu pływaka: każda linia to obserwacja jednego pacjenta, a każdy znacznik to nawrót. Część pacjentów ma po trzy–cztery nawroty, a w obu grupach wielu nie ma żadnego (18 z 47 przy placebo, 20 z 38 przy tiotepie). Analiza samego pierwszego zdarzenia odrzuca wszystko, co leży na prawo od pierwszego znacznika. Panel B pokazuje średnią skumulowaną liczbę nawrotów na pacjenta, liczoną jak estymator Nelsona–Aalena na danych (start, stop]. Po 12 miesiącach wynosi 0.72 przy placebo i 0.45 przy tiotepie, po 36 miesiącach 1.93 i 1.35. Pionowa odległość krzywych to różnica w średniej liczbie nawrotów. Stosunek ich nachyleń odpowiada w przybliżeniu ilorazowi intensywności, który model Andersena–Gilla szacuje dodatkowo z kontrolą innych zmiennych.
Na co uważać. Krzywe nie mają przedziałów ufności, a po 36 miesiącach w obserwacji zostaje tylko 13 i 16 pacjentów, więc dalsze schodki są niepewne. Średnia nie mówi, czy nawroty skupiają się u kilku osób – to widać dopiero w panelu A i to uzasadnia model słabości. Estymator zakłada, że cenzurowanie nie zależy od nawrotów. Wykres nie pokazuje też zgonów, które kończą obserwację.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z tej sekcji. Jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka.
Kod R rysunku 1
# Rysunek 1. Oś czasu każdego pacjenta z nawrotami (A) i średnia skumulowana liczba nawrotów
# na pacjenta, estymator Nelsona–Aalena (B). Dane bladder2 z pakietu survival; bez losowania.
library(survival)
library(ggplot2)
library(patchwork)
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom", plot.title = element_text(face = "bold"))
kol <- c(placebo = "#E69F00", tiotepa = "#0072B2")   # Okabe–Ito; grupy różnią też typ linii i etykiety

d <- bladder2
d$grupa <- factor(ifelse(d$rx == 1, "placebo", "tiotepa"), names(kol))
# A. jeden wiersz na pacjenta: obserwacja od 0 do końca, punkty = nawroty
pac <- aggregate(stop ~ id + grupa, data = d, FUN = max); names(pac)[3] <- "koniec"
pac$nawroty <- tapply(d$event, d$id, sum)[as.character(pac$id)]
pac <- pac[order(pac$grupa, -pac$koniec), ]
pac$wiersz <- ave(seq_len(nrow(pac)), pac$grupa, FUN = seq_along)   # numer wiersza w obrębie grupy
nawr <- merge(subset(d, event == 1, c(id, stop)), pac[, c("id", "grupa", "wiersz")])
table(grupa = pac$grupa, liczba_nawrotow = pac$nawroty)
pA <- ggplot(pac) +
  geom_segment(aes(x = 0, xend = koniec, y = wiersz, yend = wiersz), colour = "grey60", linewidth = 0.4) +
  geom_point(data = nawr, aes(stop, wiersz, colour = grupa, shape = grupa), size = 1.8) +
  facet_grid(grupa ~ ., scales = "free_y", space = "free_y") +
  scale_colour_manual(values = kol, guide = "none") + scale_shape_manual(values = c(17, 16), guide = "none") +
  scale_y_continuous(breaks = NULL) +
  labs(title = "A. Nawroty u każdego pacjenta", x = "Miesiące od randomizacji", y = "Pacjenci") + motyw

# B. średnia skumulowana liczba nawrotów: skumulowany hazard z danych (start, stop] liczonych łącznie
mcf <- survfit(Surv(start, stop, event) ~ grupa, data = d)
s <- summary(mcf, times = c(12, 24, 36))
data.frame(grupa = s$strata, miesiac = s$time, srednio_nawrotow = round(s$cumhaz, 2), w_ryzyku = s$n.risk)
krzywe <- data.frame(t = mcf$time, mcf = mcf$cumhaz,
                     grupa = factor(rep(names(kol), mcf$strata), names(kol)))
krzywe <- rbind(data.frame(t = 0, mcf = 0, grupa = factor(names(kol), names(kol))), krzywe)
etyk <- do.call(rbind, lapply(split(krzywe, krzywe$grupa), tail, 1))
pB <- ggplot(krzywe, aes(t, mcf, colour = grupa, linetype = grupa)) +
  geom_step(linewidth = 1) +
  geom_text(data = etyk, aes(label = grupa), hjust = -0.1, size = 4, show.legend = FALSE) +
  scale_colour_manual(values = kol, guide = "none") +
  scale_linetype_manual(values = c("solid", "dashed"), guide = "none") +
  scale_x_continuous(limits = c(0, 75), breaks = seq(0, 60, 12)) +
  labs(title = "B. Średnia skumulowana liczba nawrotów", x = "Miesiące od randomizacji",
       y = "Nawroty na pacjenta") + motyw
p1 <- pA + pB + plot_layout(widths = c(1, 1.1))
p1   # zapis: ggsave("zdarzenia-nawracajace-os-czasu-i-mcf.svg", p1, width = 10, height = 6)
Wynik w R
         liczba_nawrotow
grupa      0  1  2  3  4
  placebo 18 10  4  6  9
  tiotepa 20  8  3  2  5
          grupa miesiac srednio_nawrotow w_ryzyku
1 grupa=placebo      12             0.72       42
2 grupa=placebo      24             1.45       32
3 grupa=placebo      36             1.93       13
4 grupa=tiotepa      12             0.45       32
5 grupa=tiotepa      24             0.89       25
6 grupa=tiotepa      36             1.35       16
Przykład
W danych bladder2 (85 pacjentów, 112 nawrotów raka pęcherza, do czterech na osobę) iloraz hazardów dla tiotepy wobec placebo wynosi 0.59, 95% CI [0.32, 1.10], dla pierwszego nawrotu, 0.63 [0.37, 1.06] w modelu AG, 0.72 [0.48, 1.07] w PWP-TT i 0.76 [0.50, 1.15] w PWP-GT. Analiza samego pierwszego nawrotu wykorzystuje tylko 47 zdarzeń i pomija 65 kolejnych. Modele odpowiadają na różne pytania, więc dają różne liczby; w pracy podaj, który model wybrano i dlaczego.
Na co uważać
- Zależność zdarzeń. Bez odpornych błędów standardowych (
cluster(id)) przedziały ufności są zbyt wąskie. - Różnice między osobami. Część osób ma wiele nawrotów, część żadnego – rozważ model słabości.
- Zgon kończy obserwację. Gdy zgon jest częsty i związany z nawrotami, nie jest zwykłym cenzurowaniem.
- Liczba zdarzeń zamiast czasu. Jeśli znasz tylko liczby zdarzeń, użyj regresji Poissona z offsetem.
Zdarzenia nawracające w R
Kod porównuje cztery analizy tych samych danych: model Coxa dla pierwszego nawrotu, model Andersena–Gilla oraz modele PWP z czasem całkowitym i czasem od poprzedniego zdarzenia, wszystkie z odpornymi błędami standardowymi. Liczby w tekście pochodzą z tego kodu.
AG, PWP-TT i PWP-GT na danych bladder2
R
library(survival)
# dane bladder2 z pakietu survival: nawroty raka pęcherza, format licznikowy (start, stop]
d <- bladder2                      # rx: 1 = placebo, 2 = tiotepa
c(pacjenci = length(unique(d$id)), wiersze = nrow(d), nawroty = sum(d$event))
table(liczba_nawrotow = tapply(d$event, d$id, sum))
# 1. Tylko pierwsze zdarzenie (zwykły model Coxa)
pierwsze <- subset(d, enum == 1)
m0 <- coxph(Surv(stop, event) ~ rx + number + size, data = pierwsze)
# 2. Andersen–Gill: wspólny hazard bazowy, odporne SE na pacjenta
ag <- coxph(Surv(start, stop, event) ~ rx + number + size + cluster(id), data = d)
# 3. PWP czas całkowity: osobny hazard bazowy dla kolejnego zdarzenia
pwp_tt <- coxph(Surv(start, stop, event) ~ rx + number + size + strata(enum) + cluster(id), data = d)
# 4. PWP czas od poprzedniego zdarzenia (gap time)
pwp_gt <- coxph(Surv(stop - start, event) ~ rx + number + size + strata(enum) + cluster(id), data = d)
hr <- function(m) { s <- summary(m)$conf.int["rx", c(1, 3, 4)]; p <- coef(summary(m))["rx", ncol(coef(summary(m)))]; c(round(s, 2), p = round(p, 3)) }
rbind(pierwsze_zdarzenie = hr(m0), andersen_gill = hr(ag), pwp_tt = hr(pwp_tt), pwp_gt = hr(pwp_gt))
Wynik w R
pacjenci  wiersze  nawroty
      85      178      112
liczba_nawrotow
 0  1  2  3  4
38 18  7  8 14
                   exp(coef) lower .95 upper .95     p
pierwsze_zdarzenie      0.59      0.32      1.10 0.096
andersen_gill           0.63      0.37      1.06 0.080
pwp_tt                  0.72      0.48      1.07 0.103
pwp_gt                  0.76      0.50      1.15 0.196
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet survival: coxph() z cluster() i strata()). Rysunek 1 wykonano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R (R package version 3.8-6) [Computer software]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Który model zdarzeń nawracających wybrać: Andersena–Gilla czy PWP?
Andersen–Gill odpowiada na pytanie o średni wpływ predyktora na częstość wszystkich zdarzeń i zakłada, że ryzyko nie zależy od liczby wcześniejszych zdarzeń. PWP pozwala, by każde kolejne zdarzenie miało inny hazard bazowy, co pasuje, gdy drugi nawrót jest z natury bardziej (albo mniej) prawdopodobny niż pierwszy. Wybór uzasadnij pytaniem badawczym, a nie wartością p.
Dlaczego w modelu Andersena–Gilla stosuje się cluster(id)?
Kolejne zdarzenia tej samej osoby są ze sobą skorelowane, więc zwykłe błędy standardowe są zbyt małe. cluster(id) daje odporne (sandwiczowe) błędy standardowe liczone na poziomie osoby. Inną drogą jest jawne modelowanie zróżnicowania osób efektem losowym, czyli modelem słabości.
Czy zdarzenia nawracające można analizować regresją Poissona?
Tak, jeśli interesuje cię tylko liczba zdarzeń na osobę: model Poissona z offsetem log(czas obserwacji) albo model ujemny dwumianowy przy nadmiernej dyspersji. Traci się jednak informację o tym, kiedy zdarzenia wystąpiły, i trudniej uwzględnić zmienne zależne od czasu.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Amorim, L. D. A. F., & Cai, J. (2015). Modelling recurrent events: A tutorial for analysis in epidemiology. International Journal of Epidemiology, 44(1), 324–333. https://doi.org/10.1093/ije/dyu222 ● Otwarty dostęp: pełny tekst
- Andersen, P. K., & Gill, R. D. (1982). Cox's regression model for counting processes: A large sample study. The Annals of Statistics, 10(4), 1100–1120. https://doi.org/10.1214/aos/1176345976 ● Otwarty dostęp
- Prentice, R. L., Williams, B. J., & Peterson, A. V. (1981). On the regression analysis of multivariate failure time data. Biometrika, 68(2), 373–379. https://doi.org/10.1093/biomet/68.2.373
Cytowania BibTeX
@article{amorim2015modelling, author={Amorim, Leila D. A. F. and Cai, Jianwen}, title={{Modelling recurrent events: A tutorial for analysis in epidemiology}}, journal={International Journal of Epidemiology}, year={2015}, volume={44}, number={1}, pages={324--333}, doi={10.1093/ije/dyu222}}@article{andersen1982cox, author={Andersen, P. K. and Gill, R. D.}, title={{Cox's regression model for counting processes: A large sample study}}, journal={The Annals of Statistics}, year={1982}, volume={10}, number={4}, pages={1100--1120}, doi={10.1214/aos/1176345976}}@article{prentice1981regression, author={Prentice, R. L. and Williams, B. J. and Peterson, A. V.}, title={{On the regression analysis of multivariate failure time data}}, journal={Biometrika}, year={1981}, volume={68}, number={2}, pages={373--379}, doi={10.1093/biomet/68.2.373}}