Co to jest wykres Pareto?
Wykres Pareto (ang. Pareto chart) to wykres słupkowy liczebności kategorii posortowanych malejąco, zwykle z linią sum skumulowanych dodawanych od lewej do prawej (Wilkinson, 2006). Słupki odczytuje się na lewej osi (liczebność), a linię – na prawej (skumulowany odsetek). Jest szeroko stosowany w kontroli jakości do wskazywania głównych przyczyn wad lub awarii.
Nazwa nawiązuje do zasady Pareto, czyli reguły 80/20: niewielka część przyczyn odpowiada za większość skutków. Alkiayat (2021) przypisuje Juranowi dodanie linii skumulowanej oraz określenia „nieliczne istotne” i „liczne mniej ważne” przyczyny, zaznaczając, że 80/20 to tylko przybliżenie.
Jak czytać wykres Pareto
- Słupki pokazują, ile razy wystąpiła każda przyczyna; najwyższy stoi po lewej.
- Linia skumulowana mówi, jaki odsetek wszystkich przypadków wyjaśniają przyczyny od lewej do danego punktu. Jej pierwszy punkt leży na szczycie pierwszego słupka, ostatni – na 100%.
- Pozioma linia 80% (opcjonalna) pomaga odczytać, ile przyczyn trzeba usunąć, żeby objąć cztery piąte problemu.
- Kategoria „Inne” stoi zawsze na końcu, niezależnie od wielkości – to zbiór przyczyn, a nie jedna przyczyna.
Wykres Pareto pokazuje stan w jednym okresie. Zmianę w czasie śledzi się na karcie kontrolnej.
Przykład
W symulowanym badaniu internetowym odrzucono 412 ankiet z dziesięciu powodów. Najczęstszy była ankieta przerwana (86, czyli 20.9%), a trzy pierwsze przyczyny objęły 48.5% odrzuceń. Próg 80% przekroczyła dopiero siódma przyczyna (83.0%). Trzy przyczyny – błąd w pytaniu kontrolnym, te same odpowiedzi w siatce i sprzeczne odpowiedzi – dotyczą nieuważnego wypełniania. Prawdopodobieństwa przyczyn ustawiono ręcznie; ziarna (770) nie zmieniano.
Na rysunku
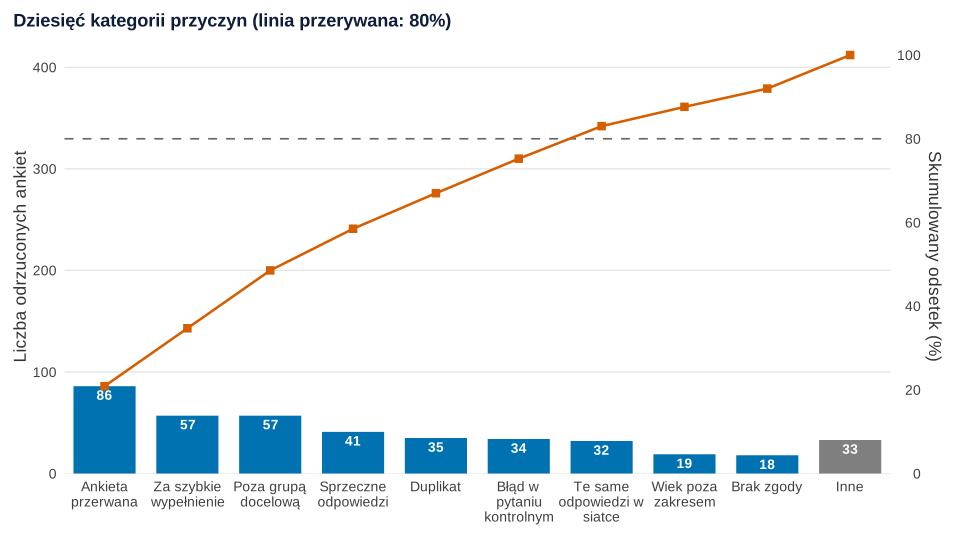
set.seed(770)).Co widać. Linia skumulowana rośnie łagodnie: do 80% potrzeba siedmiu z dziesięciu kategorii, więc reguła 80/20 tu nie działa. Szary słupek „Inne” (33) jest wyższy niż trzy nazwane przyczyny.
Na co uważać. Kształt wykresu zależy od tego, jak podzielono przyczyny. Duża kategoria „Inne” to sygnał, że warto ją rozbić. Odwrotnie, rozdrobnienie jednego problemu na kilka kategorii obniża jego słupki.
Podpis do pracy:
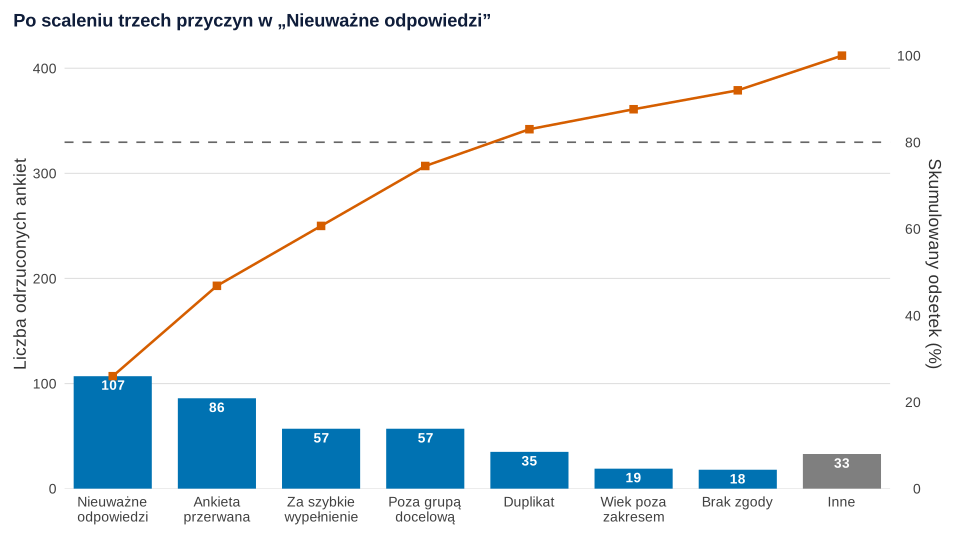
set.seed(770)).Co widać. Po scaleniu najczęstszą przyczyną są nieuważne odpowiedzi (107, czyli 26.0%), a nie przerwana ankieta. Dwie pierwsze przyczyny obejmują 46.8% odrzuceń, a 80% osiąga piąta z ośmiu kategorii.
Na co uważać. Żaden z dwóch rysunków nie jest „prawdziwy” – podział odpowiada na inne pytanie. Ustal kategorie przed liczeniem (najlepiej według tego, co da się naprawić jednym działaniem) i opisz je w pracy. Wykres liczy zdarzenia, a nie ich koszt: rzadka przyczyna może być ważniejsza.
Podpis do pracy:
Jak opisać w pracy
W rozdziale o próbie podaj liczbę wykluczonych przypadków, kryteria i ich częstość – wykres Pareto może zastąpić tabelę. Kryteria wykluczania omawia hasło czyszczenie danych z ankiety online.
Na co uważać
- Dwie osie bez opisu. Oś odsetka skumulowanego musi być podpisana, a 100% na prawej osi powinno odpowiadać sumie wszystkich przypadków na lewej.
- Reguła 80/20 jako dogmat. To przybliżenie (Alkiayat, 2021). Podaj, ile przyczyn faktycznie daje 80%.
- Przyczyna a mechanizm. Wykres przyczyn braków nie mówi, czy dane brakują losowo; o tym rozstrzyga analiza mechanizmu braków danych. Inne sposoby pokazania braków opisuje wpis braki danych na wykresie.
- Kategorie nominalne, nie czas. Sortowanie według liczebności ma sens tylko wtedy, gdy kategorie nie mają naturalnego porządku. Przykład z obrotami klientów jest we wpisie statystyka w ekonomii – zadania.
Wykres Pareto w R
Kod losuje przyczyny odrzucenia, a funkcja pareto() sortuje kategorie (z „Inne” na końcu), liczy odsetek skumulowany i rysuje słupki z linią w ggplot2; prawą oś daje sec_axis(). Rysunki na stronie powstały z tych samych obiektów p1 i p2 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Wykres Pareto i scalanie kategorii
Kod R rysunków 1 i 2
# Wykres Pareto: przyczyny odrzucenia ankiet (rysunek 1) i te same dane po scaleniu kategorii (rysunek 2)
suppressPackageStartupMessages({library(ggplot2)})
oi <- c(niebieski = "#0072B2", cynober = "#D55E00", szary = "grey50")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), panel.grid.major.x = element_blank(),
                                             plot.title.position = "plot")
zawin <- function(x, szer = 13) sapply(x, function(s) paste(strwrap(s, szer), collapse = "\n"))

# Przyczyny odrzucenia 412 ankiet internetowych (dane symulowane, prawdopodobieństwa ustawione ręcznie)
set.seed(770)
przyczyny <- c("Ankieta przerwana", "Za szybkie wypełnienie", "Poza grupą docelową", "Błąd w pytaniu kontrolnym",
               "Te same odpowiedzi w siatce", "Sprzeczne odpowiedzi", "Duplikat", "Brak zgody",
               "Wiek poza zakresem", "Inne")
p <- c(.22, .13, .11, .10, .09, .08, .07, .05, .04, .11)
n <- as.vector(rmultinom(1, size = 412, prob = p))
d1 <- data.frame(przyczyna = przyczyny, n = n)

pareto <- function(d, tytul) {
  inne <- d[d$przyczyna == "Inne", ]                                   # „Inne” zawsze na końcu
  d <- rbind(d[d$przyczyna != "Inne", ][order(-d$n[d$przyczyna != "Inne"]), ], inne)
  d$skum <- 100 * cumsum(d$n) / sum(d$n)
  d$poz <- seq_len(nrow(d))
  N <- sum(d$n)
  w <- ggplot(d, aes(x = poz)) +
    geom_col(aes(y = n, fill = przyczyna == "Inne"), width = 0.75, show.legend = FALSE) +
    geom_hline(yintercept = 0.8 * N, linetype = "dashed", colour = "grey40") +
    geom_line(aes(y = skum / 100 * N), colour = oi[["cynober"]], linewidth = 0.9) +
    geom_point(aes(y = skum / 100 * N), colour = oi[["cynober"]], shape = 15, size = 2.6) +
    geom_text(aes(y = n, label = n), vjust = 1.4, size = 3.6, colour = "white", fontface = "bold") +
    scale_fill_manual(values = c("FALSE" = oi[["niebieski"]], "TRUE" = oi[["szary"]])) +
    scale_x_continuous(breaks = d$poz, labels = zawin(d$przyczyna), expand = c(0.01, 0.01)) +
    scale_y_continuous(name = "Liczba odrzuconych ankiet", limits = c(0, N), expand = expansion(mult = c(0, 0.04)),
                       sec.axis = sec_axis(~ . / N * 100, name = "Skumulowany odsetek (%)", breaks = seq(0, 100, 20))) +
    labs(title = tytul, x = NULL)
  list(wykres = w, tabela = d[, c("przyczyna", "n", "skum")])
}

r1 <- pareto(d1, "Dziesięć kategorii przyczyn (linia przerywana: 80%)")
print(transform(r1$tabela, skum = round(skum, 1)), row.names = FALSE)

# Rysunek 2: trzy przyczyny związane z nieuważnym wypełnianiem połączone w jedną kategorię
nieuwaga <- c("Błąd w pytaniu kontrolnym", "Te same odpowiedzi w siatce", "Sprzeczne odpowiedzi")
d2 <- rbind(data.frame(przyczyna = "Nieuważne odpowiedzi", n = sum(d1$n[d1$przyczyna %in% nieuwaga])),
            d1[!d1$przyczyna %in% nieuwaga, ])
r2 <- pareto(d2, "Po scaleniu trzech przyczyn w „Nieuważne odpowiedzi”")
print(transform(r2$tabela, skum = round(skum, 1)), row.names = FALSE)

p1 <- r1$wykres + motyw
p2 <- r2$wykres + motyw
p1
p2
Wynik w R
                   przyczyna  n  skum
           Ankieta przerwana 86  20.9
      Za szybkie wypełnienie 57  34.7
         Poza grupą docelową 57  48.5
        Sprzeczne odpowiedzi 41  58.5
                    Duplikat 35  67.0
   Błąd w pytaniu kontrolnym 34  75.2
 Te same odpowiedzi w siatce 32  83.0
          Wiek poza zakresem 19  87.6
                  Brak zgody 18  92.0
                        Inne 33 100.0
              przyczyna   n  skum
   Nieuważne odpowiedzi 107  26.0
      Ankieta przerwana  86  46.8
 Za szybkie wypełnienie  57  60.7
    Poza grupą docelową  57  74.5
               Duplikat  35  83.0
     Wiek poza zakresem  19  87.6
             Brak zgody  18  92.0
                   Inne  33 100.0
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie – funkcja bazowa rmultinom(); rysunki – pakiet ggplot2). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Co pokazuje linia na wykresie Pareto?
Skumulowany odsetek wszystkich przypadków: przy każdej kategorii – jaką część problemu wyjaśniają ona i wszystkie przyczyny stojące na lewo od niej. Odczytuje się ją na prawej osi; kończy się na 100%.
Czy na wykresie Pareto zawsze musi wyjść 80/20?
Nie. Reguła 80/20 to przybliżenie, a nie prawo. Przy wielu podobnie częstych przyczynach linia rośnie łagodnie i do 80% potrzeba większości kategorii – to też wynik, który warto podać.
Jak zrobić wykres Pareto w R?
Posortuj kategorie malejąco (z „Inne” na końcu), policz cumsum() liczebności i podziel przez sumę. W ggplot2 słupki rysuje geom_col(), linię – geom_line() z punktami, a prawą oś procentową – sec_axis() w scale_y_continuous().
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Braki danych na wykresie
Mapa braków, wzorce UpSet, braki na wykresie rozrzutu i w grupach oraz schodek porzucenia ankiety w R – z podpisami do pracy i zdaniami do Wyników.
Czytaj →PoradnikStatystyka w ekonomii – zadania z rozwiązaniami
Dziesięć zadań jak na kolokwium: indeksy łańcuchowe, Laspeyres i Paasche, zmiana realna, Gini z kwintyli, koncentracja, trend i sezonowość.
Czytaj →PoradnikWykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →PoradnikAnaliza ABC/XYZ asortymentu
Hurtownia części: krzywa Lorenza, umowne progi ABC, CV popytu i tygodnie bez sprzedaży, macierz ABC × XYZ i stabilność klas – pięć rysunków z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Alkiayat, M. (2021). A practical guide to creating a Pareto chart as a quality improvement tool. Global Journal on Quality and Safety in Healthcare, 4(2), 83–84. https://doi.org/10.36401/jqsh-21-x1 ● Otwarty dostęp
- Wilkinson, L. (2006). Revising the Pareto chart. The American Statistician, 60(4), 332–334. https://doi.org/10.1198/000313006x152243
Cytowania BibTeX
@article{alkiayat2021practical, author={Alkiayat, Mohammad}, title={{A practical guide to creating a Pareto chart as a quality improvement tool}}, journal={Global Journal on Quality and Safety in Healthcare}, year={2021}, volume={4}, number={2}, pages={83--84}, doi={10.36401/jqsh-21-x1}}@article{wilkinson2006revising, author={Wilkinson, Leland}, title={{Revising the Pareto chart}}, journal={The American Statistician}, year={2006}, volume={60}, number={4}, pages={332--334}, doi={10.1198/000313006x152243}}