Sześć typowych projektów w pracy z biologii i ochrony środowiska
Prace dyplomowe z biologii i ochrony środowiska łączą bardzo różne dane: pomiary roślin na kilku stanowiskach, liczby osobników złowionych w pułapki, spisy gatunków z płatów roślinności, parametry wody mierzone co miesiąc i ankiety o postawach wobec przyrody. Każdy z tych typów danych wymaga innego modelu, a wspólny mianownik jest jeden: najpierw ustal, co jest niezależnym powtórzeniem. W badaniach terenowych to częściej stanowisko, staw albo płat niż pojedyncza próbka. Tabela porządkuje sześć projektów omówionych w tym poradniku.
| Projekt | Typowe pytanie | Dane | Analiza główna | Wielkość efektu |
|---|---|---|---|---|
| 1. Porównanie stanowisk | Czy rośliny z miejsc wydeptywanych mają krótsze liście? | pomiar ciągły i ocena porządkowa (0–4), 4 stanowiska | ANOVA Welcha z testem Gamesa–Howella; Kruskal–Wallis z testem Dunna | ω², ε² z 95% CI |
| 2. Liczebność w pułapkach | Czy w lasach gospodarczych łowi się mniej biegaczowatych niż w rezerwatach? | zliczenia, pułapki zagnieżdżone w stanowiskach, różny czas ekspozycji | ujemny dwumianowy model mieszany z offsetem albo analiza na poziomie stanowisk | iloraz częstości (IRR) z 95% CI |
| 3. Różnorodność gatunkowa | Czy łąki niekoszone są bogatsze w gatunki? | liczebności gatunków na płatach | wskaźniki Shannona i Simpsona, rozrzedzanie, test Welcha; skład – PERMANOVA | g Hedgesa, R² z PERMANOVA |
| 4. Cechy środowiska | Co wiąże się z liczbą gatunków roślin wodnych w stawach? | kilka zmiennych na każdy staw | korelacje Spearmana, kontrola współliniowości | ρ Spearmana z p |
| 5. Monitoring w czasie | Czy stężenie azotanów w rzece maleje? | pomiary co miesiąc w kilku punktach | model mieszany z sezonem i autokorelacją AR(1) | trend na rok z 95% CI, amplituda sezonowa |
| 6. Postawy proekologiczne | Czy studenci kierunków przyrodniczych mają silniejsze postawy proekologiczne? | skala Likerta z pozycjami odwróconymi | α Cronbacha, test t Welcha, korelacja Spearmana | d Cohena, ρ |
Wszystkie dane w przykładach są symulowane, a liczby nie opisują żadnych rzeczywistych stanowisk, gatunków ani populacji. Pełny kod znajdziesz w sekcji Przykład w R. Nie wiesz, który test pasuje do Twojej hipotezy? Pomoże kreator doboru testu, a cały proces od pytania badawczego do rozdziału wyników opisuje przewodnik po statystyce w pracy dyplomowej.
Zanim zaczniesz: jednostka badawcza i pseudoreplikacja
Najczęstszy problem statystyczny w pracach przyrodniczych nie wynika z wyboru testu, tylko z liczenia powtórzeń. Pseudoreplikacja to testowanie efektu warunku na danych, w których warunek nie był powtórzony albo powtórzenia nie są od siebie niezależne. Hurlbert (1984) opisał ją jako testowanie z niewłaściwym członem błędu i znalazł ją w 27% ze 176 przejrzanych eksperymentów ekologicznych, czyli w 48% tych badań, w których autorzy użyli statystyki inferencyjnej.
W praktyce zadaj sobie trzy pytania, zanim zaczniesz zbierać dane:
- Czemu przypisany jest warunek, który porównujesz? Jeśli badasz wpływ sposobu użytkowania lasu, warunek mają całe drzewostany, a nie pułapki. Liczba niezależnych powtórzeń to liczba drzewostanów.
- Ile masz takich jednostek w każdej grupie? Jedno stanowisko na grupę to brak powtórzeń: możesz opisać różnicę między tymi dwoma miejscami, ale nie możesz jej przypisać czynnikowi, który je różni.
- Co jeszcze łączy pomiary? Pomiary w tym samym punkcie w kolejnych miesiącach, w sąsiednich płatach albo na tym samym osobniku są do siebie podobne. Trzeba to uwzględnić w modelu albo w planie analizy.
Zuur, Ieno i Elphick (2010), na podstawie doświadczeń z kursów statystyki dla ekologów, szacują, że mniej więcej połowa prac ich uczestników sprzed kursu zawierałaby naruszenia założeń stosowanych metod, a zależność obserwacji wymieniają wśród problemów, które da się wykryć przed analizą. Zaproponowany przez nich protokół eksploracji danych – wartości odstające, niejednorodność wariancji, współliniowość, zależność obserwacji, nadmiar zer – to dobra lista kontrolna do rozdziału o metodach.
Projekt 1. Porównanie stanowisk: ANOVA Welcha i test Kruskala–Wallisa
Przykład: zmierzono długość najdłuższego liścia u 25 roślin babki lancetowatej na każdym z czterech stanowisk różniących się wydeptywaniem: trawnik wydeptywany, pobocze ścieżki, łąka koszona i łąka niekoszona. Dodatkowo każdą roślinę oceniono na skali uszkodzeń mechanicznych od 0 (brak) do 4 (silne). Pytanie dotyczy tych czterech konkretnych miejsc, więc 25 roślin na stanowisku to rozsądne powtórzenia. Gdyby jednak teza brzmiała „wydeptywanie skraca liście”, jedno stanowisko na poziom czynnika by nie wystarczyło – patrz ramka o pseudoreplikacji wyżej.
Pomiar ciągły: ANOVA Welcha i test Gamesa–Howella
Średnia długość liścia wynosiła 6.00 cm (SD = 1.20) na trawniku, 7.63 cm (SD = 2.21) na poboczu, 10.05 cm (SD = 2.88) na łące koszonej i 11.76 cm (SD = 3.09) na łące niekoszonej. Odchylenia standardowe rosną razem ze średnią, co w pomiarach biologicznych zdarza się bardzo często. Dlatego zamiast klasycznej ANOVA wybierz ANOVA Welcha, która nie zakłada równych wariancji. Długość liścia różniła się między stanowiskami, F(3, 49.29) = 33.98, p < .001, ω² = .44, 95% CI [.28, .55]. Porównania parami testem Gamesa–Howella, który też nie wymaga równych wariancji, wykazały różnice między wszystkimi parami stanowisk (p ≤ .013) z wyjątkiem obu łąk (p = .194).
Ocena porządkowa: Kruskal–Wallis i test Dunna
Skala uszkodzeń ma pięć uporządkowanych kategorii, więc średnia z kodów 0–4 byłaby trudna do obrony. Właściwy jest test Kruskala–Wallisa z medianami i rozstępem ćwiartkowym w opisie. Mediana uszkodzeń wynosiła 3 (Q1–Q3: 2–3) na trawniku, 2 (2–3) na poboczu, 2 (1–2) na łące koszonej i 1 (1–2) na łące niekoszonej. Różnice były istotne, H(3) = 21.29, p < .001, ε² = .22, 95% CI [.11, .40]. Test Dunna z poprawką Holma wskazał, że trawnik różni się od pozostałych trzech stanowisk (p = .031, .003 i < .001), a pozostałe pary nie różniły się istotnie (p ≥ .257). Obie procedury krok po kroku w programie z menu opisujemy w poradnikach ANOVA w jamovi i testy nieparametryczne w jamovi, a przećwiczyć je możesz na zadaniach z ANOVA z rozwiązaniami.
Projekt 2. Liczebność w pułapkach: zliczenia, offset i pseudoreplikacja
To najważniejszy projekt w tym poradniku, bo łączy trzy pułapki naraz: zliczenia, różny czas obserwacji i zagnieżdżenie. Przykład: na 12 stanowiskach (6 w rezerwatach i 6 w lasach gospodarczych) ustawiono po 8 pułapek Barbera i policzono złowione biegaczowate. Pułapki miały działać 14 dni, ale część została zalana lub zniszczona i pracowała krócej. Dane z tego przykładu możesz pobrać: biologia-pulapki-barbera-dane.csv (96 wierszy: stanowisko, typ lasu, numer pułapki, liczba dni, liczba osobników).
Krok 1. Opis rozkładu i stanowisk
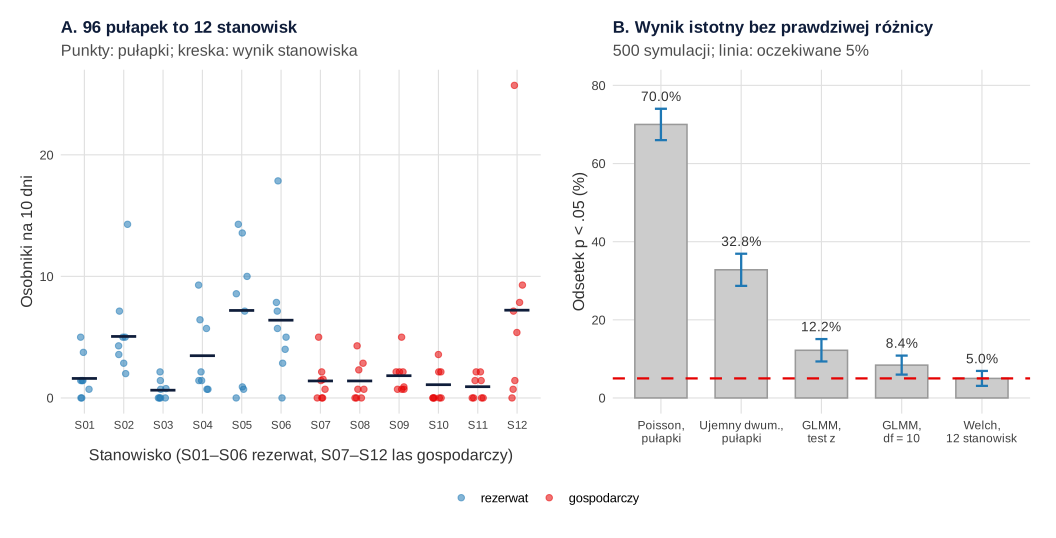
Średnio w pułapce było 4.24 osobnika, ale wariancja wyniosła 34.10, w 24 pułapkach (25.0%) nie było żadnego osobnika, a w jednej – 36. To typowy obraz zliczeń biologicznych: dużo zer, długi prawy ogon i wariancja wielokrotnie większa od średniej. Zanim policzysz model, przelicz wynik każdego stanowiska na wspólną jednostkę, np. liczbę osobników na 10 dni pracy pułapek. W rezerwatach wahała się od 0.63 do 7.20, a w lasach gospodarczych od 0.93 do 7.21. Już ten opis pokazuje, że stanowiska różnią się między sobą bardzo mocno, także w obrębie jednego typu lasu.
Krok 2. Błąd: 96 pułapek jako 96 powtórzeń
Najprostsza analiza to regresja Poissona na 96 pułapkach z typem lasu jako predyktorem i logarytmem liczby dni jako offsetem (dzięki niemu model porównuje liczbę osobników na dzień, a nie surowe sumy). Daje ona iloraz częstości IRR = 0.58, 95% CI [0.48, 0.71], p < .001, czyli „w lasach gospodarczych łowi się o 42% mniej biegaczowatych”. Ten wynik jest jednak podwójnie błędny. Po pierwsze, współczynnik rozproszenia wynosi 8.07 zamiast około 1, a model przewiduje 2.5 pułapki z zerem, choć obserwowano 24 – to nadmierna dyspersja. Po drugie, pułapki z jednego stanowiska nie są niezależne. Przejście na regresję ujemną dwumianową naprawia pierwszy problem (24.6 przewidywanych zer), ale nie drugi: IRR = 0.56, 95% CI [0.34, 0.93], p = .026, wciąż „istotne”.
Nie ratuj się logarytmowaniem zliczeń i zwykłą ANOVA. O’Hara i Kotze (2010) pokazali w symulacjach, że transformacje logarytmiczna i pierwiastkowa zliczeń działają słabo (z wyjątkiem małego rozproszenia i dużych średnich), a modele quasi-Poissona i ujemny dwumianowy dla surowych zliczeń są konsekwentnie lepsze. Szczegóły modeli dla zliczeń, w tym model z nadmiarem zer na wypadek, gdyby nawet model ujemny dwumianowy zaniżał liczbę zer, opisujemy w poradniku regresja dla zliczeń krok po kroku.
Krok 3. Model mieszany z losowym efektem stanowiska
Właściwy model ma stanowisko jako efekt losowy: ujemny dwumianowy uogólniony liniowy model mieszany (GLMM) z offsetem. Oszacowanie efektu jest podobne, IRR = 0.53, ale przedział ufności jest znacznie szerszy, 95% CI [0.22, 1.27], p = .154. Odchylenie standardowe stanowisk na skali logarytmicznej wyniosło 0.66, co oznacza, że typowe stanowisko różni się od średniej swojego typu lasu mniej więcej dwukrotnie w górę lub w dół. Ta zmienność między stanowiskami jest właściwym tłem, na którym trzeba ocenić różnicę między typami lasu.
Jest jeszcze jeden haczyk. Przy zaledwie 12 stanowiskach test Walda (statystyka z) w modelu mieszanym jest zbyt liberalny. Bolker i in. (2009) w przewodniku po GLMM dla ekologów podkreślają, że wnioskowanie i testowanie hipotez w takich modelach pozostaje trudne. Prostym zabezpieczeniem jest przyjęcie rozkładu t z liczbą stopni swobody równą liczbie stanowisk minus 2 (tu 10): IRR = 0.53, 95% CI [0.20, 1.43], p = .184. Równie dobrym, a często najbardziej przekonującym podejściem jest analiza na poziomie stanowisk: 12 wyników (logarytm liczby osobników na dzień) porównanych testem Welcha. Daje ona iloraz 0.57, 95% CI [0.19, 1.66], t(9.49) = 1.19, p = .264. Zwróć uwagę, że w danych są stanowiska bardzo bogate w obu typach lasu (S05 i S12) i bardzo ubogie (S03 i S11) – z 12 stanowisk nie da się więc rozstrzygnąć, czy typ lasu ma znaczenie.
Krok 4. Ile kosztuje pseudoreplikacja? Symulacja
Rysunek 1B pokazuje wynik 500 symulowanych badań z tym samym układem (12 stanowisk po 8 pułapek), w których typ lasu nie miał żadnego wpływu. Regresja Poissona na pułapkach dała wynik istotny w 70.0% badań, a regresja ujemna dwumianowa na pułapkach w 32.8%, zamiast oczekiwanych 5%. Model mieszany z testem z dał 12.2%, z rozkładem t o 10 stopniach swobody – 8.4%, a test Welcha na 12 wynikach stanowisk – 5.0%. Najważniejsza decyzja nie dotyczy więc rozkładu (Poisson czy ujemny dwumianowy), tylko tego, co jest powtórzeniem. Jeśli możesz, zaplanuj więcej stanowisk, a mniej pułapek na stanowisku – to liczba stanowisk decyduje o mocy. Model mieszany w wersji dla danych ciągłych opisujemy w poradniku model wielopoziomowy krok po kroku.
| Analiza | Co jest powtórzeniem | IRR [95% CI] | p | Odsetek p < .05 bez efektu |
|---|---|---|---|---|
| Regresja Poissona | pułapka (n = 96) | 0.58 [0.48, 0.71] | < .001 | 70.0% |
| Regresja ujemna dwumianowa | pułapka (n = 96) | 0.56 [0.34, 0.93] | .026 | 32.8% |
| GLMM ujemny dwumianowy, test z | stanowisko (losowy efekt) | 0.53 [0.22, 1.27] | .154 | 12.2% |
| GLMM ujemny dwumianowy, t(10) | stanowisko (losowy efekt) | 0.53 [0.20, 1.43] | .184 | 8.4% |
| Test Welcha na wynikach stanowisk | stanowisko (n = 12) | 0.57 [0.19, 1.66] | .264 | 5.0% |
Projekt 3. Różnorodność gatunkowa: Shannon, Simpson i rozrzedzanie
Przykład: na 16 płatach łąki (8 koszonych i 8 niekoszonych) policzono osobniki wszystkich gatunków roślin z puli 30 gatunków. Jednostką analizy jest płat, więc każdy wskaźnik różnorodności liczysz osobno dla płatu, a dopiero potem porównujesz grupy.
Które wskaźniki policzyć
Liczba gatunków (S) jest najprostsza, ale silnie zależy od tego, ile osobników policzono. Wskaźnik Shannona to entropia Shannona rozkładu osobników między gatunki: uwzględnia i liczbę gatunków, i ich równomierność. Wskaźnik Simpsona opiera się na prawdopodobieństwie, że dwa losowo wybrane osobniki należą do tego samego gatunku, i jest wrażliwy głównie na gatunki dominujące. Hill (1973) pokazał, że liczba gatunków, entropia Shannona i indeks Simpsona należą do jednej rodziny miar, które można interpretować jako efektywną liczbę gatunków i które różnią się tym, na ile uwzględniają gatunki rzadkie. Jost (2006) przekonuje, że to właśnie efektywna liczba gatunków, a nie surowa entropia, zachowuje się jak miara różnorodności. Dlatego w pracy podawaj exp(H) i odwrotność indeksu Simpsona (1/D), a surowe H traktuj jako wynik pośredni.
| Wskaźnik | Łąka koszona | Łąka niekoszona |
|---|---|---|
| Liczba osobników na płacie | 149.0 | 151.5 |
| Liczba gatunków S | 19.88 | 22.88 |
| S rozrzedzone do 81 osobników | 16.51 | 18.89 |
| Entropia Shannona H (naty) | 2.22 | 2.46 |
| Efektywna liczba gatunków exp(H) | 9.54 | 11.88 |
| Odwrotność indeksu Simpsona 1/D | 6.03 | 7.62 |
| Równomierność Pielou J = H / ln S | .74 | .79 |
Płaty miały różną liczbę osobników (najmniej 81), więc liczbę gatunków porównaj po rozrzedzeniu (ang. rarefaction), czyli policz, ile gatunków spodziewasz się na każdym płacie przy losowaniu 81 osobników. Rozrzedzona liczba gatunków była większa na łąkach niekoszonych (M = 18.89, SD = 1.66) niż koszonych (M = 16.51, SD = 1.84), t(13.85) = 2.72, p = .017, różnica 2.38 gatunku, 95% CI [0.50, 4.26]. Efektywna liczba gatunków exp(H) też była wyższa na łąkach niekoszonych (11.88 wobec 9.54), ale przy 8 płatach na grupę różnica nie osiągnęła istotności, t(13.72) = 1.79, p = .096, g Hedgesa = 0.84, 95% CI [−0.15, 1.81]. Szeroki przedział to uczciwa informacja: 16 płatów to mało, by oszacować różnicę precyzyjnie.
Skład gatunkowy, a nie tylko liczba gatunków
Dwa siedliska mogą mieć tyle samo gatunków, ale zupełnie inne. Skład porównasz, licząc niepodobieństwo każdej pary płatów indeksem Braya–Curtisa i testując różnicę między grupami PERMANOVA. W przykładzie sposób użytkowania wyjaśniał 44% zmienności składu, pseudo-F(1, 14) = 10.85, R² = .44, p = .001 (999 permutacji). Rozproszenie płatów wokół środka grupy nie różniło się (p = .931), więc wynik dotyczy położenia grup, a nie tylko ich różnej zmienności.
Projekt 4. Cechy środowiska: korelacje, współliniowość i dane przestrzenne
Przykład: w 30 stawach zmierzono stężenie fosforu całkowitego, przewodność elektrolityczną, pH i głębokość, a także policzono gatunki roślin wodnych (makrofitów). Stężenia i przewodność mają zwykle rozkład prawoskośny, a związki bywają nieliniowe, dlatego naturalnym pierwszym krokiem jest macierz korelacji Spearmana, która opiera się na rangach.
W przykładzie liczba gatunków makrofitów korelowała ujemnie z fosforem, ρ = −.27, p = .146, i przewodnością, ρ = −.17, p = .378, a dodatnio z pH, ρ = .20, p = .292, i głębokością, ρ = .20, p = .281. Żadna korelacja nie była istotna. To nie znaczy, że związków nie ma: przy 30 stawach korelacja rzędu .20–.30 ma szeroki przedział ufności i małą moc, więc w pracy opisz wielkość i kierunek związku, a nie tylko „brak istotności”. Ważniejsza jest druga obserwacja: fosfor i przewodność korelowały ze sobą bardzo silnie, ρ = .74. Wstawione razem do regresji będą się „wyrywać” wariancję i ich współczynniki staną się niestabilne. Zuur i in. (2010) wymieniają współliniowość wśród problemów, które należy wykryć już w eksploracji danych – wybierz wtedy jedną zmienną na podstawie teorii albo zbuduj wskaźnik żyzności.
Dane przestrzenne – krótko. Stawy, stanowiska i punkty położone blisko siebie są zwykle bardziej podobne niż odległe. Dormann i in. (2007) przypominają, że jeśli ta autokorelacja przestrzenna zostaje w resztach modelu, narusza założenie niezależności, może obciążać oszacowania i zwiększać odsetek błędów I rodzaju. W pracy licencjackiej wystarczy zwykle zapisać współrzędne punktów, sprawdzić I Morana dla reszt modelu i w razie wyraźnej autokorelacji dodać efekt losowy obszaru albo użyć modelu z przestrzenną strukturą błędu. Bardziej złożone metody przestrzenne to temat na osobną konsultację z promotorem.
Projekt 5. Pomiary powtarzane w czasie: sezonowość i trend
Przykład: w 6 punktach na rzece przez 36 miesięcy mierzono stężenie azotanów (216 pomiarów). Pytanie brzmi, czy stężenie maleje z roku na rok. Takie dane mają trzy cechy, których nie wolno zignorować: sezonowość (zimą stężenia są wyższe), stałe różnice między punktami i podobieństwo kolejnych miesięcy w tym samym punkcie.
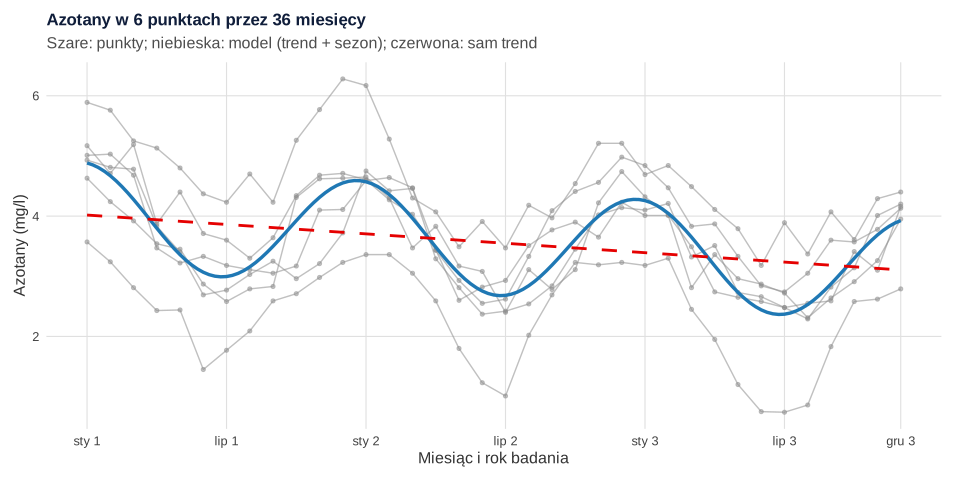
Sezon najprościej opisać dwiema zmiennymi: sinusem i cosinusem miesiąca (okres 12 miesięcy). Razem z trendem i losowym efektem punktu tworzą model mieszany, a zależność kolejnych miesięcy opisuje struktura autokorelacji AR(1) reszt. W przykładzie stężenie azotanów malało o 0.31 mg/l na rok, 95% CI [0.23, 0.40], t(207) = −7.28, p < .001. Amplituda sezonowa wyniosła 0.88 mg/l, a szczyt przypadał na przełom grudnia i stycznia. Autokorelacja kolejnych miesięcy wynosiła φ = .43, a odchylenie standardowe punktów 0.70 mg/l.
| Model | Trend (mg/l na rok) | 95% CI | Szerokość CI |
|---|---|---|---|
| Sam trend (regresja liniowa) | −0.33 | [−0.48, −0.18] | 0.30 |
| Trend + sezon | −0.31 | [−0.43, −0.20] | 0.24 |
| Trend + sezon + punkty, bez autokorelacji | −0.31 | [−0.37, −0.26] | 0.11 |
| Model mieszany: trend + sezon + punkt (losowy) + AR(1) | −0.31 | [−0.40, −0.23] | 0.17 |
Tabela pokazuje, że każdy element modelu ma znaczenie. Uwzględnienie sezonu i punktów zawęża przedział, bo usuwa przewidywalną zmienność. Pominięcie autokorelacji zawęża go jednak za bardzo: reszty kolejnych miesięcy w jednym punkcie korelowały na poziomie .33, więc 36 pomiarów niesie mniej informacji niż 36 niezależnych obserwacji. Model z AR(1) daje przedział szerszy i uczciwszy. Więcej o autokorelacji reszt i modelach dla jednego długiego szeregu przeczytasz w poradniku szeregi czasowe i ARIMA w praktyce.
Projekt 6. Ankieta postaw proekologicznych
Część prac z ochrony środowiska to badania ankietowe: postawy wobec przyrody, wiedza o zmianach klimatu, deklarowane zachowania proekologiczne. Do pomiaru postaw często używa się skali NEP (New Ecological Paradigm). Dunlap i in. (2000) opisali jej zrewidowaną wersję: 15 pozycji obejmujących szerszy zakres ekologicznego światopoglądu, ze zrównoważonym zestawem pozycji zgodnych i niezgodnych z tym światopoglądem, które w ich badaniu tworzyły spójną wewnętrznie skalę sumacyjną. Jeśli używasz polskiej wersji, zacytuj źródło adaptacji i weź z niego klucz odwracania pozycji.
Przykład: 220 studentów (po 110 z kierunków przyrodniczych i z innych kierunków) wypełniło 15 pozycji na skali Likerta 1–5; 7 z nich sformułowano przeciwnie. Przed policzeniem wyniku odwróć te pozycje (6 − odpowiedź). Bez odwrócenia α Cronbacha wyniosła −.20, czyli skala „nie działała”; po odwróceniu α = .89. Rzetelność skali i omegę policzysz w programie z menu według poradnika alfa Cronbacha i omega w jamovi.
Studenci kierunków przyrodniczych mieli wyższy średni wynik NEP (M = 3.67, SD = 0.68) niż studenci innych kierunków (M = 3.39, SD = 0.74), t(216.32) = 2.93, p = .004, d = 0.39, 95% CI [0.13, 0.66], różnica 0.28 punktu, 95% CI [0.09, 0.47]. Wynik NEP korelował z liczbą deklarowanych zachowań proekologicznych (z 8 wymienionych w ankiecie), ρ = .67, p < .001. Pamiętaj, że to badanie przekrojowe na próbie dostępnej: różnica może wynikać z tego, kto wybiera studia przyrodnicze, a nie z samych studiów. Deklaracje zachowań bywają też zawyżone, bo respondenci chcą wypaść dobrze.
Jak opisać analizę statystyczną w pracy z biologii
Rozdział o metodach ma pozwolić innej osobie powtórzyć badanie. W pracach terenowych opisz dodatkowo układ próbkowania: ile było stanowisk, ile próbek na stanowisku, jak dobrano miejsca i co traktujesz jako jednostkę analizy. Poniżej wzór akapitu dla projektów 2, 3 i 5. Gotowe zdania z wynikami możesz porównać z generatorem opisu wyników APA.
Jeśli potrzebujesz pomocy w ustaleniu jednostki analizy, doborze modelu albo odpowiedzi na uwagi promotora, możesz skonsultować to ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Przykład w R: pułapki, pseudoreplikacja i pozostałe projekty
Kod odtwarza wszystkie liczby z tego wpisu. Najważniejszy jest przepis 1 z pełną analizą projektu 2: od opisu zliczeń, przez model Poissona i ujemny dwumianowy, model mieszany i analizę na poziomie stanowisk, po symulację pseudoreplikacji. Przepis 2 zawiera pozostałe projekty, a przepis 3 – rysunki. Symulacja w przepisie 1 trwa około pół minuty.
1. Projekt 2: pułapki Barbera – Poisson, ujemny dwumianowy, GLMM, analiza stanowisk i symulacja
R
# Projekt 2: liczebność biegaczowatych w pułapkach Barbera – rezerwat vs las gospodarczy (dane symulowane).
# 12 stanowisk (6 + 6), na każdym 8 pułapek; część pułapek działała krócej (zalanie, zniszczenie),
# więc liczba dni ekspozycji trafia do modelu jako offset.
suppressPackageStartupMessages({ library(MASS); library(glmmTMB) })
set.seed(41302)
gen_dane <- function(efekt = log(0.6), sd_stan = 0.6, theta = 1.5) {
  st <- data.frame(stanowisko = factor(sprintf("S%02d", 1:12)),
                   las = factor(rep(c("rezerwat", "gospodarczy"), each = 6), levels = c("rezerwat", "gospodarczy")),
                   u = rnorm(12, 0, sd_stan))
  d <- st[rep(1:12, each = 8), ]
  d$pulapka <- rep(1:8, 12)
  d$dni <- ifelse(runif(96) < .15, sample(7:13, 96, replace = TRUE), 14)
  mu <- d$dni * exp(log(0.30) + efekt * (d$las == "gospodarczy") + d$u)
  d$osobniki <- rnbinom(96, mu = mu, size = theta)
  d$u <- NULL; rownames(d) <- NULL; d
}
d <- gen_dane()
write.csv(d, "../biologia-pulapki-barbera-dane.csv", row.names = FALSE)

# Krok 1. Opis: liczba pułapek, średnia, wariancja, zera; średnie na stanowiskach
round(c(pulapki = nrow(d), M = mean(d$osobniki), wariancja = var(d$osobniki),
        zera_proc = 100 * mean(d$osobniki == 0), max = max(d$osobniki)), 2)
stan <- aggregate(cbind(osobniki, dni) ~ stanowisko + las, data = d, FUN = sum)
stan$na_10_dni <- round(10 * stan$osobniki / stan$dni, 2)
stan

# Krok 2. Błąd: pułapki jako niezależne powtórzenia (Poisson, potem ujemny dwumianowy) – pseudoreplikacja
m_pois <- glm(osobniki ~ las + offset(log(dni)), family = poisson, data = d)
disp <- sum(residuals(m_pois, type = "pearson")^2) / df.residual(m_pois)
m_nb <- glm.nb(osobniki ~ las + offset(log(dni)), data = d)

# Krok 3. Model poprawny: ujemny dwumianowy GLMM z losowym wyrazem wolnym stanowiska
# (przy 12 stanowiskach test Walda z jest zbyt liberalny, więc podajemy też wersję z df = 12 − 2)
m_glmm <- glmmTMB(osobniki ~ las + offset(log(dni)) + (1 | stanowisko), family = nbinom2, data = d)

# Krok 4. Analiza na poziomie stanowisk: 12 wyników (logarytm osobników na dzień; + 0.5 chroni przed zerem), test Welcha
t_st <- t.test(log((osobniki + 0.5) / dni) ~ las, data = stan)

wiersz <- function(b, se, df = Inf) c(IRR = exp(b), CI_d = exp(b - qt(.975, df) * se),
                                      CI_g = exp(b + qt(.975, df) * se), p = 2 * pt(-abs(b / se), df))
wyn <- rbind(
  Poisson_pulapki = wiersz(coef(m_pois)[2], sqrt(vcov(m_pois)[2, 2])),
  NB_pulapki = wiersz(coef(m_nb)[2], sqrt(vcov(m_nb)[2, 2])),
  NB_GLMM_z = wiersz(fixef(m_glmm)$cond[2], sqrt(vcov(m_glmm)$cond[2, 2])),
  NB_GLMM_t10 = wiersz(fixef(m_glmm)$cond[2], sqrt(vcov(m_glmm)$cond[2, 2]), df = 12 - 2),
  Welch_12_stanowisk = c(exp(diff(t_st$estimate)), rev(exp(-t_st$conf.int)), t_st$p.value))
colnames(wyn) <- c("IRR", "CI_d", "CI_g", "p")
cbind(round(wyn[, 1:3], 3), p = signif(wyn[, 4], 3))
round(c(dyspersja_Poisson = disp, theta_NB = m_nb$theta,
        SD_stanowisk_GLMM = sqrt(VarCorr(m_glmm)$cond$stanowisko[1]), theta_GLMM = sigma(m_glmm),
        t_Welch = unname(t_st$statistic), df_Welch = unname(t_st$parameter)), 2)

# Krok 5. Ile zer przewiduje każdy model? (obserwowane: liczba pułapek z zerem)
c(obserwowane = sum(d$osobniki == 0),
  Poisson = round(sum(dpois(0, fitted(m_pois))), 1),
  NB_pulapki = round(sum(dnbinom(0, mu = fitted(m_nb), size = m_nb$theta)), 1),
  NB_GLMM = round(sum(dnbinom(0, mu = fitted(m_glmm), size = sigma(m_glmm))), 1))

# Krok 6. Symulacja: 500 zbiorów bez prawdziwej różnicy – jak często każda metoda daje p < .05?
set.seed(41303)
R <- 500
p_sym <- t(replicate(R, {
  s <- gen_dane(efekt = 0)
  ss <- aggregate(cbind(osobniki, dni) ~ stanowisko + las, data = s, FUN = sum)
  g <- suppressWarnings(glmmTMB(osobniki ~ las + offset(log(dni)) + (1 | stanowisko), family = nbinom2, data = s))
  c(Poisson = coef(summary(glm(osobniki ~ las + offset(log(dni)), family = poisson, data = s)))[2, 4],
    NB = coef(summary(suppressWarnings(glm.nb(osobniki ~ las + offset(log(dni)), data = s))))[2, 4],
    GLMM_z = coef(summary(g))$cond[2, 4],
    GLMM_t10 = 2 * pt(-abs(coef(summary(g))$cond[2, 3]), df = 10),
    Welch = t.test(log((osobniki + 0.5) / dni) ~ las, data = ss)$p.value)
}))
blad_I <- colMeans(p_sym < .05, na.rm = TRUE)
mc_se <- sqrt(blad_I * (1 - blad_I) / R)
round(rbind(odsetek_p_pod_05 = 100 * blad_I, blad_MC = 100 * mc_se), 1)
Wynik w R
  pulapki         M wariancja zera_proc       max
    96.00      4.24     34.10     25.00     36.00
   stanowisko         las osobniki dni na_10_dni
1         S01    rezerwat       17 106      1.60
2         S02    rezerwat       47  93      5.05
3         S03    rezerwat        7 111      0.63
4         S04    rezerwat       39 112      3.48
5         S05    rezerwat       77 107      7.20
6         S06    rezerwat       69 108      6.39
7         S07 gospodarczy       15 108      1.39
8         S08 gospodarczy       15 108      1.39
9         S09 gospodarczy       20 109      1.83
10        S10 gospodarczy       11 102      1.08
11        S11 gospodarczy       10 108      0.93
12        S12 gospodarczy       80 111      7.21
                     IRR  CI_d  CI_g        p
Poisson_pulapki    0.582 0.476 0.711 1.28e-07
NB_pulapki         0.560 0.337 0.932 2.56e-02
NB_GLMM_z          0.529 0.220 1.269 1.54e-01
NB_GLMM_t10        0.529 0.196 1.430 1.84e-01
Welch_12_stanowisk 0.566 0.193 1.658 2.64e-01
dyspersja_Poisson          theta_NB SD_stanowisk_GLMM        theta_GLMM           t_Welch          df_Welch
             8.07              0.74              0.66              1.17              1.19              9.49
obserwowane     Poisson  NB_pulapki     NB_GLMM
       24.0         2.5        24.6        22.6
                 Poisson   NB GLMM_z GLMM_t10 Welch
odsetek_p_pod_05      70 32.8   12.2      8.4     5
blad_MC                2  2.1    1.5      1.2     1
2. Projekty 1, 3, 4, 5 i 6
R
# Projekty 1, 3, 4, 5 i 6 (dane symulowane; każdy projekt ma własne ziarno).
suppressPackageStartupMessages({ library(PMCMRplus); library(effectsize); library(vegan); library(nlme); library(psych) })

# ---- Projekt 1. Babka lancetowata na czterech stanowiskach (Welch, Games–Howell; Kruskal–Wallis, Dunn)
set.seed(41311)
stanowiska <- c("trawnik wydeptywany", "pobocze ścieżki", "łąka koszona", "łąka niekoszona")
p1 <- data.frame(stanowisko = factor(rep(stanowiska, each = 25), levels = stanowiska))
p1$dlugosc <- round(rnorm(100, mean = rep(c(6.5, 8, 10.5, 12), each = 25), sd = rep(c(1.4, 2, 2.8, 3.4), each = 25)), 1)
p1$uszkodzenie <- pmin(4, pmax(0, round(rnorm(100, mean = rep(c(2.6, 2.1, 1.6, 1.1), each = 25), sd = 1))))
aggregate(dlugosc ~ stanowisko, data = p1, FUN = function(x) round(c(M = mean(x), SD = sd(x)), 2))
oneway.test(dlugosc ~ stanowisko, data = p1, var.equal = FALSE)
omega_squared(aov(dlugosc ~ stanowisko, data = p1), partial = FALSE, ci = .95, alternative = "two.sided")
summary(gamesHowellTest(dlugosc ~ stanowisko, data = p1))
aggregate(uszkodzenie ~ stanowisko, data = p1, FUN = function(x) c(Me = median(x), Q1 = quantile(x, .25)[[1]], Q3 = quantile(x, .75)[[1]]))
kruskal.test(uszkodzenie ~ stanowisko, data = p1)
rank_epsilon_squared(uszkodzenie ~ stanowisko, data = p1, ci = .95, alternative = "two.sided")
# test Dunna z poprawką Holma (z poprawką na rangi wiązane; ostrzeżenie o wiązaniach wyciszone)
summary(suppressWarnings(kwAllPairsDunnTest(uszkodzenie ~ stanowisko, data = p1, p.adjust.method = "holm")))

# ---- Projekt 3. Różnorodność roślin na 16 płatach łąki: koszone vs niekoszone
set.seed(41313)
S_pula <- 30
w_kosz <- rlnorm(S_pula, 0, 1.6); w_nie <- rlnorm(S_pula, 0, 0.9)
plat <- t(sapply(1:16, function(i) {
  w <- if (i <= 8) w_kosz else w_nie
  rmultinom(1, size = sample(80:200, 1), prob = w * rgamma(S_pula, shape = 2, rate = 2))
}))
colnames(plat) <- sprintf("gat%02d", 1:S_pula)
p3 <- data.frame(plat_id = 1:16, uzytkowanie = factor(rep(c("koszona", "niekoszona"), each = 8)),
                 N = rowSums(plat), S = specnumber(plat), H = diversity(plat, "shannon"),
                 odwr_Simpson = diversity(plat, "invsimpson"))
p3$exp_H <- exp(p3$H)
p3$J <- p3$H / log(p3$S)
p3$S_rozrzedzone <- rarefy(plat, sample = min(p3$N))
sr3 <- aggregate(cbind(N, S, S_rozrzedzone, H, exp_H, odwr_Simpson, J) ~ uzytkowanie, data = p3, FUN = mean)
sr3[-1] <- round(sr3[-1], 2); sr3
aggregate(cbind(exp_H, S_rozrzedzone) ~ uzytkowanie, data = p3, FUN = function(x) round(sd(x), 2))  # SD
min(p3$N)
t.test(exp_H ~ uzytkowanie, data = p3)
hedges_g(exp_H ~ uzytkowanie, data = p3, pooled_sd = FALSE)
t.test(S_rozrzedzone ~ uzytkowanie, data = p3)
set.seed(41314)
adonis2(plat ~ uzytkowanie, data = p3, method = "bray", permutations = 999)
betadisper_p <- permutest(betadisper(vegdist(plat, "bray"), p3$uzytkowanie), permutations = 999)
betadisper_p$tab

# ---- Projekt 4. Cechy środowiska 30 stawów a liczba gatunków makrofitów (korelacje Spearmana)
set.seed(41314)
n4 <- 30
log_P <- rnorm(n4, log(60), 0.7)
p4 <- data.frame(fosfor = round(exp(log_P)), przewodnosc = round(exp(5.6 + 0.45 * (log_P - log(60)) + rnorm(n4, 0, .2))),
                 pH = round(rnorm(n4, 7.4, 0.5), 2), glebokosc = round(runif(n4, 0.6, 3.5), 1))
p4$makrofity <- rnbinom(n4, mu = exp(2.3 - 0.35 * (log_P - log(60)) + 0.12 * p4$glebokosc), size = 12)
round(cor(p4, method = "spearman"), 2)
sapply(c("fosfor", "przewodnosc", "pH", "glebokosc"), function(v)
  round(c(rho = unname(cor.test(p4[[v]], p4$makrofity, method = "spearman", exact = FALSE)$estimate),
          p = cor.test(p4[[v]], p4$makrofity, method = "spearman", exact = FALSE)$p.value), 3))

# ---- Projekt 5. Monitoring azotanów: 6 punktów × 36 miesięcy, sezonowość i trend
set.seed(41315)
p5 <- expand.grid(miesiac = 1:36, punkt = factor(paste0("P", 1:6)))
p5$rok <- (p5$miesiac - 1) / 12
p5$sin12 <- sin(2 * pi * p5$miesiac / 12); p5$cos12 <- cos(2 * pi * p5$miesiac / 12)
u_punkt <- rnorm(6, 0, 0.6)
e <- unlist(lapply(1:6, function(i) as.numeric(arima.sim(list(ar = .5), n = 36, sd = .35))))
p5$azotany <- round(4.4 - 0.25 * p5$rok + 0.9 * p5$cos12 + 0.4 * p5$sin12 + u_punkt[p5$punkt] + e, 2)
m5_naiw <- lm(azotany ~ rok, data = p5)
m5_sez <- lm(azotany ~ rok + sin12 + cos12, data = p5)
m5_pkt <- lm(azotany ~ rok + sin12 + cos12 + punkt, data = p5)  # punkty i sezon, ale bez zależności w czasie
m5_lme <- lme(azotany ~ rok + sin12 + cos12, random = ~ 1 | punkt,
              correlation = corAR1(form = ~ miesiac | punkt), data = p5, method = "REML")
trend <- rbind(lm_sam_trend = c(coef(m5_naiw)["rok"], confint(m5_naiw)["rok", ]),
               lm_z_sezonem = c(coef(m5_sez)["rok"], confint(m5_sez)["rok", ]),
               lm_sezon_punkty = c(coef(m5_pkt)["rok"], confint(m5_pkt)["rok", ]),
               lme_AR1 = intervals(m5_lme, which = "fixed")$fixed["rok", c(2, 1, 3)])
round(trend, 3)
summary(m5_lme)$tTable |> round(3)
round(c(phi_AR1 = unname(coef(m5_lme$modelStruct$corStruct, unconstrained = FALSE)),
        SD_punktow = as.numeric(VarCorr(m5_lme)["(Intercept)", "StdDev"]),
        amplituda = sqrt(sum(fixef(m5_lme)[c("sin12", "cos12")]^2))), 2)
b <- fixef(m5_lme)
round((atan2(b["sin12"], b["cos12"]) * 12 / (2 * pi)) %% 12, 1)  # miesiąc szczytu (12 = grudzień)
reszty_P1 <- residuals(m5_pkt)[p5$punkt == "P1"]  # autokorelacja reszt w jednym punkcie
round(acf(reszty_P1, plot = FALSE, lag.max = 2)$acf[2:3], 2)

# ---- Projekt 6. Ankieta postaw proekologicznych: skala NEP (15 pozycji 1–5, 7 sformułowanych przeciwnie)
set.seed(41316)
n6 <- 220
kierunek <- factor(rep(c("przyrodniczy", "inny"), each = n6 / 2), levels = c("inny", "przyrodniczy"))
eta <- rnorm(n6, 0.45 * (kierunek == "przyrodniczy"), 1)
odwr <- c(2, 4, 6, 8, 10, 12, 14)
it <- sapply(1:15, function(j) {
  z <- 0.6 * eta + rnorm(n6, 0, 0.8) + 0.3
  x <- as.integer(cut(z, c(-Inf, -1.2, -0.4, 0.4, 1.2, Inf)))
  if (j %in% odwr) 6L - x else x
})
colnames(it) <- sprintf("nep%02d", 1:15)
it_kod <- it; it_kod[, odwr] <- 6L - it_kod[, odwr]
p6 <- data.frame(kierunek, NEP = rowMeans(it_kod))
p6$zachowania <- rbinom(n6, 8, plogis(-0.6 + 0.9 * (p6$NEP - 3.3)))
round(c(alfa_bez_odwrocenia = psych::alpha(it, warnings = FALSE)$total$raw_alpha,
        alfa_po_odwroceniu = psych::alpha(it_kod, warnings = FALSE)$total$raw_alpha), 3)
aggregate(NEP ~ kierunek, data = p6, FUN = function(x) round(c(M = mean(x), SD = sd(x), n = length(x)), 2))
t.test(NEP ~ kierunek, data = p6)
cohens_d(NEP ~ kierunek, data = p6, pooled_sd = FALSE)
cor.test(p6$NEP, p6$zachowania, method = "spearman", exact = FALSE)
Wynik w R
           stanowisko dlugosc.M dlugosc.SD
1 trawnik wydeptywany      6.00       1.20
2     pobocze ścieżki      7.63       2.21
3        łąka koszona     10.05       2.88
4     łąka niekoszona     11.76       3.09

	One-way analysis of means (not assuming equal variances)

data:  dlugosc and stanowisko
F = 33.978, num df = 3.000, denom df = 49.288, p-value = 4.729e-12

# Effect Size for ANOVA (Type I)

Parameter  | Omega2 |       95% CI
----------------------------------
stanowisko |   0.44 | [0.28, 0.55]

	Pairwise comparisons using Games-Howell test

data: dlugosc by stanowisko
alternative hypothesis: two.sided
P value adjustment method: none
H0
                                           q value   Pr(>|q|)
pobocze ścieżki - trawnik wydeptywany == 0   4.582  0.0129086   *
łąka koszona - trawnik wydeptywany == 0      9.175 1.5304e-06 ***
łąka niekoszona - trawnik wydeptywany == 0  12.285 4.7631e-09 ***
łąka koszona - pobocze ścieżki == 0          4.711  0.0090756  **
łąka niekoszona - pobocze ścieżki == 0       7.685 1.3663e-05 ***
łąka niekoszona - łąka koszona == 0          2.863  0.1935688
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
           stanowisko uszkodzenie.Me uszkodzenie.Q1 uszkodzenie.Q3
1 trawnik wydeptywany              3              2              3
2     pobocze ścieżki              2              2              3
3        łąka koszona              2              1              2
4     łąka niekoszona              1              1              2

	Kruskal-Wallis rank sum test

data:  uszkodzenie by stanowisko
Kruskal-Wallis chi-squared = 21.289, df = 3, p-value = 9.17e-05

Epsilon2 (rank) |       95% CI
------------------------------
0.22            | [0.11, 0.40]

	Pairwise comparisons using Dunn's all-pairs test

data: uszkodzenie by stanowisko
alternative hypothesis: two.sided
P value adjustment method: holm
H0
                                           z value   Pr(>|z|)
pobocze ścieżki - trawnik wydeptywany == 0   2.665  0.0308306   *
łąka koszona - trawnik wydeptywany == 0      3.438  0.0029349  **
łąka niekoszona - trawnik wydeptywany == 0   4.383 7.0107e-05 ***
łąka koszona - pobocze ścieżki == 0          0.773  0.6884636
łąka niekoszona - pobocze ścieżki == 0       1.719  0.2569640
łąka niekoszona - łąka koszona == 0          0.946  0.6884636
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
  uzytkowanie     N     S S_rozrzedzone    H exp_H odwr_Simpson    J
1     koszona 149.0 19.88         16.51 2.22  9.54         6.03 0.74
2  niekoszona 151.5 22.88         18.89 2.46 11.88         7.62 0.79
  uzytkowanie exp_H S_rozrzedzone
1     koszona  2.80          1.84
2  niekoszona  2.42          1.66
[1] 81

	Welch Two Sample t-test

data:  exp_H by uzytkowanie
t = -1.7882, df = 13.72, p-value = 0.09585
alternative hypothesis: true difference in means between group koszona and group niekoszona is not equal to 0
95 percent confidence interval:
 -5.1540047  0.4722569
sample estimates:
   mean in group koszona mean in group niekoszona
                9.543671                11.884545

Hedges' g |        95% CI
-------------------------
-0.84     | [-1.81, 0.15]

- Estimated using un-pooled SD.
	Welch Two Sample t-test

data:  S_rozrzedzone by uzytkowanie
t = -2.7208, df = 13.853, p-value = 0.01669
alternative hypothesis: true difference in means between group koszona and group niekoszona is not equal to 0
95 percent confidence interval:
 -4.2554367 -0.5016855
sample estimates:
   mean in group koszona mean in group niekoszona
                16.50978                 18.88834

Permutation test for adonis under reduced model
Permutation: free
Number of permutations: 999

adonis2(formula = plat ~ uzytkowanie, data = p3, permutations = 999, method = "bray")
         Df SumOfSqs      R2      F Pr(>F)
Model     1   1.1752 0.43659 10.849  0.001 ***
Residual 14   1.5166 0.56341
Total    15   2.6918 1.00000
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
          Df       Sum Sq      Mean Sq          F N.Perm Pr(>F)
Groups     1 3.450159e-05 3.450159e-05 0.00770715    999  0.931
Residuals 14 6.267196e-02 4.476569e-03         NA     NA     NA
            fosfor przewodnosc    pH glebokosc makrofity
fosfor        1.00        0.74 -0.28      0.19     -0.27
przewodnosc   0.74        1.00 -0.07      0.13     -0.17
pH           -0.28       -0.07  1.00     -0.09      0.20
glebokosc     0.19        0.13 -0.09      1.00      0.20
makrofity    -0.27       -0.17  0.20      0.20      1.00
    fosfor przewodnosc    pH glebokosc
rho -0.272      -0.167 0.199     0.204
p    0.146       0.378 0.292     0.281
                   rok  2.5 % 97.5 %
lm_sam_trend    -0.333 -0.482 -0.184
lm_z_sezonem    -0.314 -0.433 -0.196
lm_sezon_punkty -0.314 -0.370 -0.259
lme_AR1         -0.313 -0.397 -0.228
             Value Std.Error  DF t-value p-value
(Intercept)  4.017     0.294 207  13.649       0
rok         -0.313     0.043 207  -7.283       0
sin12        0.311     0.048 207   6.461       0
cos12        0.820     0.046 207  17.981       0
   phi_AR1 SD_punktow  amplituda
      0.43       0.70       0.88
sin12
  0.7
[1] 0.33 0.30
alfa_bez_odwrocenia  alfa_po_odwroceniu
             -0.200               0.892
      kierunek  NEP.M NEP.SD  NEP.n
1         inny   3.39   0.74 110.00
2 przyrodniczy   3.67   0.68 110.00

	Welch Two Sample t-test

data:  NEP by kierunek
t = -2.9263, df = 216.32, p-value = 0.003796
alternative hypothesis: true difference in means between group inny and group przyrodniczy is not equal to 0
95 percent confidence interval:
 -0.46859266 -0.09140734
sample estimates:
        mean in group inny mean in group przyrodniczy
                  3.389697                   3.669697

Cohen's d |         95% CI
--------------------------
-0.39     | [-0.66, -0.13]

- Estimated using un-pooled SD.
	Spearman's rank correlation rho

data:  p6$NEP and p6$zachowania
S = 584179, p-value < 2.2e-16
alternative hypothesis: true rho is not equal to 0
sample estimates:
      rho
0.6708167
3. Rysunki
R
# Rysunki do wpisu (uruchom z folderu kod/): LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b413-rysunki.R
suppressPackageStartupMessages({ library(ggplot2); library(patchwork); library(svglite) })
KOLORY <- c(akcent = "#e50101", drugi = "#1f78b4", dane = "grey55", granat = "#0f1d3a")
theme_metodolog <- function(base_size = 13) {
  theme_minimal(base_size = base_size) +
    theme(plot.title = element_text(face = "bold", colour = KOLORY[["granat"]], size = rel(1.05), margin = margin(b = 6)),
          plot.subtitle = element_text(colour = "grey30", margin = margin(b = 8)),
          panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
          axis.title = element_text(colour = "grey20"), axis.text = element_text(colour = "grey25"),
          legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA),
          plot.margin = margin(10, 14, 10, 10))
}
zapisz_svg <- function(wykres, plik, szer = 10, wys = 5.6) {
  svglite::svglite(plik, width = szer, height = wys, bg = "white"); print(wykres); invisible(grDevices::dev.off())
  cat(sprintf("Zapisano %s: w HTML width=\"%d\" height=\"%d\" (%d KB)\n", plik, round(szer * 100), round(wys * 100), round(file.info(plik)$size / 1024)))
}
pdf(NULL)
suppressMessages(invisible(capture.output({ for (f in c("b413-1-pulapki-pseudoreplikacja.R", "b413-2-pozostale-projekty.R")) source(f) })))

# Rysunek 1: pułapki na stanowiskach (A) i odsetek fałszywych alarmów w symulacji (B)
d$na_10_dni <- 10 * d$osobniki / d$dni
kol_las <- c(rezerwat = KOLORY[["drugi"]], gospodarczy = KOLORY[["akcent"]])
rA <- ggplot(d, aes(stanowisko, na_10_dni, colour = las)) +
  geom_jitter(width = .15, height = 0, alpha = .55, size = 1.9) +
  geom_point(data = stan, aes(stanowisko, na_10_dni), shape = 95, size = 11, colour = KOLORY[["granat"]]) +
  scale_colour_manual(values = kol_las, name = NULL) +
  labs(title = "A. 96 pułapek to 12 stanowisk", subtitle = "Punkty: pułapki; kreska: wynik stanowiska",
       x = "Stanowisko (S01–S06 rezerwat, S07–S12 las gospodarczy)", y = "Osobniki na 10 dni") +
  theme_metodolog(12) + theme(axis.text.x = element_text(size = 8.5))
bl <- data.frame(metoda = c("Poisson,\npułapki", "Ujemny dwum.,\npułapki", "GLMM,\ntest z", "GLMM,\ndf = 10", "Welch,\n12 stanowisk"),
                 proc = 100 * blad_I, se = 100 * mc_se)
bl$metoda <- factor(bl$metoda, levels = bl$metoda)
print(data.frame(metoda = gsub("\n", " ", bl$metoda), proc = round(bl$proc, 1), se = round(bl$se, 1)), row.names = FALSE)
rB <- ggplot(bl, aes(metoda, proc)) + geom_col(fill = "grey80", colour = "grey60", width = .65) +
  geom_errorbar(aes(ymin = proc - 1.96 * se, ymax = proc + 1.96 * se), width = .15, colour = KOLORY[["drugi"]], linewidth = .8) +
  geom_hline(yintercept = 5, colour = KOLORY[["akcent"]], linetype = 2, linewidth = .8) +
  geom_text(aes(y = proc + 1.96 * se + 2, label = sprintf("%.1f%%", proc)), vjust = 0, size = 3.6, colour = "grey20") +
  scale_y_continuous(limits = c(0, 80), breaks = seq(0, 80, 20)) +
  labs(title = "B. Wynik istotny bez prawdziwej różnicy", subtitle = "500 symulacji; linia: oczekiwane 5%",
       x = NULL, y = "Odsetek p < .05 (%)") + theme_metodolog(12) + theme(axis.text.x = element_text(size = 9))
zapisz_svg(rA + rB + plot_layout(widths = c(1.15, 1), guides = "collect") & theme(legend.position = "bottom"),
           "../biologia-pseudoreplikacja-pulapki.svg", szer = 11, wys = 5.6)

# Rysunek 2: monitoring azotanów – dane z 6 punktów i krzywa z modelu mieszanego z sezonem i trendem
nowe <- data.frame(miesiac = seq(1, 36, by = .25))
nowe$rok <- (nowe$miesiac - 1) / 12
nowe$sin12 <- sin(2 * pi * nowe$miesiac / 12); nowe$cos12 <- cos(2 * pi * nowe$miesiac / 12)
nowe$pred <- predict(m5_lme, nowe, level = 0)
nowe$trend <- fixef(m5_lme)[1] + fixef(m5_lme)["rok"] * nowe$rok
r2 <- ggplot(p5, aes(miesiac, azotany)) +
  geom_line(aes(group = punkt), colour = KOLORY[["dane"]], alpha = .55, linewidth = .5) +
  geom_point(colour = KOLORY[["dane"]], alpha = .5, size = 1.1) +
  geom_line(data = nowe, aes(miesiac, pred), colour = KOLORY[["drugi"]], linewidth = 1.2) +
  geom_line(data = nowe, aes(miesiac, trend), colour = KOLORY[["akcent"]], linewidth = 1, linetype = 2) +
  scale_x_continuous(breaks = c(1, 7, 13, 19, 25, 31, 36),
                     labels = c("sty 1", "lip 1", "sty 2", "lip 2", "sty 3", "lip 3", "gru 3")) +
  labs(title = "Azotany w 6 punktach przez 36 miesięcy", subtitle = "Szare: punkty; niebieska: model (trend + sezon); czerwona: sam trend",
       x = "Miesiąc i rok badania", y = "Azotany (mg/l)") + theme_metodolog(12)
zapisz_svg(r2, "../biologia-sezonowosc-azotany.svg", szer = 10, wys = 5)
Wynik w R
                metoda proc  se
      Poisson, pułapki 70.0 2.0
 Ujemny dwum., pułapki 32.8 2.1
          GLMM, test z 12.2 1.5
         GLMM, df = 10  8.4 1.2
   Welch, 12 stanowisk  5.0 1.0
Zapisano ../biologia-pseudoreplikacja-pulapki.svg: w HTML width="1100" height="560" (32 KB)
Zapisano ../biologia-sezonowosc-azotany.svg: w HTML width="1000" height="500" (43 KB)
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (m.in. funkcje glm(), lm(), oneway.test(), kruskal.test(), t.test() i cor.test() z pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- glmmTMB (wersja 1.1.15.2): Brooks, M. E., Kristensen, K., van Benthem, K. J., Magnusson, A., Berg, C. W., Nielsen, A., Skaug, H. J., Mächler, M., & Bolker, B. M. (2017). glmmTMB balances speed and flexibility among packages for zero-inflated generalized linear mixed modeling. The R Journal, 9(2), 378–400. https://doi.org/10.32614/RJ-2017-066
- PMCMRplus (wersja 1.9.12): Pohlert, T. (2024). PMCMRplus: Calculate pairwise multiple comparisons of mean rank sums extended (R package version 1.9.12) [Computer software]. https://doi.org/10.32614/CRAN.package.PMCMRplus
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- vegan (wersja 2.7-3): Oksanen, J., Simpson, G., Blanchet, F., Kindt, R., Legendre, P., Minchin, P., O’Hara, R., Solymos, P., Stevens, M., Szoecs, E., Wagner, H., Barbour, M., Bedward, M., Bolker, B., Borcard, D., Borman, T., Carvalho, G., Chirico, M., De Caceres, M., … Weedon, J. (2026). vegan: Community ecology package (R package version 2.7-3) [Computer software]. https://doi.org/10.32614/CRAN.package.vegan
- nlme (wersja 3.1-168): Pinheiro, J., Bates, D., & R Core Team. (2025). nlme: Linear and nonlinear mixed effects models (R package version 3.1-168) [Computer software]. https://doi.org/10.32614/CRAN.package.nlme
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device (R package version 2.2.2) [Computer software]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy w analizach prac z biologii i ochrony środowiska
- Próbki traktowane jak niezależne powtórzenia. 96 pułapek z 12 stanowisk to 12 powtórzeń dla porównania typów lasu – w symulacji błędna analiza dawała wynik istotny w 70.0% badań bez prawdziwego efektu.
- Jedno stanowisko na poziom czynnika i wniosek o czynniku („wydeptywanie skraca liście”), choć porównano tylko dwa konkretne miejsca.
- Zliczenia logarytmowane albo analizowane ANOVA zamiast modelu ujemnego dwumianowego lub Poissona z kontrolą nadmiernej dyspersji (O’Hara i Kotze, 2010).
- Brak offsetu, gdy pułapki, transekty albo obserwacje trwały różnie długo.
- Odsetki (np. kiełkowania, przeżywalności) przekształcane funkcją arcus sinus. Warton i Hui (2011) odradzają tę transformację: dla danych typu „k z n nasion” regresja logistyczna jest łatwiejsza w interpretacji i zwykle ma większą moc, a dla odsetków pokrycia lepsza jest transformacja logitowa.
- Liczba gatunków porównywana bez rozrzedzenia, choć na płatach policzono różną liczbę osobników.
- Surowe wskaźniki Shannona i Simpsona interpretowane jak liczby gatunków; czytelniejsza jest efektywna liczba gatunków.
- Pomiary miesięczne bez sezonu i bez autokorelacji, co daje zbyt wąskie przedziały ufności dla trendu.
- Silnie skorelowane zmienne środowiskowe (np. fosfor i przewodność) wstawione razem do regresji i interpretowane osobno.
- Pozycje odwrócone w ankiecie nieodwrócone przed policzeniem wyniku – w przykładzie α spadła z .89 do −.20.
Najczęstsze pytania
Jakie testy statystyczne wybrać do pracy magisterskiej z biologii albo ochrony środowiska?
Zależy to od typu danych i od tego, co jest powtórzeniem. Pomiar ciągły na kilku stanowiskach porównasz ANOVA Welcha, ocenę porządkową testem Kruskala–Wallisa, liczbę osobników modelem ujemnym dwumianowym (z efektem losowym stanowiska, gdy próbki są zagnieżdżone), a dane z comiesięcznego monitoringu modelem mieszanym z sezonem. Przy każdej analizie podaj wielkość efektu z 95% CI, np. ω², ε², IRR albo d Cohena.
Czy próbki z jednego stanowiska można traktować jako osobne powtórzenia?
Tylko wtedy, gdy pytasz o różnice między tymi konkretnymi stanowiskami. Jeśli porównujesz czynnik przypisany całym stanowiskom (np. typ lasu albo sposób koszenia), powtórzeniem jest stanowisko, a próbki z niego są ze sobą skorelowane. Uwzględnij to efektem losowym stanowiska albo analizuj wyniki uśrednione dla stanowisk – inaczej popełniasz pseudoreplikację i zawyżasz istotność.
Jak porównać różnorodność gatunkową dwóch siedlisk w pracy dyplomowej?
Policz wskaźniki osobno dla każdego płatu lub stanowiska, a dopiero potem porównaj grupy, np. testem t Welcha. Liczbę gatunków rozrzedź do wspólnej liczby osobników, a wskaźniki Shannona i Simpsona przelicz na efektywną liczbę gatunków (exp(H) i 1/D). Skład gatunkowy porównasz PERMANOVA na odległościach Braya–Curtisa.
Czy liczbę osobników złowionych w pułapki można analizować ANOVA po logarytmowaniu?
Lepiej nie. Zliczenia mają dużo zer i wariancję rosnącą ze średnią, a symulacje pokazują, że logarytmowanie zliczeń działa słabo w porównaniu z modelami dla surowych zliczeń. Użyj regresji ujemnej dwumianowej (albo Poissona, jeśli nie ma nadmiernej dyspersji), z logarytmem czasu ekspozycji jako offsetem i efektem losowym stanowiska.
Jak uwzględnić sezonowość w comiesięcznych pomiarach jakości wody?
Dodaj do modelu sinus i cosinus miesiąca (okres 12 miesięcy) albo zmienne zero-jedynkowe dla miesięcy, a punkt pomiarowy uwzględnij jako efekt losowy. Sprawdź autokorelację reszt kolejnych miesięcy i w razie potrzeby dodaj strukturę AR(1). Bez tego przedział ufności dla trendu bywa zbyt wąski.
Powiązane hasła
Przeczytaj też
Statystyka w pracy z rolnictwa, zootechniki i weterynarii
Poletka w blokach, krzywa plonu, kojec jako jednostka, ważenia w modelu mieszanym, dokumentacja stada i ankiety: analizy, zdania APA i kod R.
Czytaj →PoradnikRegresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →PoradnikModel wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →PoradnikStatystyka w pracy dyplomowej – przewodnik
Osiem etapów od hipotez do obrony: na każdy etap poradniki, hasła i kalkulatory oraz tabela typowych problemów z odpowiedzią, co przeczytać.
Czytaj →Piszesz pracę z biologii lub ochrony środowiska i nie wiesz, jak policzyć wyniki?
Pomożemy ustalić jednostkę analizy, dobrać model do Twoich stanowisk, zliczeń albo pomiarów w czasie, policzyć go z wielkością efektu i wyjaśnić tak, żebyś umiał(a) samodzielnie opisać i obronić wyniki.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bolker, B. M., Brooks, M. E., Clark, C. J., Geange, S. W., Poulsen, J. R., Stevens, M. H. H., & White, J.-S. S. (2009). Generalized linear mixed models: A practical guide for ecology and evolution. Trends in Ecology & Evolution, 24(3), 127–135. https://doi.org/10.1016/j.tree.2008.10.008 ● Otwarty dostęp: pełny tekst
- Dormann, C. F., McPherson, J. M., Araújo, M. B., Bivand, R., Bolliger, J., Carl, G., Davies, R. G., Hirzel, A., Jetz, W., Kissling, W. D., Kühn, I., Ohlemüller, R., Peres-Neto, P. R., Reineking, B., Schröder, B., Schurr, F. M., & Wilson, R. (2007). Methods to account for spatial autocorrelation in the analysis of species distributional data: A review. Ecography, 30(5), 609–628. https://doi.org/10.1111/j.2007.0906-7590.05171.x ● Otwarty dostęp: pełny tekst
- Dunlap, R. E., Van Liere, K. D., Mertig, A. G., & Jones, R. E. (2000). New trends in measuring environmental attitudes: Measuring endorsement of the New Ecological Paradigm: A revised NEP Scale. Journal of Social Issues, 56(3), 425–442. https://doi.org/10.1111/0022-4537.00176
- Hill, M. O. (1973). Diversity and evenness: A unifying notation and its consequences. Ecology, 54(2), 427–432. https://doi.org/10.2307/1934352
- Hurlbert, S. H. (1984). Pseudoreplication and the design of ecological field experiments. Ecological Monographs, 54(2), 187–211. https://doi.org/10.2307/1942661
- Jost, L. (2006). Entropy and diversity. Oikos, 113(2), 363–375. https://doi.org/10.1111/j.2006.0030-1299.14714.x
- O’Hara, R. B., & Kotze, D. J. (2010). Do not log-transform count data. Methods in Ecology and Evolution, 1(2), 118–122. https://doi.org/10.1111/j.2041-210x.2010.00021.x
- Warton, D. I., & Hui, F. K. C. (2011). The arcsine is asinine: The analysis of proportions in ecology. Ecology, 92(1), 3–10. https://doi.org/10.1890/10-0340.1 ● Otwarty dostęp
- Zuur, A. F., Ieno, E. N., & Elphick, C. S. (2010). A protocol for data exploration to avoid common statistical problems. Methods in Ecology and Evolution, 1(1), 3–14. https://doi.org/10.1111/j.2041-210x.2009.00001.x ● Otwarty dostęp
Cytowania BibTeX
@article{bolker2009generalized, author={Bolker, Benjamin M. and Brooks, Mollie E. and Clark, Connie J. and Geange, Shane W. and Poulsen, John R. and Stevens, M. Henry H. and White, Jada-Simone S.}, title={{Generalized linear mixed models: A practical guide for ecology and evolution}}, journal={Trends in Ecology \& Evolution}, year={2009}, volume={24}, number={3}, pages={127--135}, doi={10.1016/j.tree.2008.10.008}}@article{dormann2007methods, author={Dormann, Carsten F. and McPherson, Jana M. and Araújo, Miguel B. and Bivand, Roger and Bolliger, Janine and Carl, Gudrun and Davies, Richard G. and Hirzel, Alexandre and Jetz, Walter and Kissling, W. Daniel and Kühn, Ingolf and Ohlemüller, Ralf and Peres-Neto, Pedro R. and Reineking, Björn and Schröder, Boris and Schurr, Frank M. and Wilson, Robert}, title={{Methods to account for spatial autocorrelation in the analysis of species distributional data: A review}}, journal={Ecography}, year={2007}, volume={30}, number={5}, pages={609--628}, doi={10.1111/j.2007.0906-7590.05171.x}}@article{dunlap2000new, author={Dunlap, Riley E. and Van Liere, Kent D. and Mertig, Angela G. and Jones, Robert Emmet}, title={{New trends in measuring environmental attitudes: Measuring endorsement of the New Ecological Paradigm: A revised NEP Scale}}, journal={Journal of Social Issues}, year={2000}, volume={56}, number={3}, pages={425--442}, doi={10.1111/0022-4537.00176}}@article{hill1973diversity, author={Hill, M. O.}, title={{Diversity and evenness: A unifying notation and its consequences}}, journal={Ecology}, year={1973}, volume={54}, number={2}, pages={427--432}, doi={10.2307/1934352}}@article{hurlbert1984pseudoreplication, author={Hurlbert, Stuart H.}, title={{Pseudoreplication and the design of ecological field experiments}}, journal={Ecological Monographs}, year={1984}, volume={54}, number={2}, pages={187--211}, doi={10.2307/1942661}}@article{jost2006entropy, author={Jost, Lou}, title={{Entropy and diversity}}, journal={Oikos}, year={2006}, volume={113}, number={2}, pages={363--375}, doi={10.1111/j.2006.0030-1299.14714.x}}@article{ohara2010do, author={O'Hara, Robert B. and Kotze, D. Johan}, title={{Do not log-transform count data}}, journal={Methods in Ecology and Evolution}, year={2010}, volume={1}, number={2}, pages={118--122}, doi={10.1111/j.2041-210x.2010.00021.x}}@article{warton2011arcsine, author={Warton, David I. and Hui, Francis K. C.}, title={{The arcsine is asinine: The analysis of proportions in ecology}}, journal={Ecology}, year={2011}, volume={92}, number={1}, pages={3--10}, doi={10.1890/10-0340.1}}@article{zuur2010protocol, author={Zuur, Alain F. and Ieno, Elena N. and Elphick, Chris S.}, title={{A protocol for data exploration to avoid common statistical problems}}, journal={Methods in Ecology and Evolution}, year={2010}, volume={1}, number={1}, pages={3--14}, doi={10.1111/j.2041-210x.2009.00001.x}}