Gdy grup nie da się przydzielić
Chcesz porównać pacjentów z osobami bez choroby, pielęgniarki z nauczycielami albo kobiety z mężczyznami. Nikogo do grupy nie przydzielasz, bo grupy już istnieją. Taki projekt to porównanie grup istniejących, czyli odmiana schematu obserwacyjnego, najczęściej przekrojowego: mierzysz wynik raz w każdej grupie i sprawdzasz, czym się różnią. Brak losowego przydziału odróżnia go od eksperymentu, a brak wprowadzanej interwencji – od quasi-eksperymentu.
Ogólną budowę tego podrozdziału opisuje wpis rozdział metodologiczny. Tutaj pokazujemy to, co jest specyficzne dla grup istniejących: skąd wziąć grupę porównawczą, jak opisać źródło każdej grupy, jak czytać tabelę porównania i dlaczego ANCOVA nie „wyrównuje” takich grup. Na końcu znajdziesz gotowy podrozdział do przerobienia.
Przykład przewodni (fikcyjny, dane symulowane). Studentka chce sprawdzić, czy osoby z przewlekłym bólem krzyża wypadają gorzej w zadaniu wyszukiwania symboli (liczba poprawnych znaków w 90 sekund). Ma 120 pacjentów poradni leczenia bólu. Rozważa dwie grupy porównawcze po 120 osób: ochotników z internetu albo osoby z przychodni POZ tej samej dzielnicy. Ponieważ dane są symulowane, znamy prawdziwą różnicę: −2.92 punktu. W prawdziwym badaniu tej liczby nikt nie zna.
Dlaczego to nie eksperyment
W eksperymencie losowanie sprawia, że grupy różnią się przed manipulacją tylko przypadkiem. Grupy istniejące powstały z określonych powodów. Pacjenci różnią się od osób bez choroby wiekiem, lekami, snem i aktywnością. Pielęgniarki różnią się od nauczycieli płcią, stażem i pracą zmianową. Każda z tych cech może być zmienną zakłócającą, a dobór do grup to klasyczne zagrożenie trafności wewnętrznej (Shadish i in., 2002). Dlatego zanim zaczniesz, zapisz, o które z trzech pytań ci chodzi:
| Pytanie | Co na nie odpowiada | Jak o tym pisać |
|---|---|---|
| Czy grupy – takie, jakie są – różnią się wynikiem? | Różnica surowa z 95% CI | „Pacjenci uzyskali niższy wynik niż…” |
| Czy różnica utrzymuje się przy tym samym wieku, płci, wykształceniu? | Model z cechami, które nie są skutkiem przynależności do grupy | „Po uwzględnieniu wieku… różnica wyniosła…” |
| Czy choroba lub zawód powoduje tę różnicę? | Jedno porównanie przekrojowe tego nie rozstrzyga | Hipoteza do dalszych badań, nie wniosek |
Konsekwencja dla słownictwa: przynależność do grupy nazywaj czynnikiem grupującym albo predyktorem, a o różnicach pisz bez „wpływu”. Podobną zasadę omawia wpis o badaniu korelacyjnym; wpis o eksperymencie z losowym przydziałem pokazuje, czego tu brakuje.
Kryteria i źródło każdej grupy
Czytelnik musi wiedzieć, skąd wzięła się każda grupa. Opisz obie osobno, według tego samego układu. Raportowanie według STROBE wymaga m.in. podania, które zmienne zakłócające uwzględniono i dlaczego (Vandenbroucke i in., 2007).
| Element | Pacjenci | Grupa porównawcza |
|---|---|---|
| Źródło | Poradnia leczenia bólu | Przychodnia POZ tej samej dzielnicy |
| Jak ustalono przynależność | Rozpoznanie w dokumentacji, ból ≥ 12 tygodni | Pytanie przesiewowe: brak przewlekłego bólu krzyża |
| Rekrutacja | Kolejni pacjenci w ustalonym okresie | Kolejne osoby w tym samym okresie, zgłaszające się z innego powodu |
| Włączenie i wyłączenie | 30–69 lat; bez rozpoznanej choroby neurologicznej | Te same kryteria wieku i wyłączenia |
| Dobór | Wszyscy spełniający kryteria | Częstościowy: płeć i dekada wieku jak u pacjentów |
Uważaj na kryteria stosowane tylko w jednej grupie. Każde takie kryterium może wprowadzić błąd selekcji. Reszta zależy od tego, jakie to grupy.
Pacjenci a „zdrowi”
Słowo „zdrowi” bez kryterium jest deklaracją. Napisz, czego dokładnie nie stwierdzono i jak to ustalono (pytanie, dokumentacja, badanie). Nie twórz też grupy wyjątkowo zdrowej. Schwartz i Susser (2011) na liczbowych przykładach pokazali, że dobieranie do badań kliniczno-kontrolnych w psychiatrii wyłącznie osób bez zaburzeń może powodować znaczne obciążenie. Opisz też stan pacjentów: etap choroby, leczenie, leki. W przykładzie grupę nazywamy „osobami bez przewlekłego bólu krzyża”, bo tyle o nich wiadomo.
Zawody
Porównując zawody, porównujesz też płeć, wiek, staż, tryb pracy i miejsce zatrudnienia. Przy wynikach zdrowotnych dochodzi efekt zdrowego pracownika: osoby chore rzadziej są zatrudniane i częściej odchodzą, a Li i Sung (1999) radzą, by w miarę możliwości unikać populacji ogólnej jako grupy porównawczej. Jeśli zebrałeś(-aś) dane w kilku placówkach, osoby z jednej placówki nie są od siebie niezależne i analiza powinna to uwzględniać.
Płeć
Napisz, jak o nią pytano i co zrobiono z odpowiedziami spoza dwóch głównych kategorii (zob. pytania o płeć i wiek w ankiecie). Różnica między kobietami a mężczyznami nie mówi, skąd się wzięła: grupy różnią się biologicznie, społecznie i życiorysem. Przed porównaniem średnich skali sprawdź, czy mierzy ona to samo w obu grupach (inwariancja pomiaru). Pokazuj wielkość efektu, bo przy dużej próbie istotna bywa także bardzo mała różnica.
Jak dobrać grupę porównawczą
Wacholder i in. (1992) sformułowali trzy zasady wyboru kontroli w badaniach kliniczno-kontrolnych. Tamten schemat dobiera osoby według wyniku, a tu grupa jest punktem wyjścia, ale pytania są przydatne także w tym projekcie:
- Ta sama baza. Czy osoba z grupy porównawczej pochodzi z tej samej populacji co grupa badana – czy trafiłaby do poradni, gdyby miała ten problem?
- Brak zniekształceń. Czy inne cechy nie mieszają się z porównaniem?
- Taka sama dokładność. Czy pomiar jest równie dokładny w obu grupach: ten sam badacz, narzędzie, pora, tryb?
| Źródło | Zaleta | Ryzyko |
|---|---|---|
| Ta sama placówka lub rejon, inny powód kontaktu | Podobne pochodzenie i tryb badania | Powód kontaktu może wiązać się z wynikiem |
| Losowa próba z rejestru lub spisu | Najbliżej populacji | Rzadko dostępna w pracy dyplomowej; niski odsetek odpowiedzi |
| Znajomi lub rodzina uczestników | Łatwa rekrutacja | Mogą przypominać uczestników pod względem badanej cechy |
| Ochotnicy z internetu | Tanio i szybko | Samodobór, inny wiek i wykształcenie, inny tryb pomiaru |
Grimes i Schulz (2005) przypominają, że idealna grupa kontrolna nie istnieje, a jedna dobrze wybrana grupa jest zwykle lepsza niż dwie lub więcej. W przykładzie są dwie tylko po to, żeby porównać skutki wyboru. Grupa z POZ powstała przez dobór częstościowy: te same proporcje płci i dekad wieku co u pacjentów. Pamiętaj o koszcie: cech użytych do doboru nie zbadasz już jako różnic między grupami. Bardziej złożone metody opisuje wpis o propensity score.
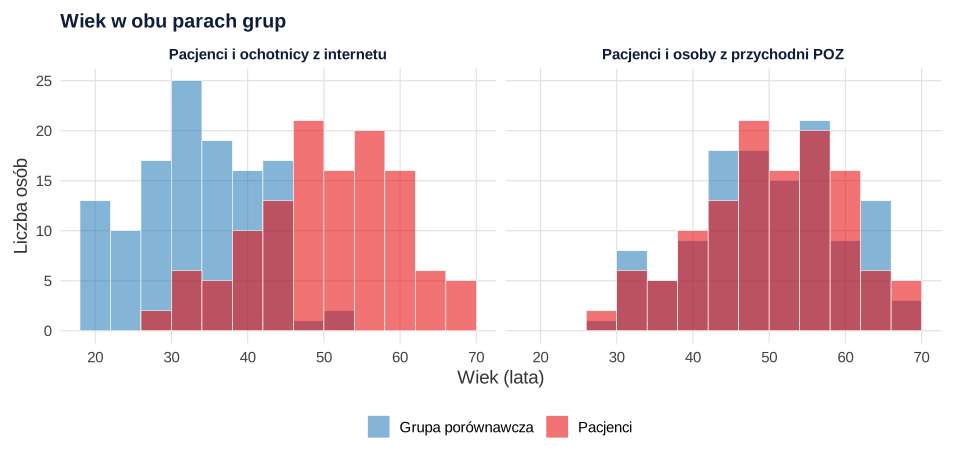
Różnicę widać przed jakimkolwiek testem. 95% ochotników ma najwyżej 45 lat, a 72.5% pacjentów jest od nich starszych. W parze z POZ analogiczny odsetek (powyżej 66 lat) wynosi 4.2%.
Tabela porównania grup
Pokaż cechy obu grup w jednej tabeli i dodaj standaryzowaną różnicę (SMD). Ogólne zasady układu takiej tabeli opisuje wpis tabela 1. W badaniu grup istniejących ta tabela jest już wynikiem: mówi, jak bardzo grupy są porównywalne.
Tabela 1
Charakterystyka pacjentów i dwóch grup porównawczych
| Cecha | Pacjenci (n = 120) | POZ (n = 120) | Internet (n = 120) | SMD POZ | SMD internet |
|---|---|---|---|---|---|
| Wiek w latach, M (SD) | 50.9 (9.3) | 50.6 (9.6) | 33.7 (8.0) | 0.03 | 1.98 |
| Kobiety, % | 53.3 | 53.3 | 72.5 | 0.00 | −0.40 |
| Wykształcenie wyższe, % | 25.0 | 26.7 | 70.0 | −0.04 | −1.01 |
| Wykształcenie zasadnicze, % | 37.5 | 31.7 | 0.8 | 0.12 | 1.05 |
| Objawy depresji (PHQ-9), M (SD) | 9.3 (2.7) | 3.8 (2.6) | 5.0 (2.6) | 2.09 | 1.62 |
Uwaga. SMD – standaryzowana różnica: pacjenci minus grupa porównawcza. POZ – osoby z przychodni dobrane częstościowo według płci i dekady wieku. Testów istotności różnic nie podano. Dane symulowane.
SMD opisuje wielkość różnicy w jednostkach odchylenia standardowego i – inaczej niż p – nie zmienia się wraz z liczebnością. Taki sposób porównywania cech omawia Austin (2009). Wartość bezwzględną poniżej 0.10 często uznaje się za pomijalną, ale to granica umowna. Kolumny p nie podawaj: STROBE odradza testy istotności w tabelach opisowych, a p nie jest właściwym kryterium wyboru zmiennych zakłócających (Vandenbroucke i in., 2007).
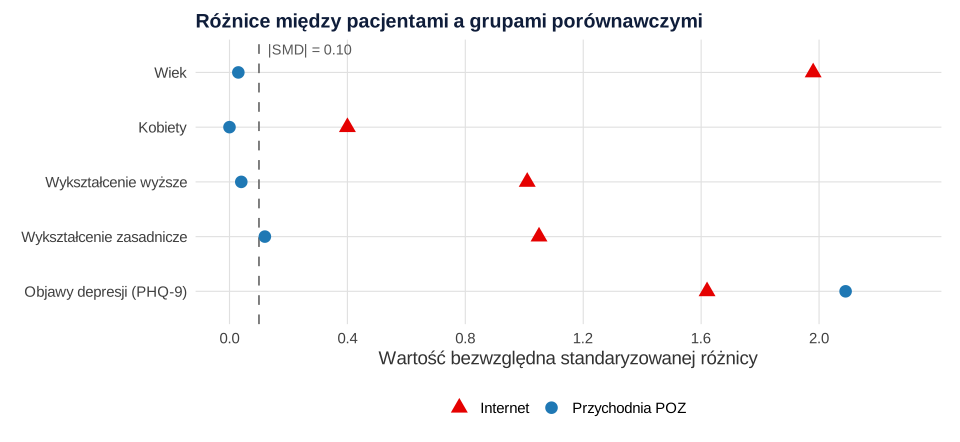
Czytaj wiersze inaczej w zależności od tego, czym jest cecha. Wiek i płeć istniały przed bólem, więc ich różnice to brak porównywalności. Objawy depresji (PHQ-9; SMD = 2.09) mogą być częścią obrazu choroby. Tej różnicy nie da się potraktować jak błędu doboru.
ANCOVA przy grupach nielosowych – ostrożnie
ANCOVA w eksperymencie zwiększa precyzję. Przy grupach istniejących kusi, żeby użyć jej do „wyrównania” grup. Miller i Chapman (2001) piszą, że w wielu takich przypadkach nie ma sposobu, by „skorygować” rzeczywiste różnice między grupami w potencjalnym kowariancie. Rysunek 3 pokazuje, dlaczego. To jedna symulowana próba, więc liczby ilustrują mechanizm, a nie dokładne wielkości.
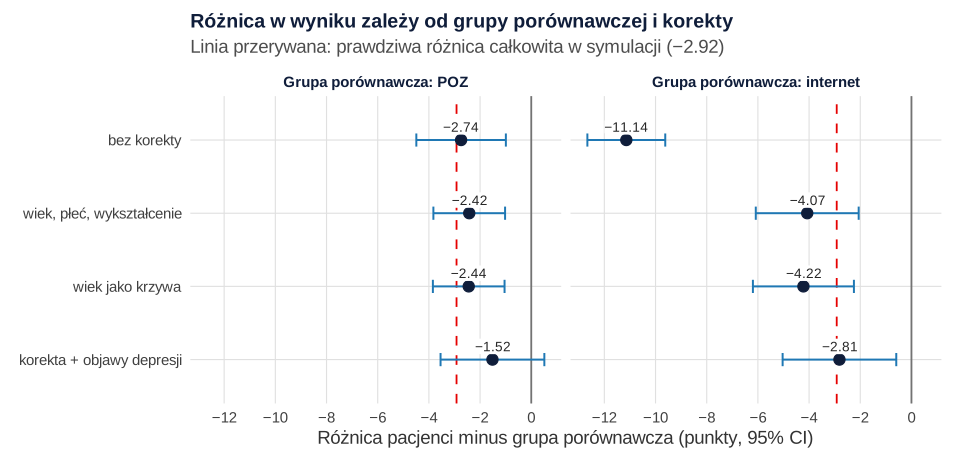
- Dobrze dobrana grupa: korekta niewiele zmienia. Z POZ różnica wynosi −2.74 punktu bez korekty i −2.42 po uwzględnieniu wieku, płci i wykształcenia. Nawet przed korektą jest blisko prawdziwych −2.92.
- Grupa z innej populacji: korekta niczego nie gwarantuje. Z ochotnikami różnica spada z −11.14 do −4.07. Wygląda to na sukces, ale 72.5% pacjentów leży poza zakresem wieku ochotników, więc model przewiduje wynik osób, których prawie nie ma w tej grupie. W symulacji ochotnicy mają też niezmierzoną przewagę 2 punktów wynikającą z samodoboru; tego model nie usunie. Gdy zostawisz wspólny zakres 30–45 lat, zostaje 33 pacjentów i 78 ochotników, a różnica wynosi −4.74, 95% CI [−7.11, −2.37].
- Kowariant, który jest częścią choroby, zmienia pytanie. Dodanie objawów depresji zmniejsza różnicę z POZ do −1.52, 95% CI [−3.54, 0.51], p = .142. To nie znaczy, że „różnica wynikała z depresji”. W symulacji ból obniża wynik bezpośrednio i przez nasilenie objawów, a model odpowiada już o osobach z tym samym nasileniem objawów – które w tych grupach zdarzają się rzadko. Jeśli interesuje cię mechanizm, zaplanuj mediację, a jej przekrojowy charakter opisz wprost jako ograniczenie.
Jest jeszcze problem pomiaru. Westfall i Yarkoni (2016) pokazali, że strategie pomijające nierzetelność zmiennych kontrolnych mają bardzo wysoki odsetek błędów I rodzaju, najwyższy przy dużych próbach i umiarkowanej rzetelności. W małej symulacji (2000 powtórzeń, po 120 osób w grupie) grupy różniły się tylko prawdziwą cechą (d = 0.80), a sama grupa nie miała wpływu na wynik. Przy korekcie bezbłędnym pomiarem cechy fałszywie istotnych było 5.9% wyników, przy rzetelności .70 – 13.6%, a przy .50 – 27.6%. Korekta wyrównuje grupy tylko tak dobrze, jak zmierzono cechę.
Zasady praktyczne:
- Kowarianty wybierz przed analizą, z wiedzy o temacie, a nie z p (zob. czy kontrolować wiek i płeć).
- Uwzględniaj cechy sprzed powstania grupy albo od niej niezależne.
- Podaj oszacowania surowe i skorygowane z 95% CI oraz listę kowariantów z uzasadnieniem (Vandenbroucke i in., 2007).
- Sprawdź wspólny zakres cech i interakcję grupa × kowariant.
- Pisz „uwzględniono w modelu”, a nie „wyrównano grupy”. O pomiarze przed i po w grupach nielosowych przeczytaj we wpisie o paradoksie Lorda.
Podrozdział „Metoda” – od szkicu do gotowego tekstu
Jak bywa napisane (fikcyjny przykład):
Co jest nie tak: nie ma tu eksperymentu ani grupy kontrolnej w sensie eksperymentu. „Zdrowe” nie mówi, kim są te osoby i skąd pochodzą. Brak istotności nie dowodzi podobieństwa. „Wpływ” obiecuje wniosek przyczynowy, a kontrola objawów depresji zmienia pytanie badawcze.
Poprawiona wersja (przykładowe liczby z symulacji):
Komentarz: pierwszy akapit od razu odbiera czytelnikowi złudzenie eksperymentu. Oba źródła i okres są podane obok siebie. Zgodę komisji wpisz tylko, jeśli ją uzyskano.
Do rozdziału wyników (liczby z przykładu):
Co wolno napisać we wnioskach
| Możesz napisać | Nie pisz |
|---|---|
| „Pacjenci uzyskali niższy wynik niż osoby bez przewlekłego bólu z tej samej dzielnicy.” | „Ból obniża szybkość przetwarzania.” |
| „Różnica utrzymała się po uwzględnieniu wieku, płci i wykształcenia.” | „Wykluczono wpływ wieku i wykształcenia.” |
| „Wynik jest zgodny z hipotezą o związku bólu z funkcjonowaniem poznawczym.” | „Potwierdzono, że ból jest przyczyną…” |
| „Po dodaniu objawów depresji oszacowanie było mniejsze i mniej precyzyjne.” | „Różnicę wyjaśnia depresja.” |
Zdania o przyczynie zastąp pytaniem do dalszych badań. Wnioski ogranicz do populacji, z której pochodziły grupy. W ograniczeniach wymień: brak losowego przydziału, jedno źródło każdej grupy, niezmierzone cechy i przekrojowy pomiar.
Na co zwrócić uwagę w poszczególnych dziedzinach
To częste akcenty, a nie reguły. Pierwszeństwo mają wymagania uczelni i promotora.
| Dziedzina | Na co uważać |
|---|---|
| Psychologia | Współwystępujące objawy jako kowarianty, porównywalność skal w grupach, pisanie o różnicach bez języka przyczyn. |
| Nauki o zdrowiu | Definicja rozpoznania i jego źródło, leki, etap choroby, opis według STROBE, tryb badania w obu grupach. |
| Fizjoterapia | Poziom aktywności, wcześniejsza rehabilitacja, rzetelność pomiaru u tej samej osoby badającej, znaczenie kliniczne różnicy. |
| Zarządzanie | Stanowisko, branża, wielkość firmy, samodobór do zawodu, dane z kilku organizacji jako struktura zagnieżdżona. |
Najczęstsze błędy
- Nazywanie badania eksperymentem albo grupy porównawczej „kontrolną” bez wyjaśnienia, jak powstała.
- Grupa porównawcza z innego świata: pacjenci z poradni i studenci z mediów społecznościowych.
- Kryteria tylko dla jednej grupy, np. wykluczenia stosowane wyłącznie u „zdrowych”.
- „Grupy nie różniły się wiekiem, bo p > .05” zamiast podania wielkości różnicy.
- ANCOVA na cechę będącą częścią grupy i wniosek, że „po kontroli różnicy nie ma”.
- Korekta przy braku wspólnego zakresu, czyli przewidywanie dla osób, których w grupie nie ma.
- Różny pomiar w grupach: jedna grupa w gabinecie, druga online.
- Język „wpływu” i „skutku” w tytule, hipotezach i wnioskach.
Porównanie grup istniejących w R
Trzy przepisy liczą wszystkie liczby z tekstu i używają tylko bazowego R. Pierwszy tworzy dane i zapisuje je do pliku CSV w folderze nadrzędnym (../), drugi liczy modele, trzeci to mała symulacja o nierzetelnym kowariancie. Uruchamiaj je po kolei z jednego folderu. Rysunki powstały w osobnym skrypcie na tych samych danych. Dane możesz pobrać: pacjenci-i-grupy-porownawcze-dane.csv (360 osób: grupa, wiek, płeć, wykształcenie, PHQ-9, wynik zadania).
Grupy i tabela równowagi
R
# B471 – porównanie grup istniejących: pacjenci a dwie grupy porównawcze
# Dane symulowane (fikcyjny przykład). Tylko bazowy R.
set.seed(471)

symuluj <- function(n, grupa, wiek, lata_m, lata_sd, kobieta, phq_m, bol, selekcja) {
  lata <- rnorm(n, lata_m, lata_sd)                 # lata nauki: w pliku tylko 3 kategorie
  phq_bez <- rnorm(n, phq_m, 3)                     # objawy depresji bez bólu
  phq <- round(pmin(pmax(phq_bez + 5 * bol, 0), 27))
  phq0 <- round(pmin(pmax(phq_bez, 0), 27))
  baza <- 46 - 0.20 * (wiek - 30) - 0.35 * pmax(wiek - 50, 0) +
    0.6 * (lata - 13) + 0.8 * kobieta + selekcja + rnorm(n, 0, 5)
  data.frame(grupa, wiek,
             plec = ifelse(kobieta == 1, "kobieta", "mezczyzna"),
             wyksztalcenie = cut(lata, c(-Inf, 11.5, 14.5, Inf),
                                 labels = c("zasadnicze", "srednie", "wyzsze")),
             phq, wynik = round(baza - 1.2 * bol - 0.35 * phq),
             wynik_bez_bolu = baza - 0.35 * phq0,
             wynik_z_bolem = baza - 1.2 - 0.35 * pmin(pmax(round(phq_bez + 5), 0), 27))
}

n <- 120
wiek_p <- round(pmin(pmax(rnorm(n, 52, 9), 30), 69))
kob_p <- rbinom(n, 1, .56)
# Pacjenci z poradni leczenia bólu
pacjenci <- symuluj(n, "pacjenci", wiek_p, 12.6, 2.5, kob_p, 4.0, 1, 0)
# Ochotnicy z internetu: młodsi, częściej z wyższym wykształceniem, inna selekcja
wiek_i <- round(pmin(pmax(rnorm(n, 33, 8.5), 19), 69))
internet <- symuluj(n, "internet", wiek_i, 15.6, 2.0, rbinom(n, 1, .78), 5.0, 0, 2)
# Osoby z przychodni POZ tej samej dzielnicy: ta sama płeć i dekada wieku co pacjent (dobór częstościowy)
wiek_z <- pmin(pmax(wiek_p %/% 10 * 10 + sample(0:9, n, TRUE), 30), 69)
poz <- symuluj(n, "poz", wiek_z, 12.9, 2.6, kob_p, 4.0, 0, 0)

prawda <- mean(pacjenci$wynik_z_bolem - pacjenci$wynik_bez_bolu)  # znane tylko w symulacji
cat(sprintf("Prawdziwa różnica całkowita u pacjentów (bezpośrednia i przez objawy): %.2f\n\n", prawda))

dane <- rbind(pacjenci, internet, poz)
dane$wynik_bez_bolu <- dane$wynik_z_bolem <- NULL
dane <- data.frame(id = seq_len(nrow(dane)), dane)
write.csv(dane, "../pacjenci-i-grupy-porownawcze-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")

# Standaryzowana różnica: ciągła i 0/1 (wariancje obu grup uśrednione)
smd_c <- function(a, b) (mean(a) - mean(b)) / sqrt((var(a) + var(b)) / 2)
smd_p <- function(a, b) {
  pa <- mean(a); pb <- mean(b)
  (pa - pb) / sqrt((pa * (1 - pa) + pb * (1 - pb)) / 2)
}

opis <- function(d) c(n = nrow(d),
                      wiek_M = mean(d$wiek), wiek_SD = sd(d$wiek),
                      kobiety_proc = 100 * mean(d$plec == "kobieta"),
                      wyzsze_proc = 100 * mean(d$wyksztalcenie == "wyzsze"),
                      zasadnicze_proc = 100 * mean(d$wyksztalcenie == "zasadnicze"),
                      phq_M = mean(d$phq), phq_SD = sd(d$phq))
cat("Opis grup\n")
print(round(sapply(list(pacjenci = pacjenci, poz = poz, internet = internet), opis), 1))

rownowaga <- function(a, b) c(
  wiek = smd_c(a$wiek, b$wiek),
  kobiety = smd_p(a$plec == "kobieta", b$plec == "kobieta"),
  wyzsze = smd_p(a$wyksztalcenie == "wyzsze", b$wyksztalcenie == "wyzsze"),
  zasadnicze = smd_p(a$wyksztalcenie == "zasadnicze", b$wyksztalcenie == "zasadnicze"),
  phq = smd_c(a$phq, b$phq))

smd <- rbind(poz = rownowaga(pacjenci, poz), internet = rownowaga(pacjenci, internet))
cat("\nStandaryzowane różnice: pacjenci minus grupa porównawcza\n")
print(round(smd, 2))

# Czy grupy mają wspólny zakres wieku?
gorny <- quantile(internet$wiek, .95)
cat(sprintf("\n95. percentyl wieku w grupie internetowej: %.0f lat\n", gorny))
cat(sprintf("Pacjenci powyżej tego wieku: %.1f%%\n", 100 * mean(pacjenci$wiek > gorny)))
gorny2 <- quantile(poz$wiek, .95)
cat(sprintf("95. percentyl wieku w grupie POZ: %.0f lat; pacjenci powyżej: %.1f%%\n",
            gorny2, 100 * mean(pacjenci$wiek > gorny2)))
Wynik w R
Prawdziwa różnica całkowita u pacjentów (bezpośrednia i przez objawy): -2.92

Opis grup
                pacjenci   poz internet
n                  120.0 120.0    120.0
wiek_M              50.9  50.6     33.7
wiek_SD              9.3   9.6      8.0
kobiety_proc        53.3  53.3     72.5
wyzsze_proc         25.0  26.7     70.0
zasadnicze_proc     37.5  31.7      0.8
phq_M                9.3   3.8      5.0
phq_SD               2.7   2.6      2.6

Standaryzowane różnice: pacjenci minus grupa porównawcza
         wiek kobiety wyzsze zasadnicze  phq
poz      0.03     0.0  -0.04       0.12 2.09
internet 1.98    -0.4  -1.01       1.05 1.62

95. percentyl wieku w grupie internetowej: 45 lat
Pacjenci powyżej tego wieku: 72.5%
95. percentyl wieku w grupie POZ: 66 lat; pacjenci powyżej: 4.2%
Trzy modele, dwie grupy porównawcze
R
# B471 – ta sama grupa pacjentów, dwie grupy porównawcze, trzy modele
# Uruchom po pierwszym przepisie (czyta plik CSV z folderu nadrzędnego). Tylko bazowy R.
dane <- read.csv("../pacjenci-i-grupy-porownawcze-dane.csv", fileEncoding = "UTF-8")
dane$wyksztalcenie <- factor(dane$wyksztalcenie, c("zasadnicze", "srednie", "wyzsze"))

# Liczebność na etapie planowania: d = 0.40, moc .80, alfa .05, dwie grupy
print(power.t.test(delta = 0.40, sd = 1, sig.level = .05, power = .80))

cat("Średnie wyniku w grupach\n")
print(aggregate(wynik ~ grupa, dane, function(x) round(c(M = mean(x), SD = sd(x), n = length(x)), 2)))

szacuj <- function(porownawcza, wzor, etykieta) {
  d <- subset(dane, grupa %in% c("pacjenci", porownawcza))
  d$grupa <- relevel(factor(d$grupa), ref = porownawcza)   # odniesieniem jest grupa porównawcza
  m <- lm(wzor, data = d)
  ci <- confint(m)["grupapacjenci", ]
  s <- summary(m)$coefficients["grupapacjenci", ]
  data.frame(porownawcza, model = etykieta, b = s[["Estimate"]], lo = ci[[1]], hi = ci[[2]],
             t = s[["t value"]], df = m$df.residual, p = s[["Pr(>|t|)"]])
}
modele <- list(
  "bez korekty" = wynik ~ grupa,
  "wiek, płeć, wykształcenie" = wynik ~ grupa + wiek + plec + wyksztalcenie,
  "wiek jako krzywa" = wynik ~ grupa + poly(wiek, 2) + plec + wyksztalcenie,
  "korekta + objawy depresji" = wynik ~ grupa + wiek + plec + wyksztalcenie + phq)

wyniki <- do.call(rbind, lapply(c("poz", "internet"), function(g)
  do.call(rbind, lapply(names(modele), function(e) szacuj(g, modele[[e]], e)))))
rownames(wyniki) <- NULL
write.csv(wyniki, "b471-szacunki.csv", row.names = FALSE, fileEncoding = "UTF-8")
cat("\nRóżnica pacjenci minus grupa porównawcza (b) z 95% CI\n")
print(transform(wyniki, b = round(b, 2), lo = round(lo, 2), hi = round(hi, 2),
                t = round(t, 2), p = signif(p, 3)))

# Wspólny zakres wieku: od 30 do 45 lat (45 to 95. percentyl wieku ochotników)
wspolny <- subset(dane, grupa %in% c("pacjenci", "internet") & wiek >= 30 & wiek <= 45)
print(table(wspolny$grupa))
wspolny$grupa <- relevel(factor(wspolny$grupa), ref = "internet")
m_w <- lm(wynik ~ grupa + wiek + plec + wyksztalcenie, wspolny)
cat("Internet, tylko wspólny zakres wieku:\n")
print(round(c(b = coef(m_w)[["grupapacjenci"]], confint(m_w)["grupapacjenci", ]), 2))

# Czy związek wieku z wynikiem jest taki sam w obu grupach (POZ)?
d <- subset(dane, grupa %in% c("pacjenci", "poz"))
m0 <- lm(wynik ~ grupa + wiek + plec + wyksztalcenie, d)
m1 <- lm(wynik ~ grupa * wiek + plec + wyksztalcenie, d)
cat("\nInterakcja grupa × wiek (POZ)\n")
print(anova(m0, m1))

# Standaryzowana różnica w wyniku (POZ) bez korekty
a <- d$wynik[d$grupa == "pacjenci"]; b <- d$wynik[d$grupa == "poz"]
cat(sprintf("\nd (POZ, bez korekty) = %.2f\n", (mean(a) - mean(b)) / sqrt((var(a) + var(b)) / 2)))
print(t.test(a, b))
Wynik w R
     Two-sample t test power calculation

              n = 99.08057
          delta = 0.4
             sd = 1
      sig.level = 0.05
          power = 0.8
    alternative = two.sided

NOTE: n is number in *each* group

Średnie wyniku w grupach
     grupa wynik.M wynik.SD wynik.n
1 internet   47.67     5.11  120.00
2 pacjenci   36.52     6.75  120.00
3      poz   39.27     7.01  120.00

Różnica pacjenci minus grupa porównawcza (b) z 95% CI
  porownawcza                     model      b     lo    hi      t  df        p
1         poz               bez korekty  -2.74  -4.49 -0.99  -3.09 238 2.26e-03
2         poz wiek, płeć, wykształcenie  -2.42  -3.82 -1.02  -3.41 234 7.68e-04
3         poz          wiek jako krzywa  -2.44  -3.84 -1.04  -3.44 233 6.94e-04
4         poz korekta + objawy depresji  -1.52  -3.54  0.51  -1.47 233 1.42e-01
5    internet               bez korekty -11.14 -12.66 -9.62 -14.42 238 2.59e-34
6    internet wiek, płeć, wykształcenie  -4.07  -6.08 -2.06  -3.99 234 8.79e-05
7    internet          wiek jako krzywa  -4.22  -6.20 -2.25  -4.21 233 3.58e-05
8    internet korekta + objawy depresji  -2.81  -5.03 -0.59  -2.50 233 1.32e-02

internet pacjenci
      78       33
Internet, tylko wspólny zakres wieku:
     b  2.5 % 97.5 %
 -4.74  -7.11  -2.37

Interakcja grupa × wiek (POZ)
Analysis of Variance Table

Model 1: wynik ~ grupa + wiek + plec + wyksztalcenie
Model 2: wynik ~ grupa * wiek + plec + wyksztalcenie
  Res.Df    RSS Df Sum of Sq      F Pr(>F)
1    234 7068.3
2    233 7056.5  1    11.791 0.3893 0.5333

d (POZ, bez korekty) = -0.40

	Welch Two Sample t-test

data:  a and b
t = -3.0876, df = 237.65, p-value = 0.002257
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 -4.4909444 -0.9923889
sample estimates:
mean of x mean of y
 36.52500  39.26667
Korekta nierzetelnym pomiarem
R
# B471 – czy korekta nierzetelnym pomiarem „wyrównuje” grupy?
# Grupy różnią się tylko prawdziwą cechą C (d = 0.80); sama grupa nie ma żadnego wpływu na wynik.
# Pomiar C ma rzetelność od 1.00 do .50. Dane symulowane, tylko bazowy R.
set.seed(47112)

jeden <- function(rzet, n = 120) {
  g <- rep(0:1, each = n)
  C <- rnorm(2 * n, 0.8 * g, 1)
  pomiar <- C + rnorm(2 * n, 0, sqrt((1 - rzet) / rzet))
  y <- 0.5 * C + rnorm(2 * n, 0, 1)
  summary(lm(y ~ g + pomiar))$coefficients["g", "Pr(>|t|)"] < .05
}

rzetelnosci <- c(1, .9, .7, .5)
odsetek <- sapply(rzetelnosci, function(r) mean(replicate(2000, jeden(r))))
wynik <- data.frame(rzetelnosc = rzetelnosci, falszywe_istotne_proc = round(100 * odsetek, 1))
print(wynik, row.names = FALSE)
Wynik w R
 rzetelnosc falszywe_istotne_proc
        1.0                   5.9
        0.9                   5.1
        0.7                  13.6
        0.5                  27.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (bazowe pakiety); rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Lista kontrolna
- Czy w pierwszym zdaniu metody jest jasne, że grupy były istniejące, a nie losowane?
- Czy dla każdej grupy podano źródło, okres, sposób ustalenia przynależności, kryteria i rekrutację?
- Czy obie grupy badano tym samym narzędziem, w tych samych warunkach?
- Czy tabela porównania zawiera SMD i nie zawiera kolumny p dla cech opisowych?
- Czy sprawdzono wspólny zakres kluczowych cech?
- Czy kowarianty ustalono przed analizą i każdemu przypisano uzasadnienie?
- Czy podano wynik surowy i skorygowany z 95% CI?
- Czy wnioski dotyczą różnic i tej populacji, a nie przyczyn?
Najczęstsze pytania
Czym porównanie grup istniejących różni się od eksperymentu?
W eksperymencie osoby trafiają do warunków losowo, więc grupy przed manipulacją różnią się tylko przypadkiem. Grupy istniejące powstały same i różnią się wieloma cechami naraz. Dlatego wynik opisuje różnicę między grupami, a nie skutek przynależności do jednej z nich. W pierwszym zdaniu metody napisz wprost, że przynależność nie była przydzielana.
Jak dobrać grupę porównawczą do pacjentów?
Szukaj osób z tej samej populacji co pacjenci – z tego samego rejonu, w tym samym okresie, badanych tym samym narzędziem i w tym samym trybie. Stosuj te same kryteria włączenia i wyłączenia. Rozważ dobór częstościowy według płci i wieku. Unikaj grup wybranych dlatego, że łatwo je znaleźć, np. studentów z mediów społecznościowych.
Czy można nazwać grupę porównawczą grupą kontrolną?
Lepiej nie, jeśli nikt nie przydzielał osób do grup. „Grupa kontrolna” sugeruje schemat eksperymentalny, a tu masz grupę porównawczą. Nazwij ją według kryterium, np. „osoby bez przewlekłego bólu krzyża”, i opisz jej źródło. Słowo „zdrowi” bez kryterium mówi czytelnikowi niewiele.
Czy ANCOVA może wyrównać grupy, które nie były losowane?
Nie w tym sensie, jaki zwykle się zakłada. Miller i Chapman (2001) wskazują, że w wielu takich sytuacjach nie da się „skorygować” rzeczywistych różnic w kowariancie. Korekta ma sens dla cech sprzed powstania grupy, przy wspólnym zakresie wartości i rzetelnym pomiarze. Podaj wynik surowy i skorygowany, a we wnioskach pisz „uwzględniono w modelu”.
Co napisać we wnioskach, jeśli grupy nie były losowe?
Napisz, że grupy różniły się wynikiem i czy różnica utrzymała się po uwzględnieniu wybranych cech. Nie pisz, że choroba lub zawód powodują różnicę. Zdanie o przyczynie zamień na hipotezę do dalszych badań, a w ograniczeniach wymień brak losowego przydziału, niezmierzone cechy i przekrojowy pomiar.
Powiązane hasła
Przeczytaj też
Grupa kontrolna w badaniu interwencji
Lista oczekujących, zwykła opieka czy aktywna kontrola: co każda opcja kontroluje, symulacja w R, tabela decyzyjna i gotowe zdania do pracy.
Czytaj →PoradnikRozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →PoradnikTabela 1 – charakterystyka próby
M (SD) czy mediana z kwartylami, n (%), braki w osobnych wierszach, kolumny grup i wartości p w RCT – ze wzorem APA do skopiowania i kodem gtsummary w R.
Czytaj →PoradnikBadanie kliniczno-kontrolne krok po kroku
Definicja przypadku, baza źródłowa, dobór kontroli i nadmierne dopasowanie, regresja warunkowa a zwykła, liczebność i opis wg STROBE – z symulacją w R.
Czytaj →PoradnikBadanie korelacyjne w pracy
Jak nazwać schemat i zmienne, ile osób potrzeba dla r, jak ułożyć kwestionariusze, co kontrolować i co wolno napisać we wnioskach – z gotowym podrozdziałem „Metoda” i przykładem w R.
Czytaj →Porównujesz grupy, których nie losowałeś(-aś)?
Pomożemy dobrać grupę porównawczą i kowarianty, policzyć różnice w R lub SPSS i opisać wnioski tak, żebyś umiał(a) samodzielnie je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Austin, P. C. (2009). Balance diagnostics for comparing the distribution of baseline covariates between treatment groups in propensity-score matched samples. Statistics in Medicine, 28(25), 3083–3107. https://doi.org/10.1002/sim.3697 ● Otwarty dostęp
- Grimes, D. A., & Schulz, K. F. (2005). Compared to what? Finding controls for case-control studies. The Lancet, 365(9468), 1429–1433. https://doi.org/10.1016/s0140-6736(05)66379-9
- Li, C.-Y., & Sung, F.-C. (1999). A review of the healthy worker effect in occupational epidemiology. Occupational Medicine, 49(4), 225–229. https://doi.org/10.1093/occmed/49.4.225
- Miller, G. A., & Chapman, J. P. (2001). Misunderstanding analysis of covariance. Journal of Abnormal Psychology, 110(1), 40–48. https://doi.org/10.1037/0021-843X.110.1.40
- Schwartz, S., & Susser, E. (2011). The use of well controls: An unhealthy practice in psychiatric research. Psychological Medicine, 41(6), 1127–1131. https://doi.org/10.1017/s0033291710001595
- Shadish, W. R., Cook, T. D., & Campbell, D. T. (2002). Experimental and quasi-experimental designs for generalized causal inference. Houghton Mifflin.
- Vandenbroucke, J. P., von Elm, E., Altman, D. G., Gøtzsche, P. C., Mulrow, C. D., Pocock, S. J., Poole, C., Schlesselman, J. J., Egger, M., & STROBE Initiative. (2007). Strengthening the Reporting of Observational Studies in Epidemiology (STROBE): Explanation and elaboration. PLOS Medicine, 4(10), Article e297. https://doi.org/10.1371/journal.pmed.0040297 ● Otwarty dostęp
- Wacholder, S., McLaughlin, J. K., Silverman, D. T., & Mandel, J. S. (1992). Selection of controls in case-control studies: I. Principles. American Journal of Epidemiology, 135(9), 1019–1028. https://doi.org/10.1093/oxfordjournals.aje.a116396
- Westfall, J., & Yarkoni, T. (2016). Statistically controlling for confounding constructs is harder than you think. PLOS ONE, 11(3), Article e0152719. https://doi.org/10.1371/journal.pone.0152719 ● Otwarty dostęp
Cytowania BibTeX
@article{austin2009balance, author={Austin, Peter C.}, title={{Balance diagnostics for comparing the distribution of baseline covariates between treatment groups in propensity-score matched samples}}, journal={Statistics in Medicine}, year={2009}, volume={28}, number={25}, pages={3083--3107}, doi={10.1002/sim.3697}}@article{grimes2005compared, author={Grimes, David A. and Schulz, Kenneth F.}, title={{Compared to what? Finding controls for case-control studies}}, journal={The Lancet}, year={2005}, volume={365}, number={9468}, pages={1429--1433}, doi={10.1016/s0140-6736(05)66379-9}}@article{li1999review, author={Li, C.-Y. and Sung, F.-C.}, title={{A review of the healthy worker effect in occupational epidemiology}}, journal={Occupational Medicine}, year={1999}, volume={49}, number={4}, pages={225--229}, doi={10.1093/occmed/49.4.225}}@article{miller2001misunderstanding, author={Miller, Gregory A. and Chapman, Jean P.}, title={{Misunderstanding analysis of covariance}}, journal={Journal of Abnormal Psychology}, year={2001}, volume={110}, number={1}, pages={40--48}, doi={10.1037/0021-843x.110.1.40}}@article{schwartz2011use, author={Schwartz, S. and Susser, E.}, title={{The use of well controls: An unhealthy practice in psychiatric research}}, journal={Psychological Medicine}, year={2011}, volume={41}, number={6}, pages={1127--1131}, doi={10.1017/s0033291710001595}}@book{shadish2002experimental, author={Shadish, William R. and Cook, Thomas D. and Campbell, Donald T.}, title={{Experimental and quasi-experimental designs for generalized causal inference}}, year={2002}, publisher={Houghton Mifflin}}@article{vandenbroucke2007strengthening, author={Vandenbroucke, Jan P. and von Elm, Erik and Altman, Douglas G. and Gøtzsche, Peter C. and Mulrow, Cynthia D. and Pocock, Stuart J. and Poole, Charles and Schlesselman, James J. and Egger, Matthias and {STROBE Initiative}}, title={{Strengthening the Reporting of Observational Studies in Epidemiology (STROBE): Explanation and elaboration}}, journal={PLOS Medicine}, year={2007}, volume={4}, number={10}, eid={e297}, doi={10.1371/journal.pmed.0040297}}@article{wacholder1992selection, author={Wacholder, Sholom and McLaughlin, Joseph K. and Silverman, Debra T. and Mandel, Jack S.}, title={{Selection of controls in case-control studies: I. Principles}}, journal={American Journal of Epidemiology}, year={1992}, volume={135}, number={9}, pages={1019--1028}, doi={10.1093/oxfordjournals.aje.a116396}}@article{westfall2016statistically, author={Westfall, Jacob and Yarkoni, Tal}, title={{Statistically controlling for confounding constructs is harder than you think}}, journal={PLOS ONE}, year={2016}, volume={11}, number={3}, eid={e0152719}, doi={10.1371/journal.pone.0152719}}