Te same osoby kilka razy: co trzeba opisać
W schemacie z powtarzanymi pomiarami każda osoba dostarcza kilku wyników: w kilku warunkach albo w kilku momentach (definicja: schemat międzyobiektowy i wewnątrzobiektowy). Analiza takich danych jest opisana we wpisie ANOVA z powtarzanymi pomiarami krok po kroku, a schemat AB/BA z losowaniem sekwencji – we wpisie schemat naprzemienny (crossover). Tu zajmujemy się tym, co dzieje się wcześniej: ułożeniem kolejności, odstępami, ubytkiem i tym, jak to wszystko zapisać w rozdziale metodologicznym.
Przykład przewodni (wymyślony, dane symulowane). Studentka bada, czy układ karty zleceń wpływa na szybkość jej sprawdzania. Mamy cztery wersje: A – obecna, B – tabela, C – kolor, D – tabela i kolor. 48 studentów pielęgniarstwa sprawdza w każdej wersji po jednym zestawie zleceń, a wynikiem jest czas w sekundach. W drugim, krótszym przykładzie te same osoby trzy razy wypełniają skalę stresu (przed sesją, w sesji, miesiąc po).
Oba przykłady są „powtarzanymi pomiarami”, ale opisuje się je inaczej, i od tego rozróżnienia zaczyna się dobra metoda.
| Czynnik: warunek | Czynnik: czas | |
|---|---|---|
| Przykład | Cztery wersje karty zleceń | Stres przed sesją, w sesji, po sesji |
| Czy kolejność da się zmieniać? | Tak – trzeba ją zaplanować | Nie – czas płynie w jedną stronę |
| Główne zagrożenie | Wprawa, zmęczenie, przeniesienie | Ubytek, zdarzenia między pomiarami, oswojenie z pomiarem |
| Co opisać | Kolejności, sposób przydziału, przerwy | Terminy, odstępy, liczbę osób w każdym pomiarze |
| Do jakich zdań uprawnia | Porównanie warunków (przy kontrbalansowaniu) | Opis zmiany w czasie, bez wskazywania jej przyczyny |
Gdy zmiana w czasie ma być efektem interwencji, potrzebujesz opisu z wpisu badanie przed i po. Gdy warunki przydziela się różnym osobom, punktem wyjścia jest eksperyment z losowym przydziałem.
Kiedy badać te same osoby
Główną zaletą schematów wewnątrzobiektowych jest efektywność: różnice między ludźmi znikają z członu błędu. Główną wadą są efekty kontekstu – ćwiczenia, uwrażliwienia i przeniesienia (Greenwald, 1976). Zysk jest konkretny. Dla efektu d = 0.40 i korelacji między pomiarami r = .60 mamy dz = 0.45 i przy mocy 80% wystarczą 42 osoby. Dwie osobne grupy wymagałyby razem 200 osób. Przy podawaniu efektu zaznacz, której miary używasz – przeliczenia zależą od schematu (Lakens, 2013).
Te same osoby to dobry wybór, gdy warunki są krótkie, odwracalne i niezapamiętywane, a stan badanego jest stabilny. Zły wybór, gdy pierwszy warunek zmienia osobę na stałe: uczy strategii, ujawnia cel badania albo daje trwałą poprawę. Wtedy wybierz porównanie grup.
Kontrbalansowanie: pełne, kwadrat łaciński, kwadrat zrównoważony
Kontrbalansowanie rozkłada kolejność po równo na warunki. Hasło w słowniku pokazuje zasadę przy trzech warunkach. Przy planowaniu pracy liczą się trzy decyzje:
| Sposób | Liczba kolejności (4 warunki) | Co równoważy | Kiedy wybrać |
|---|---|---|---|
| Pełne kontrbalansowanie | 24 (dla 3, 4, 5, 6 warunków: 6, 24, 120, 720) | Pozycję i kolejność całkowicie | 2–3 warunki albo 4 przy dużej próbie (N podzielne przez 24) |
| Prosty kwadrat łaciński | 4 | Tylko pozycję | Gdy przeniesienia praktycznie nie ma |
| Kwadrat zrównoważony (Williamsa) | 4 (przy nieparzystej liczbie warunków: 2k) | Pozycję i bezpośredniego poprzednika | Domyślnie przy 4 i więcej warunkach |
| Losowa kolejność dla każdej osoby | Różnie | Tylko średnio | Wiele krótkich prób i komputer, który losuje |
Rysunek 1 pokazuje różnicę. W prostym kwadracie łacińskim każdy warunek stoi raz na każdej pozycji, ale D zawsze następuje po C. W kwadracie zrównoważonym każdy warunek ma każdego poprzednika dokładnie raz. Taki układ dla parzystej liczby warunków opisał Williams (1949), a dla wielu powtórzeń tego samego warunku lub przeniesień wyższych rzędów metodę ich tworzenia podał Brooks (2012).
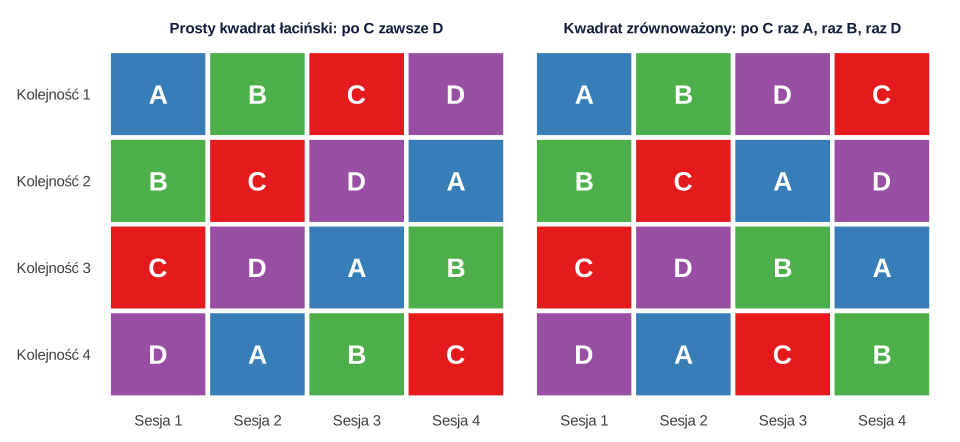
Sama lista kolejności nie wystarczy. Osoby trzeba do nich losowo przydzielić, najlepiej blokami: w każdym bloku czterech kolejnych osób występują wszystkie cztery sekwencje (randomizacja blokowa). Listę przygotuj przed badaniem, np. w generatorze listy randomizacji. Liczba osób powinna być wielokrotnością liczby kolejności. W przykładzie 48 osób daje po 12 na sekwencję, a listę można pobrać: powtarzane-pomiary-lista-kolejnosci.csv.
Co się dzieje bez kontrbalansowania
Założenia symulacji: B nie różni się od A, C skraca czas o 3 s, D o 8 s. Niezależnie od wersji karty sesje 2, 3 i 4 są szybsze o 9, 14 i 17 s (wprawa). Najprościej byłoby dać wszystkim wersje po kolei: A, B, C, D, tak że nowa karta zawsze jest ostatnia. Tabela porównuje dwa osobne losowania tego samego scenariusza.
| Porównanie (prawdziwa różnica) | Stała kolejność A–B–C–D | Kwadrat zrównoważony |
|---|---|---|
| B – A (0 s) | −11.2 s, t(47) = −7.76, p < .001 | 0.6 s, t(47) = 0.34, p = .739 |
| D – A (−8 s) | −25.8 s, t(47) = −17.91, p < .001 | −6.0 s, t(47) = −3.06, p = .004 |
Przy stałej kolejności karta B wygląda na wyraźnie lepszą, choć nie jest. Zdanie w dyskusji „nowy układ skraca czas o 11 s” opisywałoby wprawę. Efektu nie widać w żadnym teście ani w wykresie reszt: jest wbudowany w schemat. Żadna analiza nie oddzieli warunku od sesji, gdy każdy warunek pojawia się tylko w jednej sesji.
W 2000 powtórzeń (rysunek 2) stała kolejność zawyżała różnicę B – A średnio o 9.0 s, a test dawał istotny wynik w 100% badań. Wszystkie trzy schematy kontrbalansowane były nieobciążone. Różnice pojawiają się po dodaniu przeniesienia: po warunku C następna sesja jest szybsza o 6 s (kolor „uczy” patrzenia). Wtedy prosty kwadrat, w którym po C zawsze jest D, zawyża różnicę D – A o 4.5 s. Kwadrat zrównoważony i pełne kontrbalansowanie mają D – A bez obciążenia, ale nie są bezbłędne: różnica C – A jest o 1.5 s za mała, bo warunek C nigdy nie następuje po sobie samym, a pozostałe warunki po nim tak.
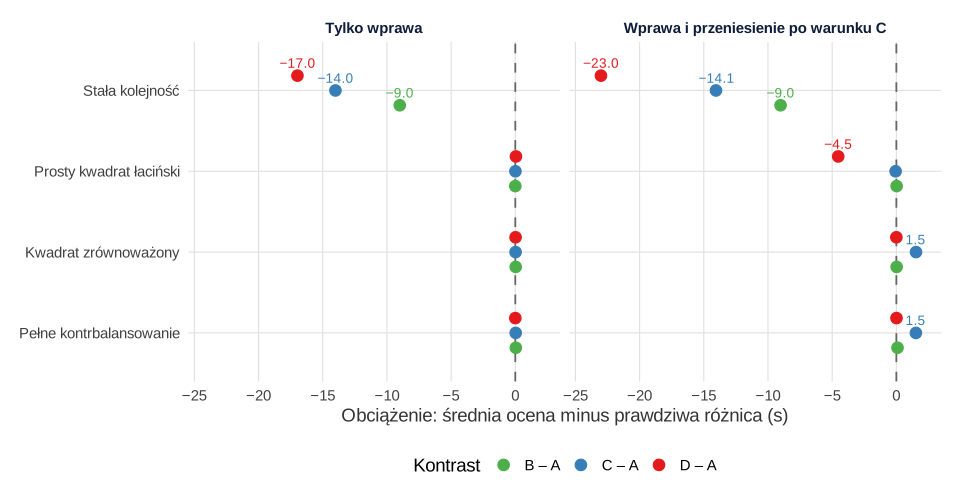
Wniosek praktyczny: kontrbalansowanie nie usuwa przeniesienia, tylko je rozkłada. Jeśli warunki mogą zostawiać ślad, dodaj przerwę albo przeczytaj o przeniesieniu w schemacie naprzemiennym. Hasło o efekcie przeniesienia tłumaczy jego rodzaje.
Kolejność trzeba też uwzględnić w analizie. Pomijanie kontrbalansowania obniża moc (Pollatsek i Well, 1995). W jednym badaniu z kwadratem zrównoważonym model mieszany bez sesji miał SD reszt 10.82 i SE kontrastu 2.21. Z sesją było to 7.28 i 1.49, przy tych samych różnicach. Różnica D – A wyniosła −6.01 s, 95% CI [−9.61, −2.41] (przedział skorygowany metodą Bonferroniego dla trzech kontrastów), a test warunku F(3, 138) = 8.15, p < .001. Pomijanie sesji jest zachowawcze: w symulacji test t dla B – A dawał wynik istotny w mniej niż 1% badań zamiast 5%.
Odstępy, wprawa, zmęczenie, przeniesienie
| Efekt | Skąd się bierze | Co zaplanować | Co napisać |
|---|---|---|---|
| Ćwiczenie (wprawa) | Znajomość zadania i bodźców | Próba treningowa, wersje równoległe, kontrbalansowanie | Liczbę prób treningowych; czy wersje zadania były równoważne |
| Zmęczenie, znudzenie | Długość sesji | Limit czasu, przerwy, krótsze zadania | Czas sesji i przerw |
| Przeniesienie | Ślad po poprzednim warunku | Odstęp uzasadniony mechanizmem, kwadrat zrównoważony | Długość odstępu i jego uzasadnienie |
| Oswojenie z pomiarem | Sam pomiar zmienia odpowiedź | Odpowiedni odstęp, zadania bez zapamiętywania | Czy użyto tej samej wersji narzędzia |
Wprawa nie jest drobiazgiem. W metaanalizie testów zdolności poznawczych wyniki po powtórzeniu rosły średnio o .26 odchylenia standardowego, a przy identycznej wersji testu bardziej (Hausknecht i in., 2007). W testach neuropsychologicznych wielkość tego efektu zależała m.in. od użycia wersji alternatywnych, wieku, diagnozy i długości odstępu (Calamia i in., 2012).
Nie ma uniwersalnego „dobrego odstępu”. Musi być dość długi, by minął ślad poprzedniego warunku, i dość krótki, by badana cecha się nie zmieniła. Podaj oba argumenty jednym zdaniem. Do oceny stabilności narzędzia przy danym odstępie służy rzetelność test–retest, a odstęp dłuższy niż kilka tygodni kieruje już ku schematowi podłużnemu.
Ubytek i łączenie pomiarów po kodzie
W anonimowej ankiecie powtarzanej pomiary łączysz kodem identyfikacyjnym, a technikę łączenia plików opisuje wpis łączenie danych z kilku plików. W metodzie potrzebujesz trzech liczb z każdego etapu: zebrano, połączono, nie dopasowano. W przykładzie o stresie pliki miały 121, 100 i 73 wiersze. Jeden kod w T0 się powtarzał, trzy kody z T1 nie miały pary (literówki, poprawione po metryczce i odnotowane w dzienniku). Ostatecznie T0 wypełniło 120 osób, T0 i T1 – 100 (83.3%), a wszystkie trzy pomiary – 73 (60.8%).
Ubytek jest częścią wyniku, więc opisz, kto odpadł. W przykładzie osoby, które nie wypełniły T2, różniły się niewiele w T0 (21.5 wobec 20.1, standaryzowana różnica −0.26), ale wyraźnie w T1 (31.0 wobec 25.6, standaryzowana różnica −1.11). Odpadały osoby najbardziej zestresowane. Średnia z T2 wśród osób, które ją wypełniły, wyniosła 17.9 przy prawdziwej 18.8 w całej próbie, co sugeruje spadek większy od rzeczywistego. Model mieszany, który korzysta ze wszystkich dostępnych pomiarów, dał 18.7.
To dlatego plan analizy powinien określać postępowanie z brakami danych. Klasyczna analiza powtarzanych pomiarów często usuwa całą osobę z brakiem w jednym pomiarze, jak MANOVA w ilustracji Twiska i de Vente (2002). Metody największej wiarygodności i imputacja wielokrotna wykorzystują częściowe dane (Graham, 2009). Symulację odpadania i porównanie analiz znajdziesz we wpisie ANOVA czy model mieszany.
Podrozdział „Metoda” – wzór z komentarzem
Jak bywa napisane:
„Badanie miało charakter eksperymentalny. Wzięło w nim udział 48 studentów. Każdy sprawdzał cztery karty zleceń w losowej kolejności. Czas mierzono stoperem. Dane poddano analizie ANOVA.”
Co jest nie tak: nie wiadomo, czy był to układ wewnątrzobiektowy; „losowa kolejność” może znaczyć kwadrat, permutacje dla każdej osoby albo decyzję badacza; brakuje przerw, próby treningowej, informacji o zestawach zadań, ubytku i o tym, czy sesja była w modelu. Poprawiona wersja:
Schemat. Zastosowano schemat wewnątrzobiektowy z jednym czynnikiem (układ karty zleceń: A, B, C, D). Kolejność warunków kontrbalansowano zrównoważonym kwadratem łacińskim (kolejności ABDC, BCAD, CDBA, DACB), w którym każdy warunek występował raz na każdej pozycji i raz po każdym innym warunku. Przydział do kolejności był losowy, w blokach po 4 osoby, według listy przygotowanej przed badaniem [program, ziarno].
Uczestnicy. Do badania zaproszono [liczba] studentów [kierunek, rok]; zgłosiło się [n], a badanie ukończyło 48 (po 12 w każdej kolejności). Zakładając d = 0.40 i r = .60 między warunkami (dz = 0.45), dla mocy 80% i α = .05 potrzeba 42 osób przy porównaniu dwóch warunków; zaplanowano 48, by zachować równą liczbę osób w kolejnościach.
Narzędzia. Przygotowano cztery zestawy po [liczba] zleceń o równej trudności, ustalonej w pilotażu [n osób]. Zestawy przypisano do układów [w sposób stały / losowo]. Wynikiem był czas sprawdzenia zestawu w sekundach, mierzony [narzędzie].
Procedura. Badanie odbyło się indywidualnie w jednym spotkaniu. Przed częścią właściwą uczestnik wykonał próbę treningową na odrębnym zestawie. Między zestawami była przerwa [liczba] min, wystarczająca [uzasadnienie]. Spotkanie trwało około [liczba] min.
Plan analizy. Czas analizowano liniowym modelem mieszanym z efektami stałymi układu karty i pozycji w sesji oraz losowym wyrazem wolnym osoby (R, pakiety lme4 i lmerTest; stopnie swobody Satterthwaite’a). Układy B, C i D porównano z A z korektą Holma. Osoby z częściowymi danymi pozostawały w modelu. Reguły wykluczeń ustalono przed zebraniem danych: [reguły].
Komentarz. Nazwa schematu i sposób losowania to dwa zdania, które odpowiadają na najczęstsze pytanie recenzenta. „Ziarno” w nawiasie umożliwia odtworzenie listy. Zgłoś również, czy kolejność została zachowana w praktyce (np. kto przyszedł po terminie). Jeśli reguły wykluczeń ustalasz w eksperymencie, zobacz wpis o wykluczaniu respondentów. Pełny wynik modelu opisuje poradnik jak opisać wyniki modelu mieszanego.
W badaniu czasowym zmień kilka zdań:
Co wolno napisać we wnioskach
| Sytuacja | Możesz napisać | Nie pisz |
|---|---|---|
| Warunki kontrbalansowane | „Sprawdzanie w układzie D trwało krócej niż w układzie A o 6.0 s, 95% CI [2.4, 9.6]” | „Układ D skróci czas pracy pielęgniarek na oddziale” – to badanie na studentach, w jednym zadaniu |
| Stała kolejność | „Czas malał w kolejnych zadaniach; schemat nie pozwala oddzielić układu od wprawy” | „Układ D był najlepszy” |
| Pomiar w czasie bez grupy porównawczej | „Stres był wyższy w sesji niż przed nią” | „Sesja spowodowała wzrost stresu o…”, bez zastrzeżenia |
| Duży ubytek | „Wśród osób, które pozostały w badaniu…; odpadały głównie osoby z wyższym stresem” | „Po miesiącu stres wrócił do poziomu wyjściowego u studentów” |
Schemat wewnątrzobiektowy sam nie czyni badania eksperymentem. Porównanie warunków można nazwać przyczynowym tylko wtedy, gdy kolejność została kontrbalansowana i losowo przydzielona, a warunki kontrolował badacz. W przeciwnym razie napisz o tym w podrozdziale o ograniczeniach pracy.
Na co zwrócić uwagę w poszczególnych dziedzinach
Poniższe uwagi to obserwacje ogólne, a wymagania uczelni i promotora mają pierwszeństwo.
| Dziedzina | Typowa sytuacja | Na co zwrócić uwagę |
|---|---|---|
| Psychologia | Zadania poznawcze w kilku warunkach | Wersje równoległe bodźców, rozdzielenie bodźców od warunków, próba treningowa |
| Nauki o zdrowiu | Parametry lub objawy w kilku terminach | Pora dnia, zmienność stanu pacjenta, stałość osoby mierzącej, data każdego pomiaru |
| Fizjoterapia | Kilka testów funkcjonalnych w jednym spotkaniu | Kolejność testów, przerwy, rozgrzewka, zmęczenie mięśni, rzetelność pomiaru |
| Zarządzanie | Ankieta u tych samych pracowników w dwóch falach | Rotacja kadr, moment w cyklu pracy, wiarygodność kodu, obawy o anonimowość |
Najczęstsze błędy
- „Losowa kolejność” bez metody. Czytelnik musi wiedzieć, czy to kwadrat, permutacje czy losowanie dla każdej osoby.
- Nowy warunek zawsze na końcu. Różnica zawiera wtedy całą wprawę; w przykładzie 9 s przy prawdziwym zerze.
- Kontrbalansowanie bez uwzględnienia w analizie. Wynik jest nieobciążony, ale traci moc.
- N niepodzielne przez liczbę kolejności. Przy 50 osobach i 4 sekwencjach równowaga się rozpada; zaplanuj 48 lub 52.
- Traktowanie kwadratu jako ochrony przed przeniesieniem. Prosty kwadrat zawyżył różnicę D – A o 4.5 s.
- Opis „n = 120” przy trzech pomiarach. Podaj liczebność w każdym pomiarze i liczbę osób z kompletem danych.
- Łączenie po kodzie bez kontroli. Sprawdź duplikaty i kody bez pary, zanim je złączysz.
- Odstęp bez uzasadnienia. „Odstęp wynosił 2 tygodnie” nie mówi, dlaczego akurat tyle.
- Wielkość efektu bez wskazania miary. dz i d między osobami dają przy tych samych danych różne liczby; napisz, której używasz.
Kolejności, symulacja i łączenie pomiarów w R
Trzy przepisy liczą wszystkie liczby z tekstu. Pierwszy tworzy kolejności i listę przydziału, drugi symuluje badanie i powtarza je 2000 razy, trzeci łączy trzy pomiary po kodzie. Rysunki powstały w osobnym skrypcie na tych samych wynikach. Pliki CSV zapisują się w folderze nadrzędnym (../). Dane możesz pobrać: powtarzane-pomiary-karta-zlecen.csv (192 wiersze w formacie długim: osoba, sekwencja, sesja, warunek, czas w sekundach).
Kolejności, sprawdzenie równowagi i lista przydziału
R
# B469 – kolejności warunków: pełne kontrbalansowanie, kwadrat łaciński i kwadrat zrównoważony
# Cztery układy karty zleceń: A – obecny, B – tabela, C – kolor, D – tabela i kolor
warunki <- c("A", "B", "C", "D")
k <- length(warunki)

# Pełne kontrbalansowanie: wszystkie permutacje
permutacje <- function(x) {
  if (length(x) == 1) return(matrix(x, 1))
  do.call(rbind, lapply(seq_along(x), function(i) cbind(x[i], permutacje(x[-i]))))
}
pelne <- permutacje(warunki)
cat("Pełne kontrbalansowanie:", nrow(pelne), "kolejności\n")
cat("Liczba kolejności dla k = 3, 4, 5, 6:", factorial(3:6), "\n\n")

# Prosty kwadrat łaciński: każdy wiersz to poprzedni przesunięty o jedno miejsce
lacinski <- t(sapply(0:(k - 1), function(s) warunki[(0:(k - 1) + s) %% k + 1]))

# Kwadrat zrównoważony (Williams) dla parzystej liczby warunków:
# pierwszy wiersz 0, 1, k-1, 2, k-2, ..., kolejne wiersze to dodawanie 1 modulo k
pierwszy <- numeric(k)
pierwszy[seq(2, k, by = 2)] <- seq_len(k / 2)
pierwszy[seq(3, k, by = 2)] <- k - seq_len(k / 2 - 1)
zrownowazony <- t(sapply(0:(k - 1), function(s) warunki[(pierwszy + s) %% k + 1]))

# Kontrola: ile razy każdy warunek stoi na każdej pozycji i ile razy poprzedza każdy inny
poprzedniki <- function(m) {
  pary <- do.call(rbind, lapply(1:(ncol(m) - 1), function(j) m[, c(j, j + 1)]))
  table(poprzedni = factor(pary[, 1], warunki), nastepny = factor(pary[, 2], warunki))
}
pokaz <- function(nazwa, m) {
  cat(nazwa, ":\n", sep = "")
  cat(paste(" ", apply(m, 1, paste, collapse = " ")), sep = "\n")
  cat("Warunek na każdej pozycji (min–max):",
      paste(range(apply(m, 2, function(p) table(factor(p, warunki)))), collapse = "–"), "\n")
  print(poprzedniki(m)); cat("\n")
}
pokaz("Prosty kwadrat łaciński", lacinski)
pokaz("Kwadrat zrównoważony", zrownowazony)

# Lista przydziału: 48 osób, losowe permutacje kolejności w blokach po 4 osoby
set.seed(4691)
N <- 48
kolejnosc <- as.vector(replicate(N / k, sample(1:k)))
lista <- data.frame(numer = 1:N, kolejnosc = kolejnosc,
                    sekwencja = apply(zrownowazony[kolejnosc, ], 1, paste, collapse = ""))
print(table(lista$sekwencja))
print(head(lista, 8), row.names = FALSE)
write.csv(lista, "../powtarzane-pomiary-lista-kolejnosci.csv", row.names = FALSE, fileEncoding = "UTF-8")

# Liczebność dla porównania dwóch warunków (pakiet pwr)
library(pwr)
d <- 0.4; r <- 0.6
dz <- d / sqrt(2 * (1 - r))
n_zal <- ceiling(pwr.t.test(d = dz, power = .80, sig.level = .05, type = "paired")$n)
n_nz <- ceiling(pwr.t.test(d = d, power = .80, sig.level = .05, type = "two.sample")$n)
cat(sprintf("\nd = %.2f, r = %s, dz = %.2f: te same osoby n = %d; osobne grupy 2 x %d = %d\n",
            d, sub("^0", "", sprintf("%.2f", r)), dz, n_zal, n_nz, 2 * n_nz))
Wynik w R
Pełne kontrbalansowanie: 24 kolejności
Liczba kolejności dla k = 3, 4, 5, 6: 6 24 120 720

Prosty kwadrat łaciński:
  A B C D
  B C D A
  C D A B
  D A B C
Warunek na każdej pozycji (min–max): 1–1
         nastepny
poprzedni A B C D
        A 0 3 0 0
        B 0 0 3 0
        C 0 0 0 3
        D 3 0 0 0

Kwadrat zrównoważony:
  A B D C
  B C A D
  C D B A
  D A C B
Warunek na każdej pozycji (min–max): 1–1
         nastepny
poprzedni A B C D
        A 0 1 1 1
        B 1 0 1 1
        C 1 1 0 1
        D 1 1 1 0


ABDC BCAD CDBA DACB
  12   12   12   12
 numer kolejnosc sekwencja
     1         3      CDBA
     2         2      BCAD
     3         4      DACB
     4         1      ABDC
     5         2      BCAD
     6         3      CDBA
     7         1      ABDC
     8         4      DACB

d = 0.40, r = .60, dz = 0.45: te same osoby n = 42; osobne grupy 2 x 100 = 200
Efekt kolejności: jedno badanie i 2000 powtórzeń
R
# B469 – efekt kolejności bez kontrbalansowania: jedno badanie i 2000 powtórzeń
# Wynik: czas sprawdzenia zleceń w sekundach. Dane symulowane.
library(lmerTest)
library(emmeans)

warunki <- c("A", "B", "C", "D")
efekt <- c(A = 0, B = 0, C = -3, D = -8)   # prawdziwe różnice względem A
wprawa <- c(0, -9, -14, -17)               # zmiana czasu w sesjach 1–4
N <- 48

zrownowazony <- rbind(c(1, 2, 4, 3), c(2, 3, 1, 4), c(3, 4, 2, 1), c(4, 1, 3, 2))
lacinski <- rbind(c(1, 2, 3, 4), c(2, 3, 4, 1), c(3, 4, 1, 2), c(4, 1, 2, 3))
stala <- matrix(1:4, 1)
pelne <- as.matrix(expand.grid(1:4, 1:4, 1:4, 1:4))
pelne <- unname(pelne[apply(pelne, 1, function(w) length(unique(w)) == 4), ])

# Czasy w macierzy osoby x sesje; przeniesienie = dodatkowa zmiana w sesji tuż po warunku C
symuluj <- function(schemat, przeniesienie = 0) {
  sek <- schemat[rep_len(seq_len(nrow(schemat)), N), , drop = FALSE]
  u <- rnorm(N, 0, 12)
  y <- 95 + u + matrix(efekt[sek], N, 4) + matrix(wprawa, N, 4, byrow = TRUE) +
    matrix(rnorm(N * 4, 0, 7), N, 4)
  y[, 2:4] <- y[, 2:4] + przeniesienie * (sek[, 1:3] == 3)
  list(y = y, sek = sek)
}
wg_warunku <- function(s) {
  w <- matrix(NA_real_, N, 4)
  w[cbind(rep(1:N, 4), as.vector(s$sek))] <- as.vector(s$y)
  w
}

# Jedno badanie: te same osoby i błędy, dwa sposoby ułożenia kolejności
set.seed(4692)
badanie <- symuluj(zrownowazony)
y_war <- wg_warunku(badanie)
dl <- data.frame(id = factor(rep(1:N, 4)),
                 sekwencja = rep(apply(badanie$sek, 1, function(w) paste(warunki[w], collapse = "")), 4),
                 sesja = factor(rep(1:4, each = N)),
                 warunek = factor(warunki[as.vector(badanie$sek)], warunki),
                 czas_s = round(as.vector(badanie$y), 1))
dl <- dl[order(as.integer(dl$id), dl$sesja), ]
write.csv(dl, "../powtarzane-pomiary-karta-zlecen.csv", row.names = FALSE, fileEncoding = "UTF-8")
cat("Średnie czasy w warunkach:\n"); print(round(tapply(dl$czas_s, dl$warunek, mean), 1))
cat("Średnie czasy w sesjach:\n"); print(round(tapply(dl$czas_s, dl$sesja, mean), 1))

set.seed(46921)
st <- symuluj(stala)
yst <- wg_warunku(st)
opis_t <- function(m, a, b, etyk) {
  t0 <- t.test(m[, b], m[, a], paired = TRUE)
  cat(sprintf("%s: różnica %.1f s, t(%d) = %.2f, %s, 95%% CI [%.1f, %.1f]\n", etyk, t0$estimate, t0$parameter,
              t0$statistic, ifelse(t0$p.value < .001, "p < .001", sprintf("p = %s", sub("^0", "", sprintf("%.3f", t0$p.value)))),
              t0$conf.int[1], t0$conf.int[2]))
}
cat("\nStała kolejność A–B–C–D (osobne losowanie, prawdziwe różnice: B–A 0, D–A -8):\n")
opis_t(yst, 1, 2, "B – A"); opis_t(yst, 1, 4, "D – A")
cat("\nKwadrat zrównoważony, test t dla par (bez sesji w modelu):\n")
opis_t(y_war, 1, 2, "B – A"); opis_t(y_war, 1, 4, "D – A")

# Model mieszany: z sesją i bez sesji
m_sesja <- lmer(czas_s ~ warunek + sesja + (1 | id), data = dl)
m_bez <- lmer(czas_s ~ warunek + (1 | id), data = dl)
cat("\nTest warunku (model z sesją):\n"); print(anova(m_sesja)["warunek", ])
ko <- function(m) as.data.frame(summary(contrast(emmeans(m, "warunek"), "trt.vs.ctrl", adjust = "holm"), infer = TRUE))
wy <- function(m) { x <- ko(m); x[, c("estimate", "SE", "lower.CL", "upper.CL")] <- round(x[, c("estimate", "SE", "lower.CL", "upper.CL")], 2)
  x$p.value <- signif(x$p.value, 2); x[, c("contrast", "estimate", "SE", "df", "lower.CL", "upper.CL", "p.value")] }
cat("\nKontrasty względem A, model z sesją:\n"); print(wy(m_sesja), row.names = FALSE)
cat("\nKontrasty względem A, model bez sesji:\n"); print(wy(m_bez), row.names = FALSE)
cat(sprintf("\nSD reszt: z sesją %.2f, bez sesji %.2f\n", sigma(m_sesja), sigma(m_bez)))

# 2000 powtórzeń: cztery schematy, bez przeniesienia i z przeniesieniem po warunku C
schematy <- list("Stała kolejność" = stala, "Prosty kwadrat łaciński" = lacinski,
                 "Kwadrat zrównoważony" = zrownowazony, "Pełne kontrbalansowanie" = pelne)
set.seed(4693)
R <- 2000
wyn <- do.call(rbind, lapply(c(0, -6), function(pr) do.call(rbind, lapply(names(schematy), function(nz) {
  w <- t(replicate(R, {
    m <- wg_warunku(symuluj(schematy[[nz]], pr))
    c(BA = mean(m[, 2] - m[, 1]), CA = mean(m[, 3] - m[, 1]), DA = mean(m[, 4] - m[, 1]),
      p = t.test(m[, 2], m[, 1], paired = TRUE)$p.value)
  }))
  data.frame(przeniesienie = pr, schemat = nz, B_A = mean(w[, "BA"]), C_A = mean(w[, "CA"]), D_A = mean(w[, "DA"]),
             odsetek_p_B_A = 100 * mean(w[, "p"] < .05))
}))))
wyn[, 3:6] <- round(wyn[, 3:6], 2)
cat("\nŚrednie oszacowania z 2000 badań (prawda: B–A = 0, C–A = -3, D–A = -8):\n")
print(wyn, row.names = FALSE)
write.csv(wyn, "b469-symulacja.csv", row.names = FALSE, fileEncoding = "UTF-8")
Wynik w R
Średnie czasy w warunkach:
   A    B    C    D
84.1 84.8 82.4 78.1
Średnie czasy w sesjach:
   1    2    3    4
92.5 84.3 78.9 73.7

Stała kolejność A–B–C–D (osobne losowanie, prawdziwe różnice: B–A 0, D–A -8):
B – A: różnica -11.2 s, t(47) = -7.76, p < .001, 95% CI [-14.1, -8.3]
D – A: różnica -25.8 s, t(47) = -17.91, p < .001, 95% CI [-28.7, -22.9]

Kwadrat zrównoważony, test t dla par (bez sesji w modelu):
B – A: różnica 0.6 s, t(47) = 0.34, p = .739, 95% CI [-3.2, 4.5]
D – A: różnica -6.0 s, t(47) = -3.06, p = .004, 95% CI [-10.0, -2.1]

Test warunku (model z sesją):
Type III Analysis of Variance Table with Satterthwaite's method
        Sum Sq Mean Sq NumDF DenDF F value    Pr(>F)
warunek 1295.2  431.72     3   138   8.152 4.904e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Kontrasty względem A, model z sesją:
 contrast estimate   SE  df lower.CL upper.CL p.value
    B - A     0.65 1.49 138    -2.95     4.25 0.66000
    C - A    -1.65 1.49 138    -5.25     1.95 0.53000
    D - A    -6.01 1.49 138    -9.61    -2.41 0.00026

Kontrasty względem A, model bez sesji:
 contrast estimate   SE  df lower.CL upper.CL p.value
    B - A     0.65 2.21 141    -4.70     6.00   0.910
    C - A    -1.65 2.21 141    -7.01     3.70   0.910
    D - A    -6.01 2.21 141   -11.36    -0.66   0.022

SD reszt: z sesją 7.28, bez sesji 10.82

Średnie oszacowania z 2000 badań (prawda: B–A = 0, C–A = -3, D–A = -8):
 przeniesienie                 schemat   B_A    C_A    D_A odsetek_p_B_A
             0         Stała kolejność -9.00 -17.01 -24.97        100.00
             0 Prosty kwadrat łaciński  0.00  -2.99  -7.95          0.65
             0    Kwadrat zrównoważony  0.03  -2.98  -7.98          0.80
             0 Pełne kontrbalansowanie  0.04  -2.97  -8.00          0.55
            -6         Stała kolejność -9.02 -17.05 -31.01        100.00
            -6 Prosty kwadrat łaciński  0.02  -3.06 -12.53          0.25
            -6    Kwadrat zrównoważony  0.02  -1.47  -8.00          0.10
            -6 Pełne kontrbalansowanie  0.09  -1.48  -7.99          0.25
Trzy pomiary połączone po kodzie
R
# B469 – trzy pomiary w czasie łączone po kodzie: przepływ uczestników i porównanie ubytku
# Wynik: stres (fikcyjna skala 0–40), T0 – przed sesją, T1 – w sesji, T2 – miesiąc po sesji. Dane symulowane.
library(dplyr)
library(lmerTest)

set.seed(4694)
n <- 120
kod <- replicate(n, paste0(paste(sample(LETTERS, 3, TRUE), collapse = ""), sample(10:99, 1)))
stopifnot(!anyDuplicated(kod))
u <- rnorm(n, 0, 5)
t0 <- 20 + u + rnorm(n, 0, 3); t1 <- 26 + u + rnorm(n, 0, 3); t2 <- 18 + u + rnorm(n, 0, 3)
# Udział: w T1 odpadają 15% osób; w T2 częściej odpadają osoby z wysokim stresem w T1
jest1 <- rbinom(n, 1, .85) == 1
jest2 <- jest1 & rbinom(n, 1, plogis(1.2 - .30 * (t1 - mean(t1)))) == 1

f0 <- data.frame(kod = kod, t0 = round(t0))
f0 <- rbind(f0, f0[17, ])                      # ta sama osoba wysłała ankietę dwa razy
f1 <- data.frame(kod = kod[jest1], t1 = round(t1[jest1]))
f2 <- data.frame(kod = kod[jest2], t2 = round(t2[jest2]))
# Literówki w kodzie w T1: ostatnia cyfra zmieniona u trzech osób
li <- c(4, 21, 55); popr <- f1$kod[li]
f1$kod[li] <- paste0(substr(popr, 1, 4), (as.integer(substr(popr, 5, 5)) + 1) %% 10)

cat(sprintf("Wiersze: T0 = %d, T1 = %d, T2 = %d\n", nrow(f0), nrow(f1), nrow(f2)))
cat("Duplikaty kodu w T0:", sum(duplicated(f0$kod)), "\n")
f0 <- f0[!duplicated(f0$kod), ]
sieroty <- anti_join(f1, f0, by = "kod")
cat("Kody z T1 bez pary w T0:", nrow(sieroty), "\n")
# Poprawki z dziennika zmian: kod błędny -> kod właściwy, po sprawdzeniu metryczki
f1$kod[li] <- popr

szer <- f0 %>% left_join(f1, by = "kod") %>% left_join(f2, by = "kod")
stopifnot(nrow(szer) == n)
cat(sprintf("Przepływ: T0 = %d, T0 i T1 = %d (%.1f%%), komplet T0–T2 = %d (%.1f%%)\n", n, sum(!is.na(szer$t1)),
            100 * mean(!is.na(szer$t1)), sum(!is.na(szer$t2)), 100 * mean(!is.na(szer$t2))))

komp <- !is.na(szer$t2)
sd_w <- sqrt((var(szer$t0[komp]) + var(szer$t0[!komp])) / 2)
cat(sprintf("Stres w T0: ukończyli M = %.1f, nie ukończyli M = %.1f, standaryzowana różnica %.2f\n",
            mean(szer$t0[komp]), mean(szer$t0[!komp]), (mean(szer$t0[komp]) - mean(szer$t0[!komp])) / sd_w))
kt1 <- !is.na(szer$t1)
sd_w1 <- sqrt((var(szer$t1[komp]) + var(szer$t1[kt1 & !komp])) / 2)
cat(sprintf("Stres w T1 (osoby z T1): ukończyli M = %.1f, nie ukończyli M = %.1f, standaryzowana różnica %.2f\n",
            mean(szer$t1[komp]), mean(szer$t1[kt1 & !komp]), (mean(szer$t1[komp]) - mean(szer$t1[kt1 & !komp])) / sd_w1))

dlugi <- tidyr::pivot_longer(szer, t0:t2, names_to = "pomiar", values_to = "stres")
m_mix <- lmer(stres ~ pomiar + (1 | kod), data = dlugi)
b <- fixef(m_mix)
cat(sprintf("Różnica T2 – T1, prawda dla całej próby: %.2f\n", mean(round(t2) - round(t1))))
cat(sprintf("Różnica T2 – T1, tylko komplet (n = %d): %.2f\n", sum(komp), mean(szer$t2[komp] - szer$t1[komp])))
cat(sprintf("Różnica T2 – T1, model mieszany (wszystkie obserwacje): %.2f\n", b[["pomiart2"]] - b[["pomiart1"]]))
cat(sprintf("Średnia T2 (prawda %.1f): tylko osoby z T2 %.1f; model mieszany %.1f\n", mean(round(t2)),
            mean(szer$t2, na.rm = TRUE), b[["(Intercept)"]] + b[["pomiart2"]]))
Wynik w R
Wiersze: T0 = 121, T1 = 100, T2 = 73
Duplikaty kodu w T0: 1
Kody z T1 bez pary w T0: 3
Przepływ: T0 = 120, T0 i T1 = 100 (83.3%), komplet T0–T2 = 73 (60.8%)
Stres w T0: ukończyli M = 20.1, nie ukończyli M = 21.5, standaryzowana różnica -0.26
Stres w T1 (osoby z T1): ukończyli M = 25.6, nie ukończyli M = 31.0, standaryzowana różnica -1.11
Różnica T2 – T1, prawda dla całej próby: -7.91
Różnica T2 – T1, tylko komplet (n = 73): -7.64
Różnica T2 – T1, model mieszany (wszystkie obserwacje): -8.14
Średnia T2 (prawda 18.8): tylko osoby z T2 17.9; model mieszany 18.7
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- emmeans (wersja 2.0.2): Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- pwr (wersja 1.3.0): Champely, S. (2020). pwr: Basic functions for power analysis [R package]. https://doi.org/10.32614/CRAN.package.pwr
- dplyr (wersja 1.2.0): Wickham, H., François, R., Henry, L., Müller, K., & Vaughan, D. (2026). dplyr: A grammar of data manipulation [R package]. https://doi.org/10.32614/CRAN.package.dplyr
- tidyr (wersja 1.3.2): Wickham, H., Vaughan, D., & Girlich, M. (2025). tidyr: Tidy messy data [R package]. https://doi.org/10.32614/CRAN.package.tidyr
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Przed badaniem i przed oddaniem metody sprawdź…
- Czy czynnik powtarzany to warunek, czas, czy oba – i czy napisano to wprost?
- Czy kolejności są podane, a ich liczba odpowiada liczbie warunków i przyjętemu schematowi?
- Czy przydział do kolejności był losowy, blokowy i przygotowany przed badaniem?
- Czy N jest wielokrotnością liczby kolejności?
- Czy zaplanowano próbę treningową, wersje równoległe i przerwy, a odstęp ma uzasadnienie?
- Czy zadania lub bodźce przypisano do warunków w opisany sposób?
- Czy pozycja w sesji jest w modelu?
- Czy kody łączenia mają kontrolę duplikatów i braków pary oraz dziennik zmian?
- Czy podajesz liczebność w każdym pomiarze i opis osób, które odpadły?
- Czy wnioski nie mówią o przyczynie, jeśli kolejność była stała albo pomiar był tylko w czasie?
Najczęstsze pytania
Czym różni się kwadrat łaciński od kwadratu zrównoważonego?
Prosty kwadrat łaciński sprawia, że każdy warunek stoi raz na każdej pozycji, ale w stałej kolejności następuje po tym samym warunku. Kwadrat zrównoważony (Williamsa) dodatkowo równoważy bezpośredniego poprzednika: każdy warunek ma każdego poprzednika raz. W symulacji z przeniesieniem prosty kwadrat zawyżał różnicę o 4.5 s, a zrównoważony jej nie zawyżał.
Ile osób potrzebuję przy czterech warunkach i kontrbalansowaniu?
Tyle, ile wynika z analizy mocy, zaokrąglone w górę do wielokrotności liczby kolejności. W przykładzie analiza dla pary warunków dała 42 osoby, a zaplanowano 48, czyli po 12 na każdą z czterech sekwencji. Przy pełnym kontrbalansowaniu czterech warunków N musi być wielokrotnością 24.
Czy pomiary przed, w trakcie i po można kontrbalansować?
Nie. Czas płynie w jedną stronę, więc kontrbalansuje się tylko warunki. Przy pomiarach w czasie opisz terminy, odstępy i ubytek, a wnioski formułuj jako opis zmiany, nie jej przyczyny, chyba że masz grupę porównawczą i odpowiedni schemat.
Co wpisać w metodzie, jeśli część osób nie wypełniła ostatniego pomiaru?
Podaj liczbę osób w każdym pomiarze i liczbę z kompletem danych, porównaj osoby, które odpadły, z pozostałymi na wcześniejszych pomiarach i napisz, czy analiza korzysta z danych częściowych. W przykładzie T0 wypełniło 120 osób, a T2 73.
Czy w analizie trzeba uwzględnić kolejność, skoro ją kontrbalansowałem(-am)?
Warto. Kontrbalansowanie zabezpiecza przed obciążeniem, a dodanie sesji lub pozycji do modelu zmniejsza błąd. W przykładzie błąd standardowy kontrastu spadł z 2.21 do 1.49 przy tych samych oszacowaniach.
Powiązane hasła
Przeczytaj też
Nie da się połączyć pomiaru przed i po
Uczciwe łączenie kodów regułami ustalonymi z góry, analiza jak dla dwóch grup, utrata mocy, selektywne łączenie, kod R i gotowe zdania.
Czytaj →PoradnikPorównanie grup istniejących
Pacjenci i osoby bez choroby, zawody, płeć: źródło każdej grupy, dobór grupy porównawczej, standaryzowane różnice, ANCOVA ostrożnie i gotowa metoda – z kodem R.
Czytaj →PoradnikANOVA z powtarzanymi pomiarami krok po kroku
Cztery warunki, te same osoby: sferyczność i poprawka GG, η²G, porównania parami w emmeans, wykres z CI wewnątrzosobowymi, schemat mieszany i opis APA.
Czytaj →PoradnikSchemat naprzemienny (crossover)
AB/BA krok po kroku: okres, sekwencja, przeniesienie i wypłukiwanie, model mieszany w R, symulacja procedury dwuetapowej i wzór opisu.
Czytaj →PoradnikANOVA z powtarzanymi pomiarami czy model mieszany?
Ten sam przykład 2 × 4 w afex i lmerTest, symulacja odpadania MAR, struktura efektów losowych, stopnie swobody, R² i gotowy opis do artykułu.
Czytaj →PoradnikKod identyfikacyjny w ankiecie anonimowej
Jak zbudować kod respondenta, ile osób ma taki sam, dopasowanie z odległością Levenshteina, fałszywe pary i RODO – z symulacją w R.
Czytaj →PoradnikBadanie przed i po – opis metody i wnioski
Gotowy podrozdział „Metoda” dla jednej grupy i grupy nierandomizowanej, symulacja regresji do średniej i zdania, które wolno napisać we wnioskach.
Czytaj →Masz badanie z powtarzanymi pomiarami i nie wiesz, jak je opisać?
Pomożemy zaplanować kolejność warunków, połączyć pomiary i dobrać model, sprawdzimy obliczenia w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Brooks, J. L. (2012). Counterbalancing for serial order carryover effects in experimental condition orders. Psychological Methods, 17(4), 600–614. https://doi.org/10.1037/a0029310 ● Otwarty dostęp: pełny tekst
- Calamia, M., Markon, K., & Tranel, D. (2012). Scoring higher the second time around: Meta-analyses of practice effects in neuropsychological assessment. The Clinical Neuropsychologist, 26(4), 543–570. https://doi.org/10.1080/13854046.2012.680913
- Graham, J. W. (2009). Missing data analysis: Making it work in the real world. Annual Review of Psychology, 60(1), 549–576. https://doi.org/10.1146/annurev.psych.58.110405.085530
- Greenwald, A. G. (1976). Within-subjects designs: To use or not to use? Psychological Bulletin, 83(2), 314–320. https://doi.org/10.1037/0033-2909.83.2.314
- Hausknecht, J. P., Halpert, J. A., Di Paolo, N. T., & Moriarty Gerrard, M. O. (2007). Retesting in selection: A meta-analysis of coaching and practice effects for tests of cognitive ability. Journal of Applied Psychology, 92(2), 373–385. https://doi.org/10.1037/0021-9010.92.2.373
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Pollatsek, A., & Well, A. D. (1995). On the use of counterbalanced designs in cognitive research: A suggestion for a better and more powerful analysis. Journal of Experimental Psychology: Learning, Memory, and Cognition, 21(3), 785–794. https://doi.org/10.1037/0278-7393.21.3.785
- Twisk, J., & de Vente, W. (2002). Attrition in longitudinal studies: How to deal with missing data. Journal of Clinical Epidemiology, 55(4), 329–337. https://doi.org/10.1016/s0895-4356(01)00476-0
- Williams, E. J. (1949). Experimental designs balanced for the estimation of residual effects of treatments. Australian Journal of Scientific Research Series A: Physical Sciences, 2(2), 149–168. https://doi.org/10.1071/ch9490149
Cytowania BibTeX
@article{brooks2012counterbalancing, author={Brooks, Joseph L.}, title={{Counterbalancing for serial order carryover effects in experimental condition orders}}, journal={Psychological Methods}, year={2012}, volume={17}, number={4}, pages={600--614}, doi={10.1037/a0029310}}@article{calamia2012scoring, author={Calamia, Matthew and Markon, Kristian and Tranel, Daniel}, title={{Scoring higher the second time around: Meta-analyses of practice effects in neuropsychological assessment}}, journal={The Clinical Neuropsychologist}, year={2012}, volume={26}, number={4}, pages={543--570}, doi={10.1080/13854046.2012.680913}}@article{graham2009missing, author={Graham, John W.}, title={{Missing data analysis: Making it work in the real world}}, journal={Annual Review of Psychology}, year={2009}, volume={60}, number={1}, pages={549--576}, doi={10.1146/annurev.psych.58.110405.085530}}@article{greenwald1976within, author={Greenwald, Anthony G.}, title={{Within-subjects designs: To use or not to use?}}, journal={Psychological Bulletin}, year={1976}, volume={83}, number={2}, pages={314--320}, doi={10.1037/0033-2909.83.2.314}}@article{hausknecht2007retesting, author={Hausknecht, John P. and Halpert, Jane A. and Di Paolo, Nicole T. and Moriarty Gerrard, Meghan O.}, title={{Retesting in selection: A meta-analysis of coaching and practice effects for tests of cognitive ability}}, journal={Journal of Applied Psychology}, year={2007}, volume={92}, number={2}, pages={373--385}, doi={10.1037/0021-9010.92.2.373}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{pollatsek1995use, author={Pollatsek, Alexander and Well, Arnold D.}, title={{On the use of counterbalanced designs in cognitive research: A suggestion for a better and more powerful analysis}}, journal={Journal of Experimental Psychology: Learning, Memory, and Cognition}, year={1995}, volume={21}, number={3}, pages={785--794}, doi={10.1037/0278-7393.21.3.785}}@article{twisk2002attrition, author={Twisk, Jos and de Vente, Wieke}, title={{Attrition in longitudinal studies: How to deal with missing data}}, journal={Journal of Clinical Epidemiology}, year={2002}, volume={55}, number={4}, pages={329--337}, doi={10.1016/s0895-4356(01)00476-0}}@article{williams1949experimental, author={Williams, E. J.}, title={{Experimental designs balanced for the estimation of residual effects of treatments}}, journal={Australian Journal of Scientific Research Series A: Physical Sciences}, year={1949}, volume={2}, number={2}, pages={149--168}, doi={10.1071/ch9490149}}