Co to są zasoby zmienności wspólnej (wspólności)?
Zasoby zmienności wspólnej, czyli wspólność pozycji (ang. communality, oznaczana h²), to część wariancji pozycji wyjaśniana przez wszystkie czynniki wspólne w rozwiązaniu eksploracyjnej analizy czynnikowej (EFA). Wspólność przyjmuje wartości od 0 do 1: h² = .50 oznacza, że połowa zróżnicowania odpowiedzi na pozycję wynika z czynników, a połowa jest dla tej pozycji swoista. Dopełnieniem jest swoistość (uniqueness, u² = 1 − h²). Obejmuje ona specyficzną treść pozycji i błąd pomiaru.
Przy czynnikach nieskorelowanych wspólność to po prostu suma kwadratów ładunków czynnikowych pozycji. Przy rotacji ukośnej trzeba uwzględnić korelacje czynników: h² to element przekątnej macierzy PΦP′. Sama rotacja wspólności nie zmienia – zależą one tylko od liczby czynników i metody ekstrakcji.
Wspólności początkowe i końcowe
Programy pokazują zwykle dwie kolumny wspólności, które łatwo pomylić:
- Początkowe (initial) – punkt startowy algorytmu. W metodzie osi głównych to kwadrat korelacji wielokrotnej pozycji z pozostałymi (SMC). W metodzie głównych składowych zawsze 1, bo analizuje się całą wariancję.
- Po ekstrakcji (extraction) – właściwe oszacowanie h² dla przyjętej liczby czynników. Te wartości raportujesz i interpretujesz.
Wspólność zależy od liczby czynników: dodanie czynnika zwykle ją podnosi. Dlatego niska wspólność może oznaczać, że pozycja słabo mierzy konstrukt, ale także, że brakuje czynnika, który ją opisuje. Jeśli kilka pozycji o niskich wspólnościach ma wspólną treść, sprawdź rozwiązanie z dodatkowym czynnikiem.
Przykład: skala samotności
Dwieście osiemdziesiąt osób wypełniło 10-pozycyjną skalę samotności: pięć pozycji dotyczy samotności emocjonalnej (emo1–emo5, np. brak bliskiej osoby), pięć – społecznej (spo1–spo5, np. brak grupy znajomych); odpowiedzi 1–5, dane symulowane. W modelu, z którego wygenerowano dane, pozycja spo5 była słabo związana z konstruktem (ładunek .30). Dwa czynniki wyodrębniono metodą osi głównych z rotacją oblimin.
| Pozycja | Ładunek wzoru | h² początkowa (SMC) | h² po ekstrakcji | u² = 1 − h² |
|---|---|---|---|---|
| emo1 | .72 | .38 | .51 | .49 |
| emo2 | .70 | .39 | .49 | .51 |
| emo3 | .67 | .35 | .45 | .55 |
| emo4 | .58 | .28 | .35 | .65 |
| emo5 | .35 | .11 | .13 | .87 |
| spo1 | .71 | .36 | .51 | .49 |
| spo2 | .63 | .31 | .42 | .58 |
| spo3 | .61 | .28 | .37 | .63 |
| spo4 | .53 | .21 | .27 | .73 |
| spo5 | .42 | .12 | .16 | .84 |
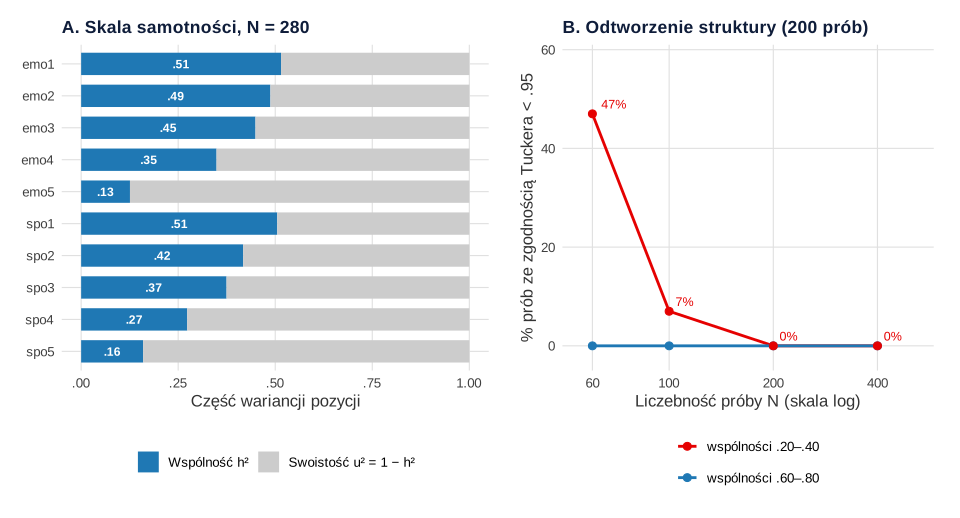
Średnia wspólność wynosi .37, a suma wspólności 3.66 – oba czynniki wyjaśniają razem 36.6% wariancji 10 pozycji. Dwie pozycje wyraźnie odstają: emo5 (h² = .13) i spo5 (h² = .16). Czynniki wyjaśniają w nich odpowiednio 13% i 16% wariancji, a resztę stanowi treść swoista i błąd. Przypadek spo5 pokazuje też, dlaczego przy rotacji ukośnej nie wolno liczyć wspólności jako sumy kwadratów ładunków wzoru: dla tej pozycji suma kwadratów daje .192, a poprawna wartość z uwzględnieniem korelacji czynników to .160.
Wspólności a liczebność próby
Wspólności mają znaczenie wykraczające poza ocenę pojedynczych pozycji. MacCallum i in. (1999) pokazali, że potrzebna liczebność próby w analizie czynnikowej nie jest stała. Zależy przede wszystkim od poziomu wspólności i od tego, ile pozycji przypada na czynnik, a popularne reguły typu „10 osób na pozycję” nie mają solidnych podstaw.
Panel B rysunku 1 powtarza tę logikę w małej symulacji. Dla struktury dwóch czynników po 5 pozycji wygenerowano po 200 prób i porównano odtworzone ładunki z prawdziwymi za pomocą współczynnika zgodności Tuckera. Lorenzo-Seva i ten Berge (2006) wskazują, że wartość powyżej .95 pozwala uznać czynniki za równe. Przy wysokich wspólnościach (.60–.80) już 60 osób dawało średnią zgodność .993 i ani jednej próby poniżej .95. Przy niskich wspólnościach (.20–.40) średnia zgodność przy 60 osobach wyniosła .945, a 47% prób nie osiągnęło progu .95. Przy 100 osobach odsetek ten spadł do 7%, a przy 200 – do zera. Im niższe wspólności, tym większej próby potrzebujesz, by struktura czynnikowa była powtarzalna. Velicer i Fava (1998) badali ten sam problem z perspektywy doboru zmiennych i osób.
Jak interpretować niskie wspólności?
Nie ma jednego progu. W literaturze często pojawia się orientacyjna granica .20–.40 dla pozycji „słabo reprezentowanych”, ale decyzja zależy od celu, liczby pozycji i treści. Przy pozycji o niskiej wspólności sprawdź po kolei:
- Treść – czy pozycja dotyczy tego samego konstruktu, czy wąskiego aspektu (np. spo5 może pytać o coś bardziej specyficznego)?
- Rozkład odpowiedzi – efekt sufitu lub podłogi i mała zmienność zaniżają korelacje, a więc i wspólność.
- Brakujący czynnik – czy kilka słabych pozycji ma wspólną treść, którą opisałby dodatkowy czynnik?
- Odwrócone brzmienie – pozycje odwrócone mają często niższe wspólności i bywają skupione na osobnym czynniku metody.
Usunięcie pozycji poprawia średnią wspólność, ale prawie nie zmienia wspólności pozostałych pozycji. W przykładzie po usunięciu spo5 wspólności pozycji spo1–spo4 wyniosły .54, .41, .36 i .27, a emo1–emo5 .52, .48, .45, .35 i .13. Decyzję o usunięciu podejmuj więc ze względu na treść i trafność, nie po to, by „podnieść wspólności”. Fabrigar i in. (1999) oraz Watkins (2018) przypominają, że decyzje w EFA – także dotyczące pozycji – wpływają na wynik i wymagają uzasadnienia. Szerzej o selekcji pozycji piszemy w poradniku Jak zbudować i zwalidować skalę psychometryczną.
Jak opisać wspólności w pracy (APA)
Wspólności po ekstrakcji umieść w ostatniej kolumnie tabeli ładunków (h²), zgodnie z wzorem tabeli analizy czynnikowej w APA. W tekście podaj zakres i wskaż pozycje o niskich wartościach.
Dalsze kroki, w tym CFA i ocenę rzetelności podskal, opisujemy w poradniku Analiza czynnikowa EFA i CFA.
Przykład w R
Kod generuje dane skali samotności, wykonuje EFA metodą osi głównych z rotacją oblimin, zestawia wspólności początkowe, końcowe i swoistości, pokazuje poprawne liczenie h² przy rotacji ukośnej, powtarza analizę bez pozycji spo5 i przeprowadza symulację z rysunku 1B (trwa około minuty).
Wspólności w EFA i ich związek z liczebnością próby
R
# R177 – Zasoby zmienności wspólnej (wspólności, h²) w EFA
# Dane symulowane: 10 pozycji skali samotności – 5 pozycji samotności emocjonalnej (emo),
# 5 pozycji samotności społecznej (spo); pozycja spo5 słabo związana z konstruktem; N = 280, odpowiedzi 1–5
suppressPackageStartupMessages({library(MASS); library(psych); library(GPArotation)})
set.seed(177)
L <- matrix(0, 10, 2)
L[1:5, 1]  <- c(.80, .75, .70, .65, .55)
L[6:10, 2] <- c(.75, .70, .65, .60, .30)
Phi <- matrix(c(1, .40, .40, 1), 2)
Sigma <- L %*% Phi %*% t(L); diag(Sigma) <- 1
z <- mvrnorm(280, rep(0, 10), Sigma)
dane <- as.data.frame(apply(z, 2, function(x) as.integer(cut(x, c(-Inf, -1.5, -0.5, 0.5, 1.5, Inf)))))
names(dane) <- c(paste0("emo", 1:5), paste0("spo", 1:5))

efa <- fa(dane, nfactors = 2, fm = "pa", rotate = "oblimin")
R <- cor(dane)
tab <- data.frame(poczatkowa_SMC = 1 - 1 / diag(solve(R)),
                  po_ekstrakcji = efa$communality,
                  swoistosc = efa$uniquenesses)
round(tab, 2)
# Przy rotacji ukośnej h² = wiersz macierzy P Φ P' (nie suma kwadratów ładunków wzoru)
P <- unclass(efa$loadings)
h2_z_P <- rowSums((P %*% efa$Phi) * P)
round(rbind(h2_z_P = h2_z_P, suma_kw_ladunkow = rowSums(P^2))[, c(1, 10)], 3)
round(c(srednia_h2 = mean(efa$communality), suma_h2 = sum(efa$communality), proc_wariancji = 100 * sum(efa$communality) / 10), 2)
round(P, 2)

# Ta sama analiza bez pozycji spo5: wspólności pozostałych prawie się nie zmieniają
f9 <- fa(dane[, -10], nfactors = 2, fm = "pa", rotate = "oblimin")
round(f9$communality, 2)

# Wspólności a liczebność próby (MacCallum i in., 1999): odtworzenie struktury dwuczynnikowej
# przy wysokich (.60–.80) i niskich (.20–.40) wspólnościach; współczynnik zgodności Tuckera
set.seed(17700)
odtworzenie <- function(lam, n) {
  Lp <- matrix(0, 10, 2); Lp[1:5, 1] <- lam; Lp[6:10, 2] <- lam
  S <- Lp %*% t(Lp); diag(S) <- 1
  x <- mvrnorm(n, rep(0, 10), S)
  e <- suppressWarnings(suppressMessages(fa(x, nfactors = 2, fm = "pa", rotate = "varimax")))
  cg <- abs(factor.congruence(Lp, e$loadings))
  mean(c(max(cg[1, ]), max(cg[2, ])))
}
war <- expand.grid(wspolnosci = c("wysokie", "niskie"), n = c(60, 100, 200, 400))
lam_war <- list(wysokie = sqrt(c(.60, .65, .70, .75, .80)), niskie = sqrt(c(.20, .25, .30, .35, .40)))
wyniki <- t(mapply(function(w, n) {
  cg <- replicate(200, odtworzenie(lam_war[[as.character(w)]], n))
  c(sr_zgodnosc = mean(cg), proc_ponizej_95 = 100 * mean(cg < .95))
}, war$wspolnosci, war$n))
sym <- cbind(war, round(wyniki, 3))
sym
Wynik w R
     poczatkowa_SMC po_ekstrakcji swoistosc
emo1           0.38          0.51      0.49
emo2           0.39          0.49      0.51
emo3           0.35          0.45      0.55
emo4           0.28          0.35      0.65
emo5           0.11          0.13      0.87
spo1           0.36          0.51      0.49
spo2           0.31          0.42      0.58
spo3           0.28          0.37      0.63
spo4           0.21          0.27      0.73
spo5           0.12          0.16      0.84
                  emo1  spo5
h2_z_P           0.515 0.160
suma_kw_ladunkow 0.512 0.192
    srednia_h2        suma_h2 proc_wariancji
          0.37           3.66          36.56
       PA1   PA2
emo1  0.72  0.01
emo2  0.70 -0.02
emo3  0.67  0.01
emo4  0.58  0.02
emo5  0.35  0.00
spo1  0.01  0.71
spo2  0.03  0.63
spo3  0.00  0.61
spo4 -0.02  0.53
spo5 -0.11  0.42
emo1 emo2 emo3 emo4 emo5 spo1 spo2 spo3 spo4
0.52 0.48 0.45 0.35 0.13 0.54 0.41 0.36 0.27
  wspolnosci   n sr_zgodnosc proc_ponizej_95
1    wysokie  60       0.993               0
2     niskie  60       0.945              47
3    wysokie 100       0.997               0
4     niskie 100       0.969               7
5    wysokie 200       1.000               0
6     niskie 200       0.985               0
7    wysokie 400       1.000               0
8     niskie 400       0.992               0
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3; EFA i współczynnik zgodności policzono pakietem psych (rotacja oblimin z GPArotation), dane wygenerowano pakietem MASS, rysunek przygotowano w ggplot2 i patchwork.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- GPArotation (wersja 2025.3-1): Bernaards, C. A., & Jennrich, R. I. (2005). Gradient projection algorithms and software for arbitrary rotation criteria in factor analysis. Educational and Psychological Measurement, 65(5), 676–696. https://doi.org/10.1177/0013164404272507
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Raportowanie wspólności początkowych zamiast końcowych – w metodzie głównych składowych początkowe to same jedynki, w osiach głównych – SMC.
- Sumowanie kwadratów ładunków wzoru po rotacji ukośnej – daje błędne h² (w przykładzie .192 zamiast .160 dla spo5).
- Mechaniczne usuwanie pozycji poniżej progu – zawęża konstrukt; najpierw sprawdź treść i rozkład odpowiedzi.
- Wspólność równa lub większa od 1 – to przypadek Heywooda, sygnał zbyt wielu czynników lub zbyt małej próby, a nie „idealna” pozycja.
- Reguła „10 osób na pozycję” bez oglądania wspólności – przy niskich wspólnościach nawet 100 osób może nie wystarczyć.
- Mylenie wspólności z rzetelnością – h² opisuje wariancję wspólną z innymi pozycjami w danym rozwiązaniu, a nie rzetelność pozycji; wariancja swoista może zawierać treść stabilną w czasie.
Najczęstsze pytania
Co oznacza wspólność pozycji w analizie czynnikowej?
To odsetek wariancji pozycji wyjaśniany przez wszystkie zachowane czynniki. Wspólność .51 oznacza, że czynniki wyjaśniają 51% zróżnicowania odpowiedzi, a pozostałe 49% to treść swoista dla pozycji i błąd pomiaru.
Jaka wspólność jest za niska?
Nie ma jednego progu; wartości poniżej około .20 zwykle sygnalizują pozycję słabo związaną z rozwiązaniem. Zanim ją usuniesz, sprawdź treść, rozkład odpowiedzi i to, czy nie brakuje czynnika. Usuwaj pozycję z powodów merytorycznych, a nie po to, by podnieść średnią wspólność.
Czym różnią się wspólności początkowe od wspólności po ekstrakcji?
Początkowe są punktem startowym algorytmu: w metodzie osi głównych to kwadraty korelacji wielokrotnej (SMC), w metodzie głównych składowych – jedynki. Wspólności po ekstrakcji to właściwe oszacowania dla przyjętej liczby czynników i właśnie je raportujesz.
Czy rotacja zmienia wspólności?
Nie. Wspólności zależą od liczby czynników i metody ekstrakcji, a rotacja – ortogonalna czy ukośna – tylko obraca osie. Przy rotacji ukośnej nie licz ich jednak jako sumy kwadratów ładunków wzoru, bo trzeba uwzględnić korelacje czynników.
Jak wspólności wpływają na potrzebną liczebność próby?
Im wyższe wspólności, tym mniejsza próba wystarcza do odtworzenia struktury. W symulacji z dwoma czynnikami po 5 pozycji przy wspólnościach .60–.80 wystarczało 60 osób, a przy wspólnościach .20–.40 prawie połowa prób z 60 osobami nie odtworzyła struktury z zadowalającą zgodnością.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza czynnikowa w jamovi
EFA i CFA w jamovi na jednym przykładzie: ustawienia, tabele do czytania, ukryte ładunki, rzetelność, opis APA i te same wyniki w R.
Czytaj →PoradnikAnaliza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Fabrigar, L. R., Wegener, D. T., MacCallum, R. C., & Strahan, E. J. (1999). Evaluating the use of exploratory factor analysis in psychological research. Psychological Methods, 4(3), 272–299. https://doi.org/10.1037/1082-989x.4.3.272
- Lorenzo-Seva, U., & ten Berge, J. M. F. (2006). Tucker’s congruence coefficient as a meaningful index of factor similarity. Methodology, 2(2), 57–64. https://doi.org/10.1027/1614-2241.2.2.57
- MacCallum, R. C., Widaman, K. F., Zhang, S., & Hong, S. (1999). Sample size in factor analysis. Psychological Methods, 4(1), 84–99. https://doi.org/10.1037/1082-989x.4.1.84
- Velicer, W. F., & Fava, J. L. (1998). Affects of variable and subject sampling on factor pattern recovery. Psychological Methods, 3(2), 231–251. https://doi.org/10.1037/1082-989x.3.2.231
- Watkins, M. W. (2018). Exploratory factor analysis: A guide to best practice. Journal of Black Psychology, 44(3), 219–246. https://doi.org/10.1177/0095798418771807 ● Otwarty dostęp
Cytowania BibTeX
@article{fabrigar1999evaluating, author={Fabrigar, Leandre R. and Wegener, Duane T. and MacCallum, Robert C. and Strahan, Erin J.}, title={{Evaluating the use of exploratory factor analysis in psychological research}}, journal={Psychological Methods}, year={1999}, volume={4}, number={3}, pages={272--299}, doi={10.1037/1082-989x.4.3.272}}@article{lorenzoseva2006tucker, author={Lorenzo-Seva, Urbano and ten Berge, Jos M. F.}, title={{Tucker’s congruence coefficient as a meaningful index of factor similarity}}, journal={Methodology}, year={2006}, volume={2}, number={2}, pages={57--64}, doi={10.1027/1614-2241.2.2.57}}@article{maccallum1999sample, author={MacCallum, Robert C. and Widaman, Keith F. and Zhang, Shaobo and Hong, Sehee}, title={{Sample size in factor analysis}}, journal={Psychological Methods}, year={1999}, volume={4}, number={1}, pages={84--99}, doi={10.1037/1082-989x.4.1.84}}@article{velicer1998affects, author={Velicer, Wayne F. and Fava, Joseph L.}, title={{Affects of variable and subject sampling on factor pattern recovery}}, journal={Psychological Methods}, year={1998}, volume={3}, number={2}, pages={231--251}, doi={10.1037/1082-989x.3.2.231}}@article{watkins2018exploratory, author={Watkins, Marley W.}, title={{Exploratory factor analysis: A guide to best practice}}, journal={Journal of Black Psychology}, year={2018}, volume={44}, number={3}, pages={219--246}, doi={10.1177/0095798418771807}}