Do czego służy EFA w SPSS
Eksploracyjna analiza czynnikowa (EFA) sprawdza, ile wspólnych wymiarów kryje się za odpowiedziami na pozycje kwestionariusza i które pozycje do nich należą. W pracy dyplomowej pojawia się zwykle przy budowie własnej skali. Czym EFA różni się od CFA i jak przejść od jednej do drugiej, opisuje poradnik analiza czynnikowa EFA i CFA. Kiedy zamiast niej wystarczy analiza głównych składowych, wyjaśnia wpis PCA czy analiza czynnikowa. Tutaj zajmujemy się tylko SPSS: oknami procedury Factor, składnią i tym, co z wydruku przepisać do pracy.
Ścieżki menu i nazwy opcji sprawdziliśmy w oficjalnej dokumentacji IBM SPSS Statistics 31 (IBM Corp., b.d.-a–b.d.-g). Podajemy je po angielsku. Polska wersja dokumentacji podaje ścieżkę Analizuj → Redukcja wymiarów → Czynnik… (IBM Corp., b.d.-h), ale nazwy opcji w polskim interfejsie mogą brzmieć inaczej niż w naszym opisie. Ogólne zasady czytania wydruku opisuje wpis jak czytać wyniki z SPSS.
Przykład i pliki do pobrania
Wszystkie liczby pochodzą z jednego zbioru symulowanego. 260 osób studiujących odpowiedziało na 12 pozycji fikcyjnej skali postaw wobec statystyki (od 1 – zdecydowanie się nie zgadzam do 5 – zdecydowanie się zgadzam). Skalę zaprojektowaliśmy z trzema podskalami po cztery pozycje: lęk na zajęciach i sprawdzianach (z1, z4, z7, z10), przekonanie o wartości statystyki (z3, z6, z9, z12) oraz lęk przed proszeniem o pomoc (z2, z5, z8, z11). Pozycje podskal są przemieszane. Cztery osoby pominęły po jednej pozycji.
Pobierz plik .sav z etykietami zmiennych i odpowiedzi albo ten sam zbiór w pliku CSV. Format SPSS opisuje hasło plik .sav.
Przygotowanie danych
- Jedna kolumna na pozycję z wartościami 1–5 – analizujesz pozycje, a nie wyniki podskal.
- Pozycje odwrócone przekodowane albo zostawione – ważne, żeby wiedzieć, które to. W EFA pozycja odwrócona bez przekodowania da ujemny ładunek. Przekodowanie krok po kroku pokazuje wpis przygotowanie danych w SPSS.
- Typ danych. Dokumentacja IBM wymaga zmiennych ilościowych, odpowiednich do korelacji Pearsona. Danych kategorialnych nie należy analizować tą procedurą (IBM Corp., b.d.-a). Pozycje skali Likerta z pięcioma odpowiedziami zwykle traktuje się jako przybliżenie danych ilościowych. Przy dwóch–trzech kategoriach lub silnej skośności lepsza jest korelacja polichoryczna, a okno Factor analizuje tylko macierz korelacji albo kowariancji (IBM Corp., b.d.-c).
- Braki danych. Domyślnie SPSS usuwa wiersz z jakimkolwiek brakiem (IBM Corp., b.d.-g). W przykładzie analizę oprze więc na 256 z 260 osób.
EFA w SPSS krok po kroku: okna procedury
- Analyze → Dimension Reduction → Factor. Przenieś z1–z12 na listę Variables. Procedura należy do modułu Statistics Base (IBM Corp., b.d.-a).
- Descriptives. Zaznacz Univariate descriptives, Initial solution oraz KMO and Bartlett's test of sphericity. Opcja Anti-image doda macierz z miarą adekwatności (MSA) każdej pozycji na przekątnej (IBM Corp., b.d.-b).
- Extraction. Jako metodę (Method) wybierz Principal axis factoring, czyli metodę osi głównych. Zaznacz Scree plot. W części Extract zmień domyślną regułę wartości własnej na stałą liczbę czynników – tu 3 (IBM Corp., b.d.-c).
- Rotation. Wybierz Promax albo Direct Oblimin, obie rotacje skośne. Obie domyślnie używają normalizacji Kaisera (IBM Corp., b.d.-d).
- Scores – zostaw puste, chyba że naprawdę potrzebujesz wyników czynnikowych (zob. typowe błędy).
- Options. Zaznacz sortowanie współczynników według wielkości i ukrywanie małych współczynników, np. poniżej .30 (IBM Corp., b.d.-f).
- Paste zamiast OK. SPSS wklei składnię FACTOR do edytora (IBM Corp., b.d.-a). Gotową składnię znajdziesz w sekcji składnia SPSS i kod R.
Osie główne czy składowe główne?
Domyślną metodą w SPSS są składowe główne (EXTRACTION=PC), a domyślną rotacją – Varimax (IBM Corp., b.d.-g). To analiza głównych składowych z rotacją ortogonalną, a nie analiza czynnikowa: składowe obejmują całą wariancję pozycji, łącznie z błędem pomiaru, a Varimax zakłada, że wymiary nie korelują. Fabrigar i in. (1999) pokazali, że każda z tych decyzji wpływa na wynik, a autorzy opublikowanych badań rutynowo wybierali rozwiązania wątpliwe. Metoda osi głównych analizuje tylko wariancję wspólną. W symulacjach de Wintera i Dodou (2012) lepiej niż metoda największej wiarygodności odtwarzała strukturę przy niewielu pozycjach na czynnik.
Promax (Hendrickson i White, 1964) najpierw wyznacza rozwiązanie ortogonalne, a potem przekształca je w skośne, podnosząc ładunki do potęgi (kappa). W składni wykładnik to liczba w nawiasie, domyślnie PROMAX(4) (IBM Corp., b.d.-g). Opis okna Rotation tego pola nie wymienia (IBM Corp., b.d.-d), więc wartość najpewniej sprawdzisz w składni. Direct Oblimin (Jennrich i Sampson, 1966) ma parametr delta; domyślne 0 daje rozwiązanie najbardziej skośne (IBM Corp., b.d.-d).
Jak czytać wydruk: tabela po tabeli
Tabele mają układ tabel wynikowych SPSS. Liczby policzono w R tymi samymi metodami co SPSS; układ tabeli jak w SPSS. Iteracje osi głównych i rotacji w SPSS i w pakietach psych i GPArotation mają nieco inne kryteria zbieżności i szczegóły implementacji, dlatego w SPSS liczby mogą się różnić na drugim–trzecim miejscu po przecinku.
KMO i test Bartletta
| Kaiser-Meyer-Olkin Measure of Sampling Adequacy. | .761 | |
| Bartlett's Test of Sphericity | Approx. Chi-Square | 769.469 |
| df | 66 | |
| Sig. | .000 | |
KMO pokazuje, czy korelacje między pozycjami wynikają ze wspólnych czynników, czy są raczej związkami par pozycji. Test Bartletta sprawdza, czy macierz korelacji jest jednostkowa (IBM Corp., b.d.-b; Kaiser i Rice, 1974; Bartlett, 1950). KMO = .76 jest zadowalające, a istotny test Bartletta mówi tylko tyle, że pozycje w ogóle korelują – przy 256 osobach to prawie pewne. Najniższe MSA pojedynczej pozycji (z przekątnej macierzy Anti-image) ma z12: .51. To pierwszy sygnał, że ta pozycja słabo pasuje do reszty. Progi i interpretację opisuje hasło KMO i test sferyczności Bartletta.
Wspólności
| Initial | Extraction | |
|---|---|---|
| z1 | .453 | .627 |
| z2 | .340 | .447 |
| z3 | .308 | .419 |
| z4 | .368 | .393 |
| z5 | .327 | .447 |
| z6 | .323 | .360 |
| z7 | .375 | .492 |
| z8 | .406 | .534 |
| z9 | .299 | .428 |
| z10 | .260 | .265 |
| z11 | .473 | .568 |
| z12 | .185 | .101 |
Wspólność to część wariancji pozycji wyjaśniona przez wspólne czynniki. Kolumna Initial to wartości początkowe – w R przyjęliśmy kwadraty korelacji wielokrotnych (SMC), od których zaczyna metoda osi głównych. Strony dokumentacji, które sprawdziliśmy, nie opisują wartości startowych SPSS. Ważna jest kolumna Extraction. Trzy czynniki wyjaśniają tylko 10% wariancji pozycji z12. Wspólność z10 (.27) też jest niska, ale ta pozycja wyraźnie ładuje swój czynnik.
Wyjaśniona wariancja i liczba czynników
| Factor | Initial Eigenvalues | Extraction Sums of Squared Loadings | Rotation Sums of Squared Loadings: Total | ||||
|---|---|---|---|---|---|---|---|
| Total | % of Variance | Cumulative % | Total | % of Variance | Cumulative % | ||
| 1 | 3.389 | 28.238 | 28.238 | 2.870 | 23.918 | 23.918 | 2.427 |
| 2 | 1.930 | 16.086 | 44.324 | 1.347 | 11.227 | 35.145 | 1.595 |
| 3 | 1.416 | 11.799 | 56.123 | .865 | 7.204 | 42.349 | 2.233 |
| 4 | 1.054 | 8.780 | 64.903 | ||||
| 5 | .774 | 6.453 | 71.356 | ||||
| 6–12 | .632–.362 | 100.000 | |||||
Wiersze 6–12 skróciliśmy. W SPSS każdy czynnik ma osobny wiersz. Cztery wartości własne przekraczają 1, więc przy domyślnym ustawieniu (MINEIGEN(1); IBM Corp., b.d.-g) SPSS wyodrębniłby cztery czynniki. Czwarta wartość, 1.054, jest jednak ledwo powyżej progu. O'Connor (2000) przypomina, że reguła „wartość własna większa od 1” jest wadliwa, a lepszymi metodami są analiza równoległa i test MAP. Opisał też makra, które liczą je w SPSS.
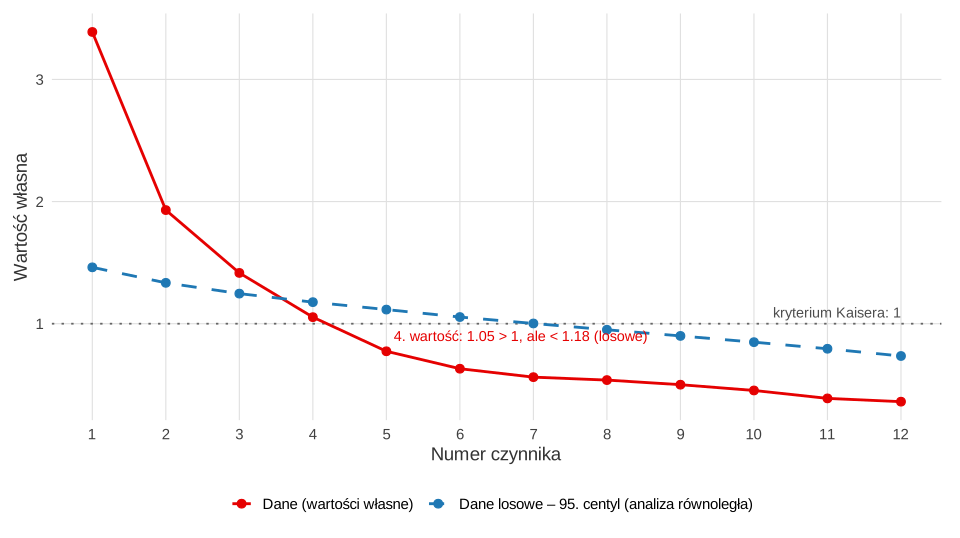
Analiza równoległa (Horn, 1965) porównuje wartości własne z wartościami z danych losowych. Trzy pierwsze są większe od losowych, a czwarta (1.054 wobec 1.177) już nie. Zgadza się to z wykresem osypiska i projektem skali, więc ustawiamy trzy czynniki. Okno Factor analizy równoległej nie liczy. Policz ją makrem O'Connora albo w R (przepis 3 niżej). Uzupełnieniem jest test MAP Velicera.
Ostatnia kolumna pokazuje sumy kwadratów po rotacji. Przy rotacji skośnej czynniki dzielą wariancję, więc tych sum nie dodaje się do wariancji ogółem. W pracy podaj procent wariancji wspólnej sprzed rotacji: trzy czynniki wyjaśniają 42.3% wariancji pozycji.
Macierz wzoru (Pattern Matrix)
| Factor 1 | Factor 2 | Factor 3 | |
|---|---|---|---|
| z1 | .839 | ||
| z7 | .697 | ||
| z4 | .591 | ||
| z10 | .463 | ||
| z9 | .665 | ||
| z3 | .643 | ||
| z6 | .621 | ||
| z12 | .323 | ||
| z8 | .757 | ||
| z5 | .706 | ||
| z2 | .677 | ||
| z11 | .374 | .500 |
Po rotacji skośnej SPSS pokazuje trzy tabele: macierz wzoru, macierz struktury i korelacje czynników (IBM Corp., b.d.-d). Pozycje przypisuj według macierzy wzoru. Jej współczynniki to ładunki, czyli unikatowy związek pozycji z czynnikiem przy kontroli pozostałych. Dwie pozycje wymagają decyzji:
- z11 (unikanie konsultacji z prowadzącym) ładuje swój czynnik (.50), ale też lęk na zajęciach (.37). To ładunek krzyżowy. Treść pozycji dotyczy obu obszarów, więc rozważ jej przeredagowanie albo usunięcie.
- z12 (statystyka jest ciekawa) ładuje czynnik wartości tylko na .32, przy wspólności .10 i najniższym MSA. Pozycja mierzy raczej zainteresowanie niż przekonanie o przydatności.
Usunięcie pozycji to decyzja merytoryczna: po niej powtórz analizę i opisz to w pracy.
Macierz struktury i korelacje czynników
| Factor 1 | Factor 2 | Factor 3 | |
|---|---|---|---|
| z1 | .785 | −.174 | .331 |
| z7 | .690 | −.328 | .240 |
| z4 | .622 | −.184 | .355 |
| z10 | .504 | −.273 | .230 |
| z9 | −.183 | .651 | −.025 |
| z3 | −.232 | .647 | −.111 |
| z6 | −.134 | .595 | −.023 |
| z12 | −.071 | .308 | −.084 |
| z8 | .277 | −.028 | .726 |
| z5 | .230 | −.050 | .663 |
| z2 | .291 | −.103 | .668 |
| z11 | .609 | −.210 | .673 |
| Factor | 1 | 2 | 3 |
|---|---|---|---|
| 1 | 1.000 | −.341 | .458 |
| 2 | −.341 | 1.000 | −.128 |
| 3 | .458 | −.128 | 1.000 |
Macierz struktury zawiera zwykłe korelacje pozycji z czynnikami. Powstaje z macierzy wzoru i korelacji czynników, dlatego pozycje lęku na zajęciach korelują też z lękiem przed proszeniem o pomoc (.23–.36). Oba rodzaje lęku korelują ze sobą na .46, więc Varimax wymusiłby tu nierealistyczną niezależność. Dla z11 pokazuje korelacje .61 i .67 z dwoma czynnikami, co potwierdza problem z tą pozycją. W pracy podaj macierz wzoru i korelacje czynników; macierz struktury dołącz w aneksie albo na prośbę recenzenta.
Promax czy Oblimin?
Na tych samych danych Direct Oblimin z delta = 0 daje prawie ten sam wzór. Największa różnica ładunku wynosi .07, a z11 dzieli się podobnie (.41 i .49). Korelacje czynników są niższe: .37 zamiast .46 i −.28 zamiast −.34. Przegląd kryteriów rotacji pokazał, że różne rotacje skośne mogą dać inne ładunki i korelacje czynników, zwłaszcza przy złożonych pozycjach (Sass i Schmitt, 2010). Wybierz rotację przed analizą i podaj jej parametry. Więcej o obu metodach piszemy w haśle rotacja nieortogonalna (ukośna).
Zapis wyników w stylu APA
W metodzie lub wynikach opisz każdą decyzję: metodę ekstrakcji, sposób wyboru liczby czynników, rotację z parametrem, próg interpretacji ładunków i los problematycznych pozycji (Watkins, 2018). Wzór do dostosowania:
Pełną macierz wzoru ze wspólnościami pokaż w tabeli. Wzór takiej tabeli podaje hasło tabela analizy czynnikowej w APA. Rzetelność podskal policzysz potem w oknie Reliability Analysis (alfa Cronbacha w SPSS) albo, wprost z ładunków, w kalkulatorze alfy i omegi. Zdania do innych testów przygotuje generator opisu wyników APA.
Składnia SPSS i kod R
Przepis 1 to składnia do wklejenia w edytorze składni SPSS. Napisaliśmy ją według opisu polecenia FACTOR w Command Syntax Reference (IBM Corp., b.d.-g), ale nie uruchamialiśmy jej w SPSS. Drugi wiersz /CRITERIA dotyczy rotacji, bo kryteria podane po /EXTRACTION nie wpływają już na ekstrakcję. Przepisy 2 i 3 w R tworzą pliki do pobrania i liczą liczby z tabel: KMO i test Bartletta (pakiet psych), metodę osi głównych odtworzoną krok po kroku jak w SPSS (start od SMC, kryterium zbieżności 0.001, najwyżej 25 iteracji), Promax z kappa = 4 (psych::Promax, rotacja Varimax z normalizacją Kaisera i potęga 4) oraz Direct Oblimin z delta = 0 (pakiet GPArotation). Sumy kwadratów po rotacji policzyliśmy z macierzy struktury. Kryteria zbieżności i szczegóły rotacji w SPSS mogą się nieco różnić, dlatego w SPSS ostatnie miejsca po przecinku mogą być inne. Uruchom przepisy po kolei z folderu, w którym zapiszesz pliki danych.
1. Składnia SPSS: FACTOR z osiami głównymi i Promax
SPSS
* EFA: 12 pozycji, metoda osi głównych, 3 czynniki, Promax (kappa = 4).
* Składnia zgodna z opisem FACTOR w Command Syntax Reference; nie była uruchamiana w SPSS.
FACTOR
  /VARIABLES=z1 z2 z3 z4 z5 z6 z7 z8 z9 z10 z11 z12
  /MISSING=LISTWISE
  /PRINT=UNIVARIATE INITIAL EXTRACTION ROTATION KMO AIC
  /FORMAT=SORT BLANK(.30)
  /PLOT=EIGEN
  /CRITERIA=FACTORS(3) ITERATE(25)
  /EXTRACTION=PAF
  /CRITERIA=ITERATE(25)
  /ROTATION=PROMAX(4).

* Wariant z rotacją Direct Oblimin (delta = 0) – zamień tylko ostatni wiersz.
*  /ROTATION=OBLIMIN(0).
2. Dane: CSV i plik SPSS .sav z etykietami
R
# B293 – dane przykładowe: 12 pozycji skali postaw wobec statystyki (dane symulowane, set.seed(3010))
# 260 osób studiujących; trzy skorelowane czynniki, odpowiedzi 1–5; plik CSV i plik SPSS .sav z etykietami
suppressPackageStartupMessages(library(haven))
set.seed(3010)
n <- 260
Phi <- matrix(c(1, .45, -.30, .45, 1, -.25, -.30, -.25, 1), 3)    # korelacje czynników w populacji
czynnik <- rep(1:3, 4)                         # z1, z4, z7, z10 – lęk na zajęciach; z2, z5, z8, z11 – lęk przed pytaniem o pomoc; z3, z6, z9, z12 – wartość statystyki
L <- matrix(0, 12, 3)
L[cbind(1:12, czynnik)] <- c(.75, .70, .70, .70, .65, .65, .65, .75, .60, .60, .55, .50)
L[11, 1] <- .35                                # z11 ładuje też czynnik lęku na zajęciach
Fk <- MASS::mvrnorm(n, rep(0, 3), Phi)
unik <- sqrt(1 - rowSums((L %*% Phi) * L))
X <- Fk %*% t(L) + sapply(unik, function(s) rnorm(n, 0, s))
dane <- as.data.frame(apply(X, 2, function(x) as.integer(cut(x, c(-Inf, -1.3, -.45, .35, 1.15, Inf)))))
names(dane) <- paste0("z", 1:12)
dane[cbind(c(18, 77, 140, 203), c(5, 9, 2, 12))] <- NA   # 4 osoby pominęły po jednej pozycji
dane <- data.frame(id = 1:n, dane)
write.csv(dane, "../analiza-czynnikowa-spss-dane.csv", row.names = FALSE, na = "")

etykiety <- c("Napięcie przed kolokwium ze statystyki", "Niechęć do pytania prowadzącego o wyjaśnienie",
              "Statystyka przyda mi się w pracy zawodowej", "Pustka w głowie przy zadaniu na zajęciach",
              "Wstyd przed proszeniem kolegów o pomoc", "Statystyka pomaga rozumieć badania",
              "Stres przy liczeniu na czas", "Obawa, że pytanie o pomoc wypadnie głupio",
              "Wyniki analiz są ważne w moim zawodzie", "Nerwowość przy oddawaniu projektu",
              "Unikanie konsultacji z prowadzącym", "Statystyka jest ciekawa")
odp <- c("zdecydowanie się nie zgadzam" = 1, "raczej się nie zgadzam" = 2, "ani tak, ani nie" = 3,
         "raczej się zgadzam" = 4, "zdecydowanie się zgadzam" = 5)
sav <- dane
attr(sav$id, "label") <- "Numer osoby"
for (i in 1:12) sav[[paste0("z", i)]] <- labelled(sav[[paste0("z", i)]], odp, label = etykiety[i])
write_sav(sav, "../analiza-czynnikowa-spss-dane.sav")

c(osoby = nrow(dane), komplet_odpowiedzi = sum(complete.cases(dane)))
round(sapply(dane[, -1], function(x) c(M = mean(x, na.rm = TRUE), SD = sd(x, na.rm = TRUE))), 2)
Wynik:
             osoby komplet_odpowiedzi
               260                256
     z1   z2   z3   z4   z5   z6   z7   z8   z9  z10  z11  z12
M  3.10 3.10 3.08 3.06 3.06 3.15 3.03 3.20 3.03 3.07 3.04 3.03
SD 1.14 1.26 1.20 1.13 1.18 1.14 1.23 1.08 1.21 1.17 1.15 1.14
3. EFA: KMO, analiza równoległa, osie główne, Promax i Oblimin
R
# B293 – EFA jak w procedurze Factor w SPSS: KMO i Bartlett, osie główne (PAF), Promax (kappa 4) i Oblimin (delta 0)
suppressPackageStartupMessages({ library(psych); library(GPArotation) })
dane <- read.csv("../analiza-czynnikowa-spss-dane.csv")
X <- na.omit(dane[, paste0("z", 1:12)])          # Exclude cases listwise (domyślne w SPSS)
R <- cor(X); n <- nrow(X); p <- ncol(X)
n

# Krok 1. KMO and Bartlett's Test (opcja KMO and Bartlett's test of sphericity)
kmo <- KMO(R)
bart <- cortest.bartlett(R, n = n)
round(c(KMO = kmo$MSA, chi2 = bart$chisq, df = bart$df), 3); bart$p.value
round(sort(kmo$MSAi), 3)                         # MSA pozycji – przekątna macierzy Anti-image Correlation

# Krok 2. Wartości własne macierzy korelacji (Initial Eigenvalues) i analiza równoległa (poza SPSS)
ev <- eigen(R)$values
round(cbind(Total = ev, Proc = 100 * ev / p, Skum = cumsum(100 * ev / p)), 3)
sum(ev > 1)                                      # kryterium Kaisera – domyślne „Based on Eigenvalue > 1”
# analiza równoległa Horna: 1000 zbiorów losowych o tym samym n i p, 95. centyl wartości własnych
set.seed(3011)
losowe <- replicate(1000, eigen(cor(matrix(rnorm(n * p), n, p)), only.values = TRUE)$values)
c95 <- apply(losowe, 1, quantile, probs = .95)
round(cbind(empiryczne = ev, losowe_95 = c95)[1:6, ], 3)
which(ev <= c95)[1] - 1                          # liczba czynników według analizy równoległej

# Krok 3. Osie główne jak w SPSS: start od SMC, iteracje do zmiany wspólności < 0.001, najwyżej 25
paf_spss <- function(R, k, iter = 25, eps = 0.001) {
  h2 <- 1 - 1 / diag(solve(R)); h2_0 <- h2
  for (it in 1:iter) {
    Rr <- R; diag(Rr) <- h2
    e <- eigen(Rr, symmetric = TRUE)
    L <- e$vectors[, 1:k] %*% diag(sqrt(e$values[1:k]), k)
    nowe <- rowSums(L^2)
    zmiana <- max(abs(nowe - h2)); h2 <- nowe
    if (zmiana < eps) break
  }
  L <- sweep(L, 2, sign(colSums(L)), "*")        # znak kolumn jest umowny
  dimnames(L) <- list(colnames(R), paste0("F", 1:k))
  list(L = L, h2_0 = h2_0, h2 = h2, iteracje = it, zbiezne = zmiana < eps)
}
paf <- paf_spss(R, 3)
paf$iteracje; paf$zbiezne
round(cbind(Initial = paf$h2_0, Extraction = paf$h2), 3)          # tabela Communalities
ss <- colSums(paf$L^2)
round(cbind(Total = ss, Proc = 100 * ss / p, Skum = cumsum(100 * ss / p)), 3)   # Extraction Sums of Squared Loadings
# kontrola: psych::fa() z metodą osi głównych (inne kryterium zbieżności – mogą być drobne różnice)
fa_psych <- fa(R, nfactors = 3, n.obs = n, fm = "pa", rotate = "none", SMC = TRUE)
round(max(abs(fa_psych$communality - paf$h2)), 4)

# Krok 4. Promax z kappa = 4 (Kaiser normalization: Varimax z normalizacją, potem potęga 4)
pro <- Promax(paf$L, m = 4)
znak <- sign(colSums(unclass(pro$loadings)))    # odwrócenie znaku czynnika nie zmienia rozwiązania
wzor <- sweep(unclass(pro$loadings), 2, znak, "*"); Phi <- pro$Phi * outer(znak, znak)
dimnames(Phi) <- list(colnames(wzor), colnames(wzor))
struktura <- wzor %*% Phi
kolej <- order(apply(abs(wzor), 1, which.max), -apply(abs(wzor), 1, max))  # jak FORMAT=SORT
pokaz <- function(M, blank = .30) { M <- round(M[kolej, ], 3); M[abs(M) < blank] <- NA; M }
pokaz(wzor)                                       # Pattern Matrix z ukryciem |ładunek| < .30
round(struktura[kolej, ], 3)                      # Structure Matrix bez ukrywania
round(Phi, 3)                                     # Factor Correlation Matrix
round(colSums(struktura^2), 3)                    # Rotation Sums of Squared Loadings (Total): sumy kwadratów w kolumnach macierzy struktury

# Krok 5. Direct Oblimin, delta = 0, z normalizacją Kaisera – porównanie
obl <- oblimin(paf$L, gam = 0, normalize = TRUE)
zn2 <- sign(colSums(unclass(obl$loadings)))
wzor_obl <- sweep(unclass(obl$loadings), 2, zn2, "*"); Phi_obl <- obl$Phi * outer(zn2, zn2)
round(wzor_obl[kolej, ], 3)
round(Phi_obl, 3)
round(max(abs(wzor_obl - wzor)), 3)               # największa różnica ładunków Promax – Oblimin
Wynik:
[1] 256
    KMO    chi2      df
  0.761 769.469  66.000
[1] 1.796977e-120
  z12    z6    z9    z3    z8    z1    z4    z5   z10    z7    z2   z11
0.513 0.564 0.675 0.686 0.758 0.764 0.793 0.802 0.817 0.826 0.827 0.840
      Total   Proc    Skum
 [1,] 3.389 28.238  28.238
 [2,] 1.930 16.086  44.324
 [3,] 1.416 11.799  56.123
 [4,] 1.054  8.780  64.903
 [5,] 0.774  6.453  71.356
 [6,] 0.632  5.263  76.619
 [7,] 0.563  4.688  81.307
 [8,] 0.539  4.488  85.795
 [9,] 0.501  4.173  89.968
[10,] 0.453  3.779  93.747
[11,] 0.389  3.238  96.985
[12,] 0.362  3.015 100.000
[1] 4
     empiryczne losowe_95
[1,]      3.389     1.462
[2,]      1.930     1.335
[3,]      1.416     1.246
[4,]      1.054     1.177
[5,]      0.774     1.116
[6,]      0.632     1.055
[1] 3
[1] 10
[1] TRUE
    Initial Extraction
z1    0.453      0.627
z2    0.340      0.447
z3    0.308      0.419
z4    0.368      0.393
z5    0.327      0.447
z6    0.323      0.360
z7    0.375      0.492
z8    0.406      0.534
z9    0.299      0.428
z10   0.260      0.265
z11   0.473      0.568
z12   0.185      0.101
   Total   Proc   Skum
F1 2.870 23.918 23.918
F2 1.347 11.227 35.145
F3 0.865  7.204 42.349
[1] 0.0018
       F1    F2    F3
z1  0.839    NA    NA
z7  0.697    NA    NA
z4  0.591    NA    NA
z10 0.463    NA    NA
z9     NA 0.665    NA
z3     NA 0.643    NA
z6     NA 0.621    NA
z12    NA 0.323    NA
z8     NA    NA 0.757
z5     NA    NA 0.706
z2     NA    NA 0.677
z11 0.374    NA 0.500
        F1     F2     F3
z1   0.785 -0.174  0.331
z7   0.690 -0.328  0.240
z4   0.622 -0.184  0.355
z10  0.504 -0.273  0.230
z9  -0.183  0.651 -0.025
z3  -0.232  0.647 -0.111
z6  -0.134  0.595 -0.023
z12 -0.071  0.308 -0.084
z8   0.277 -0.028  0.726
z5   0.230 -0.050  0.663
z2   0.291 -0.103  0.668
z11  0.609 -0.210  0.673
       F1     F2     F3
F1  1.000 -0.341  0.458
F2 -0.341  1.000 -0.128
F3  0.458 -0.128  1.000
   F1    F2    F3
2.427 1.595 2.233
        F1     F2     F3
z1   0.821  0.117 -0.014
z7   0.697 -0.087 -0.076
z4   0.591  0.035  0.101
z10  0.472 -0.104  0.011
z9  -0.043  0.645  0.071
z3  -0.067  0.625 -0.007
z6   0.004  0.603  0.048
z12  0.036  0.317 -0.062
z8  -0.004  0.035  0.734
z5  -0.041 -0.005  0.682
z2   0.022 -0.038  0.655
z11  0.409 -0.022  0.493
       F1     F2     F3
F1  1.000 -0.275  0.374
F2 -0.275  1.000 -0.085
F3  0.374 -0.085  1.000
[1] 0.067
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek wykonano w pakietach ggplot2 i svglite. Składni SPSS nie uruchamiano. W pracy podaj wersję SPSS lub R, której faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- GPArotation (wersja 2025.3-1): Bernaards, C. A., & Jennrich, R. I. (2005). Gradient projection algorithms and software for arbitrary rotation criteria in factor analysis. Educational and Psychological Measurement, 65(5), 676–696. https://doi.org/10.1177/0013164404272507
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Typowe błędy
- Domyślne ustawienia. Składowe główne z Varimax i regułą wartości własnej większej od 1 to analiza głównych składowych, a nie EFA. Nazwij w pracy metodę, której faktycznie użyłeś.
- Liczba czynników z samej reguły „większa od 1”. W przykładzie dałaby czwarty, pusty czynnik.
- Interpretacja macierzy struktury zamiast wzoru – przy skorelowanych czynnikach prawie każda pozycja „ładuje” kilka czynników.
- Przepisanie sum kwadratów po rotacji skośnej jako procentu wyjaśnionej wariancji.
- Zbyt mało iteracji. Domyślny limit to 25 (IBM Corp., b.d.-g). Jeśli SPSS zgłosi brak zbieżności, zwiększ Maximum Iterations for Convergence w oknie Extraction (IBM Corp., b.d.-c), zamiast przechodzić na składowe główne.
- Wyniki czynnikowe zamiast wyników skali. Opcja Save as variables w oknie Scores zapisuje wyniki czynnikowe metodą regresji, Bartletta albo Andersona–Rubina (IBM Corp., b.d.-e). Są one nieokreślone i przed użyciem w dalszych analizach wymagają oceny (Grice, 2001). W pracy dyplomowej zwykle wystarczy suma albo średnia pozycji podskali – zob. wyniki czynnikowe.
- EFA i CFA na tej samej próbie jako „potwierdzenie” struktury. Jak to zaplanować, pokazuje wpis analiza czynnikowa EFA i CFA.
Tę samą analizę w darmowym programie pokazuje wpis analiza czynnikowa w jamovi. Jeśli nie masz pewności, czy EFA pasuje do Twojego pytania badawczego, skorzystaj z kreatora doboru testu. Inne wpisy z serii: korelacja i regresja w SPSS, ANOVA w SPSS.
Najczęstsze pytania
Gdzie w SPSS jest analiza czynnikowa?
W menu Analyze → Dimension Reduction → Factor. Okno ma przyciski Descriptives, Extraction, Rotation, Scores i Options, a przycisk Paste wkleja składnię FACTOR (IBM Corp., b.d.-a). Procedura należy do modułu Statistics Base. Polska dokumentacja IBM podaje ścieżkę Analizuj → Redukcja wymiarów → Czynnik… (IBM Corp., b.d.-h).
Jak zrobić test KMO i Bartletta w SPSS?
W oknie Factor kliknij Descriptives i zaznacz KMO and Bartlett's test of sphericity (IBM Corp., b.d.-b). Tabela pojawi się na początku wydruku. W składni odpowiada jej słowo KMO w podkomendzie /PRINT. MSA pojedynczych pozycji zobaczysz po zaznaczeniu Anti-image, na przekątnej macierzy korelacji.
Którą metodę ekstrakcji wybrać w SPSS do analizy czynnikowej?
Do eksploracyjnej analizy czynnikowej wybierz Principal axis factoring albo Maximum likelihood. Domyślne Principal components to analiza głównych składowych, która analizuje całą wariancję pozycji, łącznie z błędem pomiaru. Metoda osi głównych nie wymaga normalności i dobrze radzi sobie przy niewielu pozycjach na czynnik (de Winter i Dodou, 2012).
Czym różni się Pattern Matrix od Structure Matrix w SPSS?
Obie tabele pojawiają się po rotacji skośnej (IBM Corp., b.d.-d). Pattern Matrix zawiera unikatowe związki pozycji z czynnikami przy kontroli pozostałych czynników – według niej przypisujesz pozycje. Structure Matrix zawiera zwykłe korelacje pozycji z czynnikami, zawyżone przez korelacje między czynnikami. W przykładzie z tego wpisu pozycje lęku na zajęciach korelują z drugim czynnikiem lęku na .23–.36, choć ich ładunki na nim są poniżej .30.
Jak ustawić kappa w rotacji Promax w SPSS?
W składni wpisz wartość w nawiasie: /ROTATION=PROMAX(4). Domyślna wartość to 4, a dopuszczalna musi być większa od 1 (IBM Corp., b.d.-g). Opis okna Rotation w dokumentacji IBM nie wymienia pola z tą wartością, dlatego najpewniej sprawdzisz ją w składni wklejonej przyciskiem Paste.
Dlaczego SPSS wyodrębnił więcej czynników, niż ma moja skala?
Bo domyślnie zatrzymuje każdy czynnik o wartości własnej większej od 1 (IBM Corp., b.d.-g). Ta reguła często prowadzi do zbyt wielu czynników (O'Connor, 2000). W przykładzie czwarta wartość własna wynosiła 1.05, a analiza równoległa wskazała trzy czynniki. Ustaw w oknie Extraction stałą liczbę czynników uzasadnioną analizą równoległą i projektem skali.
Powiązane hasła
Przeczytaj też
Analiza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →PoradnikPCA czy analiza czynnikowa?
Kiedy redukcja danych, a kiedy model konstruktu: tabela „kiedy która” i porównanie PCA z EFA na tych samych danych w R – ładunki, korelacje i wyniki osób.
Czytaj →PoradnikJak czytać wyniki z SPSS
Osiem najczęstszych tabel SPSS: co odczytać, który wiersz wybrać, co znaczy Sig. = .000 i jak przepisać wynik w stylu APA.
Czytaj →Analiza czynnikowa w SPSS daje inną strukturę niż u autorów skali?
Sprawdzimy ustawienia ekstrakcji i rotacji, liczbę czynników i pozycje problematyczne oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bartlett, M. S. (1950). Tests of significance in factor analysis. British Journal of Statistical Psychology, 3(2), 77–85. https://doi.org/10.1111/j.2044-8317.1950.tb00285.x
- de Winter, J. C. F., & Dodou, D. (2012). Factor recovery by principal axis factoring and maximum likelihood factor analysis as a function of factor pattern and sample size. Journal of Applied Statistics, 39(4), 695–710. https://doi.org/10.1080/02664763.2011.610445
- Fabrigar, L. R., Wegener, D. T., MacCallum, R. C., & Strahan, E. J. (1999). Evaluating the use of exploratory factor analysis in psychological research. Psychological Methods, 4(3), 272–299. https://doi.org/10.1037/1082-989x.4.3.272
- Grice, J. W. (2001). Computing and evaluating factor scores. Psychological Methods, 6(4), 430–450. https://doi.org/10.1037/1082-989x.6.4.430
- Hendrickson, A. E., & White, P. O. (1964). Promax: A quick method for rotation to oblique simple structure. British Journal of Statistical Psychology, 17(1), 65–70. https://doi.org/10.1111/j.2044-8317.1964.tb00244.x
- Horn, J. L. (1965). A rationale and test for the number of factors in factor analysis. Psychometrika, 30(2), 179–185. https://doi.org/10.1007/BF02289447
- IBM Corp. (b.d.-a). Factor Analysis. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=features-factor-analysis ● Otwarty dostęp
- IBM Corp. (b.d.-b). Factor Analysis Descriptives. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=analysis-factor-descriptives ● Otwarty dostęp
- IBM Corp. (b.d.-c). Factor Analysis Extraction. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=analysis-factor-extraction ● Otwarty dostęp
- IBM Corp. (b.d.-d). Factor Analysis Rotation. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=analysis-factor-rotation ● Otwarty dostęp
- IBM Corp. (b.d.-e). Factor Analysis Scores. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=analysis-factor-scores ● Otwarty dostęp
- IBM Corp. (b.d.-f). Factor Analysis Options. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=analysis-factor-options ● Otwarty dostęp
- IBM Corp. (b.d.-g). FACTOR. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=reference-factor ● Otwarty dostęp
- IBM Corp. (b.d.-h). Analiza czynnikowa. Dokumentacja IBM SPSS Statistics 31.0.0. https://www.ibm.com/docs/pl/spss-statistics/31.0.0?topic=features-factor-analysis ● Otwarty dostęp
- Jennrich, R. I., & Sampson, P. F. (1966). Rotation for simple loadings. Psychometrika, 31(3), 313–323. https://doi.org/10.1007/bf02289465
- Kaiser, H. F., & Rice, J. (1974). Little Jiffy, Mark IV. Educational and Psychological Measurement, 34(1), 111–117. https://doi.org/10.1177/001316447403400115
- O'Connor, B. P. (2000). SPSS and SAS programs for determining the number of components using parallel analysis and Velicer's MAP test. Behavior Research Methods, Instruments, & Computers, 32(3), 396–402. https://doi.org/10.3758/bf03200807 ● Otwarty dostęp
- Sass, D. A., & Schmitt, T. A. (2010). A comparative investigation of rotation criteria within exploratory factor analysis. Multivariate Behavioral Research, 45(1), 73–103. https://doi.org/10.1080/00273170903504810
- Watkins, M. W. (2018). Exploratory factor analysis: A guide to best practice. Journal of Black Psychology, 44(3), 219–246. https://doi.org/10.1177/0095798418771807 ● Otwarty dostęp
Cytowania BibTeX
@article{bartlett1950tests, author={Bartlett, M. S.}, title={{Tests of significance in factor analysis}}, journal={British Journal of Statistical Psychology}, year={1950}, volume={3}, number={2}, pages={77--85}, doi={10.1111/j.2044-8317.1950.tb00285.x}}@article{dewinter2012factor, author={de Winter, Joost C. F. and Dodou, Dimitra}, title={{Factor recovery by principal axis factoring and maximum likelihood factor analysis as a function of factor pattern and sample size}}, journal={Journal of Applied Statistics}, year={2012}, volume={39}, number={4}, pages={695--710}, doi={10.1080/02664763.2011.610445}}@article{fabrigar1999evaluating, author={Fabrigar, Leandre R. and Wegener, Duane T. and MacCallum, Robert C. and Strahan, Erin J.}, title={{Evaluating the use of exploratory factor analysis in psychological research}}, journal={Psychological Methods}, year={1999}, volume={4}, number={3}, pages={272--299}, doi={10.1037/1082-989x.4.3.272}}@article{grice2001computing, author={Grice, James W.}, title={{Computing and evaluating factor scores}}, journal={Psychological Methods}, year={2001}, volume={6}, number={4}, pages={430--450}, doi={10.1037/1082-989x.6.4.430}}@article{hendrickson1964promax, author={Hendrickson, Alan E. and White, Paul Owen}, title={{Promax: A quick method for rotation to oblique simple structure}}, journal={British Journal of Statistical Psychology}, year={1964}, volume={17}, number={1}, pages={65--70}, doi={10.1111/j.2044-8317.1964.tb00244.x}}@article{horn1965rationale, author={Horn, John L.}, title={{A rationale and test for the number of factors in factor analysis}}, journal={Psychometrika}, year={1965}, volume={30}, number={2}, pages={179--185}, doi={10.1007/bf02289447}}@misc{ibmndfactoranalysis, author={{IBM Corp.}}, title={{Factor Analysis}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-a}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=features-factor-analysis}}@misc{ibmndfactordescriptives, author={{IBM Corp.}}, title={{Factor Analysis Descriptives}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-b}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=analysis-factor-descriptives}}@misc{ibmndfactorextraction, author={{IBM Corp.}}, title={{Factor Analysis Extraction}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-c}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=analysis-factor-extraction}}@misc{ibmndfactorrotation, author={{IBM Corp.}}, title={{Factor Analysis Rotation}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-d}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=analysis-factor-rotation}}@misc{ibmndfactorscores, author={{IBM Corp.}}, title={{Factor Analysis Scores}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-e}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=analysis-factor-scores}}@misc{ibmndfactoroptions, author={{IBM Corp.}}, title={{Factor Analysis Options}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-f}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=analysis-factor-options}}@misc{ibmndfactorsyntax, author={{IBM Corp.}}, title={{FACTOR}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-g}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=reference-factor}}@misc{ibmndanalizaczynnikowapl, author={{IBM Corp.}}, title={{Analiza czynnikowa}}, howpublished={Dokumentacja IBM SPSS Statistics 31.0.0}, year={b.d.-h}, publisher={IBM}, url={https://www.ibm.com/docs/pl/spss-statistics/31.0.0?topic=features-factor-analysis}}@article{jennrich1966rotation, author={Jennrich, Robert I. and Sampson, P. F.}, title={{Rotation for simple loadings}}, journal={Psychometrika}, year={1966}, volume={31}, number={3}, pages={313--323}, doi={10.1007/bf02289465}}@article{kaiser1974little, author={Kaiser, Henry F. and Rice, John}, title={{Little Jiffy, Mark IV}}, journal={Educational and Psychological Measurement}, year={1974}, volume={34}, number={1}, pages={111--117}, doi={10.1177/001316447403400115}}@article{oconnor2000spss, author={O'Connor, Brian P.}, title={{SPSS and SAS programs for determining the number of components using parallel analysis and Velicer's MAP test}}, journal={Behavior Research Methods, Instruments, \& Computers}, year={2000}, volume={32}, number={3}, pages={396--402}, doi={10.3758/bf03200807}}@article{sass2010comparative, author={Sass, Daniel A. and Schmitt, Thomas A.}, title={{A comparative investigation of rotation criteria within exploratory factor analysis}}, journal={Multivariate Behavioral Research}, year={2010}, volume={45}, number={1}, pages={73--103}, doi={10.1080/00273170903504810}}@article{watkins2018exploratory, author={Watkins, Marley W.}, title={{Exploratory factor analysis: A guide to best practice}}, journal={Journal of Black Psychology}, year={2018}, volume={44}, number={3}, pages={219--246}, doi={10.1177/0095798418771807}}