Co to jest test MAP Velicera?
Test MAP Velicera (ang. minimum average partial, minimum średniej korelacji cząstkowej) to metoda ustalania, ile składowych lub czynników zachować w analizie. Velicer (1976) zaproponował, by po kolei usuwać z macierzy korelacji wpływ pierwszych k składowych głównych i za każdym razem liczyć średni kwadrat pozostałych korelacji cząstkowych. Liczba składowych to ta, przy której średnia osiąga minimum.
Jak działa
Dopóki usuwamy składowe, które opisują wspólną zmienność kilku pozycji, korelacje cząstkowe maleją. Gdy zaczynamy usuwać składowe zbudowane głównie z jednej pozycji, korelacje cząstkowe znów rosną – stąd minimum. Velicer (1976) podkreśla, że metoda daje dokładny punkt zatrzymania i prostą interpretację. Najlepiej pasuje do sytuacji, gdy analiza głównych składowych jest wstępnym etapem analizy czynnikowej lub jej zamiennikiem; różnice obu podejść opisuje wpis PCA czy analiza czynnikowa.
O'Connor (2000) zalicza MAP, obok analizy równoległej, do procedur sprawdzonych i zalecanych. Zauważa też, że badacze wciąż częściej sięgają po prostsze i zawodne kryterium Kaisera (wartość własna > 1). Zwick i Velicer (1986) porównali pięć takich reguł w klasycznej pracy. W R test policzysz funkcją VSS() z pakietu psych.
Przykład
Trzystu badanych odpowiedziało na 12 pozycji, po cztery na każdy z trzech skorelowanych czynników (dane symulowane). Średni kwadrat korelacji cząstkowych wyniósł .0530 po usunięciu jednej składowej, .0420 po dwóch, .0337 po trzech i .0520 po czterech. Minimum przypada na trzy składowe; analiza równoległa również wskazała trzy.
Na rysunku
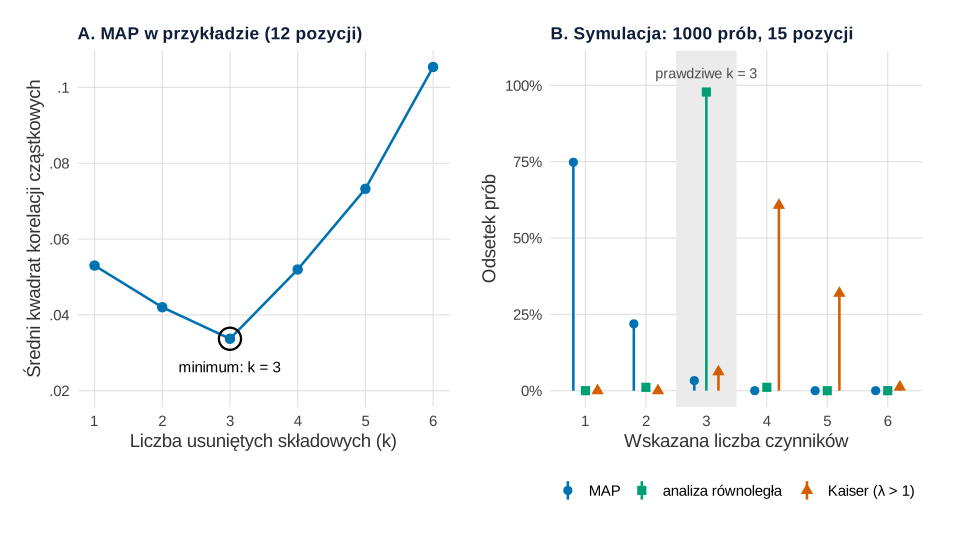
set.seed(3801) i set.seed(3802)).Co widać. Panel A to krzywa z przykładu: średni kwadrat korelacji cząstkowych spada do minimum przy trzech składowych (.0337) i potem rośnie. Własna funkcja w kodzie daje te same wartości co VSS(). Panel B to inny, trudniejszy układ: 15 pozycji, trzy czynniki po pięć pozycji, ładunki tylko .40–.60, 200 osób, 1000 prób. Na wykresie lizakowym widać, że analiza równoległa trafia w trzy czynniki w 97.8% prób. MAP wskazuje jeden czynnik w 74.8% prób, a trzy tylko w 3.3%. Kryterium Kaisera przeszacowuje: cztery czynniki w 60.7% prób, pięć w 31.9%. Błąd Monte Carlo odsetków nie przekracza 1.6 pp.
Na co uważać. To jeden układ parametrów, dobrany ręcznie przed uruchomieniem: słabe ładunki i mało pozycji na czynnik. Przy silnych ładunkach, jak w przykładzie, MAP trafia. Symulacja nie mówi więc, że MAP zawsze zaniża liczbę czynników. Pokazuje jednak, że przy słabych ładunkach kryteria mogą się mocno rozjechać i że warto zestawiać kilka z nich. Analizę równoległą policzono tu w uproszczeniu: średnie wartości własne ze 100 losowych zbiorów, wyliczone raz dla całej symulacji. Jak czytać wykres osypiska i ładunki, pokazuje wpis analiza czynnikowa na wykresie.
Podpis do pracy:
Ziarna set.seed(3801) (dane z przykładu) i set.seed(3802) (symulacja) ustalono raz i nie zmieniano. Rysunek na stronie różni się od wyniku kodu tylko motywem serwisu.
Kod R rysunku 1
# Rysunek 1. Krzywa MAP dla danych z przykładu (A) i liczba czynników wskazana przez MAP,
# analizę równoległą i kryterium Kaisera w 1000 symulowanych próbach (B)
library(ggplot2)
library(patchwork)
suppressPackageStartupMessages(library(psych))

kol <- c(MAP = "#0072B2", PA = "#009E73", Kaiser = "#D55E00")  # Okabe–Ito
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(0.95)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

map <- function(R, kmax = 6) {                    # MAP Velicera: średni kwadrat korelacji cząstkowych
  e <- eigen(R, symmetric = TRUE); p <- ncol(R)
  sapply(1:kmax, function(m) {
    A <- e$vectors[, 1:m, drop = FALSE] %*% diag(sqrt(e$values[1:m]), m)
    C <- R - A %*% t(A); D <- diag(1 / sqrt(diag(C)))
    P <- D %*% C %*% D
    (sum(P^2) - p) / (p * (p - 1))
  })
}

# A: dane z przykładu (te same co wyżej)
set.seed(3801)
L <- matrix(0, 12, 3)
L[1:4, 1] <- c(.75, .70, .65, .60); L[5:8, 2] <- c(.75, .70, .60, .55); L[9:12, 3] <- c(.70, .65, .60, .55)
Phi <- matrix(.30, 3, 3); diag(Phi) <- 1
dane <- sim.structure(fx = L, Phi = Phi, n = 300)$observed
mA <- map(cor(dane))
all.equal(mA, VSS(dane, n = 6, plot = FALSE)$map)  # zgodność z psych::VSS()

# B: 1000 prób – 15 pozycji, 3 czynniki po 5 pozycji, ładunki .40–.60, korelacja czynników .30, n = 200
n <- 200; p <- 15; R <- 1000
Lb <- matrix(0, p, 3); for (j in 1:3) Lb[(5 * j - 4):(5 * j), j] <- c(.60, .55, .50, .45, .40)
Phib <- matrix(.30, 3, 3); diag(Phib) <- 1
set.seed(3802)                                    # ziarno ustalone raz
losowe <- replicate(100, eigen(cor(matrix(rnorm(n * p), n, p)), symmetric = TRUE, only.values = TRUE)$values)
prog_PA <- rowMeans(losowe)                       # analiza równoległa: średnie wartości własne z danych losowych
wsk <- t(replicate(R, {
  X <- matrix(rnorm(n * 3), n, 3) %*% chol(Phib) %*% t(Lb) +
       matrix(rnorm(n * p), n, p) %*% diag(sqrt(1 - rowSums((Lb %*% Phib) * Lb)))
  r <- cor(X); ew <- eigen(r, symmetric = TRUE, only.values = TRUE)$values
  c(MAP = which.min(map(r, 8)), PA = which.min(ew > prog_PA) - 1, Kaiser = sum(ew > 1))
}))
tab <- sapply(as.data.frame(wsk), function(x) table(factor(x, levels = 0:8)) / R)
round(tab[rowSums(tab) > 0, ], 3)                 # odsetek prób wskazujących k czynników
round(colMeans(wsk == 3), 3)                      # odsetek trafień (prawdziwe k = 3)

pA <- ggplot(data.frame(k = 1:6, map = mA), aes(k, map)) +
  geom_line(colour = kol[["MAP"]], linewidth = 0.9) + geom_point(colour = kol[["MAP"]], size = 2.8) +
  annotate("point", x = which.min(mA), y = min(mA), shape = 1, size = 7, stroke = 1.2) +
  annotate("text", x = which.min(mA), y = min(mA) - 0.006, label = "minimum: k = 3", size = 4, vjust = 1) +
  scale_x_continuous(breaks = 1:6) + scale_y_continuous(limits = c(0.02, NA), labels = function(x) sub("^0", "", x)) +
  labs(title = "A. MAP w przykładzie (12 pozycji)", x = "Liczba usuniętych składowych (k)",
       y = "Średni kwadrat korelacji cząstkowych")
tab <- tab[rowSums(tab) > 0, ]                    # tylko liczby czynników wskazane choć raz
dl <- data.frame(k = rep(as.numeric(rownames(tab)), 3), metoda = rep(colnames(tab), each = nrow(tab)),
                 ods = as.vector(tab))
dl$metoda <- factor(dl$metoda, levels = c("MAP", "PA", "Kaiser"))
pB <- ggplot(dl, aes(k, ods, colour = metoda, shape = metoda)) +
  annotate("rect", xmin = 2.5, xmax = 3.5, ymin = -Inf, ymax = Inf, fill = "grey92") +
  annotate("text", x = 3, y = 1.04, label = "prawdziwe k = 3", size = 3.8, colour = "grey30") +
  geom_linerange(aes(ymin = 0, ymax = ods), position = position_dodge(width = 0.6), linewidth = 0.9) +
  geom_point(position = position_dodge(width = 0.6), size = 2.8) +
  scale_x_continuous(breaks = 1:6) +
  scale_y_continuous(limits = c(0, 1.06), labels = function(x) paste0(round(100 * x), "%")) +
  scale_colour_manual(values = kol, labels = c("MAP", "analiza równoległa", "Kaiser (λ > 1)"), name = NULL) +
  scale_shape_manual(values = c(MAP = 16, PA = 15, Kaiser = 17), labels = c("MAP", "analiza równoległa", "Kaiser (λ > 1)"), name = NULL) +
  labs(title = "B. Symulacja: 1000 prób, 15 pozycji", x = "Wskazana liczba czynników", y = "Odsetek prób")
p1 <- (pA | pB) & motyw
p1
Wynik w R
[1] TRUE
    MAP    PA Kaiser
1 0.748 0.000  0.000
2 0.219 0.011  0.000
3 0.033 0.978  0.062
4 0.000 0.011  0.607
5 0.000 0.000  0.319
6 0.000 0.000  0.012
   MAP     PA Kaiser
 0.033  0.978  0.062
Jak opisać w pracy
Na co uważać
- Płaskie minimum. Gdy sąsiednie wartości różnią się dopiero w trzecim miejscu po przecinku, porównaj oba rozwiązania pod kątem interpretacji.
- Jedno kryterium to za mało. Zestaw MAP z analizą równoległą i wykresem osypiska, a decyzję opisz.
- Podaj wersję. Napisz, z jakiego programu i funkcji pochodzi wynik.
Całą procedurę wyboru liczby czynników omawia poradnik Analiza czynnikowa EFA i CFA.
Test MAP w R
Kod symuluje odpowiedzi na 12 pozycji o strukturze trójczynnikowej, wypisuje wartości własne, liczy średni kwadrat korelacji cząstkowych funkcją VSS() i porównuje wynik z analizą równoległą.
MAP Velicera i analiza równoległa dla 12 pozycji
R
suppressPackageStartupMessages(library(psych))
set.seed(3801)
L <- matrix(0, 12, 3)                               # 12 pozycji, 3 czynniki po 4 pozycje
L[1:4, 1] <- c(.75, .70, .65, .60); L[5:8, 2] <- c(.75, .70, .60, .55); L[9:12, 3] <- c(.70, .65, .60, .55)
Phi <- matrix(.30, 3, 3); diag(Phi) <- 1            # czynniki skorelowane .30
dane <- sim.structure(fx = L, Phi = Phi, n = 300)$observed
round(eigen(cor(dane))$values[1:6], 2)              # wartości własne (Kaiser: > 1)
v <- VSS(dane, n = 6, plot = FALSE)                 # MAP: średni kwadrat korelacji cząstkowych
round(data.frame(k = 1:6, MAP = v$map), 4)
which.min(v$map)                                    # liczba składowych wg MAP
fa.parallel(dane, fa = "pc", n.iter = 100, plot = FALSE)   # analiza równoległa dla porównania
Wynik w R
[1] 3.69 1.90 1.67 0.73 0.66 0.60
  k    MAP
1 1 0.0530
2 2 0.0420
3 3 0.0337
4 4 0.0520
5 5 0.0733
6 6 0.1054
[1] 3
Parallel analysis suggests that the number of factors =  NA  and the number of components =  3
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet psych). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://doi.org/10.32614/CRAN.package.psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy test MAP Velicera jest lepszy od analizy równoległej?
Obie metody są zalecane i zwykle stosuje się je razem. Gdy wskazują różne liczby czynników, porównaj oba rozwiązania pod kątem interpretowalności i ładunków, a wybór uzasadnij w pracy.
Jak policzyć test MAP w R?
W pakiecie psych: VSS(dane, n = 8). Wartości średniego kwadratu korelacji cząstkowych są w elemencie $map, a which.min(v$map) zwraca wskazaną liczbę składowych.
Czy test MAP można zastosować do pozycji porządkowych?
Tak, jeśli zamiast macierzy Pearsona podasz macierz korelacji polichorycznych, np. VSS(dane, cor = "poly"). Opisz w pracy, jakiej macierzy użyto.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →PoradnikPCA czy analiza czynnikowa?
Kiedy redukcja danych, a kiedy model konstruktu: tabela „kiedy która” i porównanie PCA z EFA na tych samych danych w R – ładunki, korelacje i wyniki osób.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- O'Connor, B. P. (2000). SPSS and SAS programs for determining the number of components using parallel analysis and Velicer's MAP test. Behavior Research Methods, Instruments, & Computers, 32(3), 396–402. https://doi.org/10.3758/bf03200807 ● Otwarty dostęp
- Velicer, W. F. (1976). Determining the number of components from the matrix of partial correlations. Psychometrika, 41(3), 321–327. https://doi.org/10.1007/bf02293557
- Zwick, W. R., & Velicer, W. F. (1986). Comparison of five rules for determining the number of components to retain. Psychological Bulletin, 99(3), 432–442. https://doi.org/10.1037/0033-2909.99.3.432
Cytowania BibTeX
@article{oconnor2000spss, author={O'Connor, Brian P.}, title={{SPSS and SAS programs for determining the number of components using parallel analysis and Velicer's MAP test}}, journal={Behavior Research Methods, Instruments, \& Computers}, year={2000}, volume={32}, number={3}, pages={396--402}, doi={10.3758/bf03200807}}@article{velicer1976determining, author={Velicer, Wayne F.}, title={{Determining the number of components from the matrix of partial correlations}}, journal={Psychometrika}, year={1976}, volume={41}, number={3}, pages={321--327}, doi={10.1007/bf02293557}}@article{zwick1986comparison, author={Zwick, William R. and Velicer, Wayne F.}, title={{Comparison of five rules for determining the number of components to retain}}, journal={Psychological Bulletin}, year={1986}, volume={99}, number={3}, pages={432--442}, doi={10.1037/0033-2909.99.3.432}}