Co to jest test Brunnera–Munzela?
Test Brunnera–Munzela (ang. Brunner–Munzel test) porównuje dwie grupy niezależne pod względem efektu względnego p = P(X1 < X2) + ½P(X1 = X2), czyli prawdopodobieństwa, że losowy wynik z drugiej grupy przewyższy wynik z pierwszej. Brunner i Munzel (2000) zaprojektowali go dla grup o różnym rozproszeniu i danych z remisami, np. ocen na skali porządkowej.
Jak działa test Brunnera–Munzela
Hipoteza zerowa mówi, że efekt względny wynosi ½. Test korzysta z rang w połączonej próbie i rang wewnątrz każdej grupy; z ich różnic szacuje wariancję osobno dla każdej grupy (σ̂²1, σ̂²2):
W porównuje się z rozkładem t, a stopnie swobody wyznacza się wzorem Satterthwaite'a, jak w teście Welcha. W symulacjach autorów przybliżenie trzymało nominalny poziom istotności od 10 osób w grupie, a test Wilcoxona–Manna–Whitneya bywał konserwatywny albo liberalny.
Przykład
Pacjenci ocenili poprawę na skali 1–7: 20 osób po leczeniu standardowym i 30 po nowej terapii (dane symulowane). Mediany: 5 i 6, odchylenia standardowe: 1.27 i 1.96. Efekt względny p̂ = .723, 95% CI [.574, .873]: w 72% par pacjent nowej terapii ocenił poprawę wyżej, licząc remisy po połowie. Test dał W(35.36) = 3.03, p = .005.
Na rysunku
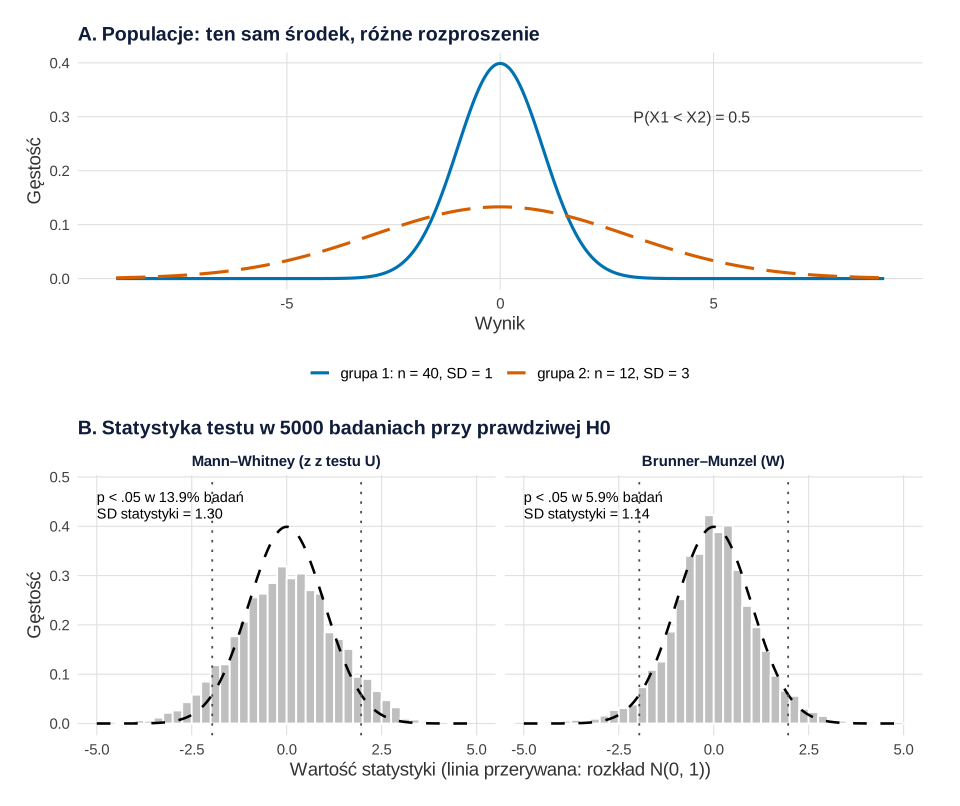
set.seed(3833)).Co widać. Obie populacje mają rozkład normalny ze środkiem w zerze, więc losowy wynik z grupy 2 przewyższa wynik z grupy 1 dokładnie w połowie par. Hipoteza zerowa testu Brunnera–Munzela jest prawdziwa. Grupa 2 jest jednak mniejsza (12 wobec 40 osób) i ma trzy razy większe SD. W panelu B histogram statystyki z z testu U jest wyraźnie szerszy niż krzywa N(0, 1): jej SD wynosi 1.30 zamiast 1. Wartości poza ±1.96, czyli p < .05, wypadły w 13.9% badań (błąd Monte Carlo 0.5 pp), a nie w 5%. Test U liczy błąd standardowy tak, jakby oba rozkłady były jednakowe. Statystyka W Brunnera–Munzela szacuje wariancję osobno w każdej grupie. Jej histogram prawie pokrywa się z krzywą, a p < .05 wypadło w 5.9% badań (błąd MC 0.3 pp).
Na co uważać. Przy 12 osobach w mniejszej grupie test Brunnera–Munzela jest jeszcze lekko liberalny. W porównuje się z rozkładem t o małej liczbie stopni swobody, więc jego granice istotności leżą nieco dalej niż ±1.96. Rysunek pokazuje jeden układ. Gdy większe SD ma większa grupa, test U staje się zbyt zachowawczy. Symulację z pięcioma testami i kilkoma scenariuszami pokazuje wpis Testy odporne dla dwóch grup. To, co test U „widzi” przy równych medianach, opisuje wpis test Manna–Whitneya w obrazkach. Parametry populacji (n = 40 i 12, SD = 1 i 3) ustawiono ręcznie, by różnica rozproszenia była wyraźna; ziarna nie zmieniano.
Podpis do pracy:
Kod rysunku liczy test Brunnera–Munzela tym samym wzorem co przykład poniżej. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Prawdziwa H0 (P(X1 < X2) = 0.5), różne rozproszenie: statystyki testu U i Brunnera–Munzela
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
kol <- c("grupa 1: n = 40, SD = 1" = "#0072B2", "grupa 2: n = 12, SD = 3" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# Statystyka Brunnera–Munzela (wzór z hasła) i statystyka z testu U (przybliżenie normalne, bez remisów)
bm <- function(a, b) {
  n1 <- length(a); n2 <- length(b); N <- n1 + n2
  r <- rank(c(a, b)); m1 <- mean(r[1:n1]); m2 <- mean(r[n1 + 1:n2])
  v1 <- sum((r[1:n1] - rank(a) - m1 + (n1 + 1) / 2)^2) / (n1 - 1)
  v2 <- sum((r[n1 + 1:n2] - rank(b) - m2 + (n2 + 1) / 2)^2) / (n2 - 1)
  W <- n1 * n2 * (m2 - m1) / (N * sqrt(n1 * v1 + n2 * v2))
  df <- (n1 * v1 + n2 * v2)^2 / ((n1 * v1)^2 / (n1 - 1) + (n2 * v2)^2 / (n2 - 1))
  c(stat = W, p = 2 * pt(-abs(W), df))
}
mw <- function(a, b) {
  n1 <- length(a); n2 <- length(b)
  U <- sum(rank(c(a, b))[n1 + 1:n2]) - n2 * (n2 + 1) / 2   # pary, w których b > a
  z <- (U - n1 * n2 / 2) / sqrt(n1 * n2 * (n1 + n2 + 1) / 12)
  c(stat = z, p = 2 * pnorm(-abs(z)))
}

# Symulacja: obie populacje normalne wokół 0, więc P(X1 < X2) = 0.5 (H0 testu B–M jest prawdziwa);
# mniejsza grupa ma trzy razy większe SD (parametry ustawione ręcznie)
set.seed(3833)
R <- 5000
wyn <- t(replicate(R, { a <- rnorm(40, 0, 1); b <- rnorm(12, 0, 3); c(mw(a, b), bm(a, b)) }))
colnames(wyn) <- c("z_U", "p_U", "W_BM", "p_BM")
odrz <- colMeans(wyn[, c("p_U", "p_BM")] < .05)
round(rbind(odsetek_p_mniej_05 = odrz, blad_MC = sqrt(odrz * (1 - odrz) / R),
            SD_statystyki = apply(wyn[, c("z_U", "W_BM")], 2, sd)), 4)

# Panel A: dwie populacje o tym samym środku i różnym rozproszeniu
x <- seq(-9, 9, by = 0.05)
gest <- rbind(data.frame(x, g = dnorm(x, 0, 1), grupa = names(kol)[1]),
              data.frame(x, g = dnorm(x, 0, 3), grupa = names(kol)[2]))
pA <- ggplot(gest, aes(x, g, colour = grupa, linetype = grupa)) +
  geom_line(linewidth = 1.1) +
  annotate("text", x = 4.5, y = 0.3, label = "P(X1 < X2) = 0.5", size = 4.2, colour = "grey20") +
  scale_colour_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = c("solid", "longdash"), name = NULL) +
  labs(title = "A. Populacje: ten sam środek, różne rozproszenie", x = "Wynik", y = "Gęstość") +
  motyw + theme(legend.position = "top")

# Panel B: rozkład obu statystyk z 5000 badań na tle N(0, 1); poza liniami kropkowanymi – p < .05
st <- rbind(data.frame(test = "Mann–Whitney (z z testu U)", s = wyn[, "z_U"]),
            data.frame(test = "Brunner–Munzel (W)", s = wyn[, "W_BM"]))
st$test <- factor(st$test, levels = unique(st$test))
etyk <- data.frame(test = factor(levels(st$test), levels = levels(st$test)),
                   et = sprintf("p < .05 w %.1f%% badań\nSD statystyki = %.2f", 100 * odrz,
                                apply(wyn[, c("z_U", "W_BM")], 2, sd)))
krzywa <- data.frame(s = seq(-5, 5, by = 0.05)); krzywa$g <- dnorm(krzywa$s)
pB <- ggplot(st, aes(s)) +
  geom_histogram(aes(y = after_stat(density)), binwidth = 0.25, boundary = 0, fill = "grey75", colour = "white") +
  geom_line(data = krzywa, aes(s, g), linewidth = 0.9, linetype = "dashed") +
  geom_vline(xintercept = c(-1.96, 1.96), linetype = "dotted", colour = "grey30") +
  geom_text(data = etyk, aes(x = -5, y = 0.47, label = et), hjust = 0, vjust = 1, size = 3.8, lineheight = 0.95) +
  facet_wrap(~ test, ncol = 2) +
  coord_cartesian(xlim = c(-5, 5), ylim = c(0, 0.48)) +
  labs(title = "B. Statystyka testu w 5000 badaniach przy prawdziwej H0",
       x = "Wartość statystyki (linia przerywana: rozkład N(0, 1))", y = "Gęstość") +
  motyw

p <- pA / pB + plot_layout(heights = c(1, 1.1))
p
Wynik w R
                      p_U   p_BM
odsetek_p_mniej_05 0.1386 0.0586
blad_MC            0.0049 0.0033
SD_statystyki      1.3019 1.1436
Jak opisać w pracy
Na co uważać
- To nie test median. Divine i współautorzy (2018) pokazują, że także test U Manna–Whitneya odpowiada na pytanie o P(X1 < X2) + ½P(X1 = X2), a nie o mediany. Brunner–Munzel testuje tę samą wielkość bez założenia jednakowych rozkładów.
- Kierunek. p̂ > .5 oznacza przewagę grupy drugiej. Ta sama liczba to miara A Varghi–Delaneya liczona od drugiej grupy, a delta Cliffa wynosi 2p̂ − 1 (tu .446).
Porównanie z testem Yuena pokazuje wpis Testy odporne dla dwóch grup.
Test Brunnera–Munzela w R
Pakiety z gotową funkcją nie są potrzebne: kod liczy test ze wzoru na rangach, z efektem względnym, przedziałem ufności i stopniami swobody Satterthwaite'a, a dla porównania – test U Manna–Whitneya.
Test Brunnera–Munzela ze wzoru
R
set.seed(3832)
a <- sample(1:7, 20, replace = TRUE, prob = c(.02, .05, .13, .30, .30, .15, .05))  # standard: skupione oceny
b <- sample(1:7, 30, replace = TRUE, prob = c(.12, .10, .08, .10, .15, .20, .25))  # nowa terapia: duży rozrzut
n1 <- length(a); n2 <- length(b); N <- n1 + n2
r  <- rank(c(a, b))                                # rangi w połączonej próbie
r1 <- rank(a); r2 <- rank(b)                       # rangi wewnątrz grup
m1 <- mean(r[1:n1]); m2 <- mean(r[n1 + 1:n2])
p_hat <- (m2 - (n2 + 1) / 2) / n1                  # P(A < B) + 0.5 · P(A = B)
v1 <- sum((r[1:n1] - r1 - m1 + (n1 + 1) / 2)^2) / (n1 - 1)
v2 <- sum((r[n1 + 1:n2] - r2 - m2 + (n2 + 1) / 2)^2) / (n2 - 1)
W  <- n1 * n2 * (m2 - m1) / (N * sqrt(n1 * v1 + n2 * v2))           # statystyka Brunnera–Munzela
df <- (n1 * v1 + n2 * v2)^2 / ((n1 * v1)^2 / (n1 - 1) + (n2 * v2)^2 / (n2 - 1))  # df Satterthwaite'a
p  <- 2 * pt(-abs(W), df)
se <- sqrt(v1 / (n1 * n2^2) + v2 / (n2 * n1^2))
round(c(Me_a = median(a), Me_b = median(b), sd_a = sd(a), sd_b = sd(b)), 2)
round(c(p_hat = p_hat, W = W, df = df, p = p,
        ci_dolna = p_hat - qt(.975, df) * se, ci_gorna = p_hat + qt(.975, df) * se), 3)
wilcox.test(a, b, exact = FALSE)                   # dla porównania: test U Manna–Whitneya
Wynik w R
Me_a Me_b sd_a sd_b
5.00 6.00 1.27 1.96
   p_hat        W       df        p ci_dolna ci_gorna
   0.723    3.030   35.362    0.005    0.574    0.873

	Wilcoxon rank sum test with continuity correction

data:  a and b
W = 166, p-value = 0.007074
alternative hypothesis: true location shift is not equal to 0
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (test liczony ze wzoru, bez dodatkowych pakietów). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym test Brunnera–Munzela różni się od testu U Manna–Whitneya?
Oba dotyczą tej samej wielkości: prawdopodobieństwa przewagi jednej grupy. Test U wylicza błąd standardowy przy założeniu, że rozkłady są jednakowe, więc przy różnym rozproszeniu i nierównych grupach jego poziom istotności się rozjeżdża. Brunner–Munzel szacuje wariancję osobno w każdej grupie.
Czy test Brunnera–Munzela porównuje mediany?
Nie. Testuje efekt względny p, czyli to, czy losowy wynik z jednej grupy częściej przewyższa wynik z drugiej. Mediany grup mogą być równe przy p różnym od 0.5 i odwrotnie.
Jak policzyć test Brunnera–Munzela w R?
Funkcje są w pakietach brunnermunzel i lawstat. Bez nich test łatwo policzyć ze wzoru: rangi w połączonej próbie i wewnątrz grup, statystyka W i df Satterthwaite'a – kod poniżej.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Testy odporne: Welch, Yuen, Brunner–Munzel
Co porównuje każdy test, miary efektu z CI, Brunner–Munzel liczony ręcznie w R i symulacja błędu I rodzaju przy nierównych grupach – ze wzorem opisu APA.
Czytaj →PoradnikTesty nieparametryczne krok po kroku
Kiedy test rangowy ma sens, Mann–Whitney, Wilcoxon, Kruskal–Wallis z testem Dunna i Friedman na jednym badaniu – z wielkością efektu i opisem APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Brunner, E., & Munzel, U. (2000). The nonparametric Behrens-Fisher problem: Asymptotic theory and a small-sample approximation. Biometrical Journal, 42(1), 17–25. https://doi.org/10.1002/(sici)1521-4036(200001)42:1<17::aid-bimj17>3.0.co;2-u
- Divine, G. W., Norton, H. J., Barón, A. E., & Juarez-Colunga, E. (2018). The Wilcoxon–Mann–Whitney procedure fails as a test of medians. The American Statistician, 72(3), 278–286. https://doi.org/10.1080/00031305.2017.1305291 ● Otwarty dostęp
Cytowania BibTeX
@article{brunner2000nonparametric, author={Brunner, Edgar and Munzel, Ullrich}, title={{The nonparametric Behrens-Fisher problem: Asymptotic theory and a small-sample approximation}}, journal={Biometrical Journal}, year={2000}, volume={42}, number={1}, pages={17--25}, doi={10.1002/(sici)1521-4036(200001)42:1<17::aid-bimj17>3.0.co;2-u}}@article{divine2018wilcoxon, author={Divine, George W. and Norton, H. James and Barón, Anna E. and Juarez-Colunga, Elizabeth}, title={{The Wilcoxon–Mann–Whitney procedure fails as a test of medians}}, journal={The American Statistician}, year={2018}, volume={72}, number={3}, pages={278--286}, doi={10.1080/00031305.2017.1305291}}