Trzy testy, trzy pytania
Porównujesz dwie niezależne grupy, a dane nie wyglądają podręcznikowo: jedna grupa jest mała i ma duży rozrzut, w drugiej jest kilka bardzo wysokich wyników. Test t Studenta i odruchowo wybierany test Manna–Whitneya mogą wtedy zawieść. Ten wpis pokazuje trzy testy, które w takiej sytuacji trzymają poziom istotności, i wyjaśnia, o co każdy z nich pyta.
| Test | Co porównuje | Hipoteza zerowa | Miara efektu |
|---|---|---|---|
| test t Welcha | średnie | średnie w populacjach są równe | różnica średnich z 95% CI, g Hedgesa |
| test Yuena | średnie ucinane 20% | średnie ucinane są równe | różnica średnich ucinanych z CI, miara wyjaśniająca ξ |
| test Brunnera–Munzela | prawdopodobieństwo przewagi | P(X < Y) + ½P(X = Y) = .5 | p̂ z CI, czyli A Varghi–Delaneya; delta Cliffa |
| test Manna–Whitneya | rozkłady przez rangi | oba rozkłady są identyczne | p̂ albo korelacja rangowo-biseryjna |
Wszystkie trzy testy odporne mają wspólną cechę: każda grupa wnosi do błędu standardowego własną zmienność, a stopnie swobody są korygowane wzorem Welcha–Satterthwaite’a (Welch, 1947). Różnią się tym, co porównują. Wybierz test, którego parametr odpowiada Twojemu pytaniu badawczemu, i zapisz go w planie analizy przed zebraniem danych.
Wpis rozwija dwa wcześniejsze teksty. Kiedy test t wystarcza przy skośnych danych, opisuje wpis test t przy rozkładzie innym niż normalny. Miary efektu po testach rangowych omawia wpis wielkość efektu dla testów nieparametrycznych. Tutaj skupiamy się na nierównych wariancjach i liczebnościach oraz na teście Brunnera–Munzela.
Przykład: powiadomienia a czas rozwiązania łamigłówki
W eksperymencie (dane symulowane) 60 osób rozwiązywało łamigłówkę logiczną. 42 osoby pracowały z wyciszonym telefonem, a 18 dostawało w trakcie zadania powiadomienia. Wynik to czas rozwiązania w sekundach. Grupy mają nierówne liczebności. Dane są w pliku CSV.
Bez powiadomień: M = 63.76 s, SD = 11.46, Me = 60.50, średnia ucinana 20% = 61.92. Z powiadomieniami: M = 80.06 s, SD = 26.16, Me = 70.50, średnia ucinana 20% = 74.58. Mniejsza grupa ma ponad dwa razy większe odchylenie standardowe i dwa bardzo długie czasy, 124 i 153 s (rysunek 1). To dokładnie sytuacja, w której wybór testu ma znaczenie.
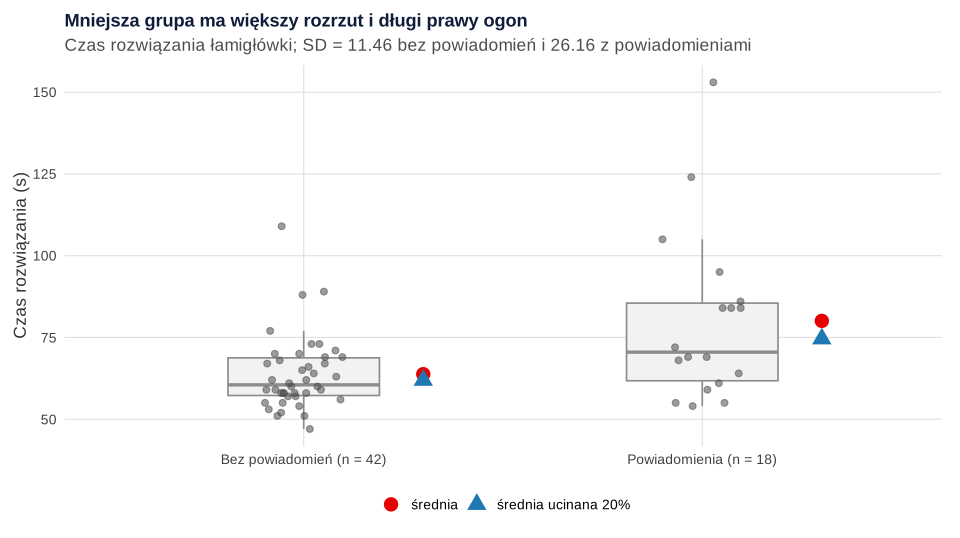
Zawsze zacznij od wykresu. Wykres pudełkowy z punktami pokazuje od razu różnicę rozproszenia, długość ogona i obserwacje odstające. Nie usuwaj długich czasów tylko dlatego, że odstają. Jeśli to prawdziwe pomiary, lepiej wybrać metodę, która ogranicza ich wpływ. Szerzej pisze o tym wpis czy można usunąć obserwacje odstające.
Test t Welcha jako punkt wyjścia
Jeśli pytasz o różnicę średnich, domyślnym wyborem jest test Welcha, a nie test Studenta. Delacre i in. (2017) argumentują, że założenie równych wariancji rzadko jest spełnione, a test Welcha niewiele traci, gdy wariancje są równe. Nie wybieraj go też na podstawie testu Levene’a. Zimmerman (2004) pokazał, że procedura dwuetapowa, czyli najpierw test równości wariancji, a potem wybór testu t, nie chroni poziomu istotności. Wzory i ręczne obliczenia znajdziesz w haśle test Welcha.
W przykładzie różnica średnich wynosi 16.29 s, 95% CI [2.91, 29.68], t(19.86) = 2.54, p = .020. Test Studenta na tych samych danych daje t(58) = 3.38, p = .001. To nie jest lepsza moc. Test Studenta łączy wariancje obu grup, więc wspólna wariancja jest zdominowana przez dużą grupę o małym rozrzucie. Gdy to mniejsza grupa ma większy rozrzut, błąd standardowy różnicy wychodzi za mały, a p za małe.
Test Welcha ma jednak słabość: porównuje średnie, a średnią mocno przesuwają pojedyncze skrajne wyniki. Dwa czasy 124 i 153 s podnoszą średnią grupy z powiadomieniami i zwiększają jej SD. Jeśli interesuje Cię „typowy” czas, a nie średnia razem z ogonem, sięgnij po test Yuena.
Test Yuena: średnie ucinane
Yuen (1974) zaproponował dwupróbkową statystykę t dla średnich ucinanych przy nierównych wariancjach. W abstrakcie zalecała ją zwłaszcza wtedy, gdy rozkłady mają długie ogony albo obserwacje odstające. Z każdej grupy odrzucasz po 20% najmniejszych i największych wyników i porównujesz średnie z tego, co zostało. Błąd standardowy liczysz jednak z danych winsoryzowanych, a nie z obciętych. Dlaczego to ważne i jak policzyć średnią ucinaną i winsoryzację krok po kroku, opisuje osobne hasło. Stopnie swobody wynikają z liczby wyników, które zostały po ucięciu, więc przy 18 osobach są wyraźnie mniejsze niż w teście Welcha.
W R test Yuena liczy funkcja yuen() z pakietu WRS2. Pakiet ten zawiera odporne wersje testów t, ANOVA, ANCOVA i mediacji i jest opisany jako samouczek dla badaczy z nauk społecznych (Mair i Wilcox, 2020). W przykładzie różnica średnich ucinanych wynosi 12.66 s, 95% CI [1.21, 24.11], ty(12.69) = 2.39, p = .033. Różnica jest mniejsza niż różnica średnich, bo ucięcie ograniczyło wpływ dwóch najdłuższych czasów.
Jako wielkość efektu WRS2 podaje miarę wyjaśniającą ξ (explanatory measure of effect size). Przyjmuje wartości od 0 do 1. Tutaj ξ = 0.53, a bootstrapowy 95% CI to [0.27, 0.79]. Przy przedziale z bootstrapu podaj liczbę powtórzeń i ustal ziarno losowania.
Test Brunnera–Munzela: prawdopodobieństwo przewagi
Trzeci test nie pyta o średnie. Pyta, jak często losowa osoba z jednej grupy ma wynik wyższy niż losowa osoba z drugiej. Tę wielkość nazywa się prawdopodobieństwem przewagi albo efektem względnym:
p = P(X < Y) + ½ P(X = Y)
Remisy liczą się po połowie, więc test działa także dla skal z wieloma wiązaniami, np. sum punktów z kwestionariusza. Brunner i Munzel (2000) rozwiązali dla tej wielkości nieparametryczny odpowiednik problemu Behrensa–Fishera, czyli porównanie grup bez założenia równego rozproszenia. Wariancję oszacowania liczą z dwóch rodzajów rang: w połączonej próbie i wewnątrz każdej grupy. Dla małych prób, od 10 osób w grupie, zaproponowali przybliżenie rozkładem t ze stopniami swobody Satterthwaite’a. Podali też przedział ufności dla p.
Testu nie ma w bazowym R, ale obliczenie to kilka linijek (kod niżej):
- Nadaj rangi wszystkim 60 wynikom razem, a potem osobno w każdej grupie.
- Policz p̂ ze średniej rangi drugiej grupy: p̂ = (R̄2 − (n2 + 1)/2) / n1.
- Dla każdej osoby odejmij rangę wewnątrz grupy od rangi w całej próbie. Wariancja tych różnic w każdej grupie daje błąd standardowy p̂.
- Statystyka to t = (p̂ − .5) / SE, a stopnie swobody liczysz wzorem Satterthwaite’a z obu wariancji.
W przykładzie p̂ = .71, 95% CI [.55, .87], tBM(24.74) = 2.64, p = .014. Losowo wybrana osoba z powiadomieniami rozwiązywała łamigłówkę dłużej niż losowo wybrana osoba bez powiadomień z prawdopodobieństwem .71. To ta sama liczba, którą daje bezpośrednie porównanie wszystkich 42 × 18 = 756 par. W literaturze o wielkości efektu nazywa się ją miarą A Varghi–Delaneya. Vargha i Delaney (2000) opisali ją jako miarę przewagi stochastycznej dla dowolnej zmiennej co najmniej porządkowej. Po przeliczeniu 2p̂ − 1 otrzymujesz deltę Cliffa: δ = .42, 95% CI [.09, .75].
Karch (2021) zaleca test Brunnera–Munzela jako domyślną procedurę nieparametryczną w psychologii. Argumentuje, że dobrze kontroluje błąd I rodzaju, gdy grupy różnią się rozproszeniem, a moc ma podobną do testu Manna–Whitneya.
Kiedy Mann–Whitney odpowiada na inne pytanie
Test Manna–Whitneya liczy z danych dokładnie to samo p̂. W przykładzie W = 536.5, a 536.5 / 756 = .71. Różnica tkwi w hipotezie zerowej. Klasyczny test zakłada, że przy prawdziwej H0 oba rozkłady są identyczne: mają ten sam kształt i to samo rozproszenie. Karch (2021) nazywa to założeniem wymienialności (exchangeability). Gdy grupy różnią się rozproszeniem, test Manna–Whitneya może odrzucać H0 nawet przy p = .5, czyli bez żadnej przewagi którejkolwiek grupy. Brunner i Munzel (2000) pokazali w symulacji, że bywa wtedy zachowawczy albo liberalny, zależnie od stosunku liczebności i wariancji. Fagerland i Sandvik (2009) dodali, że już niewielkie różnice wariancji i umiarkowana skośność wyraźnie zmieniają rzeczywisty poziom istotności.
Wynik Manna–Whitneya da się więc czytać na kilka sposobów, zależnie od przyjętych założeń (Fay i Proschan, 2010). Jeśli rozkłady różnią się tylko położeniem, test mówi o przesunięciu. Jeśli różnią się kształtem lub rozproszeniem, mówi tylko tyle, że rozkłady nie są identyczne. Test Brunnera–Munzela odpowiada wprost na pytanie o przewagę jednej grupy, bez założenia o kształcie. Co test Manna–Whitneya testuje w typowej sytuacji i jak go zapisać, wyjaśnia hasło test U Manna–Whitneya.
Symulacja: błąd I rodzaju przy nierównych wariancjach i n
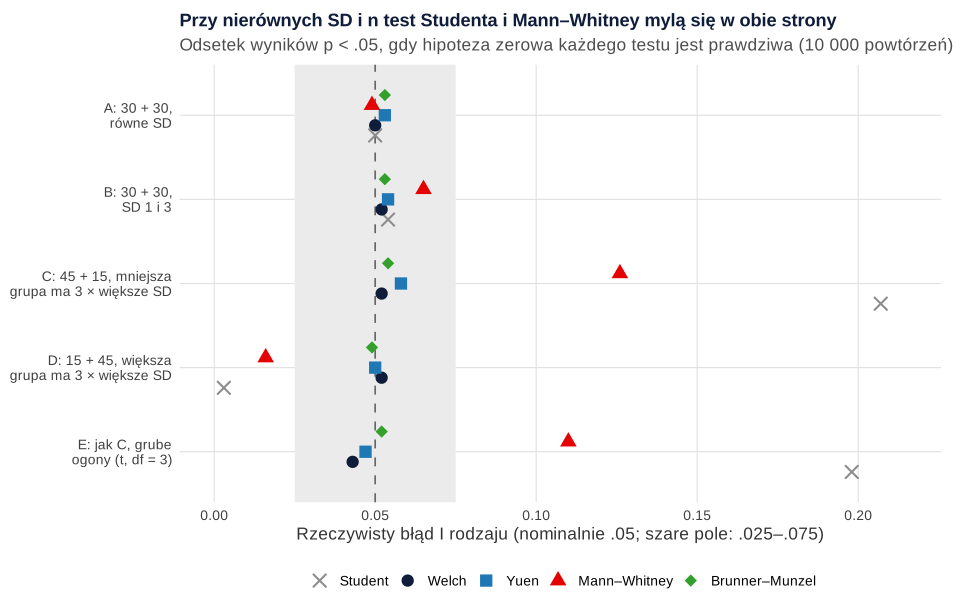
Żeby porównać pięć testów uczciwie, potrzebujemy sytuacji, w której hipoteza zerowa każdego z nich jest prawdziwa. Wystarczą dwa rozkłady symetryczne wokół tej samej wartości. Wtedy równe są średnie, średnie ucinane i mediany, a p = .5. Grupy mogą się jednak różnić rozproszeniem. Każdy z pięciu scenariuszy powtórzyliśmy 10 000 razy i policzyliśmy odsetek wyników p < .05, czyli rzeczywisty błąd I rodzaju (rysunek 2).
Wyniki są jednoznaczne:
- Równe grupy i równe SD (A): wszystkie testy trzymają poziom, od .049 do .053.
- Równe grupy, trzykrotnie różne SD (B): test Studenta jeszcze sobie radzi (.054), ale test Manna–Whitneya ma już .065.
- Mniejsza grupa ma większe SD (C, 45 i 15 osób): test Studenta daje .207, czyli cztery razy więcej fałszywych alarmów, niż obiecuje α, a Mann–Whitney .126. Welch, Yuen i Brunner–Munzel: .052, .058 i .054.
- Większa grupa ma większe SD (D): błąd przechodzi w drugą stronę. Test Studenta ma .003, a Mann–Whitney .016, więc oba są zbyt zachowawcze i tracą moc.
- Grube ogony (E): obraz jak w C. Student .198, Mann–Whitney .110, a trzy testy odporne od .043 do .052.
Wniosek dla pracy: przy nierównych grupach test Studenta i test Manna–Whitneya mogą mylić się w obie strony, zależnie od tego, która grupa ma większy rozrzut. Trzy testy z tego wpisu trzymają poziom we wszystkich scenariuszach. Ograniczenie symulacji: rozkłady były symetryczne. Przy skośnych rozkładach o różnym kształcie średnia, średnia ucinana i p przestają być tym samym parametrem, a testy przestają testować tę samą hipotezę.
Jak wybrać test do swojej pracy
| Sytuacja | Test główny | Analiza wrażliwości |
|---|---|---|
| Pytanie o średnią (koszt, łączny czas, suma punktów), kilkadziesiąt osób w grupie | Welch | bootstrapowy CI dla różnicy średnich |
| Pytanie o typowy wynik, długie ogony albo kilka skrajnych wyników | Yuen (20%) | Welch na pełnych danych |
| Pytanie „czy wyniki w jednej grupie są zwykle wyższe”, skala porządkowa albo dużo remisów | Brunner–Munzel | Mann–Whitney, jeśli rozproszenie jest podobne |
| Nierówne grupy i wyraźnie różne rozproszenie | Welch, Yuen albo Brunner–Munzel zależnie od pytania | nie test Studenta ani nie sam Mann–Whitney |
Wybierz jeden test główny przed analizą i zapisz go w planie. Pozostałe podaj jako analizę wrażliwości, a nie jako alternatywę do wyboru po fakcie. Jeśli się różnią, opisz to i wyjaśnij, czym różnią się porównywane parametry. Gdy nie wiesz, od czego zacząć, pomoże kreator doboru testu statystycznego, a pełne omówienie testu t znajdziesz w poradniku test t Studenta krok po kroku.
Jak opisać wynik w pracy
Napisz, który test był główny i dlaczego, podaj miarę efektu z przedziałem ufności i krótko wynik analizy wrażliwości. Poniższy akapit zakłada, że w planie analizy głównym testem był test Brunnera–Munzela.
Opis dla innych testów przygotuje generator opisu wyników w stylu APA. Przy teście Brunnera–Munzela zawsze zaznacz, której grupy przewagę oznacza p̂. Wartość .71 dla jednej grupy to .29 dla drugiej.
Testy odporne w R: WRS2 i Brunner–Munzel ręcznie
Przepis 1 liczy wszystkie wyniki z przykładu. Test Yuena i jego miarę efektu daje pakiet WRS2 (funkcje yuen() i yuen.effect.ci()). Test Brunnera–Munzela jest zapisany jako krótka funkcja w bazowym R, a jej p̂ sprawdzamy na wszystkich parach osób. Przepis 2 to symulacja z rysunku 2; test Yuena jest w niej zapisany ręcznie, żeby pętla działała szybciej, i daje te same wartości p co yuen().
1. Welch, Yuen, Brunner–Munzel i Mann–Whitney na jednych danych
R
# B242 – testy odporne dla dwóch grup: Welch, Yuen, Brunner–Munzel i Mann–Whitney na jednych danych
# Dane symulowane, set.seed(2423): czas rozwiązania łamigłówki (sekundy) w grupie bez powiadomień
# z telefonu (n = 42) i w grupie, która w trakcie zadania dostawała powiadomienia (n = 18).
suppressPackageStartupMessages(library(WRS2))
set.seed(2423)
bez <- round(45 + rgamma(42, shape = 4, scale = 5))
pow <- round(50 + rgamma(18, shape = 2, scale = 14))
dane <- data.frame(czas = c(bez, pow),
                   grupa = factor(rep(c("bez powiadomień", "powiadomienia"), c(42, 18)),
                                  levels = c("bez powiadomień", "powiadomienia")))
write.csv(dane, "../testy-odporne-dane-przyklad.csv", row.names = FALSE, fileEncoding = "UTF-8")

# Krok 1. Opis grup: n, M, SD, Me, średnia ucinana 20%
opis <- function(x) c(n = length(x), M = mean(x), SD = sd(x), Me = median(x), Mt20 = mean(x, trim = 0.2),
                      min = min(x), max = max(x))
round(sapply(split(dane$czas, dane$grupa), opis), 2)

# Krok 2. Test t Welcha (domyślny w R) i – dla porównania – test t Studenta
welch <- t.test(pow, bez)
round(c(roznica = unname(diff(rev(welch$estimate))), t = unname(welch$statistic), df = unname(welch$parameter),
        p = welch$p.value, CI = welch$conf.int), 3)
student <- t.test(pow, bez, var.equal = TRUE)
round(c(t = unname(student$statistic), df = unname(student$parameter), p = student$p.value), 3)

# Krok 3. Test Yuena (średnie ucinane 20%) i jego miara efektu z bootstrapowym CI
yuen(czas ~ grupa, data = dane, tr = 0.2)
set.seed(2424)
yuen.effect.ci(czas ~ grupa, data = dane, tr = 0.2, nboot = 2000)

# Krok 4. Test Brunnera–Munzela ręcznie: rangi w całej próbie i wewnątrz grup, df Satterthwaite'a
brunner_munzel <- function(x, y) {
  n1 <- length(x); n2 <- length(y); N <- n1 + n2
  r <- rank(c(x, y)); r1 <- r[1:n1]; r2 <- r[(n1 + 1):N]          # rangi w połączonej próbie
  v1 <- sum((r1 - rank(x) - mean(r1) + (n1 + 1) / 2)^2) / (n1 - 1)  # wariancja „rang przewagi” w grupie 1
  v2 <- sum((r2 - rank(y) - mean(r2) + (n2 + 1) / 2)^2) / (n2 - 1)
  p_hat <- (mean(r2) - (n2 + 1) / 2) / n1                          # P(X < Y) + 0.5 P(X = Y)
  se <- sqrt(n1 * v1 + n2 * v2) / (n1 * n2)
  df <- (n1 * v1 + n2 * v2)^2 / ((n1 * v1)^2 / (n1 - 1) + (n2 * v2)^2 / (n2 - 1))
  t <- (p_hat - 0.5) / se
  c(p_hat = p_hat, t = t, df = df, p = 2 * pt(-abs(t), df),
    CI_dolna = p_hat - qt(0.975, df) * se, CI_gorna = p_hat + qt(0.975, df) * se)
}
bm <- brunner_munzel(bez, pow)
round(bm, 3)
# delta Cliffa = 2 * p_hat - 1 (te same granice przedziału po przeliczeniu)
round(2 * bm[c("p_hat", "CI_dolna", "CI_gorna")] - 1, 2)
# kontrola: p_hat policzone wprost ze wszystkich 42 × 18 par
round(mean(outer(bez, pow, "<") + 0.5 * outer(bez, pow, "==")), 3)

# Krok 5. Test Manna–Whitneya (w R: wilcox.test) – ta sama miara przewagi, inne założenia
mw <- wilcox.test(pow, bez, exact = FALSE)
c(W = unname(mw$statistic), p = round(mw$p.value, 3), p_hat = round(unname(mw$statistic) / (42 * 18), 3))
Wynik w R
     bez powiadomień powiadomienia
n              42.00         18.00
M              63.76         80.06
SD             11.46         26.16
Me             60.50         70.50
Mt20           61.92         74.58
min            47.00         54.00
max           109.00        153.00
roznica       t      df       p     CI1     CI2
 16.294   2.540  19.856   0.020   2.907  29.680
     t     df      p
 3.376 58.000  0.001
Call:
yuen(formula = czas ~ grupa, data = dane, tr = 0.2)

Test statistic: 2.3941 (df = 12.69), p-value = 0.03286

Trimmed mean difference:  -12.66026
95 percent confidence interval:
-24.1129     -1.2076

Explanatory measure of effect size: 0.53

$effsize
[1] 0.5310257

$alpha
[1] 0.05

$CI
[1] 0.2670365 0.7929404

   p_hat        t       df        p CI_dolna CI_gorna
   0.710    2.635   24.741    0.014    0.546    0.874
   p_hat CI_dolna CI_gorna
    0.42     0.09     0.75
[1] 0.71
      W       p   p_hat
536.500   0.011   0.710
2. Symulacja błędu I rodzaju
R
# B242 – błąd I rodzaju pięciu testów przy nierównych wariancjach i liczebnościach (symulacja, set.seed(2425))
# W każdym scenariuszu obie populacje są symetryczne wokół tej samej wartości, więc prawdziwe są
# jednocześnie hipotezy zerowe wszystkich testów: równe średnie, równe średnie ucinane i P(X < Y) = 0.5.
set.seed(2425)
R <- 10000
yuen_p <- function(x, y, tr = 0.2) {                # test Yuena (jak WRS2::yuen), wersja szybka do pętli
  s <- function(v) { n <- length(v); g <- floor(tr * n); v <- sort(v)
    w <- c(rep(v[g + 1], g), v[(g + 1):(n - g)], rep(v[n - g], g)); h <- n - 2 * g
    c(mt = mean(v[(g + 1):(n - g)]), d = (n - 1) * var(w) / (h * (h - 1)), h = h) }
  a <- s(x); b <- s(y)
  t <- (a[["mt"]] - b[["mt"]]) / sqrt(a[["d"]] + b[["d"]])
  df <- (a[["d"]] + b[["d"]])^2 / (a[["d"]]^2 / (a[["h"]] - 1) + b[["d"]]^2 / (b[["h"]] - 1))
  2 * pt(-abs(t), df)
}
bm_p <- function(x, y) {                            # test Brunnera–Munzela (jak w przykładzie)
  n1 <- length(x); n2 <- length(y); N <- n1 + n2
  r <- rank(c(x, y)); r1 <- r[1:n1]; r2 <- r[(n1 + 1):N]
  v1 <- sum((r1 - rank(x) - mean(r1) + (n1 + 1) / 2)^2) / (n1 - 1)
  v2 <- sum((r2 - rank(y) - mean(r2) + (n2 + 1) / 2)^2) / (n2 - 1)
  t <- ((mean(r2) - mean(r1)) / N) / (sqrt(n1 * v1 + n2 * v2) / (n1 * n2))
  df <- (n1 * v1 + n2 * v2)^2 / ((n1 * v1)^2 / (n1 - 1) + (n2 * v2)^2 / (n2 - 1))
  2 * pt(-abs(t), df)
}
scen <- data.frame(
  nazwa = c("A: 30 i 30, równe SD", "B: 30 i 30, SD 1 i 3", "C: 45 i 15, mniejsza grupa ma 3 × większe SD",
            "D: 15 i 45, większa grupa ma 3 × większe SD", "E: jak C, rozkład o grubych ogonach (t, df = 3)"),
  n1 = c(30, 30, 45, 15, 45), n2 = c(30, 30, 15, 45, 15), sd2 = c(1, 3, 3, 3, 3), ogony = c(0, 0, 0, 0, 1))
losuj <- function(n, s, ogony) if (ogony) s * rt(n, df = 3) else rnorm(n, 0, s)
wynik <- t(sapply(seq_len(nrow(scen)), function(i) {
  sc <- scen[i, ]
  p <- replicate(R, {
    x <- losuj(sc$n1, 1, sc$ogony); y <- losuj(sc$n2, sc$sd2, sc$ogony)
    c(Student = t.test(x, y, var.equal = TRUE)$p.value, Welch = t.test(x, y)$p.value, Yuen = yuen_p(x, y),
      Mann_Whitney = wilcox.test(x, y, exact = FALSE)$p.value, Brunner_Munzel = bm_p(x, y))
  })
  rowMeans(p < .05)
}))
rownames(wynik) <- scen$nazwa
round(wynik, 3)
Wynik w R
                                                Student Welch  Yuen Mann_Whitney Brunner_Munzel
A: 30 i 30, równe SD                              0.050 0.050 0.053        0.049          0.053
B: 30 i 30, SD 1 i 3                              0.054 0.052 0.054        0.065          0.053
C: 45 i 15, mniejsza grupa ma 3 × większe SD      0.207 0.052 0.058        0.126          0.054
D: 15 i 45, większa grupa ma 3 × większe SD       0.003 0.052 0.050        0.016          0.049
E: jak C, rozkład o grubych ogonach (t, df = 3)   0.198 0.043 0.047        0.110          0.052
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki wykonano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- WRS2 (wersja 1.1.7): Mair, P., & Wilcox, R. (2020). Robust statistical methods in R using the WRS2 package. Behavior Research Methods, 52(2), 464–488. https://doi.org/10.3758/s13428-019-01246-w
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Test Studenta przy nierównych grupach. Gdy mniejsza grupa ma większy rozrzut, zawyża liczbę fałszywych alarmów. W przykładzie dał p = .001 zamiast .020.
- Wybór testu według testu Levene’a albo Shapiro-Wilka. Procedura dwuetapowa nie chroni poziomu istotności (Zimmerman, 2004). Test odporny zaplanuj z góry; zob. też homogeniczność wariancji.
- Zwykły test t na danych po ucięciu. Zaniża błąd standardowy. Średnie ucinane porównuje test Yuena.
- „Test Manna–Whitneya porównuje mediany”. Nie porównuje, a przy różnym rozproszeniu może dać istotny wynik bez przewagi którejkolwiek grupy.
- Raportowanie samego p. Podaj różnicę średnich, średnich ucinanych albo p̂ z CI. Przeliczenia między miarami pokazuje wpis o wielkości efektu dla testów nieparametrycznych.
- Wybór testu po obejrzeniu wyników. Liczenie czterech testów i opisanie tego z najmniejszym p to ukryte wielokrotne testowanie.
Plan całej analizy, od opisu próby po testy hipotez, znajdziesz w przewodniku po statystyce w pracy dyplomowej. Jeśli chcesz, żeby ktoś sprawdził dobór testów w Twojej pracy, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Czym różni się test Brunnera–Munzela od testu Manna–Whitneya?
Oba liczą z rang to samo prawdopodobieństwo przewagi p̂, ale test Manna–Whitneya zakłada, że przy prawdziwej H0 rozkłady są identyczne, także pod względem rozproszenia. Test Brunnera–Munzela szacuje wariancję osobno w każdej grupie i koryguje stopnie swobody, więc przy różnym rozproszeniu trzyma poziom istotności (Brunner i Munzel, 2000; Karch, 2021). W naszej symulacji Mann–Whitney miał od .016 do .126 fałszywych alarmów, a Brunner–Munzel od .049 do .054.
Kiedy użyć testu Yuena zamiast testu t Welcha?
Gdy pytasz o typowy wynik, a w danych są długie ogony albo kilka skrajnych wartości, które mocno przesuwają średnią. Test Yuena porównuje średnie ucinane 20% i liczy błąd standardowy z danych winsoryzowanych (Yuen, 1974). Gdy pytanie dotyczy średniej, np. łącznego kosztu, zostań przy teście Welcha, a test Yuena podaj jako analizę wrażliwości.
Jak policzyć test Brunnera–Munzela w R bez dodatkowych pakietów?
Nadaj rangi w połączonej próbie i osobno w każdej grupie, policz p̂ ze średniej rangi drugiej grupy, a błąd standardowy z wariancji różnic między rangą w próbie a rangą w grupie. Statystyka to (p̂ − .5)/SE z rozkładem t i stopniami swobody Satterthwaite’a. Gotowa funkcja na kilkanaście linijek jest w sekcji z kodem.
Czy test t Studenta można stosować przy nierównych liczebnościach grup?
Tylko gdy wariancje są podobne, a tego nie wiadomo z góry. Gdy mniejsza grupa ma większy rozrzut, test Studenta jest zbyt liberalny: w symulacji z grupami 45 i 15 osób i trzykrotnie większym SD w mniejszej grupie dał .207 fałszywych alarmów. Dlatego domyślnie stosuj test Welcha (Delacre i in., 2017).
Jak interpretować p̂ = .71 w teście Brunnera–Munzela?
Losowo wybrana osoba z jednej grupy ma wyższy wynik niż losowo wybrana osoba z drugiej z prawdopodobieństwem .71 (remisy liczone po połowie). Wartość .5 oznacza brak przewagi. To ta sama liczba co miara A Varghi–Delaneya (Vargha i Delaney, 2000), a 2p̂ − 1 = .42 to delta Cliffa. Zawsze napisz, przewagę której grupy oznacza p̂.
Powiązane hasła
Przeczytaj też
Test t przy rozkładzie nienormalnym
Kiedy skośność naprawdę szkodzi testowi t: symulacja w R, test Welcha, bootstrap, test Yuena i Mann–Whitney na jednym przykładzie oraz opis APA.
Czytaj →PoradnikWielkość efektu w testach nieparametrycznych
r = Z/√N, korelacja rangowo-biseryjna, delta Cliffa, A Varghi–Delaneya, ε² i W Kendalla: co mierzą, jak je przeliczać i podać z CI – z kodem R.
Czytaj →PoradnikKreator: jaki test statystyczny wybrać?
Kilka pytań o hipotezę, zmienną i układ badania, a w wyniku test główny, alternatywa, miara efektu i linki do poradnika oraz kalkulatora.
Czytaj →Porównujesz dwie nierówne grupy i nie wiesz, który test wybrać?
Sprawdzimy dobór testu do pytania badawczego, miary efektu i opis wyników oraz wyjaśnimy je tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Brunner, E., & Munzel, U. (2000). The nonparametric Behrens-Fisher problem: Asymptotic theory and a small-sample approximation. Biometrical Journal, 42(1), 17–25. https://doi.org/10.1002/(sici)1521-4036(200001)42:1<17::aid-bimj17>3.0.co;2-u
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Fagerland, M. W., & Sandvik, L. (2009). The Wilcoxon–Mann–Whitney test under scrutiny. Statistics in Medicine, 28(10), 1487–1497. https://doi.org/10.1002/sim.3561
- Fay, M. P., & Proschan, M. A. (2010). Wilcoxon–Mann–Whitney or t-test? On assumptions for hypothesis tests and multiple interpretations of decision rules. Statistics Surveys, 4, 1–39. https://doi.org/10.1214/09-SS051 ● Otwarty dostęp
- Karch, J. D. (2021). Psychologists should use Brunner-Munzel’s instead of Mann-Whitney’s U test as the default nonparametric procedure. Advances in Methods and Practices in Psychological Science, 4(2), Article 2515245921999602. https://doi.org/10.1177/2515245921999602 ● Otwarty dostęp
- Mair, P., & Wilcox, R. (2020). Robust statistical methods in R using the WRS2 package. Behavior Research Methods, 52(2), 464–488. https://doi.org/10.3758/s13428-019-01246-w ● Otwarty dostęp
- Vargha, A., & Delaney, H. D. (2000). A critique and improvement of the CL common language effect size statistics of McGraw and Wong. Journal of Educational and Behavioral Statistics, 25(2), 101–132. https://doi.org/10.3102/10769986025002101
- Welch, B. L. (1947). The generalization of 'Student's' problem when several different population variances are involved. Biometrika, 34(1–2), 28–35. https://doi.org/10.1093/biomet/34.1-2.28
- Yuen, K. K. (1974). The two-sample trimmed t for unequal population variances. Biometrika, 61(1), 165–170. https://doi.org/10.1093/biomet/61.1.165
- Zimmerman, D. W. (2004). A note on preliminary tests of equality of variances. British Journal of Mathematical and Statistical Psychology, 57(1), 173–181. https://doi.org/10.1348/000711004849222
Cytowania BibTeX
@article{brunner2000nonparametric, author={Brunner, Edgar and Munzel, Ullrich}, title={{The nonparametric Behrens-Fisher problem: Asymptotic theory and a small-sample approximation}}, journal={Biometrical Journal}, year={2000}, volume={42}, number={1}, pages={17--25}, doi={10.1002/(sici)1521-4036(200001)42:1<17::aid-bimj17>3.0.co;2-u}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{fagerland2009wilcoxon, author={Fagerland, Morten W. and Sandvik, Leiv}, title={{The Wilcoxon–Mann–Whitney test under scrutiny}}, journal={Statistics in Medicine}, year={2009}, volume={28}, number={10}, pages={1487--1497}, doi={10.1002/sim.3561}}@article{fay2010wilcoxon, author={Fay, Michael P. and Proschan, Michael A.}, title={{Wilcoxon–Mann–Whitney or t-test? On assumptions for hypothesis tests and multiple interpretations of decision rules}}, journal={Statistics Surveys}, year={2010}, volume={4}, pages={1--39}, doi={10.1214/09-ss051}}@article{karch2021psychologists, author={Karch, Julian D.}, title={{Psychologists should use Brunner-Munzel’s instead of Mann-Whitney’s U test as the default nonparametric procedure}}, journal={Advances in Methods and Practices in Psychological Science}, year={2021}, volume={4}, number={2}, eid={2515245921999602}, doi={10.1177/2515245921999602}}@article{mair2020robust, author={Mair, Patrick and Wilcox, Rand}, title={{Robust statistical methods in R using the WRS2 package}}, journal={Behavior Research Methods}, year={2020}, volume={52}, number={2}, pages={464--488}, doi={10.3758/s13428-019-01246-w}}@article{vargha2000critique, author={Vargha, András and Delaney, Harold D.}, title={{A critique and improvement of the CL common language effect size statistics of McGraw and Wong}}, journal={Journal of Educational and Behavioral Statistics}, year={2000}, volume={25}, number={2}, pages={101--132}, doi={10.3102/10769986025002101}}@article{welch1947generalization, author={Welch, B. L.}, title={{The generalization of 'Student's' problem when several different population variances are involved}}, journal={Biometrika}, year={1947}, volume={34}, number={1–2}, pages={28--35}, doi={10.1093/biomet/34.1-2.28}}@article{yuen1974two, author={Yuen, Karen K.}, title={{The two-sample trimmed t for unequal population variances}}, journal={Biometrika}, year={1974}, volume={61}, number={1}, pages={165--170}, doi={10.1093/biomet/61.1.165}}@article{zimmerman2004note, author={Zimmerman, Donald W.}, title={{A note on preliminary tests of equality of variances}}, journal={British Journal of Mathematical and Statistical Psychology}, year={2004}, volume={57}, number={1}, pages={173--181}, doi={10.1348/000711004849222}}