Do czego służy GEE w SPSS
Te same osoby zmierzono kilka razy, a wynik jest zero-jedynkowy, np. zdał lub nie zdał. Zwykła regresja logistyczna zakłada, że każdy wiersz pliku to inna, niezależna obserwacja. Tu tak nie jest. Pomiary jednej osoby są do siebie podobne. Naturalnym rozwiązaniem są uogólnione równania estymujące (GEE). Liang i Zeger (1986) pokazali, że dają one zgodne oszacowania współczynników i ich wariancji przy łagodnych założeniach o zależności pomiarów w czasie.
W SPSS procedura jest w menu Analyze → Generalized Linear Models → Generalized Estimating Equations.... Rozszerza uogólniony model liniowy na pomiary powtarzane i inne dane skorelowane. Zakłada, że przypadki są zależne w obrębie obiektu (osoby) i niezależne między obiektami (IBM Corp., b.d.-a). Według IBM wymaga edycji SPSS Statistics Standard albo opcji Advanced Statistics. Nazwy menu, zakładek i tabel podajemy po angielsku, za dokumentacją IBM. W polskiej wersji interfejsu mogą brzmieć inaczej.
Ten wpis to instrukcja obsługi okna i wydruku. Czym GEE różni się od modelu mieszanego, dlaczego ilorazy szans z obu modeli się różnią i co z brakami danych, wyjaśnia wpis GEE czy model mieszany?. Dla wyniku ciągłego i efektów losowych w SPSS zobacz MIXED w SPSS. Ogólne zasady czytania wydruku opisuje wpis jak czytać wyniki z SPSS.
Przykład i pliki do pobrania
Przykład jest fikcyjny. 120 studentów oddawało co tydzień zadanie domowe przez cztery tygodnie. Połowa dostawała przypomnienia SMS dzień przed terminem, połowa nie. Pytanie: czy przypomnienia zwiększają szansę oddania zadania w terminie? Każdy student ma cztery pomiary zero-jedynkowe, razem 480 wierszy.
| Zmienna | Opis | Rola w oknie GEE |
|---|---|---|
id | numer studenta (1–120) | Subject variables |
tydzien | tydzień zajęć: 1–4 | Within-subject variables i czynnik |
grupa | 0 = bez przypomnień, 1 = przypomnienia SMS | czynnik |
termin | zadanie oddane w terminie: 0 = nie, 1 = tak | zmienna zależna |
Pobierz plik .sav (z etykietami zmiennych i wartości) albo ten sam zbiór jako plik CSV. Dane wygenerowano w R z ziarnem set.seed(5563). Ziarno wybraliśmy spośród kilkudziesięciu sprawdzonych tak, żeby efekt przypomnień był wyraźny. Studenci różnili się stałą skłonnością do terminowości, stąd korelacja pomiarów.
| Grupa | Tydzień 1 | Tydzień 2 | Tydzień 3 | Tydzień 4 |
|---|---|---|---|---|
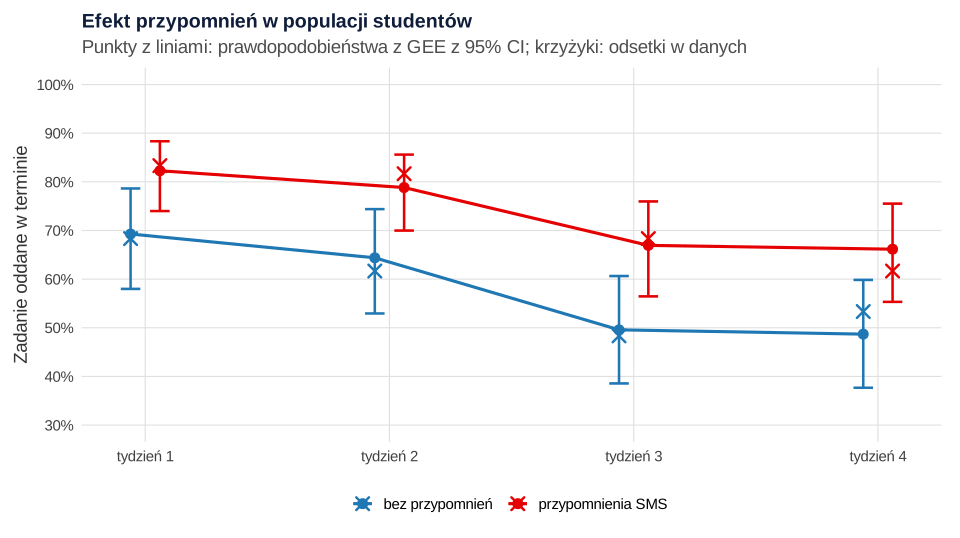
| Bez przypomnień | 68.3% | 61.7% | 48.3% | 53.3% |
| Przypomnienia SMS | 83.3% | 81.7% | 68.3% | 61.7% |
Dane w formacie długim
Procedura GEE pracuje na danych w formacie długim: jeden wiersz to jeden pomiar jednego studenta. Kombinacja zmiennych podmiotu (Subject variables) ma jednoznacznie wskazywać osobę, a zmienne wewnątrzpodmiotowe (Within-subject variables) wyznaczają kolejność pomiarów (IBM Corp., b.d.-a). Jeśli masz plik szeroki z kolumnami termin1–termin4, przekształć go kreatorem Data → Restructure. Krok po kroku pokazuje to wpis o modelu mieszanym w SPSS.
W składni domyślnie SORT=YES: SPSS sortuje przypadki po podmiocie i tygodniu na czas analizy. Bez sortowania wiersze jednej osoby muszą leżeć obok siebie, inaczej wyniki mogą być błędne (IBM Corp., b.d.-f). Brakujący pomiar to po prostu brak wiersza. Pamiętaj jednak, że zwykłe GEE dobrze znosi tylko braki całkowicie losowe (zob. MCAR, MAR i MNAR oraz wpis GEE czy model mieszany?).
Okno Generalized Estimating Equations krok po kroku
Okno ma kilka zakładek. Przejdź je w tej kolejności (IBM Corp., b.d.-a, b.d.-b, b.d.-c):
- Repeated. Przenieś
iddo Subject variables, atydziendo Within-subject variables. W grupie Working Correlation Matrix wybierz strukturę roboczej macierzy korelacji, tu Exchangeable. Do wyboru są też Independent, AR(1), M-dependent i Unstructured. W grupie Covariance Matrix zostaw Robust estimator. W składni to ustawienie domyślne, a domyślną macierzą roboczą jest Independent (IBM Corp., b.d.-f). - Type of Model. W grupie Binary Response or Events/Trials Data wybierz Binary logistic, czyli rozkład dwumianowy z łączem logitowym. Dla wyniku ciągłego służy Linear, a dla zliczeń np. Poisson loglinear (zob. regresja Poissona w SPSS).
- Response. Przenieś
termindo pola zmiennej zależnej. Kliknij Reference Category i wybierz First (lowest value). To najważniejszy krok całego okna – wyjaśniamy go niżej. - Predictors.
grupaitydzientrafiają do Factors. Domyślnie parametr redundantny, czyli kategorię odniesienia, dostaje ostatni poziom czynnika (IBM Corp., b.d.-e). Jeśli wolisz porównywać z grupą bez przypomnień i z tygodniem 1, ustaw w opcjach czynników kolejność malejącą (w składniORDER=DESCENDING). Tak zrobiliśmy w tym wpisie. - Model. Dodaj
grupaitydzienjako efekty główne. Interakcję grupa × tydzień dodasz, jeśli hipoteza dotyczy różnego przebiegu w grupach. - Statistics. Zostaw Type III i statystyki Walda. W grupie Print zaznacz wykładnicze oszacowania parametrów (exp(B), czyli ilorazy szans) oraz Working correlation matrix (IBM Corp., b.d.-b).
- EM Means. Przenieś
grupaitydziendo listy i wybierz skalę Response. Dostaniesz szacowane prawdopodobieństwa zamiast logitów (IBM Corp., b.d.-a).
Zakładka Estimation dotyczy w GEE tylko początkowego uogólnionego modelu liniowego. Liczbę iteracji i kryteria zbieżności samych równań ustawia się na zakładce Repeated (IBM Corp., b.d.-a).
Pułapka: SPSS domyślnie modeluje „nie”
Dla dwuwartościowej zmiennej zależnej SPSS domyślnie traktuje ostatnią, najwyższą kategorię (u nas 1 = „tak”) jako odniesienie. Oszacowania dotyczą wtedy kategorii 0, czyli nieoddania zadania w terminie (IBM Corp., b.d.-c). Dopasowanie modelu się nie zmienia, ale znaki tak. Przy ustawieniu domyślnym efekt przypomnień wyszedłby B = −0.722, exp(B) = 0.486. Łatwo wtedy napisać, że przypomnienia „zmniejszają szanse”. Po wyborze First (lowest value) dostajesz B = 0.722, exp(B) = 2.059. To szanse oddania zadania w terminie. Studium przypadku IBM też wybiera First (IBM Corp., b.d.-d). W składni odpowiada temu termin (REFERENCE=FIRST).
Model Information i Correlated Data Summary
Pierwsze tabele służą do kontroli. Model Information powtarza ustawienia: m.in. zmienną zależną, rozkład i funkcję łączącą (IBM Corp., b.d.-b). Sprawdź, czy SPSS dopasował model, który zaplanowałeś. Correlated Data Summary podaje liczbę podmiotów, minimalną i maksymalną liczbę pomiarów na podmiot oraz wymiar macierzy korelacji (IBM Corp., b.d.-d). U nas: 120 podmiotów, od 4 do 4 pomiarów, wymiar 4. Jeśli liczba podmiotów równa się liczbie wierszy, pomyliłeś zmienną w Subject variables.
Goodness of Fit: QIC i wybór macierzy roboczej
GEE nie opiera się na pełnej wiarygodności, więc zwykłego AIC nie da się policzyć. Pan (2001) zaproponował zamiast niego kryterium oparte na quasi-wiarygodności (QIC). Tabela Goodness of Fit podaje dwie wartości (IBM Corp., b.d.-b, b.d.-d):
- QIC – do porównywania struktur macierzy roboczej przy tych samych predyktorach. Mniejsze znaczy lepsze.
- QICC – do porównywania zestawów predyktorów przy tej samej macierzy roboczej.
Uruchomiliśmy model z czterema strukturami. Wartości QIC policzyliśmy w R funkcją QIC() z pakietu geepack, według wzoru Pana (2001). SPSS może podać nieco inne liczby. Porównuj więc tylko wartości z jednego programu.
| Working Correlation Matrix | B | Std. Error | exp(B) [95% CI] | Sig. | QIC |
|---|---|---|---|---|---|
| Independent | .736 | .263 | 2.087 [1.246, 3.495] | .005 | 600.061 |
| Exchangeable (ρ = .258) | .722 | .262 | 2.059 [1.233, 3.440] | .006 | 600.010 |
| AR(1) (ρ = .320) | .700 | .265 | 2.013 [1.196, 3.388] | .008 | 600.124 |
| Unstructured | .715 | .261 | 2.045 [1.225, 3.412] | .006 | 599.991 |
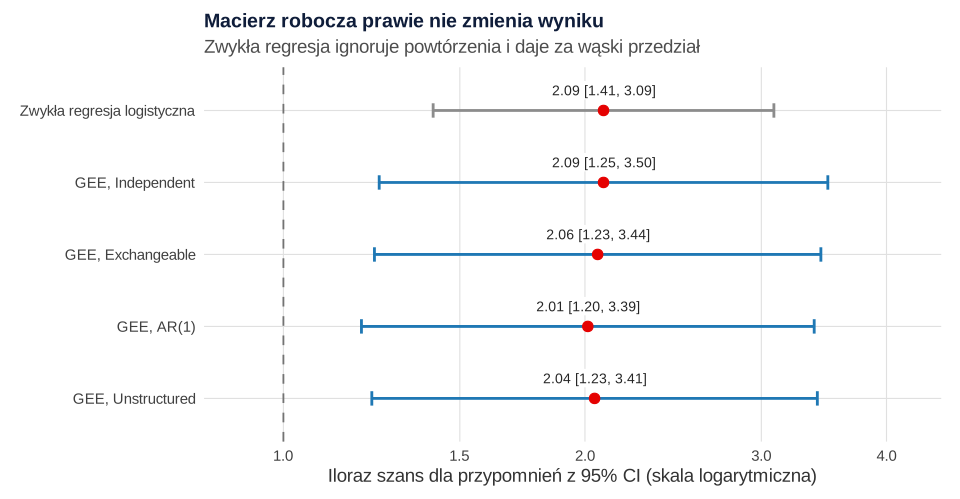
Najmniejsze QIC ma Unstructured, ale różnice są w setnych częściach przy wartościach rzędu 600. To nic nie rozstrzyga. Podobnie było w studium IBM: QIC 1829.275 wobec 1829.280 (IBM Corp., b.d.-d). Ważniejsze, że efekt przypomnień prawie się nie zmienia. To typowe dla GEE. Z estymatorem odpornym oszacowania pozostają zgodne nawet przy źle dobranej macierzy roboczej, a dobra macierz poprawia głównie efektywność (Liang i Zeger, 1986).
Dlatego macierz wybierz przed analizą, z planu badania. Przy kilku równo rozłożonych pomiarach rozsądna jest Exchangeable. AR(1) pasuje, gdy bliższe w czasie pomiary są bardziej podobne. Unstructured szacuje osobną korelację dla każdej pary pomiarów, tu sześć. Przy wielu pomiarach i niewielu osobach to za dużo parametrów. Nie przełączaj macierzy, aż p spadnie poniżej .05.
Tests of Model Effects
Tabelę tę zamawia opcja statystyk podsumowania modelu na zakładce Statistics. W oknie Generalized Linear Models nosi nazwę Tests of Model Effects. Podaje dla każdego efektu jeden test Walda. Domyślnie są to testy Type III (IBM Corp., b.d.-b, b.d.-e). Wiersz (Intercept) pomiń. Test dla czynnika o kilku poziomach ma tyle stopni swobody, ile parametrów: tydzień ma 3.
| Source | Wald Chi-Square | df | Sig. |
|---|---|---|---|
| grupa | 7.614 | 1 | .006 |
| tydzien | 24.614 | 3 | .000 |
„Sig. = .000” zapisz w pracy jako p < .001. W GEE nie ma testu ilorazu wiarygodności. W składni słowo LR daje przy GEE uogólnione statystyki score (IBM Corp., b.d.-e).
Parameter Estimates: exp(B) i błąd odporny
Tabela Parameter Estimates zawiera oszacowania, statystyki testowe i przedziały ufności Walda, a po zaznaczeniu opcji – także oszacowania wykładnicze, exp(B) (IBM Corp., b.d.-b). Kolumny nazywamy tak jak w oknie Generalized Linear Models (zob. regresja Poissona w SPSS). Ich dokładnych podpisów w wydruku GEE nie potwierdziliśmy w dokumentacji.
| Parameter | B | Std. Error | Lower | Upper | Wald Chi-Square | df | Sig. | exp(B) | 95% CI exp(B) |
|---|---|---|---|---|---|---|---|---|---|
| (Intercept) | .813 | .250 | .322 | 1.303 | 10.550 | 1 | .001 | 2.254 | 1.380–3.682 |
| [grupa=1] | .722 | .262 | .209 | 1.235 | 7.614 | 1 | .006 | 2.059 | 1.233–3.440 |
| [grupa=0] | 0a | 1 | |||||||
| [tydzien=4] | −.865 | .228 | −1.311 | −.419 | 14.456 | 1 | .000 | .421 | .270–.658 |
| [tydzien=3] | −.830 | .247 | −1.314 | −.346 | 11.292 | 1 | .001 | .436 | .269–.708 |
| [tydzien=2] | −.221 | .261 | −.732 | .290 | .718 | 1 | .397 | .802 | .481–1.337 |
| [tydzien=1] | 0a | 1 |
a Parametr redundantny (kategoria odniesienia), ustawiony na 0.
Jak to czytać? Przy tym samym tygodniu szanse oddania zadania w terminie były w grupie z przypomnieniami 2.06 razy większe, 95% CI [1.23, 3.44]. W tygodniach 3 i 4 szanse były o ponad połowę mniejsze niż w tygodniu 1 (exp(B) = 0.44 i 0.42). To efekty brzegowe, czyli uśrednione w populacji studentów, a nie efekty dla konkretnej osoby. Dlaczego to ważne i czym różni się iloraz szans z modelu mieszanego, wyjaśnia wpis GEE czy model mieszany?.
Estymator odporny czy model-based?
Estymator odporny (kanapkowy) daje zgodne błędy standardowe nawet przy źle określonej macierzy roboczej. Estymator model-based to ujemna uogólniona odwrotność hesjanu, oparta wprost na przyjętej macierzy roboczej (IBM Corp., b.d.-a). Tutaj obie wersje są bliskie: dla grupy .262 wobec .264, dla tygodnia 4 .228 wobec .246. Zostaw domyślny estymator odporny. Wyjątkiem jest bardzo mała liczba osób, przy której błąd odporny bywa za mały (zob. wpis o GEE).
Porównaj też zwykłą regresję logistyczną na 480 wierszach. Daje podobne B = 0.736, ale błąd standardowy 0.200 zamiast 0.262. Przedział jest przez to za wąski (rysunek 1), a p za małe. Zwykła regresja liczy każdego studenta jak cztery niezależne osoby. To ta sama pseudoreplikacja, przed którą chroni GEE.
EM Means: prawdopodobieństwa zamiast logitów
Średnie brzegowe na skali Response są podawane w jednostkach zmiennej zależnej, czyli jako szacowane prawdopodobieństwa. Skala Linear predictor dałaby logity. Kontrasty i korekty (np. Bonferroni) wybierzesz w tym samym oknie (IBM Corp., b.d.-a). W składni domyślne są porównania parami bez korekty, czyli LSD (IBM Corp., b.d.-e).
| Poziom | Prawdopodobieństwo | 95% CI |
|---|---|---|
| Bez przypomnień | .583 | [.492, .668] |
| Przypomnienia SMS | .742 | [.666, .805] |
| Tydzień 1 | .764 | [.681, .831] |
| Tydzień 2 | .722 | [.636, .794] |
| Tydzień 3 | .585 | [.494, .671] |
| Tydzień 4 | .577 | [.484, .664] |
W R (emmeans) średnie dla grupy uśredniono po tygodniach na skali logitu, więc nie są zwykłym odsetkiem z tabeli opisowej. Różnicę grup na skali ilorazu szans emmeans podaje jako 2.06, z = 2.759, p = .006 – to ten sam test co w Parameter Estimates.
Zapis wyników w stylu APA
Podaj model (GEE, łącze logitowe), macierz roboczą z uzasadnieniem, estymator odporny, ilorazy szans z 95% CI i p. Wzór tabeli:
Tabela 1
Uogólnione równania estymujące dla oddania zadania w terminie
| Predyktor | B | SE | OR | 95% CI dla OR | p |
|---|---|---|---|---|---|
| Przypomnienia SMS (vs brak) | 0.72 | 0.26 | 2.06 | [1.23, 3.44] | .006 |
| Tydzień 2 (vs 1) | −0.22 | 0.26 | 0.80 | [0.48, 1.34] | .397 |
| Tydzień 3 (vs 1) | −0.83 | 0.25 | 0.44 | [0.27, 0.71] | .001 |
| Tydzień 4 (vs 1) | −0.87 | 0.23 | 0.42 | [0.27, 0.66] | < .001 |
Uwaga. 120 studentów, 480 pomiarów. GEE z łączem logitowym, roboczą macierzą korelacji wymienną (ρ = .26) i odpornymi błędami standardowymi. OR = iloraz szans oddania zadania w terminie; przedziały i p z testu Walda. Dane symulowane.
Ostatnie zdanie dopasuj do programu i wersji, których naprawdę użyłeś (zob. jak cytować SPSS i R). Zdania do prostszych analiz złożysz w generatorze opisu wyników APA.
Składnia SPSS i kod R
Przepis 1 to składnia do wklejenia w edytorze składni SPSS. Napisaliśmy ją według wykresu składni GENLIN i opisu podkomend MODEL, CRITERIA, REPEATED, EMMEANS i PRINT w Command Syntax Reference (IBM Corp., b.d.-e, b.d.-f), ale nie uruchamialiśmy jej w SPSS. Przepis 2 w R tworzy pliki do pobrania i liczy wszystkie liczby z tabel (pakiety geepack i emmeans). Pakiet geepack może szacować korelację roboczą i parametr skali nieco inaczej niż SPSS, np. bez domyślnej w SPSS korekty korelacji na liczbę parametrów (ADJUSTCORR=YES). Dlatego SPSS może dać różnice na dalszych miejscach po przecinku. Tego nie sprawdzaliśmy w SPSS.
1. Składnia SPSS: GEE dla wyniku binarnego
SPSS
* Składnia zgodna z opisem GENLIN w Command Syntax Reference; nie była uruchamiana w SPSS.
* GEE: termin (1 = tak) modelowany przy kategorii odniesienia FIRST (0 = nie).
GENLIN termin (REFERENCE=FIRST) BY grupa tydzien (ORDER=DESCENDING)
  /MODEL grupa tydzien INTERCEPT=YES DISTRIBUTION=BINOMIAL LINK=LOGIT
  /CRITERIA ANALYSISTYPE=3(WALD) CILEVEL=95
  /REPEATED SUBJECT=id WITHINSUBJECT=tydzien SORT=YES CORRTYPE=EXCHANGEABLE
    ADJUSTCORR=YES COVB=ROBUST
  /EMMEANS TABLES=grupa SCALE=ORIGINAL
  /EMMEANS TABLES=tydzien SCALE=ORIGINAL
  /PRINT CPS DESCRIPTIVES MODELINFO FIT SUMMARY SOLUTION(EXPONENTIATED) WORKINGCORR.

* Porównanie macierzy roboczych: powtórz z CORRTYPE=INDEPENDENT, AR(1) i UNSTRUCTURED
* i porównaj QIC w tabelach Goodness of Fit.
2. Te same liczby w R i pliki .sav oraz CSV
R
# GEE dla wyniku binarnego w powtarzanych pomiarach – liczby do tabel w układzie okna
# Generalized Estimating Equations (SPSS, procedura GENLIN z podkomendą REPEATED).
# Dane fikcyjne (symulowane): 120 studentów, 4 tygodnie, czy zadanie oddano w terminie (1 = tak).
# Ziarno 5563 wybrano spośród kilkudziesięciu tak, aby efekt przypomnień był wyraźny.
suppressPackageStartupMessages({ library(haven); library(geepack); library(emmeans) })
options(width = 110)
set.seed(5563)
n <- 120
id      <- rep(1:n, each = 4)
tydzien <- rep(1:4, times = n)
grupa   <- rep(rep(0:1, each = n / 2), each = 4)        # 1 = przypomnienia SMS
u       <- rep(rnorm(n, 0, 1.6), each = 4)              # stała skłonność studenta (źródło korelacji)
eta     <- 1.3 + c(0, -0.4, -0.8, -1.2)[tydzien] + 0.9 * grupa + u
termin  <- rbinom(4 * n, 1, plogis(eta))
dane <- data.frame(id, tydzien, grupa, termin)
# Format długi: jeden wiersz = jeden pomiar jednego studenta (480 wierszy, bez braków)

# 1. Plik .sav z etykietami i ten sam zbiór w CSV
sav <- dane
sav$id      <- labelled(sav$id, label = "Numer studenta")
sav$tydzien <- labelled(sav$tydzien, label = "Tydzień zajęć (1–4)")
sav$grupa   <- labelled(sav$grupa, labels = c("bez przypomnień" = 0, "przypomnienia SMS" = 1), label = "Grupa")
sav$termin  <- labelled(sav$termin, labels = c("nie" = 0, "tak" = 1), label = "Zadanie oddane w terminie")
write_sav(sav, "gee-spss-dane.sav")
write.csv(dane, "gee-spss-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")

# 2. Opis danych i Correlated Data Summary
lp <- table(dane$id)
cat("Wiersze (pomiary):", nrow(dane), " studenci:", length(lp), " pomiarów na studenta: min =", min(lp), " max =", max(lp), "\n")
cat("Odsetek zadań oddanych w terminie (grupa x tydzień):\n")
print(round(100 * tapply(dane$termin, list(grupa = dane$grupa, tydzien = dane$tydzien), mean), 1))

# Funkcje: tabela Parameter Estimates (Wald, przedziały 95%) i testy Type III Walda
tabela <- function(b, V) {
  se <- sqrt(diag(V)); z <- qnorm(.975)
  data.frame(B = round(b, 3), SE = round(se, 3), Lower = round(b - z * se, 3), Upper = round(b + z * se, 3),
             Wald = round((b / se)^2, 3), df = 1, Sig = round(pchisq((b / se)^2, 1, lower.tail = FALSE), 4),
             ExpB = round(exp(b), 3), ExpB_L = round(exp(b - z * se), 3), ExpB_U = round(exp(b + z * se), 3))
}
wald3 <- function(b, V, wzor) {
  k <- grep(wzor, names(b)); W <- as.numeric(t(b[k]) %*% solve(V[k, k]) %*% b[k])
  c(Wald = round(W, 3), df = length(k), Sig = round(pchisq(W, length(k), lower.tail = FALSE), 4))
}
dane$grupa_f <- factor(dane$grupa); dane$tydzien_f <- factor(dane$tydzien)
dane <- dane[order(dane$id, dane$tydzien), ]               # SPSS sortuje po Subject i Within-subject
f <- termin ~ grupa_f + tydzien_f

# 3. Zwykła regresja logistyczna, która udaje, że wszystkie 480 pomiarów są niezależne
m_glm <- glm(f, family = binomial, data = dane)
cat("\n== Zwykła regresja logistyczna (bez uwzględnienia powtórzeń) ==\n")
print(tabela(coef(m_glm), vcov(m_glm))["grupa_f1", c("B", "SE", "Sig")])

# 4. GEE: Binary logistic, macierz robocza Exchangeable, estymator odporny (domyślny w GENLIN)
m_ex <- geeglm(f, id = id, waves = tydzien, family = binomial, data = dane, corstr = "exchangeable")
b <- coef(m_ex); V_rob <- m_ex$geese$vbeta; V_mod <- m_ex$geese$vbeta.naiv
names(b) <- rownames(V_rob) <- colnames(V_rob) <- rownames(V_mod) <- colnames(V_mod) <- names(coef(m_ex))
cat("\n== GEE, Exchangeable: Parameter Estimates (robust) ==\n"); print(tabela(b, V_rob))
cat("Ten sam model, błędy model-based:\n"); print(tabela(b, V_mod)[, c("B", "SE", "Sig")])
cat("Korelacja robocza (Exchangeable) =", round(m_ex$geese$alpha, 3), " skala =", round(m_ex$geese$gamma, 3), "\n")
cat("Tests of Model Effects (Type III, Wald, robust):\n")
print(rbind(grupa = wald3(b, V_rob, "^grupa_f"), tydzien = wald3(b, V_rob, "^tydzien_f")))

# 5. Pułapka: domyślna kategoria odniesienia odpowiedzi (Last) – modelowane jest P(termin = 0)
m_odwr <- geeglm(I(1 - termin) ~ grupa_f + tydzien_f, id = id, waves = tydzien, family = binomial,
                 data = dane, corstr = "exchangeable")
cat("\nOdpowiedź z odniesieniem Last (P = 0): B grupa =", round(coef(m_odwr)[["grupa_f1"]], 3),
    " Exp(B) =", round(exp(coef(m_odwr)[["grupa_f1"]]), 3), "\n")

# 6. Cztery struktury macierzy roboczej: efekt grupy i QIC (Pan, 2001; funkcja geepack::QIC)
cat("\n== Struktury macierzy roboczej ==\n")
wyn <- NULL
for (s in c("independence", "exchangeable", "ar1", "unstructured")) {
  m <- geeglm(f, id = id, waves = tydzien, family = binomial, data = dane, corstr = s)
  bb <- coef(m)[["grupa_f1"]]; ss <- sqrt(m$geese$vbeta[2, 2])
  wyn <- rbind(wyn, data.frame(struktura = s, B = round(bb, 3), SE_robust = round(ss, 3),
                               ExpB = round(exp(bb), 3), L = round(exp(bb - 1.96 * ss), 3), U = round(exp(bb + 1.96 * ss), 3),
                               Sig = round(2 * pnorm(-abs(bb / ss)), 4), QIC = round(QIC(m)[["QIC"]], 3)))
  if (s == "unstructured") { cat("Macierz robocza Unstructured (korelacje par tygodni):\n"); print(round(m$geese$alpha, 3)) }
  if (s == "ar1") cat("AR(1): rho =", round(m$geese$alpha, 3), "\n")
}
print(wyn, row.names = FALSE)

# 7. EM Means na skali odpowiedzi (prawdopodobieństwa), model Exchangeable, macierz odporna,
#    przedziały z rozkładu normalnego (df = Inf), jak przedziały Walda
cat("\n== EM Means: grupa (uśrednione po tygodniach na skali logitu) ==\n")
em_g <- update(emmeans(m_ex, ~ grupa_f, type = "response"), df = Inf); print(em_g)
print(pairs(em_g, reverse = TRUE))
cat("\n== EM Means: tydzień ==\n")
print(update(emmeans(m_ex, ~ tydzien_f, type = "response"), df = Inf))
Wynik w R
Wiersze (pomiary): 480  studenci: 120  pomiarów na studenta: min = 4  max = 4
Odsetek zadań oddanych w terminie (grupa x tydzień):
     tydzien
grupa    1    2    3    4
    0 68.3 61.7 48.3 53.3
    1 83.3 81.7 68.3 61.7

== Zwykła regresja logistyczna (bez uwzględnienia powtórzeń) ==
             B  SE   Sig
grupa_f1 0.736 0.2 2e-04

== GEE, Exchangeable: Parameter Estimates (robust) ==
                 B    SE  Lower  Upper   Wald df    Sig  ExpB ExpB_L ExpB_U
(Intercept)  0.813 0.250  0.322  1.303 10.550  1 0.0012 2.254  1.380  3.682
grupa_f1     0.722 0.262  0.209  1.235  7.614  1 0.0058 2.059  1.233  3.440
tydzien_f2  -0.221 0.261 -0.732  0.290  0.718  1 0.3969 0.802  0.481  1.337
tydzien_f3  -0.830 0.247 -1.314 -0.346 11.292  1 0.0008 0.436  0.269  0.708
tydzien_f4  -0.865 0.228 -1.311 -0.419 14.456  1 0.0001 0.421  0.270  0.658
Ten sam model, błędy model-based:
                 B    SE    Sig
(Intercept)  0.813 0.242 0.0008
grupa_f1     0.722 0.264 0.0062
tydzien_f2  -0.221 0.256 0.3875
tydzien_f3  -0.830 0.246 0.0008
tydzien_f4  -0.865 0.246 0.0004
Korelacja robocza (Exchangeable) = 0.258  skala = 0.994
Tests of Model Effects (Type III, Wald, robust):
          Wald df    Sig
grupa    7.614  1 0.0058
tydzien 24.614  3 0.0000

Odpowiedź z odniesieniem Last (P = 0): B grupa = -0.722  Exp(B) = 0.486

== Struktury macierzy roboczej ==
AR(1): rho = 0.32
Macierz robocza Unstructured (korelacje par tygodni):
alpha.1:2 alpha.1:3 alpha.1:4 alpha.2:3 alpha.2:4 alpha.3:4
    0.205     0.249     0.358     0.282     0.307     0.147
    struktura     B SE_robust  ExpB     L     U    Sig     QIC
 independence 0.736     0.263 2.087 1.246 3.495 0.0052 600.061
 exchangeable 0.722     0.262 2.059 1.233 3.440 0.0058 600.010
          ar1 0.700     0.265 2.013 1.196 3.388 0.0084 600.124
 unstructured 0.715     0.261 2.045 1.225 3.412 0.0062 599.991

== EM Means: grupa (uśrednione po tygodniach na skali logitu) ==
 grupa_f  prob     SE  df asymp.LCL asymp.UCL
 0       0.583 0.0454 Inf     0.492     0.668
 1       0.742 0.0356 Inf     0.666     0.805

Results are averaged over the levels of: tydzien_f
Covariance estimate used: vbeta
Degrees-of-freedom method: user-specified
Confidence level used: 0.95
Intervals are back-transformed from the logit scale
 contrast            odds.ratio    SE  df null z.ratio p.value
 grupa_f1 / grupa_f0       2.06 0.539 Inf    1   2.759  0.0058

Results are averaged over the levels of: tydzien_f
Degrees-of-freedom method: user-specified
Tests are performed on the log odds ratio scale

== EM Means: tydzień ==
 tydzien_f  prob     SE  df asymp.LCL asymp.UCL
 1         0.764 0.0384 Inf     0.681     0.831
 2         0.722 0.0405 Inf     0.636     0.794
 3         0.585 0.0454 Inf     0.494     0.671
 4         0.577 0.0466 Inf     0.484     0.664

Results are averaged over the levels of: grupa_f
Covariance estimate used: vbeta
Degrees-of-freedom method: user-specified
Confidence level used: 0.95
Intervals are back-transformed from the logit scale
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami geepack, emmeans i haven; rysunki wykonano w pakietach ggplot2 i svglite. Składni SPSS nie uruchamiano. W pracy podaj wersję SPSS lub R, której faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- geepack (wersja 1.3.13): Højsgaard, S., Halekoh, U., & Yan, J. (2006). The R package geepack for generalized estimating equations. Journal of Statistical Software, 15(2), 1–11. https://doi.org/10.18637/jss.v015.i02
- emmeans (wersja 2.0.2): Lenth, R., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means (R package version 2.0.2) [Computer software]. https://doi.org/10.32614/CRAN.package.emmeans
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Typowe błędy
- Domyślna kategoria odniesienia odpowiedzi. SPSS modeluje wtedy kategorię 0 i odwraca znaki. Wybierz First (lowest value) na zakładce Response.
- Plik w formacie szerokim albo zła zmienna podmiotu. W Correlated Data Summary liczba podmiotów musi odpowiadać liczbie osób.
- Zwykła regresja logistyczna na wszystkich wierszach. Błędy standardowe predyktorów stałych w obrębie osoby są za małe.
- Wybór macierzy roboczej pod wynik. QIC różniące się o ułamki nie rozstrzyga. Decyzję zapisz przed analizą.
- Interpretacja ilorazu szans z GEE jako efektu dla konkretnej osoby. To efekt uśredniony w populacji (zob. GEE czy model mieszany?). Jeśli pytasz o osoby, potrzebujesz wielopoziomowej regresji logistycznej.
- Braki inne niż całkowicie losowe. Gdy słabsi studenci częściej znikają z danych, zwykłe GEE może dać obciążony wynik.
W jamovi podobne dane możesz przeanalizować modelem mieszanym (zob. model mieszany w jamovi). Gdy masz tylko jeden pomiar na osobę, wróć do regresji logistycznej w SPSS. Model do pytania dobierzesz w kreatorze wyboru testu.
Najczęstsze pytania
Gdzie w SPSS są uogólnione równania estymujące (GEE)?
W menu Analyze → Generalized Linear Models → Generalized Estimating Equations. Na zakładce Repeated wskazujesz zmienną osoby i zmienną czasu oraz roboczą macierz korelacji, na Type of Model rozkład i łącze, a na Response zmienną zależną. Według IBM procedura wymaga edycji Standard albo opcji Advanced Statistics (IBM Corp., b.d.-a). W polskiej wersji interfejsu nazwy mogą brzmieć inaczej.
Jaką macierz roboczą wybrać na zakładce Repeated w SPSS?
Wybierz ją przed analizą, z planu badania: Exchangeable przy kilku podobnych pomiarach, AR(1), gdy bliższe pomiary są bardziej podobne, Unstructured przy niewielu pomiarach i dużej próbie. Z estymatorem odpornym oszacowania pozostają zgodne nawet przy złej macierzy (Liang i Zeger, 1986). W przykładzie iloraz szans dla przypomnień wynosił od 2.01 do 2.09 przy czterech macierzach.
Dlaczego w SPSS GEE współczynnik ma odwrotny znak?
Najczęściej przez domyślną kategorię odniesienia zmiennej zależnej. SPSS przyjmuje ostatnią, najwyższą kategorię (np. 1) jako odniesienie, więc oszacowania dotyczą kategorii 0 (IBM Corp., b.d.-c). Na zakładce Response kliknij Reference Category i wybierz First (lowest value), w składni termin (REFERENCE=FIRST). W przykładzie zmienia to B z −0.722 na 0.722.
Co oznaczają QIC i QICC w tabeli Goodness of Fit?
To kryteria oparte na quasi-wiarygodności, odpowiedniki AIC dla GEE (Pan, 2001). QIC porównuje struktury macierzy roboczej przy tych samych predyktorach, a QICC zestawy predyktorów przy tej samej macierzy; mniejsze znaczy lepsze (IBM Corp., b.d.-d). Różnice o ułamki nie rozstrzygają wyboru.
Czy w GEE używać estymatora odpornego czy model-based?
Zwykle odpornego, który jest domyślny w składni GENLIN (IBM Corp., b.d.-f). Daje zgodne błędy standardowe nawet przy źle określonej macierzy roboczej. Przy bardzo małej liczbie osób bywa jednak za mały i wtedy potrzebne są poprawki na małą próbę.
Powiązane hasła
Przeczytaj też
GEE czy model mieszany?
Efekty brzegowe a warunkowe, robocza macierz korelacji, błąd kanapkowy i CR2, braki MCAR i MAR oraz QIC – na jednym przykładzie w R.
Czytaj →PoradnikModel mieszany (MIXED) w SPSS krok po kroku
Linear Mixed Models od pliku w formacie długim po opis APA: Subjects i Repeated, losowy wyraz wolny, ICC, struktury AR(1), CS i UN, średnie brzegowe i składnia MIXED – na przykładzie dwóch grup i trzech pomiarów z brakami.
Czytaj →PoradnikRegresja logistyczna w SPSS
Binary Logistic krok po kroku: kategoria odniesienia, Hosmer–Lemeshow, pseudo-R², tabela klasyfikacji, Exp(B) z przedziałami ufności i zapis APA.
Czytaj →PoradnikRegresja Poissona i ujemna dwumianowa w SPSS
Generalized Linear Models od pliku .sav po opis APA: offset, Value/df i nadmierna dyspersja, IRR z exp(B), szacowany parametr k i składnia GENLIN – na fikcyjnych danych o nieobecnościach.
Czytaj →Masz powtarzane pomiary w SPSS i nie wiesz, jak je przeanalizować?
Sprawdzimy format danych, model GEE lub mieszany i opis wyników oraz wyjaśnimy je tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- IBM Corp. (b.d.-a). Generalized Estimating Equations. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/advanced/idh_idd_gee_repeated.html ● Otwarty dostęp
- IBM Corp. (b.d.-b). Generalized Estimating Equations Statistics. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/advanced/idh_idd_gee_statistics.html ● Otwarty dostęp
- IBM Corp. (b.d.-c). Generalized Linear Models Reference Category. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/advanced/idh_idd_genlin_refcat_dlg.html ● Otwarty dostęp
- IBM Corp. (b.d.-d). Using Generalized Estimating Equations to Fit a Repeated Measures Logistic Regression. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_casestudies_project_ddita/spss/tutorials/gee_wheeze_intro.html ● Otwarty dostęp
- IBM Corp. (b.d.-e). GENLIN. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/advanced/syn_genlin.html ● Otwarty dostęp
- IBM Corp. (b.d.-f). REPEATED Subcommand (GENLIN command). IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/advanced/syn_genlin_repeated.html ● Otwarty dostęp
- Liang, K.-Y., & Zeger, S. L. (1986). Longitudinal data analysis using generalized linear models. Biometrika, 73(1), 13–22. https://doi.org/10.1093/biomet/73.1.13
- Pan, W. (2001). Akaike's information criterion in generalized estimating equations. Biometrics, 57(1), 120–125. https://doi.org/10.1111/j.0006-341x.2001.00120.x
Cytowania BibTeX
@misc{ibmnd31gee, author={{IBM Corp.}}, title={{Generalized Estimating Equations}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-a}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/advanced/idh_idd_gee_repeated.html}}@misc{ibmnd31geestat, author={{IBM Corp.}}, title={{Generalized Estimating Equations Statistics}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-b}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/advanced/idh_idd_gee_statistics.html}}@misc{ibmnd31genlinrefcat, author={{IBM Corp.}}, title={{Generalized Linear Models Reference Category}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-c}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/advanced/idh_idd_genlin_refcat_dlg.html}}@misc{ibmnd31geestudium, author={{IBM Corp.}}, title={{Using Generalized Estimating Equations to Fit a Repeated Measures Logistic Regression}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-d}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_casestudies_project_ddita/spss/tutorials/gee_wheeze_intro.html}}@misc{ibmnd31genlinskladnia, author={{IBM Corp.}}, title={{GENLIN}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-e}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/advanced/syn_genlin.html}}@misc{ibmnd31genlinrepeated, author={{IBM Corp.}}, title={{REPEATED Subcommand (GENLIN command)}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-f}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/advanced/syn_genlin_repeated.html}}@article{liang1986longitudinal, author={Liang, Kung-Yee and Zeger, Scott L.}, title={{Longitudinal data analysis using generalized linear models}}, journal={Biometrika}, year={1986}, volume={73}, number={1}, pages={13--22}, doi={10.1093/biomet/73.1.13}}@article{pan2001akaikes, author={Pan, Wei}, title={{Akaike's information criterion in generalized estimating equations}}, journal={Biometrics}, year={2001}, volume={57}, number={1}, pages={120--125}, doi={10.1111/j.0006-341x.2001.00120.x}}