Do czego służy ta procedura w SPSS
Gdy zmienna zależna to liczba zdarzeń – nieobecności, wizyt, błędów, wypadków – zwykła regresja liniowa się nie sprawdza. Zliczenia są nieujemne, skośne i mają wiele zer. Zamiast niej stosuje się regresję Poissona albo regresję ujemną dwumianową (Coxe i in., 2009; Gardner i in., 1995). Teorię, wybór modelu i modele z nadmiarem zer omawia poradnik regresja dla zliczeń krok po kroku. Tutaj pokazujemy, gdzie to wszystko jest w SPSS i jak czytać wydruk.
W SPSS oba modele są w jednym oknie: Analyze → Generalized Linear Models → Generalized Linear Models... (IBM Corp., b.d.-a). Według IBM ta procedura wymaga edycji SPSS Statistics Standard albo opcji Advanced Statistics. Nazwy menu, zakładek i tabel podajemy po angielsku, za dokumentacją IBM. W polskiej wersji interfejsu mogą brzmieć inaczej. Ogólne zasady czytania wydruku wyjaśnia wpis jak czytać wyniki z SPSS.
Przykład i pliki do pobrania
Przykład jest fikcyjny. Mamy 240 studentów i liczbę ich nieobecności w semestrze. Pytanie: czy udział w programie mentoringu wiąże się z mniejszą liczbą nieobecności, przy kontroli pracy zarobkowej i czasu dojazdu? Haczyk: studenci mieli różną liczbę zajęć (30, 45 albo 60). Ktoś, kto opuścił 6 z 60 zajęć, opuszczał rzadziej niż ktoś, kto opuścił 6 z 30.
| Zmienna | Opis | M | SD |
|---|---|---|---|
nieob | liczba nieobecności w semestrze (zmienna zależna, 0–19) | 3.78 | 4.10 |
zajecia | liczba zajęć w semestrze: 30, 45 lub 60 (ekspozycja) | 45.00 | 12.27 |
mentoring | udział w mentoringu: 0 = nie, 1 = tak | 0.49 | 0.50 |
praca | praca zarobkowa: 0 = nie, 1 = tak | 0.36 | 0.48 |
dojazd | czas dojazdu na uczelnię w minutach (2–120) | 35.46 | 23.04 |
Pobierz plik .sav (z etykietami zmiennych i wartości) albo ten sam zbiór jako plik CSV. Już opis danych zdradza problem. Średnia liczba nieobecności to 3.78, a wariancja – 16.78. W rozkładzie Poissona obie byłyby podobne. Zer jest 47 (19.6%).
Przygotowanie danych: offset jako logarytm
Zmienna zależna musi być liczbą całkowitą nieujemną. Przypadki z wartością ujemną, niecałkowitą albo brakiem SPSS pomija w analizie (IBM Corp., b.d.-a). Sprawdź więc minimum i maksimum, zanim uruchomisz model. Kody braków danych, np. 99, zdefiniuj jako braki (zob. przygotowanie danych w SPSS).
Różną liczbę zajęć uwzględnia offset. To predyktor, którego współczynnik nie jest szacowany, tylko ustalony na 1. Jego wartości dodaje się do predyktora liniowego (IBM Corp., b.d.-c). Przy łączu logarytmicznym offset musi być logarytmem naturalnym ekspozycji. IBM ilustruje to wypadkami kierowców z logarytmem stażu jako offsetem (IBM Corp., b.d.-c). SPSS nie zlogarytmuje zmiennej za Ciebie. Utwórz ją w Transform → Compute Variable albo składnią: COMPUTE ln_zajecia = LN(zajecia). Model opisuje wtedy częstość nieobecności na jedno zajęcie, a nie surową liczbę.
Okno Generalized Linear Models krok po kroku
Okno ma kilka zakładek. Przejdź je w tej kolejności (IBM Corp., b.d.-a, b.d.-b, b.d.-c, b.d.-e):
- Type of Model. W grupie Counts wybierz Poisson loglinear, czyli rozkład Poissona z łączem logarytmicznym. Model ujemny dwumianowy omawiamy niżej – ma pułapkę w ustawieniu domyślnym.
- Response. Przenieś
nieobdo pola zmiennej zależnej. - Predictors. Zmienne kategorialne trafiają do pola Factors, ilościowe – do Covariates. Tu:
mentoringipracajako czynniki,dojazdjako kowariant. W grupie Offset zaznacz Variable i wskażln_zajecia. - Options (przycisk pod polem Factors). Wybierz kolejność kategorii Descending. Wtedy kategorią odniesienia jest najniższa wartość (0 = nie). Domyślnie odniesieniem jest ostatnia kategoria (IBM Corp., b.d.-d). Pominięcie tego kroku nie zmienia dopasowania modelu, ale odwraca znaki: zamiast B = −0.52 dla mentoringu dostaniesz +0.52 dla „braku mentoringu”.
- Model. Domyślny model zawiera tylko wyraz wolny. Zaznacz trzy predyktory i dodaj je jako Main effects.
- Estimation. Na razie zostaw domyślną skalę. Dla rozkładu Poissona jest ona ustalona na 1 (IBM Corp., b.d.-d). Do tej zakładki wrócimy przy nadmiernej dyspersji.
- Statistics. Zostaw Type III i przedziały 95%. Pod Parameter estimates zaznacz opcję wyświetlania wykładniczych oszacowań. W składni odpowiada jej
/PRINT SOLUTION(EXPONENTIATED)(IBM Corp., b.d.-d). Wykładnicze oszacowanie, exp(B), to w modelu z łączem logarytmicznym iloraz częstości (IRR).
Na zakładce Save możesz zapisać wartości przewidywane i reszty, np. standaryzowane reszty dewiancyjne, do diagnostyki (IBM Corp., b.d.-e). Wydruk zawiera m.in. tabele Goodness of Fit, Omnibus Test, Tests of Model Effects i Parameter Estimates.
Goodness of Fit: sprawdź nadmierną dyspersję
Zacznij od tej tabeli.
| Value | df | Value/df | |
|---|---|---|---|
| Deviance | 875.030 | 236 | 3.708 |
| Scaled Deviance | 875.030 | 236 | |
| Pearson Chi-Square | 886.420 | 236 | 3.756 |
| Scaled Pearson Chi-Square | 886.420 | 236 | |
| Log Likelihood | −735.450 | ||
| Akaike's Information Criterion (AIC) | 1478.901 | ||
| Finite Sample Corrected AIC (AICC) | 1479.071 | ||
| Bayesian Information Criterion (BIC) | 1492.823 | ||
| Consistent AIC (CAIC) | 1496.823 |
Kolumna Value/df przy dewiancji i statystyce Pearsona szacuje parametr skali. W regresji Poissona powinna być bliska 1 (IBM Corp., b.d.-e). Tu wynosi 3.71 i 3.76. Rozrzut zliczeń jest prawie czterokrotnie większy, niż zakłada model, czyli mamy nadmierną dyspersję. Osoby różnią się skłonnością do zdarzeń bardziej, niż wyjaśniają predyktory (Gardner i in., 1995). Błędy standardowe są wtedy za małe, przedziały za wąskie, a wartości p za niskie.
Kryteria informacyjne (AIC, BIC) służą do porównywania modeli na tych samych danych, a mniejsze znaczy lepsze (zob. AIC i BIC w regresji). Log-wiarygodność SPSS domyślnie podaje w pełnej postaci (IBM Corp., b.d.-d), tak jak funkcja logLik() w R.
Omnibus Test i Tests of Model Effects
Omnibus Test to test ilorazu wiarygodności modelu z predyktorami wobec modelu z samym wyrazem wolnym (i offsetem): Likelihood Ratio Chi-Square = 75.546, df = 3, Sig. = .000 (IBM Corp., b.d.-e). Tests of Model Effects podaje dla każdego predyktora test Walda: mentoring χ² = 55.660, praca χ² = 6.632 (Sig. = .010), dojazd χ² = 16.102 (wszystkie df = 1). Wiersz (Intercept) pomiń. Przy nadmiernej dyspersji te liczby są zbyt optymistyczne.
Parameter Estimates i Exp(B) jako IRR
Tabela Parameter Estimates ma kolumny B, Std. Error, 95% przedział Walda (Lower, Upper) i część Hypothesis Test (Wald Chi-Square, df, Sig.) (IBM Corp., b.d.-e). Po zaznaczeniu wykładniczych oszacowań dochodzą exp(B) i jego przedział. Dokładnych podpisów tych kolumn nie potwierdziliśmy w dokumentacji, dlatego w tabelach nazywamy je opisowo.
| Parameter | B | Std. Error | Lower | Upper | Wald Chi-Square | df | Sig. | exp(B) | 95% CI exp(B) |
|---|---|---|---|---|---|---|---|---|---|
| (Intercept) | −2.527 | .0721 | −2.669 | −2.386 | 1227.945 | 1 | .000 | .080 | .069–.092 |
| [mentoring=1] | −.516 | .0691 | −.651 | −.380 | 55.660 | 1 | .000 | .597 | .521–.684 |
| [mentoring=0] | 0a | 1 | |||||||
| [praca=1] | .174 | .0677 | .042 | .307 | 6.632 | 1 | .010 | 1.190 | 1.043–1.359 |
| [praca=0] | 0a | 1 | |||||||
| dojazd | .0056 | .0014 | .003 | .008 | 16.102 | 1 | .000 | 1.006 | 1.003–1.008 |
| (Scale) | 1b |
a Parametr redundantny (kategoria odniesienia), ustawiony na 0. b Wartość ustalona. Oba przypisy mają odpowiedniki w wydrukach z dokumentacji IBM (IBM Corp., b.d.-e).
Jak czytać exp(B), czyli iloraz częstości (IRR, incidence rate ratio)? Dla mentoringu wynosi .597. Przy tej samej pracy i dojeździe uczestnicy mentoringu opuszczali zajęcia o około 40% rzadziej (1 − .597). Dla kowariantu exp(B) dotyczy wzrostu o jedną jednostkę, czyli o minutę dojazdu. To mało czytelne, więc w opisie przelicz efekt na 10 minut: exp(10 × B).
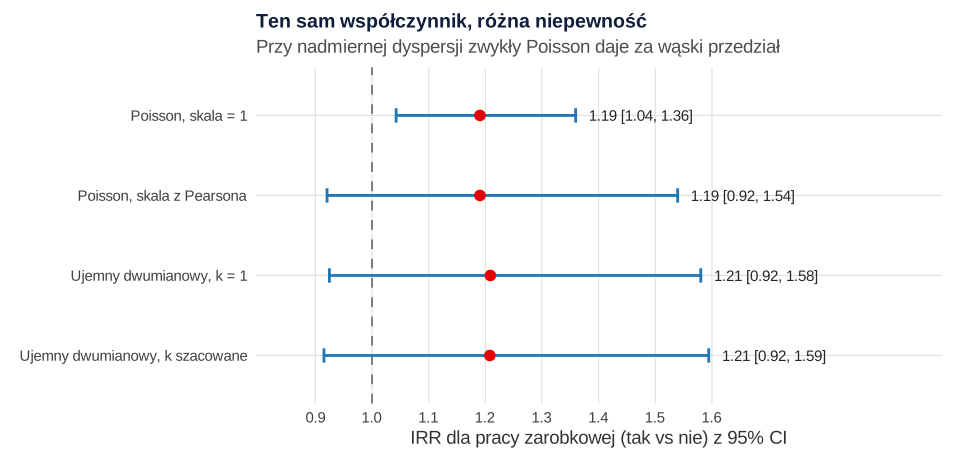
Wyróżniony wiersz pracy zarobkowej to pułapka. W tym modelu efekt jest „istotny” (p = .010). Zaraz zobaczysz, że to skutek nadmiernej dyspersji.
Co zrobić z nadmierną dyspersją w SPSS
Okno daje trzy drogi:
- Skala z Pearsona. Na zakładce Estimation zmień Scale Parameter Method na Pearson chi-square (albo Deviance). Współczynniki zostają te same, a błędy standardowe mnożą się przez pierwiastek ze skali: √3.756 = 1.94. Taki „nadmiernie rozproszony Poisson” pokazuje studium IBM (IBM Corp., b.d.-e) i opisuje Gardner i in. (1995). Log-wiarygodność i kryteria informacyjne SPSS liczy wtedy nadal przy skali 1 (IBM Corp., b.d.-d).
- Odporna macierz kowariancji. Na zakładce Estimation jest też Robust estimator (Huber/White/sandwich). Daje zgodne błędy standardowe nawet przy źle określonej funkcji wariancji (IBM Corp., b.d.-b).
- Model ujemny dwumianowy. Dodaje składnik losowy, który odpowiada za niewyjaśnione różnice między osobami (Gardner i in., 1995). Trzeba go jednak dobrze ustawić.
Model nadmiernie rozproszonego Poissona i model ujemny dwumianowy często dają podobne wyniki. Mogą się jednak różnić, bo inaczej ważą małe i duże zliczenia (Ver Hoef i Boveng, 2007).
Regresja ujemna dwumianowa: pułapka k = 1
Najprostsza droga, czyli Negative binomial with log link na zakładce Type of Model, nie szacuje parametru dyspersji. Ustala tak zwany parametr pomocniczy (ancillary parameter) na 1 (IBM Corp., b.d.-a). W składni odpowiada temu domyślne NEGBIN(1) (IBM Corp., b.d.-d). Aby SPSS oszacował ten parametr, wybierz Custom: rozkład Negative binomial, łącze Log i w grupie Parameter opcję Estimate value (IBM Corp., b.d.-a). W składni to DISTRIBUTION=NEGBIN(MLE). Parametr pomocniczy (oznaczmy go k) równy 0 daje model Poissona. Im większe k, tym silniejsza dyspersja. Funkcja glm.nb() z pakietu MASS w R podaje zamiast niego θ = 1/k.
W naszych danych k oszacowano na 0.82 (SE = 0.11), więc ustalone k = 1 akurat niewiele zmienia. Przy innych danych model z k = 1 bywa jednak źle określony. IBM wprost ostrzega, że wartość 1 może nie być optymalna (IBM Corp., b.d.-e). Oszacowanie k znajdziesz w wydruku, ale jego miejsca i podpisu nie potwierdziliśmy w dokumentacji.
| Parameter | B | Std. Error | Lower | Upper | Wald Chi-Square | df | Sig. | exp(B) | 95% CI exp(B) |
|---|---|---|---|---|---|---|---|---|---|
| (Intercept) | −2.546 | .1509 | −2.841 | −2.250 | 284.787 | 1 | .000 | .078 | .058–.105 |
| [mentoring=1] | −.521 | .1373 | −.790 | −.252 | 14.388 | 1 | .000 | .594 | .454–.777 |
| [praca=1] | .189 | .1416 | −.089 | .466 | 1.778 | 1 | .182 | 1.208 | .915–1.594 |
| dojazd | .0063 | .0029 | .000 | .012 | 4.513 | 1 | .034 | 1.006 | 1.000–1.012 |
Wiersze kategorii odniesienia (0a) pominęliśmy. Błędy standardowe są dwa razy większe niż w modelu Poissona. Efekt mentoringu pozostał wyraźny: IRR = 0.59, 95% CI [0.45, 0.78]. Efekt pracy zarobkowej przestał być istotny (p = .182), a przedział obejmuje 1. Dojazd: każde 10 minut to średnio 6.5% więcej nieobecności, IRR = 1.065, 95% CI [1.005, 1.128], p = .034. W R statystyka Pearsona podzielona przez df wynosi tu 0.93, czyli nadmierna dyspersja zniknęła. MASS liczy błędy standardowe współczynników przy ustalonym θ. SPSS może się więc różnić na dalszych miejscach po przecinku.
Poisson czy ujemny dwumianowy: test i zera
IBM podaje formalny test: iloraz wiarygodności modelu Poissona i ujemnego dwumianowego przy pozostałych ustawieniach bez zmian. Statystyka −2 × (LL Poissona − LL modelu ujemnego dwumianowego) ma wtedy rozkład mieszany. Połowa masy przypada na 0, a połowa na χ² z 1 df, więc p z tablicy χ² trzeba podzielić przez 2 (IBM Corp., b.d.-e). Tu: −2 × (−735.450 − (−573.907)) = 323.09, p < .001. Log-wiarygodności odczytasz z tabel Goodness of Fit obu modeli. Inna droga z dokumentacji to model ujemny dwumianowy z k = 0 i test mnożnika Lagrange’a z zakładki Statistics (IBM Corp., b.d.-e).
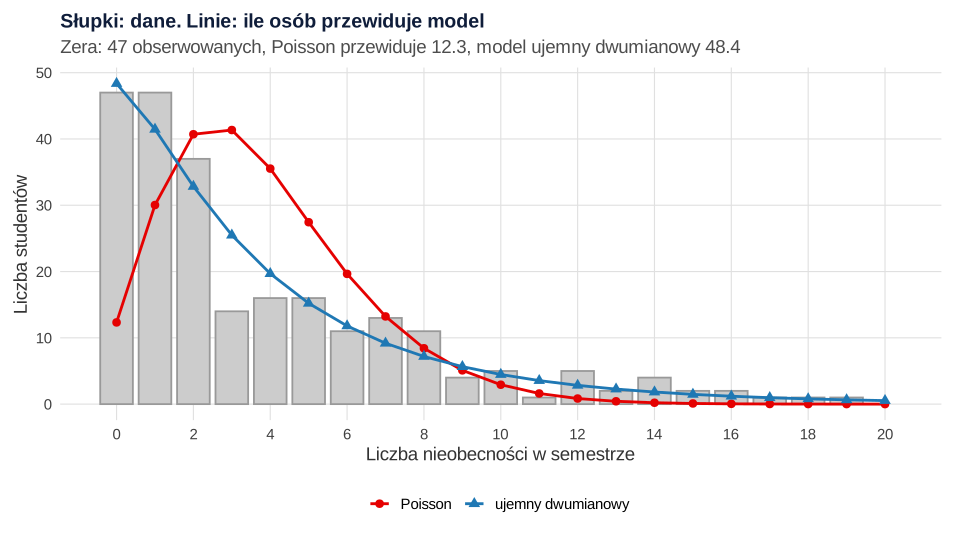
Porównaj też zera. Obserwowanych jest 47. Model Poissona przewiduje ich 12.3, a model ujemny dwumianowy – 48.4 (rysunek 2). Gdyby zer wciąż brakowało, zobacz model z nadmiarem zer. W oknie GENLIN takiego modelu nie ma.
Zapis wyników w stylu APA
Podaj model, offset, powód wyboru modelu ujemnego dwumianowego (Value/df lub test), IRR z 95% CI i p. Raportuj model, który zaplanowałeś. Nie wybieraj spośród czterech ustawień tego, w którym wyszło „istotnie”. Wzór tabeli:
Tabela 1
Regresja ujemna dwumianowa liczby nieobecności w semestrze
| Predyktor | B | SE | IRR | 95% CI dla IRR | p |
|---|---|---|---|---|---|
| Mentoring (1 = tak) | −0.52 | 0.14 | 0.59 | [0.45, 0.78] | < .001 |
| Praca zarobkowa (1 = tak) | 0.19 | 0.14 | 1.21 | [0.92, 1.59] | .182 |
| Dojazd (na 10 min) | 0.063 | 0.029 | 1.06 | [1.00, 1.13] | .034 |
Uwaga. N = 240. Model z łączem logarytmicznym i offsetem ln(liczba zajęć); IRR = iloraz częstości nieobecności na jedno zajęcie. Przedziały i p z testu Walda. Parametr dyspersji k = 0.82 (SE = 0.11). Model Poissona: Pearson χ²/df = 3.76; test ilorazu wiarygodności Poisson vs ujemny dwumianowy: 323.09, p < .001. Dane symulowane.
Ostatnie zdanie dopasuj do programu i wersji, których naprawdę użyłeś (zob. jak cytować SPSS i R). Zdania do innych analiz złożysz w generatorze opisu wyników APA. Gdy wynik jest zero-jedynkowy, a chcesz podać ryzyko względne, zobacz zmodyfikowaną regresję Poissona oraz regresję logistyczną w SPSS.
Składnia SPSS i kod R
Przepis 1 to składnia do wklejenia w edytorze składni SPSS. Napisaliśmy ją według wykresu składni GENLIN i opisu podkomend MODEL, CRITERIA i PRINT w Command Syntax Reference (IBM Corp., b.d.-d), ale nie uruchamialiśmy jej w SPSS. Przepis 2 w R tworzy pliki do pobrania i liczy wszystkie liczby z tabel (funkcje glm() i MASS::glm.nb()).
1. Składnia SPSS: offset, model Poissona i ujemny dwumianowy
SPSS
* Składnia zgodna z opisem GENLIN w Command Syntax Reference; nie była uruchamiana w SPSS.
* Offset: logarytm naturalny liczby zajęć.
COMPUTE ln_zajecia = LN(zajecia).

* Model 1. Regresja Poissona z offsetem (skala ustalona na 1).
GENLIN nieob BY mentoring praca (ORDER=DESCENDING) WITH dojazd
  /MODEL mentoring praca dojazd INTERCEPT=YES OFFSET=ln_zajecia
    DISTRIBUTION=POISSON LINK=LOG
  /CRITERIA SCALE=1 ANALYSISTYPE=3(WALD) CILEVEL=95 CITYPE=WALD
  /PRINT CPS DESCRIPTIVES MODELINFO FIT SUMMARY SOLUTION(EXPONENTIATED).

* Model 2. Regresja ujemna dwumianowa z szacowanym parametrem pomocniczym.
GENLIN nieob BY mentoring praca (ORDER=DESCENDING) WITH dojazd
  /MODEL mentoring praca dojazd INTERCEPT=YES OFFSET=ln_zajecia
    DISTRIBUTION=NEGBIN(MLE) LINK=LOG
  /CRITERIA ANALYSISTYPE=3(WALD) CILEVEL=95 CITYPE=WALD
  /PRINT CPS DESCRIPTIVES MODELINFO FIT SUMMARY SOLUTION(EXPONENTIATED).
2. Te same liczby w R i pliki .sav oraz CSV
R
# Regresja Poissona i ujemna dwumianowa – liczby do tabel w układzie Generalized Linear Models (SPSS)
# Dane fikcyjne (symulowane): 240 studentów, liczba nieobecności w semestrze, różna liczba zajęć.
# Metody jak w GENLIN: pełna log-wiarygodność, przedziały i testy Walda, test omnibus ilorazem
# wiarygodności, Type III Wald, kategoria 0 jako odniesienie (kolejność czynników Descending).
suppressPackageStartupMessages({ library(haven); library(MASS) })
options(width = 110)
set.seed(536)
n <- 240
zajecia   <- sample(c(30, 45, 60), n, replace = TRUE)   # liczba zajęć w semestrze (ekspozycja)
mentoring <- rbinom(n, 1, 0.5)                           # 1 = udział w programie mentoringu
praca     <- rbinom(n, 1, 0.4)                           # 1 = praca zarobkowa
dojazd    <- round(pmin(120, rgamma(n, shape = 2.5, scale = 14)))   # czas dojazdu, min
mu <- zajecia * exp(log(0.07) - 0.40 * mentoring + 0.35 * praca + 0.006 * dojazd)
nieob <- rnegbin(n, mu = mu, theta = 1.5)                # zliczenia z nadmierną dyspersją
dane <- data.frame(id = 1:n, nieob, zajecia, mentoring, praca, dojazd)

# 1. Plik .sav z etykietami i ten sam zbiór w CSV
sav <- dane
sav$id <- labelled(sav$id, label = "Numer osoby")
sav$nieob <- labelled(sav$nieob, label = "Liczba nieobecności w semestrze")
sav$zajecia <- labelled(sav$zajecia, label = "Liczba zajęć w semestrze")
sav$mentoring <- labelled(sav$mentoring, labels = c("nie" = 0, "tak" = 1), label = "Udział w mentoringu")
sav$praca <- labelled(sav$praca, labels = c("nie" = 0, "tak" = 1), label = "Praca zarobkowa")
sav$dojazd <- labelled(sav$dojazd, label = "Czas dojazdu na uczelnię (min)")
write_sav(sav, "regresja-poissona-spss-dane.sav")
write.csv(dane, "regresja-poissona-spss-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")

cat("N =", n, "\n")
print(round(sapply(dane[-1], function(x) c(M = mean(x), SD = sd(x), min = min(x), max = max(x))), 2))
cat("Odsetek zer:", round(mean(dane$nieob == 0), 3), "\n")
cat("Średnia i wariancja nieobecności:", round(mean(dane$nieob), 2), round(var(dane$nieob), 2), "\n")

# 2. Offset: logarytm naturalny ekspozycji (w SPSS: COMPUTE ln_zajecia = LN(zajecia).)
dane$ln_zajecia <- log(dane$zajecia)
f <- nieob ~ mentoring + praca + dojazd + offset(ln_zajecia)

# Funkcje: tabele w układzie GENLIN
dobroc <- function(m, k) {               # k = liczba szacowanych parametrów
  N <- nobs(m); dfr <- N - length(coef(m)); ll <- as.numeric(logLik(m))
  dev <- deviance(m); pea <- sum(residuals(m, type = "pearson")^2)
  data.frame(stat = c("Deviance", "Pearson Chi-Square", "Log Likelihood", "AIC", "AICC", "BIC", "CAIC"),
             Value = round(c(dev, pea, ll, -2 * ll + 2 * k, -2 * ll + 2 * k * N / (N - k - 1),
                             -2 * ll + k * log(N), -2 * ll + k * (log(N) + 1)), 3),
             df = c(dfr, dfr, NA, NA, NA, NA, NA),
             Value_df = round(c(dev / dfr, pea / dfr, NA, NA, NA, NA, NA), 3))
}
parametry <- function(m, se = sqrt(diag(vcov(m)))) {
  b <- coef(m); z <- qnorm(.975)
  data.frame(B = round(b, 4), SE = round(se, 4), Lower = round(b - z * se, 3), Upper = round(b + z * se, 3),
             Wald = round((b / se)^2, 3), df = 1, Sig = signif(pchisq((b / se)^2, 1, lower.tail = FALSE), 3),
             ExpB = round(exp(b), 3), ExpB_L = round(exp(b - z * se), 3), ExpB_U = round(exp(b + z * se), 3))
}

# 3. Model 1: Poisson loglinear, skala ustalona na 1
m_p <- glm(f, family = poisson, data = dane)
m_0 <- glm(nieob ~ 1 + offset(ln_zajecia), family = poisson, data = dane)
cat("\n== Model 1: Poisson loglinear ==\nGoodness of Fit\n")
print(dobroc(m_p, k = length(coef(m_p))), row.names = FALSE)
lr <- 2 * (logLik(m_p) - logLik(m_0))
cat("Omnibus Test: LR Chi-Square =", round(lr, 3), " df =", length(coef(m_p)) - 1,
    " Sig =", signif(pchisq(lr, length(coef(m_p)) - 1, lower.tail = FALSE), 3), "\n")
cat("Parameter Estimates (Scale = 1)\n"); print(parametry(m_p))

# 4. Ten sam model ze skalą z Pearsona (Scale Parameter Method: Pearson chi-square)
phi <- sum(residuals(m_p, type = "pearson")^2) / df.residual(m_p)
cat("\nSkala z Pearsona (phi) =", round(phi, 3), " pierwiastek =", round(sqrt(phi), 3), "\n")
print(parametry(m_p, se = sqrt(diag(vcov(m_p))) * sqrt(phi))[, c("B", "SE", "Lower", "Upper", "Sig", "ExpB_L", "ExpB_U")])

# 5. Model 2: Negative binomial with log link – parametr pomocniczy ustalony na 1 (domyślnie)
m_nb1 <- glm(f, family = negative.binomial(theta = 1), data = dane)   # k = 1/theta = 1
cat("\n== Model 2: ujemny dwumianowy, k = 1 (ustalone) ==\n")
cat("Log Likelihood =", round(as.numeric(logLik(m_nb1)), 3), "\n")
print(parametry(m_nb1)[, c("B", "SE", "Sig", "ExpB", "ExpB_L", "ExpB_U")])

# 6. Model 3: ujemny dwumianowy z szacowanym parametrem (Custom, Estimate value)
m_nb <- glm.nb(f, data = dane)
k_hat <- 1 / m_nb$theta; se_k <- m_nb$SE.theta / m_nb$theta^2
cat("\n== Model 3: ujemny dwumianowy, k szacowane ==\n")
cat("theta (MASS) =", round(m_nb$theta, 3), " k = 1/theta =", round(k_hat, 3), " SE(k) =", round(se_k, 3), "\n")
print(dobroc(m_nb, k = length(coef(m_nb)) + 1), row.names = FALSE)
print(parametry(m_nb))
b <- coef(m_nb)["dojazd"]; s_b <- sqrt(vcov(m_nb)["dojazd", "dojazd"])
cat("Dojazd co 10 min: IRR =", round(exp(10 * b), 3), " 95% CI [", round(exp(10 * (b - qnorm(.975) * s_b)), 3),
    ",", round(exp(10 * (b + qnorm(.975) * s_b)), 3), "]\n")

# 7. Poisson czy ujemny dwumianowy: test ilorazu wiarygodności z rozkładem mieszanym
lr_pn <- as.numeric(2 * (logLik(m_nb) - logLik(m_p)))
cat("\nLR (NB vs Poisson) =", round(lr_pn, 3), " p (połowa chi2 z 1 df) =",
    signif(0.5 * pchisq(lr_pn, 1, lower.tail = FALSE), 3), "\n")

# 8. Ile zer przewiduje każdy model (porównanie z obserwowanymi)
mu_p <- fitted(m_p); mu_nb <- fitted(m_nb)
cat("Zera: obserwowane =", sum(dane$nieob == 0), " Poisson =", round(sum(dpois(0, mu_p)), 1),
    " ujemny dwumianowy =", round(sum(dnbinom(0, mu = mu_nb, size = m_nb$theta)), 1), "\n")
Wynik w R
N = 240
    nieob zajecia mentoring praca dojazd
M    3.78   45.00      0.49  0.36  35.46
SD   4.10   12.27      0.50  0.48  23.04
min  0.00   30.00      0.00  0.00   2.00
max 19.00   60.00      1.00  1.00 120.00
Odsetek zer: 0.196
Średnia i wariancja nieobecności: 3.78 16.78

== Model 1: Poisson loglinear ==
Goodness of Fit
               stat    Value  df Value_df
           Deviance  875.030 236    3.708
 Pearson Chi-Square  886.420 236    3.756
     Log Likelihood -735.450  NA       NA
                AIC 1478.901  NA       NA
               AICC 1479.071  NA       NA
                BIC 1492.823  NA       NA
               CAIC 1496.823  NA       NA
Omnibus Test: LR Chi-Square = 75.546  df = 3  Sig = 2.77e-16
Parameter Estimates (Scale = 1)
                  B     SE  Lower  Upper     Wald df       Sig  ExpB ExpB_L ExpB_U
(Intercept) -2.5272 0.0721 -2.669 -2.386 1227.945  1 5.15e-269 0.080  0.069  0.092
mentoring   -0.5157 0.0691 -0.651 -0.380   55.660  1  8.62e-14 0.597  0.521  0.684
praca        0.1743 0.0677  0.042  0.307    6.632  1  1.00e-02 1.190  1.043  1.359
dojazd       0.0056 0.0014  0.003  0.008   16.102  1  6.00e-05 1.006  1.003  1.008

Skala z Pearsona (phi) = 3.756  pierwiastek = 1.938
                  B     SE  Lower  Upper      Sig ExpB_L ExpB_U
(Intercept) -2.5272 0.1398 -2.801 -2.253 4.49e-73  0.061  0.105
mentoring   -0.5157 0.1340 -0.778 -0.253 1.18e-04  0.459  0.776
praca        0.1743 0.1312 -0.083  0.431 1.84e-01  0.921  1.539
dojazd       0.0056 0.0027  0.000  0.011 3.84e-02  1.000  1.011

== Model 2: ujemny dwumianowy, k = 1 (ustalone) ==
Log Likelihood = -574.976
                  B     SE      Sig  ExpB ExpB_L ExpB_U
(Intercept) -2.5461 0.1457 2.06e-68 0.078  0.059  0.104
mentoring   -0.5215 0.1323 8.13e-05 0.594  0.458  0.769
praca        0.1896 0.1367 1.65e-01 1.209  0.925  1.580
dojazd       0.0063 0.0028 2.75e-02 1.006  1.001  1.012

== Model 3: ujemny dwumianowy, k szacowane ==
theta (MASS) = 1.213  k = 1/theta = 0.824  SE(k) = 0.11
               stat    Value  df Value_df
           Deviance  268.265 236    1.137
 Pearson Chi-Square  219.026 236    0.928
     Log Likelihood -573.907  NA       NA
                AIC 1157.813  NA       NA
               AICC 1158.070  NA       NA
                BIC 1175.217  NA       NA
               CAIC 1180.217  NA       NA
                  B     SE  Lower  Upper    Wald df      Sig  ExpB ExpB_L ExpB_U
(Intercept) -2.5458 0.1509 -2.841 -2.250 284.787  1 6.80e-64 0.078  0.058  0.105
mentoring   -0.5209 0.1373 -0.790 -0.252  14.388  1 1.49e-04 0.594  0.454  0.777
praca        0.1888 0.1416 -0.089  0.466   1.778  1 1.82e-01 1.208  0.915  1.594
dojazd       0.0063 0.0029  0.000  0.012   4.513  1 3.36e-02 1.006  1.000  1.012
Dojazd co 10 min: IRR = 1.065  95% CI [ 1.005 , 1.128 ]

LR (NB vs Poisson) = 323.087  p (połowa chi2 z 1 df) = 1.54e-72
Zera: obserwowane = 47  Poisson = 12.3  ujemny dwumianowy = 48.4
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami haven i MASS; rysunki wykonano w pakietach ggplot2 i svglite. Składni SPSS nie uruchamiano. W pracy podaj wersję SPSS lub R, której faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Typowe błędy
- Liczba zajęć jako offset bez logarytmu albo jako zwykły kowariant. Offsetem przy łączu log jest ln(ekspozycji).
- Pominięta tabela Goodness of Fit. Value/df wyraźnie powyżej 1 oznacza za małe błędy standardowe w modelu Poissona.
- „Negative binomial with log link” uznany za model z szacowaną dyspersją. Ta opcja ustala parametr pomocniczy na 1. Szacowanie daje dopiero Custom z Estimate value.
- Odwrócone znaki przez domyślną kategorię odniesienia (ostatnią). Sprawdź, który wiersz ma 0a.
- Raportowanie B bez exp(B) albo opis IRR jako różnicy liczby nieobecności. IRR to stosunek częstości, a nie różnica.
- Pomiary powtarzane tych samych osób w zwykłym modelu. Gdy każdy student ma kilka semestrów, obserwacje nie są niezależne. Wtedy potrzebne są GEE albo model mieszany.
Zliczenia w praktyce pokazują wpisy o pracy z logistyki (błędy kompletacji z offsetem) i BHP i ergonomii (wypadki na liczbę godzin pracy). Model do pytania dobierzesz w kreatorze wyboru testu.
Najczęstsze pytania
Gdzie w SPSS jest regresja Poissona?
W menu Analyze → Generalized Linear Models → Generalized Linear Models. Na zakładce Type of Model wybierz Poisson loglinear, na Response – zmienną zależną, a na Predictors – czynniki, kowarianty i ewentualny offset. Według IBM procedura wymaga edycji Standard albo opcji Advanced Statistics (IBM Corp., b.d.-a). W polskiej wersji interfejsu nazwy mogą brzmieć inaczej.
Jak w SPSS sprawdzić nadmierną dyspersję?
W tabeli Goodness of Fit odczytaj Value/df przy wierszach Deviance i Pearson Chi-Square. W regresji Poissona powinny być bliskie 1 (IBM Corp., b.d.-e). W przykładzie wynoszą 3.71 i 3.76, więc błędy standardowe modelu Poissona są za małe. Formalnie można porównać model Poissona z ujemnym dwumianowym testem ilorazu wiarygodności i podzielić p z tablicy χ² przez 2.
Czy opcja Negative binomial with log link szacuje parametr dyspersji?
Nie. Ustala parametr pomocniczy rozkładu ujemnego dwumianowego na 1 (IBM Corp., b.d.-a). Aby SPSS go oszacował, wybierz Custom, rozkład Negative binomial, łącze Log i w grupie Parameter opcję Estimate value; w składni DISTRIBUTION=NEGBIN(MLE). Parametr równy 0 daje model Poissona.
Jak wprowadzić offset w SPSS?
Najpierw utwórz logarytm naturalny ekspozycji, np. COMPUTE ln_zajecia = LN(zajecia). Potem na zakładce Predictors w grupie Offset wskaż tę zmienną. Współczynnik offsetu jest ustalony na 1, a jego wartości dodaje się do predyktora liniowego (IBM Corp., b.d.-c). Liczba zajęć bez logarytmu albo jako zwykły kowariant to błąd.
Jak interpretować Exp(B) w regresji Poissona w SPSS?
Wykładnicze oszacowanie exp(B) to iloraz częstości (IRR). W przykładzie dla mentoringu wynosi 0.59, 95% CI [0.45, 0.78]: przy stałej pracy i dojeździe uczestnicy opuszczali zajęcia o około 40% rzadziej. Dla kowariantu IRR dotyczy wzrostu o jednostkę, więc przy minutach warto przeliczyć go na 10 minut: exp(10 × B).
Powiązane hasła
Przeczytaj też
Regresja Poissona i ujemna dwumianowa w jamovi (GAMLj)
Moduł GAMLj w jamovi: modele dla zliczeń, Chi-squared/DF jako sygnał nadmiernej dyspersji, Exp(B) jako IRR, średnie brzegowe, offset i różnice wobec SPSS.
Czytaj →PoradnikRegresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →PoradnikJak czytać wyniki z SPSS
Osiem najczęstszych tabel SPSS: co odczytać, który wiersz wybrać, co znaczy Sig. = .000 i jak przepisać wynik w stylu APA.
Czytaj →PoradnikRegresja logistyczna w SPSS
Binary Logistic krok po kroku: kategoria odniesienia, Hosmer–Lemeshow, pseudo-R², tabela klasyfikacji, Exp(B) z przedziałami ufności i zapis APA.
Czytaj →Masz zliczenia w SPSS i nie wiesz, który model wybrać?
Sprawdzimy model, offset, nadmierną dyspersję i opis wyników oraz wyjaśnimy je tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Coxe, S., West, S. G., & Aiken, L. S. (2009). The analysis of count data: A gentle introduction to Poisson regression and its alternatives. Journal of Personality Assessment, 91(2), 121–136. https://doi.org/10.1080/00223890802634175
- Gardner, W., Mulvey, E. P., & Shaw, E. C. (1995). Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models. Psychological Bulletin, 118(3), 392–404. https://doi.org/10.1037/0033-2909.118.3.392
- IBM Corp. (b.d.-a). Generalized Linear Models. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/advanced/idh_idd_genlin_typeofmodel.html ● Otwarty dostęp
- IBM Corp. (b.d.-b). Generalized Linear Models Estimation. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/advanced/idh_idd_genlin_estimation.html ● Otwarty dostęp
- IBM Corp. (b.d.-c). Generalized Linear Models Predictors. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/advanced/idh_idd_genlin_predictors.html ● Otwarty dostęp
- IBM Corp. (b.d.-d). GENLIN. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/advanced/syn_genlin.html ● Otwarty dostęp
- IBM Corp. (b.d.-e). Using Poisson regression to analyze ship damage rates (Generalized Linear Models). IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_casestudies_project_ddita/spss/tutorials/genlin_ships_intro.html ● Otwarty dostęp
- Ver Hoef, J. M., & Boveng, P. L. (2007). Quasi-Poisson vs. negative binomial regression: How should we model overdispersed count data? Ecology, 88(11), 2766–2772. https://doi.org/10.1890/07-0043.1
Cytowania BibTeX
@article{coxe2009analysis, author={Coxe, Stefany and West, Stephen G. and Aiken, Leona S.}, title={{The analysis of count data: A gentle introduction to Poisson regression and its alternatives}}, journal={Journal of Personality Assessment}, year={2009}, volume={91}, number={2}, pages={121--136}, doi={10.1080/00223890802634175}}@article{gardner1995regression, author={Gardner, William and Mulvey, Edward P. and Shaw, Esther C.}, title={{Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models}}, journal={Psychological Bulletin}, year={1995}, volume={118}, number={3}, pages={392--404}, doi={10.1037/0033-2909.118.3.392}}@misc{ibmndgenlin31, author={{IBM Corp.}}, title={{Generalized Linear Models}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-a}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/advanced/idh_idd_genlin_typeofmodel.html}}@misc{ibmndgenlinestimation31, author={{IBM Corp.}}, title={{Generalized Linear Models Estimation}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-b}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/advanced/idh_idd_genlin_estimation.html}}@misc{ibmndgenlinpredictors31, author={{IBM Corp.}}, title={{Generalized Linear Models Predictors}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-c}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/advanced/idh_idd_genlin_predictors.html}}@misc{ibmndgenlinsyntax31, author={{IBM Corp.}}, title={{GENLIN}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-d}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/advanced/syn_genlin.html}}@misc{ibmndgenlinships31, author={{IBM Corp.}}, title={{Using Poisson regression to analyze ship damage rates (Generalized Linear Models)}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-e}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_casestudies_project_ddita/spss/tutorials/genlin_ships_intro.html}}@article{verhoef2007quasi, author={Ver Hoef, Jay M. and Boveng, Peter L.}, title={{Quasi-Poisson vs. negative binomial regression: How should we model overdispersed count data?}}, journal={Ecology}, year={2007}, volume={88}, number={11}, pages={2766--2772}, doi={10.1890/07-0043.1}}