Co to jest błąd wyprzedzenia diagnozy?
Błąd wyprzedzenia diagnozy (ang. lead-time bias) powstaje, gdy badanie przesiewowe wykrywa chorobę wcześniej, niż ujawniłyby ją objawy, a przeżycie liczy się od rozpoznania. Czas od rozpoznania do zgonu wydłuża się o okres wyprzedzenia, nawet jeśli chory umiera tego samego dnia co bez przesiewu. Pozorna korzyść wynika z przesunięcia punktu startu, a nie z dłuższego życia.
Błąd długości
Błąd długości (ang. length bias, length-time bias) wynika z tego, że przesiew częściej trafia na przypadki rozwijające się wolno, bo dłużej pozostają w wykrywalnej fazie przedklinicznej. Szybko postępujące przypadki częściej ujawniają się objawami między badaniami. Wykryte w przesiewie przypadki mają więc z natury lepsze rokowanie; to odmiana błędu selekcji. Skrajną postacią jest nadrozpoznanie zmian, które nigdy nie dałyby objawów.
Przykład
W symulacji z R 5-letnie przeżycie liczone od rozpoznania klinicznego wyniosło 29.0%. Gdy te same osoby rozpoznano 2 lata wcześniej, a daty zgonów się nie zmieniły, „przeżycie” wzrosło do 47.0%. W drugiej części wolno rosnące guzy stanowiły 50.3% wszystkich, ale 86.5% wykrytych w jednorazowym przesiewie.
Na rysunku
Rysunek pochodzi z tej samej symulacji co liczby w przykładzie (ten sam kod i to samo ziarno). Panel A pokazuje osiem pierwszych osób, a panel B – 40 pierwszych guzów z 10 000.
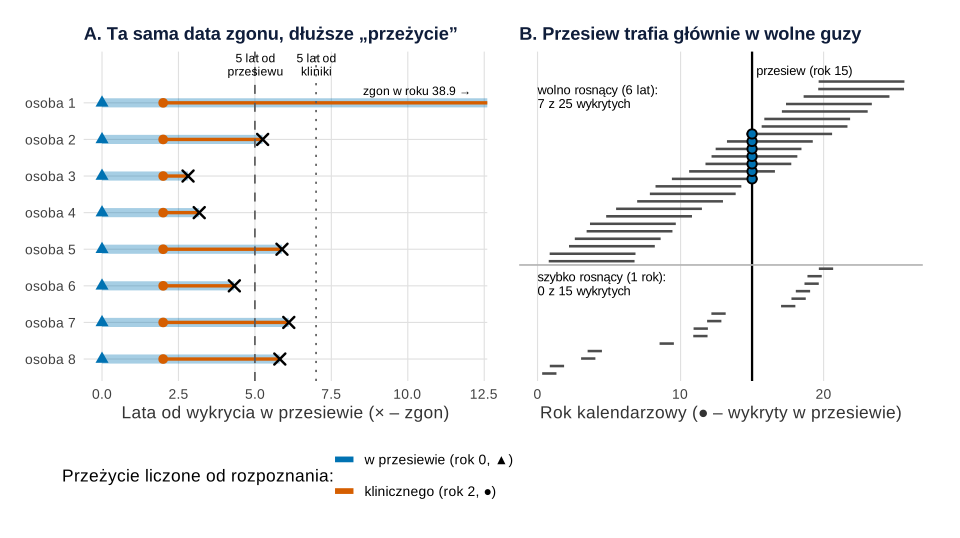
set.seed(531)).Co widać. W panelu A każda osoba umiera w tym samym momencie niezależnie od tego, jak rozpoznano chorobę – krzyżyk jest jeden. Zmienia się tylko początek liczenia. Licząc od przesiewu, 5 lat przeżyło 5 z 8 osób; licząc od rozpoznania klinicznego – 1 z 8. Panel B pokazuje błąd długości. Przesiew w roku 15 „widzi” tylko guzy, których faza przedkliniczna przecina tę datę. Długie odcinki (guzy wolno rosnące) przecinają ją częściej: wykryto 7 z 25 wolnych i 0 z 15 szybkich. W całej symulacji guzy wolne stanowią 50.3% wszystkich i 86.5% wykrytych.
Na co uważać. Panel B to mała próbka – 0 wykrytych szybkich guzów jest tu przypadkiem, nie regułą. Rysunek zakłada, że przesiew nie zmienia daty zgonu, czyli że program nic nie daje. Na prawdziwych danych tej daty „bez przesiewu” nie da się zobaczyć, dlatego wykres przeżycia od rozpoznania nie odróżni skutecznego programu od nieskutecznego. Rozstrzyga porównanie umieralności w grupach z randomizacją (zob. Jak uniknąć błędu).
Podpis do pracy:
Kod rysunku jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p1, w którym podmieniono tylko motyw (krój czcionki, siatka).
Kod R rysunku 1
# Rysunek 1. Błąd wyprzedzenia na osi czasu (A) i błąd długości przy jednorazowym przesiewie (B)
library(ggplot2)
library(patchwork)

kol <- c(przesiew = "#0072B2", klinicznie = "#D55E00")   # Okabe–Ito, czytelne przy deuteranopii
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), panel.grid.major.y = element_blank(),
        legend.position = "bottom", plot.title = element_text(face = "bold", size = rel(0.95)))

set.seed(531)                                   # ta sama symulacja co w sekcji „Symulacja w R”
n <- 10000
do_zgonu <- rexp(n, rate = 1 / 4)               # lata od rozpoznania klinicznego do zgonu
wolny <- rbinom(n, 1, 0.5)
poczatek <- runif(n, 0, 20)                     # początek fazy przedklinicznej (lata)
faza <- ifelse(wolny == 1, 6, 1)
wykryty <- poczatek <= 15 & poczatek + faza > 15  # jednorazowy przesiew w roku 15

# A: osiem pierwszych osób; przesiew w roku 0, rozpoznanie kliniczne 2 lata później, ta sama data zgonu
os <- data.frame(osoba = factor(paste("osoba", 1:8), paste("osoba", 8:1)), zgon = 2 + do_zgonu[1:8])
os$od_przesiewu_5 <- os$zgon > 5                # czy „przeżył 5 lat” licząc od przesiewu
os$od_kliniki_5 <- os$zgon - 2 > 5              # … licząc od rozpoznania klinicznego
print(transform(os, zgon = round(zgon, 1)), row.names = FALSE)
pA <- ggplot(os, aes(y = osoba)) +
  geom_segment(aes(x = 0, xend = zgon, yend = osoba, colour = "przesiew"),
               linewidth = 3.2, alpha = 0.35) +
  geom_segment(aes(x = 2, xend = zgon, yend = osoba, colour = "klinicznie"), linewidth = 1.2) +
  geom_point(aes(x = 0, colour = "przesiew"), shape = 17, size = 3) +
  geom_point(aes(x = 2, colour = "klinicznie"), shape = 16, size = 3) +
  geom_point(aes(x = zgon), shape = 4, size = 3, stroke = 1.3) +
  geom_vline(xintercept = c(5, 7), linetype = c("dashed", "dotted"), colour = "grey35") +
  annotate("text", x = c(5, 7), y = 8.75, label = c("5 lat od\nprzesiewu", "5 lat od\nkliniki"),
           size = 3.2, vjust = 0, lineheight = 0.9) +
  scale_colour_manual("Przeżycie liczone od rozpoznania:", values = kol, breaks = names(kol),
                      labels = c(przesiew = "w przesiewie (rok 0, ▲)", klinicznie = "klinicznego (rok 2, ●)")) +
  geom_text(data = subset(os, zgon > 12), aes(x = 12, label = sprintf("zgon w roku %.1f →", zgon)),
            hjust = 1, vjust = -0.9, size = 3.2) +
  scale_y_discrete(expand = expansion(add = c(0.6, 1.4))) +
  coord_cartesian(xlim = c(0, 12)) +
  labs(x = "Lata od wykrycia w przesiewie (× – zgon)", y = NULL,
       title = "A. Ta sama data zgonu, dłuższe „przeżycie”") +
  guides(colour = guide_legend(nrow = 2, override.aes = list(shape = NA, alpha = 1, linewidth = 2)))

# B: 40 pierwszych guzów – faza przedkliniczna jako odcinek, przesiew w roku 15
gz <- data.frame(id = 1:40, poczatek = poczatek[1:40], koniec = poczatek[1:40] + faza[1:40],
                 typ = factor(ifelse(wolny[1:40] == 1, "wolno rosnący (6 lat)", "szybko rosnący (1 rok)")),
                 wykryty = wykryty[1:40])
gz <- gz[order(gz$typ, gz$poczatek), ]
gz$poz <- seq_len(nrow(gz))
print(table(typ = gz$typ, wykryty_w_przesiewie = gz$wykryty))
etyk <- data.frame(poz = c(13, 38), lab = sprintf("%s:\n%d z %d wykrytych", levels(gz$typ),
                   tapply(gz$wykryty, gz$typ, sum), as.vector(table(gz$typ))))
pB <- ggplot(gz, aes(y = poz)) +
  geom_vline(xintercept = 15, linewidth = 0.8) +
  annotate("text", x = 15.3, y = 41.5, label = "przesiew (rok 15)", hjust = 0, size = 3.4) +
  geom_hline(yintercept = 15.5, colour = "grey70") +                # granica między typami guzów
  geom_segment(aes(x = poczatek, xend = koniec, yend = poz), linewidth = 0.9, colour = "grey30") +
  geom_text(data = etyk, aes(x = 0, label = lab), hjust = 0, size = 3.4, lineheight = 0.9) +
  geom_point(data = subset(gz, wykryty), aes(x = 15), shape = 21, size = 2.6, stroke = 1,
             fill = kol[["przesiew"]], colour = "black") +
  scale_y_continuous(NULL, breaks = NULL, expand = expansion(add = c(1, 2.5))) +
  labs(x = "Rok kalendarzowy (● – wykryty w przesiewie)",
       title = "B. Przesiew trafia głównie w wolne guzy")
p1 <- (pA | pB) & motyw
p1
Wynik w R
   osoba zgon od_przesiewu_5 od_kliniki_5
 osoba 1 38.9           TRUE         TRUE
 osoba 2  5.3           TRUE        FALSE
 osoba 3  2.8          FALSE        FALSE
 osoba 4  3.2          FALSE        FALSE
 osoba 5  5.9           TRUE        FALSE
 osoba 6  4.3          FALSE        FALSE
 osoba 7  6.1           TRUE        FALSE
 osoba 8  5.8           TRUE        FALSE
                        wykryty_w_przesiewie
typ                      FALSE TRUE
  szybko rosnący (1 rok)    15    0
  wolno rosnący (6 lat)     18    7
Jak uniknąć błędu
Grimes i Schulz (2002) podkreślają, że oba błędy zniekształcają pozorną wartość programów przesiewowych, a uniknąć ich pozwala tylko badanie z randomizacją, w którym porównuje się umieralność całych grup, a nie przeżycie od rozpoznania. Welch i in. (2000) pokazali na danych SEER z lat 1950–1995, że zmiany 5-letniego przeżycia dla 20 nowotworów prawie nie wiązały się ze zmianami umieralności (r = .00), za to wiązały się ze zmianami zapadalności (r = .49). W danych obserwacyjnych Duffy i in. (2008) proponują korektę na wyprzedzenie przy założeniu wykładniczego czasu fazy przedklinicznej oraz analizę wrażliwości dla błędu długości.
Jak opisać w pracy
Na co uważać
Krzywe analizy przeżycia dla przypadków z przesiewu i klinicznych rozejdą się nawet przy całkowicie nieskutecznym programie. Nie myl tych błędów z błędem przeżywalności ani z błędem czasu nieśmiertelnego, w którym okres przed rozpoczęciem leczenia błędnie zalicza się do czasu leczenia.
Błąd wyprzedzenia i błąd długości w R
Pierwsza część kodu przesuwa datę rozpoznania o 2 lata przy niezmienionej dacie zgonu i porównuje 5-letnie przeżycie od rozpoznania. Druga symuluje guzy wolno i szybko rosnące oraz jednorazowy przesiew. Liczby w tekście pochodzą z tego kodu.
Pozorny wzrost przeżycia i nadreprezentacja wolnych guzów
R
set.seed(531)
# 1. Błąd wyprzedzenia: przesiew przesuwa rozpoznanie o 2 lata, data zgonu się nie zmienia
n <- 10000
do_zgonu <- rexp(n, rate = 1 / 4)               # lata od rozpoznania klinicznego do zgonu
przezycie5_klin  <- mean(do_zgonu > 5)          # 5-letnie przeżycie liczone od rozpoznania klinicznego
przezycie5_przes <- mean(do_zgonu + 2 > 5)      # to samo, liczone od rozpoznania w przesiewie
# 2. Błąd długości: połowa guzów rośnie wolno (faza przedkliniczna 6 lat), połowa szybko (1 rok)
wolny <- rbinom(n, 1, 0.5)
poczatek <- runif(n, 0, 20)                     # początek fazy przedklinicznej (lata)
faza <- ifelse(wolny == 1, 6, 1)
wykryty <- poczatek <= 15 & poczatek + faza > 15  # jednorazowy przesiew w roku 15
round(c(przezycie5_klin = przezycie5_klin, przezycie5_przes = przezycie5_przes,
        wolne_wsrod_wszystkich = mean(wolny), wolne_wsrod_wykrytych = mean(wolny[wykryty])), 3)
Wynik w R
       przezycie5_klin       przezycie5_przes wolne_wsrod_wszystkich
                 0.290                  0.470                  0.503
 wolne_wsrod_wykrytych
                 0.865
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Symulacja nie wymaga dodatkowych pakietów; rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Dlaczego dłuższe przeżycie po przesiewie nie dowodzi jego skuteczności?
Bo przeżycie liczy się od rozpoznania, a przesiew przesuwa rozpoznanie wcześniej. W symulacji 5-letnie przeżycie wzrosło z 29.0% do 47.0%, choć nikt nie żył dłużej.
Czym błąd długości różni się od błędu wyprzedzenia?
Błąd wyprzedzenia dotyczy tego samego chorego i przesunięcia punktu startu. Błąd długości dotyczy tego, kto zostaje wykryty: przesiew częściej trafia na wolno postępujące przypadki o lepszym rokowaniu.
Jak ocenić program przesiewowy bez tych błędów?
Porównaj umieralność z powodu choroby w grupach losowo zaproszonych i niezaproszonych do przesiewu, licząc wszystkie osoby, a nie tylko wykryte przypadki (Grimes i Schulz, 2002).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Duffy, S. W., Nagtegaal, I. D., Wallis, M., Cafferty, F. H., Houssami, N., Warwick, J., Allgood, P. C., Kearins, O., Tappenden, N., O’Sullivan, E., & Lawrence, G. (2008). Correcting for lead time and length bias in estimating the effect of screen detection on cancer survival. American Journal of Epidemiology, 168(1), 98–104. https://doi.org/10.1093/aje/kwn120
- Grimes, D. A., & Schulz, K. F. (2002). Uses and abuses of screening tests. The Lancet, 359(9309), 881–884. https://doi.org/10.1016/s0140-6736(02)07948-5
- Welch, H. G., Schwartz, L. M., & Woloshin, S. (2000). Are increasing 5-year survival rates evidence of success against cancer? JAMA, 283(22), 2975–2978. https://doi.org/10.1001/jama.283.22.2975
Cytowania BibTeX
@article{duffy2008correcting, author={Duffy, Stephen W. and Nagtegaal, Iris D. and Wallis, Matthew and Cafferty, Fay H. and Houssami, Nehmat and Warwick, Jane and Allgood, Prue C. and Kearins, Olive and Tappenden, Nancy and O'Sullivan, Emma and Lawrence, Gill}, title={{Correcting for lead time and length bias in estimating the effect of screen detection on cancer survival}}, journal={American Journal of Epidemiology}, year={2008}, volume={168}, number={1}, pages={98--104}, doi={10.1093/aje/kwn120}}@article{grimes2002uses, author={Grimes, David A. and Schulz, Kenneth F.}, title={{Uses and abuses of screening tests}}, journal={The Lancet}, year={2002}, volume={359}, number={9309}, pages={881--884}, doi={10.1016/s0140-6736(02)07948-5}}@article{welch2000are, author={Welch, H. G. and Schwartz, L. M. and Woloshin, S.}, title={{Are increasing 5-year survival rates evidence of success against cancer?}}, journal={JAMA}, year={2000}, volume={283}, number={22}, pages={2975--2978}, doi={10.1001/jama.283.22.2975}}